
{count, plural, one {Corso} other {Corsi}}
Introduzione a dbt
{hours} ore
34.1K
dbt (data build tool) è uno strumento potente utilizzato da data analyst e data engineer per trasformare, testare e documentare i dati nel moderno data stack.
Sebbene sia ampiamente noto per le sue capacità di modellazione, un’altra funzionalità fondamentale è lo snapshot di dbt, che ti permette di catturare dimensioni a lenta variazione (SCD) nel tuo data warehouse.
Questo tutorial fornirà una spiegazione approfondita degli snapshot di dbt, dei loro casi d’uso e dell’implementazione. Farò quanto segue:
Per saperne di più su dbt, dai un’occhiata alla nostra guida Cos’è dbt? Un’introduzione pratica per i Data Engineer e al nostro corso Introduzione a dbt.
Uno snapshot di dbt è un meccanismo per tracciare le modifiche ai record nel tempo, soprattutto per le tabelle in cui le modifiche storiche non vengono mantenute di default. Gli snapshot sono usati principalmente per implementare le Slowly Changing Dimensions (SCD) di tipo 2. Memorizzano le versioni delle righe quando le colonne tracciate cambiano.
Casi d’uso includono:
Gli snapshot di dbt sono preziosi perché fungono da registro delle modifiche ai dati nel tempo, abilitando l’analisi storica e la reportistica per la conformità.
Ecco alcuni vantaggi che otterrai usando gli snapshot:
Gli snapshot possono essere utili in alcune situazioni specifiche, come:
Gli snapshot si integrano perfettamente nell’ecosistema di dbt, sfruttandone la configurazione e la gestione delle esecuzioni per costruire in modo efficiente tabelle storiche.
Vediamo come esempio i tipi di modelli usati sui dati.
Esistono due modelli usati per i dati:
Questi due modelli differiscono per scopo, metodi di archiviazione e applicazioni.
Ecco un riepilogo delle differenze:
|
Caratteristica |
Modelli standard |
Snapshot |
|
Scopo |
Trasformazioni dello stato attuale |
Tracciamento storico |
|
Archiviazione |
Tabella o vista con dati correnti |
Tabella storica solo append |
|
Ideale per |
Modelli di fatto/dimensionali |
Dimensioni a lenta variazione |
Gli snapshot seguono in genere un flusso strutturato che assicura che tutte le modifiche vengano catturate in modo sistematico, coinvolgendo i seguenti passaggi:
dbt snapshot per confrontare i dati attuali con gli snapshot esistenti.Ma come vengono tracciate le modifiche in dbt?
Tutte le modifiche sono registrate nella tabella di output dello snapshot.
Se viene rilevata una modifica, dbt aggiorna il campo dbt_valid_to per la versione precedente all’ora corrente e inserisce una nuova riga con il campo dbt_valid_from impostato all’ora corrente.
Gli snapshot usano due strategie principali per rilevare le modifiche.
updated_at affidabili.|
Strategia |
Metodo di rilevamento |
Ideale per |
|
Timestamp |
Colonna timestamp aggiornato |
Tabelle con timestamp di ultima modifica affidabili |
|
Check |
Confronto diretto delle colonne |
Tabelle senza colonne timestamp |
Anche le modifiche ai dati, come le cancellazioni, possono essere tracciate, ma non di default. Tuttavia, c’è un modo per cambiare questo comportamento e monitorare tali hard delete.
invalidate_hard_deletes=True per contrassegnare le righe cancellate con un valore dbt_valid_to, preservandone l’ultimo stato.Ecco un esempio di implementazione della strategia check, tenendo conto degli hard delete:
{%
  snapshot customers_snapshot %}

{%
  set config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='check',
    check_cols=['tier'],
    invalidate_hard_deletes=True
  )
%}

SELECT * FROM {{ source('customers') }}

{% endsnapshot %}Ora che sappiamo come funzionano gli snapshot di dbt, vediamo come implementarli
Per esercitarti con gli snapshot, creeremo una tabella clienti di esempio che imita un sistema di membership reale. Questo ci fornisce dati concreti per testare strategie comuni di snapshot.
import csv
from datetime import datetime

# Define the data
customers_data = [
    ["customer_id", "name", "tier", "updated_at"],  # header row
    [1, "Alice Tan", "Silver", "2025-07-01 10:00:00"],
    [2, "Bob Lee", "Gold", "2025-07-01 10:00:00"],
    [3, "Cheryl Lim", "Silver", "2025-07-01 10:00:00"]
]

# Write data to customers.csv
with open("customers.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
writer.writerows(customers_data)Prima di poter implementare gli snapshot, è essenziale configurare correttamente il tuo progetto dbt. Ciò assicura che il tuo ambiente sia predisposto per gestire modelli, snapshot, test e documentazione in modo strutturato e scalabile.
pip install dbtSostituisci dbt-postgres con l’adapter del tuo warehouse, ad es. dbt-snowflake o dbt-bigquery, in base al tuo ambiente.
1. Vai alla directory dei progetti desiderata.
Qui memorizzerai i tuoi progetti di analytics o ELT. In questo caso, conserveremo tutti i file correlati in questa cartella del progetto dbt.
cd ~/dbt-snapshot-project2. Inizializza un nuovo progetto dbt.
Crea un file di configurazione chiamato dbt_project.yml:
Incolla il seguente contenuto nel file del progetto:
name: dbt_snapshots_project
version: '1.0'
profile: austinchia

seeds:
  dbt_snapshots_project:
    +quote_columns: false
3. Testa la tua connessione.
dbt debugQuesto dovrebbe essere l’output del comando:
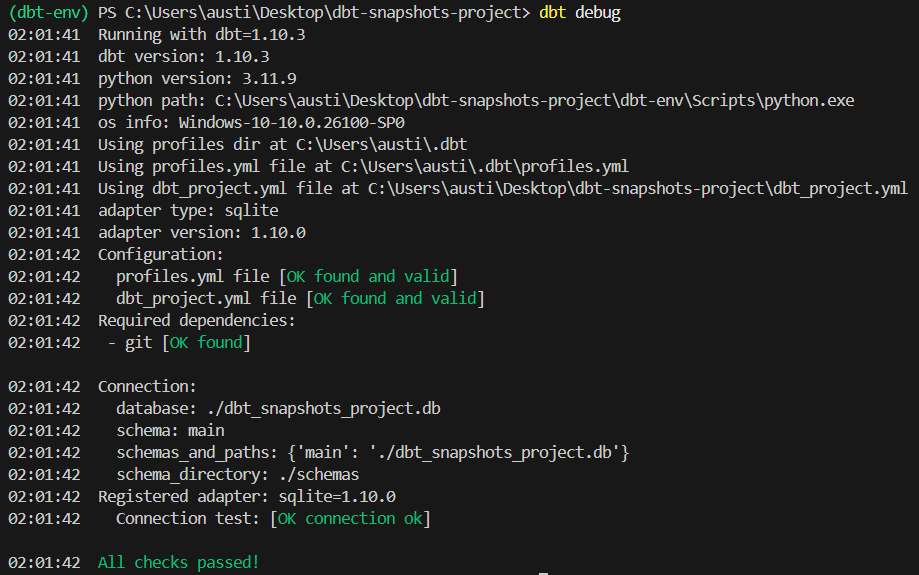
4. Carica i seed in un database locale.
Esegui il seguente comando:
dbt seedQuesto dovrebbe essere l’output del comando:
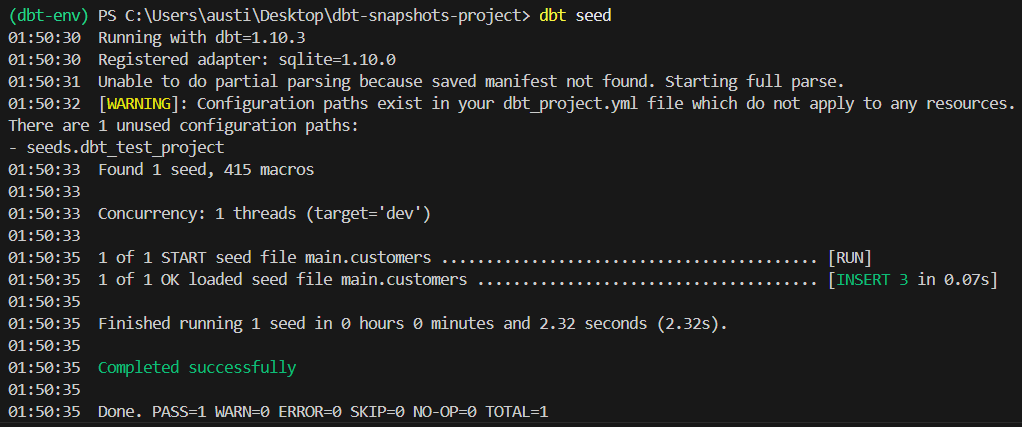
5. Configura le impostazioni di connessione al database
Nel file profiles.yml, solitamente in ~/.dbt/profiles.yml.
Ecco cosa contiene il mio file profiles:
austinchia:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_snapshots_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_snapshots_project.db
      extensions:
        - "C:/sqlean/crypto.dll"
Se stai usando un database SQLite come me, dovrai installare anche l’estensione SQLean.
6. Ingerisci i dati nei modelli di staging di dbt:
Crea una nuova cartella chiamata models. In quella cartella, crea un file chiamato stg_customers.sql.
Incolla il seguente codice nel file:
SELECT
  *
FROM {{ ref('customers') }}
7. Crea i modelli di staging usando il seguente comando in dbt.
dbt run --select stg_customersQuesto dovrebbe essere l’output del comando:
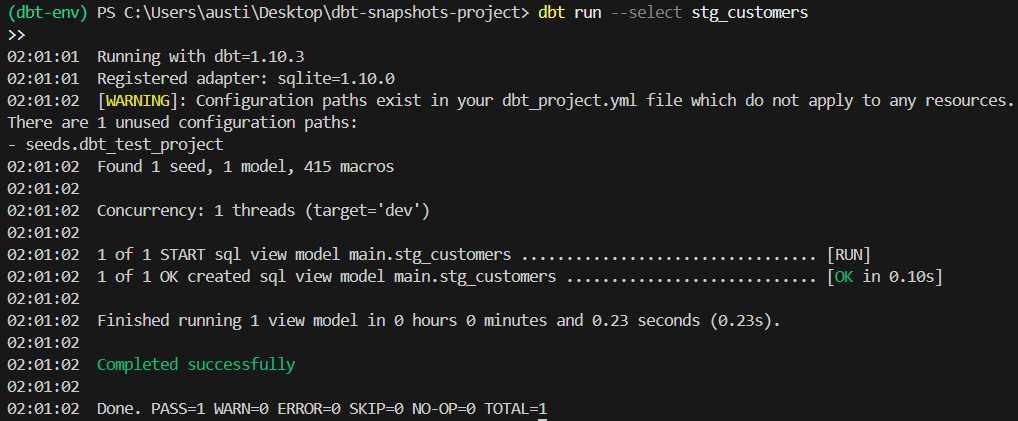
Per questo esempio, puoi usare il seguente codice per eseguire uno snapshot con strategia timestamp.
{% snapshot customers_snapshot %}

{{
  config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='timestamp',
    updated_at='updated_at'
  )
}}

select * from {{ ref('customers') }}

{% endsnapshot %}Esegui:
dbt snapshotCon questo comando, dbt crea la tabella di snapshot se non esiste. Inserisce anche nuove righe per le modifiche rilevate.
Questo dovrebbe essere l’output del comando:
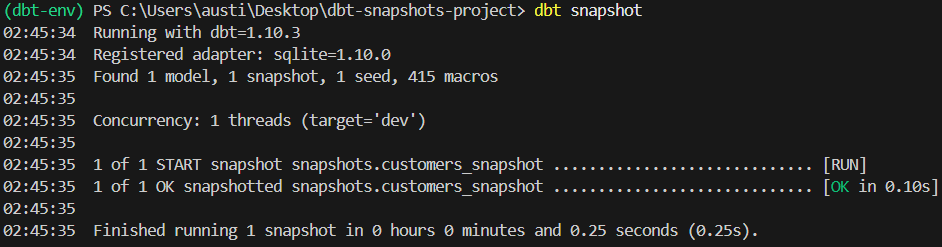
Ora che hai eseguito lo snapshot, dovresti ottenere un nuovo file snapshot.db creato nella directory del progetto.
L’ho aperto in VSCode per vedere com’è il file:
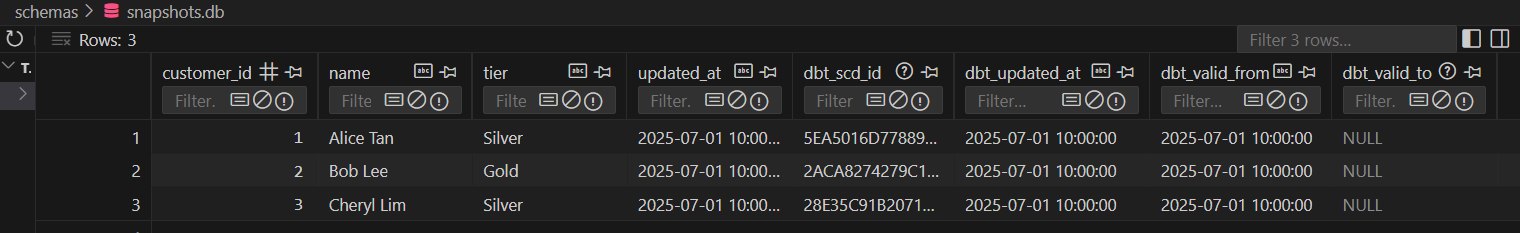
Come puoi vedere, contiene colonne aggiuntive come dbt_updated_at e così via. Queste sono fondamentali per determinare se sono state apportate modifiche ai dati e quando.
Per guide più pratiche su dbt, dai un’occhiata alla nostra guida al Semantic Layer con dbt.
Gli snapshot permettono ai team di catturare una traccia di audit completa delle modifiche di qualsiasi attributo all’interno di una tabella nel tempo, rendendoli potenti per conformità, debug e analytics.
customers con i campi rilevanti. Include ID cliente, nome, email e timestamp updated_at per tracciare quando si verificano cambiamenti.CREATE TABLE customers (
customer_id INTEGER PRIMARY KEY,
name VARCHAR(100),
email VARCHAR(100),
updated_at TIMESTAMP
);Usa il seguente codice per inserire dati nella tabella. Questi dati verranno usati come stato originale prima della modifica.
INSERT INTO customers VALUES
(1, 'Alice Tan', 'alice@example.com', '2025-07-01 10:00:00'),
(2, 'Bob Lee', 'bob.lee@example.com', '2025-07-01 10:00:00');{% snapshot customers_email_snapshot %}
{%
set config(
target_schema='snapshots',
unique_key='customer_id',
strategy='check',
check_cols=['email'],
invalidate_hard_deletes=True
)
%}
SELECT * FROM {{ source('customers') }}
{% endsnapshot %}dbt snapshot per registrare lo stato iniziale.dbt snapshotSuccessivamente, aggiorneremo la nostra tabella originale modificando le informazioni di un cliente per simulare un cambiamento di dato.
UPDATE customers
SET email = 'alice.tan@example.com', updated_at = '2025-07-02 09:00:00'
WHERE customer_id = 1;dbt snapshot per catturare la modifica.dbt snapshotPer vedere le differenze e le modifiche apportate ai dati, dovrai interrogare la tabella di snapshot. La tabella dovrebbe mostrare entrambe le versioni dell’indirizzo email con i rispettivi intervalli di validità:
SELECT customer_id, email, dbt_valid_from, dbt_valid_to
FROM snapshots.customers_email_snapshot
ORDER BY customer_id, dbt_valid_from;
Questo processo garantisce di mantenere una cronologia completa delle modifiche all’email, fondamentale per audit GDPR, tracciamento della cronologia dei contatti o analytics per il supporto clienti.
Una gestione efficace della configurazione consente ai team di scalare le implementazioni di snapshot tra progetti e ambienti senza interruzioni.
dbt_project.yml per impostare configurazioni di snapshot predefinite, come schema di destinazione o materializzazioni, applicabili a tutti gli snapshot.Per impostazione predefinita, dbt crea i campi dbt_valid_from e dbt_valid_to. Puoi rinominarli usando le opzioni di config valid_from e valid_to se gli standard del tuo team richiedono convenzioni di denominazione diverse per chiarezza negli strumenti BI o di data governance.
Le migrazioni possono causare discrepanze se non gestite correttamente. Ecco alcune aree a cui prestare attenzione quando stai migrando le configurazioni degli snapshot:
Le modifiche ai dati possono essere tracciate in sincronia con gli snapshot di dbt.
Per esempio:
Implementare gli snapshot di dbt in produzione richiede un design attento per garantire prestazioni, manutenibilità e valore di business.
Meglio seguire queste indicazioni:
In produzione vorrai ottimizzare i tuoi dati affinché le modifiche possano essere tracciate in modo efficiente senza influire sul prodotto.
Ecco alcuni consigli:
unique_key e colonne di validità per query più veloci.Usare una unique_key non univoca porta a versionamento delle righe errato. Verifica sempre la logica di unicità prima del deploy.
Il gonfiarsi dello snapshot può anche verificarsi quando si memorizzano modifiche storiche non necessarie (ad es., colonne con aggiornamenti di timestamp frequenti), facendo crescere rapidamente i costi di storage.
Usare gli snapshot in dbt può comportare alcune specifiche sfide tecniche:
Problema: Righe duplicate nello snapshot a causa di chiavi univoche definite male.
Soluzione:
Problema: Query lente durante l’analisi dei dati storici.
Soluzione:
dbt_valid_from o per intervalli di date per ridurre il volume di dati scansionati.Problemi comuni includono:
SELECT dello snapshot.Soluzioni:
dbt debug per validare connessione e configurazione.Gli snapshot di dbt permettono ai team di analytics di costruire dataset storici solidi con un minimo carico ingegneristico, abilitando analytics per la conformità. Se vuoi saperne di più su dbt, consulta il nostro corso Introduzione a dbt. Per letture e altre guide, dai un’occhiata a Introduzione al pacchetto dbt-utils e al tutorial su dbt.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



