Matrixdiagonalisatie is een handige techniek in de lineaire algebra die complexe matrices omzet naar hun eenvoudigste vorm: een diagonale matrix. Diagonalizatie is nuttig in tal van toepassingen in data science, van principal component analysis tot het oplossen van differentiaalvergelijkingen en het analyseren van Markov-ketens.
Dit artikel begint bij de basis van een diagonale matrix, verkent wanneer een matrix diagonaliseerbaar is en doorloopt het stapsgewijze proces van diagonalizatie met gedetailleerde voorbeelden. We kijken ook naar het geavanceerde numerieke algoritme dat grote matrices efficiënt verwerkt.
Wat is een diagonale matrix?
Een diagonale matrix is een vierkante matrix waarbij alle elementen buiten de hoofddiagonaal nul zijn.
In wiskundige notatie is een matrix D diagonaal als D[i,j] = 0 wanneer i ≠ j.
Het eenvoudigste voorbeeld is een 3×3-diagonale matrix:
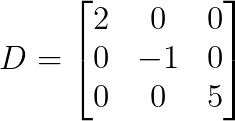
Let op dat alle elementen behalve de diagonaalelementen nul zijn. Wat maakt deze matrices zo bijzonder?
Waarom zijn diagonale matrices belangrijk?
Diagonale matrices hebben meerdere computationele voordelen dankzij hun eenvoudige structuur:
- Eenvoud bij vermenigvuldigen: Bij het vermenigvuldigen van diagonale matrices kunnen we de overeenkomstige diagonaalelementen vermenigvuldigen. Zo vereist matrix-vectorvermenigvuldiging slechts n vermenigvuldigingen in plaats van n² bij algemene matrices.
- Machtverheffen: Om D^n te berekenen, kunnen we elk diagonaalelement tot de n-de macht verheffen, zonder complexe matrixvermenigvuldigingen.
- Inverse berekenen: Als alle diagonaalelementen niet nul zijn, kan de inverse worden berekend door de reciproken van de diagonaalelementen te nemen, waardoor dure matrixinversies worden vermeden.
- Determinant: De determinant is gelijk aan het product van alle diagonaalelementen.
- Opslagvereisten: De opslag daalt van n² naar n elementen, wat het geheugengebruik voor grote matrices verlaagt.
- Eigenwaarden: Eigenwaarden zijn direct zichtbaar als de diagonaalelementen, waardoor spectrale analyse triviaal wordt.
- Lineaire stelsels oplossen: Het oplossen van Dx = b wordt gereduceerd tot elementgewijze deling, waardoor een complexe bewerking eenvoudig wordt.
Deze computationele voordelen verklaren ook waarom het proces van diagonalizatie zo waardevol is in numerieke computing.
Wat is matrixdiagonalisatie?
Matrixdiagonalisatie is het proces waarbij we een diagonale matrix D en een inverteerbare matrix P vinden zodanig dat:
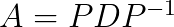
Equivalent kunnen we schrijven:
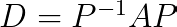
Dit laat zien dat D gelijkvormig is aan A via een basisverandering die wordt weergegeven door P.
Geometrisch gezien onthult diagonalizatie dat veel lineaire transformaties kunnen worden ontbonden in drie stappen:
- Overgaan op een speciaal coördinatenstelsel (vermenigvuldigen met P-1)
- Eenvoudige schaling langs coördinaatassen toepassen (vermenigvuldigen met D)
- Teruggaan naar de oorspronkelijke coördinaten (vermenigvuldigen met P)
De kolommen van P zijn eigenvectoren van A, terwijl de diagonaalelementen van D de bijbehorende eigenwaarden zijn. Deze relatie tussen diagonalizatie en het eigensysteem komt neer op: een matrix is diagonaliseerbaar dan en slechts dan als zij genoeg lineair onafhankelijke eigenvectoren heeft om een basis te vormen.
Wanneer kan een matrix worden gedagonaliseerd?
Omdat niet alle matrices gedagonaliseerd kunnen worden, bekijken we eerst de diagonalizatiestelling en de voorwaarden voor diagonaliseerbaarheid voordat we de techniek toepassen.
De diagonalizatiestelling
De stelling luidt: een n×n-matrix A is diagonaliseerbaar dan en slechts dan als A n lineair onafhankelijke eigenvectoren heeft.
Dit betekent dat diagonaliseerbaarheid volledig afhangt van de geometrische structuur van de transformatie, in het bijzonder of er een basis bestaat die volledig uit eigenvectoren bestaat.
Noodzakelijke en voldoende voorwaarden
De voorwaarden voor het diagonalizatieproces zijn als volgt:
- Volledige set eigenvectoren: De matrix heeft n lineair onafhankelijke eigenvectoren.
- Geometrische multipliciteit gelijk aan algebraïsche multipliciteit: Voor elke eigenwaarde λ is de dimensie van zijn eigenruimte gelijk aan het aantal keren dat λ als wortel van het karakteristieke polynoom voorkomt.
- Minimaal polynoom heeft verschillende lineaire factoren: Het minimale polynoom factoriseert volledig in verschillende lineaire factoren.
De meest praktische test is nagaan of elke eigenwaarde “genoeg” eigenvectoren heeft. Als een eigenwaarde λ k keer als wortel van het karakteristieke polynoom voorkomt, hebben we precies k lineair onafhankelijke eigenvectoren nodig die bij λ horen.
Diagonaliseerbare vs. niet-diagonaliseerbare matrices
Bepaalde matrixtypen zijn altijd diagonaliseerbaar:
- Symmetrische matrices (reële eigenwaarden, orthogonale eigenvectoren)
- Matrices met n verschillende eigenwaarden (die hebben automatisch n onafhankelijke eigenvectoren)
- Hermitische matrices (complexe tegenhanger van symmetrische matrices)
Veelvoorkomende niet-diagonaliseerbare matrices zijn:
- Nilpotente matrices (zoals bovendriehoeksmatrices met nullen op de diagonaal)
- Jordan-blokken (matrices met herhaalde eigenwaarden maar onvoldoende eigenvectoren)
- Defecte matrices (die geen volledige set eigenvectoren hebben)
Veelvoorkomende misvattingen
Voordat we verdergaan, pakken we een paar veelvoorkomende misvattingen over diagonaliseerbaarheid aan:
- Diagonaliseerbaarheid ≠ inverteerbaarheid: Dit zijn volledig onafhankelijke eigenschappen. Een matrix kan diagonaliseerbaar maar singulier (met nul als eigenwaarde) zijn. If zero is an eigenvalue, the matrix is not invertible but can still be diagonalizable. Similarly, a matrix can be invertible but non-diagonalizable: A matrix with no zero eigenvalues (hence invertible) might still lack enough eigenvectors.
- Diagonaliseerbaarheid ≠ reële eigenwaarden hebben: Matrices met complexe eigenwaarden kunnen nog steeds diagonaliseerbaar zijn over de complexe getallen.
- Herhaalde eigenwaarden ≠ niet-diagonaliseerbaar: Matrices kunnen herhaalde eigenwaarden hebben en toch diagonaliseerbaar zijn als ze genoeg eigenvectoren hebben.
Tot nu toe hebben we alle concepten rond diagonalizatie doorgenomen. Je bent meer dan klaar om te duiken in het stapsgewijze proces voor diagonalizatie, met meerdere voorbeelden.
Stapsgewijs proces voor diagonalizatie
Laten we het proces van het diagonalizeren van een matrix stap voor stap doorlopen.
Stap 1: Eigenwaarden vinden
We lossen eerst de karakteristieke vergelijking op om alle eigenwaarden te vinden:
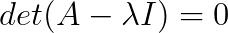
Beschouw een 2×2-matrix:
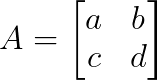
Het karakteristieke polynoom is:
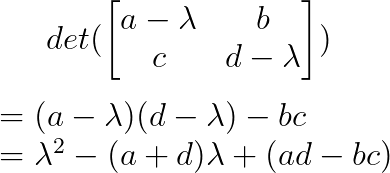
Dit gelijk aan nul stellen en oplossen levert de eigenwaarden op. Voor grotere matrices houdt dit in dat determinanten van (n×n)-matrices berekend moeten worden, wat steeds complexer wordt.
Stap 2: Eigenvectoren vinden
Voor elke eigenwaarde λᵢ lossen we het stelsel op om de bijbehorende eigenvectoren te vinden:
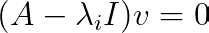
Dit omvat:
- λᵢ invullen in (A — λᵢI)
- De resulterende matrix rijreduceren om de nulruimte te vinden
- De algemene oplossing uitdrukken in vrije parameters
- Specifieke eigenvectoren kiezen (meestal met eenvoudige gehele componenten)
Het aantal lineair onafhankelijke eigenvectoren per eigenwaarde bepaalt of diagonalizatie mogelijk is.
Stap 3: P en D construeren
Zodra we alle eigenvectoren hebben:
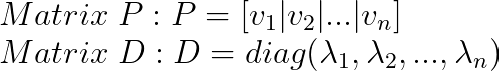
Hierbij is de volgorde van belang; de i-de kolom van P moet overeenkomen met het i-de diagonaalelement van D.
Tot slot kunnen we de diagonalizatie verifiëren via:
- P-1 berekenen (of controleren dat P inverteerbaar is)
- Verifiëren dat A = PDP-1 of equivalent D = P-1AP
- Controleren dat Avᵢ = λᵢvᵢ voor elk eigenvector-eigenwaarde-paar
De volgorde van eigenvectoren in P is willekeurig, maar eenmaal gekozen bepaalt die de volgorde van eigenwaarden in D. Verschillende ordeningen leveren verschillende maar equivalente diagonalizaties op.
Uitgewerkte voorbeelden van diagonalizatie
Laten we verschillende scenario's uitwerken om ons begrip van het diagonalizatieproces te verdiepen.
Voorbeeld 1: Matrix met verschillende eigenwaarden
Beschouw de matrix:
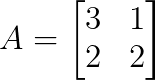
We werken stap één door om de eigenwaarden te vinden door het karakteristieke polynoom te schrijven als
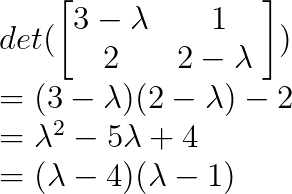
Dus λ₁ = 4 en λ₂ = 1.
Vervolgens vinden we de eigenvectoren door waarden voor λ in te vullen.
Voor λ₁ = 4:
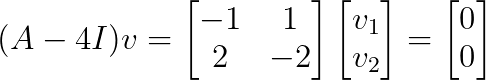
Dit geeft v₁ = [1, 1]ᵀ
Invullen van λ₂ = 1:
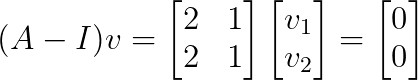
Dit geeft v₂ = [1, -2]ᵀ
We kunnen de diagonalizatie construeren als:
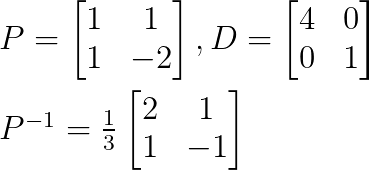
Omdat we alle matrices P, D en P-1 hebben gevonden, kunnen we de oorspronkelijke matrix diagonaliseren.
Voorbeeld 2: Matrix met herhaalde eigenwaarden
Beschouw:
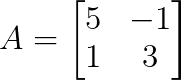
Laten we de eigenwaarden vinden via het karakteristieke polynoom:
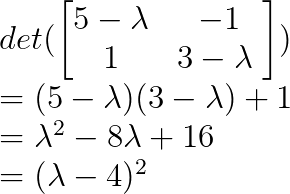
Dus λ = 4 is een herhaalde eigenwaarde met algebraïsche multipliciteit 2.
Laten we de eigenvectoren voor λ = 4 vinden:
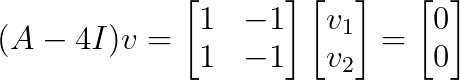
Dit stelsel heeft rang 1, wat een 1-dimensionale eigenruimte oplevert met basisvector v = [1, 1]ᵀ.
Omdat we maar één lineair onafhankelijke eigenvector hebben voor een eigenwaarde met multipliciteit 2, is deze matrix niet diagonaliseerbaar.
Voorbeeld 3: Complexe eigenwaarden
Beschouw de rotatiematrix:
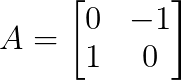
We kunnen de eigenwaarden vinden via het karakteristieke polynoom:
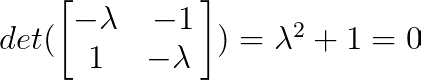
Dus λ₁ = i en λ₂ = -i (waarbij i de imaginaire eenheid is).
Vervolgens vinden we de eigenvectoren. Voor λ₁ = i:
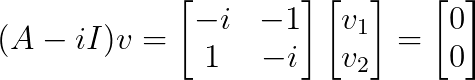
Dit geeft v₁ = [1, -i]ᵀ
Voor λ₂ = -i:
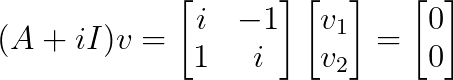
Dit geeft v₂ = [1, i]ᵀ
Dit is een klassiek voorbeeld van een complexe diagonalizatie:
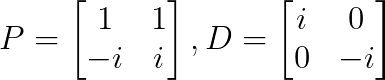
Deze matrix is diagonaliseerbaar over de complexe getallen maar niet over de reële getallen.
Computationele methoden en numerieke aandachtspunten
Handmatige berekeningen werken goed voor kleine matrices, maar in de praktijk zijn numerieke algoritmen nodig die grote matrices efficiënt aankunnen.
Het QR-algoritme
Het QR-algoritme is de standaardmethode om eigenwaarden te vinden in moderne software. In plaats van karakteristieke polynomen op te lossen (wat onpraktisch wordt voor grote matrices), gebruikt het een iteratieve aanpak die de eigenwaarden geleidelijk blootlegt.
Het algoritme werkt via herhaalde transformaties:
- Ontbinden: Aₖ = QₖRₖ (QR-decompositie)
- Vormen: Aₖ₊₁ = RₖQₖ
- Herhalen tot convergentie
Bij elke iteratie wordt de matrix meer driehoeksvormig terwijl de eigenwaarden behouden blijven. Uiteindelijk verschijnen de eigenwaarden op de diagonaal. Voor symmetrische matrices resulteert dit in een diagonale matrix, wat direct de diagonalizatie oplevert.
Moderne implementaties verbeteren dit basisalgoritme met:
- Voorbewerking om de rekenkosten te verlagen
- Shifts die de convergentie versnellen
- Methoden om geconvergeerde eigenwaarden vroegtijdig te extraheren
- Speciale technieken voor paren van complexe eigenwaarden
Conditionering en numerieke stabiliteit
Niet alle diagonalizatieproblemen zijn even stabiel. De sleutel is hoe “gescheiden” de eigenvectoren zijn. Wanneer eigenvectoren bijna dezelfde richting hebben, kunnen kleine numerieke fouten tot grote onnauwkeurigheden leiden.
Deze instabiliteit uit zich op verschillende manieren:
- Dichtbij elkaar liggende eigenwaarden: Wanneer eigenwaarden erg op elkaar lijken, worden hun eigenvectoren numeriek lastig te onderscheiden.
- Bijna-defecte matrices: Matrices die bijna niet-diagonaliseerbaar zijn, hebben extreem gevoelige eigenvectoren.
- Afrondingsfouten: Computerrekenkunde kan kleine fouten uitvergroten tot significante onnauwkeurigheden
Bij dit soort onstabiele gevallen gebruiken numerieke bibliotheken vaak alternatieve ontbindingen die de eenvoud van de diagonale vorm opofferen voor beter numeriek gedrag.
Werken met grote matrices
Verschillende strategieën zijn van toepassing afhankelijk van de grootte en structuur van onze matrix.
Voor ijle matrices (voornamelijk nullen) vinden gespecialiseerde algoritmen zoals Lanczos- of Arnoldi-methoden eigenwaarden zonder ooit de volledige matrix te vormen. Dit werkt goed wanneer de matrix te groot is om op te slaan.
Als we slechts een paar eigenwaarden nodig hebben (zoals de grootste of kleinste), kunnen iteratieve methoden deze direct vinden zonder het volledige spectrum te berekenen.
Voor grote problemen verdelen parallelle algoritmen het werk over meerdere processors, terwijl matrix-vrije methoden het opslaan van de matrix volledig vermijden en alleen vermenigvuldigingen met vectoren nodig hebben.
De beste aanpak hangt doorgaans af van de specifieke behoeften van het probleem: de matrixstructuur, het aantal benodigde eigenwaarden en de gewenste nauwkeurigheid voor onze toepassing.
Conclusie
Matrixdiagonalisatie zet complexe lineaire transformaties om in hun eenvoudigste vorm en onthult hun structuur via eigenwaarden en eigenvectoren. We hebben onderzocht wanneer matrices gedagonaliseerd kunnen worden — namelijk wanneer er een volledige set lineair onafhankelijke eigenvectoren is — en het systematische proces doorlopen om deze eigendecomposities te vinden.
Aan de hand van praktische voorbeelden hebben we gezien hoe verschillende eigenwaarden diagonaliseerbaarheid garanderen, terwijl herhaalde eigenwaarden een analyse van eigenruimten vereisen. We hebben ook gevallen bekeken waarin diagonalizatie faalt, en geleerd over de numerieke methoden die diagonalizatie op grote schaal computational mogelijk maken.
Wil je matrixdiagonalisaties en hun toepassingen in data science verder verkennen? Schrijf je dan in voor onze cursus Linear Algebra for Data Science, waarin je deze concepten onder de knie krijgt met hands-on implementaties en praktijkvoorbeelden.




Matrixdiagonalisatie is een handige techniek in de lineaire algebra die complexe matrices omzet naar hun eenvoudigste vorm: een diagonale matrix. Diagonalizatie is nuttig in tal van toepassingen in data science, van principal component analysis tot het oplossen van differentiaalvergelijkingen en het analyseren van Markov-ketens.
Dit artikel begint bij de basis van een diagonale matrix, verkent wanneer een matrix diagonaliseerbaar is en doorloopt het stapsgewijze proces van diagonalizatie met gedetailleerde voorbeelden. We kijken ook naar het geavanceerde numerieke algoritme dat grote matrices efficiënt verwerkt.
Wat is een diagonale matrix?
Een diagonale matrix is een vierkante matrix waarbij alle elementen buiten de hoofddiagonaal nul zijn.
In wiskundige notatie is een matrix D diagonaal als D[i,j] = 0 wanneer i ≠ j.
Het eenvoudigste voorbeeld is een 3×3-diagonale matrix:
Let op dat alle elementen behalve de diagonaalelementen nul zijn. Wat maakt deze matrices zo bijzonder?
Waarom zijn diagonale matrices belangrijk?
Diagonale matrices hebben meerdere computationele voordelen dankzij hun eenvoudige structuur:
Deze computationele voordelen verklaren ook waarom het proces van diagonalizatie zo waardevol is in numerieke computing.
Wat is matrixdiagonalisatie?
Matrixdiagonalisatie is het proces waarbij we een diagonale matrix D en een inverteerbare matrix P vinden zodanig dat:
Equivalent kunnen we schrijven:
Dit laat zien dat D gelijkvormig is aan A via een basisverandering die wordt weergegeven door P.
Geometrisch gezien onthult diagonalizatie dat veel lineaire transformaties kunnen worden ontbonden in drie stappen:
De kolommen van P zijn eigenvectoren van A, terwijl de diagonaalelementen van D de bijbehorende eigenwaarden zijn. Deze relatie tussen diagonalizatie en het eigensysteem komt neer op: een matrix is diagonaliseerbaar dan en slechts dan als zij genoeg lineair onafhankelijke eigenvectoren heeft om een basis te vormen.
Wanneer kan een matrix worden gedagonaliseerd?
Omdat niet alle matrices gedagonaliseerd kunnen worden, bekijken we eerst de diagonalizatiestelling en de voorwaarden voor diagonaliseerbaarheid voordat we de techniek toepassen.
De diagonalizatiestelling
De stelling luidt: een n×n-matrix A is diagonaliseerbaar dan en slechts dan als A n lineair onafhankelijke eigenvectoren heeft.
Dit betekent dat diagonaliseerbaarheid volledig afhangt van de geometrische structuur van de transformatie, in het bijzonder of er een basis bestaat die volledig uit eigenvectoren bestaat.
Noodzakelijke en voldoende voorwaarden
De voorwaarden voor het diagonalizatieproces zijn als volgt:
De meest praktische test is nagaan of elke eigenwaarde “genoeg” eigenvectoren heeft. Als een eigenwaarde λ k keer als wortel van het karakteristieke polynoom voorkomt, hebben we precies k lineair onafhankelijke eigenvectoren nodig die bij λ horen.
Diagonaliseerbare vs. niet-diagonaliseerbare matrices
Bepaalde matrixtypen zijn altijd diagonaliseerbaar:
Veelvoorkomende niet-diagonaliseerbare matrices zijn:
Veelvoorkomende misvattingen
Voordat we verdergaan, pakken we een paar veelvoorkomende misvattingen over diagonaliseerbaarheid aan:
Tot nu toe hebben we alle concepten rond diagonalizatie doorgenomen. Je bent meer dan klaar om te duiken in het stapsgewijze proces voor diagonalizatie, met meerdere voorbeelden.
Stapsgewijs proces voor diagonalizatie
Laten we het proces van het diagonalizeren van een matrix stap voor stap doorlopen.
Stap 1: Eigenwaarden vinden
We lossen eerst de karakteristieke vergelijking op om alle eigenwaarden te vinden:
Beschouw een 2×2-matrix:
Het karakteristieke polynoom is:
Dit gelijk aan nul stellen en oplossen levert de eigenwaarden op. Voor grotere matrices houdt dit in dat determinanten van (n×n)-matrices berekend moeten worden, wat steeds complexer wordt.
Stap 2: Eigenvectoren vinden
Voor elke eigenwaarde λᵢ lossen we het stelsel op om de bijbehorende eigenvectoren te vinden:
Dit omvat:
Het aantal lineair onafhankelijke eigenvectoren per eigenwaarde bepaalt of diagonalizatie mogelijk is.
Stap 3: P en D construeren
Zodra we alle eigenvectoren hebben:
Hierbij is de volgorde van belang; de i-de kolom van P moet overeenkomen met het i-de diagonaalelement van D.
Tot slot kunnen we de diagonalizatie verifiëren via:
De volgorde van eigenvectoren in P is willekeurig, maar eenmaal gekozen bepaalt die de volgorde van eigenwaarden in D. Verschillende ordeningen leveren verschillende maar equivalente diagonalizaties op.
Uitgewerkte voorbeelden van diagonalizatie
Laten we verschillende scenario's uitwerken om ons begrip van het diagonalizatieproces te verdiepen.
Voorbeeld 1: Matrix met verschillende eigenwaarden
Beschouw de matrix:
We werken stap één door om de eigenwaarden te vinden door het karakteristieke polynoom te schrijven als
Dus λ₁ = 4 en λ₂ = 1.
Vervolgens vinden we de eigenvectoren door waarden voor λ in te vullen.
Voor λ₁ = 4:
Dit geeft v₁ = [1, 1]ᵀ
Invullen van λ₂ = 1:
Dit geeft v₂ = [1, -2]ᵀ
We kunnen de diagonalizatie construeren als:
Omdat we alle matrices P, D en P-1 hebben gevonden, kunnen we de oorspronkelijke matrix diagonaliseren.
Voorbeeld 2: Matrix met herhaalde eigenwaarden
Beschouw:
Laten we de eigenwaarden vinden via het karakteristieke polynoom:
Dus λ = 4 is een herhaalde eigenwaarde met algebraïsche multipliciteit 2.
Laten we de eigenvectoren voor λ = 4 vinden:
Dit stelsel heeft rang 1, wat een 1-dimensionale eigenruimte oplevert met basisvector v = [1, 1]ᵀ.
Omdat we maar één lineair onafhankelijke eigenvector hebben voor een eigenwaarde met multipliciteit 2, is deze matrix niet diagonaliseerbaar.
Voorbeeld 3: Complexe eigenwaarden
Beschouw de rotatiematrix:
We kunnen de eigenwaarden vinden via het karakteristieke polynoom:
Dus λ₁ = i en λ₂ = -i (waarbij i de imaginaire eenheid is).
Vervolgens vinden we de eigenvectoren. Voor λ₁ = i:
Dit geeft v₁ = [1, -i]ᵀ
Voor λ₂ = -i:
Dit geeft v₂ = [1, i]ᵀ
Dit is een klassiek voorbeeld van een complexe diagonalizatie:
Deze matrix is diagonaliseerbaar over de complexe getallen maar niet over de reële getallen.
Computationele methoden en numerieke aandachtspunten
Handmatige berekeningen werken goed voor kleine matrices, maar in de praktijk zijn numerieke algoritmen nodig die grote matrices efficiënt aankunnen.
Het QR-algoritme
Het QR-algoritme is de standaardmethode om eigenwaarden te vinden in moderne software. In plaats van karakteristieke polynomen op te lossen (wat onpraktisch wordt voor grote matrices), gebruikt het een iteratieve aanpak die de eigenwaarden geleidelijk blootlegt.
Het algoritme werkt via herhaalde transformaties:
Bij elke iteratie wordt de matrix meer driehoeksvormig terwijl de eigenwaarden behouden blijven. Uiteindelijk verschijnen de eigenwaarden op de diagonaal. Voor symmetrische matrices resulteert dit in een diagonale matrix, wat direct de diagonalizatie oplevert.
Moderne implementaties verbeteren dit basisalgoritme met:
Conditionering en numerieke stabiliteit
Niet alle diagonalizatieproblemen zijn even stabiel. De sleutel is hoe “gescheiden” de eigenvectoren zijn. Wanneer eigenvectoren bijna dezelfde richting hebben, kunnen kleine numerieke fouten tot grote onnauwkeurigheden leiden.
Deze instabiliteit uit zich op verschillende manieren:
Bij dit soort onstabiele gevallen gebruiken numerieke bibliotheken vaak alternatieve ontbindingen die de eenvoud van de diagonale vorm opofferen voor beter numeriek gedrag.
Werken met grote matrices
Verschillende strategieën zijn van toepassing afhankelijk van de grootte en structuur van onze matrix.
Voor ijle matrices (voornamelijk nullen) vinden gespecialiseerde algoritmen zoals Lanczos- of Arnoldi-methoden eigenwaarden zonder ooit de volledige matrix te vormen. Dit werkt goed wanneer de matrix te groot is om op te slaan.
Als we slechts een paar eigenwaarden nodig hebben (zoals de grootste of kleinste), kunnen iteratieve methoden deze direct vinden zonder het volledige spectrum te berekenen.
Voor grote problemen verdelen parallelle algoritmen het werk over meerdere processors, terwijl matrix-vrije methoden het opslaan van de matrix volledig vermijden en alleen vermenigvuldigingen met vectoren nodig hebben.
De beste aanpak hangt doorgaans af van de specifieke behoeften van het probleem: de matrixstructuur, het aantal benodigde eigenwaarden en de gewenste nauwkeurigheid voor onze toepassing.
Conclusie
Matrixdiagonalisatie zet complexe lineaire transformaties om in hun eenvoudigste vorm en onthult hun structuur via eigenwaarden en eigenvectoren. We hebben onderzocht wanneer matrices gedagonaliseerd kunnen worden — namelijk wanneer er een volledige set lineair onafhankelijke eigenvectoren is — en het systematische proces doorlopen om deze eigendecomposities te vinden.
Aan de hand van praktische voorbeelden hebben we gezien hoe verschillende eigenwaarden diagonaliseerbaarheid garanderen, terwijl herhaalde eigenwaarden een analyse van eigenruimten vereisen. We hebben ook gevallen bekeken waarin diagonalizatie faalt, en geleerd over de numerieke methoden die diagonalizatie op grote schaal computational mogelijk maken.
Wil je matrixdiagonalisaties en hun toepassingen in data science verder verkennen? Schrijf je dan in voor onze cursus Linear Algebra for Data Science, waarin je deze concepten onder de knie krijgt met hands-on implementaties en praktijkvoorbeelden.