
Cursus
Fijn-afstemmen met Llama 3
2 uur
4.1K
Qwen3‑VL‑8B is het krachtigste en meest gebruikte vision‑language‑model in de Qwen‑serie, ontworpen voor uniforme interpretatie van tekst, afbeeldingen en video.
Het biedt grote verbeteringen in tekstgeneratie, visueel redeneren, ruimtelijke perceptie, omgaan met lange contexten en agentinteractie, waardoor het geschikt is voor zowel onderzoek als inzet in de praktijk, aan de edge en in de cloud.
In deze tutorial gaan we fine‑tunen op elektronische schema’s met Qwen3‑VL‑8B‑Instruct. Door het model te trainen op het interpreteren van schemasymbolen, verbindingen en ruimtelijke relaties, leert het schakelingen correct te begrijpen en vast te stellen welke elektronische componenten in een echte schakeling moeten worden toegevoegd.
Je leert hoe je:
Is Hugging Face nog nieuw voor je? Dan is de Hugging Face Fundamentals skill track iets voor jou!
Bij vision‑language‑modellen wordt GPU‑geheugen al snel een knelpunt. Beelden met hoge resolutie en multimodale encoders verbruiken snel VRAM, dus een GPU met veel geheugen is sterk aan te raden.
Voor deze tutorial starten we een RunPod A100 (80GB)‑instantie met de nieuwste PyTorch‑image. Deze setup biedt voldoende VRAM‑ruimte voor training en voorkomt onnodige geheugenknepen tijdens het fine‑tunen.
Scroll naar de sectie Pod Template. Selecteer hier de nieuwste PyTorch‑image. Hier kun je ook opslaginstellingen aanpassen en omgevingsvariabelen toevoegen.
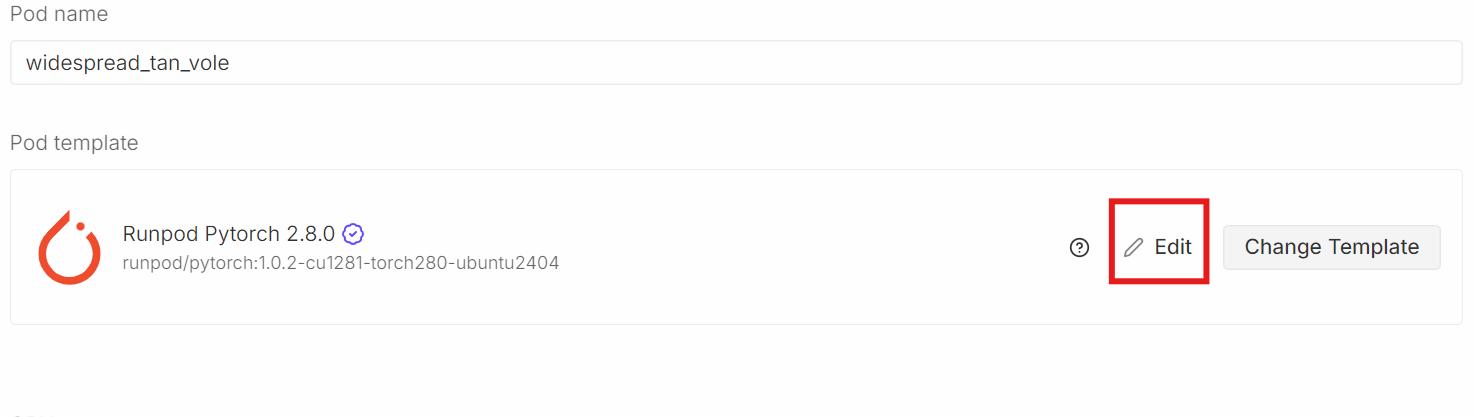
Klik op Edit en maak dan de volgende wijzigingen:
HF_TOKEN toe en stel de waarde in op je Hugging Face‑toegangstoken (genereer er een via de Hugging Face Settings)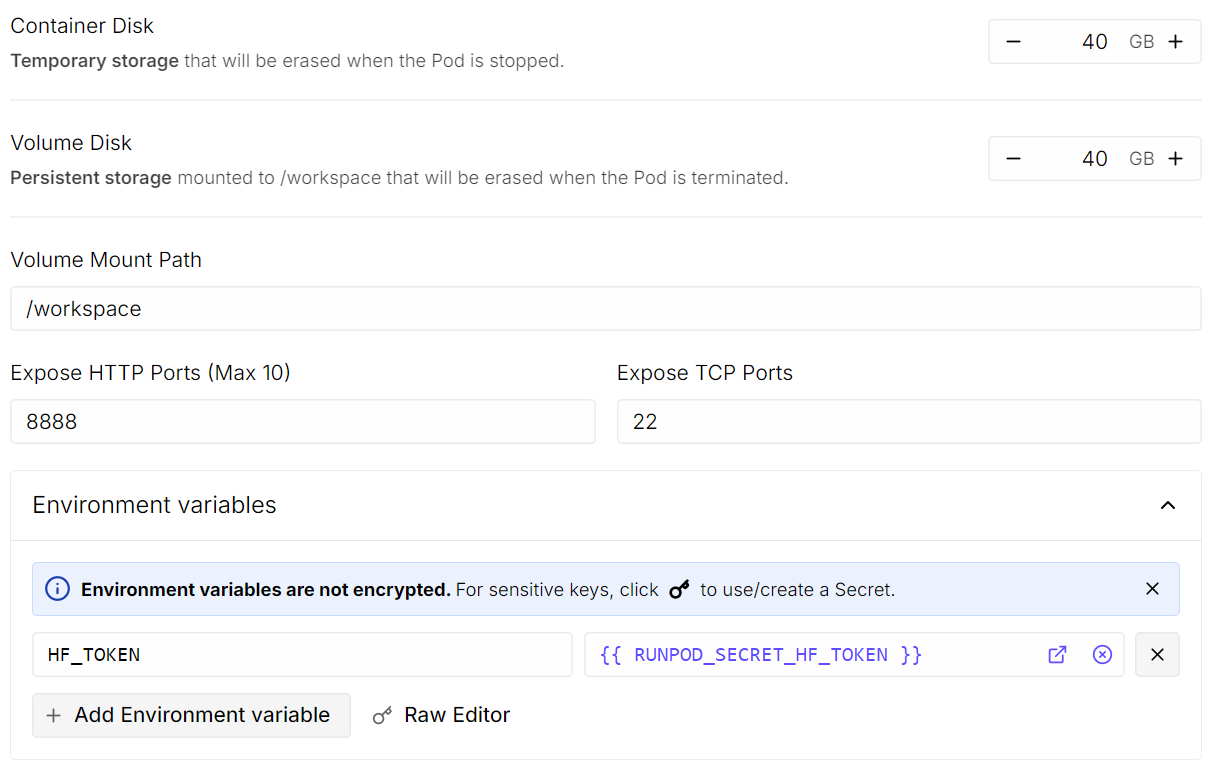
Klaar? Sla dan de template op en deploy de pod.
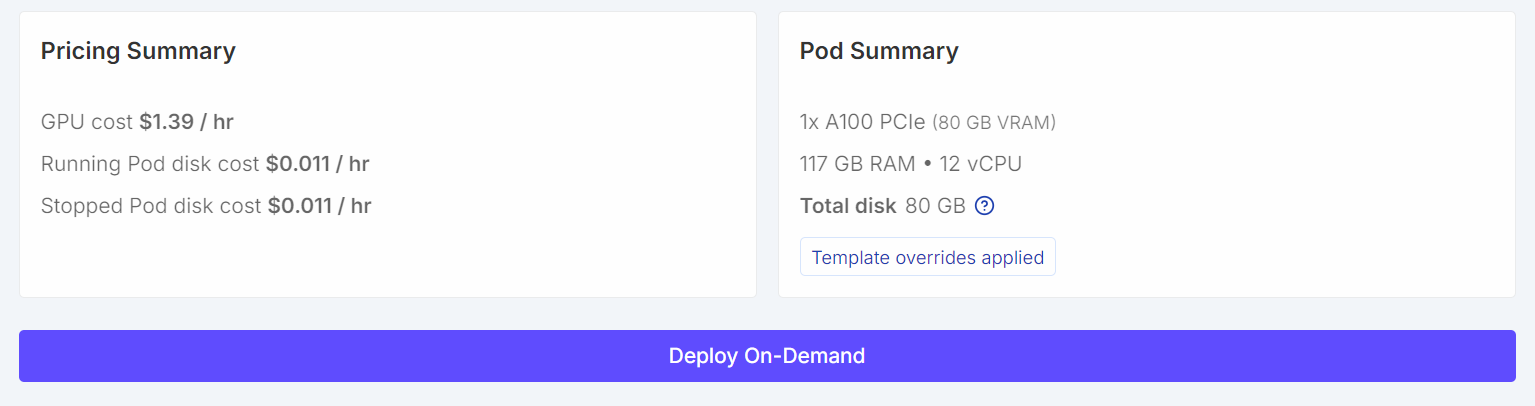
Zodra de pod draait:
Voer onderstaande cel uit om de dependencies te installeren. In Jupyter geeft een uitroepteken aan het begin aan dat de regel als shellopdracht moet worden uitgevoerd in plaats van als Pythoncode.
!pip -q install -U accelerate datasets pillow sentencepiece safetensors peft
!pip install --quiet "transformers==5.0.0rc1"
!pip install --quiet --no-deps trl
!pip install --no-cache-dir flash-attn --no-build-isolation
Stel vervolgens een vaste random seed in voor reproduceerbaarheid en schakel A100‑specifieke prestatieoptimalisaties in.
import torch
from transformers import set_seed

set_seed(42)

# A100: TF32 geeft versnellingen zonder je bf16-trainingssetup te wijzigen
torch.backends.cuda.matmul.allow_tf32 = True
torch.backends.cudnn.allow_tf32 = True

print("CUDA:", torch.cuda.is_available(), torch.cuda.get_device_name(0) if torch.cuda.is_available() else None)
print("bf16 supported:", torch.cuda.is_available() and torch.cuda.is_bf16_supported())
CUDA: True NVIDIA A100 80GB PCIe
bf16 supported: TrueWe laden nu de Open Schematics‑dataset van de Hugging Face Hub. Deze dataset bevat elektronische schemabeelden met rijke metadata over elk circuit, wat hem zeer geschikt maakt voor vision‑language‑training.
import torch
from datasets import load_dataset

DATASET_ID = "bshada/open-schematics"

ds_all = load_dataset(DATASET_ID, split="train")
print(ds_all)
Dataset({
features: ['schematic', 'image', 'components_used', 'json', 'yaml', 'name', 'description', 'type'],
num_rows: 84470
})De dataset bevat meer dan 84K samples, elk met een schemabeeld en gestructureerde informatie zoals componentlijsten en machine‑leesbare formaten (JSON en YAML).
Laten we één sample inspecteren om de structuur beter te begrijpen.
# quick peek
ex = ds_all[0]
print("\nSample keys:", ex.keys())
print("name:", ex.get("name"))
print("type:", ex.get("type"))
print("components_used:", (ex.get("components_used") or [])[:10])
print("has schematic:", bool(ex.get("schematic")))
print("has json/yaml:", bool(ex.get("json")), bool(ex.get("yaml")))
print("image:", ex.get("image"))
Sample keys: dict_keys(['schematic', 'image', 'components_used', 'json', 'yaml', 'name', 'description', 'type'])
name: TiebeDeclercq/Uart-programmer
type: .kicad_sch
components_used: ['Conn_01x01_Pin', 'Conn_01x06_Pin', 'USB_A', 'Conn_02x05_Odd_Even', 'Conn_01x06_MountingPin', 'C', 'Fuse_Small', 'LED', 'R', 'CH340C']
has schematic: True
has json/yaml: True True
image: <PIL.PngImagePlugin.PngImageFile image mode=RGBA size=1123x794 at 0x7FBC6FD060F0>Dit bevestigt dat elk sample een schemabeeld met hoge resolutie, een componentlijst en gestructureerde representaties van het circuit bevat.
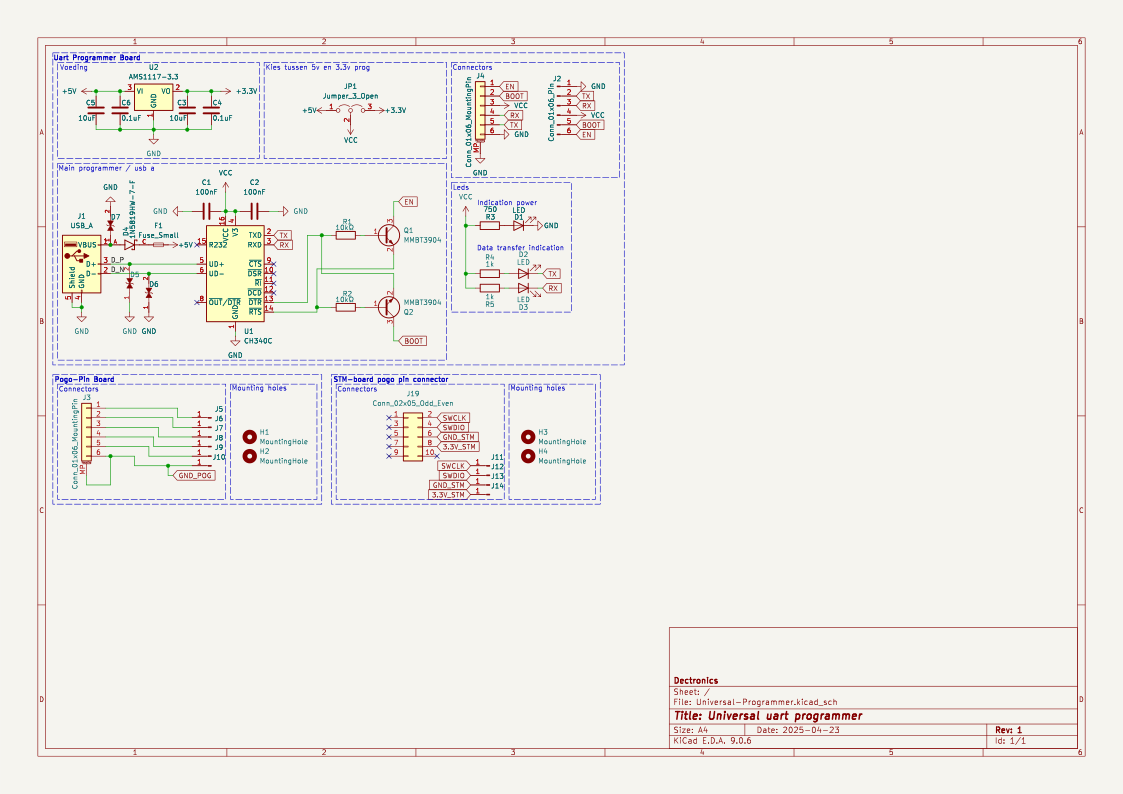
We kunnen het schemabeeld nu direct in het Jupyter‑notebook weergeven.
ex.get("image")
Tot slot bekijken we de volledige lijst met componenten in dit schema.
print(ex.get("components_used"))['Conn_01x01_Pin', 'Conn_01x06_Pin', 'USB_A', 'Conn_02x05_Odd_Even', 'Conn_01x06_MountingPin', 'C', 'Fuse_Small', 'LED', 'R', 'CH340C', 'Jumper_3_Open', 'MountingHole', 'AMS1117-3.3', 'MMBT3904', '1N5819HW-7-F', 'LESD5D5.0CT1G', '+3.3V', '+5V', 'GND', 'VCC']Deze componentlijst legt een duidelijke koppeling tussen het schemabeeld en de elektronische onderdelen in het circuit.
Voorafgaand aan training schonen en filteren we de dataset zodat elk sample de minimale informatie bevat die nodig is voor vision‑language‑leren. We focussen specifiek op voorbeelden met geldige componentannotaties en een bijbehorend schemabeeld.
Eerst bekijken we hoeveel samples ontbrekende, lege of ongeldige components_used‑items hebben.
need_cols = [c for c in ["components_used", "schematic", "name", "type"] if c in ds_all.column_names]
ds_small = ds_all.select_columns(need_cols)

missing_key = none_components = empty_components = missing_any = 0
has_schematic_but_missing = 0

for ex in ds_small:
    if "components_used" not in ex:
        missing_key += 1
        missing_any += 1
        if ex.get("schematic"):
            has_schematic_but_missing += 1
        continue

    cu = ex["components_used"]
    bad = (cu is None) or (isinstance(cu, list) and len(cu) == 0)

    if cu is None:
        none_components += 1
    elif isinstance(cu, list) and len(cu) == 0:
        empty_components += 1

    if bad:
        missing_any += 1
        if ex.get("schematic"):
            has_schematic_but_missing += 1

print("\n=== Missing components report ===")
print("Total:", len(ds_all))
print("Missing key:", missing_key)
print("None:", none_components)
print("Empty list:", empty_components)
print("Missing (any):", missing_any)
if "schematic" in need_cols:
    print("Has schematic but missing components:", has_schematic_but_missing)
=== Missing components report ===
Total: 84470
Missing key: 0
None: 47558
Empty list: 8
Missing (any): 47566
Has schematic but missing components: 47566De samenvatting laat zien dat een groot deel van de samples wel schema‑data bevat maar bruikbare componentannotaties mist.
Om onnodig geheugengebruik tijdens het filteren te voorkomen, schakelen we beelddecodering expliciet uit. Zo laadt Hugging Face geen afbeeldingen in het geheugen bij het toepassen van filters.
from datasets.features import Image as HFImage
ds_all = ds_all.cast_column("image", HFImage(decode=False))
Vervolgens definiëren we een filter dat alleen samples behoudt met een niet‑lege componentlijst en een geldige afbeeldingsreferentie.
def keep_components_and_image(components_used, image):
    # keep only rows with components
    if not (isinstance(components_used, list) and len(components_used) > 0):
        return False

    # image must exist
    if image is None:
        return False

    # when decode=False, image is dict-like: {"path": ...} or {"bytes": ...}
    if isinstance(image, dict):
        return bool(image.get("path")) or bool(image.get("bytes"))

    return True
Dit filter reduceert de dataset drastisch tot hoogwaardige, volledig bruikbare samples.
ds_clean = ds_all.filter(
    keep_components_and_image,
    input_columns=["components_used", "image"],
)

print("Original:", len(ds_all))
print("Clean:", len(ds_clean))
print("Dropped:", len(ds_all) - len(ds_clean))
Original: 84470
Clean: 33275
Dropped: 51195Na het filteren houden we 33K+ schone samples over met zowel geldige schemabeelden als expliciete componentannotaties. Deze opgeschoonde dataset vormt een betrouwbare basis voor de verdere preprocessing en modeltraining.
We laden nu het Qwen3‑VL‑8B‑Instruct‑model met de bijbehorende processor. Dit grootschalige vision‑language‑model kan gezamenlijk redeneren over beelden en tekst en is dus goed inzetbaar voor het begrijpen van schema’s.
Het model wordt geladen in bfloat16‑precisie om het geheugenverbruik te verlagen met behoud van numerieke stabiliteit. We schakelen ook Flash Attention 2 in voor snellere en geheugenefficiëntere attention op de A100‑GPU. De optie device_map="auto" plaatst model‑lagen automatisch op de beschikbare GPU.
from transformers import Qwen3VLForConditionalGeneration, AutoProcessor

MODEL_ID = "Qwen/Qwen3-VL-8B-Instruct"

model = Qwen3VLForConditionalGeneration.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="flash_attention_2",
)
processor = AutoProcessor.from_pretrained(MODEL_ID)In deze stap definiëren we lichte hulpfuncties om prompts, targets en afbeeldingen voor vision‑language‑training voor te bereiden. Eén pipeline wordt voor meerdere taken gebruikt door de variabele TASK te wisselen (components, YAML, JSON of schematic reconstruction).
We passen basislimieten toe om de doellengte en afbeeldingsgrootte te beperken. Dit houdt de training stabiel en geheugenefficiënt.
from PIL import Image


TASK = "components"  # "components" | "yaml" | "json" | "schematic"
MAX_TARGET_CHARS = 5000  # safety cap for long targets like schematic/json
MAX_IMAGE_SIDE = 1024          # bigger side
MAX_IMAGE_PIXELS = 1024 * 1024 # safety cap (1.0 MP). raise to 1.5MP if stable
De functie build_prompt() construeert de instructietekst voor het model. Hij gebruikt datasetmetadata voor context en dwingt strikte outputconstraints af om hallucinaties te verminderen en de supervisie consistent te houden tussen taken.
def build_prompt(example):
    # Use dataset fields to give better context (name/type are helpful)
    name = example.get("name") or "Unknown project"
    ftype = example.get("type") or "unknown format"

    if TASK == "components":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, extract all component labels and identifiers exactly as shown "
            "(part numbers, values, footprints, net labels like +5V/GND).\n"
            "Output only a comma-separated list. Do not generalize or add extra text."
        )

    if TASK == "yaml":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, produce YAML metadata for the design.\n"
            "Return valid YAML only. No markdown, no explanations."
        )

    if TASK == "json":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, produce a JSON representation of the schematic structure.\n"
            "Return valid JSON only. No markdown, no explanations."
        )

    if TASK == "schematic":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, reconstruct the raw KiCad schematic content.\n"
            "Return only the schematic text. No markdown, no explanations."
        )

raise ValueError("Unknown TASK")De functie build_target() haalt de ground‑truth‑output voor de gekozen taak direct uit de dataset. De inhoud wordt letterlijk teruggegeven om het model te trainen op exacte reproductie, niet parafraseren.
def build_target(example):
    if TASK == "components":
        comps = example.get("components_used") or []
        return ", ".join(comps)

    if TASK == "yaml":
        return (example.get("yaml") or "").strip()

    if TASK == "json":
        return (example.get("json") or "").strip()

    if TASK == "schematic":
        return (example.get("schematic") or "").strip()

    raise ValueError("Unknown TASK")
De functie clamp_text() past een harde tekenlimiet toe op targets. Dit voorkomt dat te grote JSON‑, YAML‑ of schemabestanden geheugenproblemen veroorzaken tijdens training.
def clamp_text(s: str, max_chars: int = MAX_TARGET_CHARS) -> str:
    s = (s or "").strip()
return s if len(s) <= max_chars else s[:max_chars].rstrip()De functie _resize_pil() normaliseert en schaalt schemabeelden vóór verwerking. Hij handhaaft zowel een maximale langste zijde als een maximum aantal pixels, voor voorspelbaar GPU‑geheugenverbruik met behoud van detail.
def _resize_pil(pil: Image.Image, max_side: int = MAX_IMAGE_SIDE, max_pixels: int = MAX_IMAGE_PIXELS) -> Image.Image:
    pil = pil.convert("RGB")
    w, h = pil.size

    # Scale down if max side too large
    scale_side = min(1.0, max_side / float(max(w, h)))

    # Scale down if too many pixels (area cap)
    scale_area = (max_pixels / float(w * h)) ** 0.5 if (w * h) > max_pixels else 1.0

    scale = min(scale_side, scale_area)

    if scale < 1.0:
        nw, nh = max(1, int(w * scale)), max(1, int(h * scale))
        pil = pil.resize((nw, nh), resample=Image.BICUBIC)

return pilIn deze stap zetten we elk opgeschoond sample om naar een multimodaal chatformaat dat direct kan worden gebruikt door het Qwen vision‑language‑model. Dit formaat koppelt het schemabeeld expliciet aan een tekstuele instructie en de bijbehorende targetoutput.
def to_messages(example):
    prompt = build_prompt(example)
    target = clamp_text(build_target(example))

    example["messages"] = [
        {
            "role": "user",
            "content": [
                {"type": "image"},
                {"type": "text", "text": prompt},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": target}],
        },
    ]
    return example
We schudden de dataset om volgorde‑bias te verwijderen en kiezen een kleine subset voor eerste experimenten.
De dataset wordt vervolgens via to_messages() gemapt om multimodale trainingsvoorbeelden te genereren. Daarna schakelen we beelddecodering weer in, zodat afbeeldingen pas tijdens training worden geladen en de preprocessing licht en geheugenefficiënt blijft.
# Start small (increase later)
train_ds = ds_clean.shuffle(seed=42).select(range(min(800, len(ds_clean)))).map(to_messages)
train_ds = train_ds.cast_column("image", HFImage(decode=True))Voordat we fine‑tunen, evalueren we de prestaties out‑of‑the‑box van het Qwen3‑VL 8B Instruct‑model op onze taak. Deze baseline helpt inschatten hoe goed het voorgetrainde model zonder aanpassing informatie uit schemabeelden haalt.
De functie run_inference() voert één forward pass uit op één voorbeeld met dezelfde prompting en beeldvoorverwerking die we later tijdens training gebruiken.
import torch

def run_inference(model_, example, max_new_tokens=256):
    prompt = build_prompt(example)

    messages = [
        {
            "role": "user",
            "content": [
                {"type": "image", "image": _resize_pil(example["image"])},
                {"type": "text", "text": prompt},
            ],
        }
    ]

    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(model_.device)

    with torch.inference_mode():
        out = model_.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)

    gen = out[0][inputs["input_ids"].shape[1]:]
    return processor.decode(gen, skip_special_tokens=True)

baseline_ex = train_ds.shuffle(seed=120).select(range(1))[0]
We evalueren het model eerst op een willekeurig gekozen sample uit de trainingsset.
print("\n--- BASELINE OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- BASELINE OUTPUT ---
J1,Conn_02x11_Odd_Even,CINT6,CINT5,CINT4,CINT3,CINT2,CINT1,CINT0,CINT15,CINT14,CINT13,CINT12,CINT11,CINT10,CINT9,CINT8,CINT7,CINT16,CINT17,CINT18,CINT19,CINT20,CINT21,CINT22,CINT23,CINT24,CINT25,CINT26,CINT27,CINT28,CINT29,CINT30,CINT31,CINT32,CINT33,CINT34,CINT35,CINT36,CINT37,CINT38,CINT39,CINT40,CINT41,CINT42,CINT43,CINT44,CINT45,CINT46,CINT47,CINT48,CINT49,CINT50,CINT51,CINT52,CINT53,CINT54,CINT55,CINT56,CINT57,CINT58,CINT59,CINT60,CINT61,CINT62
--- TARGET (dataset) ---
Conn_02x11_Odd_Even, R_Pack04, GNDIn dit voorbeeld herkent het model enkele structurele elementen, maar het genereert te veel pin‑ en signaalnamen en herstelt de exacte componentidentificaties uit de dataset niet. Dit patroon zag ik vaker bij andere voorbeelden.
Kortom: hoewel het model sterke algemene visuele en tekstuele vaardigheden heeft, ontbreekt afstemming op de dataspecifieke componentannotaties. Dit onderstreept de noodzaak van fine‑tunen om hallucinaties te verminderen en de precisie te verbeteren.
In deze sectie definiëren we een aangepaste datacollator die multimodale chat‑batches voor training voorbereidt. Hij zet elk voorbeeld om in modelklare tensors door tekst en beelden gezamenlijk te encoderen, en zorgt dat verlies alleen wordt berekend op het antwoord van de assistant.
De collator bouwt twee versies van de chattekst: een volledige versie (prompt en target) voor inputencoding en een alleen‑promptversie om de prompttokenlengtes te bepalen. Met die lengtes worden alle prompt‑ en paddingtokens in de labels gemaskeerd, zodat alleen de assistantoutput bijdraagt aan de loss. Afbeeldingen worden consistent geschaald en een vaste maximale sequentielengte wordt afgedwongen voor geheugenefficiëntie.
from typing import List, Dict, Any
import torch

MAX_LEN = 1500

def collate_fn(batch: List[Dict[str, Any]]):
    # 1) Build full chat text (includes assistant answer)
    full_texts = [
        processor.apply_chat_template(
            ex["messages"],
            tokenize=False,
            add_generation_prompt=False,
        )
        for ex in batch
    ]

    # 2) Build prompt-only text (up to user turn; generation prompt on)
    prompt_texts = [
        processor.apply_chat_template(
            ex["messages"][:-1],
            tokenize=False,
            add_generation_prompt=True,
        )
        for ex in batch
    ]

    # 3) Images
    images = [_resize_pil(ex["image"]) for ex in batch]

    # 4) Tokenize full inputs ONCE (text + images)
    enc = processor(
        text=full_texts,
        images=images,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=MAX_LEN,
    )

    input_ids = enc["input_ids"]
    pad_id = processor.tokenizer.pad_token_id

    # 5) Compute prompt lengths with TEXT-ONLY tokenization (much cheaper than text+images)
    prompt_ids = processor.tokenizer(
        prompt_texts,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=MAX_LEN,
        add_special_tokens=False,  # chat template already includes special tokens
    )["input_ids"]

    # Count non-pad tokens in prompt
    prompt_lens = (prompt_ids != pad_id).sum(dim=1)

    # 6) Labels: copy + mask prompt tokens + mask padding
    labels = input_ids.clone()
    bs, seqlen = labels.shape

    for i in range(bs):
        pl = int(prompt_lens[i].item())
        pl = min(pl, seqlen)
        labels[i, :pl] = -100

    # Mask padding positions too
    labels[labels == pad_id] = -100

    # If your processor produces pixel_values / image_grid_thw, keep them
    enc["labels"] = labels
    return enc
Deze collator maakt efficiënte en correcte supervisie mogelijk voor vision‑language‑fine‑tuning.
We configureren nu LoRA (Low‑Rank Adaptation) om het Qwen3‑VL‑model efficiënt te fine‑tunen zonder alle modelgewichten te updaten. LoRA voegt trainbare low‑rank‑matrices toe aan geselecteerde projectielagen, wat het geheugenverbruik sterk vermindert met behoud van prestaties.
from peft import LoraConfig, TaskType, get_peft_model

lora = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type=TaskType.CAUSAL_LM,
    target_modules=[
        "q_proj","k_proj","v_proj","o_proj",
        "gate_proj","up_proj","down_proj"
    ],
)
Daarna definiëren we de trainingsconfiguratie met SFTConfig, met batchgrootte, learning rate, precisie en loggingopties die geschikt zijn voor stabiel fine‑tunen op de A100‑GPU.
from trl import SFTTrainer, SFTConfig

args = SFTConfig(
    output_dir=f"qwen3vl-open-schematics-{TASK}-lora",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=4,
    gradient_checkpointing=False,
    learning_rate=1e-4,
    warmup_steps=10,
    weight_decay=0.01,
    max_grad_norm=1.0,
    bf16=True,
    fp16=False,
    lr_scheduler_type="cosine",
    logging_steps=10,
    report_to="none",
    remove_unused_columns=False,
)
Tot slot initialiseren we de SFTTrainer, waarmee model, dataset, aangepaste collator en LoRA‑configuratie worden gecombineerd om te starten met supervised fine‑tuning.
trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=train_ds,
    data_collator=collate_fn,
    peft_config=lora
)We starten nu het fine‑tunen met de geconfigureerde trainer.
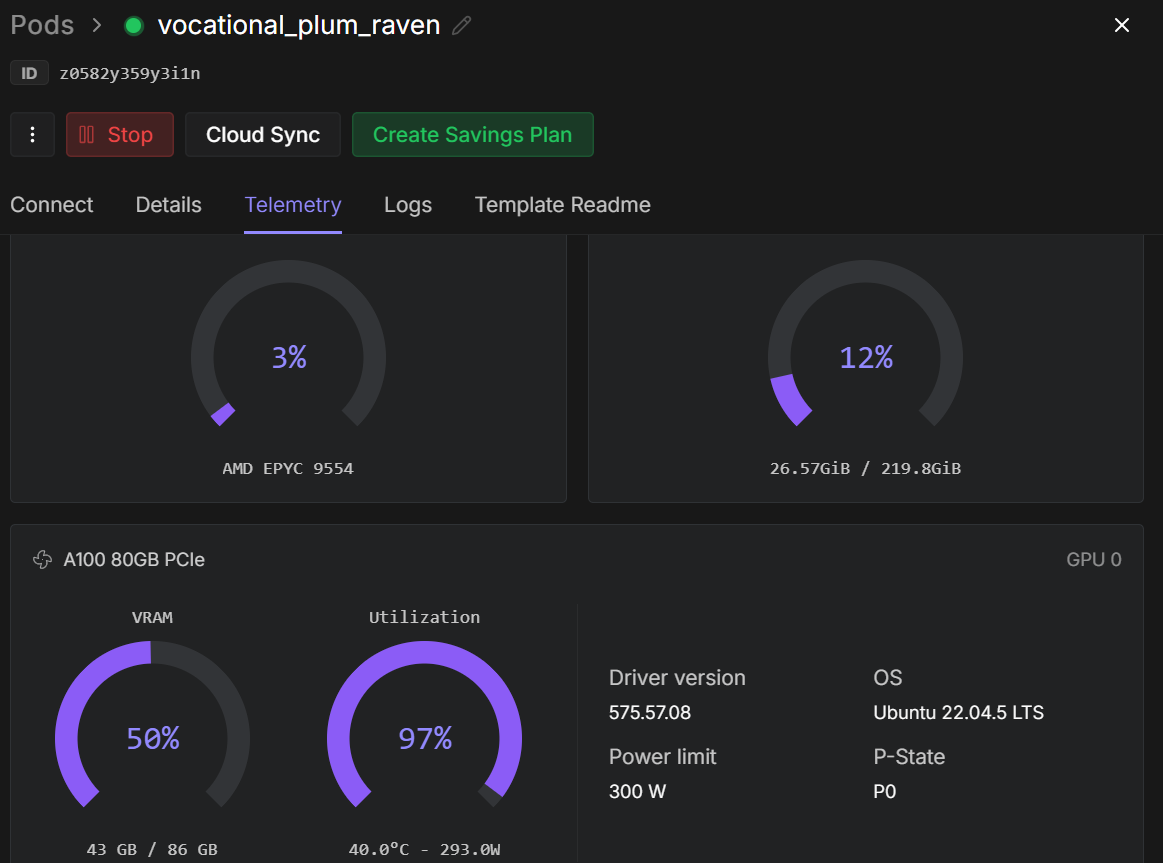
trainer.train()Zodra de training loopt, kun je het RunPod‑telemetriedashboard volgen. Op een A100 80GB‑instantie gebruikt het proces doorgaans ongeveer 40–45 GB VRAM en is de GPU‑benutting bijna maximaal, wat op efficiënte hardware‑inzet duidt.
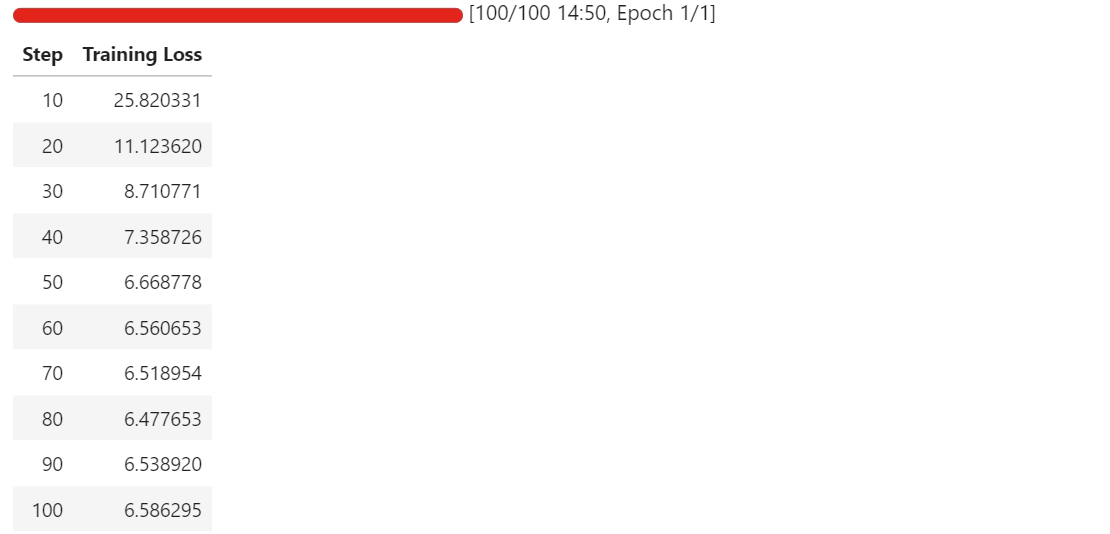
Naarmate de training vordert, zou je de training loss gestaag moeten zien dalen en vervolgens stabiliseren. In ons geval convergeert de loss en vlakt af rond 6,5, wat aangeeft dat het model zich heeft aangepast aan de taak van componentextractie.
Op dit punt zijn de LoRA‑adapters met succes gefine‑tuned en klaar voor evaluatie en export.
Na het fine‑tunen slaan we eerst de getrainde LoRA‑adapters en de bijbehorende processor lokaal op.
out_dir = trainer.args.output_dir  # from your SFTConfig/TrainingArguments

trainer.save_model(out_dir)  # saves model/adapters into output_dir
processor.save_pretrained(out_dir)  # save processor (tokenizer + image processor)
Vervolgens publiceren we het gefine‑tunede model op de Hugging Face Hub. Zo kunnen de adapters en processor worden hergebruikt voor inferentie of verder fine‑tunen.
import os

repo_id = "kingabzpro/qwen3vl-open-schematics-lora" # replace with your username/repo

# Push model/adapters
trainer.model.push_to_hub(
    repo_id,
    token=os.getenv("HF_TOKEN"),
)

# Push processor
processor.push_to_hub(
    repo_id,
    token=os.getenv("HF_TOKEN"),
)
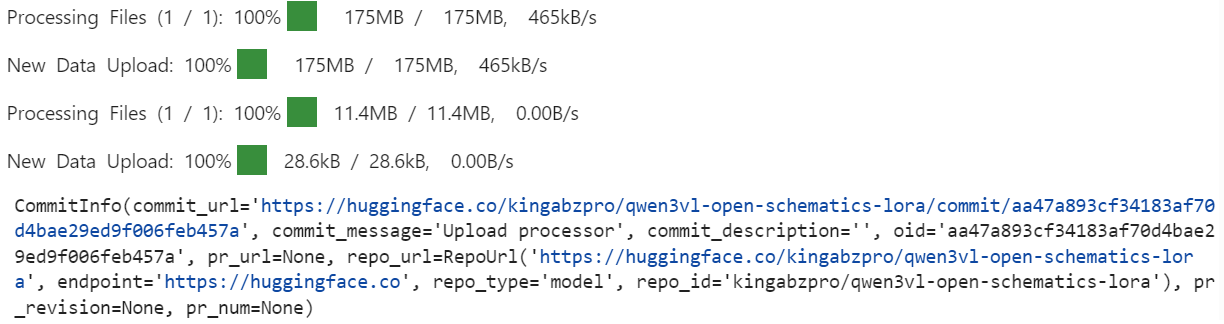
Na de upload zijn de gefine‑tunede LoRA‑adapters en de processor openbaar beschikbaar in de opgegeven repository.
Na het fine‑tunen laden we model en processor opnieuw, direct van de Hugging Face Hub. Zo evalueren we met de geëxporteerde LoRA‑adapters, precies zoals bij echte inferentie.
model = Qwen3VLForConditionalGeneration.from_pretrained(
    repo_id,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="flash_attention_2",
)
processor = AutoProcessor.from_pretrained(repo_id)
```
We now repeat the same inference procedure used during the baseline evaluation, allowing for a direct comparison between pre-fine-tuning and post-fine-tuning behavior.
```python
baseline_ex = train_ds.shuffle(seed=120).select(range(1))[0]
print("\n--- FINETUNED OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- FINETUNED OUTPUT ---
Conn_02x11_0dd_Even, P3.3V
--- TARGET (dataset) ---
Conn_02x11_Odd_Even, R_Pack04, GNDVergeleken met de baseline produceert het gefine‑tunede model een veel kortere en meer gefocuste output en vermijdt het grootschalige overgeneratie van pinnamen en afgeleide signalen.
Hoewel de voorspelling nog onvolledig is en kleine fouten bevat, is er duidelijk voortgang richting dataspecifieke componentidentificaties.
We evalueren nu een tweede voorbeeld om dit gedrag te bevestigen.
baseline_ex = train_ds.shuffle(seed=170).select(range(1))[0]
print("\n--- FINETUNED OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- FINETUNED OUTPUT ---
ATMEGA328P-PU, +5V, GND, R, C, C16MHz, SERVO_A, SERVO_B, SERVO_C, SERVO_D, SERVO_E, SERVO_F, SERVO_G
--- TARGET (dataset) ---
+5V, 7.62MM-3P, 7.62MM-3P_1, 7.62MM-3P_2, 7.62MM-3P_3, 7.62MM-3P_4, 7.62MM-3P_5, 7.62MM-3P_6, ATMEGA328P-PU, ATMEGA328P-PU_1, GND, MBB02070C1002FCT00, MBB02070C1002FCT00_1, Unknown_0_-806, X49SD16MSD2SC, Y5P102K2KV16CC0224, Y5P102K2KV16CC0224_1, Y5P102K2KV16CC0224_2Hier identificeert het gefine‑tunede model kerncomponenten, zoals de microcontroller en voedingsnetten, en vermindert het irrelevant signaalniveau‑hallucinaties aanzienlijk. Het abstraheert echter nog steeds sommige componenten in plaats van de exacte dataspecifieke identifiers te reproduceren.
Al met al laten deze resultaten zien dat fine‑tunen overgeneratie succesvol onderdrukt en de afstemming op componentextractie op schemaniveau verbetert. De precisie kan verder worden verbeterd met extra epochs, grotere trainingssets of strengere outputconstraints, maar het post‑fine‑tuning‑gedrag is duidelijk beter dan de baseline.
Loop je tegen problemen aan bij het uitvoeren van de code in deze tutorial? Raadpleeg dan het bijbehorende notebook.
Vision‑language‑modellen verschillen fundamenteel van tekst‑only‑modellen; ze hetzelfde behandelen levert bijna altijd slechte resultaten op.
Zonder zorgvuldigheid loop je snel tegen out‑of‑memory‑fouten aan, zelfs met batchgrootte één, of fine‑tune je een model dat ogenschijnlijk traint maar de taak niet echt leert. Dat heb ik zelf ondervonden.
Wat uiteindelijk het verschil maakte, was aandacht voor de details die specifiek tellen voor multimodale training.
Afbeeldingen schalen binnen veilige grenzen, de dataset opschonen om kapotte of onbruikbare samples te verwijderen, en ervoor zorgen dat alleen geldige beeld‑tekstparen naar het model gaan, zijn essentiële stappen. Als je iets hiervan overslaat, leidt dat snel tot instabiliteit of verspilde compute.
Aan de modelkant hielp het om alleen de relevante LoRA‑doellagen te gebruiken, zodat de training efficiënt en gefocust bleef, terwijl zorgvuldige afstelling van trainingsargumenten de convergentie verbeterde zonder extra geheugenbelasting.
Optimaliseren voor de A100‑GPU, Flash Attention inschakelen en bfloat16 gebruiken hielden de training stabiel en verkortten de runtime aanzienlijk. In de praktijk halveerden deze optimalisaties de trainingstijd vrijwel, zonder kwaliteitsverlies.
De eindresultaten laten zien dat zelfs een sterk voorgetraind vision‑language‑model enorm profiteert van domeinspecifiek fine‑tunen. Met de juiste preprocessing, configuratie en hardware‑bewuste optimalisaties kun je grote multimodale modellen betrouwbaar en efficiënt aanpassen.
Wil je verder oefenen met fine‑tunen? Dan raad ik de cursus Fine‑Tuning with Llama 3 aan.
LLM-cursussen
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

