
कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
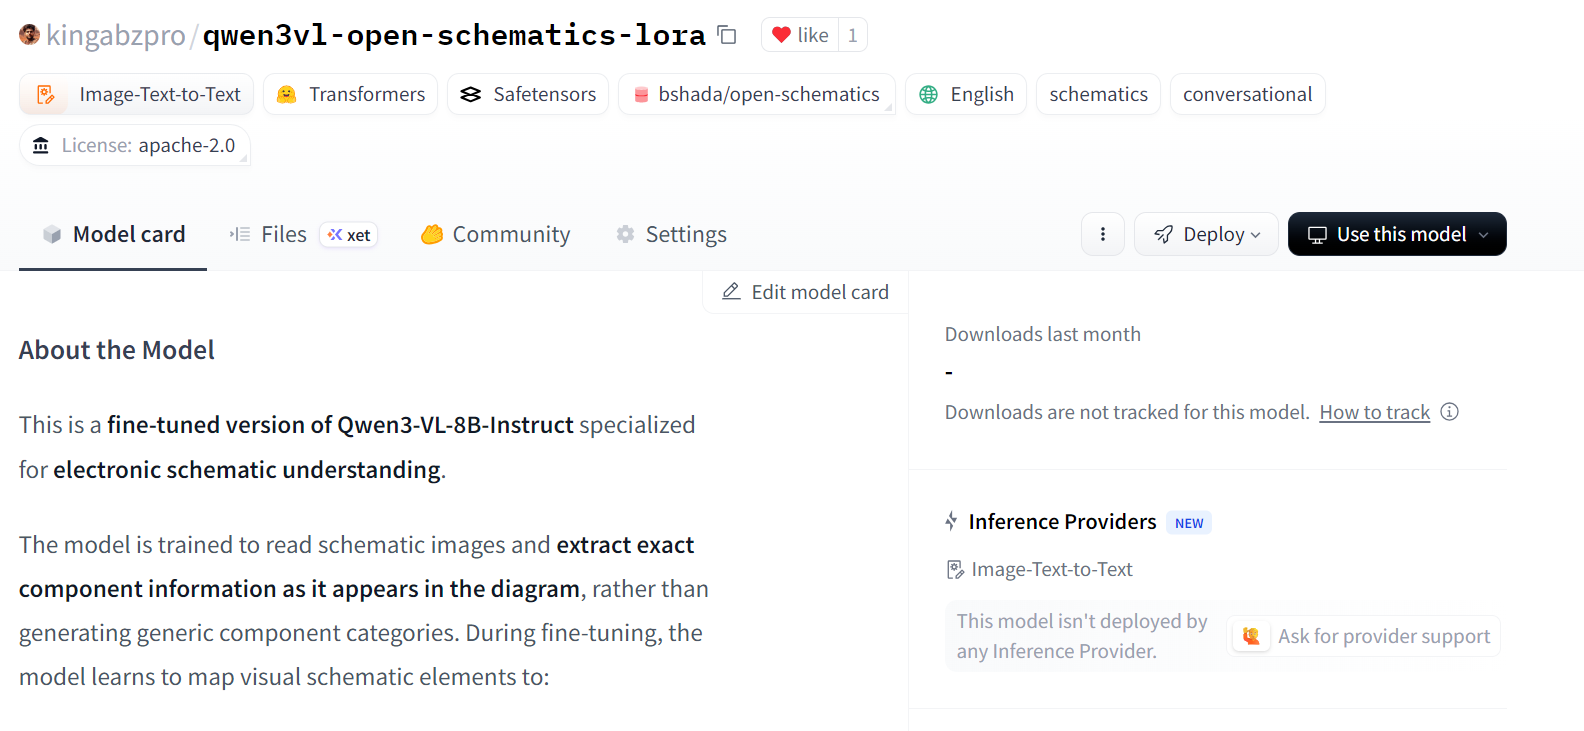
Qwen3‑VL‑8B Qwen श्रृंखला में सबसे शक्तिशाली और व्यापक रूप से उपयोग किया जाने वाला विज़न‑लैंग्वेज मॉडल है, जिसे पाठ, छवियों और वीडियो की एकीकृत समझ के लिए डिज़ाइन किया गया है।
यह टेक्स्ट जनरेशन, विज़ुअल रीजनिंग, स्पैटियल परसेप्शन, लंबे संदर्भ को संभालने और एजेंट इंटरेक्शन में बड़े सुधार देता है, जिससे यह एज और क्लाउड—दोनों वातावरणों में शोध और वास्तविक‑दुनिया परिनियोजन के लिए उपयुक्त बनता है।
इस ट्यूटोरियल में, हम फाइन‑ट्यून Qwen3‑VL‑8B‑Instruct को इलेक्ट्रॉनिक स्कीमैटिक डायग्राम्स पर करेंगे। स्कीमैटिक प्रतीकों, कनेक्शनों और स्थानिक संबंधों की व्याख्या करने के लिए मॉडल को प्रशिक्षित करके, हम इसे सर्किट डिज़ाइनों को सटीक रूप से समझने और यह निर्धारित करने में सक्षम बनाते हैं कि वास्तविक‑दुनिया के सर्किट में किन इलेक्ट्रॉनिक कॉम्पोनेंट्स को जोड़ा जाना चाहिए।
आप सीखेंगे कि कैसे:
यदि Hugging Face आपके लिए अभी नया है, तो Hugging Face Fundamentals स्किल ट्रैक आपके लिए है!
जब आप विज़न–लैंग्वेज मॉडल्स के साथ काम करते हैं, तो GPU मेमोरी एक महत्वपूर्ण बाधा बन जाती है। हाई‑रेज़ोल्यूशन इमेजेस और मल्टीमॉडल एन्कोडर्स VRAM को तेजी से खपा सकते हैं, इसलिए पर्याप्त मेमोरी वाले GPU का उपयोग करना दृढ़ता से अनुशंसित है।
इस ट्यूटोरियल के लिए, हम नवीनतम RunPod A100 (80GB) इंस्टेंस को PyTorch इमेज के साथ लॉन्च करेंगे। यह सेटअप ट्रेनिंग के लिए पर्याप्त VRAM हेडरूम प्रदान करता है और फाइन‑ट्यूनिंग के दौरान अनावश्यक मेमोरी बॉटलनेक्स से बचाता है।
नीचे Pod Template सेक्शन तक स्क्रॉल करें। यहाँ नवीनतम PyTorch इमेज चुनें। यहीं आप स्टोरेज सेटिंग्स समायोजित कर सकते हैं और एन्वायरनमेंट वेरिएबल्स जोड़ सकते हैं।
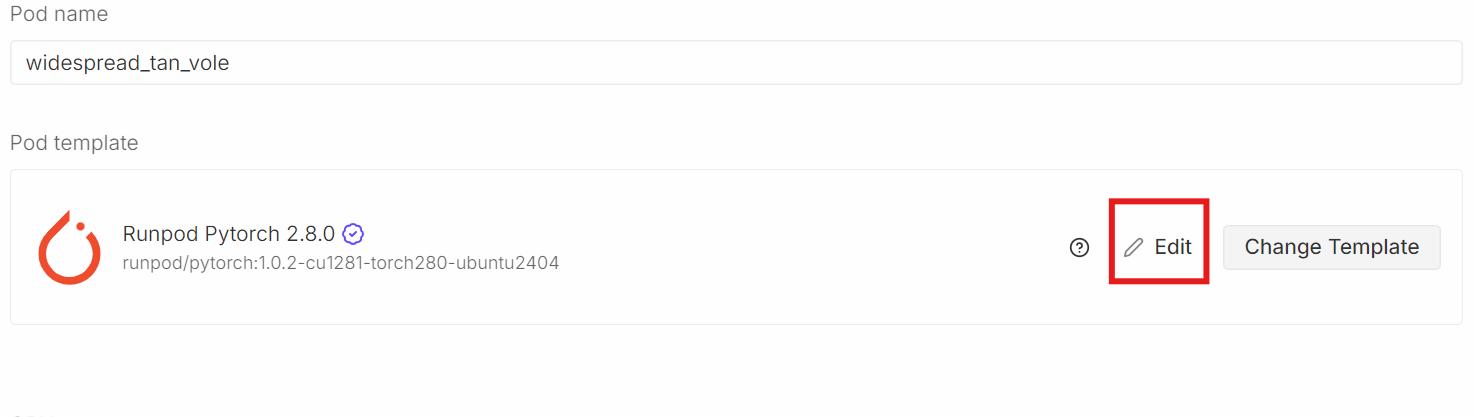
Edit पर क्लिक करें, फिर निम्न परिवर्तन करें:
HF_TOKEN जोड़ें और इसका मान अपने Hugging Face एक्सेस टोकन पर सेट करें (इसे Hugging Face Settings से जनरेट करें)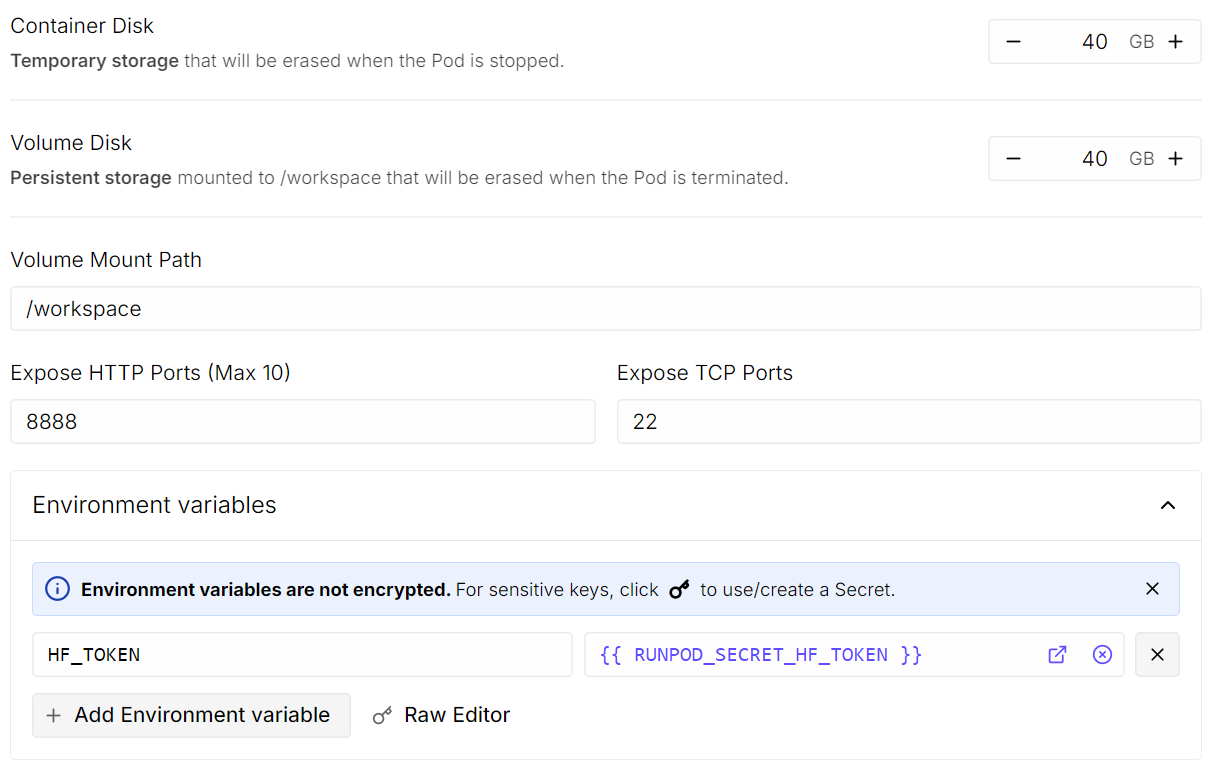
हो जाने के बाद, टेम्पलेट सेव करें और पॉड को डिप्लॉय करें।
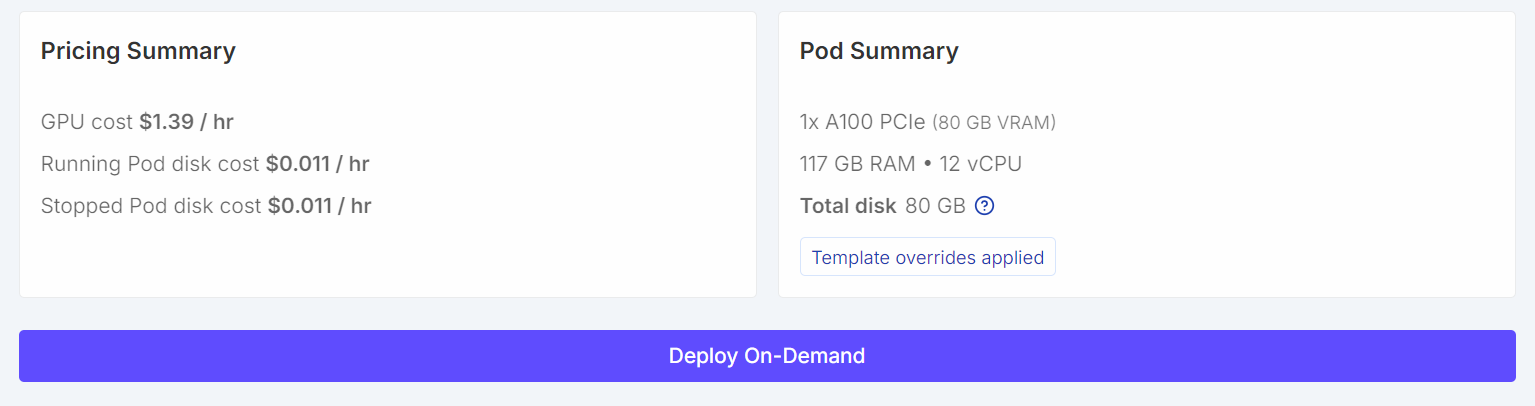
पॉड चलने के बाद:
निर्भरताएँ इंस्टॉल करने के लिए, निम्न कोड सेल चलाएँ। Jupyter में, शुरुआत में विस्मयादिबोधक चिह्न नोटबुक को बताता है कि पंक्ति को Python कोड के बजाय शेल कमांड के रूप में निष्पादित करें।
!pip -q install -U accelerate datasets pillow sentencepiece safetensors peft
!pip install --quiet "transformers==5.0.0rc1"
!pip install --quiet --no-deps trl
!pip install --no-cache-dir flash-attn --no-build-isolation
आगे, पुनरुत्पादनशीलता के लिए एक फिक्स्ड रैंडम सीड सेट करें और A100‑विशिष्ट परफॉर्मेंस ऑप्टिमाइज़ेशन सक्षम करें।
import torch
from transformers import set_seed

set_seed(42)

# A100: TF32 gives speedups without changing your bf16 training setup
torch.backends.cuda.matmul.allow_tf32 = True
torch.backends.cudnn.allow_tf32 = True

print("CUDA:", torch.cuda.is_available(), torch.cuda.get_device_name(0) if torch.cuda.is_available() else None)
print("bf16 supported:", torch.cuda.is_available() and torch.cuda.is_bf16_supported())
CUDA: True NVIDIA A100 80GB PCIe
bf16 supported: Trueअब हम Hugging Face Hub से Open Schematics डेटासेट लोड करेंगे। इस डेटासेट में प्रत्येक सर्किट का वर्णन करने वाले समृद्ध मेटाडेटा के साथ इलेक्ट्रॉनिक स्कीमैटिक इमेजेस शामिल हैं, जो इसे विज़न–लैंग्वेज ट्रेनिंग के लिए उपयुक्त बनाता है।
import torch
from datasets import load_dataset

DATASET_ID = "bshada/open-schematics"

ds_all = load_dataset(DATASET_ID, split="train")
print(ds_all)
Dataset({
features: ['schematic', 'image', 'components_used', 'json', 'yaml', 'name', 'description', 'type'],
num_rows: 84470
})डेटासेट में 84K+ सैंपल्स हैं, जिनमें प्रत्येक में स्कीमैटिक इमेज एक संरचित जानकारी के साथ जोड़ी गई है, जैसे कॉम्पोनेंट सूची और मशीन‑रीडेबल फॉर्मैट्स (JSON और YAML)।
डेटासेट संरचना को बेहतर समझने के लिए एक सिंगल सैंपल का निरीक्षण करते हैं।
# quick peek
ex = ds_all[0]
print("\nSample keys:", ex.keys())
print("name:", ex.get("name"))
print("type:", ex.get("type"))
print("components_used:", (ex.get("components_used") or [])[:10])
print("has schematic:", bool(ex.get("schematic")))
print("has json/yaml:", bool(ex.get("json")), bool(ex.get("yaml")))
print("image:", ex.get("image"))
Sample keys: dict_keys(['schematic', 'image', 'components_used', 'json', 'yaml', 'name', 'description', 'type'])
name: TiebeDeclercq/Uart-programmer
type: .kicad_sch
components_used: ['Conn_01x01_Pin', 'Conn_01x06_Pin', 'USB_A', 'Conn_02x05_Odd_Even', 'Conn_01x06_MountingPin', 'C', 'Fuse_Small', 'LED', 'R', 'CH340C']
has schematic: True
has json/yaml: True True
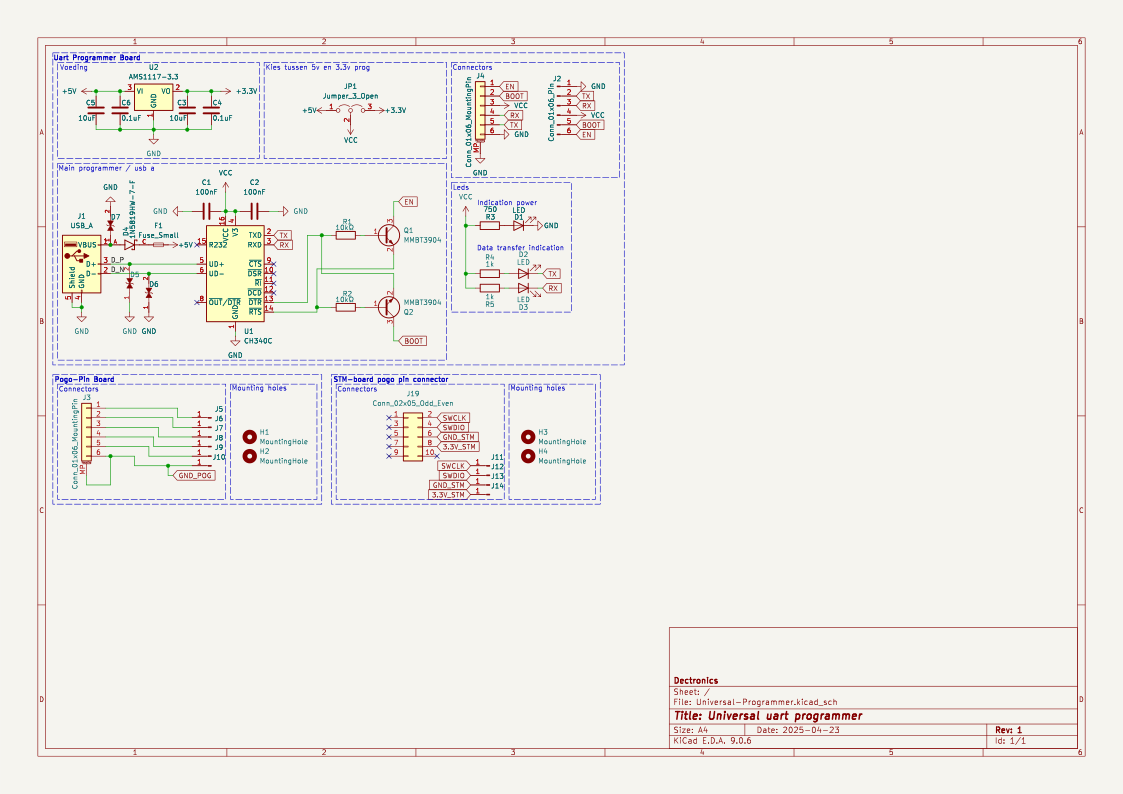
image: <PIL.PngImagePlugin.PngImageFile image mode=RGBA size=1123x794 at 0x7FBC6FD060F0>यह पुष्टि करता है कि प्रत्येक सैंपल में हाई‑रेज़ोल्यूशन स्कीमैटिक इमेज, कॉम्पोनेंट सूची और सर्किट के संरचित रिप्रेज़ेंटेशंस शामिल हैं।
अब हम Jupyter नोटबुक के अंदर सीधे स्कीमैटिक इमेज रेंडर कर सकते हैं।
ex.get("image")
अंत में, हम इस स्कीमैटिक में उपयोग किए गए कॉम्पोनेंट्स की पूरी सूची का निरीक्षण करते हैं।
print(ex.get("components_used"))['Conn_01x01_Pin', 'Conn_01x06_Pin', 'USB_A', 'Conn_02x05_Odd_Even', 'Conn_01x06_MountingPin', 'C', 'Fuse_Small', 'LED', 'R', 'CH340C', 'Jumper_3_Open', 'MountingHole', 'AMS1117-3.3', 'MMBT3904', '1N5819HW-7-F', 'LESD5D5.0CT1G', '+3.3V', '+5V', 'GND', 'VCC']यह कॉम्पोनेंट सूची स्कीमैटिक इमेज और सर्किट में मौजूद इलेक्ट्रॉनिक तत्वों के बीच स्पष्ट संबंध स्थापित करती है।
ट्रेनिंग से पहले, हम डेटासेट को साफ और फ़िल्टर करते हैं ताकि यह सुनिश्चित किया जा सके कि प्रत्येक सैंपल में विज़न–लैंग्वेज लर्निंग के लिए न्यूनतम आवश्यक जानकारी हो। विशेष रूप से, हम उन उदाहरणों को बनाए रखने पर ध्यान केंद्रित करते हैं जिनमें वैध कॉम्पोनेंट एनोटेशन और संबंधित स्कीमैटिक इमेज हो।
पहले, हम देखते हैं कि कितने सैंपल्स में components_used एंट्रीज़ गायब, खाली या अमान्य हैं।
need_cols = [c for c in ["components_used", "schematic", "name", "type"] if c in ds_all.column_names]
ds_small = ds_all.select_columns(need_cols)

missing_key = none_components = empty_components = missing_any = 0
has_schematic_but_missing = 0

for ex in ds_small:
    if "components_used" not in ex:
        missing_key += 1
        missing_any += 1
        if ex.get("schematic"):
            has_schematic_but_missing += 1
        continue

    cu = ex["components_used"]
    bad = (cu is None) or (isinstance(cu, list) and len(cu) == 0)

    if cu is None:
        none_components += 1
    elif isinstance(cu, list) and len(cu) == 0:
        empty_components += 1

    if bad:
        missing_any += 1
        if ex.get("schematic"):
            has_schematic_but_missing += 1

print("\n=== Missing components report ===")
print("Total:", len(ds_all))
print("Missing key:", missing_key)
print("None:", none_components)
print("Empty list:", empty_components)
print("Missing (any):", missing_any)
if "schematic" in need_cols:
    print("Has schematic but missing components:", has_schematic_but_missing)
=== Missing components report ===
Total: 84470
Missing key: 0
None: 47558
Empty list: 8
Missing (any): 47566
Has schematic but missing components: 47566नीचे दिया गया सारांश दिखाता है कि बड़ी संख्या में सैंपल्स में स्कीमैटिक डेटा तो है लेकिन उपयोगी कॉम्पोनेंट एनोटेशन नहीं हैं।
फ़िल्टरिंग के दौरान अनावश्यक मेमोरी उपयोग से बचने के लिए, हम स्पष्ट रूप से इमेज डिकोडिंग को अक्षम करते हैं। इससे फ़िल्टर लागू करते समय Hugging Face इमेजेस को मेमोरी में लोड नहीं करता।
from datasets.features import Image as HFImage
ds_all = ds_all.cast_column("image", HFImage(decode=False))
फिर हम एक फ़िल्टर परिभाषित करते हैं जो केवल उन सैंपल्स को रखता है जिनमें गैर‑खाली कॉम्पोनेंट सूची और वैध इमेज संदर्भ हो।
def keep_components_and_image(components_used, image):
    # keep only rows with components
    if not (isinstance(components_used, list) and len(components_used) > 0):
        return False

    # image must exist
    if image is None:
        return False

    # when decode=False, image is dict-like: {"path": ...} or {"bytes": ...}
    if isinstance(image, dict):
        return bool(image.get("path")) or bool(image.get("bytes"))

    return True
इस फ़िल्टर को लागू करने से डेटासेट काफी हद तक कम होकर उच्च‑गुणवत्ता, पूर्ण रूप से उपयोगी सैंपल्स तक सीमित हो जाता है।
ds_clean = ds_all.filter(
    keep_components_and_image,
    input_columns=["components_used", "image"],
)

print("Original:", len(ds_all))
print("Clean:", len(ds_clean))
print("Dropped:", len(ds_all) - len(ds_clean))
Original: 84470
Clean: 33275
Dropped: 51195फ़िल्टरिंग के बाद, हमारे पास 33K+ क्लीन सैंपल्स बचते हैं जिनमें वैध स्कीमैटिक इमेज और स्पष्ट कॉम्पोनेंट एनोटेशन—दोनों शामिल हैं। यह क्लीन किया हुआ डेटासेट आगे की प्रीप्रोसेसिंग और मॉडल ट्रेनिंग स्टेप्स के लिए एक विश्वसनीय आधार बनाता है।
अब हम Qwen3-VL-8B-Instruct मॉडल और उसके संबंधित प्रोसेसर को लोड करेंगे। यह एक बड़े पैमाने का विज़न–लैंग्वेज मॉडल है जो इमेज और टेक्स्ट पर संयुक्त रूप से तर्क कर सकता है, जिससे यह स्कीमैटिक समझ कार्यों के लिए उपयुक्त बनता है।
मॉडल को bfloat16 प्रिसीजन में लोड किया जाता है ताकि मेमोरी उपयोग कम हो जबकि संख्यात्मक स्थिरता बनी रहे। हम A100 GPU पर तेज़ और अधिक मेमोरी‑कुशल अटेंशन के लिए Flash Attention 2 भी सक्षम करते हैं। device_map="auto" विकल्प उपलब्ध GPU पर मॉडल लेयर्स को स्वतः प्लेस करता है।
from transformers import Qwen3VLForConditionalGeneration, AutoProcessor

MODEL_ID = "Qwen/Qwen3-VL-8B-Instruct"

model = Qwen3VLForConditionalGeneration.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="flash_attention_2",
)
processor = AutoProcessor.from_pretrained(MODEL_ID)यह चरण विज़न–लैंग्वेज ट्रेनिंग के लिए प्रॉम्प्ट, टार्गेट और इमेज तैयार करने हेतु हल्के यूटिलिटीज़ परिभाषित करता है। एक ही पाइपलाइन को TASK वेरिएबल (components, YAML, JSON, या स्कीमैटिक रिकंस्ट्रक्शन) बदलकर कई कार्यों के लिए उपयोग किया जाता है।
लक्ष्य की लंबाई और इमेज साइज को नियंत्रित करने के लिए बेसिक सेफ़्टी लिमिट्स लागू किए जाते हैं, जो ट्रेनिंग को स्थिर और मेमोरी‑कुशल बनाए रखने में मदद करते हैं।
from PIL import Image


TASK = "components"  # "components" | "yaml" | "json" | "schematic"
MAX_TARGET_CHARS = 5000  # safety cap for long targets like schematic/json
MAX_IMAGE_SIDE = 1024          # bigger side
MAX_IMAGE_PIXELS = 1024 * 1024 # safety cap (1.0 MP). raise to 1.5MP if stablebuild_prompt() फ़ंक्शन मॉडल को पास किए जाने वाले इंस्ट्रक्शन टेक्स्ट का निर्माण करता है। यह संदर्भ के लिए डेटासेट मेटाडेटा का उपयोग करता है और कड़े आउटपुट नियम लागू करता है ताकि भ्रम (हैलुसिनेशन) कम हो और सभी कार्यों में सुपरविजन एकसमान रहे।
def build_prompt(example):
    # Use dataset fields to give better context (name/type are helpful)
    name = example.get("name") or "Unknown project"
    ftype = example.get("type") or "unknown format"

    if TASK == "components":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, extract all component labels and identifiers exactly as shown "
            "(part numbers, values, footprints, net labels like +5V/GND).\n"
            "Output only a comma-separated list. Do not generalize or add extra text."
        )

    if TASK == "yaml":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, produce YAML metadata for the design.\n"
            "Return valid YAML only. No markdown, no explanations."
        )

    if TASK == "json":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, produce a JSON representation of the schematic structure.\n"
            "Return valid JSON only. No markdown, no explanations."
        )

    if TASK == "schematic":
        return (
            f"Project: {name}\nFormat: {ftype}\n"
            "From the schematic image, reconstruct the raw KiCad schematic content.\n"
            "Return only the schematic text. No markdown, no explanations."
        )

raise ValueError("Unknown TASK")build_target() फ़ंक्शन चयनित कार्य के लिए ग्राउंड‑ट्रुथ आउटपुट सीधे डेटासेट से निकालता है। सामग्री को हूबहू लौटाया जाता है ताकि मॉडल पैराफ्रेज़िंग के बजाय सटीक पुनरुत्पादन पर प्रशिक्षित हो।
def build_target(example):
    if TASK == "components":
        comps = example.get("components_used") or []
        return ", ".join(comps)

    if TASK == "yaml":
        return (example.get("yaml") or "").strip()

    if TASK == "json":
        return (example.get("json") or "").strip()

    if TASK == "schematic":
        return (example.get("schematic") or "").strip()

    raise ValueError("Unknown TASK")
clamp_text() फ़ंक्शन लक्ष्यों पर एक सख्त कैरेक्टर लिमिट लागू करता है। यह ट्रेनिंग के दौरान ओवरसाइज़्ड JSON, YAML या स्कीमैटिक फाइलों से होने वाली मेमोरी समस्याओं को रोकता है।
def clamp_text(s: str, max_chars: int = MAX_TARGET_CHARS) -> str:
    s = (s or "").strip()
return s if len(s) <= max_chars else s[:max_chars].rstrip()_resize_pil() फ़ंक्शन प्रोसेसिंग से पहले स्कीमैटिक इमेजेस को सामान्यीकृत और री‑साइज़ करता है। यह अधिकतम साइड लंबाई और अधिकतम कुल पिक्सेल काउंट—दोनों लागू करता है, ताकि GPU मेमोरी उपयोग अनुमानित रहे और दृश्य विवरण संरक्षित रहें।
def _resize_pil(pil: Image.Image, max_side: int = MAX_IMAGE_SIDE, max_pixels: int = MAX_IMAGE_PIXELS) -> Image.Image:
    pil = pil.convert("RGB")
    w, h = pil.size

    # Scale down if max side too large
    scale_side = min(1.0, max_side / float(max(w, h)))

    # Scale down if too many pixels (area cap)
    scale_area = (max_pixels / float(w * h)) ** 0.5 if (w * h) > max_pixels else 1.0

    scale = min(scale_side, scale_area)

    if scale < 1.0:
        nw, nh = max(1, int(w * scale)), max(1, int(h * scale))
        pil = pil.resize((nw, nh), resample=Image.BICUBIC)

return pilइस चरण में, हम प्रत्येक क्लीन किए गए डेटासेट सैंपल को मल्टीमॉडल चैट‑स्टाइल फॉर्मैट में बदलते हैं, जिसे Qwen विज़न–लैंग्वेज मॉडल सीधे कंज्यूम कर सकता है। यह फॉर्मैट स्कीमैटिक इमेज को स्पष्ट रूप से एक टेक्स्ट इंस्ट्रक्शन और उसके संबंधित टार्गेट आउटपुट के साथ संरेखित करता है।
def to_messages(example):
    prompt = build_prompt(example)
    target = clamp_text(build_target(example))

    example["messages"] = [
        {
            "role": "user",
            "content": [
                {"type": "image"},
                {"type": "text", "text": prompt},
            ],
        },
        {
            "role": "assistant",
            "content": [{"type": "text", "text": target}],
        },
    ]
    return example
हम ऑर्डरिंग बायस हटाने के लिए डेटासेट को शफ़ल करते हैं और शुरुआती प्रयोगों के लिए एक छोटा सबसेट चुनते हैं।
इसके बाद, डेटासेट को to_messages() के माध्यम से मैप किया जाता है ताकि मल्टीमॉडल ट्रेनिंग उदाहरण जनरेट हों। अंततः, इमेज डिकोडिंग को फिर से सक्षम किया जाता है, ताकि इमेजेस केवल ट्रेनिंग समय पर लोड हों—प्रीप्रोसेसिंग को हल्का और मेमोरी‑कुशल रखते हुए।
# Start small (increase later)
train_ds = ds_clean.shuffle(seed=42).select(range(min(800, len(ds_clean)))).map(to_messages)
train_ds = train_ds.cast_column("image", HFImage(decode=True))फाइन‑ट्यूनिंग से पहले, हम अपने कार्य पर आउट‑ऑफ‑द‑बॉक्स Qwen3‑VL 8B Instruct मॉडल का प्रदर्शन मूल्यांकित करते हैं। यह बेसलाइन हमें समझने में मदद करती है कि कोई भी टास्क‑स्पेसिफिक एडॉप्टेशन किए बिना प्रीट्रेंड मॉडल स्कीमैटिक इमेजेस से जानकारी कितनी अच्छी तरह निकाल सकता है।
run_inference() फ़ंक्शन एक उदाहरण पर उसी प्रॉम्प्टिंग और इमेज प्रीप्रोसेसिंग लॉजिक का उपयोग करके एक सिंगल फ़ॉरवर्ड पास करता है, जिसका उपयोग बाद में ट्रेनिंग के दौरान किया जाएगा।
import torch

def run_inference(model_, example, max_new_tokens=256):
    prompt = build_prompt(example)

    messages = [
        {
            "role": "user",
            "content": [
                {"type": "image", "image": _resize_pil(example["image"])},
                {"type": "text", "text": prompt},
            ],
        }
    ]

    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(model_.device)

    with torch.inference_mode():
        out = model_.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)

    gen = out[0][inputs["input_ids"].shape[1]:]
    return processor.decode(gen, skip_special_tokens=True)

baseline_ex = train_ds.shuffle(seed=120).select(range(1))[0]
हम पहले ट्रेनिंग सेट से यादृच्छिक रूप से चुने गए सैंपल पर मॉडल का मूल्यांकन करते हैं।
print("\n--- BASELINE OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- BASELINE OUTPUT ---
J1,Conn_02x11_Odd_Even,CINT6,CINT5,CINT4,CINT3,CINT2,CINT1,CINT0,CINT15,CINT14,CINT13,CINT12,CINT11,CINT10,CINT9,CINT8,CINT7,CINT16,CINT17,CINT18,CINT19,CINT20,CINT21,CINT22,CINT23,CINT24,CINT25,CINT26,CINT27,CINT28,CINT29,CINT30,CINT31,CINT32,CINT33,CINT34,CINT35,CINT36,CINT37,CINT38,CINT39,CINT40,CINT41,CINT42,CINT43,CINT44,CINT45,CINT46,CINT47,CINT48,CINT49,CINT50,CINT51,CINT52,CINT53,CINT54,CINT55,CINT56,CINT57,CINT58,CINT59,CINT60,CINT61,CINT62
--- TARGET (dataset) ---
Conn_02x11_Odd_Even, R_Pack04, GNDइस उदाहरण में, मॉडल कुछ संरचनात्मक तत्वों की सही पहचान करता है, लेकिन पिन और सिग्नल नामों का अधिक उत्पादन कर देता है, जबकि डेटासेट में उपयोग किए गए सटीक कॉम्पोनेंट आइडेंटिफायर्स को पुनर्प्राप्त करने में विफल रहता है। मैंने अधिक उदाहरणों का मूल्यांकन करते समय इसी पैटर्न को देखा।
कुल मिलाकर, ये बेसलाइन परिणाम दर्शाते हैं कि यद्यपि मॉडल में मजबूत सामान्य दृश्य और पाठ्य समझ है, यह डेटासेट‑विशिष्ट कॉम्पोनेंट एनोटेशन के साथ संरेखण की कमी रखता है। यह व्यवहार फाइन‑ट्यूनिंग की आवश्यकता को रेखांकित करता है ताकि भ्रमित आउटपुट कम हों और शुद्धता में सुधार हो।
यह सेक्शन एक कस्टम डेटा कोलेटेर परिभाषित करता है जो ट्रेनिंग के लिए मल्टीमॉडल चैट‑स्टाइल बैच तैयार करता है। यह प्रत्येक उदाहरण को टेक्स्ट और इमेज—दोनों को संयुक्त रूप से एन्कोड करके मॉडल‑रेडी टेन्सर्स में बदल देता है, जबकि यह सुनिश्चित करता है कि लॉस केवल असिस्टेंट के उत्तर पर ही गणना हो।
कोलेटेर चैट टेक्स्ट के दो संस्करण बनाता है: एक फुल संस्करण (प्रॉम्प्ट और टार्गेट) इनपुट एन्कोडिंग के लिए, और एक केवल प्रॉम्प्ट‑वाला संस्करण प्रॉम्प्ट टोकन लंबाई की गणना के लिए। इन लंबाइयों का उपयोग करते हुए, सभी प्रॉम्प्ट और पैडिंग टोकन लेबल्स में मास्क कर दिए जाते हैं, ताकि केवल असिस्टेंट आउटपुट लॉस में योगदान दे। इमेजेस का आकार सुसंगत रूप से बदला जाता है, और मेमोरी नियंत्रण के लिए एक फिक्स्ड अधिकतम सीक्वेंस लंबाई लागू की जाती है।
from typing import List, Dict, Any
import torch

MAX_LEN = 1500

def collate_fn(batch: List[Dict[str, Any]]):
    # 1) Build full chat text (includes assistant answer)
    full_texts = [
        processor.apply_chat_template(
            ex["messages"],
            tokenize=False,
            add_generation_prompt=False,
        )
        for ex in batch
    ]

    # 2) Build prompt-only text (up to user turn; generation prompt on)
    prompt_texts = [
        processor.apply_chat_template(
            ex["messages"][:-1],
            tokenize=False,
            add_generation_prompt=True,
        )
        for ex in batch
    ]

    # 3) Images
    images = [_resize_pil(ex["image"]) for ex in batch]

    # 4) Tokenize full inputs ONCE (text + images)
    enc = processor(
        text=full_texts,
        images=images,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=MAX_LEN,
    )

    input_ids = enc["input_ids"]
    pad_id = processor.tokenizer.pad_token_id

    # 5) Compute prompt lengths with TEXT-ONLY tokenization (much cheaper than text+images)
    prompt_ids = processor.tokenizer(
        prompt_texts,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=MAX_LEN,
        add_special_tokens=False,  # chat template already includes special tokens
    )["input_ids"]

    # Count non-pad tokens in prompt
    prompt_lens = (prompt_ids != pad_id).sum(dim=1)

    # 6) Labels: copy + mask prompt tokens + mask padding
    labels = input_ids.clone()
    bs, seqlen = labels.shape

    for i in range(bs):
        pl = int(prompt_lens[i].item())
        pl = min(pl, seqlen)
        labels[i, :pl] = -100

    # Mask padding positions too
    labels[labels == pad_id] = -100

    # If your processor produces pixel_values / image_grid_thw, keep them
    enc["labels"] = labels
    return enc
यह कोलेटेर विज़न–लैंग्वेज फाइन‑ट्यूनिंग के लिए कुशल और सही सुपरविजन सक्षम करता है।
अब हम LoRA (Low‑Rank Adaptation) कॉन्फ़िगर करेंगे ताकि पूरे मॉडल वज़नों को अपडेट किए बिना Qwen3‑VL मॉडल को कुशलतापूर्वक फाइन‑ट्यून किया जा सके। LoRA चयनित प्रोजेक्शन लेयर्स में ट्रेन करने योग्य लो‑रैंक मैट्रिसिस इंजेक्ट करता है, जिससे प्रदर्शन बनाए रखते हुए मेमोरी उपयोग में उल्लेखनीय कमी आती है।
from peft import LoraConfig, TaskType, get_peft_model

lora = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type=TaskType.CAUSAL_LM,
    target_modules=[
        "q_proj","k_proj","v_proj","o_proj",
        "gate_proj","up_proj","down_proj"
    ],
)
इसके बाद, हम SFTConfig का उपयोग करते हुए ट्रेनिंग कॉन्फ़िगरेशन परिभाषित करते हैं, जो A100 GPU पर स्थिर फाइन‑ट्यूनिंग के लिए उपयुक्त बैच साइज, लर्निंग रेट, प्रिसीजन और लॉगिंग विकल्प सेट करता है।
from trl import SFTTrainer, SFTConfig

args = SFTConfig(
    output_dir=f"qwen3vl-open-schematics-{TASK}-lora",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=4,
    gradient_checkpointing=False,
    learning_rate=1e-4,
    warmup_steps=10,
    weight_decay=0.01,
    max_grad_norm=1.0,
    bf16=True,
    fp16=False,
    lr_scheduler_type="cosine",
    logging_steps=10,
    report_to="none",
    remove_unused_columns=False,
)
अंत में, हम SFTTrainer इनिशियलाइज़ करते हैं, जिसमें मॉडल, डेटासेट, कस्टम कोलेटेर और LoRA कॉन्फ़िगरेशन को संयोजित करके सुपरवाइज़्ड फाइन‑ट्यूनिंग शुरू की जाती है।
trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=train_ds,
    data_collator=collate_fn,
    peft_config=lora
)अब हम कॉन्फ़िगर किए गए ट्रेनर का उपयोग करके फाइन‑ट्यूनिंग प्रक्रिया शुरू करते हैं।
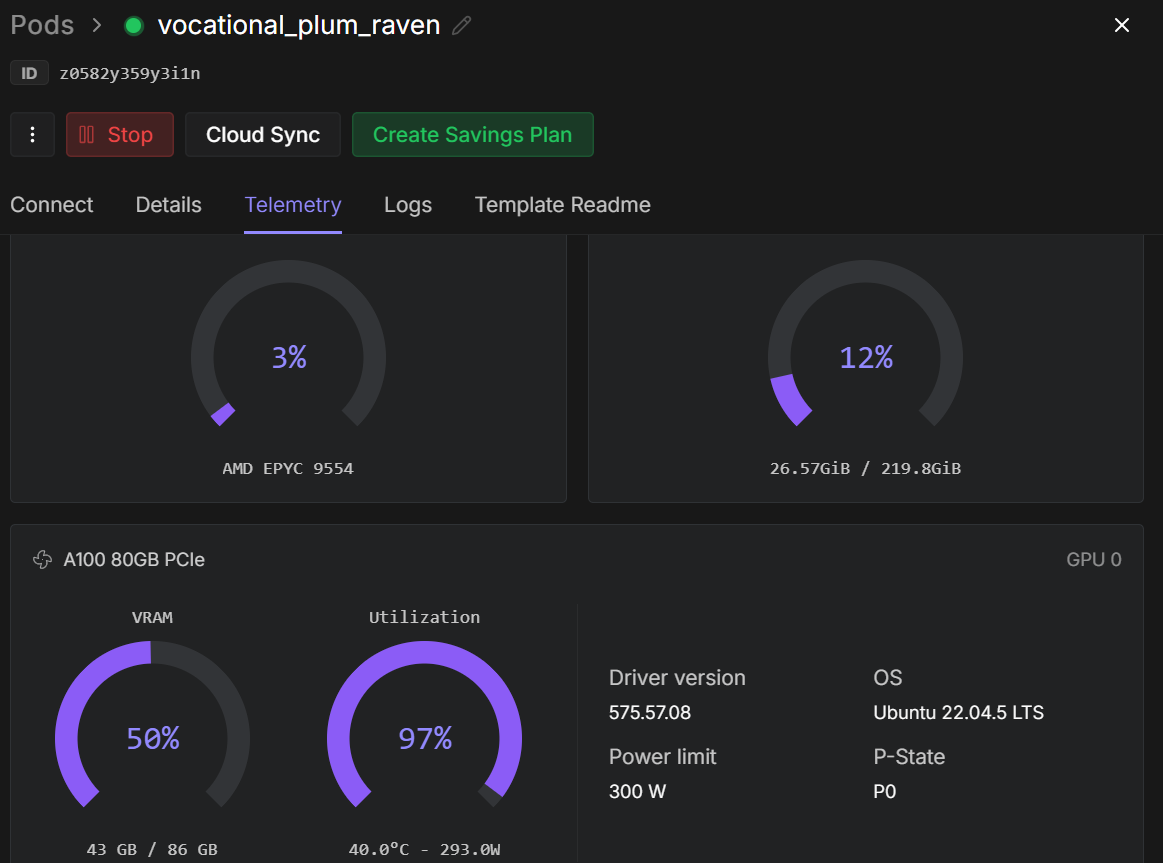
trainer.train()ट्रेनिंग शुरू होने के बाद, आप RunPod टेलीमेट्री डैशबोर्ड की मॉनिटरिंग कर सकते हैं। A100 80GB इंस्टेंस पर, यह प्रक्रिया आमतौर पर लगभग 40–45 GB VRAM का उपयोग करती है और लगभग पूर्ण GPU उपयोग तक पहुँचती है, जो कुशल हार्डवेयर उपयोग का संकेत देता है।
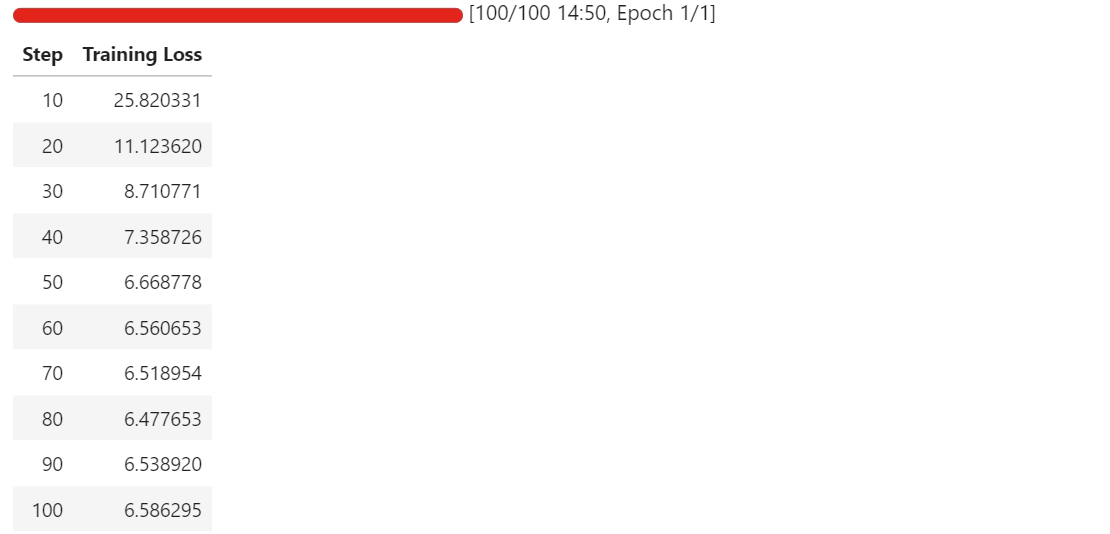
ट्रेनिंग के दौरान, आपको देखना चाहिए कि ट्रेनिंग लॉस स्थिर होने से पहले लगातार घटती है। हमारे मामले में, लॉस लगभग 6.5 पर अभिसरित होकर प्लेटो पर पहुँचता है, जो यह दर्शाने के लिए एक बेसलाइन संकेतक है कि मॉडल ने स्कीमैटिक कॉम्पोनेंट एक्सट्रैक्शन टास्क के अनुरूप अनुकूलन कर लिया है।
इस बिंदु पर, LoRA अडैप्टर्स सफलतापूर्वक फाइन‑ट्यून हो चुके हैं और मूल्यांकन तथा एक्सपोर्ट के लिए तैयार हैं।
फाइन‑ट्यूनिंग पूर्ण होने के बाद, हम सबसे पहले प्रशिक्षित LoRA अडैप्टर्स और संबंधित प्रोसेसर को लोकली सेव करते हैं।
out_dir = trainer.args.output_dir  # from your SFTConfig/TrainingArguments

trainer.save_model(out_dir)  # saves model/adapters into output_dir
processor.save_pretrained(out_dir)  # save processor (tokenizer + image processor)
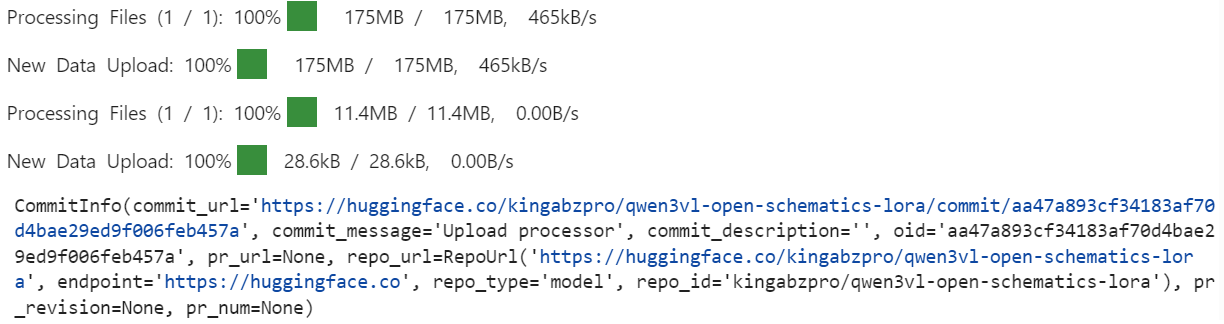
इसके बाद, हम फाइन‑ट्यून किए गए मॉडल को Hugging Face Hub पर प्रकाशित करते हैं। इससे अडैप्टर्स और प्रोसेसर को इन्फ्रेंस या आगे की फाइन‑ट्यूनिंग के लिए पुनः उपयोग किया जा सकता है।
import os

repo_id = "kingabzpro/qwen3vl-open-schematics-lora" # replace with your username/repo

# Push model/adapters
trainer.model.push_to_hub(
    repo_id,
    token=os.getenv("HF_TOKEN"),
)

# Push processor
processor.push_to_hub(
    repo_id,
    token=os.getenv("HF_TOKEN"),
)
अपलोड पूरा होने पर, फाइन‑ट्यून किए गए LoRA अडैप्टर्स और प्रोसेसर निर्दिष्ट रिपोजिटरी में सार्वजनिक रूप से उपलब्ध हो जाते हैं।
फाइन‑ट्यूनिंग के बाद, हम मॉडल और प्रोसेसर को सीधे Hugging Face Hub से रीलोड करते हैं। यह सुनिश्चित करता है कि मूल्यांकन एक्सपोर्ट किए गए LoRA अडैप्टर्स के साथ ही किया जाए, ठीक उसी तरह जैसे वास्तविक इन्फ्रेंस सेटिंग में उपयोग होगा।
model = Qwen3VLForConditionalGeneration.from_pretrained(
    repo_id,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="flash_attention_2",
)
processor = AutoProcessor.from_pretrained(repo_id)
```
We now repeat the same inference procedure used during the baseline evaluation, allowing for a direct comparison between pre-fine-tuning and post-fine-tuning behavior.
```python
baseline_ex = train_ds.shuffle(seed=120).select(range(1))[0]
print("\n--- FINETUNED OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- FINETUNED OUTPUT ---
Conn_02x11_0dd_Even, P3.3V
--- TARGET (dataset) ---
Conn_02x11_Odd_Even, R_Pack04, GNDबेसलाइन की तुलना में, फाइन‑ट्यून किया गया मॉडल बहुत छोटा और अधिक केंद्रित आउटपुट देता है, पिन नामों और अनुमानित सिग्नलों के बड़े‑पैमाने पर ओवर‑जनरेशन से बचता है।
यद्यपि भविष्यवाणी अभी भी अधूरी है और इसमें छोटे‑मोटे त्रुटियाँ हैं, यह डेटासेट‑संरेखित कॉम्पोनेंट आइडेंटिफायर्स की ओर स्पष्ट रूप से आगे बढ़ती हुई दिखती है।
हम इस व्यवहार की पुष्टि के लिए अब दूसरा उदाहरण मूल्यांकित करेंगे।
baseline_ex = train_ds.shuffle(seed=170).select(range(1))[0]
print("\n--- FINETUNED OUTPUT ---\n", run_inference(model, baseline_ex))
print("\n--- TARGET (dataset) ---\n", clamp_text(build_target(baseline_ex), 1500))
--- FINETUNED OUTPUT ---
ATMEGA328P-PU, +5V, GND, R, C, C16MHz, SERVO_A, SERVO_B, SERVO_C, SERVO_D, SERVO_E, SERVO_F, SERVO_G
--- TARGET (dataset) ---
+5V, 7.62MM-3P, 7.62MM-3P_1, 7.62MM-3P_2, 7.62MM-3P_3, 7.62MM-3P_4, 7.62MM-3P_5, 7.62MM-3P_6, ATMEGA328P-PU, ATMEGA328P-PU_1, GND, MBB02070C1002FCT00, MBB02070C1002FCT00_1, Unknown_0_-806, X49SD16MSD2SC, Y5P102K2KV16CC0224, Y5P102K2KV16CC0224_1, Y5P102K2KV16CC0224_2यहाँ, फाइन‑ट्यून किया गया मॉडल माइक्रोकंट्रोलर और पावर नेट्स जैसे मुख्य कॉम्पोनेंट्स की सही पहचान करता है, और अप्रासंगिक सिग्नल‑लेवल हैलुसिनेशंस को काफी हद तक कम करता है। हालाँकि, यह अभी भी कुछ कॉम्पोनेंट्स को सामान्यीकृत करता है या उन्हें डेटासेट‑विशिष्ट आइडेंटिफायर्स के बजाय एब्स्ट्रैक्ट रूप में प्रस्तुत करता है।
समग्र रूप से, ये परिणाम दर्शाते हैं कि फाइन‑ट्यूनिंग ओवर‑जनरेशन को सफलतापूर्वक दबाती है और स्कीमैटिक‑स्तरीय कॉम्पोनेंट एक्सट्रैक्शन के साथ संरेखण में सुधार करती है। यद्यपि अतिरिक्त एपॉक्स, बड़े ट्रेनिंग सेट या सख्त आउटपुट प्रतिबंधों के साथ सटीकता को और बेहतर किया जा सकता है, पोस्ट‑फाइन‑ट्यूनिंग व्यवहार बेसलाइन पर स्पष्ट और मापने योग्य सुधार प्रस्तुत करता है।
यदि आपको इस ट्यूटोरियल का कोड चलाने में कोई समस्या आती है, तो कृपया साथ वाली नोटबुक देखें।
विज़न–लैंग्वेज मॉडल बुनियादी रूप से केवल‑टेक्स्ट मॉडल से अलग होते हैं, और उन्हें समान तरीके से ट्रीट करना लगभग हमेशा खराब परिणाम देता है।
यदि आप सावधान नहीं हैं, तो बैच साइज एक होने पर भी आउट‑ऑफ‑मेमोरी त्रुटियों का सामना करना बहुत आसान है, या ऐसे मॉडल को फाइन‑ट्यून करना जो ट्रेन तो होता दिखता है लेकिन वास्तव में टास्क सीखने में असफल रहता है। मैंने यह बात कठिन तरीके से सीखी।
अंततः अंतर उसी चीज़ों पर ध्यान देने से आया जो विशेष रूप से मल्टीमॉडल ट्रेनिंग के लिए मायने रखती हैं।
इमेजेस को सुरक्षित सीमा तक री‑साइज़ करना, टूटे या अनुपयोगी सैंपल्स को हटाने के लिए डेटासेट की सफाई करना, और यह सुनिश्चित करना कि केवल वैध इमेज–टेक्स्ट जोड़े ही मॉडल को पास हों—ये सभी आवश्यक कदम हैं। इनमें से किसी को भी छोड़ना जल्दी ही अस्थिरता या बेकार कम्प्यूट तक ले जाता है।
मॉडलिंग पक्ष में, केवल प्रासंगिक LoRA टार्गेट लेयर्स का उपयोग करने से ट्रेनिंग कुशल और फोकस्ड रही, जबकि ट्रेनिंग आर्ग्युमेंट्स की सावधानीपूर्वक ट्यूनिंग से मेमोरी प्रेशर बढ़ाए बिना कन्वर्जेन्स में सुधार हुआ।
A100 GPU के लिए ऑप्टिमाइज़ करना, Flash Attention सक्षम करना और bfloat16 का उपयोग करना—इनसे ट्रेनिंग स्थिर रही और रनटाइम में उल्लेखनीय कमी आई। व्यवहार में, इन ऑप्टिमाइज़ेशंस ने गुणवत्ता से समझौता किए बिना ट्रेनिंग समय को लगभग आधा कर दिया।
अंतिम परिणाम दिखाते हैं कि एक मजबूत प्रीट्रेंड विज़न–लैंग्वेज मॉडल भी डोमेन‑विशिष्ट फाइन‑ट्यूनिंग से बहुत लाभान्वित होता है। सही प्रीप्रोसेसिंग, कॉन्फ़िगरेशन और हार्डवेयर‑अवेयर ऑप्टिमाइज़ेशंस के साथ, बड़े मल्टीमॉडल मॉडल्स को विश्वसनीय और कुशलता से अनुकूलित करना संभव है।
यदि आप फाइन‑ट्यूनिंग का और अभ्यास करना चाहते हैं, तो मैं Fine-Tuning with Llama 3 कोर्स लेने की सिफारिश करता/करती हूँ।
LLM Courses
कोर्स
लर्निंग पाथ
कोर्स