Hypothesetoetsing is een belangrijk onderdeel van de statistiek dat je helpt weloverwogen beslissingen te nemen in allerlei vakgebieden — van geneeskunde tot economie en sociale wetenschappen. Deze gids loodst je door de kernbegrippen, typen, stappen en toepassingen in de praktijk van hypothesetoetsing, zodat je je statistische bevindingen vol vertrouwen kunt interpreteren en presenteren.
Klaar om meer te leren over hypothesetoetsing? Kies de cursus die past bij jouw favoriete technologie: Hypothesis Testing in Python, Hypothesis Testing in R of Introduction to Statistics in Google Sheets. Volg ook onze technologie-agnostische cursus Introduction to Statistics.
Wat is hypothesetoetsing?
Hypothesetoetsing is een statistische procedure om aannames of hypothesen over een populatieparameter te toetsen. Je formuleert een nulhypothese (H0) en een alternatieve hypothese (Ha), verzamelt gegevens en bepaalt of het bewijs sterk genoeg is om de nulhypothese te verwerpen.
Het primaire doel van hypothesetoetsing is om op basis van een steekproef uitspraken te doen over een populatie. Het stelt onderzoekers en analisten in staat om te kwantificeren hoe waarschijnlijk het is dat waargenomen verschillen of relaties in de data op toeval berusten in plaats van een werkelijk effect in de populatie te weerspiegelen.
Stappen van hypothesetoetsing
Laten we stap voor stap door een hypothesetoets lopen.
Zet je onderzoeksvraag om in twee concurrerende hypothesen:
- Nulhypothese (H0): De standaardaanname dat er geen effect of verschil is.
- Alternatieve hypothese (Ha): De hypothese dat er wel een effect of verschil is.
Bijvoorbeeld:
- H0: De gemiddelde lengte van mannen is gelijk aan die van vrouwen.
- Ha: De gemiddelde lengte van mannen is niet gelijk aan die van vrouwen.
Stap 2: Verzamel en prepareer data
Verzamel gegevens via experimenten, enquêtes of observationele studies. Zorg dat de methode is ontworpen om de hypothese te toetsen en representatief is voor de populatie. Deze stap omvat vaak:
- De populatie van interesse definiëren.
- Een passende steekproefmethode kiezen.
- De steekproefgrootte bepalen.
- De data verzamelen en ordenen.
Stap 3: Kies de juiste statistische toets
Kies een statistische toets op basis van het type data en de hypothese. De keuze hangt af van factoren zoals:
- Datatype (continu, categorisch, enz.)
- Verdeling van de data (normaal, niet-normaal)
- Steekproefgrootte
- Aantal te vergelijken groepen
Veelgebruikte toetsen zijn onder andere:
Stap 4: Bereken de toetsstatistiek en p-waarde
Gebruik statistische software of formules om de toetsstatistiek en bijbehorende p-waarde te berekenen. Deze stap kwantificeert hoe sterk de steekproefdata afwijkt van de nulhypothese.
De p-waarde is een belangrijk concept in hypothesetoetsing. Ze geeft de kans weer om resultaten te observeren die net zo extreem zijn als in de steekproef, uitgaande van een ware nulhypothese.
Stap 5: Neem een beslissing
Vergelijk de p-waarde met het vooraf bepaalde significantieniveau (α), doorgaans 0,05. De beslisregel is als volgt:
- Als p-waarde ≤ α: Verwerp de nulhypothese; er is aanwijzing voor de alternatieve hypothese.
- Als p-waarde > α: Verwerp de nulhypothese niet; er is onvoldoende bewijs voor de alternatieve hypothese.
Belangrijk: het niet verwerpen van de nulhypothese bewijst niet dat die waar is; het betekent alleen dat er onvoldoende bewijs is om het tegendeel te concluderen.
Stap 6: Presenteer je bevindingen
Rapporteer de resultaten, inclusief de toetsstatistiek, p-waarde en conclusie. Bespreek of de bevindingen de initiële hypothese ondersteunen en wat de implicaties zijn. Houd bij het presenteren rekening met:
- Context geven voor het onderzoek.
- De hypothesen duidelijk formuleren.
- De toetsstatistiek en p-waarde rapporteren.
- De resultaten in begrijpelijke taal interpreteren.
- De praktische relevantie van de bevindingen bespreken.
Typen hypothesetoetsen
Hypothesetoetsen zijn grofweg in twee hoofdtypen te verdelen:
Parametrische toetsen
Parametrische toetsen gaan ervan uit dat de data een specifieke kansverdeling volgt, meestal de normale verdeling. Deze toetsen zijn over het algemeen krachtiger als aan de aannames wordt voldaan. Veelgebruikte parametrische toetsen zijn:
- t-toetsen (één-steekproef, onafhankelijke steekproeven, gepaarde steekproeven)
- ANOVA (éénweg, tweeweg, herhaalde metingen)
- Z-toetsen (één-steekproef, twee-steekproef)
- F-toetsen (éénweg, tweeweg)
Niet-parametrische toetsen
Niet-parametrische toetsen veronderstellen geen specifieke verdeling van de data. Ze zijn nuttig bij ordinale data of wanneer de aannames van parametrische toetsen zijn geschonden. Voorbeelden zijn:
- Mann-Whitney U-toets
- Wilcoxon signed-rank-toets
- Kruskal-Wallis-toets
De juiste toets kiezen
Bij het kiezen van een hypothesetoets kijken onderzoekers naar enkele brede categorieën:
- Dataverdeling: Bepaal of je data normaal verdeeld is, aangezien veel toetsen normaliteit aannemen.
- Aantal groepen: Bepaal hoeveel groepen je vergelijkt (bijv. één, twee of meer).
- Groepsonafhankelijkheid: Beslis of je groepen onafhankelijk zijn (verschillende proefpersonen) of afhankelijk (dezelfde proefpersonen meerdere keren gemeten).
- Datatype:
- Continu (bijv. lengte, gewicht),
- Ordinaal (bijv. rangordes),
- Nominaal (bijv. categorieën zonder volgorde).
Op basis van deze categorieën kun je de juiste statistische toets kiezen. Als je data bijvoorbeeld normaal verdeeld is en je hebt twee onafhankelijke groepen met continue data, gebruik je een onafhankelijke t-toets. Als je data niet normaal verdeeld is met twee onafhankelijke groepen en ordinale data, dan is een Mann-Whitney U-toets aan te raden.
Om bij de keuze te helpen, kun je een stroomdiagram voor hypothesetoetsen gebruiken als algemene leidraad:
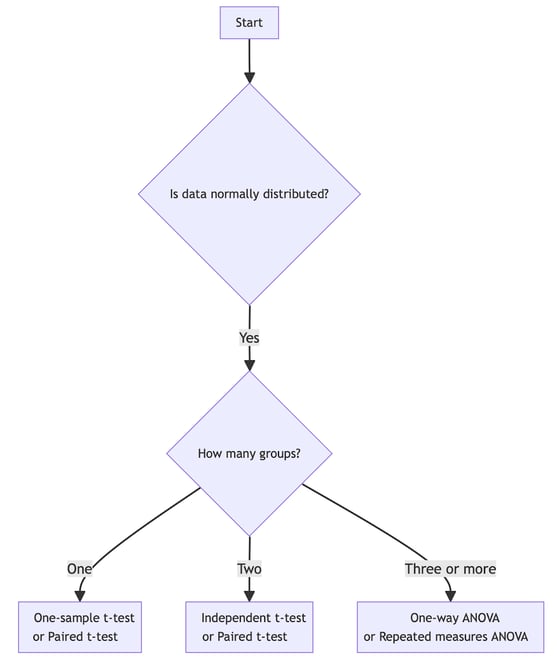
De juiste hypothesetoets kiezen voor normaal verdeelde data. Afbeelding door de auteur.
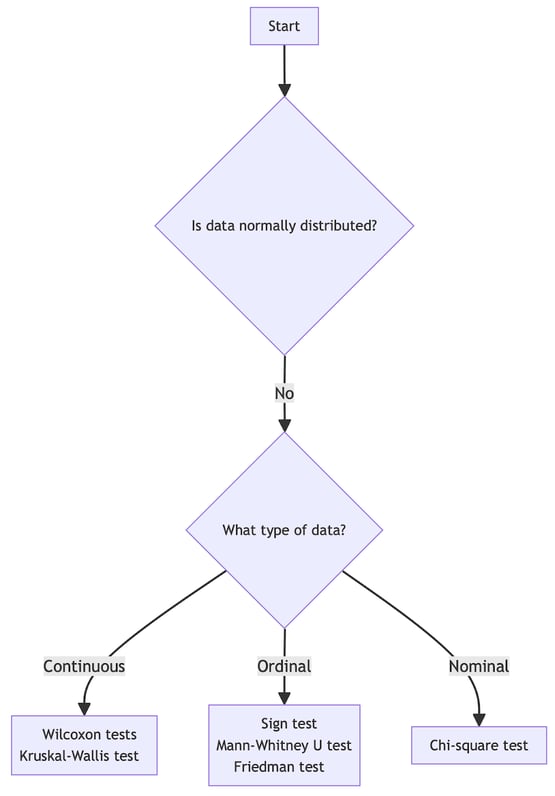
De juiste hypothesetoets kiezen voor niet-normaal verdeelde data. Afbeelding door de auteur.
Moderne benaderingen van hypothesetoetsing
Naast traditionele methoden zijn er verschillende moderne benaderingen:
Permutatie- of randomisatietoetsen
Deze toetsen schudden de waargenomen data vele malen willekeurig door elkaar om een verdeling van mogelijke uitkomsten onder de nulhypothese te creëren. Ze zijn vooral nuttig bij kleine steekproeven of wanneer niet aan de aannames van parametrische toetsen wordt voldaan.
Bootstrapping
Bootstrapping is een hersamplingtechniek waarbij herhaaldelijk met teruglegging uit de oorspronkelijke dataset wordt getrokken. Het kan worden gebruikt om de steekproevenverdeling van een statistiek te schatten en betrouwbaarheidsintervallen te construeren.
Montecarlo-simulatie
Monte Carlo-methoden gebruiken herhaald willekeurig steekproeven om numerieke resultaten te verkrijgen. Bij hypothesetoetsing kunnen ze worden gebruikt om p-waarden te schatten voor complexe statistische modellen of wanneer analytische oplossingen lastig te verkrijgen zijn.
Fouten beheersen
Bij het uitvoeren van hypothesetoetsen is het goed om mogelijke fouten te begrijpen en te beheersen:
Type I- en Type II-fouten
- Type I-fout: De nulhypothese verwerpen terwijl die in werkelijkheid waar is (vals positief).
- Type II-fout: De nulhypothese niet verwerpen terwijl die in werkelijkheid onwaar is (vals negatief).
Het significantieniveau (α) bepaalt direct de kans op een Type I-fout. Een lagere α verkleint de kans op Type I-fouten maar vergroot het risico op Type II-fouten.
Om deze fouten in balans te brengen:
- Pas het significantieniveau aan op basis van de gevolgen van elk fouttype.
- Vergroot de steekproefgrootte om de power van de toets te verbeteren.
- Gebruik eenzijdige toetsen wanneer passend.
Het file drawer-effect
Het file drawer-effect verwijst naar publicatiebias: studies met significante resultaten worden eerder gepubliceerd dan studies met niet-significante resultaten. Dit kan leiden tot een overschatting van effecten in de literatuur. Om dit te beperken:
- Overweeg om studies vooraf te preregistreren.
- Publiceer alle resultaten, significant of niet.
- Voer meta-analyses uit die rekening houden met publicatiebias.
- Simuleer vooraf data.
Verklarende woordenlijst
- Nulhypothese (H0): De standaardaanname dat er geen effect of verschil is.
- Alternatieve hypothese (Ha): De hypothese dat er wel een effect of verschil is.
- P-waarde: De kans op het waarnemen van de testresultaten onder de nulhypothese.
- Significantieniveau (α): De drempel om de nulhypothese te verwerpen, vaak 0,05.
- Toetsstatistiek: Een gestandaardiseerde waarde om de geobserveerde data met de nulhypothese te vergelijken.
- Type I-fout: Een ware nulhypothese verwerpen (vals positief).
- Type II-fout: Een onware nulhypothese niet verwerpen (vals negatief).
- Statistische power: De kans om een onware nulhypothese terecht te verwerpen.
- Betrouwbaarheidsinterval: Een waardenbereik dat waarschijnlijk de ware populatieparameter bevat.
- Effectgrootte: Een maat voor de omvang van het getoetste verschil of de relatie.
Conclusie
Onthoud dat hypothesetoetsing slechts één onderdeel is van de gereedschapskist voor statistische inferentie. Kijk altijd naar de praktische relevantie van je bevindingen, niet alleen naar statistische significantie. Naarmate je ervaring opdoet, ontwikkel je gevoel voor wanneer en hoe je deze technieken in uiteenlopende praktijksituaties toepast.
Wil je je statistische expertise verder versterken? Verken dan onderwerpen zoals How to Become a Statistician in 2024, met inzichten in het veranderende vak en de benodigde vaardigheden. Bovendien helpen het oefenen met de Top 35 Statistics Interview Questions and Answers for 2024 en onze cursus Practicing Statistics Interview Questions in R je om je vaardigheden aan te scherpen en je voor te bereiden op sollicitaties.




Hypothesetoetsing is een belangrijk onderdeel van de statistiek dat je helpt weloverwogen beslissingen te nemen in allerlei vakgebieden — van geneeskunde tot economie en sociale wetenschappen. Deze gids loodst je door de kernbegrippen, typen, stappen en toepassingen in de praktijk van hypothesetoetsing, zodat je je statistische bevindingen vol vertrouwen kunt interpreteren en presenteren.
Klaar om meer te leren over hypothesetoetsing? Kies de cursus die past bij jouw favoriete technologie: Hypothesis Testing in Python, Hypothesis Testing in R of Introduction to Statistics in Google Sheets. Volg ook onze technologie-agnostische cursus Introduction to Statistics.
Wat is hypothesetoetsing?
Hypothesetoetsing is een statistische procedure om aannames of hypothesen over een populatieparameter te toetsen. Je formuleert een nulhypothese (H0) en een alternatieve hypothese (Ha), verzamelt gegevens en bepaalt of het bewijs sterk genoeg is om de nulhypothese te verwerpen.
Het primaire doel van hypothesetoetsing is om op basis van een steekproef uitspraken te doen over een populatie. Het stelt onderzoekers en analisten in staat om te kwantificeren hoe waarschijnlijk het is dat waargenomen verschillen of relaties in de data op toeval berusten in plaats van een werkelijk effect in de populatie te weerspiegelen.
Stappen van hypothesetoetsing
Laten we stap voor stap door een hypothesetoets lopen.
Stap 1: Formuleer je hypothesen
Zet je onderzoeksvraag om in twee concurrerende hypothesen:
Bijvoorbeeld:
Stap 2: Verzamel en prepareer data
Verzamel gegevens via experimenten, enquêtes of observationele studies. Zorg dat de methode is ontworpen om de hypothese te toetsen en representatief is voor de populatie. Deze stap omvat vaak:
Stap 3: Kies de juiste statistische toets
Kies een statistische toets op basis van het type data en de hypothese. De keuze hangt af van factoren zoals:
Veelgebruikte toetsen zijn onder andere:
t-toetsen (voor het vergelijken van gemiddelden)
chi-kwadraattoetsen (voor categorische data)
ANOVA (voor het vergelijken van gemiddelden van meerdere groepen)
Stap 4: Bereken de toetsstatistiek en p-waarde
Gebruik statistische software of formules om de toetsstatistiek en bijbehorende p-waarde te berekenen. Deze stap kwantificeert hoe sterk de steekproefdata afwijkt van de nulhypothese.
De p-waarde is een belangrijk concept in hypothesetoetsing. Ze geeft de kans weer om resultaten te observeren die net zo extreem zijn als in de steekproef, uitgaande van een ware nulhypothese.
Stap 5: Neem een beslissing
Vergelijk de p-waarde met het vooraf bepaalde significantieniveau (α), doorgaans 0,05. De beslisregel is als volgt:
Belangrijk: het niet verwerpen van de nulhypothese bewijst niet dat die waar is; het betekent alleen dat er onvoldoende bewijs is om het tegendeel te concluderen.
Stap 6: Presenteer je bevindingen
Rapporteer de resultaten, inclusief de toetsstatistiek, p-waarde en conclusie. Bespreek of de bevindingen de initiële hypothese ondersteunen en wat de implicaties zijn. Houd bij het presenteren rekening met:
Typen hypothesetoetsen
Hypothesetoetsen zijn grofweg in twee hoofdtypen te verdelen:
Parametrische toetsen
Parametrische toetsen gaan ervan uit dat de data een specifieke kansverdeling volgt, meestal de normale verdeling. Deze toetsen zijn over het algemeen krachtiger als aan de aannames wordt voldaan. Veelgebruikte parametrische toetsen zijn:
Niet-parametrische toetsen
Niet-parametrische toetsen veronderstellen geen specifieke verdeling van de data. Ze zijn nuttig bij ordinale data of wanneer de aannames van parametrische toetsen zijn geschonden. Voorbeelden zijn:
De juiste toets kiezen
Bij het kiezen van een hypothesetoets kijken onderzoekers naar enkele brede categorieën:
Op basis van deze categorieën kun je de juiste statistische toets kiezen. Als je data bijvoorbeeld normaal verdeeld is en je hebt twee onafhankelijke groepen met continue data, gebruik je een onafhankelijke t-toets. Als je data niet normaal verdeeld is met twee onafhankelijke groepen en ordinale data, dan is een Mann-Whitney U-toets aan te raden.
Om bij de keuze te helpen, kun je een stroomdiagram voor hypothesetoetsen gebruiken als algemene leidraad:
De juiste hypothesetoets kiezen voor normaal verdeelde data. Afbeelding door de auteur.
De juiste hypothesetoets kiezen voor niet-normaal verdeelde data. Afbeelding door de auteur.
Moderne benaderingen van hypothesetoetsing
Naast traditionele methoden zijn er verschillende moderne benaderingen:
Permutatie- of randomisatietoetsen
Deze toetsen schudden de waargenomen data vele malen willekeurig door elkaar om een verdeling van mogelijke uitkomsten onder de nulhypothese te creëren. Ze zijn vooral nuttig bij kleine steekproeven of wanneer niet aan de aannames van parametrische toetsen wordt voldaan.
Bootstrapping
Bootstrapping is een hersamplingtechniek waarbij herhaaldelijk met teruglegging uit de oorspronkelijke dataset wordt getrokken. Het kan worden gebruikt om de steekproevenverdeling van een statistiek te schatten en betrouwbaarheidsintervallen te construeren.
Montecarlo-simulatie
Monte Carlo-methoden gebruiken herhaald willekeurig steekproeven om numerieke resultaten te verkrijgen. Bij hypothesetoetsing kunnen ze worden gebruikt om p-waarden te schatten voor complexe statistische modellen of wanneer analytische oplossingen lastig te verkrijgen zijn.
Fouten beheersen
Bij het uitvoeren van hypothesetoetsen is het goed om mogelijke fouten te begrijpen en te beheersen:
Type I- en Type II-fouten
Het significantieniveau (α) bepaalt direct de kans op een Type I-fout. Een lagere α verkleint de kans op Type I-fouten maar vergroot het risico op Type II-fouten.
Om deze fouten in balans te brengen:
Het file drawer-effect
Het file drawer-effect verwijst naar publicatiebias: studies met significante resultaten worden eerder gepubliceerd dan studies met niet-significante resultaten. Dit kan leiden tot een overschatting van effecten in de literatuur. Om dit te beperken:
Verklarende woordenlijst
Conclusie
Onthoud dat hypothesetoetsing slechts één onderdeel is van de gereedschapskist voor statistische inferentie. Kijk altijd naar de praktische relevantie van je bevindingen, niet alleen naar statistische significantie. Naarmate je ervaring opdoet, ontwikkel je gevoel voor wanneer en hoe je deze technieken in uiteenlopende praktijksituaties toepast.
Wil je je statistische expertise verder versterken? Verken dan onderwerpen zoals How to Become a Statistician in 2024, met inzichten in het veranderende vak en de benodigde vaardigheden. Bovendien helpen het oefenen met de Top 35 Statistics Interview Questions and Answers for 2024 en onze cursus Practicing Statistics Interview Questions in R je om je vaardigheden aan te scherpen en je voor te bereiden op sollicitaties.