
Cursus
Machine Learning-workflows ontwerpen in Python
4 uur
12.8K
In deze tutorial duiken we in Prefect door de belangrijkste functies, voordelen en componenten te verkennen. We bekijken hoe je taken en flows maakt, deployments beheert en flow-runs uitvoert. Tot slot begeleiden we je bij het deployen van je workflow op Prefect Cloud en het draaien ervan met cloudinfrastructuur.
Ben je benieuwd hoe je machine learning-pijplijnen automatiseert met GitHub Actions en Data Version Control? Volg dan onze cursus CI/CD for Machine Learning.
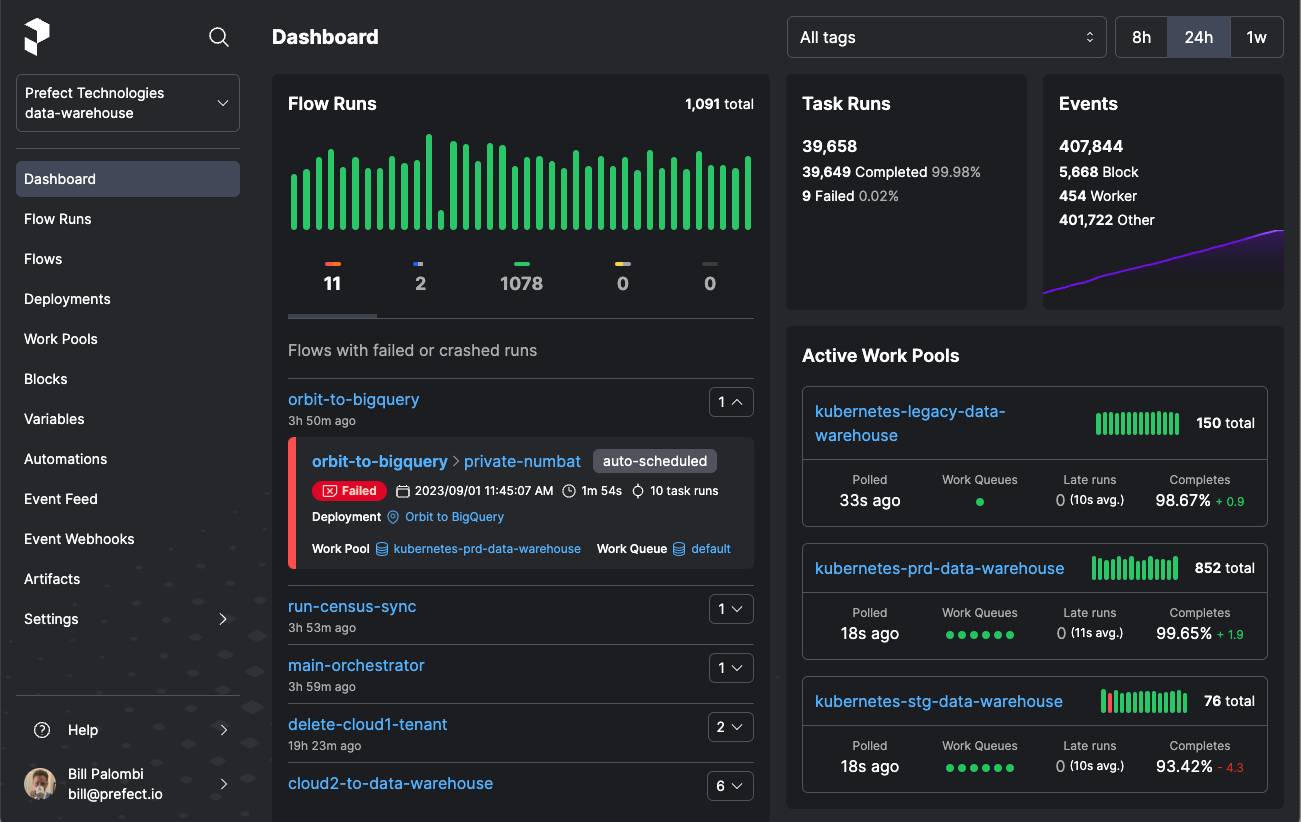
Prefect is een krachtige open-source tool voor workfloworkestratie waarmee je data- en machine learning-pijplijnen kunt ontwerpen, monitoren en erop kunt reageren met Python-code.
Prefect is uitgerust met een reeks functies, zoals automatische retries, scheduling en caching, om er maar een paar te noemen. Het is een krachtige tool waarmee je veerkrachtige en dynamische workflows kunt bouwen.
Afbeelding Bron
Met Prefect kun je eenvoudig elke Python-functie omzetten in een werkunit die geobserveerd en georkestreerd kan worden door simpelweg een paar decorators aan je code toe te voegen.
Prefect is ideaal om de ontwikkeling en deployment van workflows binnen organisaties te standaardiseren. Het biedt volledige observability in workflows en stelt je in staat je code te beheren zonder strikte DAG's of boilerplate-code.
Met één commando kunnen gebruikers moeiteloos hun eigen orkestratieserver voor ontwikkeldoeleinden opzetten. Dit gestroomlijnde proces vereenvoudigt lokale ontwikkeling en zorgt voor een soepele uitrol naar productieomgevingen.
Prefect biedt een over het algemeen intuïtieve gebruikersinterface, wat de ervaring verbetert met een visueel aantrekkelijke en gebruiksvriendelijke manier om workflows uit te voeren, te monitoren, te debuggen en te beheren.
Prefect biedt functies zoals scheduling, retries, native secrets-beheer, schaalmogelijkheden, concurrencycontrol, flexibele opties voor infrastructuur- en opslagconfiguratie en robuuste loggingfunctionaliteit.
Gebruikers kunnen ervoor kiezen om zelf een open-source Prefect-server te hosten of geavanceerde functies, hoge beschikbaarheid en verbeterde beveiliging te benutten via Prefect Cloud.
Prefect Cloud biedt alle mogelijkheden van de open-source Prefect-server, plus extra functies zoals automations, eventfeeds, events, webhooks, workspaces, organizations en meer, afgestemd op een hosted omgeving. Je kunt Prefect Cloud gratis gebruiken of betalen voor krachtigere features.
Met Prefect kun je workfloworkestratie starten met een enkele decorator, waardoor het proces wordt gestroomlijnd zonder onnodige abstracties voor efficiënt workflowbeheer.
Stuur informatie over Prefect-workflows en -pipelines naar meerdere berichtendiensten zoals Slack, Discord, e-mail, Microsoft Teams en meer. Dit kan je ook waarschuwen als de workflow faalt.
In deze sectie behandelen we de belangrijkste componenten die worden gebruikt om taken en flows te bouwen, te deployen en uit te voeren, en te beheren. Het is cruciaal om deze componenten door te nemen voordat we in de Python-tutorial duiken.
Een Prefect Task is een Python-functie met de @task-decorator die afgebakende werkunits binnen een Prefect-workflow voorstelt. We kunnen de task-decorator ook aanpassen met optionele argumenten zoals name, description, tags, cache-instellingen, retries en meer.
In de onderstaande code zijn drie machine learning-taken gemaakt met de @task-decorator die herbruikbaar zijn over verschillende flows.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Een Prefect Flow is een Python-functie met de @flow-decorator die de workflowlogica omvat. Dit maakt het makkelijker voor gebruikers om complexe datapijplijnen flexibel en eenvoudig te definiëren, configureren en uitvoeren.
In de onderstaande code hebben we een Flow gemaakt met de @flow-decorator. De flow voert alle taken sequentieel uit, waarbij de output van de ene als input voor de andere dient.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Deployments zijn flows die lokaal of in de cloud zijn opgeslagen en bevatten belangrijke informatie om je workflow op afstand te orkestreren, zoals planning- en uitvoeringsdetails.
Work pools fungeren als bemiddelaar tussen orkestratie- en uitvoeringsomgevingen, waardoor efficiënt plannen en uitvoeren van flow-runs mogelijk wordt. Gebruikers kunnen hun Agents (worker) instellen om workflows lokaal te draaien of cloudinfrastructuur benutten voor naadloze workflow-uitvoering.
Net als een dedicated compute instance beheren Work Pools de werkverdeling en prioriteren ze taken efficiënt, met flexibiliteit in de keuze van de uitvoeringsomgeving voor optimale workflowprestaties en schaalbaarheid.
In deze sectie maken, testen, deployen en voeren we een eenvoudige machine learning-workflow uit met Prefect. We stellen ook notificaties in zodat we op onze Discord-server een melding krijgen over de status van de flow-runs.
Installeer het Python-pakket met PIP
pip install -U prefectAls je de nieuwste versie van Prefect wilt gebruiken, kun je de code direct van GitHub halen.
pip install -U git+https://github.com/PrefectHQ/prefectWe pre-processen de Bank Churn-dataset van Kaggle en gebruiken vervolgens scikit-learn om het model Random Forest Classifiers te trainen en te evalueren.
De code die we gebruiken is een aangepaste versie van de code uit: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Bekijk die tutorial als je meer wilt leren over hoe het model is getraind. Onze machine learning Prefect Flow bestaat uit zeven taken:
We hebben nu alle benodigde taken samengebracht in een @flow-functie genaamd ml_workflow. Daarnaast hebben we extra argumenten aan de decorator toegevoegd om gedetailleerde logging in te schakelen.
De functie ml_workflow neemt de locatie van het databestand als input en koppelt vervolgens verschillende taken in een keten. We kunnen deze workflow beter visualiseren wanneer we hem deployen en uitvoeren op de Prefect-server.
Je kunt onze machine learning-experimenten ook tracken met MLflow. Volg de cursus Introduction to MLflow om te leren over MLflow tracking, projects, models en model registry.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
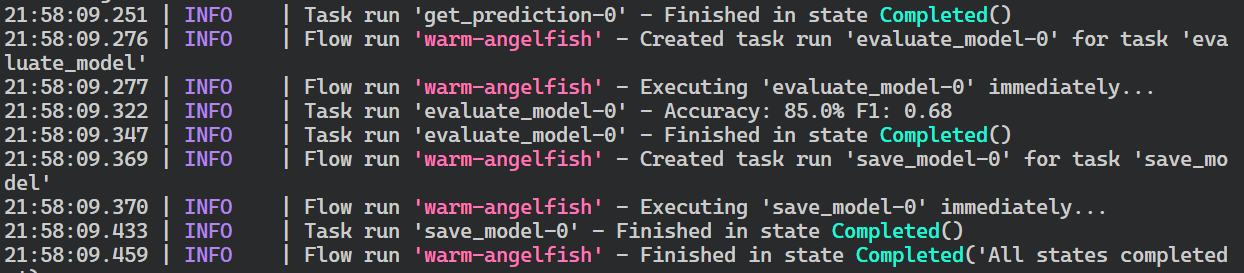
Om onze Prefect Flow te testen, voer je het Python-bestand uit in de terminal.
$ python main.pyDe flow is succesvol voltooid. De modelmetrics zijn getoond en de modelgewichten zijn opgeslagen.
Ben je nieuw in machine learning en wil je leren hoe je je data preprocesst, je model traint, optimaliseert, evalueert en opslaat? Overweeg dan de carrièretrack Machine Learning Scientist with Python. Deze cursus leert je alles vanaf het begin.
Handmatig een machine learning-pijplijn bouwen en draaien is eenvoudig en kan zelfs met scikit-learn-pipelines.
Toch zijn er meerdere voordelen aan het gebruik van Prefect, waaronder:
Nu leren we onze workflow te automatiseren door hem te deployen naar de lokale Prefect-server.
Eerst moeten we de "Deployment" bouwen door de bestands- en fl owfunctienamen op te geven. We voegen ook de tag "dev" toe aan onze Deployment.
Let op: tags in Prefect kunnen worden gebruikt om flows, taken en deployments in het Prefect-ecosysteem te categoriseren en te organiseren.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devDeployment is succesvol aangemaakt. Nu krijgen we instructies over hoe we de flow uitvoeren met de Prefect Agent.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Prefect-agents zijn verantwoordelijk voor het monitoren van work pools om beschikbare flow-runs te identificeren en deze te deployen naar de uitvoeringsomgeving.
Eén work pool kan meerdere agents hebben, waarbij elke agent een unieke ID heeft om overlap te voorkomen en naadloze schaalbaarheid te waarborgen.
We initialiseren nu de Prefect-agents in een nieuwe terminal met de standaard work pool-naam.
$ prefect agent start -p 'default-agent-pool'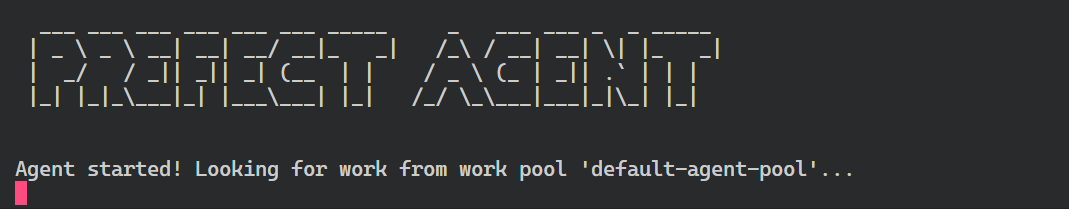
Ga naar een nieuwe terminal en voer de deployment uit door "flow_function/deployment name" op te geven. Je kunt ook alleen de deploymentnaam gebruiken om de flow uit te voeren.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Er is een flow-run aangemaakt voor de deployment die naar workers zal zoeken en de workflow zal starten.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
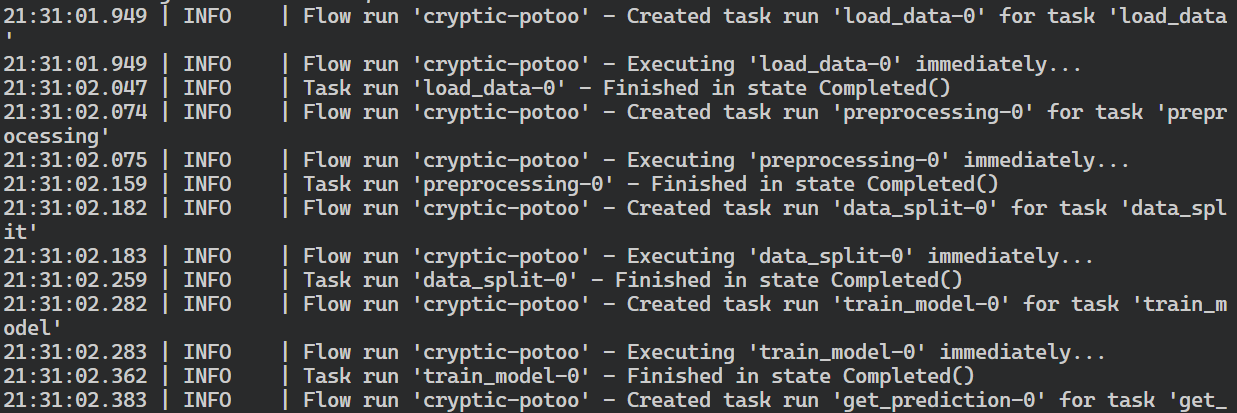
Schakel over naar de terminal waar we de agent hebben gestart om logs van onze flow-run te bekijken. De Prefect-agent heeft alle taken in de flow succesvol uitgevoerd.
Dit is een eenvoudig voorbeeld. We kunnen de workflow ook plannen of automatiseren door extra argumenten op te geven bij het bouwen van onze Deployment.
Tot nu toe hebben we onze workflow in terminals gevolgd. Laten we nu een Prefect-dashboard starten waar we alle flow-runs, deployments, work pool en notificaties kunnen zien.
Start de Prefect-server in een nieuwe terminal en klik op de lokale link om toegang te krijgen tot het dashboard.
$ prefect server start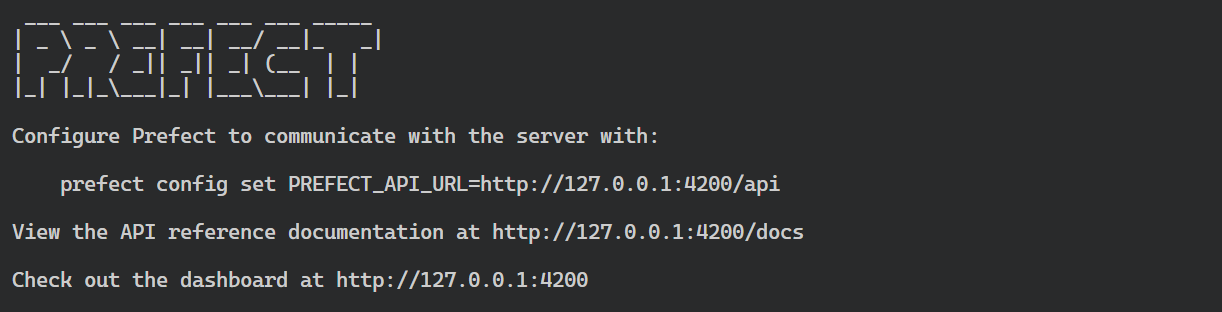
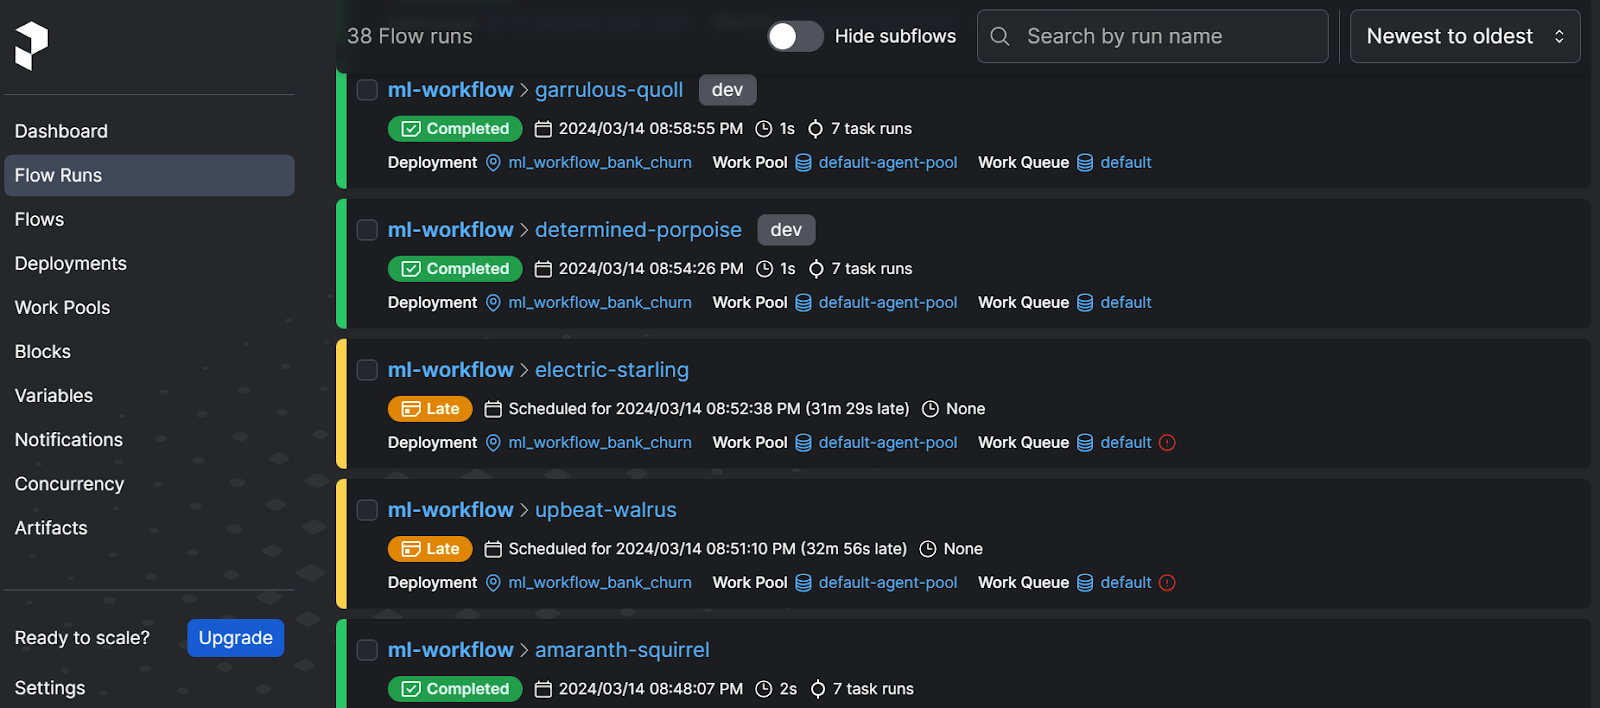
Klik op de optie "Flow" in het linkerpaneel om alle eerdere runs te bekijken. Je zult misschien zien dat sommige flows niet zijn uitgevoerd door een gebrek aan work pools, terwijl andere zonder de tag "dev" zijn uitgevoerd tijdens de experimenteerfase.
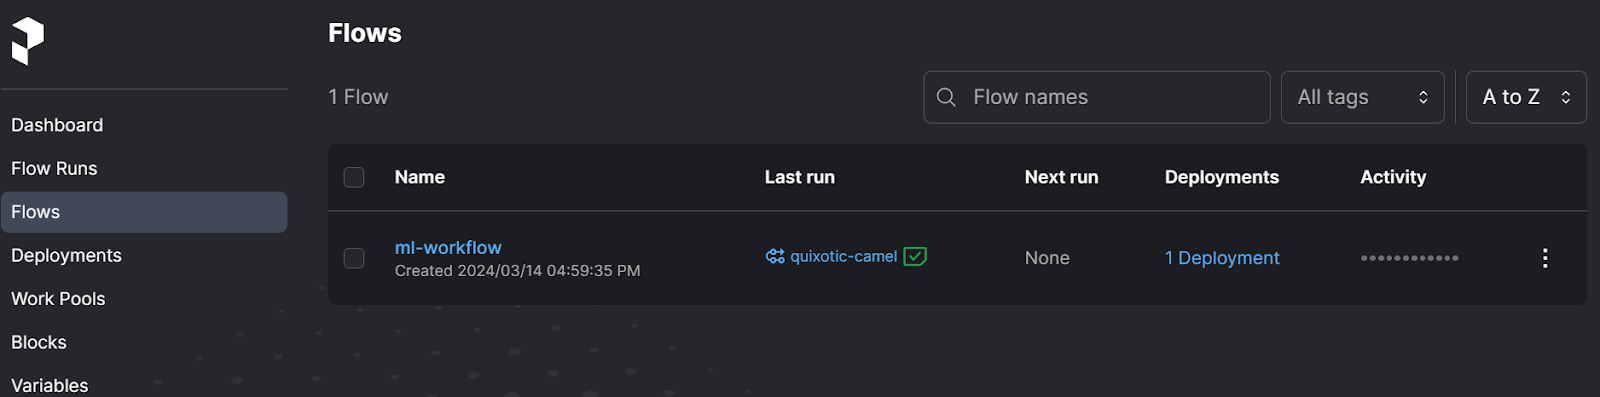
Als je op de optie Flows klikt, worden alle beschikbare flows weergegeven. Er kunnen meerdere flows bestaan binnen één deployment.
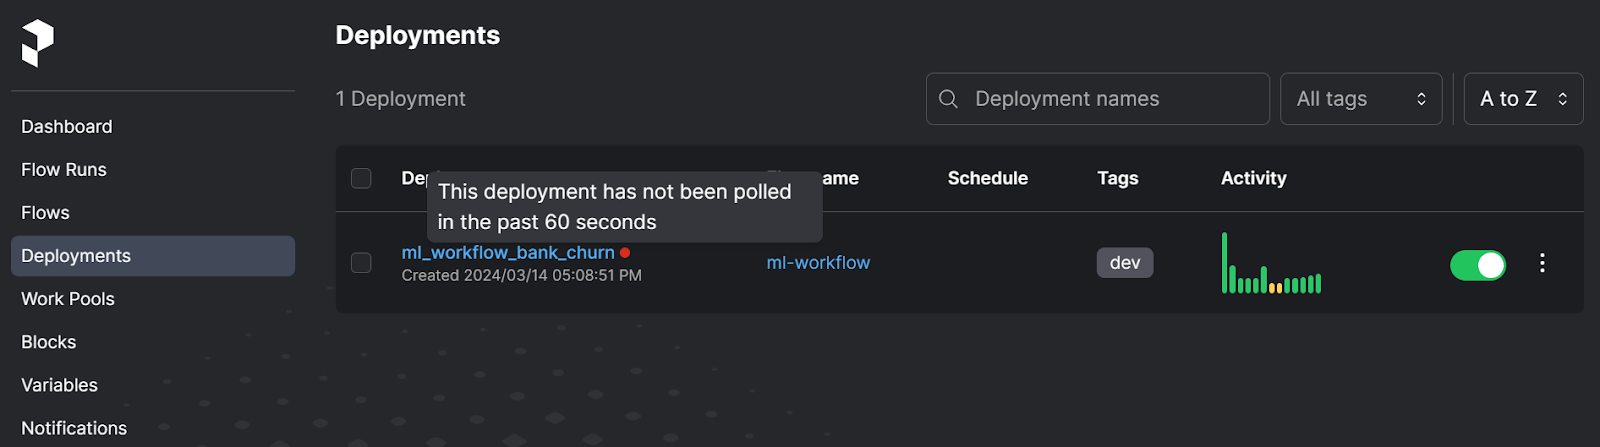
In de sectie Deployment zien we onze huidige Deployment met bijbehorende activiteit en tags. In deze sectie kunnen we de flow eenvoudig uitvoeren met de quick run-optie of de run plannen via de gebruikersinterface.
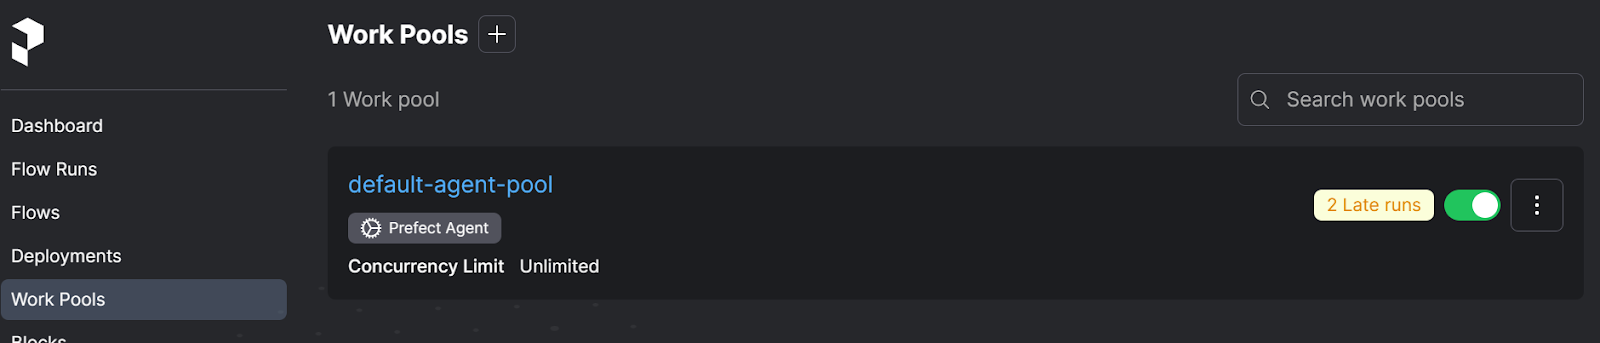
Bij Work Pools zie je onze standaard Prefect Agent. Je kunt ook een cloud work pool instellen met de Prefect CLI.
Laten we beginnen met het leuke gedeelte.
Niemand wil zijn workflow 24/7 in de gaten houden. In plaats daarvan willen we notificaties ontvangen over de workflowstatus in onze favoriete berichtenapp. Zo kunnen we snel problemen oplossen.
Hiervoor maken we een Discord-webhook. Met de webhook-ID en -token richten we een Prefect-notificatie in. Deze stuurt alle loginformatie naar de Discord-server.
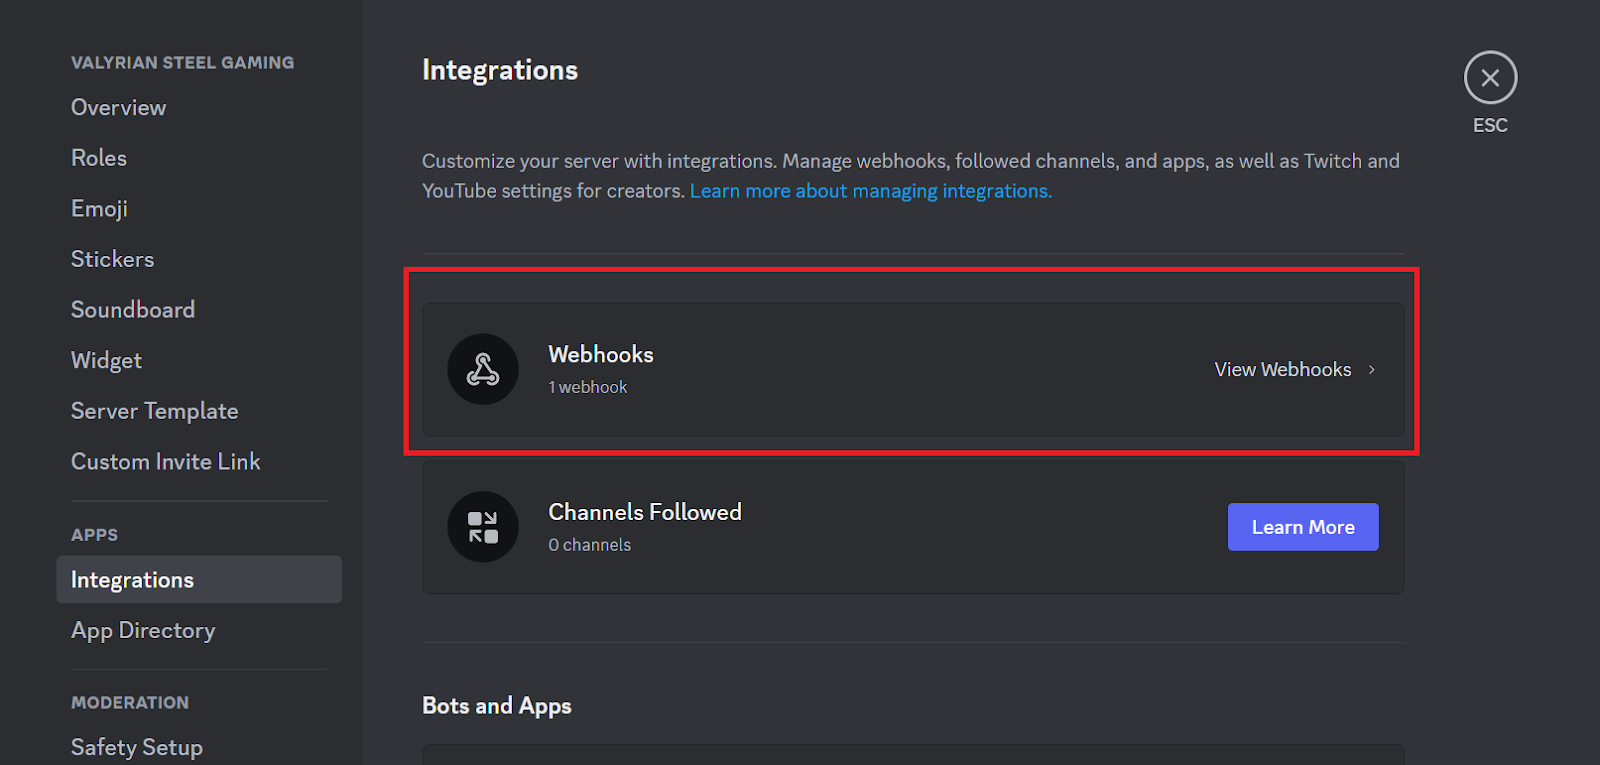
Om een webhook te maken, ga je naar de instellingen van je Discord-server, klik je op "Integrations" en kies je "View Webhooks". Klik daarna op "New Webhook".
Wijzig de weergaveafbeelding, naam en het kanaal. Kopieer daarna de Webhook-URL.
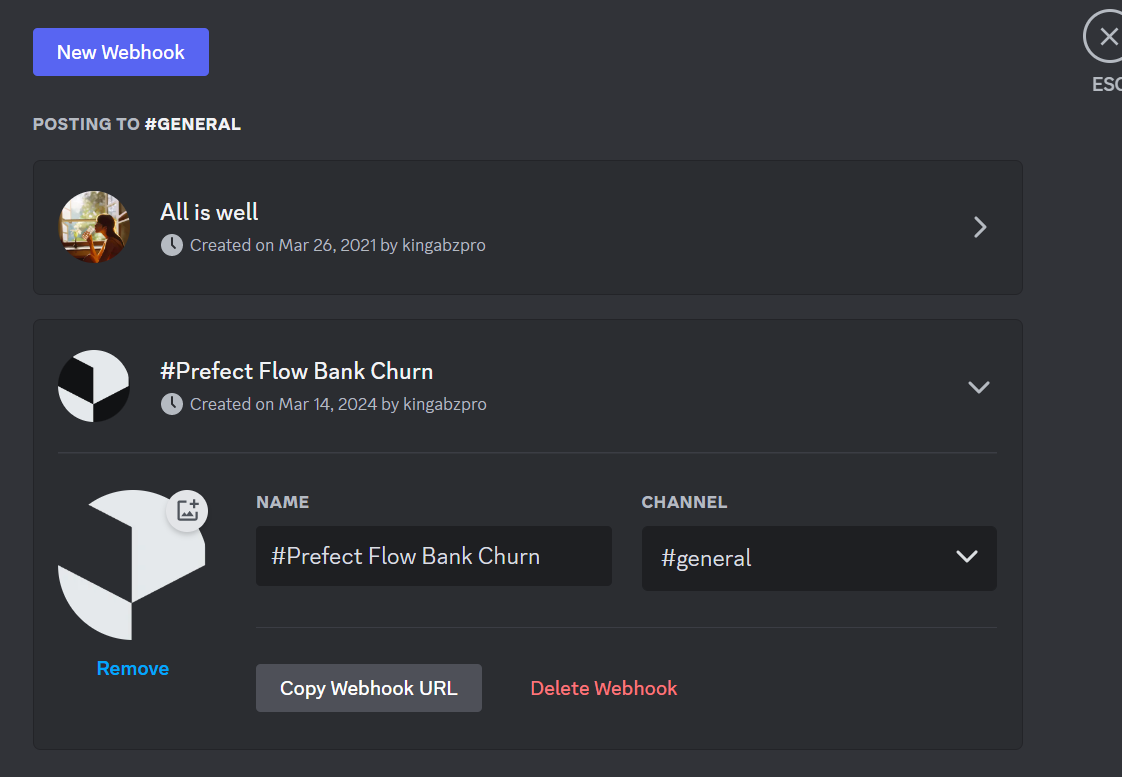
De webhook-URL bestaat uit twee delen: de Webhook ID en het Webhook-token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Voor het aanmaken van een Prefect-notificatie moeten we deze twee delen handmatig uit de link halen.
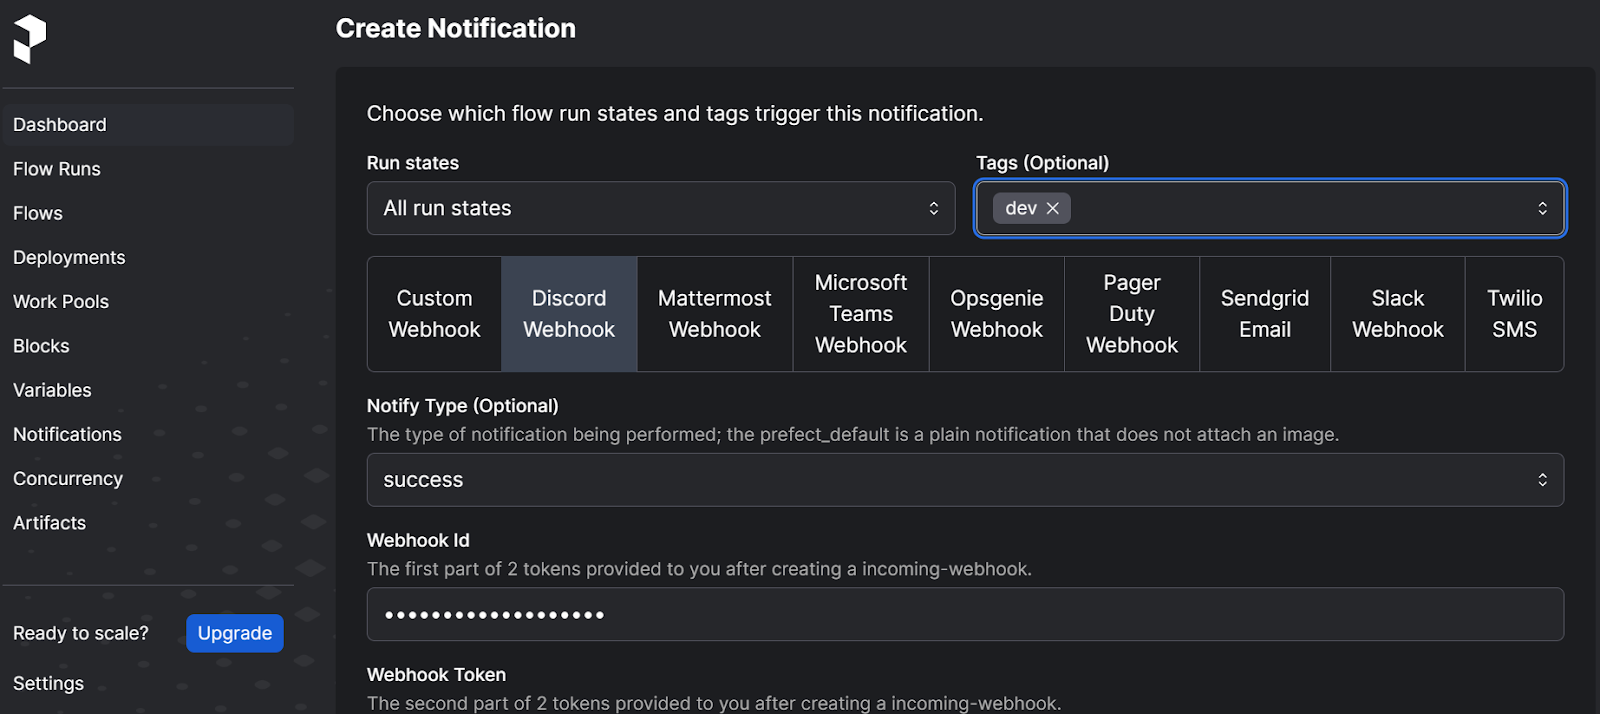
Om een Discord-notificatie in de Prefect UI te maken, ga je naar de optie "Notifications" en klik je bovenaan op de "+"-knop. Selecteer vervolgens de gewenste run states, tags, Discord-webhook en notificatietype.
Geef daarna de Webhook ID en het Webhook-token op en klik op de blauwe knop "Create".
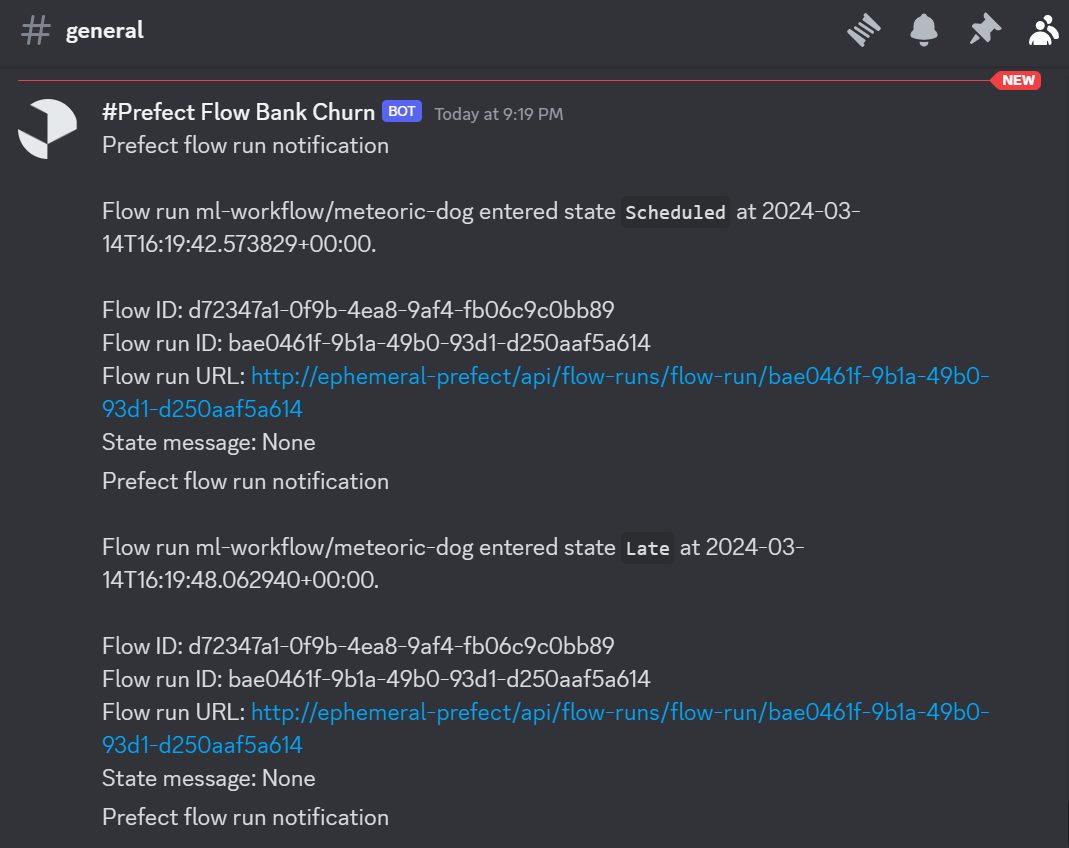
We moeten de deployment uitvoeren om notificaties te zien in het hoofdkanaal van onze Discord-server.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Geweldig. Met dezelfde methode kunnen we verschillende berichtendiensten instellen, zoals Microsoft Teams, Slack, sms en e-mail, en we kunnen zelfs onze eigen aangepaste webhook maken.
Volg de cursus Designing Machine Learning Workflows in Python om te leren hoe je pijplijnen bouwt die de tand des tijds doorstaan.
Nadat we onze machine learning-flow lokaal hebben gedeployed, is het tijd om hem op Prefect Cloud te deployen. Dit is een veel gemakkelijker proces dan lokale deployments, omdat je geen servers of agents hoeft te starten of runs via de CLI-tool hoeft uit te voeren. Alles wordt beheerd door Prefect.
Voordat we de huidige flow deployen, is het belangrijk om te weten dat er een fout zal optreden omdat geprobeerd wordt bestanden en data te benaderen vanuit een lokale map die in de cloud niet toegankelijk is. Om deze bestanden beschikbaar te maken voor Prefect Cloud, moeten we onze code aanmaken en pushen naar een openbare GitHub-repository.
Dit kan eenvoudig via de GitHub-website of door de VSCode Git-extensie te gebruiken om de remote repository te maken en de code via de gebruikersinterface te pushen.
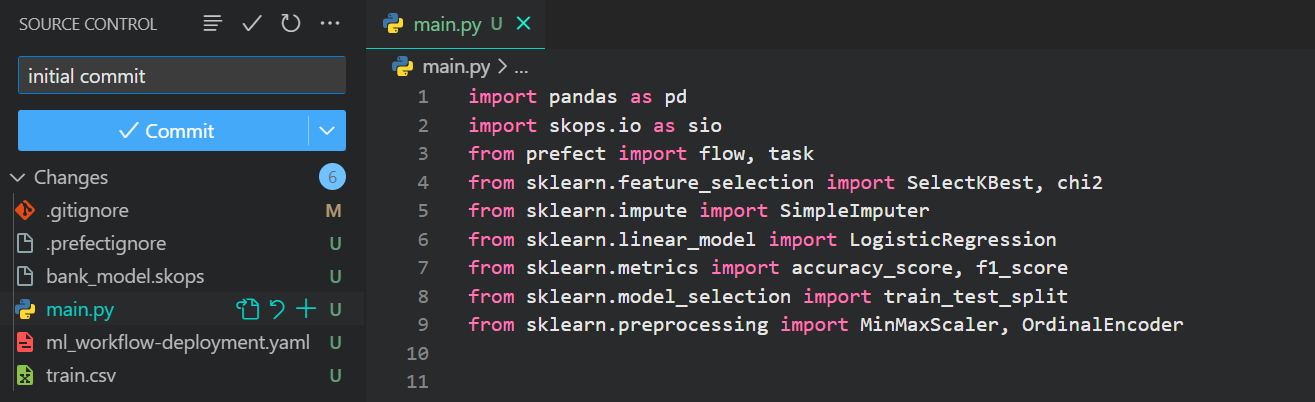
Hier is de projectrepository die we gaan gebruiken voor onze cloud-deployments: kingabzpro/ML-Workflow-Orchestration-With-Prefect
Maak je Prefect Cloud-account aan via https://app.prefect.cloud/auth/login en log daarna in met de Prefect CLI-tool.
$ prefect cloud loginKies simpelweg "Log in with a web browser" en volg de stappen om de lokale client te authenticeren met Prefect Cloud.
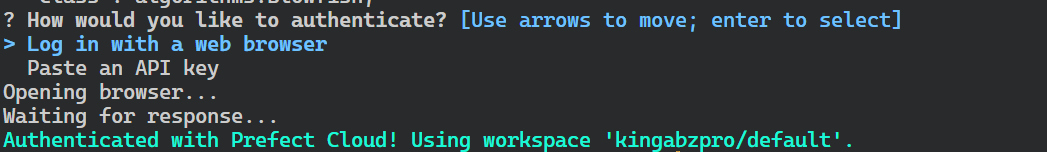
We maken een door Prefect beheerde work pool om de infrastructuur van Prefect Cloud volledig te benutten in plaats van onze lokaal draaiende agent te gebruiken.
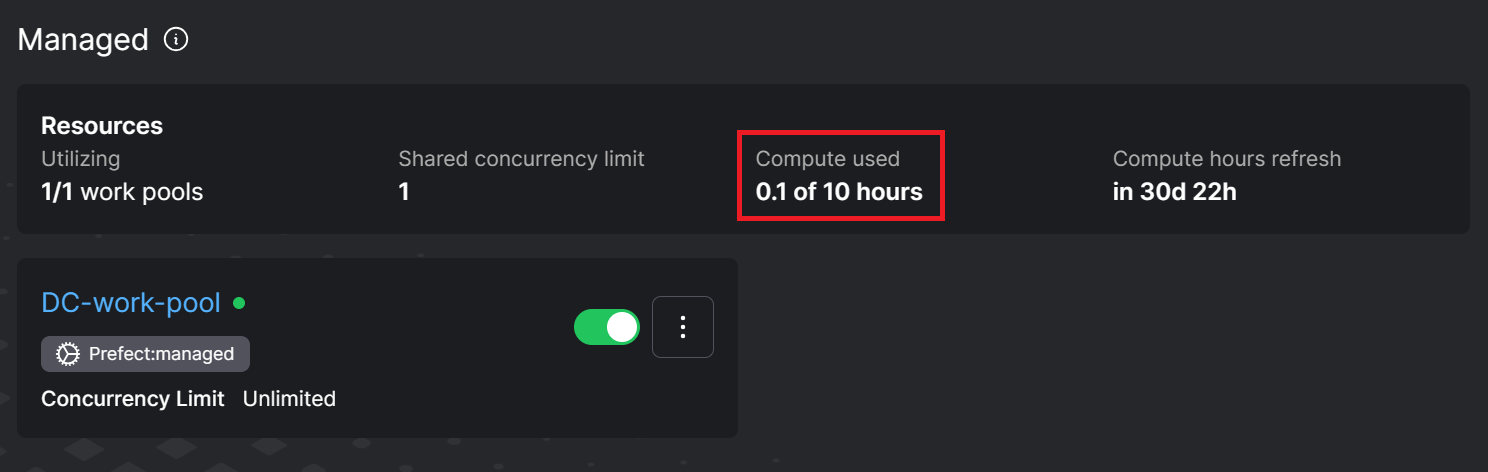
$ prefect work-pool create DC-work-pool --type prefect:managedVoor een gratis account biedt Prefect 10 gratis computeruren per maand die je kunt gebruiken om te experimenteren en te spelen.
We gaan nu programmatisch onze flow deployen naar Prefect Cloud.
Maak een nieuw bestand aan met de naam deployment.py.
Stel argumenten in voor de Prefect-flowfunctie:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Voer de Python-code uit.
$ python deployment.pyDe flow is gedeployed op Prefect Cloud. Hij kan worden uitgevoerd via de CLI of het Prefect Cloud-dashboard.
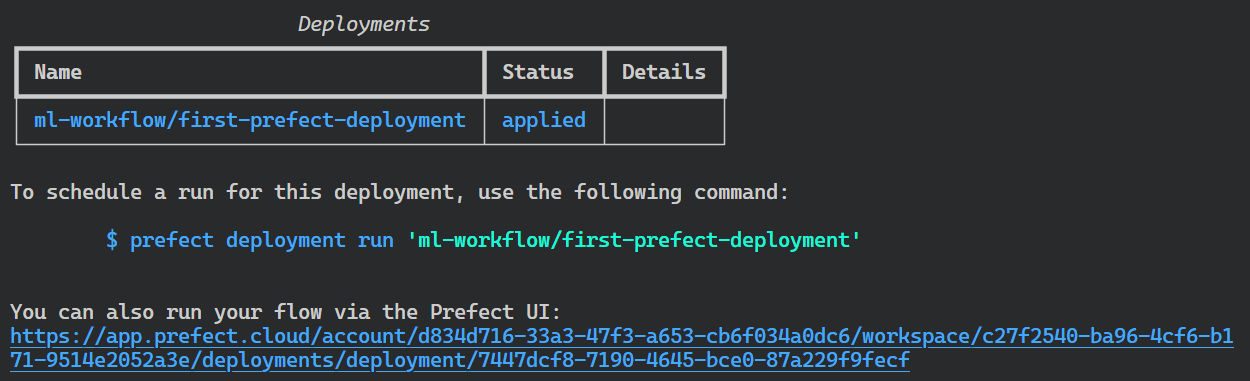
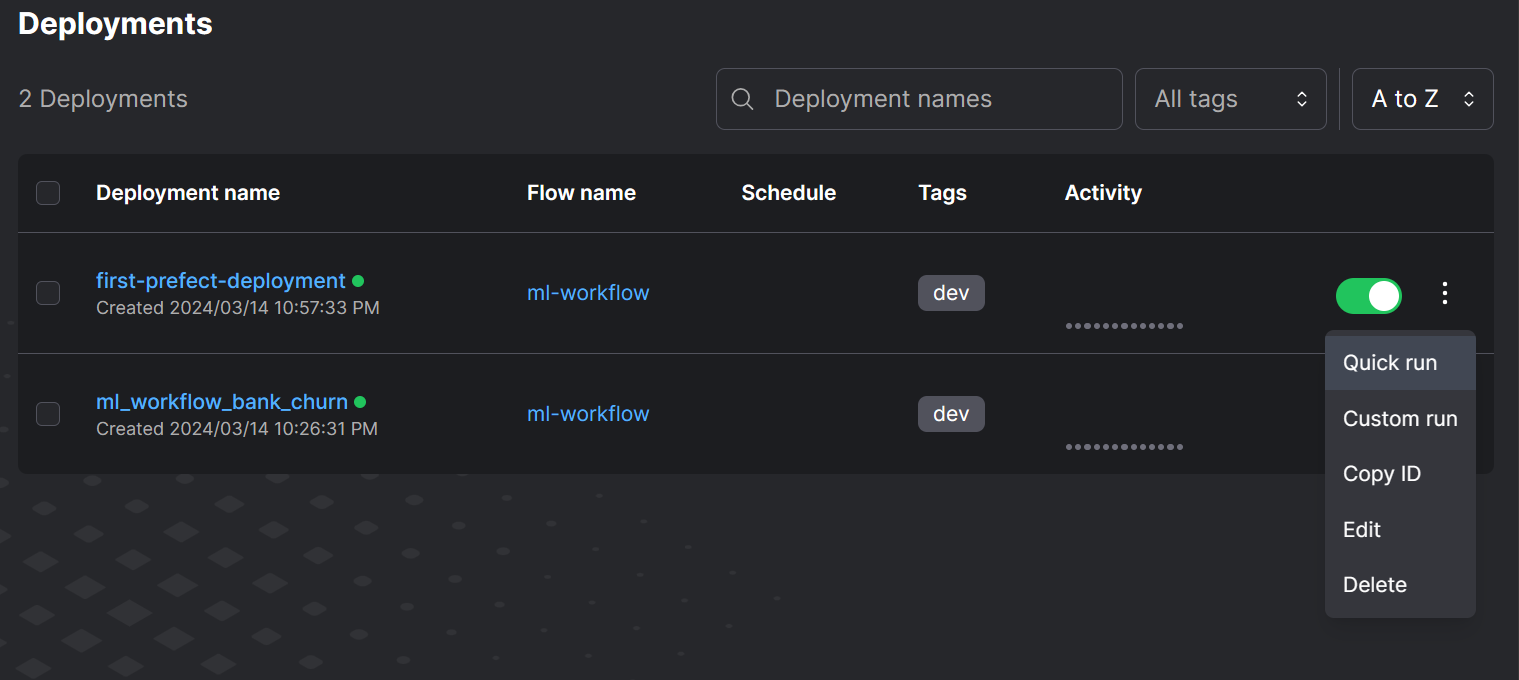
Om de flow te draaien, ga je naar de website: https://app.prefect.cloud/. Ga daarna naar de sectie "Deployments" en klik op de verticale driepuntknop bij je deployment, en selecteer de optie "Quick run".
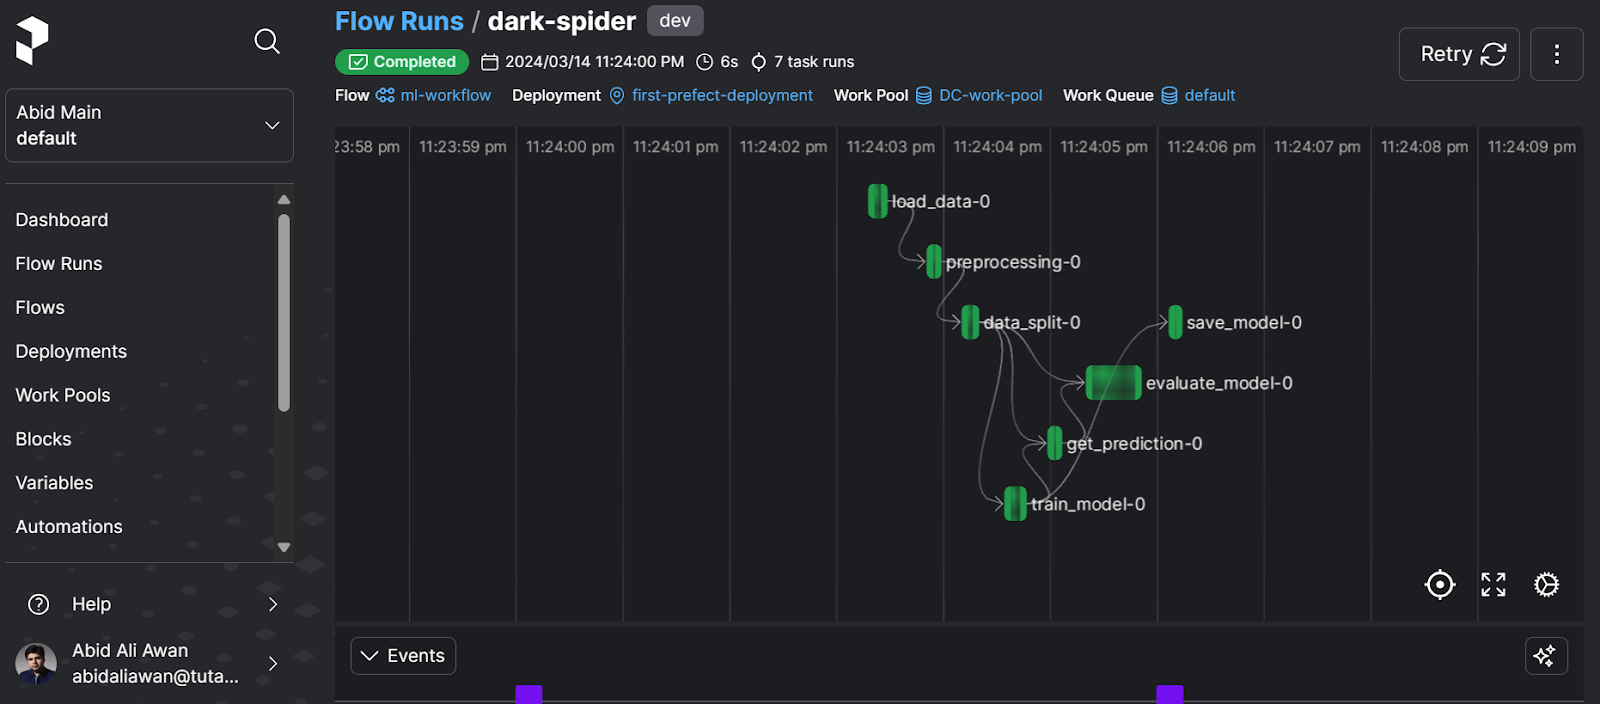
Om te zien hoe onze run presteert, ga je naar de sectie "Flow Run" en klik je op de meest recente run om de workflowgrafiek te bekijken.
Het flowdiagram geeft een overzicht van de onderlinge verbinding tussen de taken en de tijd die elk proces kostte.
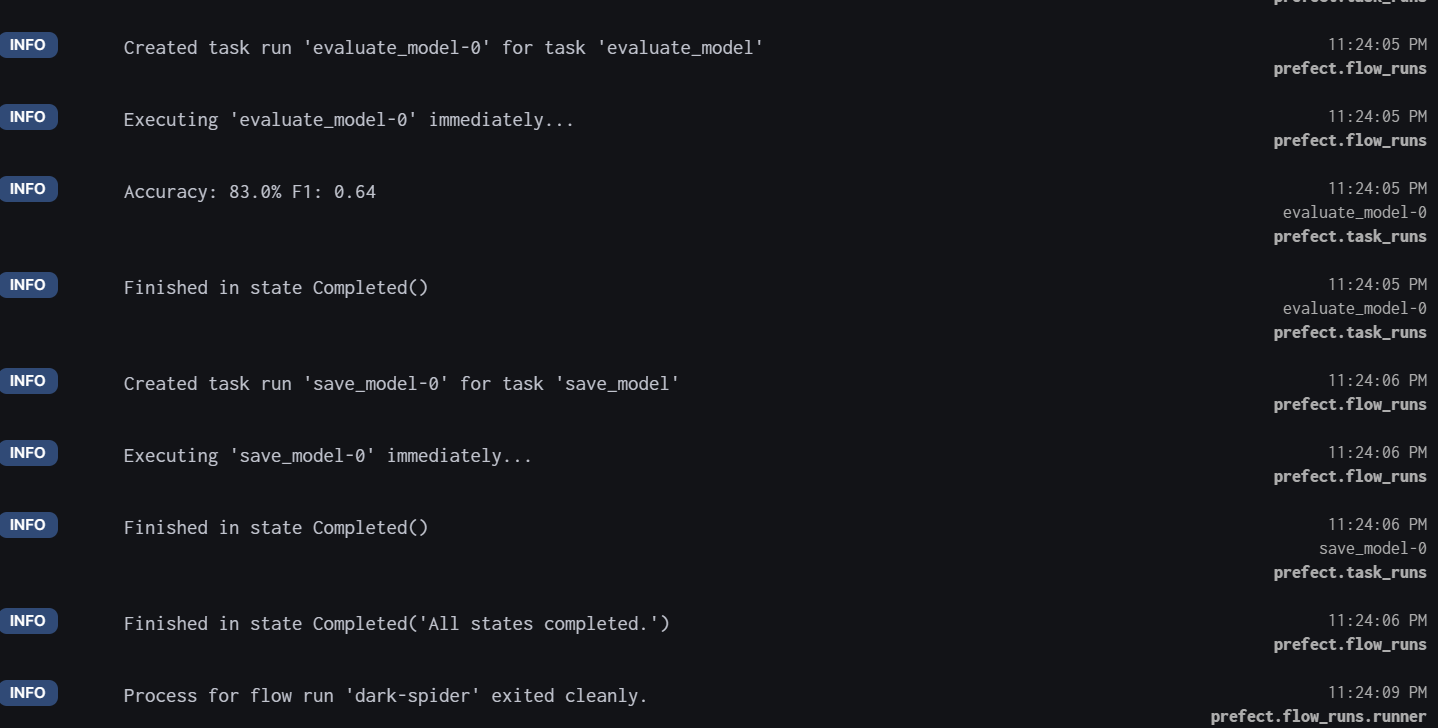
Voor gedetailleerde logs scroll je naar beneden en bekijk je alle uitgevoerde taken met tijdstempel.
Als we naar de sectie "Work Pools" gaan, zien we duidelijk dat we 0,1 uur hebben gebruikt van de limiet van 10 uur voor gratis gebruikers.
Bekijk de gids Machine Learning Workflow, met een infographic die je helpt de taken te begrijpen bij projectsetup, datavoorbereiding, modellering en deployment.
Het opzetten van één machine learning-workflow was eenvoudig. In de echte wereld moet je mogelijk meerdere machine learning- en dataworkflows tegelijk draaien. Daar blinkt Prefect in uit. Het biedt schaalbaarheid en flexibiliteit in de keuze om te draaien op een lokale of cloudomgeving voor Prefect-servers of work pools. Het is een fantastische tool voor het plannen, automatiseren en beheren van workflows.
In deze tutorial hebben we de belangrijkste functies en mogelijkheden van het Prefect-ecosysteem behandeld. We leerden ook hoe je een machine learning-flow lokaal en in de cloud deployt. Wil je je MLOps-reis voortzetten? Leer dan hoe je CI/CD bouwt voor machine learning-workflows met "A Beginner's Guide to CI/CD for Machine Learning".
Prefect is slechts één tool in het MLOps-veld voor workfloworkestratie. Wil je meer weten over andere belangrijke tools voor dataversiebeheer, feature stores, modeltesten, modeldeployment en -serving, modelmonitoring, runtime-engines en end-to-end MLOps-tools? Lees dan het artikel 25 Top MLOps Tools You Need to Know in 2024. Je kunt ook onze vergelijking Prefect vs Airflow lezen om te zien hoe de tools zich tot elkaar verhouden.
Zet vandaag je machine learning-reis voort!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

