
Khóa học
Thiết kế quy trình Machine Learning bằng Python
4 giờ
12.8K
Trong hướng dẫn này, chúng ta sẽ đi sâu vào Prefect bằng cách khám phá các tính năng chính, lợi ích và các thành phần của nó. Chúng ta sẽ xem cách tạo tasks và flows, quản lý deployments, và thực thi flow runs. Cuối cùng, chúng ta sẽ hướng dẫn bạn triển khai quy trình làm việc của mình lên Prefect Cloud và chạy nó bằng hạ tầng đám mây.
Nếu bạn quan tâm đến cách tự động hóa pipeline machine learning bằng GitHub Actions và Data Version Control, hãy cân nhắc tham gia khóa học CI/CD cho Machine Learning của chúng tôi.
Prefect là một công cụ điều phối quy trình làm việc mạnh mẽ và mã nguồn mở, cho phép người dùng thiết kế, giám sát và phản hồi các pipeline dữ liệu và machine learning bằng mã Python.
Prefect được trang bị nhiều tính năng như tự động thử lại, lập lịch, và bộ nhớ đệm, v.v. Đây là một công cụ mạnh mẽ giúp bạn xây dựng các quy trình làm việc linh hoạt và có khả năng chịu lỗi cao.
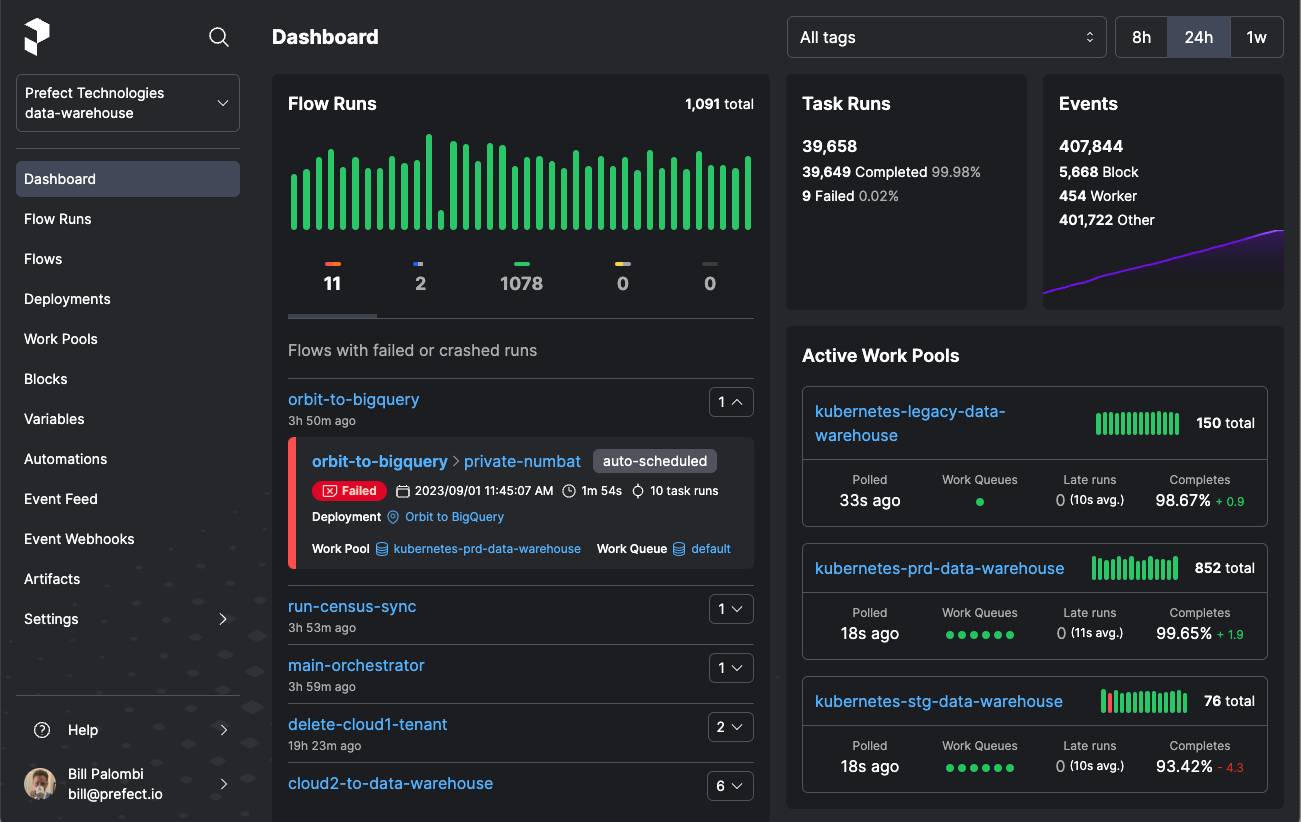
Hình ảnh Nguồn
Với Prefect, bạn có thể dễ dàng biến bất kỳ hàm Python nào thành một đơn vị công việc có thể quan sát và điều phối chỉ bằng cách thêm một vài decorator vào mã của bạn.
Prefect lý tưởng để tiêu chuẩn hóa việc phát triển và triển khai quy trình làm việc trong toàn tổ chức. Nó cung cấp khả năng quan sát toàn diện vào các quy trình và cho phép người dùng quản lý mã của mình mà không cần DAG nghiêm ngặt hay mã khuôn mẫu.
Chỉ với một lệnh, người dùng có thể dễ dàng thiết lập máy chủ điều phối của riêng mình cho mục đích phát triển. Quy trình tinh gọn này đơn giản hóa việc phát triển cục bộ và đảm bảo quá trình triển khai lên môi trường sản xuất diễn ra suôn sẻ.
Prefect cung cấp giao diện người dùng nhìn chung trực quan, nâng cao trải nghiệm bằng cách mang đến cách thức trực quan và thân thiện để chạy, giám sát, gỡ lỗi và quản lý quy trình làm việc.
Prefect cung cấp các tính năng như lập lịch, thử lại, quản lý secrets gốc, khả năng mở rộng, kiểm soát đồng thời, tùy chọn cấu hình hạ tầng và lưu trữ linh hoạt, cùng chức năng ghi log mạnh mẽ.
Người dùng có quyền lựa chọn tự lưu trữ máy chủ Prefect mã nguồn mở hoặc tận dụng các tính năng nâng cao, tính sẵn sàng cao và bảo mật tăng cường bằng cách sử dụng Prefect Cloud.
Prefect Cloud cung cấp tất cả khả năng của máy chủ Prefect mã nguồn mở cùng với các tính năng bổ sung như automations, luồng sự kiện, events, webhooks, workspaces, organizations và nhiều hơn nữa, được tối ưu cho môi trường được lưu trữ. Bạn có thể dùng Prefect Cloud miễn phí hoặc trả phí để có các tính năng mạnh hơn.
Prefect cho phép người dùng bắt đầu điều phối quy trình làm việc chỉ với một decorator, tinh gọn quy trình mà không cần các tầng trừu tượng không cần thiết để quản lý quy trình hiệu quả.
Gửi thông tin về các quy trình và pipeline Prefect tới nhiều dịch vụ nhắn tin như Slack, Discord, email, Microsoft Teams, v.v. Điều này cũng có thể cảnh báo bạn nếu quy trình làm việc gặp lỗi.
Phần này sẽ đề cập đến các thành phần chính dùng để xây dựng tasks và flows, triển khai và thực thi chúng, cũng như quản lý chúng. Việc xem lại các thành phần này là rất quan trọng trước khi đi vào hướng dẫn Python.
Prefect Task là một hàm Python được trang trí bằng decorator @task đại diện cho các đơn vị công việc rời rạc trong một quy trình làm việc Prefect. Chúng ta cũng có thể tùy chỉnh decorator task với các tham số tùy chọn như name, description, tags, cài đặt cache, retries, v.v.
Trong đoạn mã dưới đây, có ba tác vụ machine learning được tạo với decorator @task có thể tái sử dụng trên nhiều flow.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    ...
Prefect Flow là một hàm Python được trang trí bằng decorator @flow bao hàm logic của quy trình làm việc. Điều này giúp người dùng dễ dàng định nghĩa, cấu hình và thực thi các pipeline dữ liệu phức tạp một cách linh hoạt và thuận tiện.
Trong đoạn mã dưới đây, chúng ta đã tạo một Flow bằng decorator @flow. Flow này sẽ chạy tất cả các task tuần tự, lấy đầu vào từ task trước truyền sang task sau.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Deployments là các flow được lưu trên máy chủ cục bộ hoặc trên đám mây và bao gồm thông tin quan trọng để điều phối quy trình làm việc của bạn từ xa, như lập lịch và chi tiết thực thi.
Work pools đóng vai trò trung gian giữa môi trường điều phối và môi trường thực thi, cho phép lập lịch và thực thi flow run một cách hiệu quả. Người dùng có thể thiết lập Agent (worker) để chạy quy trình làm việc cục bộ hoặc tận dụng hạ tầng đám mây để thực thi liền mạch.
Tương tự như một phiên bản tính toán chuyên dụng, Work Pools quản lý phân bổ công việc và ưu tiên tác vụ hiệu quả, mang lại sự linh hoạt trong việc lựa chọn môi trường thực thi để tối ưu hiệu năng và khả năng mở rộng của quy trình.
Trong phần này, chúng ta sẽ tạo, kiểm thử, triển khai và thực thi một quy trình làm việc machine learning đơn giản bằng Prefect. Chúng ta cũng sẽ thiết lập thông báo để nhận thông tin về trạng thái flow run trên máy chủ Discord của mình.
Cài đặt gói Python bằng PIP
pip install -U prefectNếu bạn muốn sử dụng phiên bản mới nhất của Prefect, bạn có thể lấy mã trực tiếp từ GitHub.
pip install -U git+https://github.com/PrefectHQ/prefectChúng ta sẽ tiền xử lý dữ liệu Bank Churn từ Kaggle, sau đó dùng scikit-learn để huấn luyện và đánh giá mô hình Random Forest Classifiers.
Đoạn mã chúng ta sẽ dùng là phiên bản đã chỉnh sửa từ: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Hãy xem hướng dẫn đó nếu bạn muốn tìm hiểu thêm cách mô hình được huấn luyện. Prefect Flow machine learning của chúng ta gồm bảy tác vụ:
Hiện chúng ta đã ghép tất cả tác vụ cần thiết vào một hàm @flow có tên ml_workflow. Ngoài ra, chúng ta đã thêm các tham số bổ sung trong decorator để bật ghi log chi tiết.
Hàm ml_workflow nhận vị trí tệp dữ liệu làm đầu vào rồi nối các tác vụ theo chuỗi. Chúng ta sẽ có thể trực quan hóa quy trình này tốt hơn khi triển khai và thực thi nó trên máy chủ Prefect.
Bạn cũng có thể theo dõi các thí nghiệm machine learning bằng MLflow. Hãy tham gia khóa Giới thiệu về MLflow để tìm hiểu về theo dõi MLflow, projects, models và model registry.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
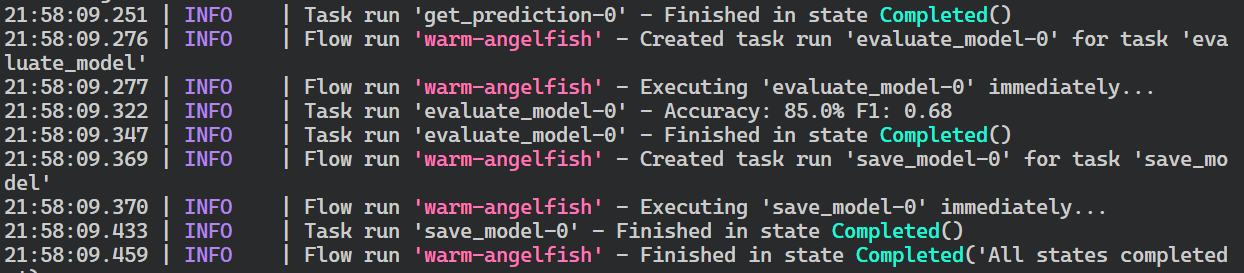
Để kiểm thử Prefect Flow của chúng ta, hãy chạy tệp Python trong terminal.
$ python main.pyFlow đã hoàn tất thành công. Nó đã hiển thị các chỉ số của mô hình và lưu trọng số mô hình.
Nếu bạn mới làm quen với machine learning và muốn học cách tiền xử lý dữ liệu, huấn luyện mô hình, tối ưu hóa, đánh giá và lưu mô hình, bạn nên cân nhắc theo học lộ trình sự nghiệp Machine Learning Scientist with Python. Khóa học này sẽ dạy bạn mọi thứ cần biết từ những bước đầu tiên.
Xây dựng và chạy một pipeline machine learning thủ công là một nhiệm vụ đơn giản có thể thực hiện được ngay cả với các pipeline của scikit-learn.
Tuy nhiên, việc sử dụng Prefect mang lại nhiều lợi ích, bao gồm:
Bây giờ, chúng ta sẽ học cách tự động hóa quy trình làm việc bằng cách triển khai nó lên máy chủ Prefect cục bộ.
Trước tiên, chúng ta phải xây dựng “Deployment” bằng cách cung cấp tên tệp và tên hàm flow. Chúng ta cũng thêm thẻ “dev” cho Deployment của mình.
Lưu ý: tags trong Prefect có thể được dùng để phân loại và tổ chức flows, tasks và deployments trong hệ sinh thái Prefect.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devDeployment đã được tạo thành công. Bây giờ, nó cung cấp cho chúng ta hướng dẫn cách thực thi flow bằng Prefect Agent.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Prefect agents chịu trách nhiệm giám sát các work pool để xác định các flow run sẵn sàng và triển khai chúng tới môi trường thực thi.
Một work pool có thể có nhiều agent, mỗi agent có ID riêng để tránh chồng chéo và đảm bảo khả năng mở rộng trơn tru.
Bây giờ, chúng ta sẽ khởi tạo Prefect agent trong một terminal mới với tên work pool mặc định.
$ prefect agent start -p 'default-agent-pool'
Chuyển sang một terminal mới và chạy deployment bằng cách cung cấp “tên_hàm_flow/tên_deployment”. Bạn cũng có thể chỉ dùng tên deployment để thực thi flow.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Nó đã tạo một flow run cho deployment, sẽ kiểm tra worker và bắt đầu chạy quy trình làm việc.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
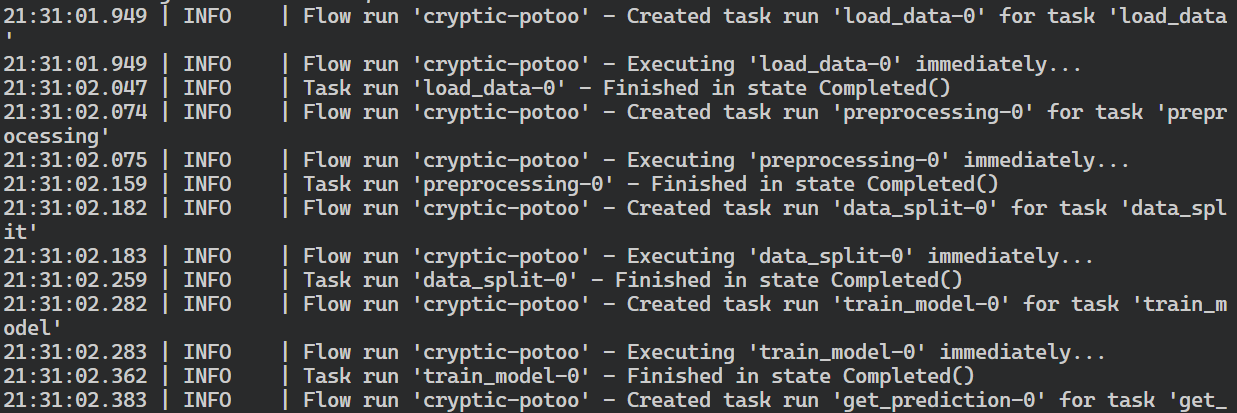
Chuyển sang terminal nơi chúng ta đã khởi tạo agent để xem log của flow run. Prefect agent đã thực thi thành công tất cả tác vụ trong flow.
Đây là một ví dụ đơn giản. Chúng ta cũng có thể lập lịch hoặc tự động hóa quy trình bằng cách cung cấp các tham số bổ sung cho lệnh build Deployment.
Cho đến giờ, chúng ta đã quan sát quy trình làm việc trong các terminal. Bây giờ, hãy khởi chạy bảng điều khiển Prefect, nơi chúng ta có thể xem tất cả flow run, deployments, work pool và thông báo.
Khởi động máy chủ Perfect trong một terminal mới và nhấp vào liên kết cục bộ được cung cấp để truy cập bảng điều khiển.
$ prefect server start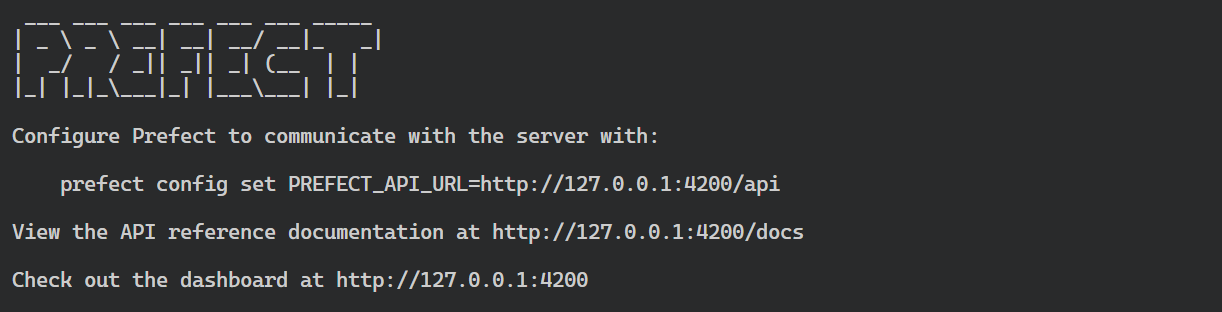
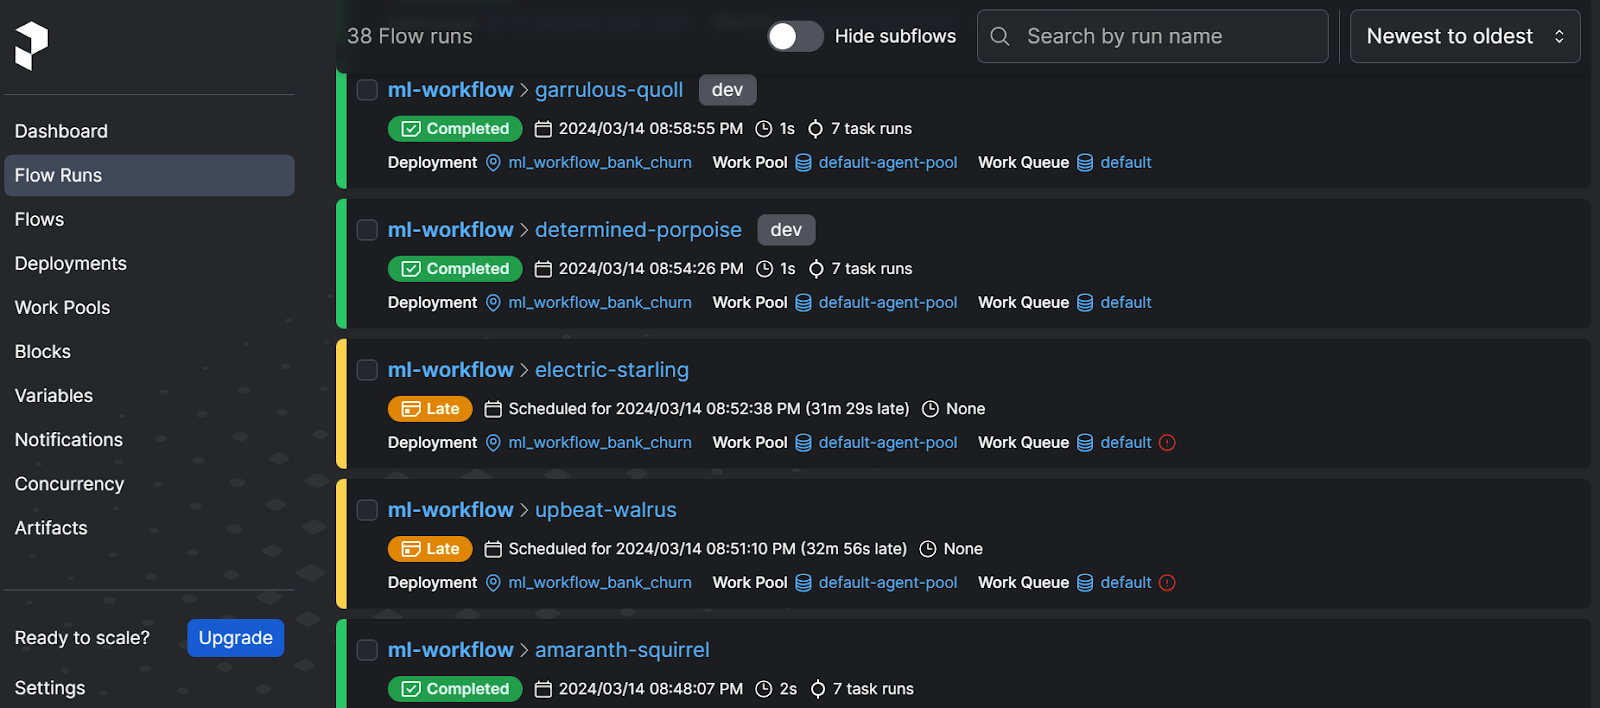
Để xem tất cả các flow đã chạy trước đó, hãy nhấp vào tùy chọn "Flow" trong bảng điều khiển bên trái. Bạn có thể nhận thấy một số flow không được thực thi do thiếu work pool, trong khi một số khác được thực thi mà không có thẻ "dev" trong giai đoạn thử nghiệm.
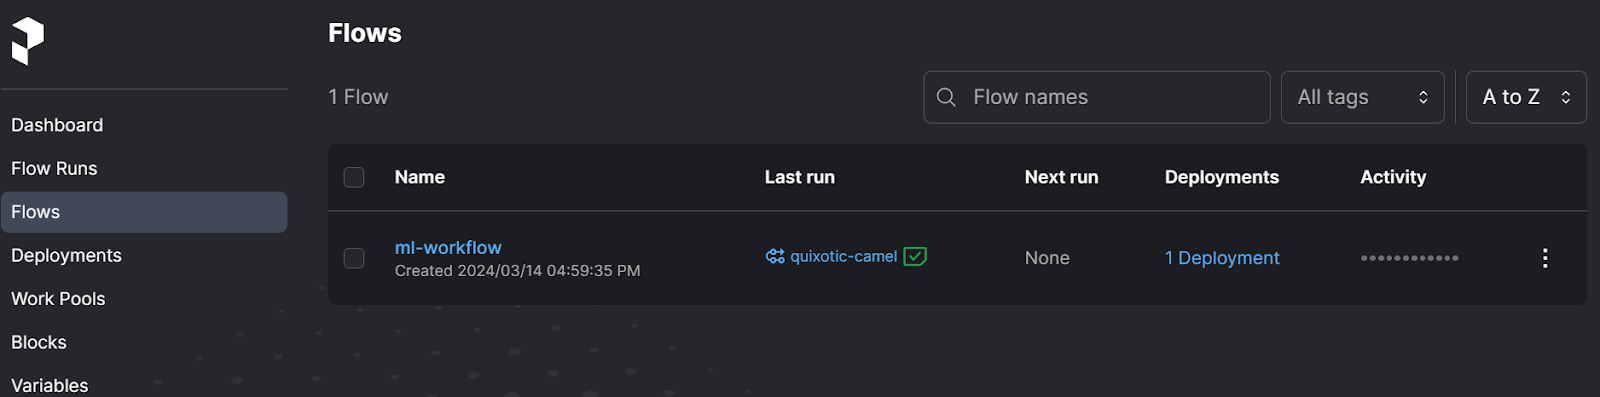
Nhấp vào tùy chọn Flows sẽ hiển thị tất cả các flow hiện có. Nhiều flow có thể tồn tại trong một deployment.
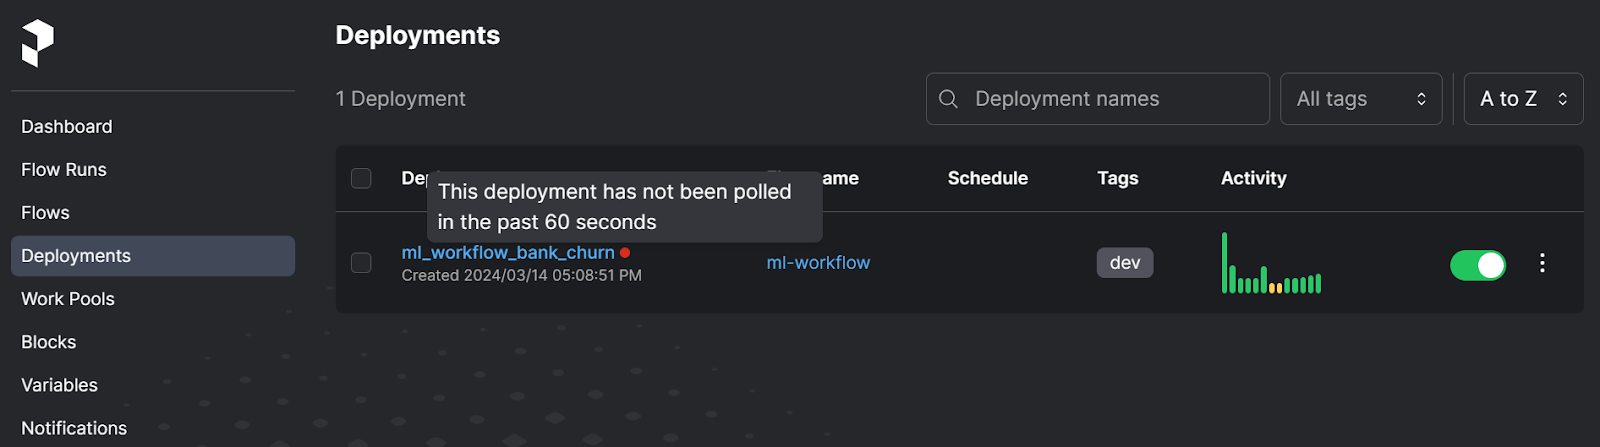
Trong phần Deployment, chúng ta có thể xem Deployment hiện tại cùng với hoạt động và các thẻ của nó. Tại đây, chúng ta có thể dễ dàng chạy flow bằng tùy chọn quick run hoặc lên lịch chạy bằng giao diện người dùng.
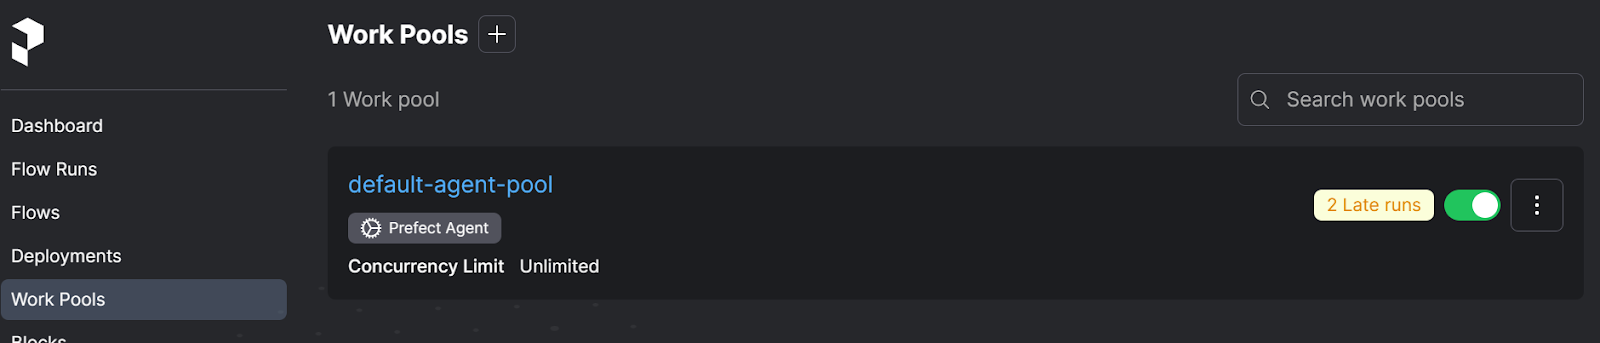
Trong Work Pools, bạn sẽ thấy Prefect Agent mặc định của chúng ta. Bạn thậm chí có thể thiết lập work pool đám mây bằng Prefect CLI.
Hãy bắt đầu với phần thú vị.
Không ai muốn giám sát quy trình làm việc 24/7. Thay vào đó, chúng ta muốn nhận thông báo về trạng thái quy trình trên ứng dụng nhắn tin ưa thích. Nhờ vậy, chúng ta có thể xử lý vấn đề nhanh chóng.
Để làm được điều này, chúng ta sẽ tạo một webhook Discord. Sử dụng webhook ID và token, chúng ta sẽ thiết lập thông báo của Prefect. Nó sẽ gửi toàn bộ thông tin log đến máy chủ Discord.
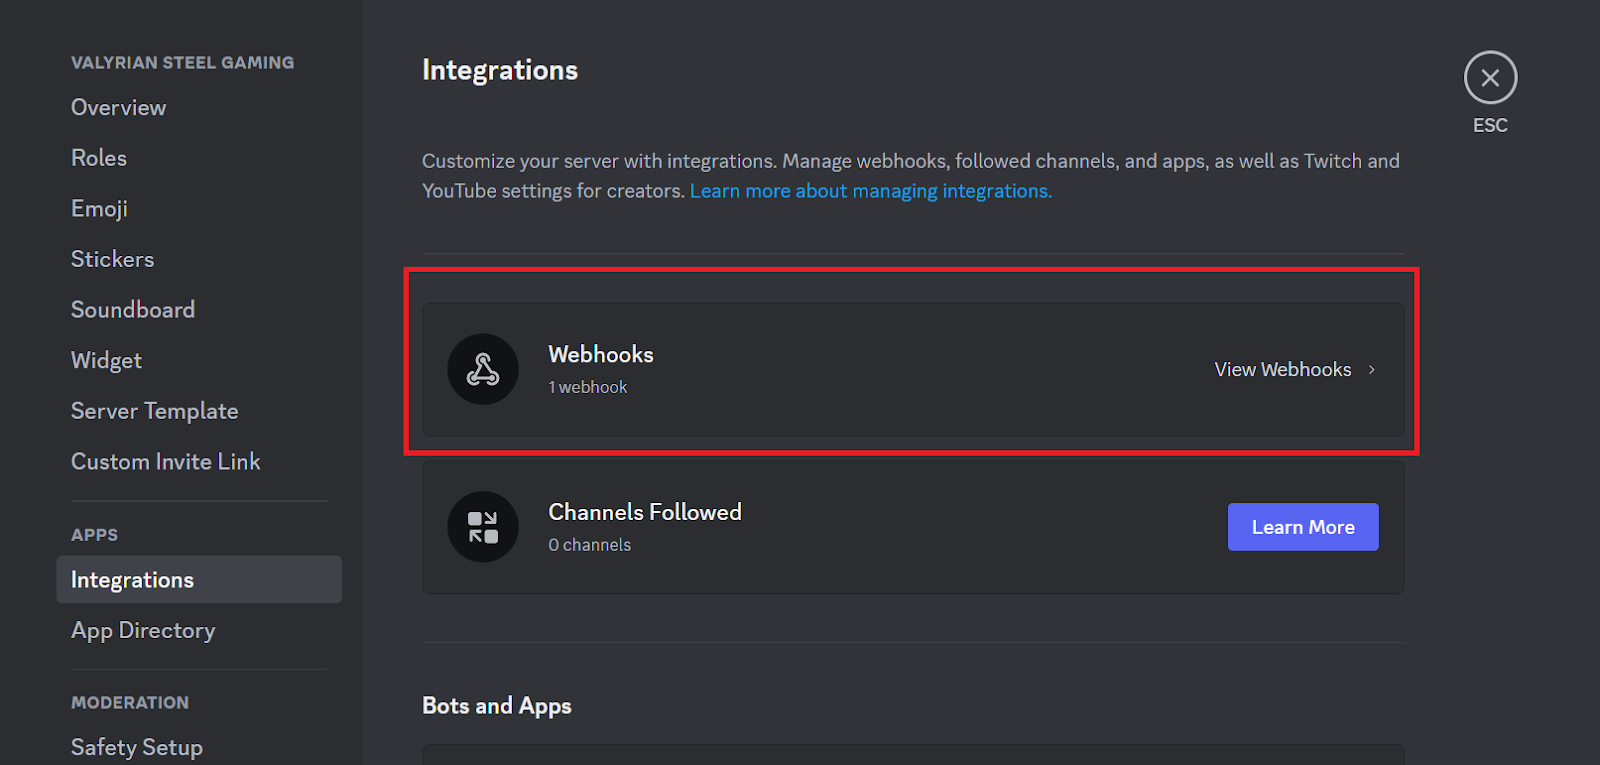
Để tạo webhook, hãy vào cài đặt máy chủ Discord của bạn, nhấp vào "Integrations" và chọn "View Webhooks". Sau đó, nhấp "New Webhook".
Thay đổi ảnh hiển thị, tên và kênh. Sau đó sao chép URL Webhook.
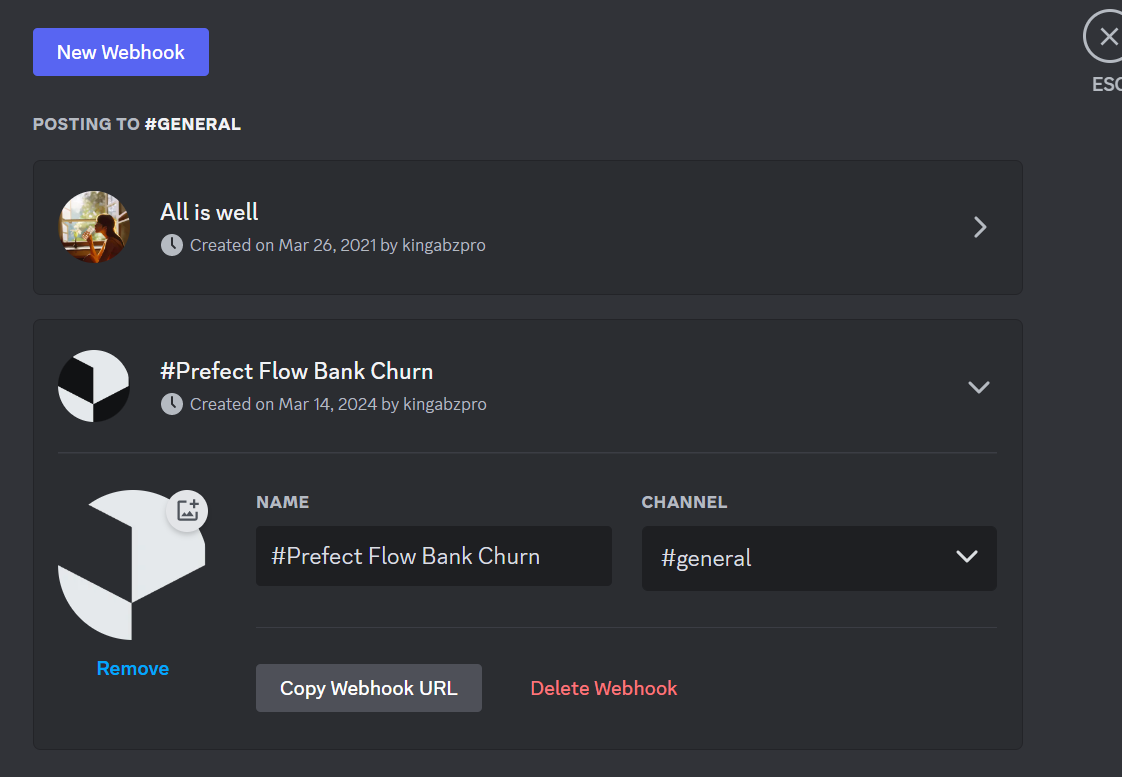
URL webhook gồm hai phần, cụ thể là Webhook Id và Webhook token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Để tạo thông báo trong Prefect, chúng ta cần tách thủ công hai phần này từ liên kết.
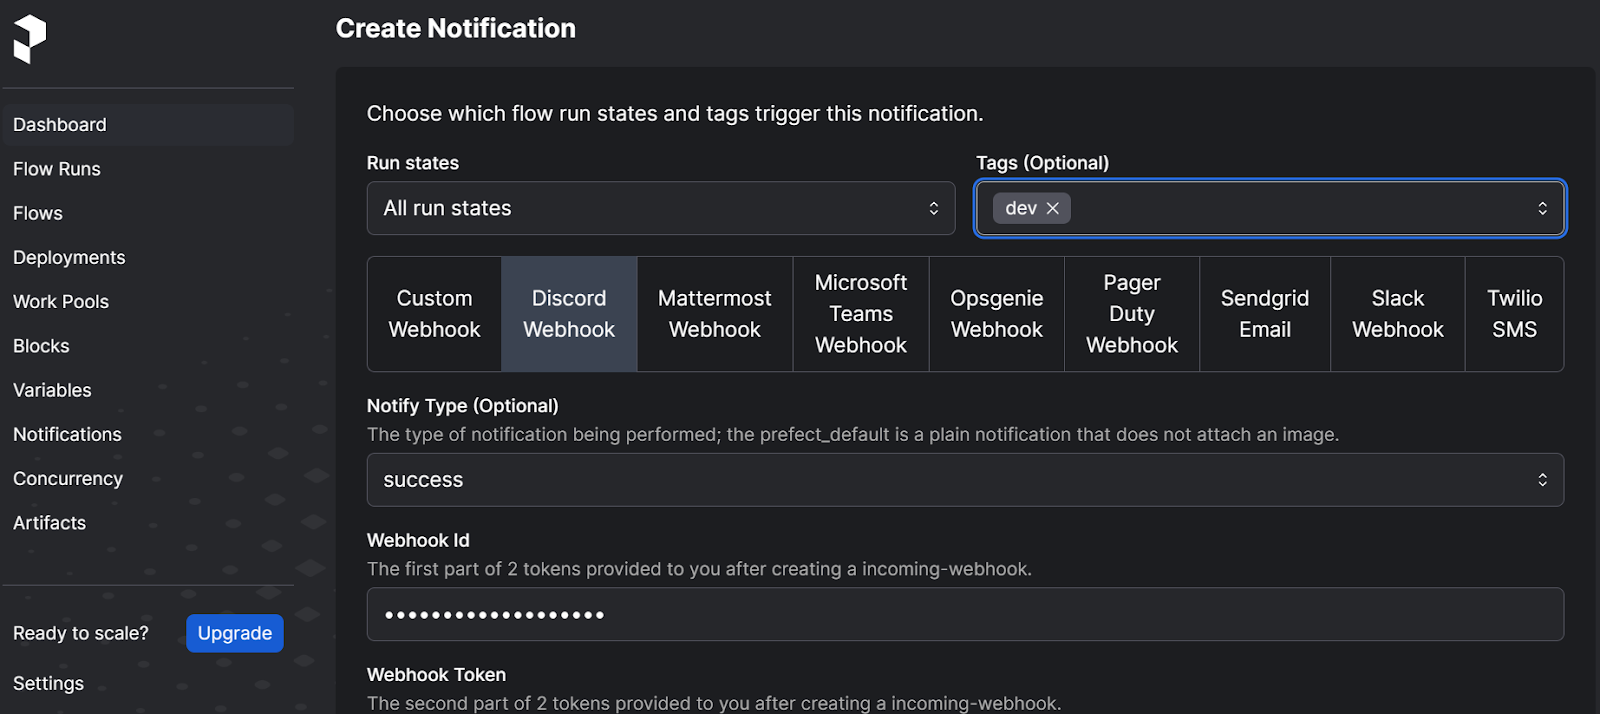
Để tạo thông báo Discord trên giao diện Prefect, hãy vào tùy chọn "Notifications" và nhấp nút "+" ở phía trên. Sau đó, chọn trạng thái chạy mong muốn, thẻ, Discord webhook và loại thông báo.
Tiếp theo, cung cấp Webhook ID và Webhook token rồi nhấp nút "Create" màu xanh.
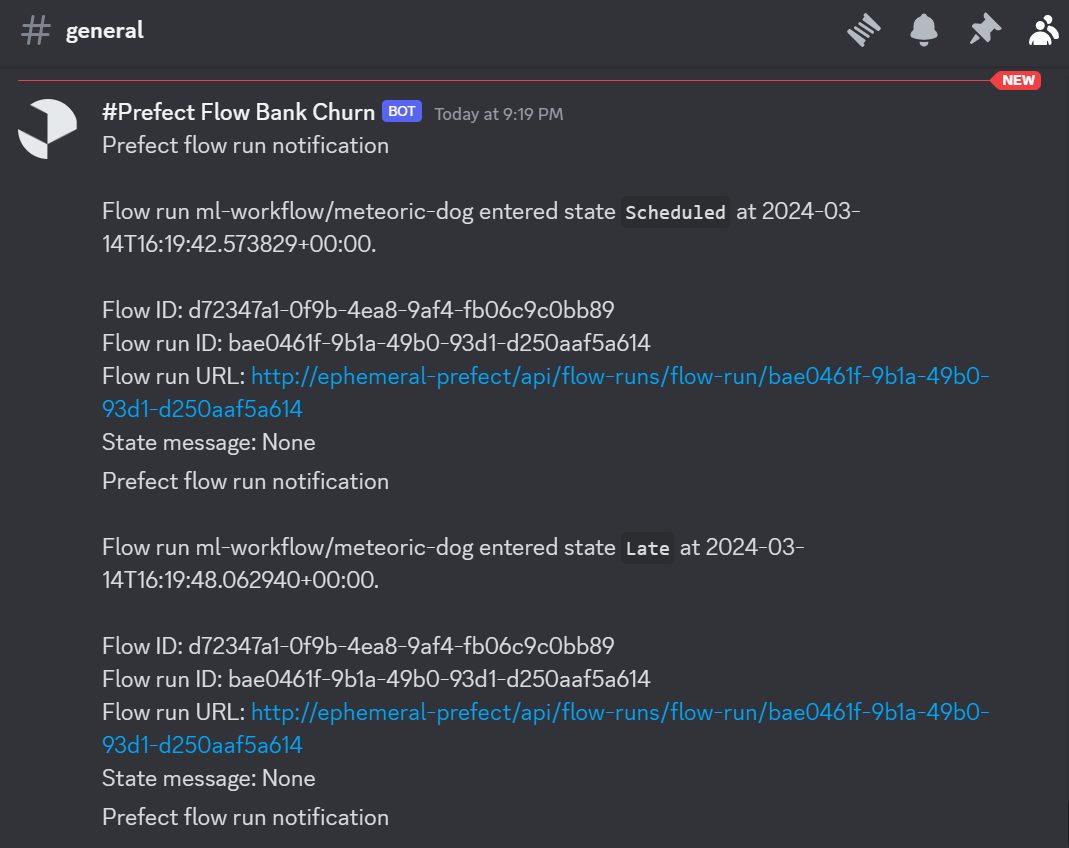
Chúng ta cần thực thi deployment để thấy thông báo trên kênh chính của máy chủ Discord.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Tuyệt vời. Bằng cách tương tự, chúng ta có thể thiết lập nhiều dịch vụ nhắn tin như Microsoft Teams, Slack, SMS và email, và thậm chí tự tạo webhook tùy chỉnh.
Hãy tham gia khóa Thiết kế quy trình làm việc Machine Learning bằng Python để học cách xây dựng các pipeline bền vững theo thời gian.
Sau khi triển khai flow machine learning cục bộ, đã đến lúc triển khai nó lên Prefect Cloud. Đây là quy trình dễ dàng hơn nhiều so với triển khai cục bộ, vì bạn không phải khởi động bất kỳ máy chủ hay agent nào hoặc thực thi các lượt chạy bằng công cụ CLI. Mọi thứ đều do Prefect quản lý.
Trước khi triển khai flow hiện tại, cần lưu ý rằng nó sẽ phát sinh lỗi vì cố gắng truy cập tệp và dữ liệu từ thư mục cục bộ không thể truy cập trên đám mây. Để làm cho các tệp này khả dụng với Prefect Cloud, chúng ta phải tạo và đẩy mã của mình lên một kho GitHub công khai.
Điều này có thể thực hiện dễ dàng qua trang web GitHub hoặc bằng tiện ích mở rộng Git của VSCode để tạo kho từ xa và đẩy mã qua giao diện người dùng.
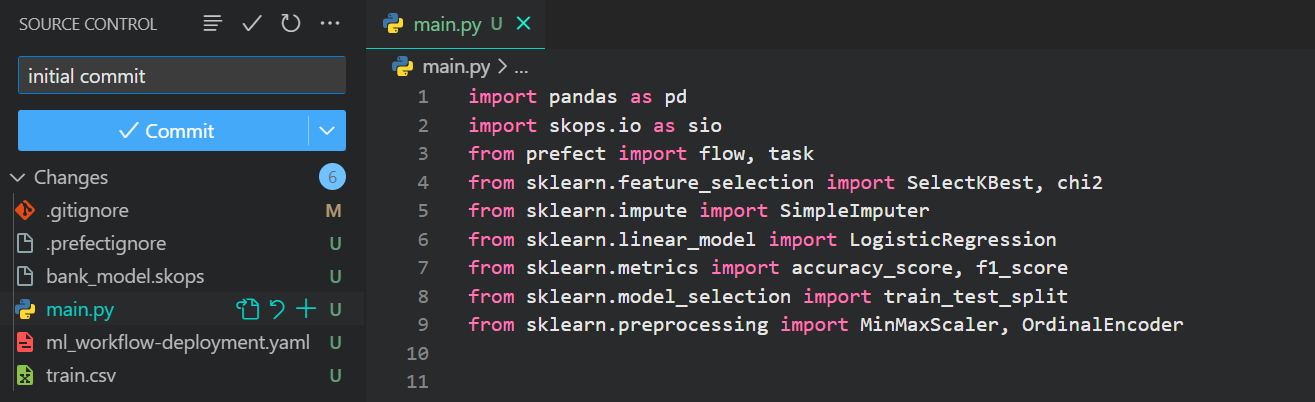
Đây là kho dự án mà chúng ta sẽ dùng cho các triển khai đám mây: kingabzpro/ML-Workflow-Orchestration-With-Prefect
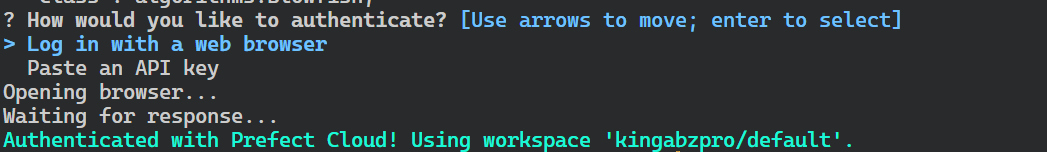
Tạo tài khoản Prefect Cloud của bạn bằng cách truy cập https://app.prefect.cloud/auth/login rồi đăng nhập bằng công cụ Prefect CLI.
$ prefect cloud loginChỉ cần chọn "Đăng nhập bằng trình duyệt web" và làm theo các bước để xác thực máy khách cục bộ với Prefect Cloud.
Chúng ta sẽ tạo một work pool do Prefect quản lý để tận dụng tối đa hạ tầng của Prefect Cloud thay vì dùng agent chạy cục bộ.
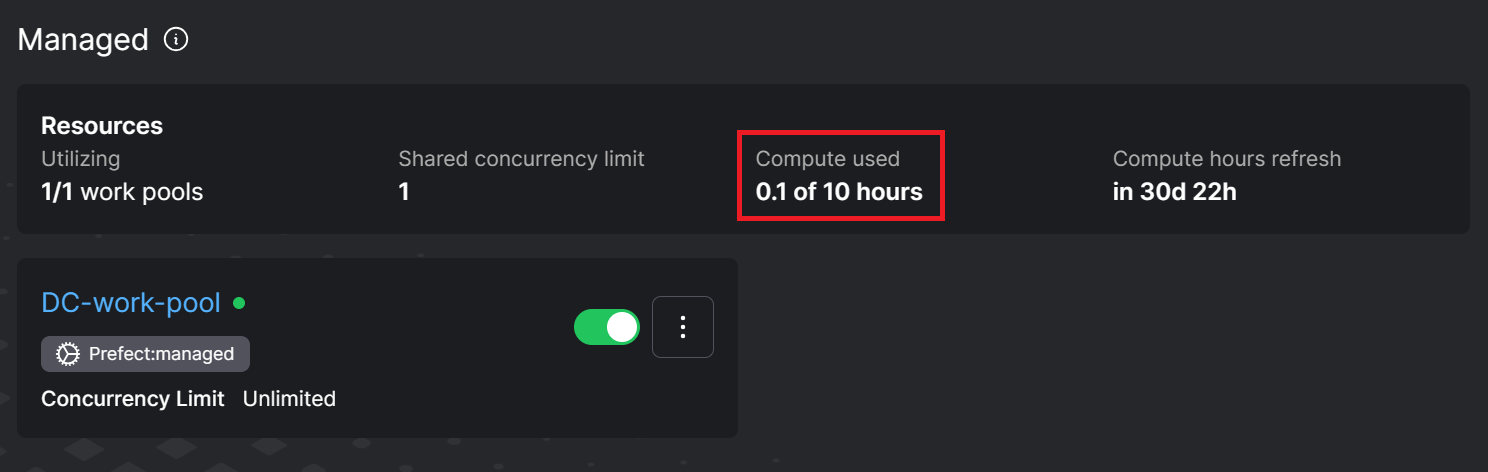
$ prefect work-pool create DC-work-pool --type prefect:managedVới tài khoản miễn phí, Prefect cung cấp 10 giờ máy tính miễn phí mỗi tháng để bạn thử nghiệm và khám phá.
Bây giờ chúng ta sẽ triển khai flow lên Prefect Cloud bằng lập trình.
Tạo tệp mới tên deployment.py.
Thiết lập tham số cho hàm flow của Prefect:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Chạy mã Python.
$ python deployment.pyFlow đã được triển khai lên Prefect Cloud. Có thể thực thi qua CLI hoặc bảng điều khiển Prefect Cloud.
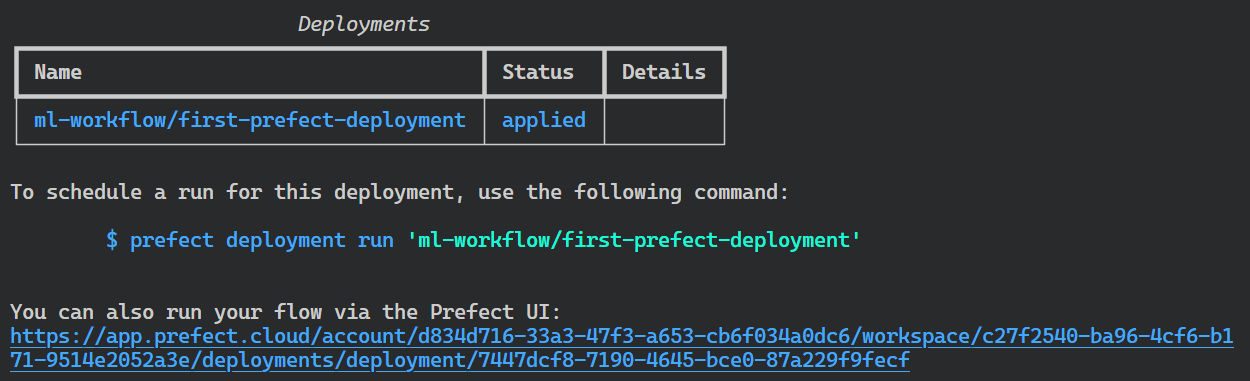
Để chạy flow, chúng ta cần truy cập trang web: https://app.prefect.cloud/. Sau đó, vào phần “Deployments” và nhấp vào nút ba chấm dọc trên deployment của bạn, rồi chọn tùy chọn “Quick run”.
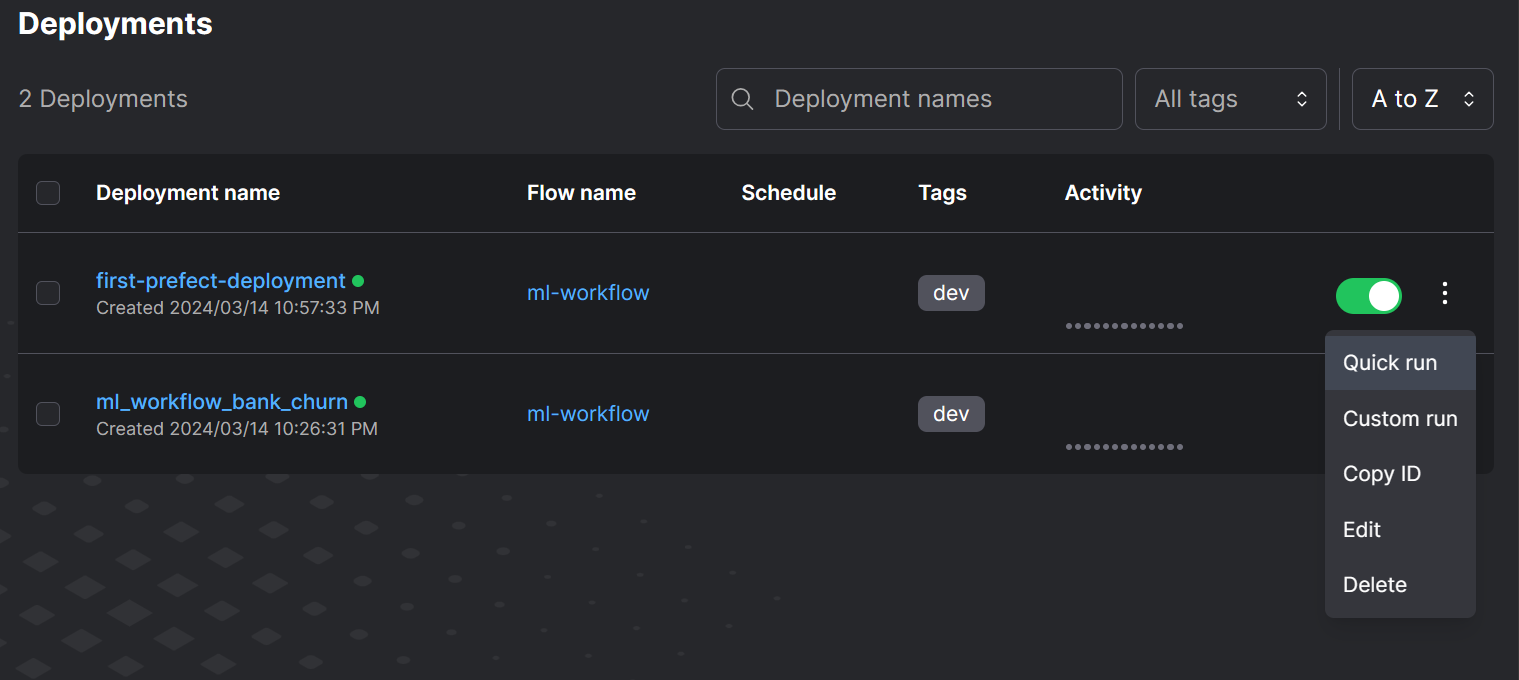
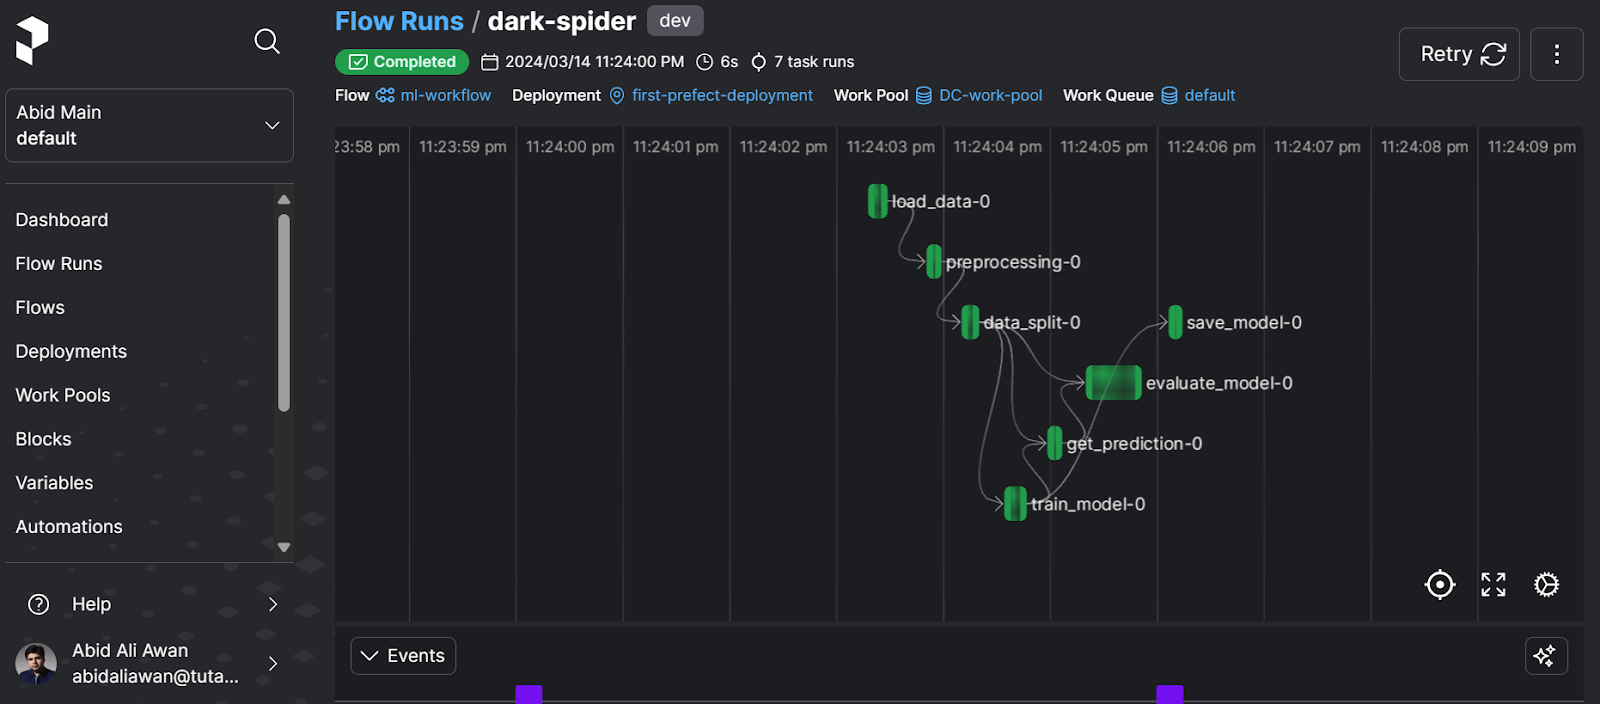
Để xem lượt chạy của chúng ta hoạt động thế nào, hãy vào phần “Flow Run” và nhấp vào lượt chạy gần nhất để xem biểu đồ workflow.
Sơ đồ flow cho thấy tổng quan về sự kết nối giữa các tác vụ và thời gian thực hiện của từng tiến trình.
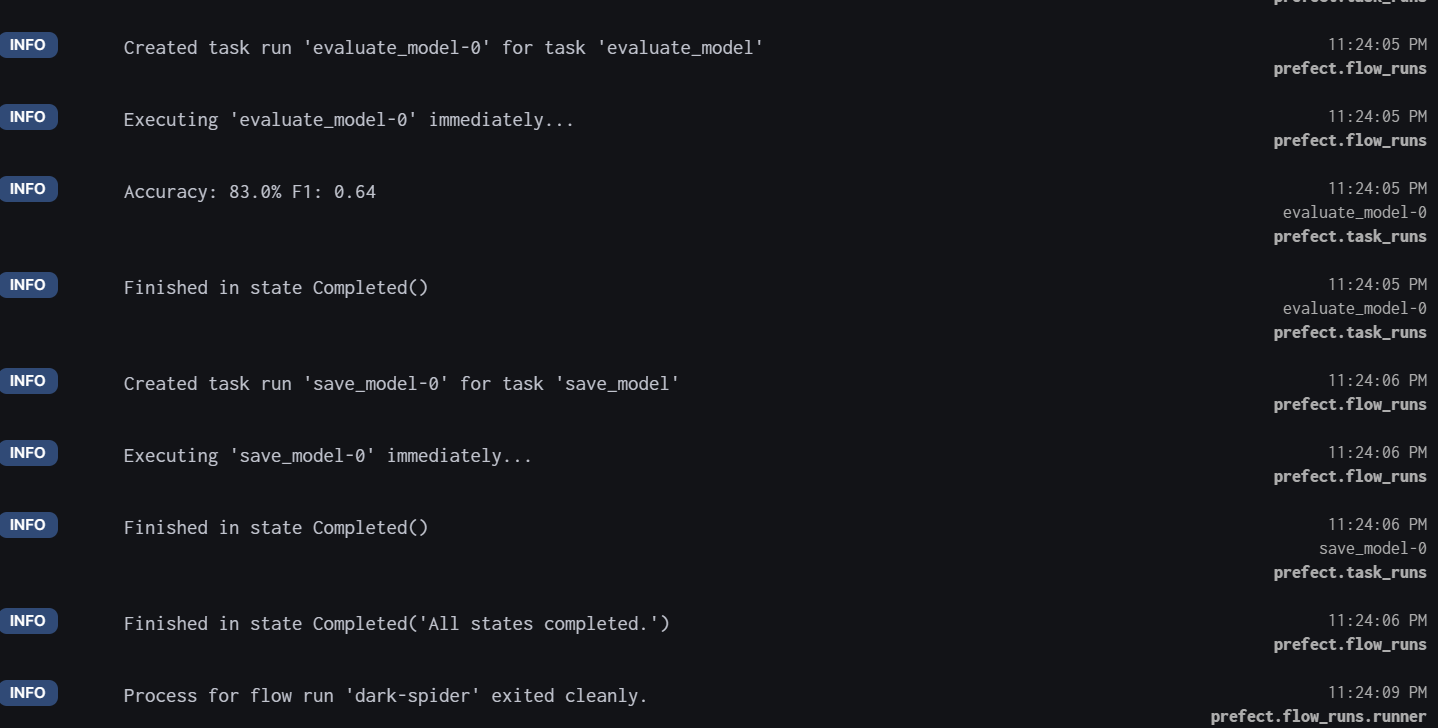
Để xem log chi tiết, hãy cuộn xuống và xem tất cả tác vụ đã thực hiện kèm dấu thời gian.
Nếu vào phần “Work Pools”, chúng ta có thể thấy rõ rằng mình đã sử dụng 0,1 giờ trong giới hạn 10 giờ cho người dùng miễn phí.
Hãy xem hướng dẫn Quy trình làm việc Machine Learning, trong đó có đồ họa minh họa giúp bạn hiểu các tác vụ trong khởi tạo dự án, chuẩn bị dữ liệu, xây dựng mô hình và triển khai.
Thiết lập một quy trình machine learning đơn lẻ khá dễ dàng. Trong các tình huống thực tế, bạn có thể cần chạy đồng thời nhiều quy trình machine learning và dữ liệu. Đây là lúc Prefect tỏa sáng. Nó mang đến khả năng mở rộng và linh hoạt trong việc lựa chọn chạy trên môi trường cục bộ hay đám mây cho máy chủ Prefect hoặc work pools. Đây là công cụ tuyệt vời để lập lịch, tự động hóa và quản lý quy trình làm việc.
Trong hướng dẫn này, chúng ta đã điểm qua các tính năng và chức năng chính của hệ sinh thái Prefect. Chúng ta cũng đã học cách triển khai một flow machine learning cục bộ và trên đám mây. Để tiếp tục hành trình MLOps, bước tiếp theo là học cách xây dựng CI/CD cho quy trình machine learning bằng cách theo dõi "Hướng dẫn CI/CD cho Machine Learning dành cho người mới bắt đầu."
Prefect chỉ là một công cụ trong lĩnh vực MLOps dùng để điều phối quy trình làm việc. Để tìm hiểu về các công cụ quan trọng khác cho quản lý phiên bản dữ liệu, kho đặc trưng, kiểm thử mô hình, triển khai và phục vụ mô hình, giám sát mô hình, công cụ runtime, và bộ công cụ MLOps đầu-cuối, hãy đọc bài viết 25 công cụ MLOps hàng đầu bạn cần biết trong 2024. Bạn cũng có thể đọc so sánh Prefect vs Airflow để xem hai công cụ khác nhau thế nào.
Tiếp tục hành trình Machine Learning của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
