
Corso
Progettare workflow di Machine Learning in Python
4 ore
12.8K
In questo tutorial esploreremo Prefect approfondendone le funzionalità principali, i vantaggi e i componenti. Vedremo come creare task e flow, gestire le deployment ed eseguire le run dei flow. Infine, ti guideremo nel distribuire il tuo workflow su Prefect Cloud ed eseguirlo usando un'infrastruttura cloud.
Se ti interessa automatizzare pipeline di machine learning usando GitHub Actions e Data Version Control, dai un'occhiata al nostro corso CI/CD per il Machine Learning.
Prefect è un potente strumento open-source per l'orchestrazione dei workflow che consente di progettare, monitorare e gestire pipeline di dati e di machine learning usando codice Python.
Prefect è dotato di un'ampia gamma di funzionalità, come retry automatici, schedulazione e caching, per citarne alcune. È uno strumento potente che ti permette di costruire workflow resilienti e dinamici.
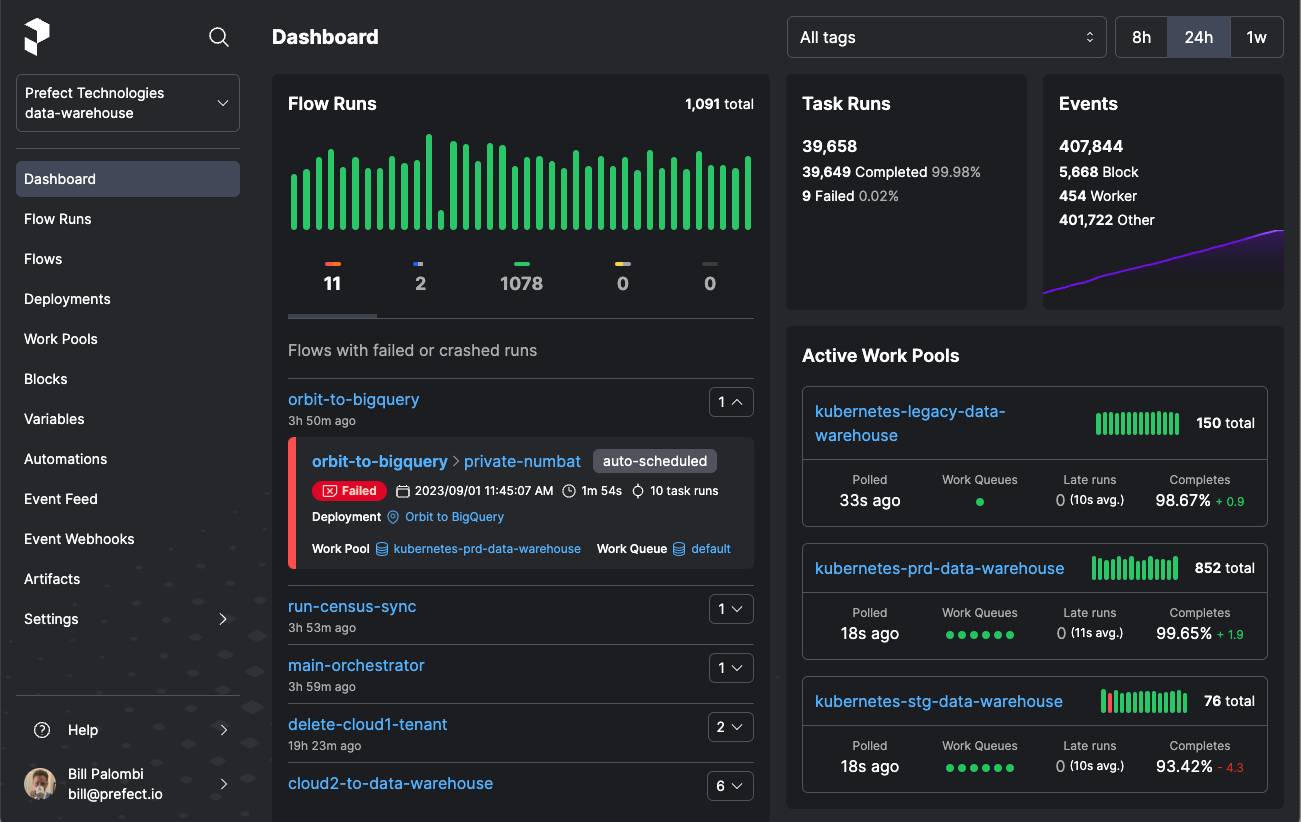
Immagine Fonte
Con Prefect, puoi trasformare facilmente qualsiasi funzione Python in un'unità di lavoro osservabile e orchestrabile semplicemente aggiungendo pochi decorator al tuo codice.
Prefect è ideale per standardizzare lo sviluppo e la distribuzione dei workflow in tutta l'organizzazione. Offre piena osservabilità sui workflow e permette di gestire il codice senza dover ricorrere a rigidi DAG o boilerplate.
Con un singolo comando, gli utenti possono configurare senza sforzo il proprio server di orchestrazione per lo sviluppo. Questo processo snello semplifica lo sviluppo locale e garantisce una distribuzione fluida in produzione.
Prefect offre un'interfaccia generalmente intuitiva, migliorando l'esperienza d'uso con un modo visivamente gradevole e semplice per eseguire, monitorare, effettuare il debug e gestire i workflow.
Prefect include funzionalità come schedulazione, retry, gestione nativa dei secret, capacità di scaling, controllo della concorrenza, opzioni flessibili di configurazione dell'infrastruttura e dello storage, e un robusto sistema di logging.
Gli utenti possono scegliere se effettuare il self-hosting di un server Prefect open-source oppure sfruttare funzionalità avanzate, alta disponibilità e maggiore sicurezza utilizzando Prefect Cloud.
Prefect Cloud offre tutte le capacità del server Prefect open-source insieme a funzionalità aggiuntive come automations, feed di eventi, eventi, webhook, workspace, organizzazioni e altro, pensate per un ambiente hosted. Puoi usare Prefect Cloud gratuitamente o pagare per funzionalità più robuste.
Prefect consente di avviare l'orchestrazione dei workflow con un singolo decorator, semplificando il processo senza astrazioni inutili per una gestione efficiente.
Invia informazioni sui workflow e le pipeline di Prefect a vari servizi di messaggistica come Slack, Discord, email, Microsoft Teams e altri. Puoi anche ricevere avvisi in caso di fallimento del workflow.
Questa sezione copre i componenti chiave usati per costruire task e flow, distribuirli, eseguirli e gestirli. È fondamentale rivedere questi componenti prima di passare al tutorial in Python.
Un Task di Prefect è una funzione Python decorata con il decorator @task che rappresenta unità di lavoro discrete all'interno di un workflow Prefect. Possiamo anche personalizzare il decorator del task con argomenti opzionali come nome, descrizione, tag, impostazioni di cache, retry e altro.
Nel codice seguente, ci sono tre task di machine learning creati con il decorator @task che possono essere riutilizzati tra i flow.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Un Flow di Prefect è una funzione Python decorata con il decorator @flow che incapsula la logica del workflow. Questo rende più semplice definire, configurare ed eseguire pipeline di dati complesse con flessibilità e facilità.
Nel codice seguente, abbiamo creato un Flow usando il decorator @flow. Il flow eseguirà tutti i task in sequenza, passando gli input da uno all'altro.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Le deployment sono flow archiviati sul server locale o sul cloud e includono informazioni importanti per orchestrare il tuo workflow da remoto, come dettagli di schedulazione ed esecuzione.
I work pool fungono da mediatori tra gli ambienti di orchestrazione ed esecuzione, consentendo una schedulazione ed esecuzione efficienti delle run dei flow. Gli utenti possono configurare i propri Agent (worker) per eseguire i workflow in locale o sfruttare l'infrastruttura cloud per un'esecuzione senza interruzioni.
Analogamente a un'istanza di calcolo dedicata, i Work Pool gestiscono in modo efficiente l'assegnazione del lavoro e la priorità dei task, offrendo flessibilità nella scelta dell'ambiente di esecuzione per prestazioni e scalabilità ottimali.
In questa sezione creeremo, testeremo, distribuiremo ed eseguiremo un semplice workflow di machine learning usando Prefect. Imposteremo anche le notifiche per essere avvisati sul nostro server Discord sullo stato delle run del flow.
Installa il pacchetto Python usando PIP
pip install -U prefectSe vuoi usare l'ultima versione di Prefect, puoi ottenere il codice direttamente da GitHub.
pip install -U git+https://github.com/PrefectHQ/prefectPreprocesseremo il dataset Bank Churn da Kaggle, poi useremo scikit-learn per addestrare e valutare un modello di Random Forest Classifiers.
Il codice che useremo è una versione modificata di quello da: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Dai un'occhiata a quel tutorial se ti interessa capire meglio come è stato addestrato il modello. Il nostro Flow di machine learning in Prefect è composto da sette task:
Ora abbiamo assemblato tutti i task necessari in una funzione @flow chiamata ml_workflow. Inoltre, abbiamo aggiunto argomenti extra nel decorator per abilitare un logging dettagliato.
La funzione ml_workflow prende come input il percorso del file dei dati e poi collega vari task in catena. Potremo visualizzare meglio questo workflow quando lo distribuiremo ed eseguiremo sul server Prefect.
Possiamo anche tracciare i nostri esperimenti di machine learning usando MLflow. Segui il corso Introduction to MLflow per imparare a usare MLflow tracking, projects, models e model registry.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
Per testare il nostro Flow di Prefect, esegui il file Python nel terminale.
$ python main.pyIl flow è stato completato con successo. Ha mostrato le metriche del modello e salvato i pesi.
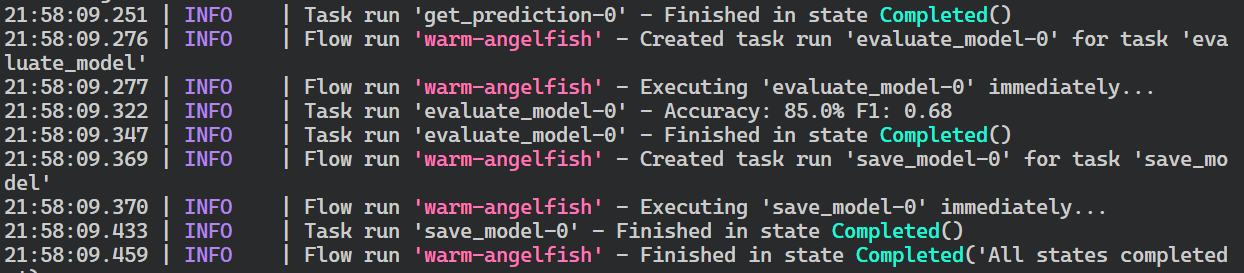
Se sei alle prime armi con il machine learning e vuoi imparare a preprocessare i tuoi dati, addestrare il modello, ottimizzarlo, valutarlo e salvarlo, prendi in considerazione il career track Machine Learning Scientist with Python. Questo percorso ti insegnerà tutto ciò che ti serve fin dall'inizio.
Costruire ed eseguire manualmente una pipeline di machine learning è un compito semplice che si può realizzare anche con le pipeline di scikit-learn.
Tuttavia, usare Prefect porta diversi vantaggi. Tra questi:
Ora impareremo ad automatizzare il nostro workflow distribuendolo sul server locale di Prefect.
Per prima cosa, dobbiamo creare la "Deployment" fornendo i nomi del file e della funzione del flow. Aggiungiamo anche il tag "dev" alla nostra Deployment.
Nota: i tag in Prefect possono essere usati per categorizzare e organizzare flow, task e deployment nell'ecosistema Prefect.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devLa deployment è stata creata con successo. Ora ci fornisce istruzioni su come eseguire il flow usando il Prefect Agent.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'I Prefect agent sono responsabili del monitoraggio dei work pool per identificare le run di flow disponibili e distribuirle nell'ambiente di esecuzione.
Un singolo work pool può avere più agent, ciascuno con un ID univoco per evitare sovrapposizioni e garantire uno scaling senza problemi.
Ora inizializzeremo i Prefect agent in un nuovo terminale con il nome del work pool predefinito.
$ prefect agent start -p 'default-agent-pool'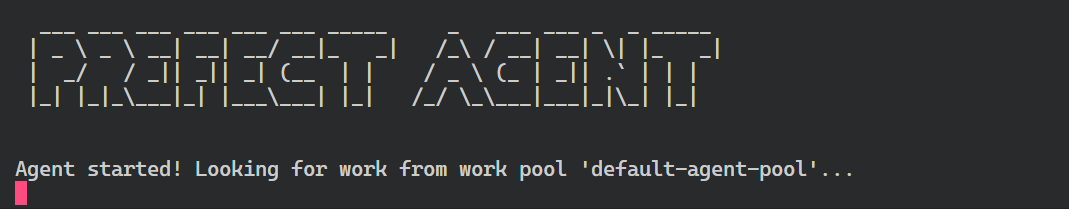
Vai in un nuovo terminale ed esegui la deployment fornendole "nome_funzione_flow/nome_deployment". Puoi anche usare solo il nome della deployment per eseguire il flow.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'È stata creata una flow run per la deployment che controllerà la presenza di worker e avvierà l'esecuzione del workflow.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
Passa al terminale in cui abbiamo avviato l'agent per vedere i log della nostra flow run. Il Prefect agent ha eseguito con successo tutti i task del flow.
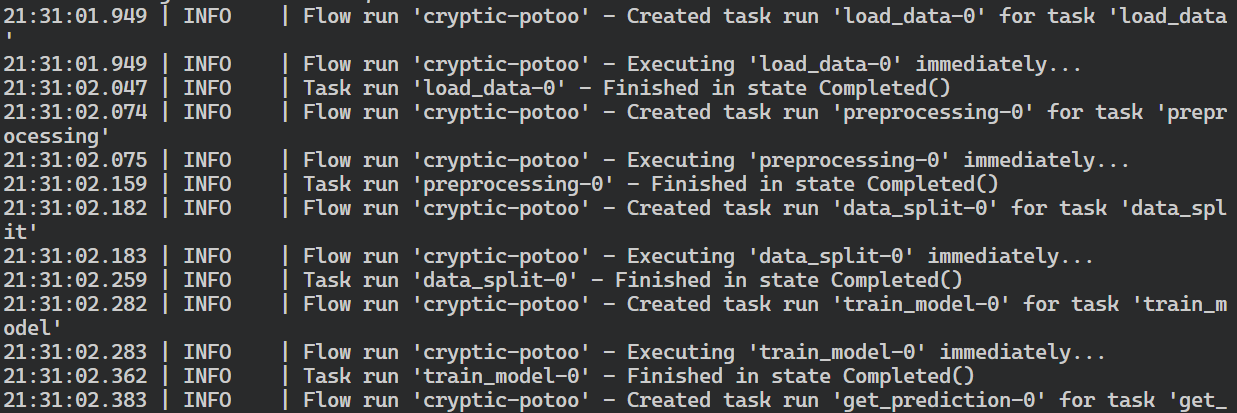
Questo è un esempio semplice. Possiamo anche schedulare o automatizzare il workflow fornendo argomenti aggiuntivi al build della Deployment.
Finora abbiamo osservato il nostro workflow nei terminali. Ora, avviamo una dashboard di Prefect dove possiamo vedere tutte le run dei flow, le deployment, i work pool e le notifiche.
Avvia il server Prefect in un nuovo terminale e clicca sul link locale fornito per accedere alla dashboard.
$ prefect server start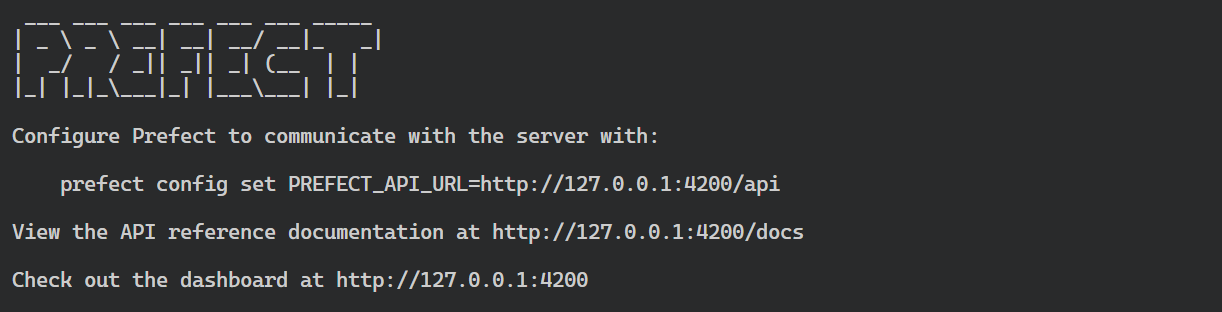
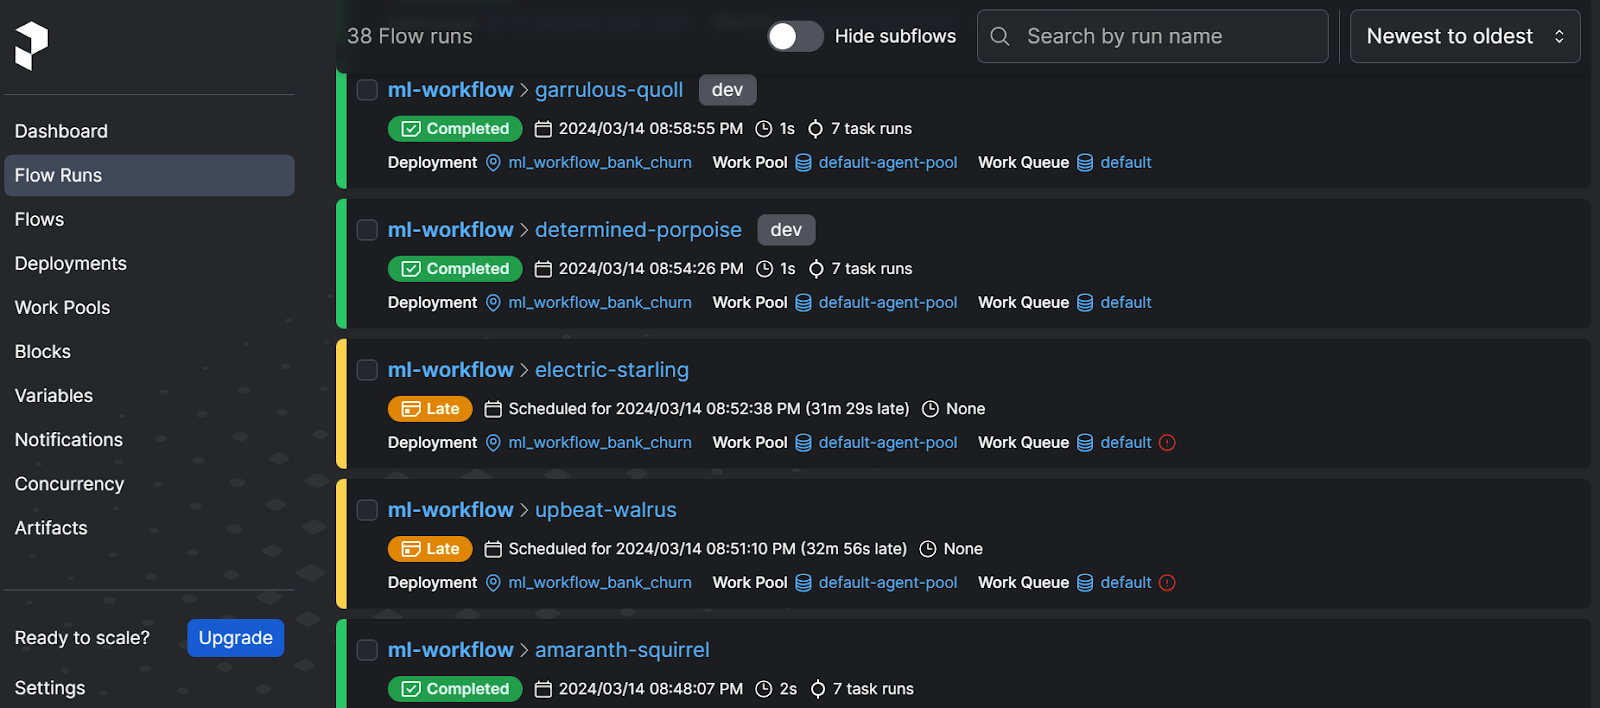
Per vedere tutte le run precedenti dei flow, clicca sull'opzione "Flow" nel pannello di sinistra. Potresti notare che alcuni flow non sono stati eseguiti per mancanza di work pool, mentre altri sono stati eseguiti senza il tag "dev" durante la fase di sperimentazione.
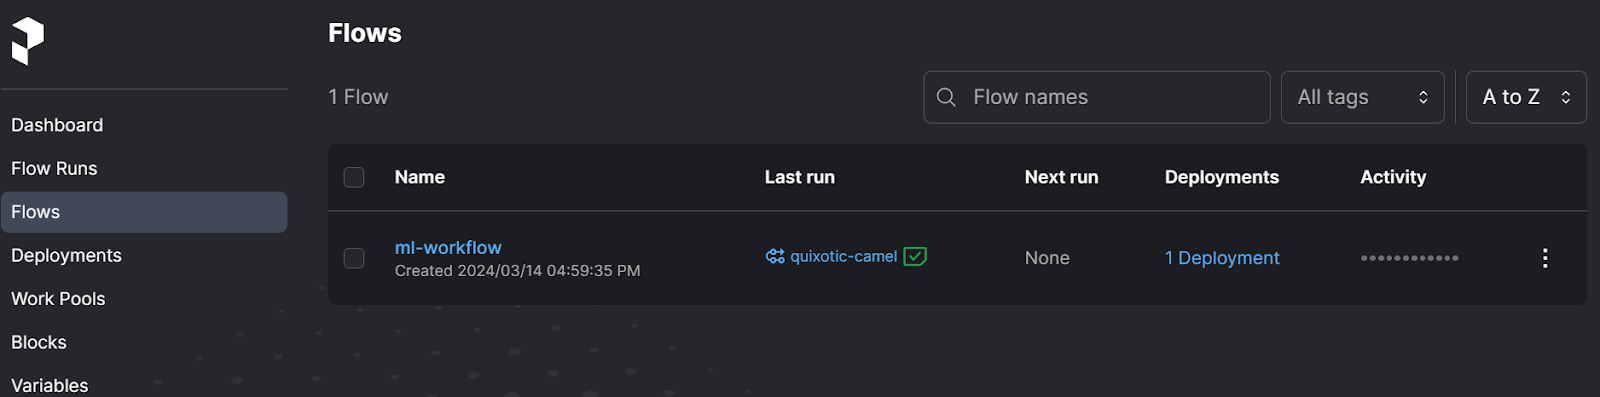
Cliccando sull'opzione Flows vengono mostrati tutti i flow disponibili. Possono esistere più flow all'interno di una singola deployment.
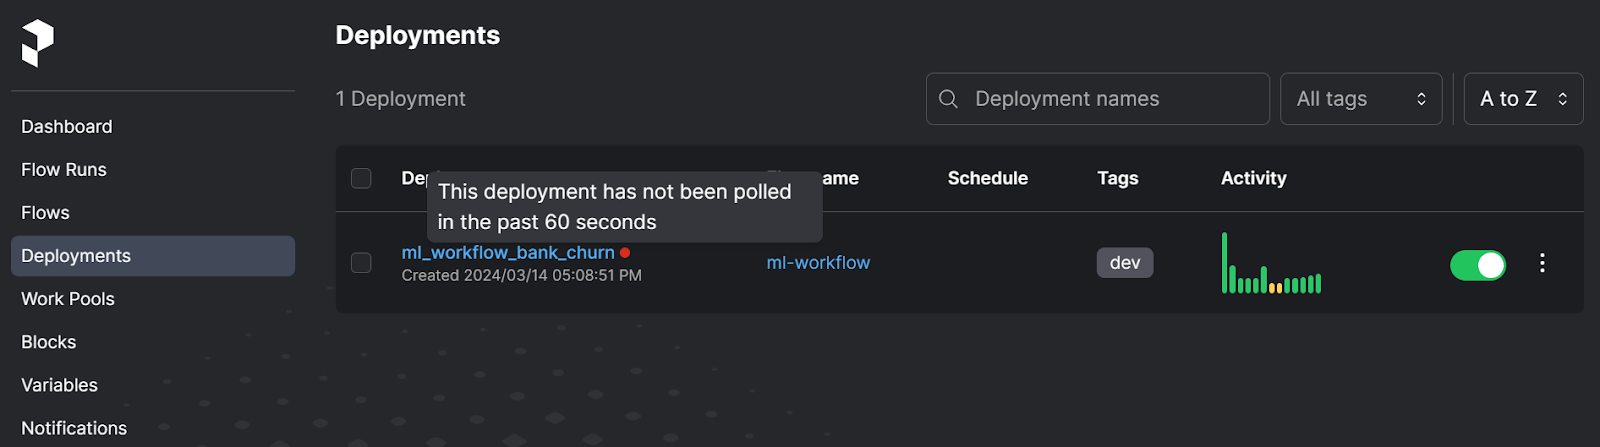
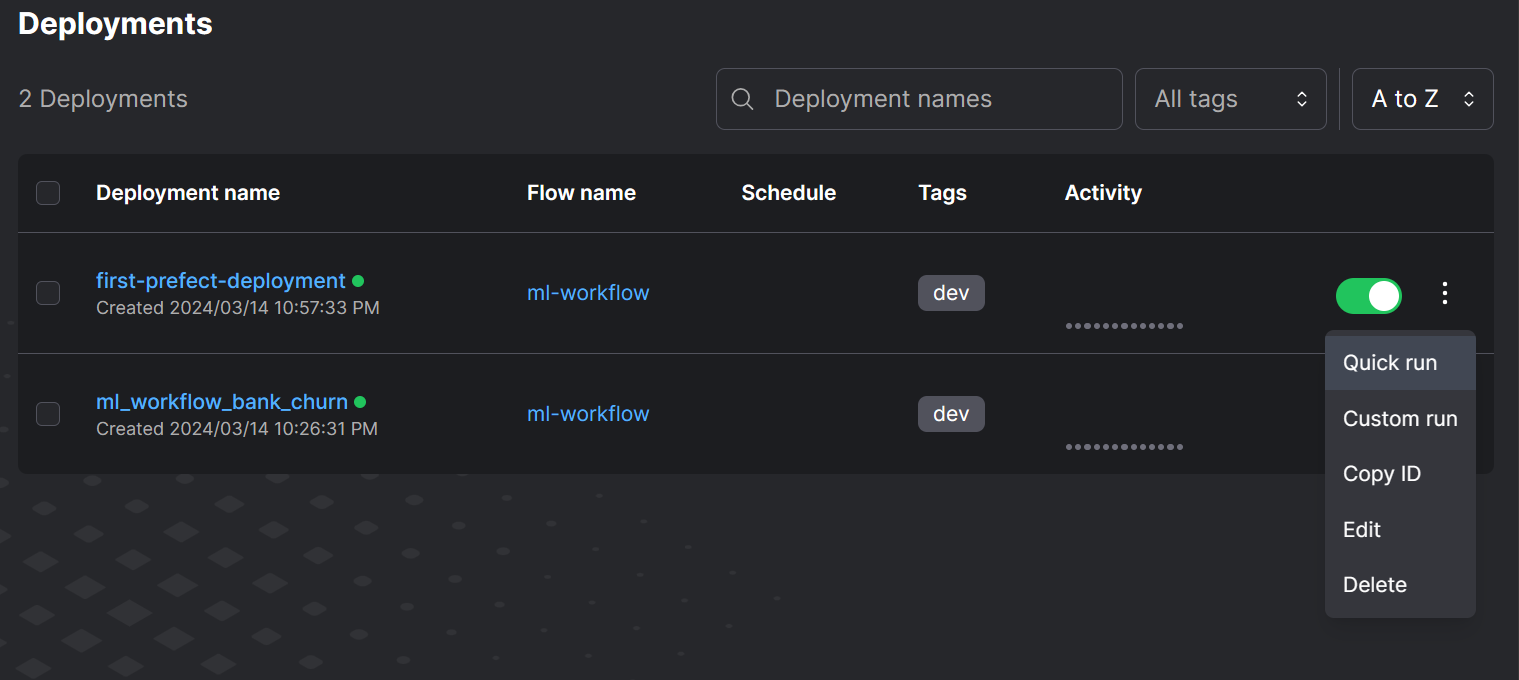
Nella sezione Deployment, possiamo vedere la nostra Deployment attuale insieme alla sua attività e ai tag. Da qui possiamo eseguire facilmente il flow con l'opzione quick run oppure schedularlo tramite interfaccia.
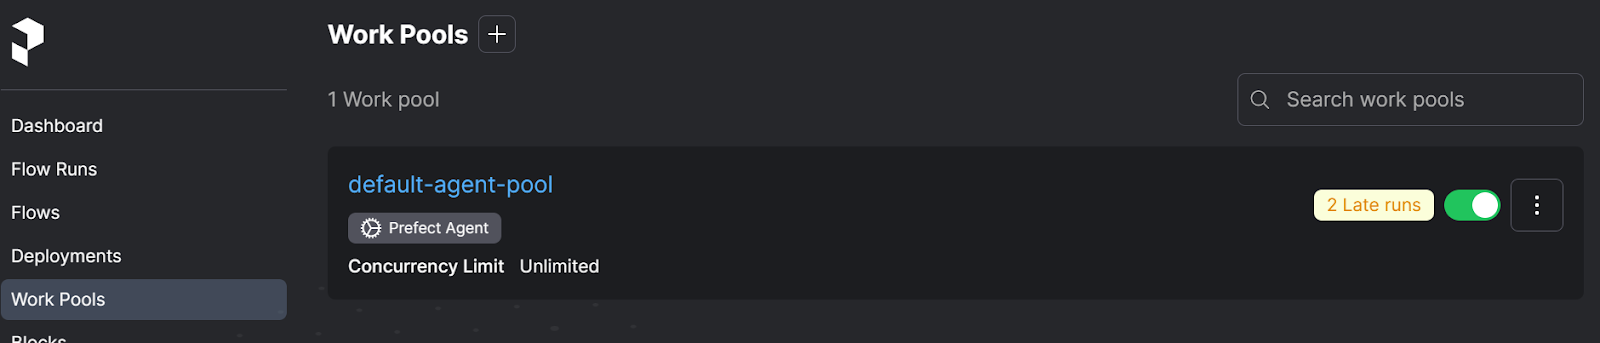
Nei Work Pool vedrai il nostro Prefect Agent predefinito. Puoi anche configurare un work pool cloud usando la CLI di Prefect.
Passiamo alla parte interessante.
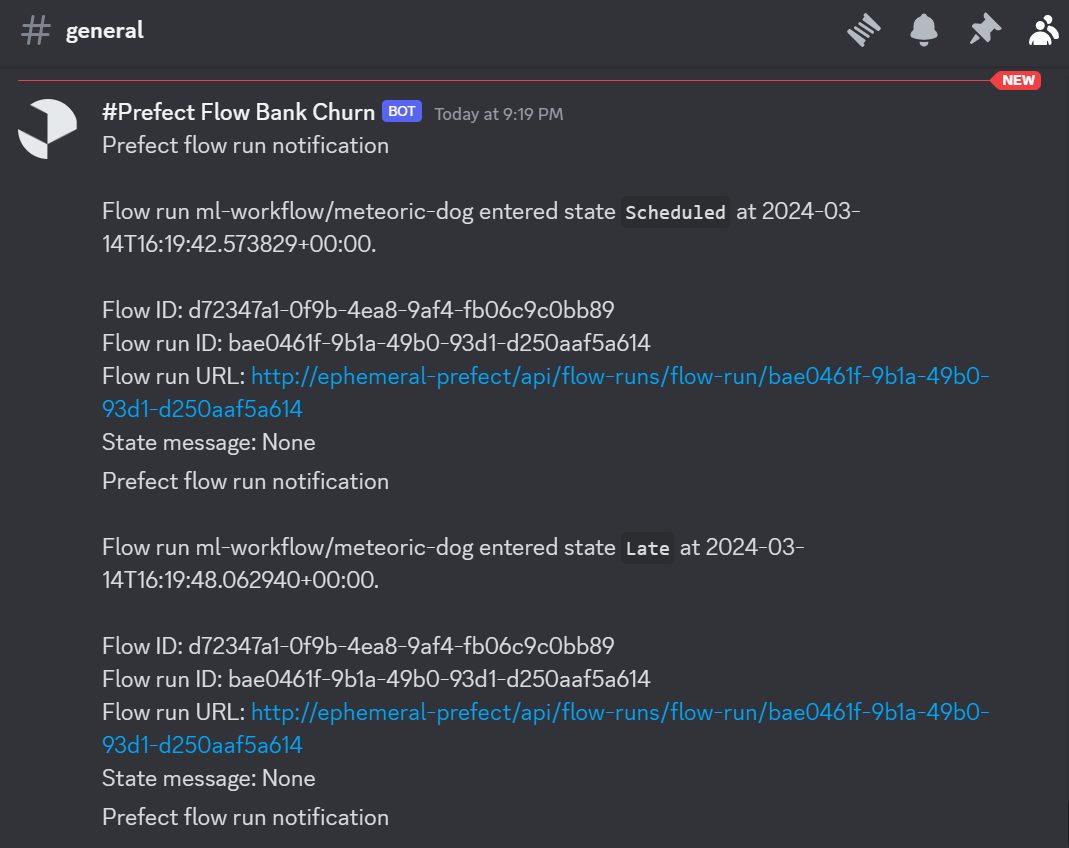
Nessuno vuole monitorare il proprio workflow 24/7. Preferiamo ricevere notifiche sullo stato del workflow nella nostra applicazione di messaggistica preferita. In questo modo possiamo risolvere rapidamente eventuali problemi.
Per farlo, creeremo un webhook di Discord. Usando l'ID e il token del webhook, imposteremo la notifica in Prefect. Invierà tutte le informazioni di logging al server Discord.
Per creare un webhook, vai nelle impostazioni del tuo server Discord, clicca su "Integrations" e seleziona "View Webhooks". Quindi clicca su "New Webhook".
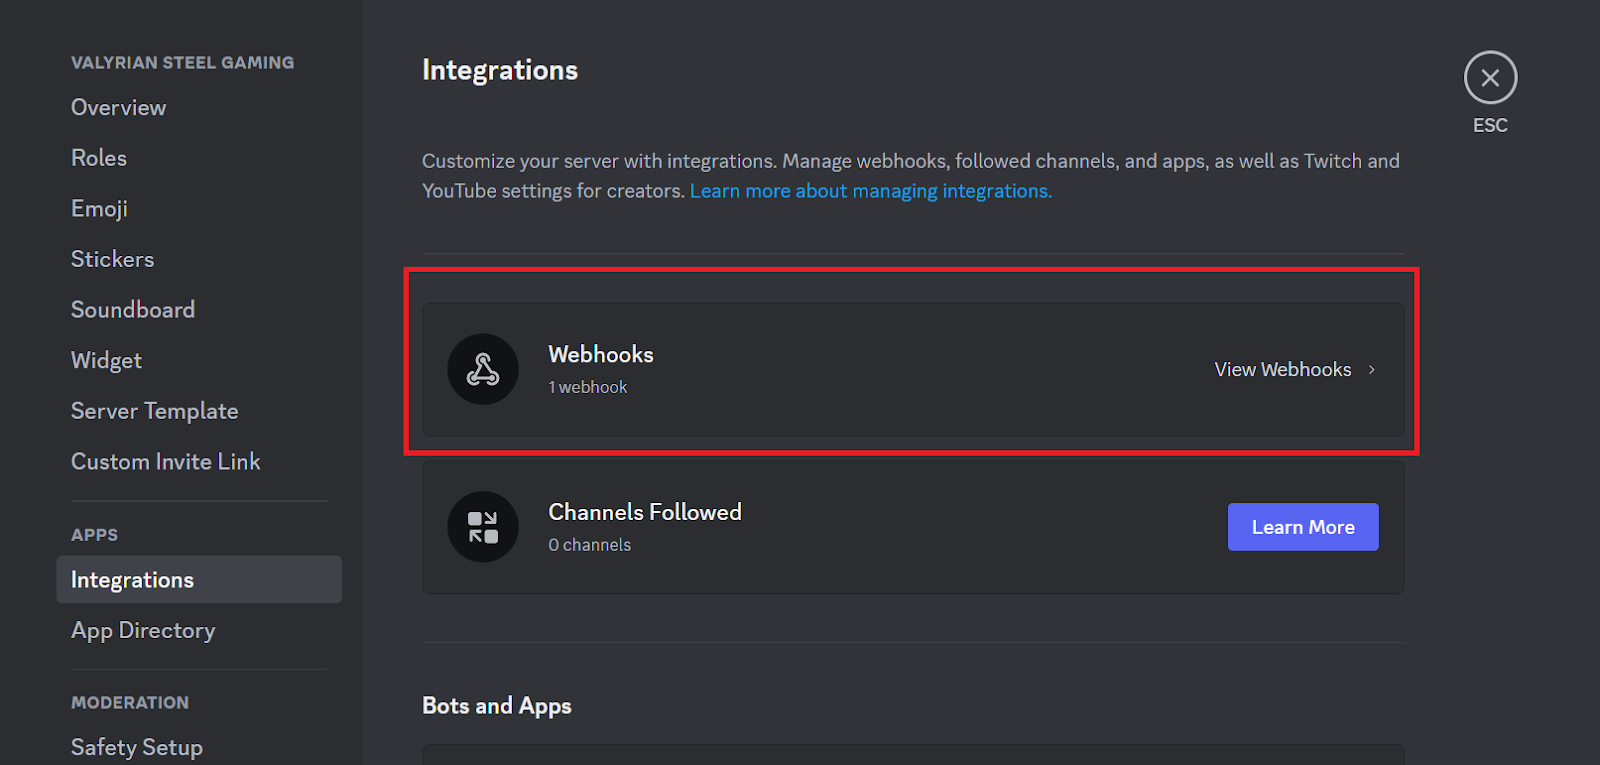
Cambia immagine, nome e canale di visualizzazione. Poi copia l'URL del Webhook.
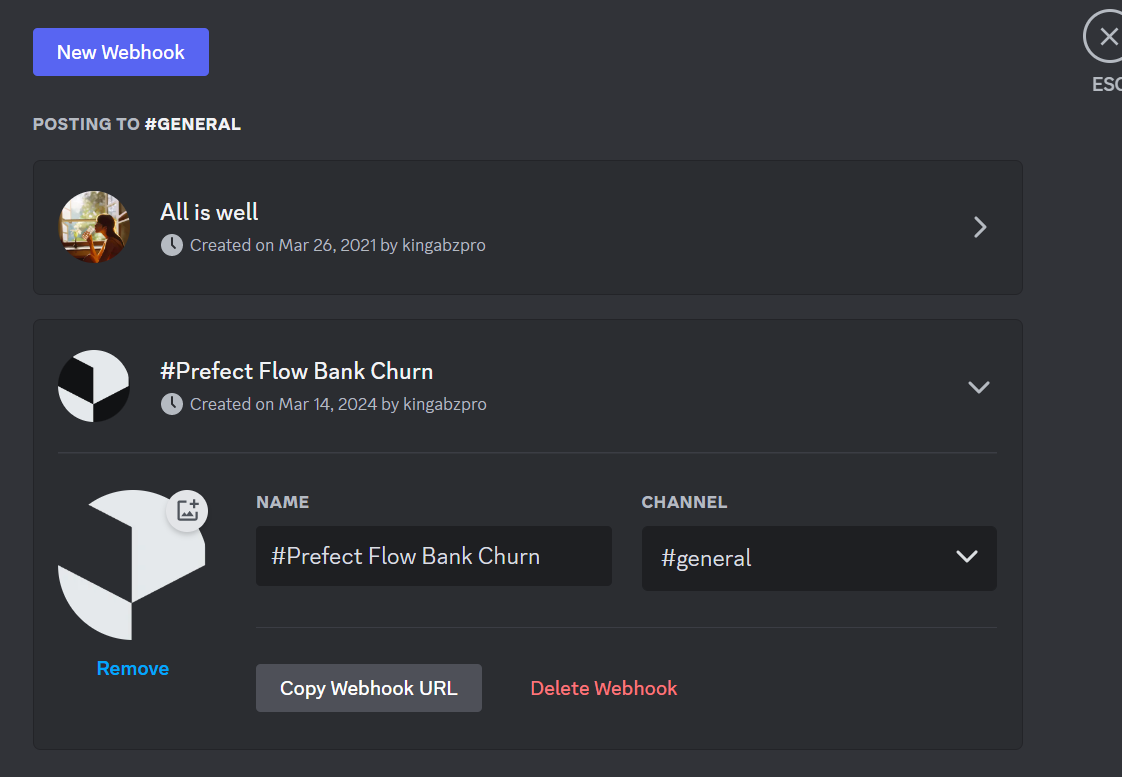
L'URL del webhook è composto da due parti, ovvero Webhook Id e Webhook token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Per creare una notifica Prefect, dobbiamo separare manualmente queste due parti dal link.
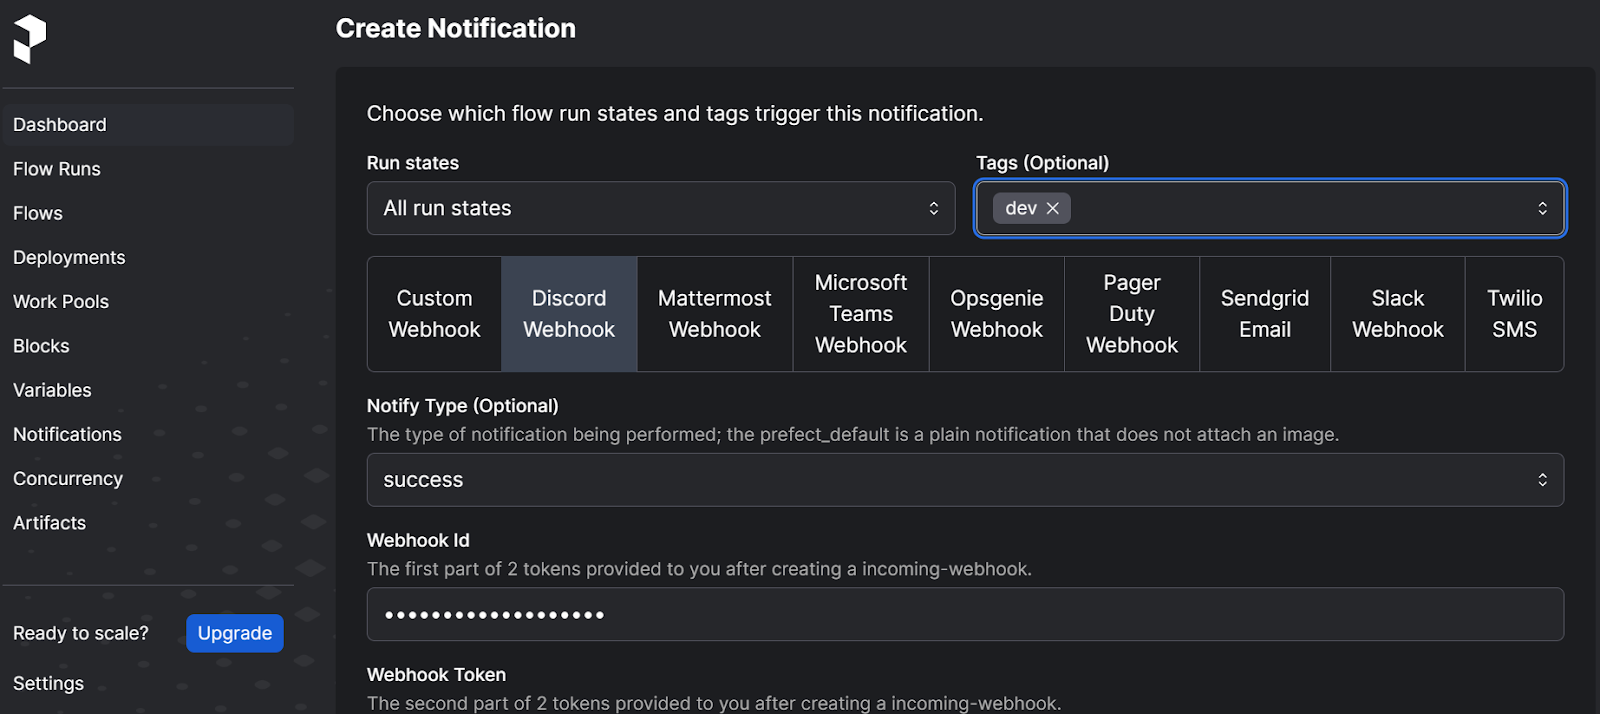
Per creare una notifica Discord dalla UI di Prefect, vai all'opzione "Notifications" e clicca sul pulsante "+" in alto. Poi seleziona gli stati di run desiderati, i tag, il webhook di Discord e il tipo di notifica.
Successivamente, inserisci il Webhook ID e il Webhook token e clicca sul pulsante blu "Create".
Dobbiamo eseguire la deployment per vedere le notifiche nel canale principale del nostro server Discord.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Fantastico. Con lo stesso metodo possiamo configurare vari servizi di messaggistica come Microsoft Teams, Slack, SMS ed email, e persino creare un webhook personalizzato.
Segui il corso Designing Machine Learning Workflows in Python per imparare a costruire pipeline che resistono alla prova del tempo.
Dopo aver distribuito il nostro flow di machine learning in locale, è il momento di portarlo su Prefect Cloud. È un processo molto più semplice rispetto alle deployment locali, perché non devi avviare server o agent né eseguire le run tramite CLI. A gestire tutto ci pensa Prefect.
Prima di distribuire il flow corrente, è importante notare che genererà un errore perché tenterà di accedere a file e dati da una directory locale non accessibile nel cloud. Per rendere questi file disponibili su Prefect Cloud, dobbiamo creare e pubblicare il nostro codice in un repository pubblico su GitHub.
Puoi farlo facilmente dal sito di GitHub o usando l'estensione Git di VSCode per creare il repository remoto e inviare il codice tramite interfaccia.
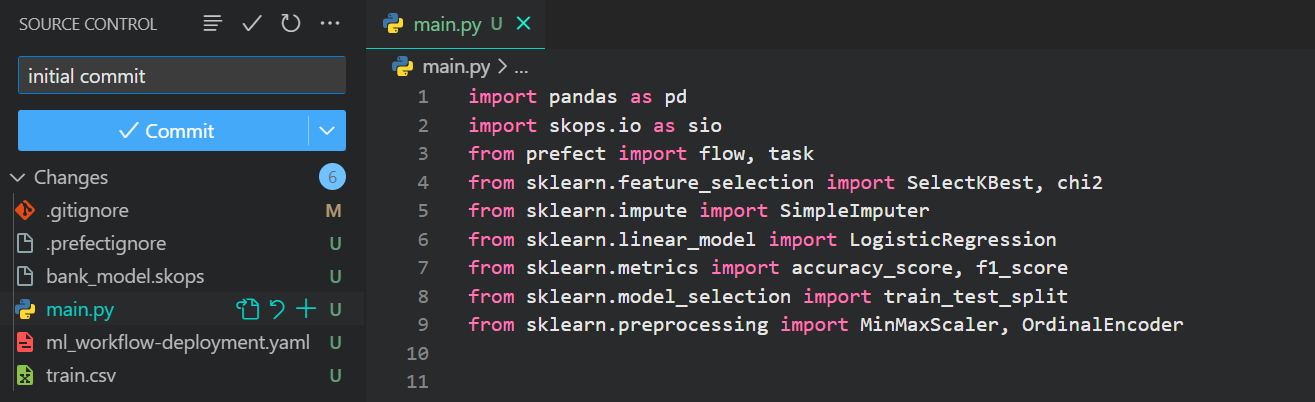
Ecco il repository del progetto che useremo per le nostre deployment su cloud: kingabzpro/ML-Workflow-Orchestration-With-Prefect
Crea il tuo account Prefect Cloud andando su https://app.prefect.cloud/auth/login e poi accedi usando lo strumento Prefect CLI.
$ prefect cloud loginScegli semplicemente "Log in with a web browser" e segui i passaggi per autenticare il client locale con Prefect Cloud.
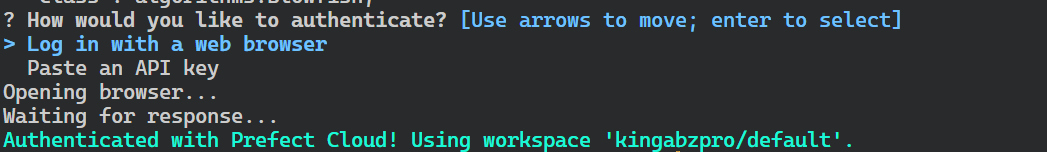
Creeremo un work pool gestito da Prefect per sfruttare appieno l'infrastruttura di Prefect Cloud invece di usare il nostro agent locale.
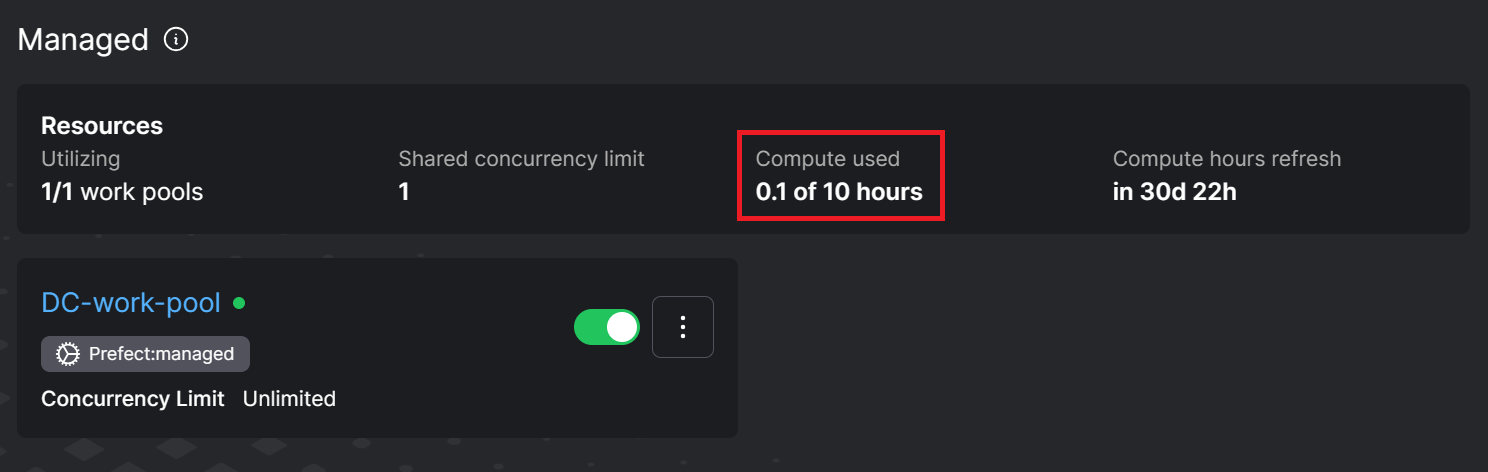
$ prefect work-pool create DC-work-pool --type prefect:managedPer un account gratuito, Prefect offre 10 ore di calcolo gratuite al mese da usare per sperimentare e fare prove.
Ora distribuiremo programmaticamente il nostro flow su Prefect Cloud.
Crea un nuovo file chiamato deployment.py.
Imposta gli argomenti per la funzione del flow di Prefect:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Esegui il codice Python.
$ python deployment.pyIl flow è distribuito su Prefect Cloud. Può essere eseguito via CLI o dalla dashboard di Prefect Cloud.
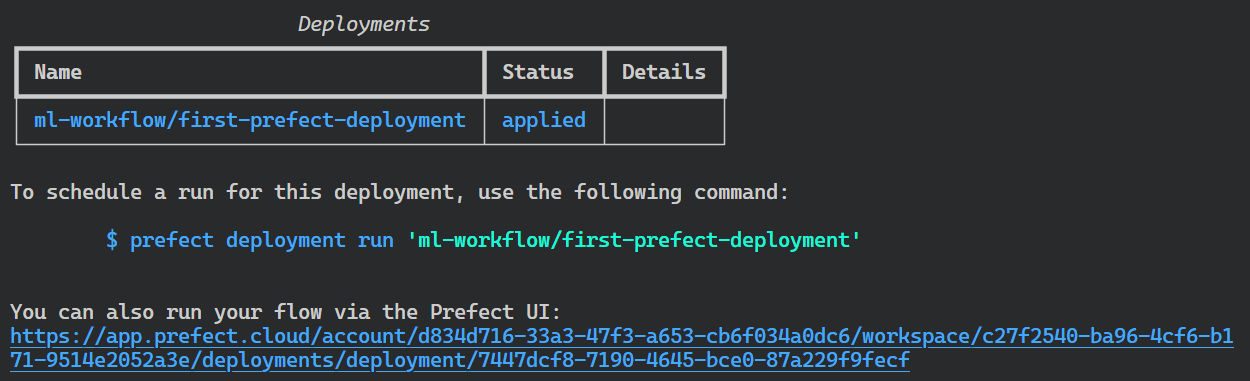
Per eseguire il flow, vai sul sito: https://app.prefect.cloud/. Poi vai nella sezione “Deployments” e clicca sul pulsante con i tre puntini verticali sulla tua deployment, quindi seleziona l'opzione “Quick run”.
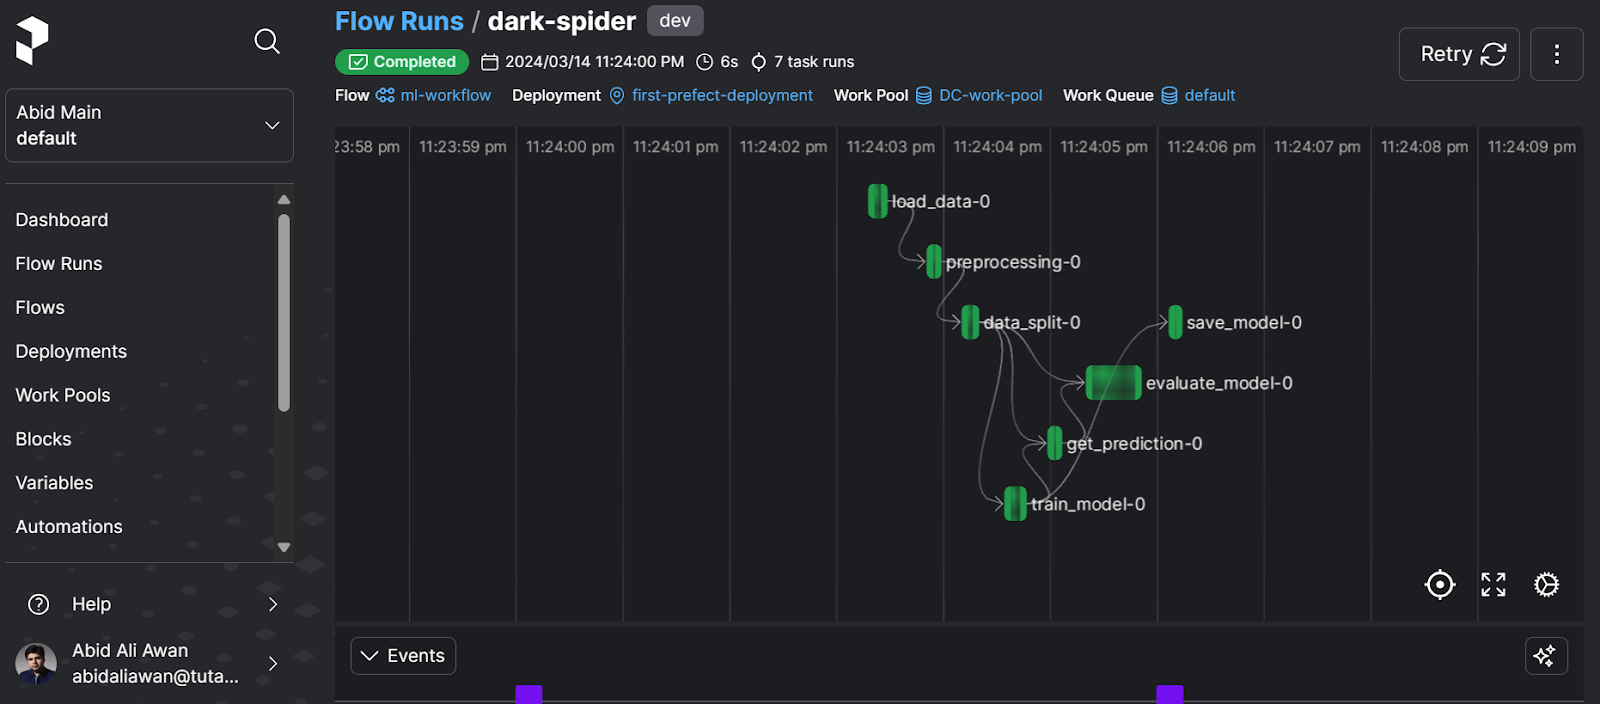
Per vedere come sta procedendo la run, vai alla sezione “Flow Run” e clicca sulla run più recente per visualizzare il grafo del workflow.
Il diagramma del flow presenta una panoramica delle interconnessioni tra i task e del tempo impiegato da ciascun processo.
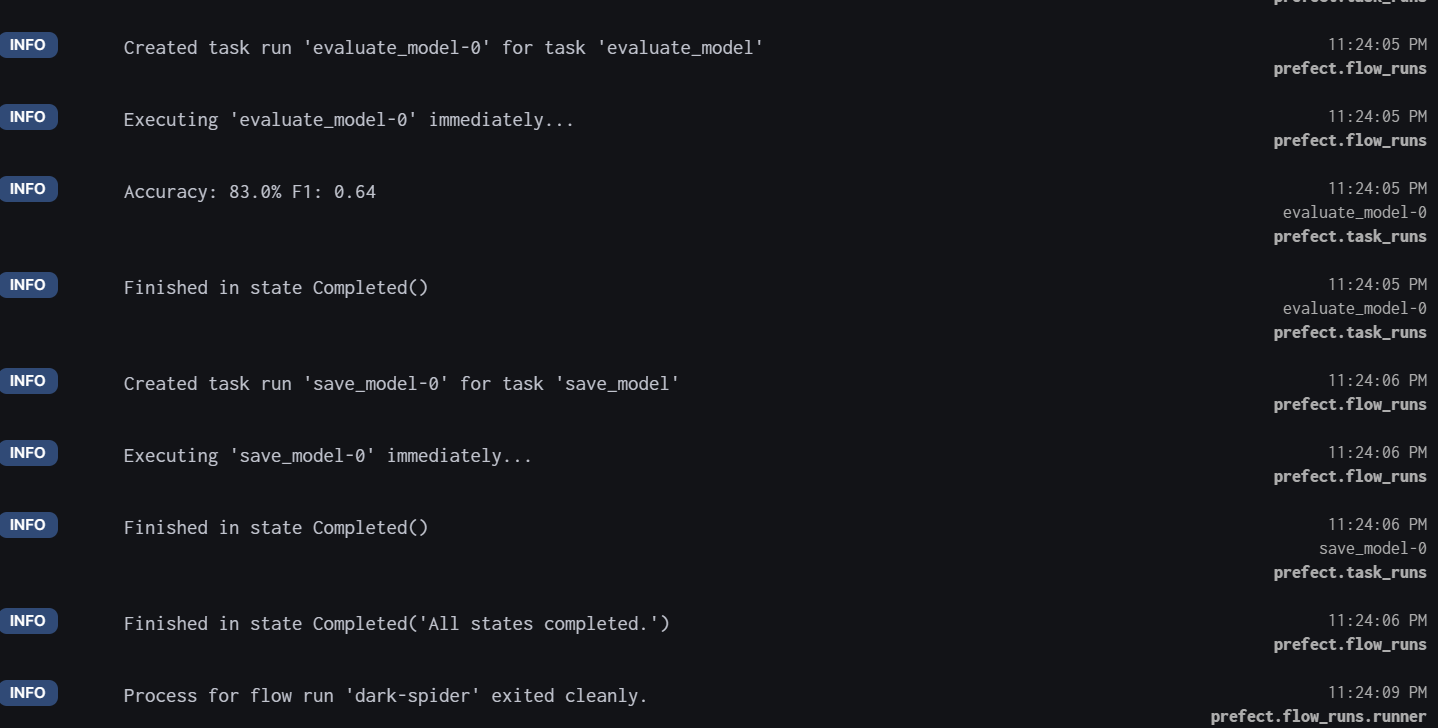
Per i log dettagliati, scorri in basso e visualizza tutti i task eseguiti con timestamp.
Se andiamo nella sezione “Work Pools”, possiamo vedere chiaramente che abbiamo usato 0,1 ore sul limite di 10 ore per gli utenti free.
Dai un'occhiata alla guida Machine Learning Workflow, che include un'infografica per aiutarti a comprendere le attività coinvolte in setup del progetto, preparazione dei dati, modellazione e deployment.
Configurare un singolo workflow di machine learning è stato semplice. Nella realtà potresti dover eseguire contemporaneamente più workflow di dati e di machine learning. Qui Prefect si distingue: offre scalabilità e flessibilità nella scelta se eseguirlo in ambiente locale o cloud per server Prefect o work pool. È uno strumento fantastico per schedulare, automatizzare e gestire i workflow.
In questo tutorial abbiamo coperto le principali funzionalità dell'ecosistema Prefect. Abbiamo anche visto come distribuire un flow di machine learning in locale e nel cloud. Per proseguire nel tuo percorso MLOps, il prossimo passo è imparare a costruire CI/CD per i workflow di machine learning seguendo "A Beginner's Guide to CI/CD for Machine Learning".
Prefect è solo uno degli strumenti nel campo MLOps usati per l'orchestrazione dei workflow. Per scoprire altri strumenti importanti per versionamento dei dati, feature store, test dei modelli, deployment e serving dei modelli, monitoraggio dei modelli, motori di runtime e strumenti MLOps end-to-end, leggi l'articolo 25 Top MLOps Tools You Need to Know in 2024. Puoi anche leggere il nostro confronto Prefect vs Airflow per vedere come si posizionano gli strumenti.
Continua oggi il tuo percorso nel Machine Learning!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



