
कोर्स
Python में मशीन लर्निंग वर्कफ़्लो डिज़ाइन करना
4 घंटा
12.8K
इस ट्यूटोरियल में, हम Prefect के प्रमुख फीचर्स, लाभ, और घटकों की पड़ताल करेंगे। हम जानेंगे कि टास्क और फ्लो कैसे बनाएँ, डिप्लॉयमेंट कैसे प्रबंधित करें, और फ्लो रन कैसे चलाएँ। अंत में, हम आपको Prefect Cloud पर अपना वर्कफ़्लो डिप्लॉय करने और क्लाउड इन्फ्रास्ट्रक्चर पर चलाने की प्रक्रिया से गुजारेंगे।
यदि आप GitHub Actions और Data Version Control का उपयोग करके मशीन लर्निंग पाइपलाइनों को स्वचालित करने में रुचि रखते हैं, तो हमारा CI/CD for Machine Learning कोर्स देखें।
Prefect एक शक्तिशाली और ओपन-सोर्स वर्कफ़्लो ऑर्केस्ट्रेशन टूल है, जो उपयोगकर्ताओं को Python कोड के जरिए डेटा और मशीन लर्निंग पाइपलाइनों को डिजाइन, मॉनिटर, और उन पर प्रतिक्रिया देने की सुविधा देता है।
Prefect ऑटोमैटिक रिट्राइज़, शेड्यूलिंग और कैशिंग जैसे कई फीचर्स के साथ आता है। यह एक ऐसा प्रभावशाली टूल है जो आपको मजबूत और डायनेमिक वर्कफ़्लो बनाने में सक्षम बनाता है।
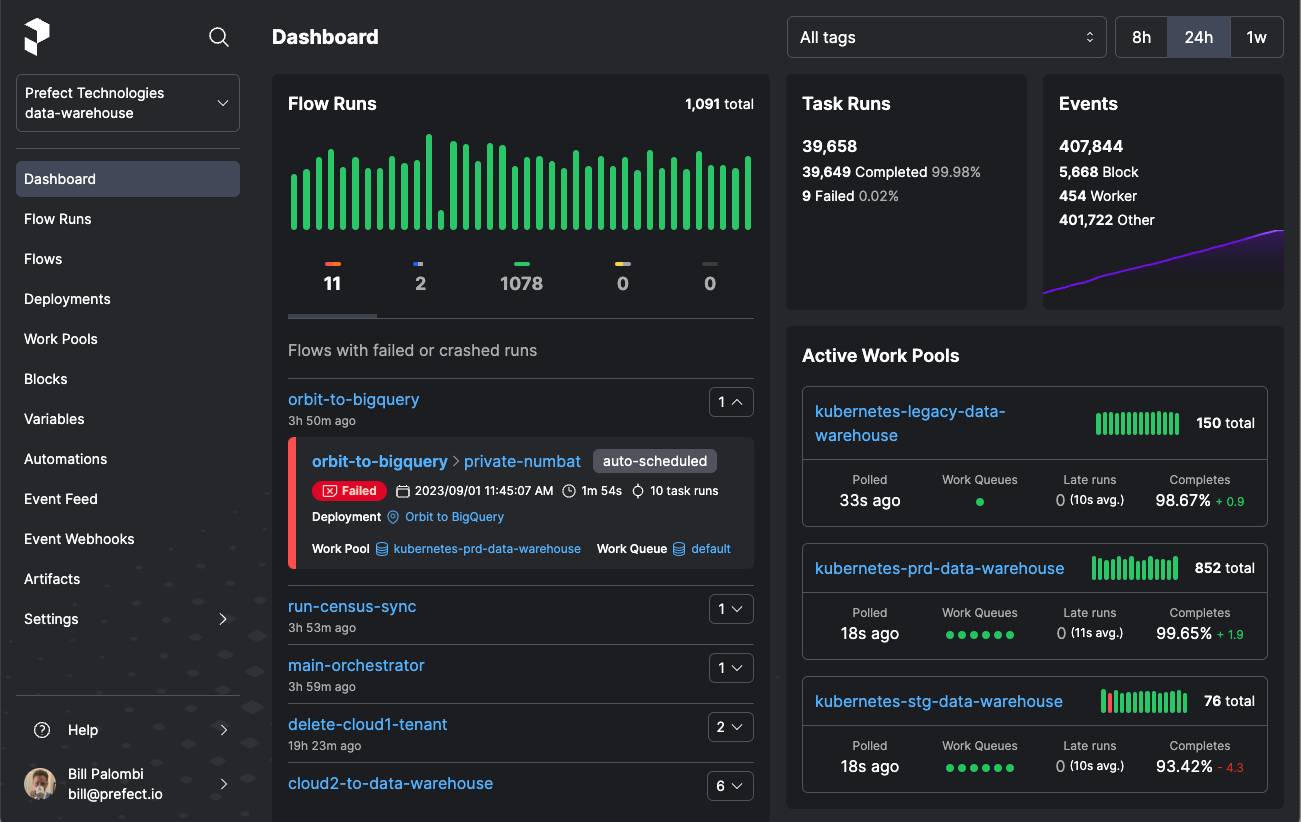
छवि स्रोत
Prefect के साथ, आप अपने कोड में कुछ डेकोरेटर जोड़कर किसी भी Python फ़ंक्शन को आसानी से एक ऐसे कार्य-यूनिट में बदल सकते हैं जिसे देखा और ऑर्केस्ट्रेट किया जा सके।
Prefect संगठनों में वर्कफ़्लो डेवलपमेंट और डिप्लॉयमेंट को मानकीकृत करने के लिए आदर्श है। यह वर्कफ़्लोज़ में पूर्ण अवलोकनीयता प्रदान करता है और उपयोगकर्ताओं को सख्त DAGs या बायलरप्लेट कोड की आवश्यकता के बिना अपने कोड को प्रबंधित करने देता है।
एक ही कमांड से उपयोगकर्ता डेवलपमेंट प्रयोजनों के लिए अपना ऑर्केस्ट्रेशन सर्वर आसानी से सेट अप कर सकते हैं। यह सरलीकृत प्रक्रिया लोकल डेवलपमेंट को सरल बनाती है और प्रोडक्शन वातावरण में सुगम डिप्लॉयमेंट सुनिश्चित करती है।
Prefect आम तौर पर सहज यूज़र इंटरफ़ेस प्रदान करता है, जिससे वर्कफ़्लोज़ को चलाना, मॉनिटर करना, डीबग करना और प्रबंधित करना दृष्टिगत रूप से आकर्षक और उपयोगकर्ता-अनुकूल हो जाता है।
Prefect शेड्यूलिंग, रिट्राइज़, नेटिव सीक्रेट मैनेजमेंट, स्केलिंग क्षमताएँ, समांतरता नियंत्रण, लचीले इन्फ्रास्ट्रक्चर और स्टोरेज कॉन्फ़िगरेशन विकल्प, और मज़बूत लॉगिंग जैसी सुविधाएँ प्रदान करता है।
उपयोगकर्ता या तो ओपन-सोर्स Prefect सर्वर को स्वयं होस्ट कर सकते हैं या Prefect Cloud का उपयोग करके उन्नत फीचर्स, उच्च उपलब्धता और बेहतर सुरक्षा का लाभ उठा सकते हैं।
Prefect Cloud, ओपन-सोर्स Prefect सर्वर की सभी क्षमताओं के साथ-साथ ऑटोमेशन, इवेंट फ़ीड्स, इवेंट्स, वेबहुक्स, वर्कस्पेसेज़, ऑर्गनाइज़ेशन आदि जैसे अतिरिक्त फीचर्स प्रदान करता है, जो होस्टेड वातावरण के अनुरूप हैं। आप Prefect Cloud को मुफ़्त में इस्तेमाल कर सकते हैं या अधिक मज़बूत फीचर्स के लिए भुगतान कर सकते हैं।
Prefect उपयोगकर्ताओं को एक ही डेकोरेटर से वर्कफ़्लो ऑर्केस्ट्रेशन शुरू करने देता है, जिससे अनावश्यक एब्स्ट्रैक्शन के बिना प्रक्रिया सरल हो जाती है और वर्कफ़्लो मैनेजमेंट कुशल बनता है।
Prefect वर्कफ़्लोज़ और पाइपलाइनों की जानकारी Slack, Discord, ईमेल, Microsoft Teams और अन्य कई मैसेजिंग सेवाओं को भेजें। यह वर्कफ़्लो के फेल होने पर आपको अलर्ट भी कर सकता है।
इस खंड में हम वे प्रमुख घटक कवर करेंगे जिनसे टास्क और फ्लो बनाए, डिप्लॉय और निष्पादित किए, और मैनेज किए जाते हैं। Python ट्यूटोरियल में जाने से पहले इन घटकों की समीक्षा करना महत्वपूर्ण है।
Prefect Task एक Python फ़ंक्शन है जिसे @task डेकोरेटर से सजाया जाता है और यह Prefect वर्कफ़्लो के भीतर पृथक कार्य-इकाइयों का प्रतिनिधित्व करता है। हम टास्क डेकोरेटर को नाम, विवरण, टैग, कैश सेटिंग्स, रिट्राइज़ आदि जैसे वैकल्पिक आर्ग्युमेंट्स के साथ कस्टमाइज़ भी कर सकते हैं।
नीचे दिए गए कोड में, @task डेकोरेटर से बनाए गए तीन मशीन लर्निंग टास्क हैं जिन्हें विभिन्न फ्लो में पुन: उपयोग किया जा सकता है।
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    ...
Prefect Flow एक Python फ़ंक्शन है जिसे @flow डेकोरेटर से सजाया जाता है और यह वर्कफ़्लो लॉजिक को समाहित करता है। इससे उपयोगकर्ताओं के लिए जटिल डेटा पाइपलाइनों को लचीलेपन और आसानी से परिभाषित, कॉन्फ़िगर और निष्पादित करना सरल हो जाता है।
नीचे दिए गए कोड में, हमने @flow डेकोरेटर का उपयोग करके एक Flow बनाया है। यह फ्लो सभी टास्क को अनुक्रम में चलाएगा, जहाँ एक का आउटपुट अगले का इनपुट होगा।
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()डिप्लॉयमेंट वे फ्लो होते हैं जो लोकल सर्वर या क्लाउड पर स्टोर किए जाते हैं और जिनमें आपके वर्कफ़्लो को रिमोटली ऑर्केस्ट्रेट करने के लिए शेड्यूलिंग और एक्ज़ीक्यूशन विवरण जैसी महत्वपूर्ण जानकारी शामिल होती है।
वर्क पूल ऑर्केस्ट्रेशन और एक्ज़ीक्यूशन वातावरण के बीच मध्यस्थ के रूप में काम करते हैं, जिससे फ्लो रन का शेड्यूलिंग और निष्पादन कुशलतापूर्वक हो पाता है। उपयोगकर्ता वर्कफ़्लोज़ को लोकल रूप से चलाने के लिए अपने एजेंट (वर्कर) सेट कर सकते हैं या निर्बाध एक्ज़ीक्यूशन के लिए क्लाउड इन्फ्रास्ट्रक्चर का लाभ उठा सकते हैं।
एक समर्पित कंप्यूट इंस्टेंस की तरह, वर्क पूल कार्य आवंटन को कुशलतापूर्वक प्रबंधित करते हैं और टास्क को प्राथमिकता देते हैं, जिससे एक्ज़ीक्यूशन वातावरण चुनने में लचीलापन मिलता है ताकि वर्कफ़्लो का प्रदर्शन और स्केलेबिलिटी बेहतर हो।
इस भाग में, हम Prefect का उपयोग करके एक सरल मशीन लर्निंग वर्कफ़्लो बनाएँगे, परीक्षण करेंगे, डिप्लॉय करेंगे और चलाएँगे। हम नोटिफिकेशन भी सेट करेंगे ताकि हमारे Discord सर्वर पर फ्लो रन की स्थिति के बारे में सूचनाएँ मिलती रहें।
PIP का उपयोग करके Python पैकेज इंस्टॉल करें
pip install -U prefectयदि आप Prefect का नवीनतम संस्करण उपयोग करना चाहते हैं, तो आप GitHub से सीधे कोड प्राप्त कर सकते हैं।
pip install -U git+https://github.com/PrefectHQ/prefectहम Kaggle के Bank Churn डेटासेट का प्रीप्रोसेसिंग करेंगे, फिर scikit-learn का उपयोग करके Random Forest Classifiers मॉडल को ट्रेन और इवैल्यूएट करेंगे।
हम जो कोड इस्तेमाल करेंगे, वह इस लेख के कोड का संशोधित संस्करण है: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines। यदि आप यह जानना चाहते हैं कि मॉडल कैसे ट्रेन किया गया था, तो उस ट्यूटोरियल पर नज़र डालें। हमारा मशीन लर्निंग Prefect Flow सात टास्क से बना है:
हमने अब सभी आवश्यक टास्क को @flow फ़ंक्शन में समेट दिया है, जिसका नाम ml_workflow है। साथ ही, हमने डेकोरेटर में विस्तृत लॉगिंग सक्षम करने के लिए अतिरिक्त आर्ग्युमेंट्स जोड़े हैं।
ml_workflow फ़ंक्शन डेटा फ़ाइल के स्थान को इनपुट के रूप में लेता है और फिर विभिन्न टास्क को क्रम में जोड़ता है। जब हम इसे Prefect सर्वर पर डिप्लॉय और रन करेंगे, तो इस वर्कफ़्लो को और बेहतर तरीके से विज़ुअलाइज़ कर पाएँगे।
आप MLflow का उपयोग करके हमारे मशीन लर्निंग प्रयोगों को भी ट्रैक कर सकते हैं। MLflow ट्रैकिंग, प्रोजेक्ट्स, मॉडल्स और मॉडल रजिस्ट्री के बारे में जानने के लिए Introduction to MLflow कोर्स करें।
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
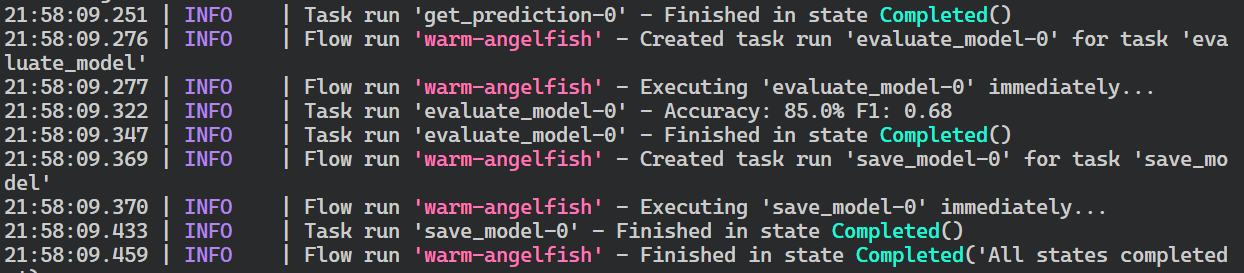
अपने Prefect Flow का परीक्षण करने के लिए, टर्मिनल में Python फ़ाइल चलाएँ।
$ python main.pyफ्लो सफलतापूर्वक पूरा हो गया है। इसने मॉडल मैट्रिक्स दिखाए हैं और मॉडल वेट्स सहेज लिए हैं।
यदि आप मशीन लर्निंग में नए हैं और सीखना चाहते हैं कि अपने डेटा का प्रीप्रोसेसिंग कैसे करें, अपने मॉडल को कैसे ट्रेन करें, ऑप्टिमाइज़, इवैल्यूएट और सेव करें, तो Machine Learning Scientist with Python करियर ट्रैक पर विचार करें। यह कोर्स आपको शुरुआत से सब कुछ सिखाएगा।
मशीन लर्निंग पाइपलाइन को मैन्युअली बनाना और चलाना एक सरल कार्य है, जिसे scikit-learn पाइपलाइनों के साथ भी किया जा सकता है।
हालाँकि, Prefect उपयोग करने के कई फायदे हैं। इनमें शामिल हैं:
अब, हम अपने वर्कफ़्लो को लोकल Prefect सर्वर पर डिप्लॉय करके ऑटोमेट करना सीखेंगे।
सबसे पहले, हमें फ़ाइल और फ्लो फ़ंक्शन के नाम देकर “Deployment” बनाना होगा। हम अपने डिप्लॉयमेंट में “dev” टैग भी जोड़ रहे हैं।
नोट: Prefect में टैग का उपयोग इकोसिस्टम में फ्लो, टास्क और डिप्लॉयमेंट को वर्गीकृत और व्यवस्थित करने के लिए किया जा सकता है।
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devडिप्लॉयमेंट सफलतापूर्वक बन गया है। अब यह हमें Prefect Agent का उपयोग करके फ्लो कैसे चलाएँ, इसके निर्देश देता है।
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Prefect एजेंट, उपलब्ध फ्लो रन की पहचान करने के लिए वर्क पूल की मॉनिटरिंग करते हैं और उन्हें एक्ज़ीक्यूशन वातावरण में डिप्लॉय करते हैं।
एक ही वर्क पूल में कई एजेंट हो सकते हैं, और प्रत्येक एजेंट का एक यूनिक ID होता है ताकि ओवरलैप न हो और स्केलिंग सुचारु रहे।
अब हम डिफ़ॉल्ट वर्क पूल नाम के साथ नए टर्मिनल में Prefect एजेंट प्रारंभ करेंगे।
$ prefect agent start -p 'default-agent-pool'
नए टर्मिनल में जाएँ और “flow_function/deployment name” देकर डिप्लॉयमेंट चलाएँ। आप केवल डिप्लॉयमेंट नाम का उपयोग करके भी फ्लो चला सकते हैं।
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'इसने डिप्लॉयमेंट के लिए एक फ्लो रन बना दिया है जो वर्करों की जाँच करेगा और वर्कफ़्लो चलाना शुरू करेगा।
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
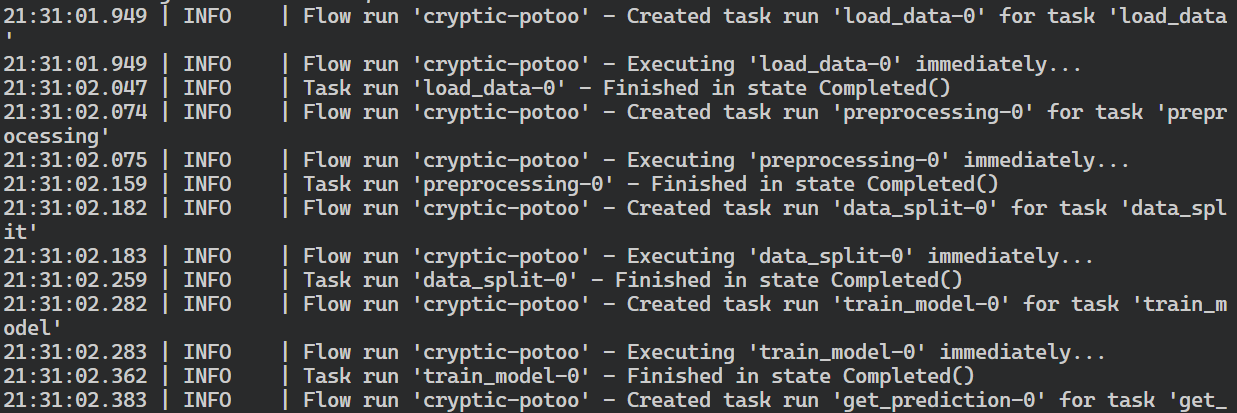
उस टर्मिनल पर स्विच करें जहाँ हमने एजेंट शुरू किया था ताकि हमारे फ्लो रन के लॉग देख सकें। Prefect एजेंट ने फ्लो के सभी टास्क सफलतापूर्वक निष्पादित कर दिए हैं।
यह एक सरल उदाहरण है। हम अपने डिप्लॉयमेंट बिल्ड में अतिरिक्त आर्ग्युमेंट्स देकर वर्कफ़्लो को शेड्यूल या ऑटोमेट भी कर सकते हैं।
अब तक हम अपने वर्कफ़्लो को टर्मिनलों में देख रहे थे। अब, एक Prefect डैशबोर्ड लॉन्च करते हैं जहाँ हम सभी फ्लो रन, डिप्लॉयमेंट, वर्क पूल और नोटिफिकेशन देख सकते हैं।
नए टर्मिनल में Prefect सर्वर शुरू करें और डैशबोर्ड तक पहुँचने के लिए दिए गए लोकल लिंक पर क्लिक करें।
$ prefect server start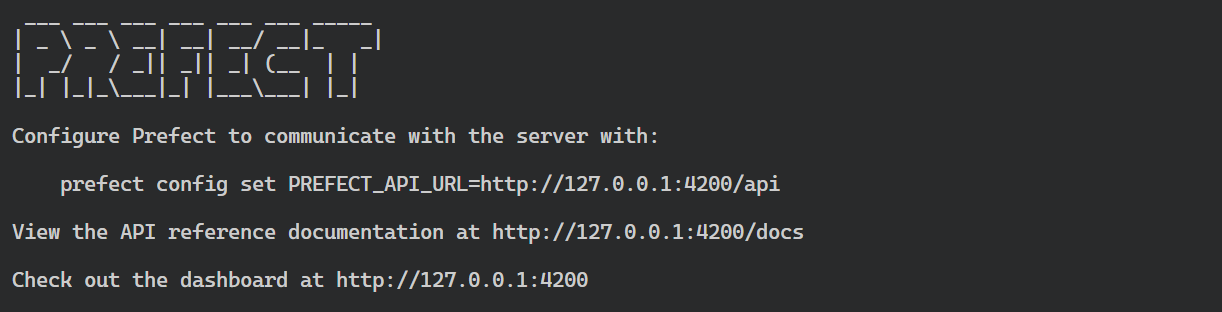
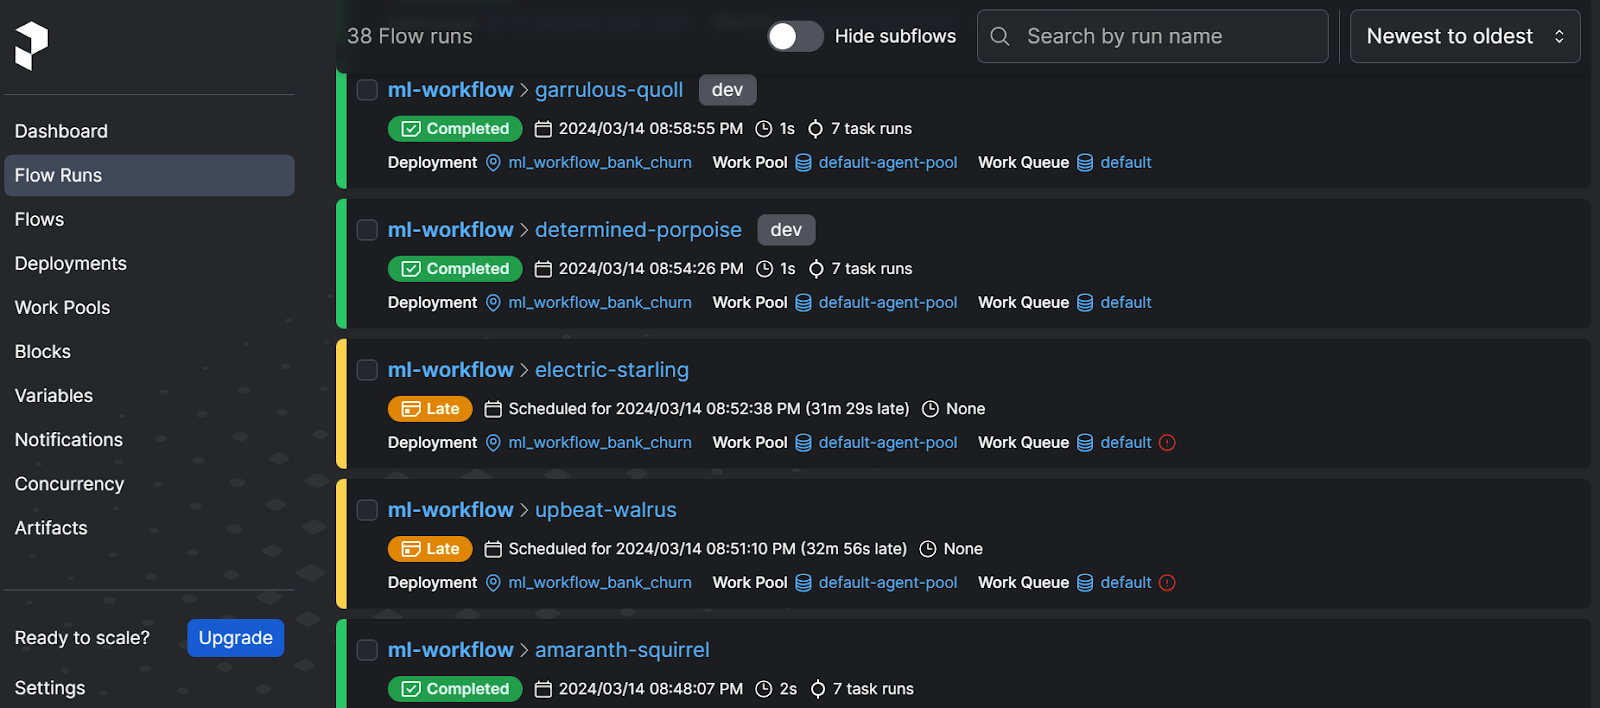
पिछले सभी रन हुए फ्लो देखने के लिए, बाएँ पैनल में "Flow" विकल्प पर क्लिक करें। आप देख सकते हैं कि कुछ फ्लो वर्क पूल की कमी के कारण निष्पादित नहीं हुए, जबकि अन्य “dev” टैग के बिना एक्सपेरिमेंटेशन चरण के दौरान निष्पादित हुए।
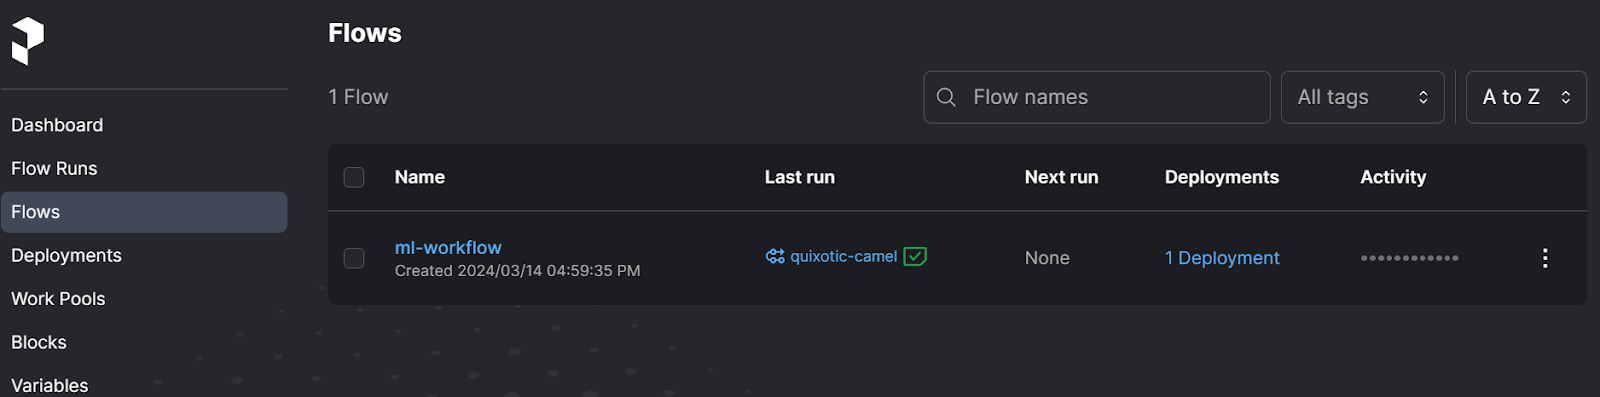
Flows विकल्प पर क्लिक करने से सभी उपलब्ध फ्लो दिखते हैं। एक ही डिप्लॉयमेंट के भीतर एकाधिक फ्लो हो सकते हैं।
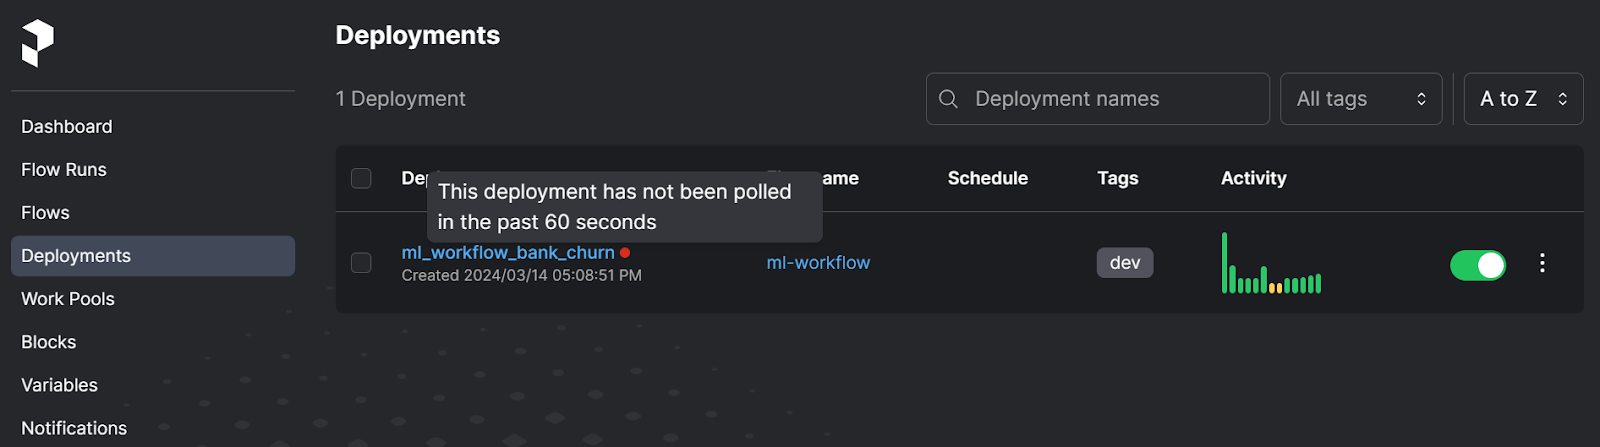
Deployment सेक्शन में, हम अपनी मौजूदा डिप्लॉयमेंट को उसकी गतिविधि और टैग के साथ देख सकते हैं। इसी सेक्शन में, हम UI का उपयोग करके या तो क्विक रन विकल्प से फ्लो चला सकते हैं या उसे शेड्यूल कर सकते हैं।
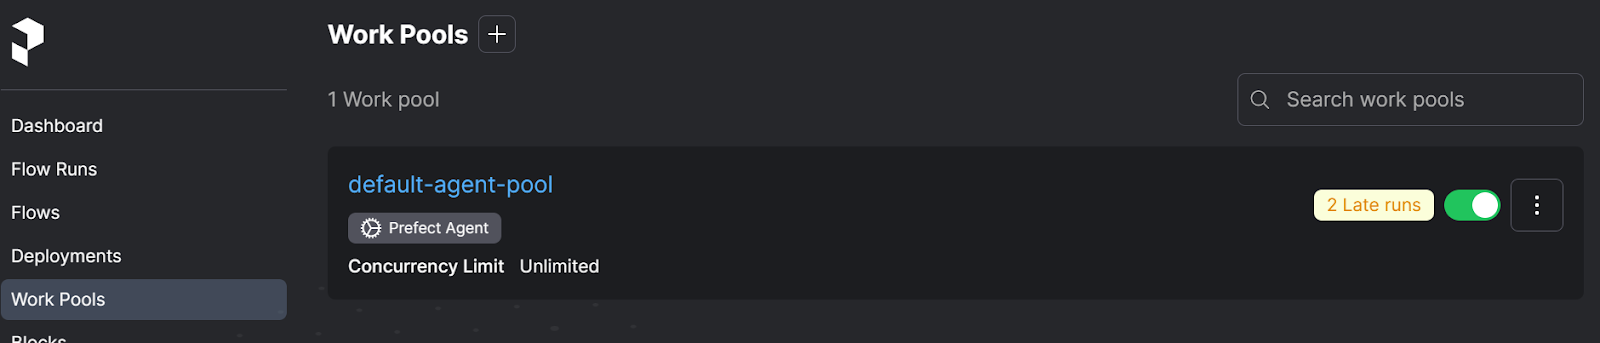
Work Pools में, आप हमारा डिफ़ॉल्ट Prefect Agent देखेंगे। आप Prefect CLI का उपयोग करके क्लाउड वर्क पूल भी सेट कर सकते हैं।
चलिए रोचक हिस्से से शुरू करते हैं।
कोई भी अपने वर्कफ़्लो को चौबीसों घंटे मॉनिटर नहीं करना चाहता। इसके बजाय, हम अपनी पसंदीदा मैसेजिंग ऐप पर वर्कफ़्लो स्टेटस की सूचनाएँ पाना चाहते हैं। इस तरह हम किसी भी समस्या को जल्द सुलझा सकते हैं।
इसे हासिल करने के लिए, हम एक Discord वेबहुक बनाएँगे। वेबहुक ID और टोकन का उपयोग करके, हम Prefect नोटिफिकेशन सेट करेंगे। यह सभी लॉगिंग जानकारी को Discord सर्वर पर भेजेगा।
वेबहुक बनाने के लिए, अपने Discord सर्वर सेटिंग्स में जाएँ, "Integrations" पर क्लिक करें, और "View Webhooks" चुनें। फिर, "New Webhook" पर क्लिक करें।
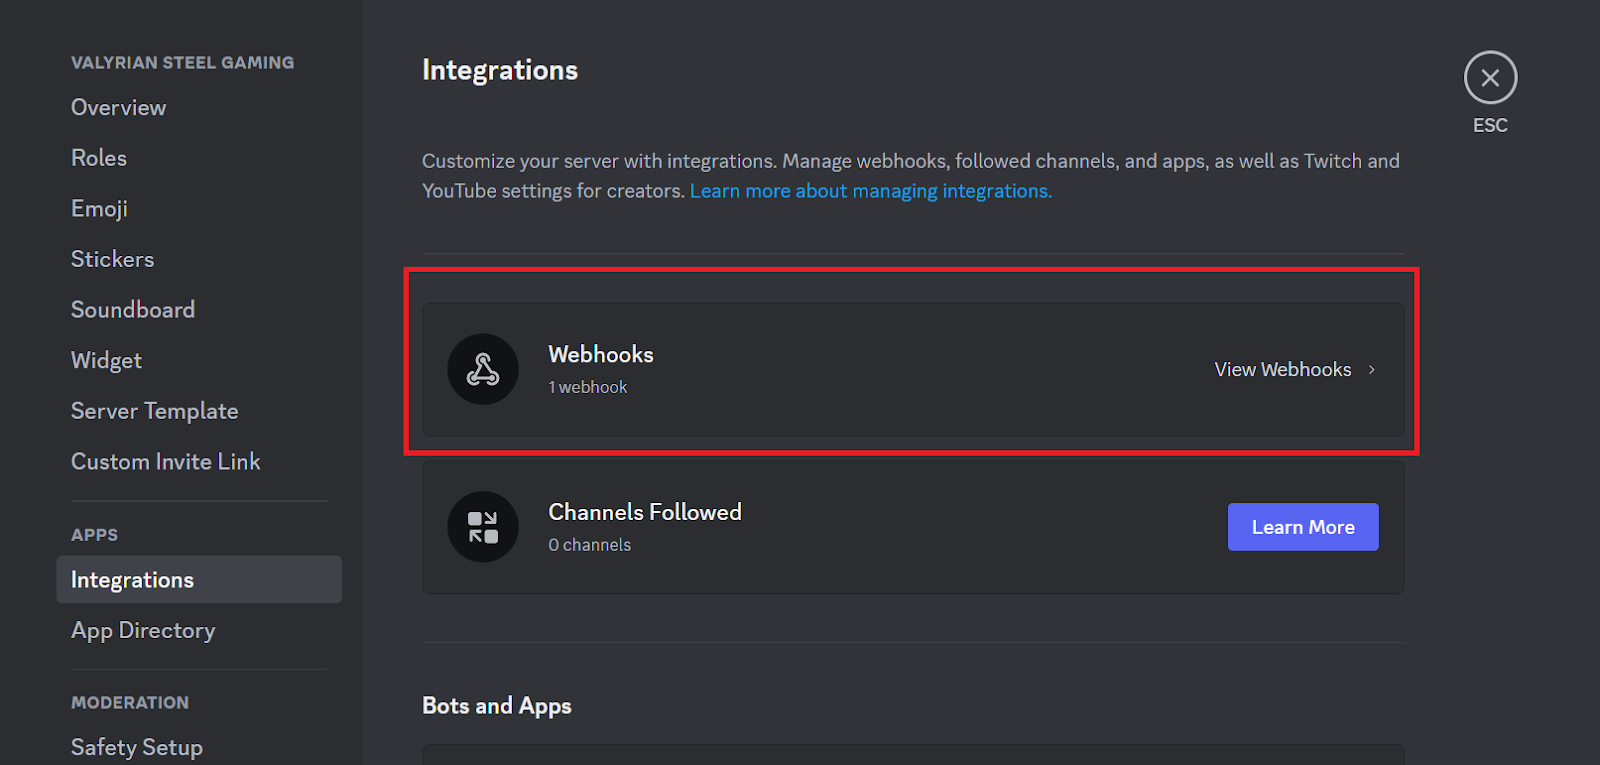
डिस्प्ले इमेज, नाम, और चैनल बदलें। फिर, Webhook URL कॉपी करें।
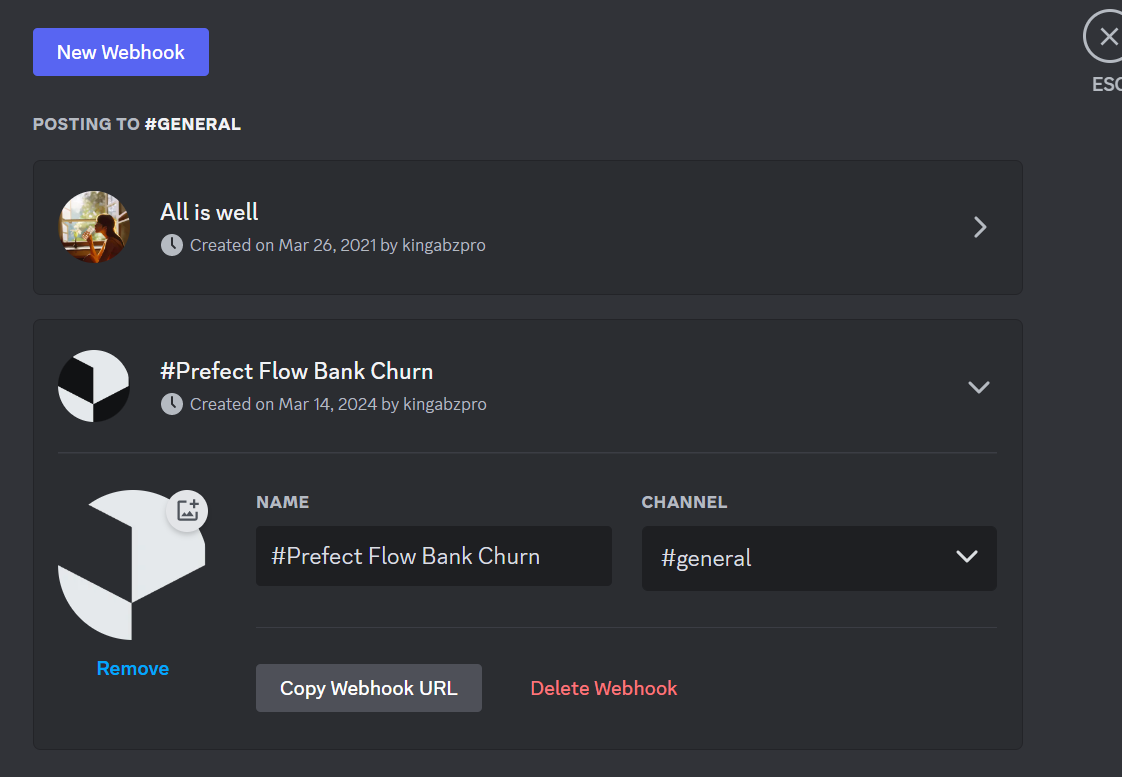
वेबहुक URL दो भागों से मिलकर बना है: Webhook Id और Webhook token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>। Prefect नोटिफिकेशन बनाने के लिए, हमें लिंक से इन दोनों भागों को मैन्युअली अलग करना होगा।
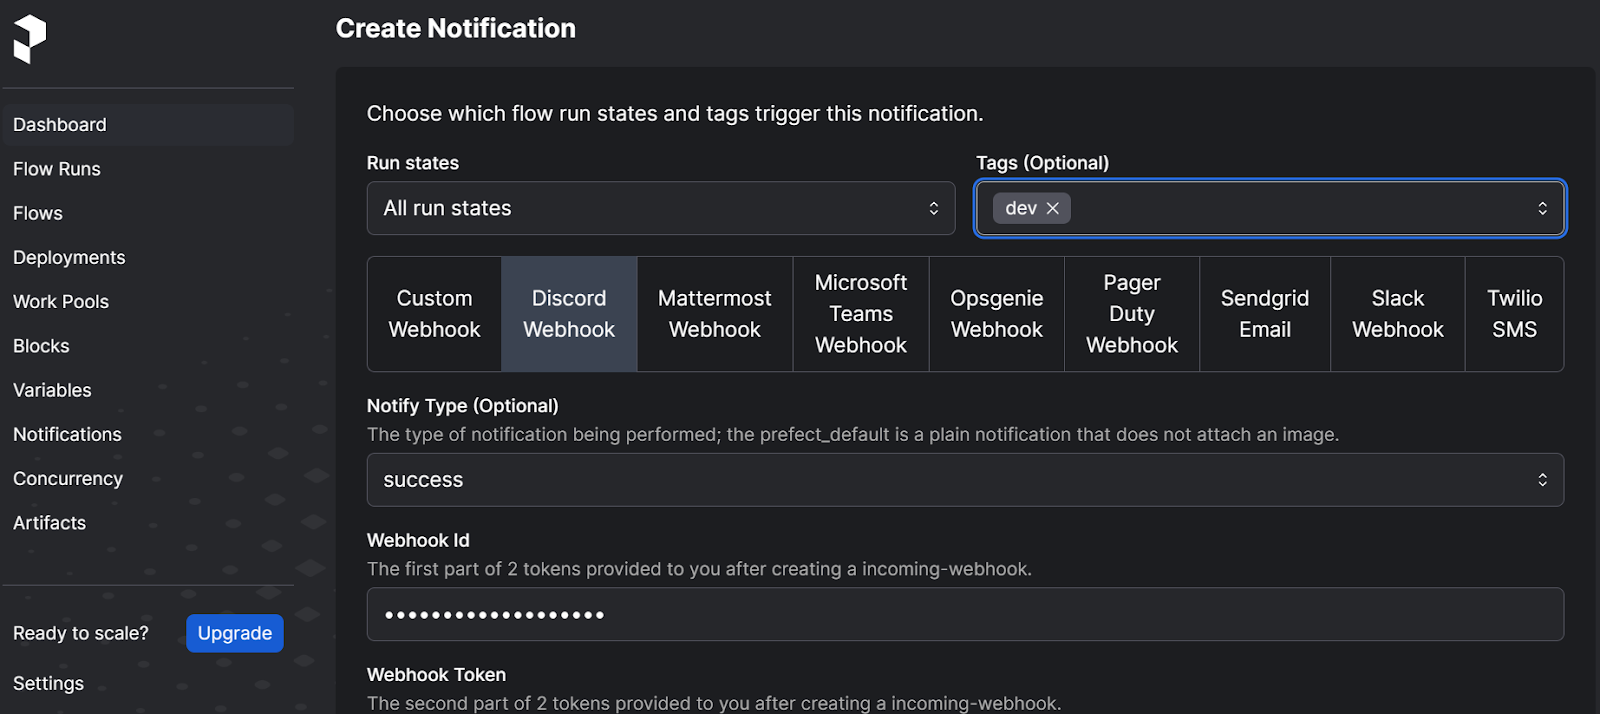
Prefect UI पर Discord नोटिफिकेशन बनाने के लिए, "Notifications" विकल्प में जाएँ और ऊपर "+" बटन पर क्लिक करें। फिर वांछित रन स्टेट्स, टैग्स, Discord वेबहुक, और नोटिफिकेशन टाइप चुनें।
इसके बाद, Webhook ID और Webhook token दें और नीले "Create" बटन पर क्लिक करें।
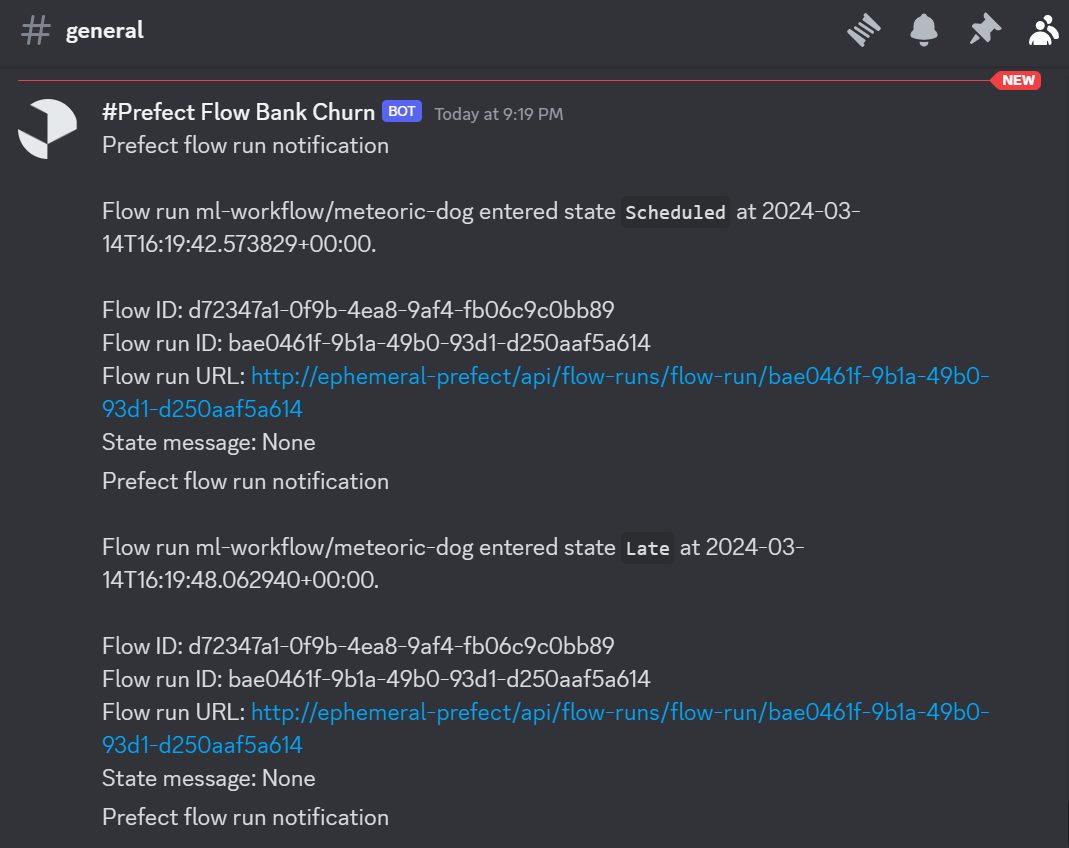
हमें अपने Discord सर्वर के मुख्य चैनल पर नोटिफिकेशन देखने के लिए डिप्लॉयमेंट को निष्पादित करना होगा।
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'बेहतरीन। इसी तरीके से, हम Microsoft Teams, Slack, SMS और ईमेल जैसी विभिन्न मैसेजिंग सेवाएँ सेट कर सकते हैं, और अपना कस्टम वेबहुक भी बना सकते हैं।
लंबे समय तक चलने वाली पाइपलाइनों का निर्माण सीखने के लिए Designing Machine Learning Workflows in Python कोर्स करें।
लोकल रूप से अपना मशीन लर्निंग फ्लो डिप्लॉय करने के बाद, अब इसे Prefect Cloud पर डिप्लॉय करने का समय है। यह लोकल डिप्लॉयमेंट से कहीं आसान प्रक्रिया है, क्योंकि आपको कोई सर्वर या एजेंट शुरू करने या CLI टूल का उपयोग करके रन को निष्पादित करने की ज़रूरत नहीं होती। सब कुछ Prefect द्वारा प्रबंधित होता है।
वर्तमान फ्लो को डिप्लॉय करने से पहले, यह ध्यान देना महत्वपूर्ण है कि यह त्रुटि देगा क्योंकि यह लोकल डायरेक्टरी से फाइलों और डेटा तक पहुँचने की कोशिश करता है जो क्लाउड में सुलभ नहीं है। इन फाइलों को Prefect Cloud के लिए उपलब्ध कराने के लिए, हमें अपना कोड एक सार्वजनिक GitHub रिपॉजिटरी में बनाना और पुश करना होगा।
यह काम GitHub वेबसाइट के माध्यम से आसानी से किया जा सकता है या VSCode Git एक्सटेंशन का उपयोग करके रिमोट रिपॉजिटरी बनाकर और UI के जरिए कोड पुश करके किया जा सकता है।
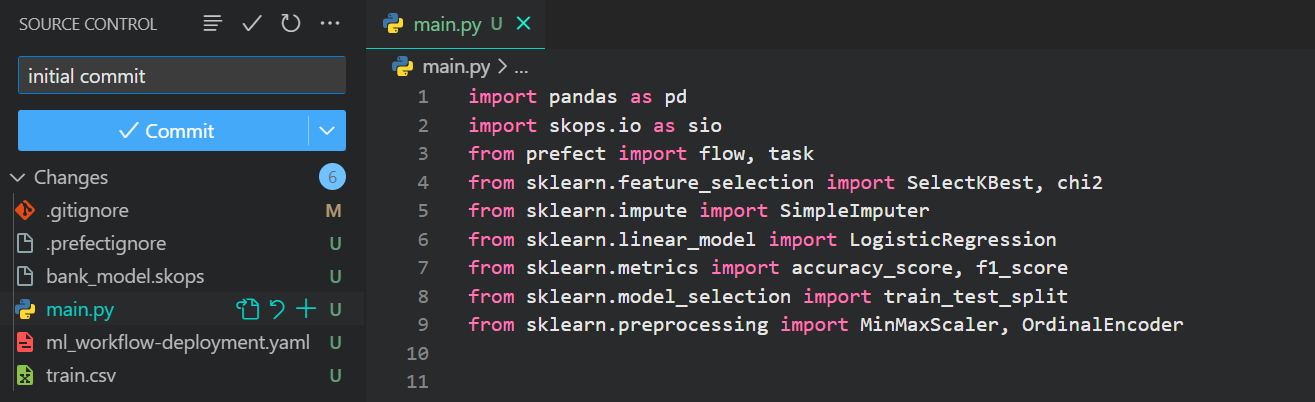
यह वह प्रोजेक्ट रिपॉजिटरी है जिसका हम अपने क्लाउड डिप्लॉयमेंट्स के लिए उपयोग करने जा रहे हैं: kingabzpro/ML-Workflow-Orchestration-With-Prefect
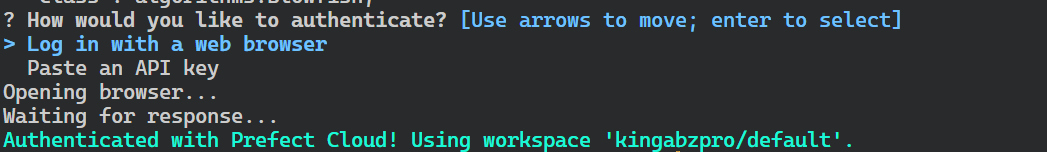
अपना Prefect Cloud अकाउंट https://app.prefect.cloud/auth/login पर जाकर बनाएँ और फिर Prefect CLI टूल का उपयोग करके लॉग इन करें।
$ prefect cloud loginबस "Log in with a web browser" चुनें और Prefect Cloud के साथ लोकल क्लाइंट को प्रमाणित करने के लिए चरणों का पालन करें।
हम अपने लोकल एजेंट के बजाय Prefect Cloud के इन्फ्रास्ट्रक्चर का पूर्ण रूप से उपयोग करने के लिए एक Prefect-मैनेज्ड वर्क पूल बनाएँगे।
$ prefect work-pool create DC-work-pool --type prefect:managedमुफ़्त अकाउंट के लिए, Prefect प्रति माह 10 मुफ़्त कंप्यूट घंटे प्रदान करता है जिनका आप प्रयोग और सीखने के लिए उपयोग कर सकते हैं।
अब हम अपने फ्लो को प्रोग्रामेटिक रूप से Prefect Cloud पर डिप्लॉय करेंगे।
deployment.py नाम की एक नई फ़ाइल बनाएँ।
Prefect फ्लो फ़ंक्शन के लिए आर्ग्युमेंट्स सेट करें:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Python कोड चलाएँ।
$ python deployment.pyफ्लो Prefect Cloud पर डिप्लॉय हो गया है। इसे CLI या Prefect Cloud डैशबोर्ड के माध्यम से निष्पादित किया जा सकता है।
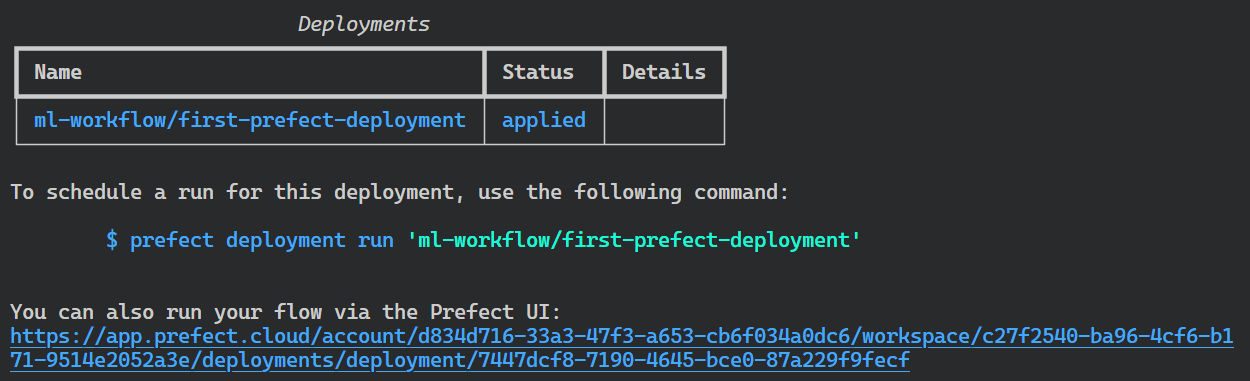
फ्लो चलाने के लिए, हमें इस वेबसाइट पर जाना होगा: https://app.prefect.cloud/। इसके बाद, “Deployments” सेक्शन में जाएँ, अपने डिप्लॉयमेंट पर वर्टिकल तीन-डॉट बटन पर क्लिक करें, और “Quick run” विकल्प चुनें।
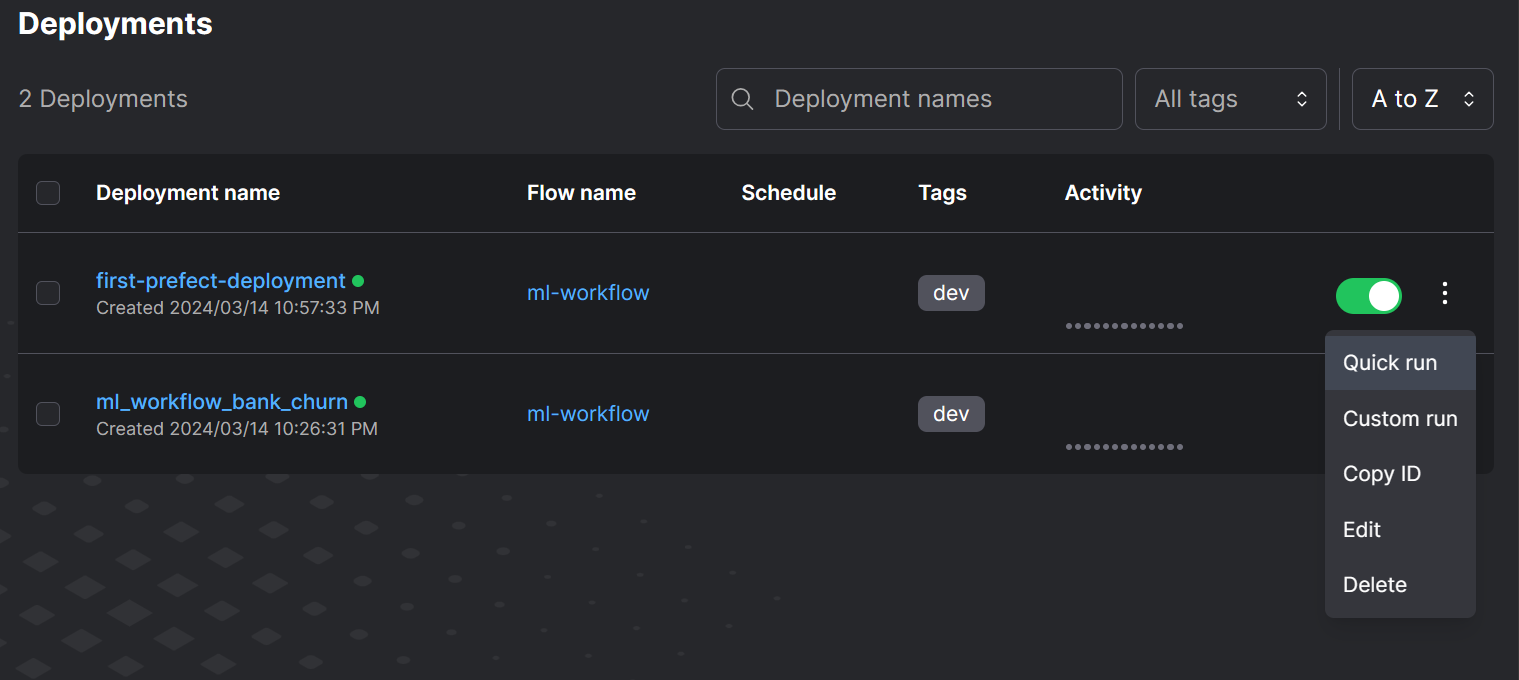
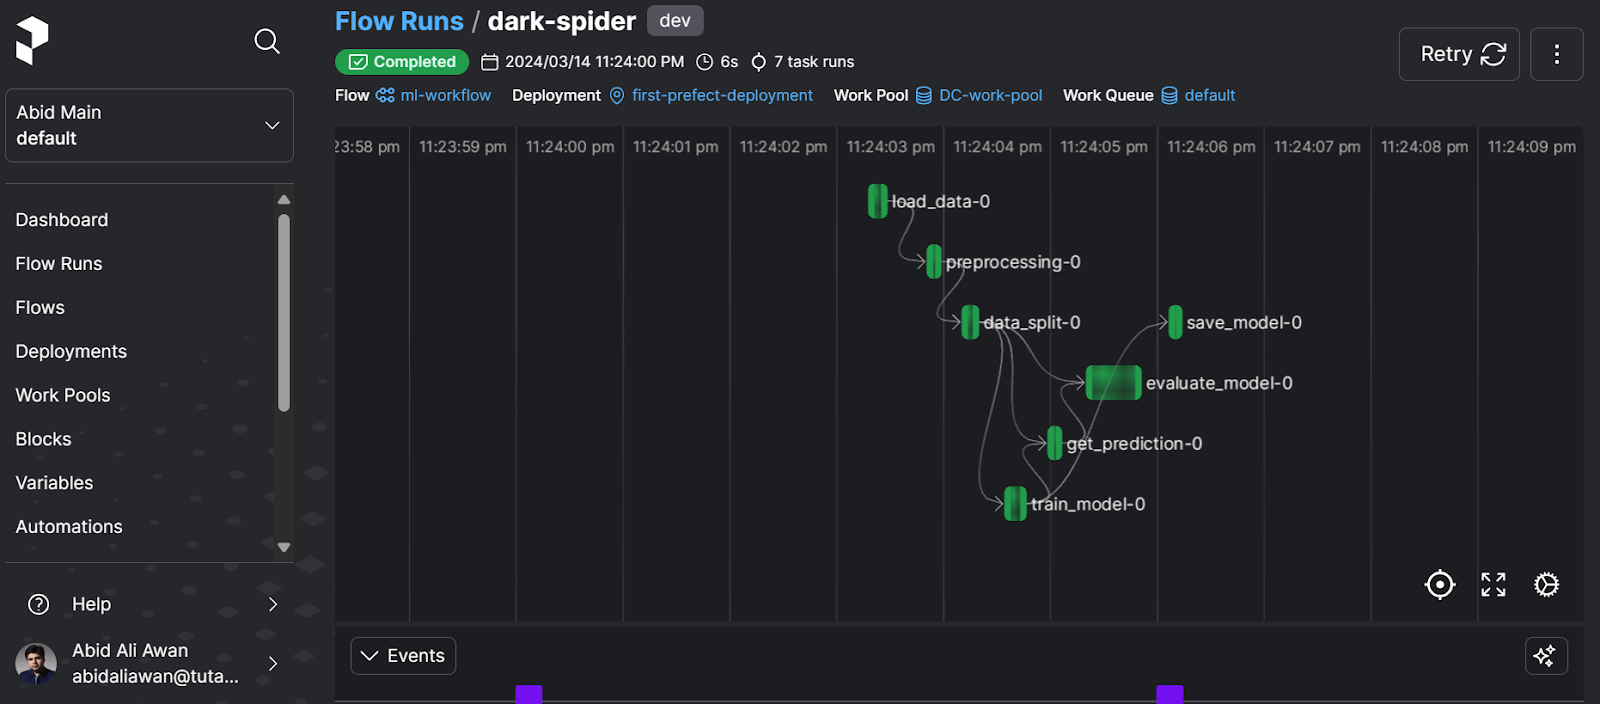
हमारा रन कैसा प्रदर्शन कर रहा है यह देखने के लिए, “Flow Run” सेक्शन में जाएँ और वर्कफ़्लो ग्राफ़ देखने के लिए सबसे हालिया रन पर क्लिक करें।
फ्लो डायग्राम टास्क के बीच के इंटरकनेक्शन और प्रत्येक प्रक्रिया में लगे समय का अवलोकन प्रस्तुत करता है।
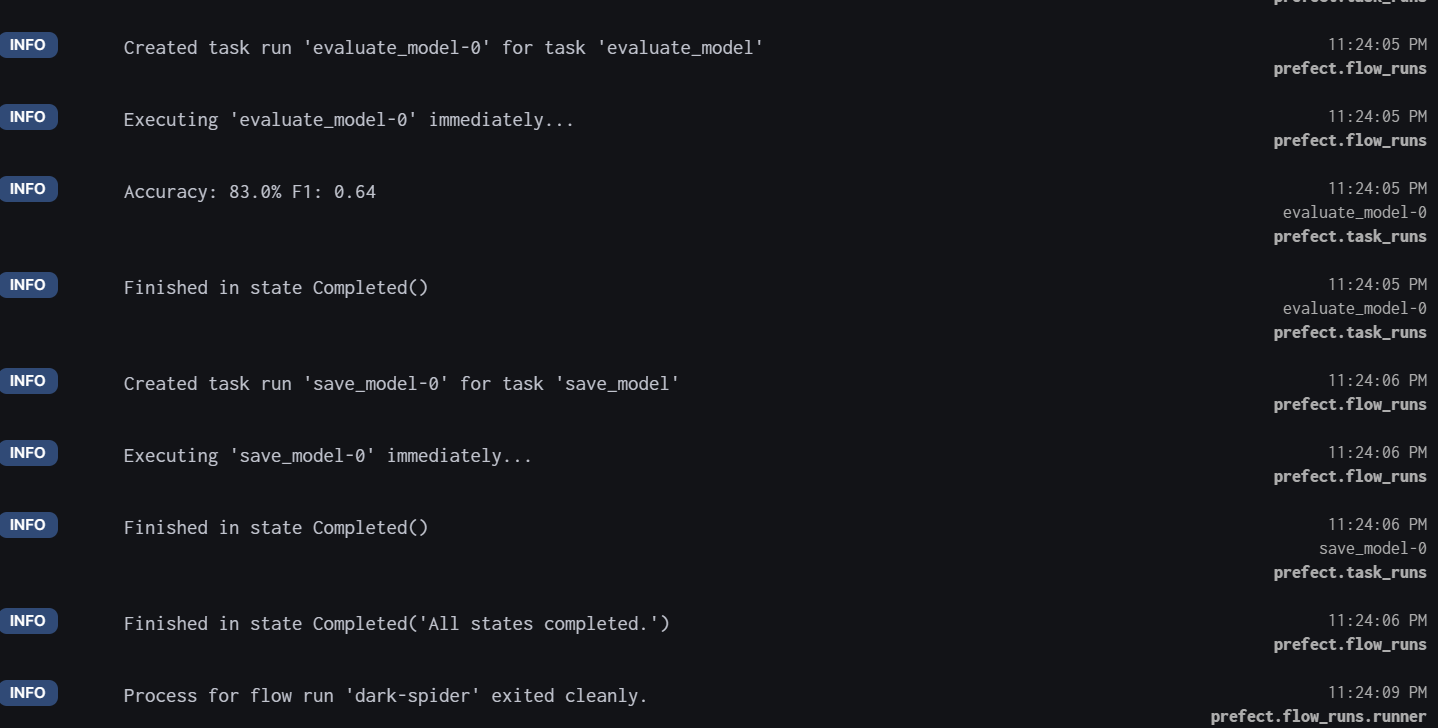
विस्तृत लॉग के लिए, नीचे स्क्रॉल करें और टाइम स्टैम्प के साथ किए गए सभी टास्क देखें।
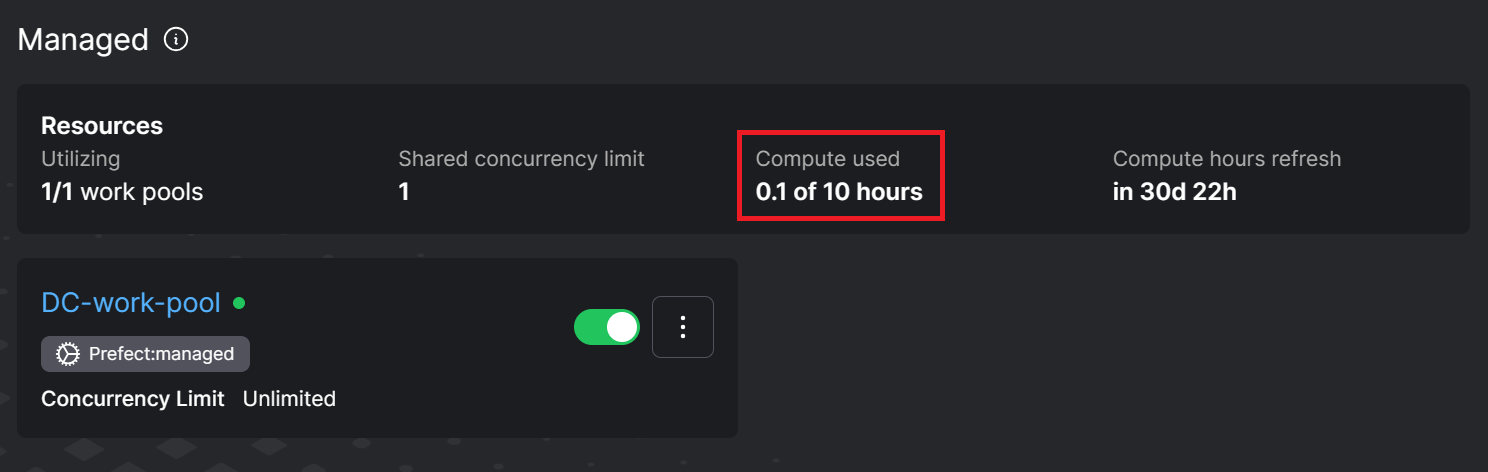
यदि हम “Work Pools” सेक्शन में जाएँ, तो स्पष्ट रूप से देख सकते हैं कि मुफ़्त उपयोगकर्ताओं के 10-घंटे की सीमा में से हमने 0.1 घंटे का उपयोग किया है।
Machine Learning Workflow गाइड देखें, जिसमें एक इन्फोग्राफ़िक शामिल है जो प्रोजेक्ट सेटअप, डेटा तैयारी, मॉडलिंग और डिप्लॉयमेंट से जुड़े कार्यों को समझने में मदद करता है।
एकल मशीन-लर्निंग वर्कफ़्लो सेट करना आसान था। वास्तविक परिदृश्यों में आपको एक साथ कई मशीन लर्निंग और डेटा वर्कफ़्लो चलाने की आवश्यकता हो सकती है। यहीं Prefect उत्कृष्ट साबित होता है। यह स्केलेबिलिटी और लचीलापन प्रदान करता है—चाहे आप इसे लोकल या क्लाउड वातावरण में, Prefect सर्वर या वर्क पूल पर चलाएँ। शेड्यूलिंग, ऑटोमेशन और वर्कफ़्लो मैनेजमेंट के लिए यह एक शानदार टूल है।
इस ट्यूटोरियल में, हमने Prefect इकोसिस्टम की मुख्य विशेषताओं और कार्यात्मकताओं को कवर किया। हमने यह भी सीखा कि मशीन लर्निंग फ्लो को लोकल और क्लाउड—दोनों पर कैसे डिप्लॉय करें। अपनी MLOps यात्रा जारी रखने के लिए, अगला कदम है “A Beginner's Guide to CI/CD for Machine Learning” का अनुसरण करके मशीन लर्निंग वर्कफ़्लोज़ के लिए CI/CD बनाना सीखना।
Prefect, MLOps क्षेत्र में वर्कफ़्लो ऑर्केस्ट्रेशन के लिए उपयोग किया जाने वाला एक टूल है। डेटा वर्शनिंग, फीचर स्टोर्स, मॉडल टेस्टिंग, मॉडल डिप्लॉयमेंट और सर्विंग, मॉडल मॉनिटरिंग, रनटाइम इंजन और एंड-टू-एंड MLOps टूल्स जैसे अन्य महत्वपूर्ण टूल्स के बारे में जानने के लिए लेख 25 Top MLOps Tools You Need to Know in 2024 पढ़ें। आप हमारा Prefect बनाम Airflow तुलना लेख भी पढ़ सकते हैं ताकि समझ सकें कि ये टूल एक-दूसरे के मुक़ाबले कैसे ठहरते हैं।
आज ही अपनी मशीन लर्निंग यात्रा जारी रखें!
कोर्स
कोर्स
कोर्स