Als je analyseert hoe lang dingen meegaan (of het nu de levensduur van elektronische componenten is, overlevingstijden van patiënten of de betrouwbaarheid van apparatuur), heb je een verdeling nodig die met de complexiteit van faalpatronen kan omgaan. De Weibull-verdeling gaat er, in tegenstelling tot simpelere modellen, niet van uit dat falen tegen een constant tempo optreedt. In plaats daarvan kan ze scenario’s modelleren waarin faalpercentages in de tijd toenemen (zoals slijtageprocessen), aanvankelijk afnemen (zoals het wegvallen van vroege fabricagefouten) of constant blijven.
Als kansrekening nieuw voor je is, behandelt onze cursus Foundations of Probability in R de statistische basis die je nodig hebt voor geavanceerd werk met verdelingen. Deze tutorial leidt je door de wiskundige fundamenten van de Weibull-verdeling. Je leert hoe je de parameters uit data schat en ziet hoe de flexibiliteit de verdeling bijzonder nuttig maakt in betrouwbaarheidsonderzoek en survivalstudies. Aan het eind begrijp je niet alleen de theorie achter deze handige verdeling, maar ook wanneer en hoe je haar toepast op je eigen tijd-tot-gebeurtenisvraagstukken.
Wat is de Weibull-verdeling?
De Weibull-verdeling is een continue kansverdeling die is ontworpen voor het modelleren van tijd-tot-gebeurtenisdata. Je komt haar het vaakst tegen in faalanalyse, survivalstudies en betrouwbaarheidstechniek, waar het doel is te begrijpen "wanneer iets gebeurt".
Wat de Weibull onderscheidt van simpelere alternatieven is haar aanpasbaarheid aan verschillende faalpatronen. Terwijl sommige verdelingen aannemen dat gebeurtenissen tegen een stabiel, voorspelbaar tempo plaatsvinden, kan Weibull omgaan met situaties waarin de kans op gebeurtenissen in de tijd verandert. Die flexibiliteit is nuttig als je met complexe systemen of processen werkt waarvan de onderliggende mechanismen niet volledig begrepen zijn.
Historische context en basisprincipes
Het verhaal achter deze verdeling begint bij de Zweedse wiskundige Waloddi Weibull, die haar in de jaren 1930 ontwikkelde bij onderzoek naar materiaalkracht en vermoeiing. Zijn werk legde de basis voor de moderne betrouwbaarheidstechniek.
De verdeling kent twee primaire vormen die verschillende analytische behoeften dienen. De twee-parameter-Weibull gebruikt vorm- en schaalparameters om scenario’s te modelleren waarin gebeurtenissen meteen kunnen starten. De drie-parameter-versie voegt een locatieparameter toe, waarmee een minimale drempel ontstaat voordat gebeurtenissen kunnen optreden—handig voor het modelleren van systemen met ingebouwde vertragingen of "inloop"-periodes.
De Weibull behoort tot een familie van verwante verdelingen, waarbij de exponentiële verdeling als speciaal geval verschijnt. Deze connectie verklaart waarom je in betrouwbaarheidscontexten vaak Weibull- en exponentiële modellen met elkaar vergeleken ziet. Door haar bredere flexibiliteit kan Weibull onder specifieke parametercondities andere bekende verdelingen benaderen, wat bijdraagt aan de brede adoptie.
Parameters van de Weibull-verdeling
Nu we de historische ontwikkeling en het basisgedrag hebben behandeld, kijken we naar de parameters die de Weibull-verdeling haar flexibiliteit geven. Elke parameter vertelt je iets specifieks over het gedrag van je data.
De vormparameter (k of β) bepaalt het karakter van de verdeling en hoe de hazardfunctie zich gedraagt. Bij waarden kleiner dan 1 zie je infant mortality-patronen waarbij vroege falingen optreden door fabricagefouten. Bij waarden groter dan 1 zie je slijtagefalingen waarbij zaken in de tijd door gebruik stukgaan.
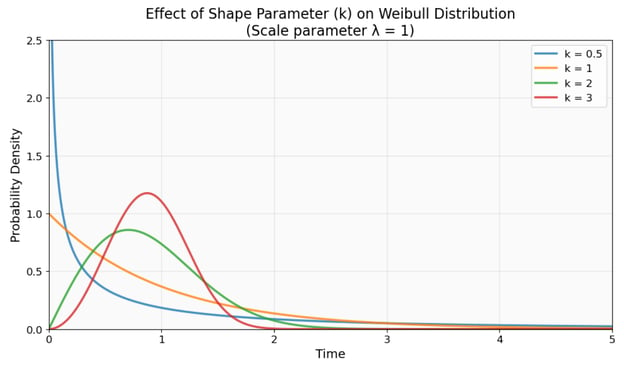
Effect van de vormparameter (k) op het gedrag van de Weibull-verdeling. Let op hoe k < 1 een hoge vroege faalkans geeft (blauwe curve), k = 1 constante faalpercentages oplevert (oranje) en k > 1 stijgende faalpercentages in de tijd laat zien (groene en rode curves). Afbeelding door de auteur.
De schaalparameter (λ of η) vertegenwoordigt de karakteristieke levensduur. Dit is het tijdstip waarop precies 63,2% van de items gefaald zal hebben, ongeacht de waarde van de vormparameter. Je kunt dit zien als de typische levensduur van de verdeling, al kan het werkelijke gemiddelde afwijken door de vorm van de verdeling.
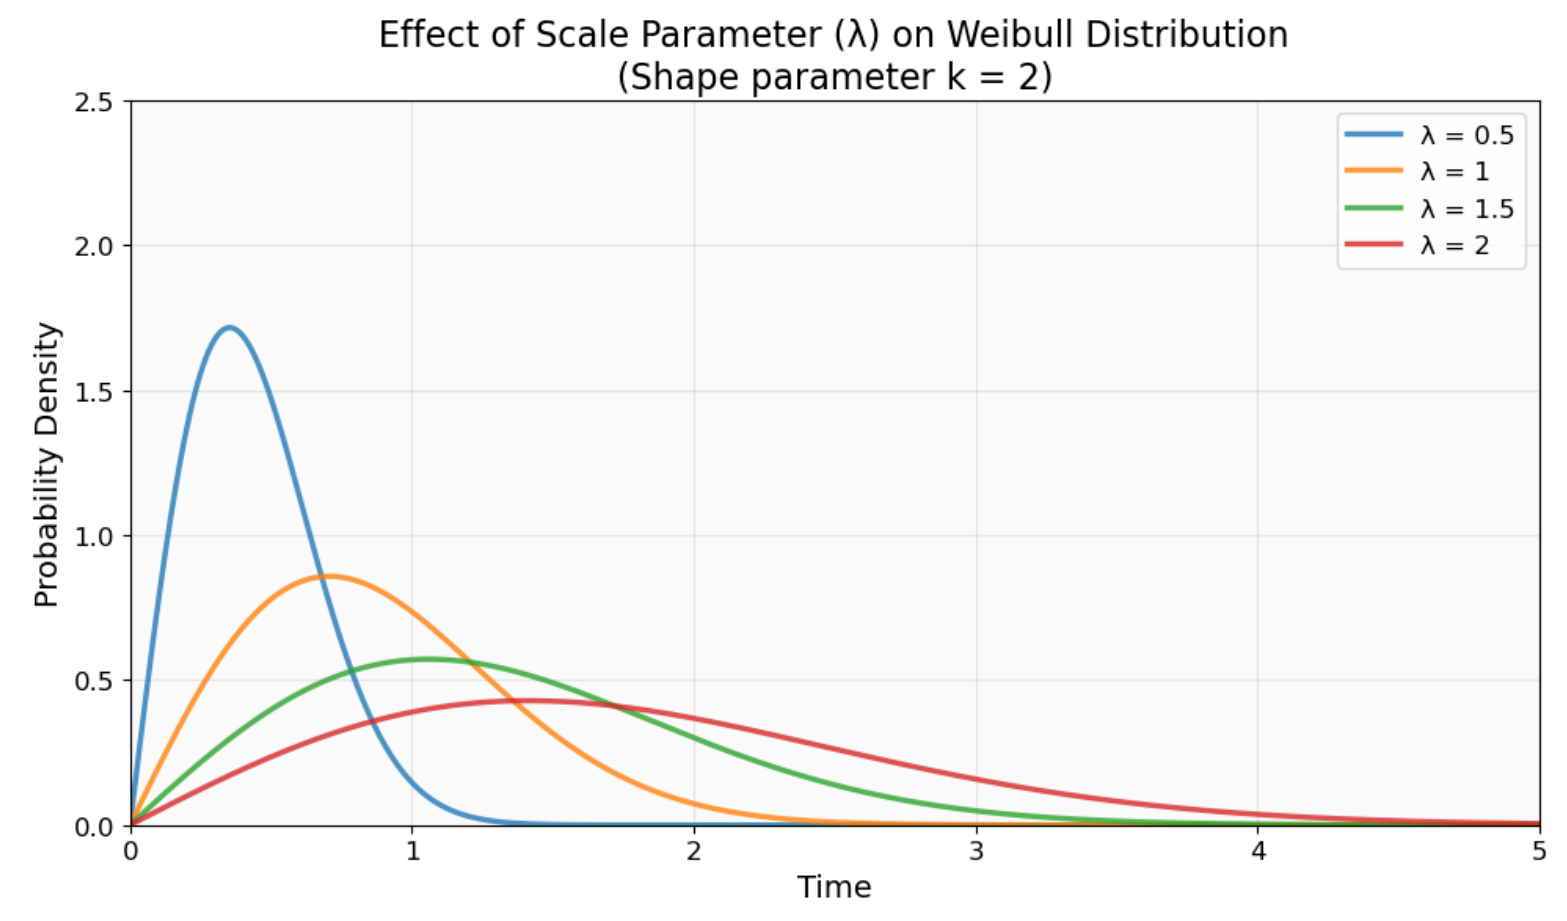
Hoe de schaalparameter (λ) de Weibull-verdeling langs de tijd-as verschuift. Grotere λ-waarden rekken de verdeling naar rechts (langere karakteristieke levensduur), terwijl kleinere waarden haar naar links comprimeren (kortere karakteristieke levensduur). De vorm blijft consistent. Afbeelding door de auteur.
In drie-parameter-toepassingen verschuift de locatieparameter (θ of γ) de verdeling langs de tijd-as. Die vertegenwoordigt een gegarandeerde minimale levensduur voordat falingen kunnen beginnen, wat helpt bij het modelleren van systemen met inloopperiodes of componenten met garantieperiodes waarin vroege falingen onmogelijk zijn.
Verschillende vakgebieden gebruiken verschillende notaties, dus je kunt (k,λ) zien in betrouwbaarheidstechniek of (β,η) in survivalanalyse. De wiskundige relaties blijven hetzelfde, ongeacht welke notatie je tegenkomt.
Wiskundige karakterisering en statistische eigenschappen
De wiskundige basis van de Weibull-verdeling biedt de tools die nodig zijn voor praktische toepassingen. Laten we de kernfuncties verkennen die deze verdeling nuttig maken.
Kernfuncties en -maten
De waarschijnlijkheidsdichtheidsfunctie (PDF) beschrijft de kans dat falen op een specifiek tijdstip optreedt. Voor de Weibull-verdeling is dit:
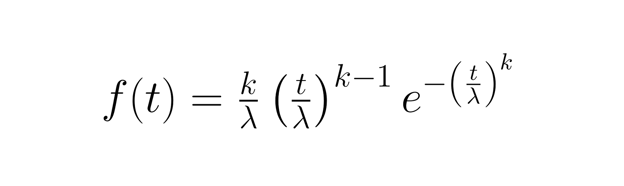
Deze functie laat zien hoe de faal-dichtheid in de tijd verandert, waarbij de vormparameter k bepaalt of falen eerder waarschijnlijker is (k < 1), constant in de tijd (k = 1) of toeneemt met de leeftijd (k > 1).
De cumulatieve verdelingsfunctie (CDF) geeft de kans dat falen tegen een specifiek tijdstip optreedt:
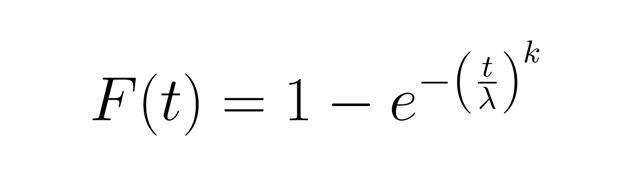
Deze functie werkt goed om het percentage items te berekenen dat binnen een bepaalde tijdsperiode naar verwachting faalt. De betrouwbaarheidsfunctie (1-CDF) biedt het complementaire perspectief en toont de kans op overleving voorbij tijd t.
De hazardfunctie onthult het instantane faaltempo op elk gegeven tijdstip:
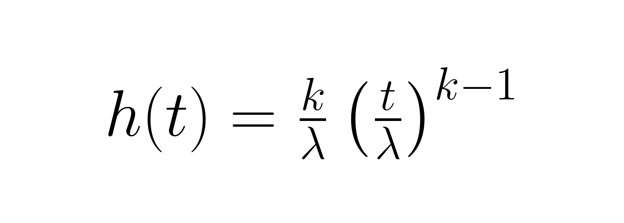
Deze functie is essentieel om te begrijpen hoe risico in de tijd verandert. Bij k < 1 daalt de hazard (betrouwbaarheid verbetert), bij k = 1 blijft hij constant, en bij k > 1 stijgt hij (betrouwbaarheid verslechtert). De overlevingsfunctie, identiek aan de betrouwbaarheidsfunctie, vertegenwoordigt de kans om voorbij een gegeven tijdstip te overleven.
Statistische momenten karakteriseren de centrale tendensen en variabiliteit van de verdeling. Het gemiddelde omvat de gammafunctie en hangt van beide parameters af, waardoor het complexer is dan de karakteristieke levensduur. De variantie kwantificeert de spreiding rond het gemiddelde, terwijl de mediaan vaak intuïtiever is dan het gemiddelde bij scheve verdelingen. De modus vertegenwoordigt het meest waarschijnlijke faalmoment, al bestaat die niet voor alle parametercombinaties.
De momentgenererende functie vangt alle statistische momenten in één uitdrukking, terwijl entropie de onzekerheid of informatie-inhoud van de verdeling meet. Deze eigenschappen, samen met patronen in faaltempo, maken de Weibull-verdeling geschikt voor het modelleren van diverse fenomenen uit de praktijk, waar simpele exponentiële aannames tekortschieten.
Conditionele betrouwbaarheid en percentielen
Berekeningen van conditionele betrouwbaarheid beantwoorden praktische vragen zoals: "Als dit onderdeel al 1000 uur heeft overleefd, wat is de kans dat het nog 500 uur meegaat?" Dit houdt in dat je de kans op overleving voor een extra periode berekent, gegeven overleving tot het huidige punt. De berekening gebruikt de volgende relatie:
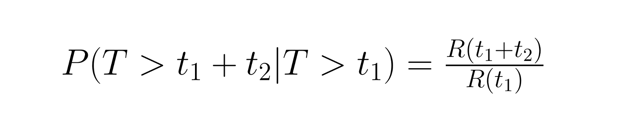
waarbij R(t) de betrouwbaarheidsfunctie is.
Percentielen helpen belangrijke levensduurmaten te schatten die bedrijfsbeslissingen sturen. De B₁₀-levensduur is het tijdstip waarop 10% van de items gefaald heeft, terwijl B₉₀ aangeeft wanneer 90% heeft gefaald. Deze percentielen zijn essentieel voor garantieanalyse, onderhoudsplanning en risicobeoordeling.
De percentpuntfunctie (inverse CDF) biedt directe schatting van kwantielen door F(t) = p op te lossen voor elke gewenste kans p. Deze functie zet cumulatieve kansen terug om in tijdwaarden, zodat je specifieke faalmomenten kunt bepalen voor gegeven betrouwbaarheidsniveaus. De meeste statistische softwarepakketten bevatten ingebouwde functies voor deze berekeningen, waardoor percentielschatting eenvoudig wordt zodra je de Weibull-parameters hebt geschat.
Parameter-schatmethoden
De wiskundige eigenschappen begrijpen is één ding, maar hoe bepaal je deze parameters daadwerkelijk uit je data? Het schatten van Weibull-parameters vereist dat je de juiste methode kiest voor jouw situatie en datakenmerken. Elke aanpak heeft specifieke voor- en nadelen.
Maximum likelihood-schatting (MLE)
MLE biedt de meest statistisch robuuste aanpak voor parameterschatting. Ze vindt de parameterversies die de waarschijnlijkheid van je geobserveerde data maximaliseren, waardoor ze effectief is bij volledige datasets. Zie het als het vinden van de parameters die je geobserveerde data het "waarschijnlijkst" maken.
De methode gaat om met gecensureerde data (waarbij je weet dat items tot een bepaald punt hebben overleefd, maar niet hun exacte faalmoment) via gespecialiseerde algoritmen. Dit is nuttig in betrouwbaarheidstesten, waar je niet altijd kunt wachten tot elk item faalt. De meeste statistische softwarepakketten bevatten MLE-routines die specifiek voor Weibull-analyse zijn ontworpen. Hoewel de rekencomplexiteit toeneemt met de omvang van de dataset, verwerken moderne implementaties datasets met honderdduizenden observaties efficiënt.
Methode van momenten (MOM)
De MOM-aanpak schat parameters door theoretische momenten te laten aansluiten op steekproefmomenten uit je data. Hoewel minder statistisch efficiënt dan MLE, biedt ze computationele eenvoud en vaak goede startschattingen voor complexere methoden.
Deze aanpak werkt goed als je snelle schattingen nodig hebt of als je werkt met data die niet perfect aan MLE-aannames voldoet. Ze is ook handig om een ruwe indruk van je parameters te krijgen voordat je in geavanceerdere analyses duikt.
Kleinste kwadraten en grafische technieken
Weibull-probability plots transformeren data naar logaritmische coördinaten waar Weibull-verdelingen als rechte lijnen verschijnen, waardoor je de model-fit visueel kunt valideren terwijl je parameters schat via lineaire regressie. De methode gebruikt speciaal geschaald grafiekpapier (nu digitaal in software) met een dubbel-logaritmische transformatie die de cumulatieve Weibull-verdeling lineariseert.
Het proces omvat het rangschikken van je faaldata van klein naar groot, het berekenen van mediane rangposities voor elk datapunt (die de cumulatieve faalkans schatten) en het plotten van faaltijden tegen deze kansen. Als je data een Weibull-verdeling volgt, vormen de punten ongeveer een rechte lijn waarvan de helling gelijk is aan de vormparameter en waarvan de positie de schaalparameter bepaalt. Het is ouderwets, maar het werkt, en de visuele feedback is waardevol om je data te begrijpen. Wanneer punten sterk afwijken van lineariteit, suggereert dat dat het Weibull-model mogelijk niet geschikt is voor je dataset, waardoor deze techniek waardevol is voor zowel parameterschatting als modelvalidatie.
Uitdagingen bij drie parameters
Het schatten van de locatieparameter θ kent unieke moeilijkheden omdat die de ondergrens van de verdeling beïnvloedt. Standaard MLE kan onbetrouwbare schattingen opleveren wanneer θ de minimaal geobserveerde faaltijd nadert.
Profile likelihood-methoden pakken deze schatproblemen aan door θ als een hinderparameter te behandelen, wat stabielere schattingen voor de vorm- en schaalparameters oplevert. Het is wat complexer, maar vaak nodig voor betrouwbare resultaten.
Toepassingen over disciplines heen
De veelzijdigheid van de Weibull-verdeling blijkt uit de toepassingen in uiteenlopende vakgebieden. Elk domein benut specifieke aspecten van de flexibiliteit van de verdeling.
Betrouwbaarheidstechniek
Betrouwbaarheidsingenieurs gebruiken Weibull-analyse voor versnelde levensduurtesten, waarbij producten onder stressomstandigheden worden getest om levensduren bij normaal gebruik te voorspellen. In plaats van jaren te wachten om te zien hoelang iets meegaat, kun je het onder stress testen en extrapoleren naar normale omstandigheden.
Garantianalyses steunen op Weibull-modellen om toekomstige claims te schatten en passende dekkingsperiodes vast te stellen. Bedrijven moeten weten hoeveel producten binnen de garantieperiode falen om hun prijzen correct te bepalen.
Preventieve onderhoudsplanning profiteert van Weibulls vermogen om veranderende faalpercentages over de levenscyclus van apparatuur te modelleren. In tegenstelling tot exponentiële modellen, die uitgaan van constante faalpercentages, kan Weibull aangeven wanneer faalpercentages beginnen te stijgen, zodat je onderhoud kunt plannen vóórdat iets stukgaat.
Medische en biologische wetenschappen
Survivalanalyse in medisch onderzoek gebruikt vaak Weibull-modellen om de effectiviteit van behandelingen en de prognose van patiënten te bestuderen. De verdeling gaat van nature om met gecensureerde data, die veel voorkomt in klinische studies waar patiënten het onderzoek kunnen verlaten voordat de gebeurtenis van interesse optreedt.
Weibull-regressie breidt de basisanalyse uit door patiëntkenmerken (leeftijd, behandelingstype, ziekte-stadium) als covariabelen op te nemen. Dit levert gepersonaliseerde overlevingsschattingen op die essentieel zijn voor behandelplanning, zodat artsen patiënten realistische verwachtingen over hun prognose kunnen geven.
Materiaalkunde en bosbouw
Materiaalkundigen gebruiken Weibull-verdelingen om de sterkte van brosse materialen zoals keramiek en composieten te modelleren, waar de zwakste schakel het totale falen bepaalt. Het vermogen van de verdeling om extreme waarden te modelleren maakt haar ideaal voor toepassingen waarin je het worstcasescenario wilt begrijpen.
Bosbeheer past Weibull-modellen toe op boomdiameterverdelingen, wat helpt om oogstopbrengsten te voorspellen en duurzaam bosbeheer te plannen. Het is een praktische toepassing die economische en ecologische belangen in balans helpt brengen.
Windenergie en milieustudies
Hoewel dit artikel focust op tijd-tot-gebeurtenis-toepassingen, modelleren Weibull-verdelingen ook andere fenomenen in milieutechniek. Windbronbeoordeling gebruikt Weibull om windsnelheidspatronen op potentiële turbinelocaties te karakteriseren, waarbij vormparameters de windconsistentie voor energieproductieplanning aangeven.
Geavanceerde onderwerpen en uitbreidingen
Hoe nuttig deze standaardtoepassingen ook zijn, moderne problemen vereisen vaak dat je verder gaat dan basis-Weibull-analyses.
Modelselectie en goodness-of-fit
Kiezen tussen Weibull en alternatieve verdelingen vereist systematisch testen met goodness-of-fit-statistieken zoals de Kolmogorov-Smirnov- en Anderson-Darling-toetsen. Deze toetsen kwantificeren hoe goed je gekozen verdeling aansluit bij geobserveerde patronen, zodat je vertrouwen krijgt in je modelkeuze.
Grafische diagnostiek vult statistische toetsen aan door patronen te onthullen die cijfers alleen kunnen missen. Residualanalyse helpt systematische afwijkingen van verwacht gedrag te identificeren, terwijl informatiecriteria (AIC/BIC) model-fit afwegen tegen complexiteit. Je wilt in feite een model dat goed past zonder onnodig ingewikkeld te zijn.
Regressie- en mengmodellen
Weibull-regressie verwerkt verklarende variabelen direct in de verdelingsparameters, zodat je kunt modelleren hoe factoren als temperatuur, belasting of patiëntkenmerken het faalgedrag beïnvloeden. Deze uitbreiding is nuttig in betrouwbaarheidstesten en medisch onderzoek waar meerdere factoren de uitkomst bepalen.
Meng-Weibull-modellen gaan om met populaties met duidelijke subgroepen (zoals verschillende faalmodi) door meerdere Weibull-verdelingen te combineren. Denk aan een populatie waarin sommige items falen door slijtage en andere door willekeurige defecten. Je hebt verschillende modellen nodig voor elke faalmodus.
Machinelearningtoepassingen gebruiken deze modellen in toenemende mate voor complexe patroonherkenning en neurale netwerken, waardoor traditionele statistische methoden met moderne AI-technieken worden verbonden.
Concurrerende risico’s en degradatiemodellen
Sommige systemen worden tegelijk geconfronteerd met meerdere faalmodi. Mechanische slijtage, elektrische storingen en omgevingsdegradatie kunnen allemaal dezelfde component bedreigen. Modellen voor concurrerende risico’s gebruiken meerdere Weibull-verdelingen om elke faalmodus te vertegenwoordigen, zodat je begrijpt welke risico’s het meest kritiek zijn.
Degradatiemodellen volgen hoe de systeemprestatie in de tijd afneemt, waarbij Weibull-verdelingen het tijdstip modelleren waarop prestaties onder aanvaardbare drempels zakken. Dit is nuttig voor systemen waarbij je degradatie kunt meten voordat volledig falen optreedt.
Verwante en speciale vormen
De inverse Weibull-verdeling modelleert situaties waarin grotere waarden minder waarschijnlijk zijn, zoals minimale sterkte in materialen of kortste overlevingstijden in de biologie. Deze variant is nuttig wanneer traditionele Weibull-aannames niet bij je datapatronen passen.
Discrete Weibull-verdelingen passen het continue model aan voor teldata, zoals het aantal cycli tot falen of discrete tijdsintervallen in survivalstudies. Het is minder gebruikelijk, maar handig wanneer je data in discrete stappen komt in plaats van als continue metingen.
Conclusie
De aanpasbaarheid van de Weibull-verdeling maakt haar waardevol voor het analyseren van wanneer dingen in de tijd gebeuren. Ze kan toenemende, afnemende of constante hazardpercentages aan en werkt goed met onvolledige data. Onze cursussen Survival Analysis in Python en Survival Analysis in R laten je oefenen met datasets en beproefde methoden.
Toekomstige onderzoekslijnen omvatten Bayesiaanse benaderingen die eerderkennis effectiever integreren, hybride modellen met machine learning die Weibull modellering combineren met neurale netwerken, en bigdata-toepassingen die traditionele methoden schalen naar enorme datasets.




Als je analyseert hoe lang dingen meegaan (of het nu de levensduur van elektronische componenten is, overlevingstijden van patiënten of de betrouwbaarheid van apparatuur), heb je een verdeling nodig die met de complexiteit van faalpatronen kan omgaan. De Weibull-verdeling gaat er, in tegenstelling tot simpelere modellen, niet van uit dat falen tegen een constant tempo optreedt. In plaats daarvan kan ze scenario’s modelleren waarin faalpercentages in de tijd toenemen (zoals slijtageprocessen), aanvankelijk afnemen (zoals het wegvallen van vroege fabricagefouten) of constant blijven.
Als kansrekening nieuw voor je is, behandelt onze cursus Foundations of Probability in R de statistische basis die je nodig hebt voor geavanceerd werk met verdelingen. Deze tutorial leidt je door de wiskundige fundamenten van de Weibull-verdeling. Je leert hoe je de parameters uit data schat en ziet hoe de flexibiliteit de verdeling bijzonder nuttig maakt in betrouwbaarheidsonderzoek en survivalstudies. Aan het eind begrijp je niet alleen de theorie achter deze handige verdeling, maar ook wanneer en hoe je haar toepast op je eigen tijd-tot-gebeurtenisvraagstukken.
Wat is de Weibull-verdeling?
De Weibull-verdeling is een continue kansverdeling die is ontworpen voor het modelleren van tijd-tot-gebeurtenisdata. Je komt haar het vaakst tegen in faalanalyse, survivalstudies en betrouwbaarheidstechniek, waar het doel is te begrijpen "wanneer iets gebeurt".
Wat de Weibull onderscheidt van simpelere alternatieven is haar aanpasbaarheid aan verschillende faalpatronen. Terwijl sommige verdelingen aannemen dat gebeurtenissen tegen een stabiel, voorspelbaar tempo plaatsvinden, kan Weibull omgaan met situaties waarin de kans op gebeurtenissen in de tijd verandert. Die flexibiliteit is nuttig als je met complexe systemen of processen werkt waarvan de onderliggende mechanismen niet volledig begrepen zijn.
Historische context en basisprincipes
Het verhaal achter deze verdeling begint bij de Zweedse wiskundige Waloddi Weibull, die haar in de jaren 1930 ontwikkelde bij onderzoek naar materiaalkracht en vermoeiing. Zijn werk legde de basis voor de moderne betrouwbaarheidstechniek.
De verdeling kent twee primaire vormen die verschillende analytische behoeften dienen. De twee-parameter-Weibull gebruikt vorm- en schaalparameters om scenario’s te modelleren waarin gebeurtenissen meteen kunnen starten. De drie-parameter-versie voegt een locatieparameter toe, waarmee een minimale drempel ontstaat voordat gebeurtenissen kunnen optreden—handig voor het modelleren van systemen met ingebouwde vertragingen of "inloop"-periodes.
De Weibull behoort tot een familie van verwante verdelingen, waarbij de exponentiële verdeling als speciaal geval verschijnt. Deze connectie verklaart waarom je in betrouwbaarheidscontexten vaak Weibull- en exponentiële modellen met elkaar vergeleken ziet. Door haar bredere flexibiliteit kan Weibull onder specifieke parametercondities andere bekende verdelingen benaderen, wat bijdraagt aan de brede adoptie.
Parameters van de Weibull-verdeling
Nu we de historische ontwikkeling en het basisgedrag hebben behandeld, kijken we naar de parameters die de Weibull-verdeling haar flexibiliteit geven. Elke parameter vertelt je iets specifieks over het gedrag van je data.
De vormparameter (k of β) bepaalt het karakter van de verdeling en hoe de hazardfunctie zich gedraagt. Bij waarden kleiner dan 1 zie je infant mortality-patronen waarbij vroege falingen optreden door fabricagefouten. Bij waarden groter dan 1 zie je slijtagefalingen waarbij zaken in de tijd door gebruik stukgaan.
Effect van de vormparameter (k) op het gedrag van de Weibull-verdeling. Let op hoe k < 1 een hoge vroege faalkans geeft (blauwe curve), k = 1 constante faalpercentages oplevert (oranje) en k > 1 stijgende faalpercentages in de tijd laat zien (groene en rode curves). Afbeelding door de auteur.
De schaalparameter (λ of η) vertegenwoordigt de karakteristieke levensduur. Dit is het tijdstip waarop precies 63,2% van de items gefaald zal hebben, ongeacht de waarde van de vormparameter. Je kunt dit zien als de typische levensduur van de verdeling, al kan het werkelijke gemiddelde afwijken door de vorm van de verdeling.
Hoe de schaalparameter (λ) de Weibull-verdeling langs de tijd-as verschuift. Grotere λ-waarden rekken de verdeling naar rechts (langere karakteristieke levensduur), terwijl kleinere waarden haar naar links comprimeren (kortere karakteristieke levensduur). De vorm blijft consistent. Afbeelding door de auteur.
In drie-parameter-toepassingen verschuift de locatieparameter (θ of γ) de verdeling langs de tijd-as. Die vertegenwoordigt een gegarandeerde minimale levensduur voordat falingen kunnen beginnen, wat helpt bij het modelleren van systemen met inloopperiodes of componenten met garantieperiodes waarin vroege falingen onmogelijk zijn.
Verschillende vakgebieden gebruiken verschillende notaties, dus je kunt (k,λ) zien in betrouwbaarheidstechniek of (β,η) in survivalanalyse. De wiskundige relaties blijven hetzelfde, ongeacht welke notatie je tegenkomt.
Wiskundige karakterisering en statistische eigenschappen
De wiskundige basis van de Weibull-verdeling biedt de tools die nodig zijn voor praktische toepassingen. Laten we de kernfuncties verkennen die deze verdeling nuttig maken.
Kernfuncties en -maten
De waarschijnlijkheidsdichtheidsfunctie (PDF) beschrijft de kans dat falen op een specifiek tijdstip optreedt. Voor de Weibull-verdeling is dit:
Deze functie laat zien hoe de faal-dichtheid in de tijd verandert, waarbij de vormparameter k bepaalt of falen eerder waarschijnlijker is (k < 1), constant in de tijd (k = 1) of toeneemt met de leeftijd (k > 1).
De cumulatieve verdelingsfunctie (CDF) geeft de kans dat falen tegen een specifiek tijdstip optreedt:
Deze functie werkt goed om het percentage items te berekenen dat binnen een bepaalde tijdsperiode naar verwachting faalt. De betrouwbaarheidsfunctie (1-CDF) biedt het complementaire perspectief en toont de kans op overleving voorbij tijd t.
De hazardfunctie onthult het instantane faaltempo op elk gegeven tijdstip:
Deze functie is essentieel om te begrijpen hoe risico in de tijd verandert. Bij k < 1 daalt de hazard (betrouwbaarheid verbetert), bij k = 1 blijft hij constant, en bij k > 1 stijgt hij (betrouwbaarheid verslechtert). De overlevingsfunctie, identiek aan de betrouwbaarheidsfunctie, vertegenwoordigt de kans om voorbij een gegeven tijdstip te overleven.
Statistische momenten karakteriseren de centrale tendensen en variabiliteit van de verdeling. Het gemiddelde omvat de gammafunctie en hangt van beide parameters af, waardoor het complexer is dan de karakteristieke levensduur. De variantie kwantificeert de spreiding rond het gemiddelde, terwijl de mediaan vaak intuïtiever is dan het gemiddelde bij scheve verdelingen. De modus vertegenwoordigt het meest waarschijnlijke faalmoment, al bestaat die niet voor alle parametercombinaties.
De momentgenererende functie vangt alle statistische momenten in één uitdrukking, terwijl entropie de onzekerheid of informatie-inhoud van de verdeling meet. Deze eigenschappen, samen met patronen in faaltempo, maken de Weibull-verdeling geschikt voor het modelleren van diverse fenomenen uit de praktijk, waar simpele exponentiële aannames tekortschieten.
Conditionele betrouwbaarheid en percentielen
Berekeningen van conditionele betrouwbaarheid beantwoorden praktische vragen zoals: "Als dit onderdeel al 1000 uur heeft overleefd, wat is de kans dat het nog 500 uur meegaat?" Dit houdt in dat je de kans op overleving voor een extra periode berekent, gegeven overleving tot het huidige punt. De berekening gebruikt de volgende relatie:
waarbij R(t) de betrouwbaarheidsfunctie is.
Percentielen helpen belangrijke levensduurmaten te schatten die bedrijfsbeslissingen sturen. De B₁₀-levensduur is het tijdstip waarop 10% van de items gefaald heeft, terwijl B₉₀ aangeeft wanneer 90% heeft gefaald. Deze percentielen zijn essentieel voor garantieanalyse, onderhoudsplanning en risicobeoordeling.
De percentpuntfunctie (inverse CDF) biedt directe schatting van kwantielen door F(t) = p op te lossen voor elke gewenste kans p. Deze functie zet cumulatieve kansen terug om in tijdwaarden, zodat je specifieke faalmomenten kunt bepalen voor gegeven betrouwbaarheidsniveaus. De meeste statistische softwarepakketten bevatten ingebouwde functies voor deze berekeningen, waardoor percentielschatting eenvoudig wordt zodra je de Weibull-parameters hebt geschat.
Parameter-schatmethoden
De wiskundige eigenschappen begrijpen is één ding, maar hoe bepaal je deze parameters daadwerkelijk uit je data? Het schatten van Weibull-parameters vereist dat je de juiste methode kiest voor jouw situatie en datakenmerken. Elke aanpak heeft specifieke voor- en nadelen.
Maximum likelihood-schatting (MLE)
MLE biedt de meest statistisch robuuste aanpak voor parameterschatting. Ze vindt de parameterversies die de waarschijnlijkheid van je geobserveerde data maximaliseren, waardoor ze effectief is bij volledige datasets. Zie het als het vinden van de parameters die je geobserveerde data het "waarschijnlijkst" maken.
De methode gaat om met gecensureerde data (waarbij je weet dat items tot een bepaald punt hebben overleefd, maar niet hun exacte faalmoment) via gespecialiseerde algoritmen. Dit is nuttig in betrouwbaarheidstesten, waar je niet altijd kunt wachten tot elk item faalt. De meeste statistische softwarepakketten bevatten MLE-routines die specifiek voor Weibull-analyse zijn ontworpen. Hoewel de rekencomplexiteit toeneemt met de omvang van de dataset, verwerken moderne implementaties datasets met honderdduizenden observaties efficiënt.
Methode van momenten (MOM)
De MOM-aanpak schat parameters door theoretische momenten te laten aansluiten op steekproefmomenten uit je data. Hoewel minder statistisch efficiënt dan MLE, biedt ze computationele eenvoud en vaak goede startschattingen voor complexere methoden.
Deze aanpak werkt goed als je snelle schattingen nodig hebt of als je werkt met data die niet perfect aan MLE-aannames voldoet. Ze is ook handig om een ruwe indruk van je parameters te krijgen voordat je in geavanceerdere analyses duikt.
Kleinste kwadraten en grafische technieken
Weibull-probability plots transformeren data naar logaritmische coördinaten waar Weibull-verdelingen als rechte lijnen verschijnen, waardoor je de model-fit visueel kunt valideren terwijl je parameters schat via lineaire regressie. De methode gebruikt speciaal geschaald grafiekpapier (nu digitaal in software) met een dubbel-logaritmische transformatie die de cumulatieve Weibull-verdeling lineariseert.
Het proces omvat het rangschikken van je faaldata van klein naar groot, het berekenen van mediane rangposities voor elk datapunt (die de cumulatieve faalkans schatten) en het plotten van faaltijden tegen deze kansen. Als je data een Weibull-verdeling volgt, vormen de punten ongeveer een rechte lijn waarvan de helling gelijk is aan de vormparameter en waarvan de positie de schaalparameter bepaalt. Het is ouderwets, maar het werkt, en de visuele feedback is waardevol om je data te begrijpen. Wanneer punten sterk afwijken van lineariteit, suggereert dat dat het Weibull-model mogelijk niet geschikt is voor je dataset, waardoor deze techniek waardevol is voor zowel parameterschatting als modelvalidatie.
Uitdagingen bij drie parameters
Het schatten van de locatieparameter θ kent unieke moeilijkheden omdat die de ondergrens van de verdeling beïnvloedt. Standaard MLE kan onbetrouwbare schattingen opleveren wanneer θ de minimaal geobserveerde faaltijd nadert.
Profile likelihood-methoden pakken deze schatproblemen aan door θ als een hinderparameter te behandelen, wat stabielere schattingen voor de vorm- en schaalparameters oplevert. Het is wat complexer, maar vaak nodig voor betrouwbare resultaten.
Toepassingen over disciplines heen
De veelzijdigheid van de Weibull-verdeling blijkt uit de toepassingen in uiteenlopende vakgebieden. Elk domein benut specifieke aspecten van de flexibiliteit van de verdeling.
Betrouwbaarheidstechniek
Betrouwbaarheidsingenieurs gebruiken Weibull-analyse voor versnelde levensduurtesten, waarbij producten onder stressomstandigheden worden getest om levensduren bij normaal gebruik te voorspellen. In plaats van jaren te wachten om te zien hoelang iets meegaat, kun je het onder stress testen en extrapoleren naar normale omstandigheden.
Garantianalyses steunen op Weibull-modellen om toekomstige claims te schatten en passende dekkingsperiodes vast te stellen. Bedrijven moeten weten hoeveel producten binnen de garantieperiode falen om hun prijzen correct te bepalen.
Preventieve onderhoudsplanning profiteert van Weibulls vermogen om veranderende faalpercentages over de levenscyclus van apparatuur te modelleren. In tegenstelling tot exponentiële modellen, die uitgaan van constante faalpercentages, kan Weibull aangeven wanneer faalpercentages beginnen te stijgen, zodat je onderhoud kunt plannen vóórdat iets stukgaat.
Medische en biologische wetenschappen
Survivalanalyse in medisch onderzoek gebruikt vaak Weibull-modellen om de effectiviteit van behandelingen en de prognose van patiënten te bestuderen. De verdeling gaat van nature om met gecensureerde data, die veel voorkomt in klinische studies waar patiënten het onderzoek kunnen verlaten voordat de gebeurtenis van interesse optreedt.
Weibull-regressie breidt de basisanalyse uit door patiëntkenmerken (leeftijd, behandelingstype, ziekte-stadium) als covariabelen op te nemen. Dit levert gepersonaliseerde overlevingsschattingen op die essentieel zijn voor behandelplanning, zodat artsen patiënten realistische verwachtingen over hun prognose kunnen geven.
Materiaalkunde en bosbouw
Materiaalkundigen gebruiken Weibull-verdelingen om de sterkte van brosse materialen zoals keramiek en composieten te modelleren, waar de zwakste schakel het totale falen bepaalt. Het vermogen van de verdeling om extreme waarden te modelleren maakt haar ideaal voor toepassingen waarin je het worstcasescenario wilt begrijpen.
Bosbeheer past Weibull-modellen toe op boomdiameterverdelingen, wat helpt om oogstopbrengsten te voorspellen en duurzaam bosbeheer te plannen. Het is een praktische toepassing die economische en ecologische belangen in balans helpt brengen.
Windenergie en milieustudies
Hoewel dit artikel focust op tijd-tot-gebeurtenis-toepassingen, modelleren Weibull-verdelingen ook andere fenomenen in milieutechniek. Windbronbeoordeling gebruikt Weibull om windsnelheidspatronen op potentiële turbinelocaties te karakteriseren, waarbij vormparameters de windconsistentie voor energieproductieplanning aangeven.
Geavanceerde onderwerpen en uitbreidingen
Hoe nuttig deze standaardtoepassingen ook zijn, moderne problemen vereisen vaak dat je verder gaat dan basis-Weibull-analyses.
Modelselectie en goodness-of-fit
Kiezen tussen Weibull en alternatieve verdelingen vereist systematisch testen met goodness-of-fit-statistieken zoals de Kolmogorov-Smirnov- en Anderson-Darling-toetsen. Deze toetsen kwantificeren hoe goed je gekozen verdeling aansluit bij geobserveerde patronen, zodat je vertrouwen krijgt in je modelkeuze.
Grafische diagnostiek vult statistische toetsen aan door patronen te onthullen die cijfers alleen kunnen missen. Residualanalyse helpt systematische afwijkingen van verwacht gedrag te identificeren, terwijl informatiecriteria (AIC/BIC) model-fit afwegen tegen complexiteit. Je wilt in feite een model dat goed past zonder onnodig ingewikkeld te zijn.
Regressie- en mengmodellen
Weibull-regressie verwerkt verklarende variabelen direct in de verdelingsparameters, zodat je kunt modelleren hoe factoren als temperatuur, belasting of patiëntkenmerken het faalgedrag beïnvloeden. Deze uitbreiding is nuttig in betrouwbaarheidstesten en medisch onderzoek waar meerdere factoren de uitkomst bepalen.
Meng-Weibull-modellen gaan om met populaties met duidelijke subgroepen (zoals verschillende faalmodi) door meerdere Weibull-verdelingen te combineren. Denk aan een populatie waarin sommige items falen door slijtage en andere door willekeurige defecten. Je hebt verschillende modellen nodig voor elke faalmodus.
Machinelearningtoepassingen gebruiken deze modellen in toenemende mate voor complexe patroonherkenning en neurale netwerken, waardoor traditionele statistische methoden met moderne AI-technieken worden verbonden.
Concurrerende risico’s en degradatiemodellen
Sommige systemen worden tegelijk geconfronteerd met meerdere faalmodi. Mechanische slijtage, elektrische storingen en omgevingsdegradatie kunnen allemaal dezelfde component bedreigen. Modellen voor concurrerende risico’s gebruiken meerdere Weibull-verdelingen om elke faalmodus te vertegenwoordigen, zodat je begrijpt welke risico’s het meest kritiek zijn.
Degradatiemodellen volgen hoe de systeemprestatie in de tijd afneemt, waarbij Weibull-verdelingen het tijdstip modelleren waarop prestaties onder aanvaardbare drempels zakken. Dit is nuttig voor systemen waarbij je degradatie kunt meten voordat volledig falen optreedt.
Verwante en speciale vormen
De inverse Weibull-verdeling modelleert situaties waarin grotere waarden minder waarschijnlijk zijn, zoals minimale sterkte in materialen of kortste overlevingstijden in de biologie. Deze variant is nuttig wanneer traditionele Weibull-aannames niet bij je datapatronen passen.
Discrete Weibull-verdelingen passen het continue model aan voor teldata, zoals het aantal cycli tot falen of discrete tijdsintervallen in survivalstudies. Het is minder gebruikelijk, maar handig wanneer je data in discrete stappen komt in plaats van als continue metingen.
Conclusie
De aanpasbaarheid van de Weibull-verdeling maakt haar waardevol voor het analyseren van wanneer dingen in de tijd gebeuren. Ze kan toenemende, afnemende of constante hazardpercentages aan en werkt goed met onvolledige data. Onze cursussen Survival Analysis in Python en Survival Analysis in R laten je oefenen met datasets en beproefde methoden.
Toekomstige onderzoekslijnen omvatten Bayesiaanse benaderingen die eerderkennis effectiever integreren, hybride modellen met machine learning die Weibull modellering combineren met neurale netwerken, en bigdata-toepassingen die traditionele methoden schalen naar enorme datasets.