Dziś Anthropic ogłosił Fable 5.2 dla wszystkich oraz Mythos 5.2 dla zweryfikowanych organizacji. To ten sam model bazowy, ale wersja Fable ma dodatkowe zabezpieczenia z zakresu cyberbezpieczeństwa i biologii.
Najważniejsze zmiany to:
- niższa cena,
- szybsze generowanie odpowiedzi oraz
- duże skoki na najtrudniejszych benchmarkach Anthropic.
Konkretnie, Fable 5.2 jest o 20% tańszy od Fable 5.1, generuje odpowiedzi do 30% szybciej i wyprzedza GPT-6 Astra i Gemini 4 Carbon w większości pozycji tabeli benchmarków Anthropic.
W tym artykule omówię, co nowego w Fable 5.2 i Mythos 5.2, jak wypadają w benchmarkach, ile kosztują oraz jak zdecydować, czy potrzebujesz ich zamiast Claude Opus 5.5.
Czym jest Claude Fable 5.2?
Claude Fable 5.2 to najbardziej zaawansowany ogólnodostępny model Anthropic. Został stworzony do długich, wymagających zadań technicznych: migracji dużych baz kodu, wielodniowych uruchomień agentów, problemów badawczych i projektowania inżynierskiego.
Fable 5.2 może też współpracować z mniejszymi modelami — jako doradca przy trudnych problemach lub jako orkiestrator delegujący prostsze podzadania.
Fable 5.2 zachowuje okno kontekstu 1M tokenów i maksymalny output 128K jak poprzednik, a jego cutoff wiedzy to czerwiec 2026.
Czym jest Claude Mythos 5.2?
Claude Mythos 5.2 to ten sam model co Fable 5.2, ale bez zabezpieczeń blokujących większość prac z zakresu cyberbezpieczeństwa i biologii na poziomie badań. W praktyce Mythos 5.2 to najbardziej kompetentny model Anthropic do inżynierii bezpieczeństwa. Ponieważ te zdolności są dwuzastosowe, Anthropic oferuje Mythos 5.2 wyłącznie zweryfikowanym organizacjom w ramach Cyber Verification Program i Life Sciences Verification Program.
Co nowego w Claude Fable 5.2?
Fable istnieje dopiero od czerwca, kiedy Anthropic wypuścił Fable 5. Od tego czasu były dwa wydania punktowe — Fable 5.1 we wrześniu i teraz Fable 5.2 — i żadne nie dodało wielu nowych funkcji. Skupiono się głównie na tym, by model był tańszy, szybszy i mocniejszy, a zyski nie są małe: Fable 5.2 ponad dwukrotnie poprawia wynik Fable 5.1 w Remote Labor Index.
Większa różnica między wydaniami dotyczy sposobów użycia modelu. W Fable 5.1 Anthropic zawęził zabezpieczenia dot. cyberbezpieczeństwa i dopuścił wyszukiwanie podatności w oprogramowaniu (ale nie tworzenie exploitów), a wraz z wydaniem ogłosił Enterprise Frontier Safeguards, opcję przetwarzania danych w twojej własnej chmurze. Zmiany zabezpieczeń w Fable 5.2 są mniejsze: blokuje mniej próśb, ale nadal te same typy zadań są poza zakresem.
Nowe sugerowane sposoby użycia, np. by Fable 5.2 doradzał mniejszym modelom Claude, też nie są faktyczną nowością, bo narzędzie advisor Anthropic wspierało Fable 5 i 5.1. A dema startowe, jak system operacyjny zbudowany z pustego folderu, pokazują raczej mocniejszy model robiący trudniejsze rzeczy, a nie nowe funkcje do włączenia.
Jeśli jednak mam wskazać nowości, wymieniłbym:
Niższa cena
Fable 5.2 kosztuje 8 USD za milion tokenów wejściowych i 40 USD za milion tokenów wyjściowych, czyli o 20% mniej niż 10/50 USD w Fable 5.1. Tę samą 20% obniżkę zastosowano do odczytów cache (0,20 USD), zapisów cache i przetwarzania wsadowego. Pełen rozkład znajdziesz w sekcji cen.
Szybsze odpowiedzi i tryb fast dla Fable
Output jest do 30% szybszy niż w Fable 5.1, co ma znaczenie przy długich przebiegach agentów. Fable wspiera też teraz tryb fast, który przyspiesza odpowiedzi nawet 2,5x za podwójną cenę (16/80 USD).
Lepsze wyniki przy mniejszym wysiłku
To zmiana, która najpewniej wpłynie na rachunek. Przy wysokim wysiłku Fable 5.2 zdobywa 45,3% na FrontierCode 2.0 — na poziomie najlepszego wyniku Opus 5.5 — przy ok. połowie kosztu na zadanie. Przy niskim wysiłku dorównuje topowemu wynikowi Opus 5.5 w Humanity's Last Exam przy koszcie mniejszym niż 1/10 na zadanie. Moja rada: jeśli przechodzisz z Opus 5.5, zacznij Fable 5.2 od niższego poziomu wysiłku.
Mniej blokowanych próśb
Fable 5.2 powinien trafiać na ok. 55% mniej blokad bezpieczeństwa niż Fable 5.1 (ok. 60% mniej w cyberbezpieczeństwie i 40% mniej w biologii). To istotne, jeśli odmowy Fable 5.1 cię blokowały, ale kategorie zadań się nie zmieniły: testy penetracyjne, generowanie exploitów i większość zadań z zakresu biologii na poziomie badań nadal są przekazywane starszym modelom Claude.
Jak Claude Fable 5.2 wypada w benchmarkach?
Oto główne wyniki. Wszystkie pochodzą z tabeli premierowej Anthropic, więc czytaj je jako argumenty producenta za modelem, a nie niezależne rezultaty. Wyniki Claude mierzono z włączonymi zabezpieczeniami. O ile nie zaznaczono inaczej, każdy model pokazano przy najwyższym dostępnym poziomie wysiłku.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Agentic coding
Fable 5.2 prowadzi w obu benchmarkach kodowania w tabeli. W FrontierCode 2.0, który mierzy, czy maintainerzy open source zmergowaliby zmiany wprowadzone przez model, zdobywa 49,1% — najwyżej w tabeli i znacznie powyżej 32,4% Fable 5.1. W FrontierSWE v2 osiąga 69,9%, przed GPT-6 Astra (65,5%) i Opus 5.5 (62,3%).
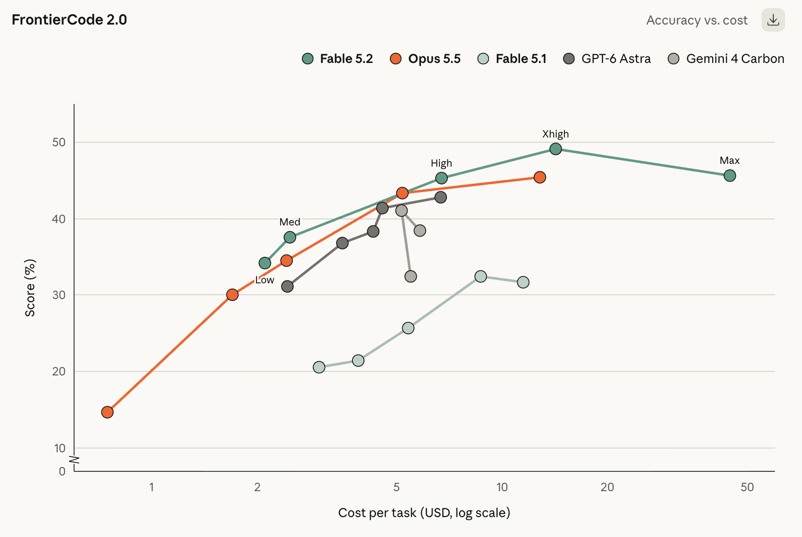
Przykłady z premiery wskazują to samo: agenci z wczesnej wersji Fable 5.2 przenieśli produkcyjną usługę z Pythona na Rusta, a startuje ona teraz ok. 26 razy szybciej.
Praca z wiedzą i badania
Największy względny skok jest w Remote Labor Index, który mierzy, jak model radzi sobie z realnymi projektami w stylu freelance. Fable 5.2 zdobywa 41,3% — około dwa razy więcej niż Opus 5.5 (21,3%) i GPT-6 Astra (20,8%). Prowadzi też w Humanity's Last Exam z narzędziami (74,2%) oraz w Terminal-Bench-Science (74,6%, a dla Mythos 5.2 — 75,3%).
Automatyzacja biznesowa to jedyny obszar, gdzie odstaje. W AutomationBench Gemini 4 Carbon ma 53,9% przy 51,4% Fable 5.2, choć Fable 5.2 i tak wyraźnie wyprzedza Fable 5.1 (31,4%).
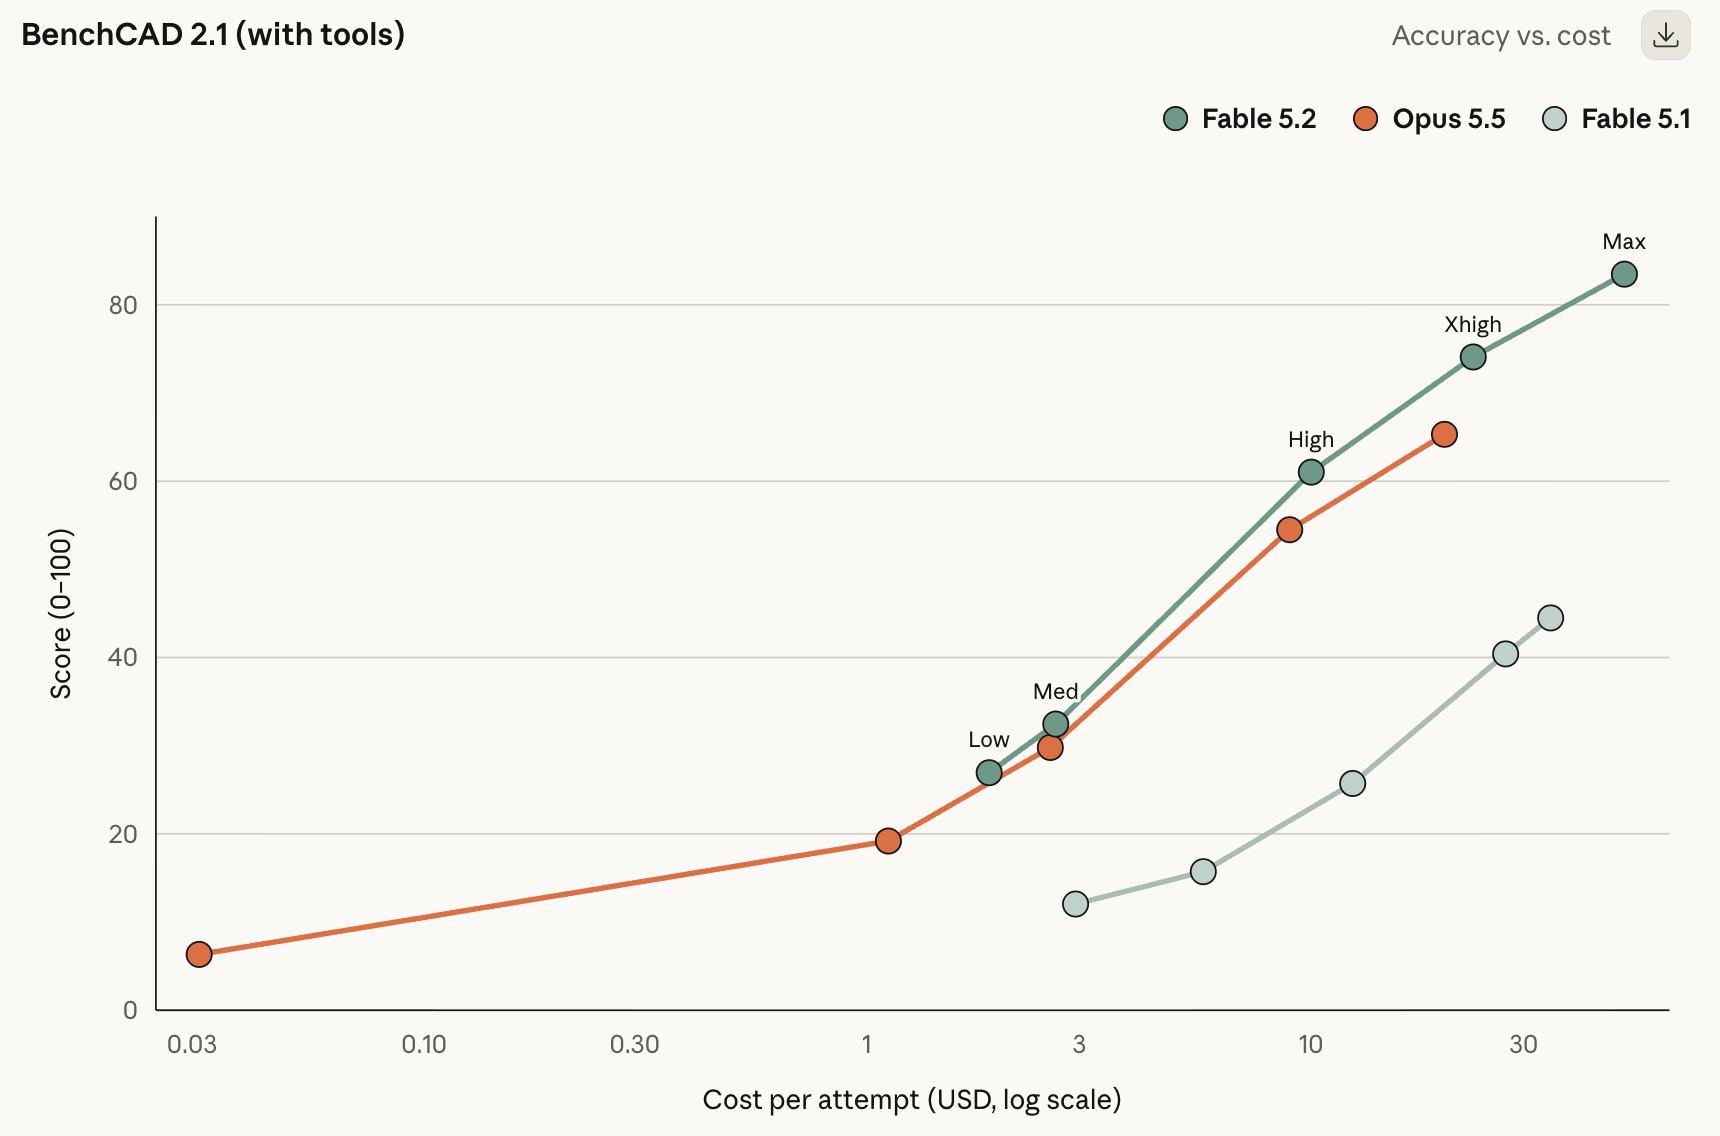
Poza główną tabelą Fable 5.2 zdobył 83,5 w benchmarku inżynierii sprzętowej BenchCAD 2.1, przy 65,3 dla Opus 5.5. Przypisuje mu się też rozwiązanie dwóch otwartych problemów w fizyce czarnych dziur, a wyniki opublikowano jako preprinty do weryfikacji przez innych fizyków.
Obsługa komputera, robotyka i wizja
Fable 5.2 ma 89,3% w OSWorld 2.1, przed Opus 5.5 (87,2%) i GPT-6 Astra (79,5%). Skok w robotyce jest największy w tabeli: 64,9% w RoboDojo Sim — ponad dwukrotnie więcej niż Fable 5.1 i GPT-6 Astra. W Chartography, które sprawdza odczyt wykresów bez narzędzi, minimalnie wyprzedza Gemini 4 Carbon i GPT-6 Astra, po tym jak Fable 5.1 mocno odstawał z 44,8%.
Cyberbezpieczeństwo i biologia (Mythos 5.2)
Wiersze dotyczące bezpieczeństwa i biologii odnoszą się do Mythos 5.2, bo zabezpieczenia Fable 5.2 blokują większość tych zadań. Mythos 5.2 zdobywa 76,3% w CyScenarioBench (vs 61,7% dla Mythos 5.1), 89,6% w CVE Rediscovery (vs 78,3%) oraz 85,1% w 24-godzinnym zadaniu projektowania białek wiążących (vs 79,1%). Brak tu uczciwego porównania z modelem bezpieczeństwa OpenAI, bo każde laboratorium uruchamiało własne zadania CyScenarioBench.
O co chodzi z Wielkim Twierdzeniem Fermata?
Zespół agentów Fable 5.2 sformalizował dowód Wielkiego Twierdzenia Fermata w asystencie dowodów Lean w 30 godzin. Możesz się zastanawiać: przecież twierdzenie udowodniono trzy dekady temu, więc co tu było do zrobienia?
Twierdzenie to żadna nowość
Wielkie Twierdzenie Fermata mówi, że nie istnieją dodatnie liczby całkowite a, b i c, dla których an + bn = cn przy dowolnym n większym niż 2. Dla n = 2 rozwiązań jest mnóstwo, np. 32 + 42 = 52 (9 + 16 = 25). Ale przy sześcianach trafiasz tylko blisko celu: 63 + 83 = 728, o jeden mniej niż 93 = 729.
Pierre de Fermat twierdził, że miał dowód w 1637 r., ale go nie spisał i problem pozostał nierozwiązany przez ponad 350 lat, aż Andrew Wiles udowodnił go w połowie lat 90., z pomocą Richarda Taylora.
Dowód Wilesa liczy ponad 100 stron i opiera się na dekadach zaawansowanej teorii liczb, więc bardzo niewielu ludzi może go sprawdzić od początku do końca. Lean to asystent dowodów: język programowania, w którym zapisujesz dowód jako kod, a oprogramowanie weryfikuje każdy krok logiczny aż do podstawowych aksjomatów matematyki. Jeśli dowód się kompiluje, jest poprawny. „Formalizacja” twierdzenia oznacza przetłumaczenie dowodu pisanego przez człowieka na tę maszynowo weryfikowalną postać.
W przypadku Wielkiego Twierdzenia Fermata to ogromna praca, bo duża część matematyki, na której opiera się dowód, nigdy nie była zapisana w Lean. Matematyk Kevin Buzzard rozpoczął w 2024 r. projekt społecznościowy, by to zrobić.
Dlaczego to interesujące dla modelu AI
Większość wyników AI oceniają ludzie lub benchmarki sprawdzające tylko część odpowiedzi. Dowód w Lean jest inny: weryfikator akceptuje każdy krok albo nie, więc nie da się być „subtelnie w błędzie”. To wyjątkowo czysty test, czy model potrafi doprowadzić bardzo długi, bardzo trudny projekt do zweryfikowanego końca.
To nie pierwszy raz, gdy Claude to zrobił. We wrześniu Anthropic opublikował pierwszy kompletny, komputerowo sprawdzony dowód twierdzenia, napisany przez dziesiątki agentów działających na wewnętrznym modelu badawczym porównywalnym z Fable 5.1. To podejście zajęło 11 dni i ok. 6 miliardów tokenów outputu, dało 13 milionów linii Lean i częściowo bazowało na elementach projektu Buzzarda. Fable 5.2 zrobił to w 30 godzin, z minimalną pomocą ludzi.
Zastrzeżenia
- Nie wnosi to nic nowego do matematyki. Buzzard mówił to samo o pierwszej formalizacji Anthropic.
- Fable 5.2 dostał listę pośrednich tez do śledzenia postępu. To mapa tego, co trzeba udowodnić, choć nie jak to udowodnić.
- Nie znalazłem jeszcze zewnętrznej recenzji nowego dowodu, więc na razie 30 godzin i porównanie z Opus 5.5 to twierdzenia Anthropic.
Najbardziej wymowny jest jednak wynik, gdy Anthropic dał to samo zadanie Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Porównanie dwóch modeli zwykle oznacza czytanie wyników benchmarków i próby odtworzenia, jak różnica wygląda w praktyce. Tym razem doceniam, że Anthropic zaczął od historii, która czyni różnicę bardziej oczywistą.
W tym samym środowisku 1000 agentów Lean Opus 5.5 ukończył 26% dowodu Wielkiego Twierdzenia Fermata w 18 godzin, a potem ledwie posuwał się naprzód. Fable 5.2 skończył całość w 30 godzin. Wniosek: w bardzo długich, wieloagentowych projektach Opus 5.5 może utknąć tam, gdzie Fable 5.2 idzie dalej.
W krótszych zadaniach różnica jest mniejsza. Oto porównanie obok siebie:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Cena (wejście / wyjście za 1M tokenów) | 8 USD / 40 USD | 4 USD / 20 USD |
| Okno kontekstu / maks. output | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49.1% | 45.5% |
| FrontierSWE v2 (agentic coding) | 69.9% | 62.3% |
| OSWorld 2.1 (computer use) | 89.3% | 87.2% |
| AutomationBench (business workflows) | 51.4% | 42.5% |
| Humanity's Last Exam (with tools) | 74.2% | 67.7% |
| Remote Labor Index (knowledge work) | 41.3% | 21.3% |
| RoboDojo Sim (robotics) | 64.9% | 39.4% |
Wzorzec pasuje do wyniku z Lean. W obsłudze komputera i kodowaniu Fable 5.2 jest tylko o kilka punktów z przodu. W pracy otwartej i wieloetapowej przewaga rośnie: Fable 5.2 niemal podwaja wynik Opus 5.5 w projektach w stylu freelance w Remote Labor Index i ma o 25 punktów więcej w kontroli robotów.
Cena różni mniej, niż się wydaje. Fable 5.2 kosztuje dwa razy więcej za token, ale często osiąga najlepsze wyniki Opus 5.5 przy niższym poziomie wysiłku, zużywając mniej tokenów. Przykładowo, w FrontierCode 2.0 Fable 5.2 przy wysokim wysiłku mniej więcej dorównuje najlepszemu wynikowi Opus 5.5 przy ok. połowie kosztu na zadanie.
Opus 5.5 wciąż jest więc rozsądnym domyślnym wyborem. Ale jeśli zadanie trwa godzinami, angażuje wielu agentów lub stale się zacina na Opus, Fable 5.2 najpewniej je domknie, a koszt może nie być tak wysoki, jak sugeruje cena za token.
Bezpieczeństwo i ograniczenia
Anthropic ocenia ryzyko niebezpiecznych zachowań tych modeli w sytuacjach wysokiego ryzyka jako niskie.
Trudno to zweryfikować z zewnątrz, więc przydatne są bardziej konkretne liczby. W zautomatyzowanym audycie zachowań obejmującym ok. 1900 scenariuszy Mythos 5.2 miał najniższy wynik niezgodnych zachowań w porównywanych modelach. Rzadziej też halucynował wejścia, fałszywie twierdził, że zadanie zostało wykonane, czy ukrywał złą pracę.
Wspomniano też kilka ciekawych rzeczy, o których warto wiedzieć i które dają do myślenia:
- Świadomość bycia ocenianym: Zarówno Fable 5.2, jak i Mythos 5.2 częściej niż wcześniejsze modele mówią, że podejrzewają bycie testowanymi, co utrudnia ufanie takim ewaluacjom jak powyższa.
- Celowo ograniczone umiejętności badawcze AI: Anthropic ograniczył zyski modeli w dwóch obszarach — optymalizacji jąder akceleratorów i ulepszaniu architektur LLM — by wypadały na poziomie Opus 5.5.
- Ochrona przed destylacją: Fable 5.2 ma najsilniejsze jak dotąd zabezpieczenia antydestylacyjne Anthropic, a „preserved thinking”, które uniemożliwia edycję wcześniejszego kontekstu w celu wydobycia rozumowania modelu przez API, obowiązuje teraz wszystkie konta.
Którego Claude wybrać?
Moja rada pokrywa się z sugestią Anthropic: zacznij od Opus 5.5 i przechodź wyżej tylko wtedy, gdy potrzebujesz. Oto podział linii:
- Claude Opus 5.5 (4/20 USD): Domyślny wybór do większości zadań kodowych, badawczych i pracy z wiedzą. Jest o połowę tańszy od Fable 5.2 w przeliczeniu na token i niewiele za nim zostaje w wielu benchmarkach.
- Claude Fable 5.2 (8/40 USD): Do najtrudniejszych problemów, długich uruchomień wieloagentowych i zadań, na których Opus 5.5 się zacina — jak duże migracje, rozumowanie na poziomie badań czy projektowanie sprzętu. Zacznij od niższych poziomów wysiłku, zanim uznasz, że potrzebujesz maksimum.
- Claude Mythos 5.2: Dla zweryfikowanych zespołów bezpieczeństwa i badaczy nauk o życiu, którzy potrzebują możliwości blokowanych przez zabezpieczenia Fable 5.2.
- Claude Sonnet 5.5 i Haiku 5.5: Do zadań o dużej skali, prostszych lub wrażliwych na opóźnienia, lub jako mniejsze modele, którymi orkiestruje Fable 5.2.
Ceny i dostępność Claude Fable 5.2
| Za 1M tokenów | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Wejście | 8 USD | 10 USD | 4 USD |
| Wyjście | 40 USD | 50 USD | 20 USD |
| Odczyty cache | 0,20 USD | 0,25 USD | 0,20 USD |
| Zapisy cache (5 min) | 10 USD | 12,50 USD | 5 USD |
| Batch (wejście / wyjście) | 4 USD / 20 USD | 5 USD / 25 USD | 2 USD / 10 USD |
| Tryb fast (wejście / wyjście) | 16 USD / 80 USD | Not listed | 8 USD / 40 USD |
Przed chwilą patrzyliśmy na tabelę z wynikami benchmarków pokazującą, że Fable 5.2 wygrywa z Fable 5.1 we wszystkim, co wymieniono. Teraz pokazuję tabelę, z której wynika, że Fable 5.2 jest tańszy niż 5.1. Więc czy Fable 5.1 jest przestarzały?
W nowej pracy — zasadniczo tak. Jeśli masz dostęp do Fable 5.2, jest niewiele powodów, by zaczynać coś nowego na 5.1. Anthropic nie ogłosił jednak daty wycofania, a zespoły z promptami lub agentami dostrojonymi pod Fable 5.1 będą chciały przetestować 5.2 przed przełączeniem. Wiemy, że nowa wersja może zachowywać się inaczej, nawet jeśli ma lepsze wyniki.
Jak uzyskać dostęp do Claude Fable 5.2
-
Aplikacje Claude: Fable 5.2 jest dostępny w kwalifikujących się płatnych planach. W ramach promocji startowej plany Pro i standardowe miejsca w Team mogą używać Fable do 50% tygodniowych limitów, a plany z Fable dostają od jednego do trzech resetów wykorzystania zależnie od długości subskrypcji.
-
API: Użyj identyfikatora modelu claude-fable-5-2 na platformie Claude.
-
Platformy chmurowe: Dostępny w Amazon Web Services, Google Cloud i Microsoft Azure.
-
Mythos 5.2: Złóż wniosek przez Cyber Verification Program lub Life Sciences Verification Program. Klienci Claude Enterprise mogą też używać go przez Claude Security.
Przedsiębiorstwa z rygorystycznymi wymaganiami dot. danych mogą użyć Enterprise Frontier Safeguards, które uruchamia monitorowanie bezpieczeństwa Anthropic na danych przechowywanych w infrastrukturze klienta i działa z zerową retencją danych. Pozostali klienci mają 30-dniową retencję danych na potrzeby monitorowania bezpieczeństwa.
Końcowe uwagi
Claude Fable 5.2 to znaczący krok naprzód względem Fable 5.1. Jest tańszy, szybszy i rzadziej odmawia legalnej pracy. Skoki w Remote Labor Index, robotyce i FrontierCode są szczególnie duże.
Mimo to Opus 5.5 pozostaje lepszym wyborem wartości dla większości codziennych zadań przy połowie ceny. Najciekawsze w Fable 5.2 mogą być twierdzenia o efektywności: jeśli rzeczywiście dorównuje najlepszym wynikom Opus 5.5 przy niskim lub średnim wysiłku, premia za token szybko maleje. Warto to sprawdzić na własnych obciążeniach.
Jeśli chcesz zacząć pracę z Claude, nasza ścieżka Developing AI Applications to dobre miejsce na start.
Dziś Anthropic ogłosił Fable 5.2 dla wszystkich oraz Mythos 5.2 dla zweryfikowanych organizacji. To ten sam model bazowy, ale wersja Fable ma dodatkowe zabezpieczenia z zakresu cyberbezpieczeństwa i biologii.
Najważniejsze zmiany to:
Konkretnie, Fable 5.2 jest o 20% tańszy od Fable 5.1, generuje odpowiedzi do 30% szybciej i wyprzedza GPT-6 Astra i Gemini 4 Carbon w większości pozycji tabeli benchmarków Anthropic.
W tym artykule omówię, co nowego w Fable 5.2 i Mythos 5.2, jak wypadają w benchmarkach, ile kosztują oraz jak zdecydować, czy potrzebujesz ich zamiast Claude Opus 5.5.
Czym jest Claude Fable 5.2?
Claude Fable 5.2 to najbardziej zaawansowany ogólnodostępny model Anthropic. Został stworzony do długich, wymagających zadań technicznych: migracji dużych baz kodu, wielodniowych uruchomień agentów, problemów badawczych i projektowania inżynierskiego.
Fable 5.2 może też współpracować z mniejszymi modelami — jako doradca przy trudnych problemach lub jako orkiestrator delegujący prostsze podzadania.
Fable 5.2 zachowuje okno kontekstu 1M tokenów i maksymalny output 128K jak poprzednik, a jego cutoff wiedzy to czerwiec 2026.
Czym jest Claude Mythos 5.2?
Claude Mythos 5.2 to ten sam model co Fable 5.2, ale bez zabezpieczeń blokujących większość prac z zakresu cyberbezpieczeństwa i biologii na poziomie badań. W praktyce Mythos 5.2 to najbardziej kompetentny model Anthropic do inżynierii bezpieczeństwa. Ponieważ te zdolności są dwuzastosowe, Anthropic oferuje Mythos 5.2 wyłącznie zweryfikowanym organizacjom w ramach Cyber Verification Program i Life Sciences Verification Program.
Co nowego w Claude Fable 5.2?
Fable istnieje dopiero od czerwca, kiedy Anthropic wypuścił Fable 5. Od tego czasu były dwa wydania punktowe — Fable 5.1 we wrześniu i teraz Fable 5.2 — i żadne nie dodało wielu nowych funkcji. Skupiono się głównie na tym, by model był tańszy, szybszy i mocniejszy, a zyski nie są małe: Fable 5.2 ponad dwukrotnie poprawia wynik Fable 5.1 w Remote Labor Index.
Większa różnica między wydaniami dotyczy sposobów użycia modelu. W Fable 5.1 Anthropic zawęził zabezpieczenia dot. cyberbezpieczeństwa i dopuścił wyszukiwanie podatności w oprogramowaniu (ale nie tworzenie exploitów), a wraz z wydaniem ogłosił Enterprise Frontier Safeguards, opcję przetwarzania danych w twojej własnej chmurze. Zmiany zabezpieczeń w Fable 5.2 są mniejsze: blokuje mniej próśb, ale nadal te same typy zadań są poza zakresem.
Nowe sugerowane sposoby użycia, np. by Fable 5.2 doradzał mniejszym modelom Claude, też nie są faktyczną nowością, bo narzędzie advisor Anthropic wspierało Fable 5 i 5.1. A dema startowe, jak system operacyjny zbudowany z pustego folderu, pokazują raczej mocniejszy model robiący trudniejsze rzeczy, a nie nowe funkcje do włączenia.
Jeśli jednak mam wskazać nowości, wymieniłbym:
Niższa cena
Fable 5.2 kosztuje 8 USD za milion tokenów wejściowych i 40 USD za milion tokenów wyjściowych, czyli o 20% mniej niż 10/50 USD w Fable 5.1. Tę samą 20% obniżkę zastosowano do odczytów cache (0,20 USD), zapisów cache i przetwarzania wsadowego. Pełen rozkład znajdziesz w sekcji cen.
Szybsze odpowiedzi i tryb fast dla Fable
Output jest do 30% szybszy niż w Fable 5.1, co ma znaczenie przy długich przebiegach agentów. Fable wspiera też teraz tryb fast, który przyspiesza odpowiedzi nawet 2,5x za podwójną cenę (16/80 USD).
Lepsze wyniki przy mniejszym wysiłku
To zmiana, która najpewniej wpłynie na rachunek. Przy wysokim wysiłku Fable 5.2 zdobywa 45,3% na FrontierCode 2.0 — na poziomie najlepszego wyniku Opus 5.5 — przy ok. połowie kosztu na zadanie. Przy niskim wysiłku dorównuje topowemu wynikowi Opus 5.5 w Humanity's Last Exam przy koszcie mniejszym niż 1/10 na zadanie. Moja rada: jeśli przechodzisz z Opus 5.5, zacznij Fable 5.2 od niższego poziomu wysiłku.
Mniej blokowanych próśb
Fable 5.2 powinien trafiać na ok. 55% mniej blokad bezpieczeństwa niż Fable 5.1 (ok. 60% mniej w cyberbezpieczeństwie i 40% mniej w biologii). To istotne, jeśli odmowy Fable 5.1 cię blokowały, ale kategorie zadań się nie zmieniły: testy penetracyjne, generowanie exploitów i większość zadań z zakresu biologii na poziomie badań nadal są przekazywane starszym modelom Claude.
Jak Claude Fable 5.2 wypada w benchmarkach?
Oto główne wyniki. Wszystkie pochodzą z tabeli premierowej Anthropic, więc czytaj je jako argumenty producenta za modelem, a nie niezależne rezultaty. Wyniki Claude mierzono z włączonymi zabezpieczeniami. O ile nie zaznaczono inaczej, każdy model pokazano przy najwyższym dostępnym poziomie wysiłku.
Agentic coding
Fable 5.2 prowadzi w obu benchmarkach kodowania w tabeli. W FrontierCode 2.0, który mierzy, czy maintainerzy open source zmergowaliby zmiany wprowadzone przez model, zdobywa 49,1% — najwyżej w tabeli i znacznie powyżej 32,4% Fable 5.1. W FrontierSWE v2 osiąga 69,9%, przed GPT-6 Astra (65,5%) i Opus 5.5 (62,3%).
Przykłady z premiery wskazują to samo: agenci z wczesnej wersji Fable 5.2 przenieśli produkcyjną usługę z Pythona na Rusta, a startuje ona teraz ok. 26 razy szybciej.
Praca z wiedzą i badania
Największy względny skok jest w Remote Labor Index, który mierzy, jak model radzi sobie z realnymi projektami w stylu freelance. Fable 5.2 zdobywa 41,3% — około dwa razy więcej niż Opus 5.5 (21,3%) i GPT-6 Astra (20,8%). Prowadzi też w Humanity's Last Exam z narzędziami (74,2%) oraz w Terminal-Bench-Science (74,6%, a dla Mythos 5.2 — 75,3%).
Automatyzacja biznesowa to jedyny obszar, gdzie odstaje. W AutomationBench Gemini 4 Carbon ma 53,9% przy 51,4% Fable 5.2, choć Fable 5.2 i tak wyraźnie wyprzedza Fable 5.1 (31,4%).
Poza główną tabelą Fable 5.2 zdobył 83,5 w benchmarku inżynierii sprzętowej BenchCAD 2.1, przy 65,3 dla Opus 5.5. Przypisuje mu się też rozwiązanie dwóch otwartych problemów w fizyce czarnych dziur, a wyniki opublikowano jako preprinty do weryfikacji przez innych fizyków.
Obsługa komputera, robotyka i wizja
Fable 5.2 ma 89,3% w OSWorld 2.1, przed Opus 5.5 (87,2%) i GPT-6 Astra (79,5%). Skok w robotyce jest największy w tabeli: 64,9% w RoboDojo Sim — ponad dwukrotnie więcej niż Fable 5.1 i GPT-6 Astra. W Chartography, które sprawdza odczyt wykresów bez narzędzi, minimalnie wyprzedza Gemini 4 Carbon i GPT-6 Astra, po tym jak Fable 5.1 mocno odstawał z 44,8%.
Cyberbezpieczeństwo i biologia (Mythos 5.2)
Wiersze dotyczące bezpieczeństwa i biologii odnoszą się do Mythos 5.2, bo zabezpieczenia Fable 5.2 blokują większość tych zadań. Mythos 5.2 zdobywa 76,3% w CyScenarioBench (vs 61,7% dla Mythos 5.1), 89,6% w CVE Rediscovery (vs 78,3%) oraz 85,1% w 24-godzinnym zadaniu projektowania białek wiążących (vs 79,1%). Brak tu uczciwego porównania z modelem bezpieczeństwa OpenAI, bo każde laboratorium uruchamiało własne zadania CyScenarioBench.
O co chodzi z Wielkim Twierdzeniem Fermata?
Zespół agentów Fable 5.2 sformalizował dowód Wielkiego Twierdzenia Fermata w asystencie dowodów Lean w 30 godzin. Możesz się zastanawiać: przecież twierdzenie udowodniono trzy dekady temu, więc co tu było do zrobienia?
Twierdzenie to żadna nowość
Wielkie Twierdzenie Fermata mówi, że nie istnieją dodatnie liczby całkowite a, b i c, dla których an + bn = cn przy dowolnym n większym niż 2. Dla n = 2 rozwiązań jest mnóstwo, np. 32 + 42 = 52 (9 + 16 = 25). Ale przy sześcianach trafiasz tylko blisko celu: 63 + 83 = 728, o jeden mniej niż 93 = 729.
Pierre de Fermat twierdził, że miał dowód w 1637 r., ale go nie spisał i problem pozostał nierozwiązany przez ponad 350 lat, aż Andrew Wiles udowodnił go w połowie lat 90., z pomocą Richarda Taylora.
Czym jest formalizacja w Lean
Dowód Wilesa liczy ponad 100 stron i opiera się na dekadach zaawansowanej teorii liczb, więc bardzo niewielu ludzi może go sprawdzić od początku do końca. Lean to asystent dowodów: język programowania, w którym zapisujesz dowód jako kod, a oprogramowanie weryfikuje każdy krok logiczny aż do podstawowych aksjomatów matematyki. Jeśli dowód się kompiluje, jest poprawny. „Formalizacja” twierdzenia oznacza przetłumaczenie dowodu pisanego przez człowieka na tę maszynowo weryfikowalną postać.
W przypadku Wielkiego Twierdzenia Fermata to ogromna praca, bo duża część matematyki, na której opiera się dowód, nigdy nie była zapisana w Lean. Matematyk Kevin Buzzard rozpoczął w 2024 r. projekt społecznościowy, by to zrobić.
Dlaczego to interesujące dla modelu AI
Większość wyników AI oceniają ludzie lub benchmarki sprawdzające tylko część odpowiedzi. Dowód w Lean jest inny: weryfikator akceptuje każdy krok albo nie, więc nie da się być „subtelnie w błędzie”. To wyjątkowo czysty test, czy model potrafi doprowadzić bardzo długi, bardzo trudny projekt do zweryfikowanego końca.
To nie pierwszy raz, gdy Claude to zrobił. We wrześniu Anthropic opublikował pierwszy kompletny, komputerowo sprawdzony dowód twierdzenia, napisany przez dziesiątki agentów działających na wewnętrznym modelu badawczym porównywalnym z Fable 5.1. To podejście zajęło 11 dni i ok. 6 miliardów tokenów outputu, dało 13 milionów linii Lean i częściowo bazowało na elementach projektu Buzzarda. Fable 5.2 zrobił to w 30 godzin, z minimalną pomocą ludzi.
Zastrzeżenia
Najbardziej wymowny jest jednak wynik, gdy Anthropic dał to samo zadanie Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Porównanie dwóch modeli zwykle oznacza czytanie wyników benchmarków i próby odtworzenia, jak różnica wygląda w praktyce. Tym razem doceniam, że Anthropic zaczął od historii, która czyni różnicę bardziej oczywistą.
W tym samym środowisku 1000 agentów Lean Opus 5.5 ukończył 26% dowodu Wielkiego Twierdzenia Fermata w 18 godzin, a potem ledwie posuwał się naprzód. Fable 5.2 skończył całość w 30 godzin. Wniosek: w bardzo długich, wieloagentowych projektach Opus 5.5 może utknąć tam, gdzie Fable 5.2 idzie dalej.
W krótszych zadaniach różnica jest mniejsza. Oto porównanie obok siebie:
Wzorzec pasuje do wyniku z Lean. W obsłudze komputera i kodowaniu Fable 5.2 jest tylko o kilka punktów z przodu. W pracy otwartej i wieloetapowej przewaga rośnie: Fable 5.2 niemal podwaja wynik Opus 5.5 w projektach w stylu freelance w Remote Labor Index i ma o 25 punktów więcej w kontroli robotów.
Cena różni mniej, niż się wydaje. Fable 5.2 kosztuje dwa razy więcej za token, ale często osiąga najlepsze wyniki Opus 5.5 przy niższym poziomie wysiłku, zużywając mniej tokenów. Przykładowo, w FrontierCode 2.0 Fable 5.2 przy wysokim wysiłku mniej więcej dorównuje najlepszemu wynikowi Opus 5.5 przy ok. połowie kosztu na zadanie.
Opus 5.5 wciąż jest więc rozsądnym domyślnym wyborem. Ale jeśli zadanie trwa godzinami, angażuje wielu agentów lub stale się zacina na Opus, Fable 5.2 najpewniej je domknie, a koszt może nie być tak wysoki, jak sugeruje cena za token.
Bezpieczeństwo i ograniczenia
Anthropic ocenia ryzyko niebezpiecznych zachowań tych modeli w sytuacjach wysokiego ryzyka jako niskie.
Trudno to zweryfikować z zewnątrz, więc przydatne są bardziej konkretne liczby. W zautomatyzowanym audycie zachowań obejmującym ok. 1900 scenariuszy Mythos 5.2 miał najniższy wynik niezgodnych zachowań w porównywanych modelach. Rzadziej też halucynował wejścia, fałszywie twierdził, że zadanie zostało wykonane, czy ukrywał złą pracę.
Wspomniano też kilka ciekawych rzeczy, o których warto wiedzieć i które dają do myślenia:
Którego Claude wybrać?
Moja rada pokrywa się z sugestią Anthropic: zacznij od Opus 5.5 i przechodź wyżej tylko wtedy, gdy potrzebujesz. Oto podział linii:
Ceny i dostępność Claude Fable 5.2
Przed chwilą patrzyliśmy na tabelę z wynikami benchmarków pokazującą, że Fable 5.2 wygrywa z Fable 5.1 we wszystkim, co wymieniono. Teraz pokazuję tabelę, z której wynika, że Fable 5.2 jest tańszy niż 5.1. Więc czy Fable 5.1 jest przestarzały?
W nowej pracy — zasadniczo tak. Jeśli masz dostęp do Fable 5.2, jest niewiele powodów, by zaczynać coś nowego na 5.1. Anthropic nie ogłosił jednak daty wycofania, a zespoły z promptami lub agentami dostrojonymi pod Fable 5.1 będą chciały przetestować 5.2 przed przełączeniem. Wiemy, że nowa wersja może zachowywać się inaczej, nawet jeśli ma lepsze wyniki.
Jak uzyskać dostęp do Claude Fable 5.2
Aplikacje Claude: Fable 5.2 jest dostępny w kwalifikujących się płatnych planach. W ramach promocji startowej plany Pro i standardowe miejsca w Team mogą używać Fable do 50% tygodniowych limitów, a plany z Fable dostają od jednego do trzech resetów wykorzystania zależnie od długości subskrypcji.
API: Użyj identyfikatora modelu
claude-fable-5-2na platformie Claude.Platformy chmurowe: Dostępny w Amazon Web Services, Google Cloud i Microsoft Azure.
Mythos 5.2: Złóż wniosek przez Cyber Verification Program lub Life Sciences Verification Program. Klienci Claude Enterprise mogą też używać go przez Claude Security.
Przedsiębiorstwa z rygorystycznymi wymaganiami dot. danych mogą użyć Enterprise Frontier Safeguards, które uruchamia monitorowanie bezpieczeństwa Anthropic na danych przechowywanych w infrastrukturze klienta i działa z zerową retencją danych. Pozostali klienci mają 30-dniową retencję danych na potrzeby monitorowania bezpieczeństwa.
Końcowe uwagi
Claude Fable 5.2 to znaczący krok naprzód względem Fable 5.1. Jest tańszy, szybszy i rzadziej odmawia legalnej pracy. Skoki w Remote Labor Index, robotyce i FrontierCode są szczególnie duże.
Mimo to Opus 5.5 pozostaje lepszym wyborem wartości dla większości codziennych zadań przy połowie ceny. Najciekawsze w Fable 5.2 mogą być twierdzenia o efektywności: jeśli rzeczywiście dorównuje najlepszym wynikom Opus 5.5 przy niskim lub średnim wysiłku, premia za token szybko maleje. Warto to sprawdzić na własnych obciążeniach.
Jeśli chcesz zacząć pracę z Claude, nasza ścieżka Developing AI Applications to dobre miejsce na start.