Curso
Introdução ao TensorFlow em Python
4 h
56.5K
Deep learning é um subcampo de machine learning, um conjunto de algoritmos inspirados na estrutura e no funcionamento do cérebro.
TensorFlow é o segundo framework de machine learning criado pelo Google, usado para projetar, construir e treinar modelos de deep learning. Você pode usar a biblioteca TensorFlow para fazer computações numéricas — o que por si só não parece tão especial — mas essas computações são executadas com grafos de fluxo de dados. Nesses grafos, os nós representam operações matemáticas, enquanto as arestas representam os dados — geralmente arrays multidimensionais, ou tensores — que fluem entre essas arestas.
Viu só? O nome “TensorFlow” vem justamente das operações que redes neurais realizam sobre arrays multidimensionais, os tensores! É literalmente o fluxo de tensores. Por enquanto, isso é tudo que você precisa saber sobre tensores, mas vamos mais a fundo nas próximas seções!
O tutorial de TensorFlow de hoje, para iniciantes, vai apresentar o uso de deep learning de forma interativa:
Baixe o notebook deste tutorial aqui.
Você também pode se interessar pelo curso Deep Learning in Python, pelo tutorial de Keras da DataCamp ou pelo tutorial de Keras com R.
Para entender bem os tensores, é bom ter alguma base de álgebra linear e cálculo vetorial. Na introdução, você viu que os tensores são implementados no TensorFlow como arrays de dados multidimensionais, mas vale uma contextualização para entender completamente o que são tensores e como são usados em machine learning.
Antes de entrar nos vetores no plano, vale relembrar rapidamente o conceito de “vetores”. Vetores são tipos especiais de matrizes, que são arranjos retangulares de números. Por serem coleções ordenadas de números, muitas vezes são vistos como matrizes coluna: têm apenas uma coluna e um certo número de linhas. Em outras palavras, você também pode considerar vetores como grandezas escalares às quais foi atribuída uma direção.
Lembrete: um exemplo de escalar é “5 metros” ou “60 m/s”, enquanto um vetor é, por exemplo, “5 metros ao norte” ou “60 m/s para leste”. A diferença é que o vetor tem direção. Esses exemplos podem parecer distantes dos vetores que você encontra em problemas de machine learning — é normal. O comprimento de um vetor matemático é um número absoluto. Já a direção é relativa: é medida em relação a uma direção de referência e tem unidade em radianos ou graus. Geralmente, assume-se direção positiva no sentido anti-horário a partir da direção de referência.
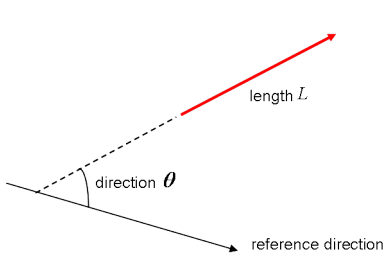
Visualmente, vetores são representados como setas, como na figura acima. Isso significa que você pode pensar neles como setas com direção e comprimento. A direção é indicada pela ponta da seta, e o comprimento, pelo tamanho da seta.
E quanto aos vetores no plano?
Vetores no plano são a forma mais direta de tensores. Eles se parecem com os vetores “comuns” que você acabou de ver, com a diferença de que pertencem a um espaço vetorial. Para entender melhor, vamos a um exemplo: você tem um vetor 2 × 1. Isso significa que o vetor pertence ao conjunto de números reais tomados aos pares. Ou, dito de outra forma, ele faz parte do espaço bidimensional. Nesses casos, você pode representá-lo no plano de coordenadas (x, y) com setas ou raios.
Trabalhando a partir desse plano, em posição padrão, com vetores tendo a ponta na origem (0,0), você obtém a coordenada x olhando a primeira linha do vetor, e a coordenada y na segunda. Claro, essa posição padrão não precisa ser mantida sempre: vetores podem se mover paralelamente a si mesmos no plano sem sofrer alterações.
Observação: de forma similar, para vetores de tamanho 3 × 1, falamos do espaço tridimensional. Você pode representá-los como figuras em 3D com setas apontando para posições no espaço do vetor — desenhadas nos eixos padrão x, y e z.
Ter esses vetores e representá-los no plano é ótimo, mas, no fim, você quer operar sobre eles. Uma forma útil de fazer isso é expressar seus vetores como bases ou vetores unitários.
Vetores unitários têm magnitude igual a 1. Você vai reconhecê-los por uma letra minúscula com acento circunflexo (o “chapéu”). Vetores unitários são convenientes para expressar um vetor 2D ou 3D como soma de duas ou três componentes ortogonais, como os eixos x e y, ou o eixo z.
E quando falamos em expressar um vetor como soma de componentes, estamos falando de vetores componente, que são dois ou mais vetores cuja soma resulta no vetor em questão.
Dica: assista a este vídeo, que explica tensores usando objetos do dia a dia!
Além dos vetores no plano, co-vetores e operadores lineares são outros dois casos que, juntos, têm algo em comum: são casos específicos de tensores. Você deve lembrar que um vetor foi caracterizado como grandeza escalar com direção. Um tensor, por sua vez, é a representação matemática de uma entidade física que pode ser caracterizada por magnitude e múltiplas direções.
Assim como um escalar é representado por um único número e um vetor por uma sequência de três números em um espaço 3D, por exemplo, um tensor pode ser representado por um arranjo de 3^R números em um espaço tridimensional.
O “R” dessa notação representa o posto (rank) do tensor: em um espaço 3D, um tensor de segunda ordem pode ser representado por 3 elevado a 2, ou 9 números. Em um espaço N-dimensional, escalares continuam exigindo apenas um número, vetores exigem N números e tensores exigem N^R números. É por isso que você ouve que escalares são tensores de ordem 0: como não têm direção, são representados por um único número.
Com isso em mente, fica fácil reconhecer e diferenciar escalares, vetores e tensores: escalares por um número, vetores por um conjunto ordenado de números e tensores por um arranjo (array) de números.
O que torna tensores tão únicos é a combinação de componentes e vetores de base: os vetores de base se transformam de uma forma entre referenciais, e os componentes se transformam de modo a manter a combinação entre componentes e vetores de base inalterada.
Agora que você já sabe mais sobre TensorFlow, é hora de instalar a biblioteca. Vale saber que o TensorFlow oferece APIs para Python, C++, Haskell, Java, Go, Rust, e também há um pacote de terceiros para R chamado tensorflow.
Dica: se quiser saber mais sobre pacotes de deep learning em R, confira o tutorial keras: Deep Learning in R da DataCamp.
Neste tutorial, você vai baixar uma versão do TensorFlow que permite escrever o código do seu projeto de deep learning em Python. Na página de instalação do TensorFlow, você encontra as formas mais comuns e as instruções mais recentes para instalar o TensorFlow usando virtualenv, pip, Docker e outras maneiras de instalar no seu computador.
Observação Você também pode instalar o TensorFlow com Conda se estiver no Windows. Porém, como a instalação de TensorFlow é mantida pela comunidade, é melhor conferir as instruções oficiais.
Depois de concluir a instalação, confira se deu tudo certo importando a biblioteca no seu ambiente com o alias tf:
import tensorflow as tfObservação: o alias usado acima é praticamente um padrão — ele ajuda a manter consistência com outros desenvolvedores que usam TensorFlow em projetos de ciência de dados e com projetos open source da comunidade.
Geralmente você escreve programas em TensorFlow para rodar como um bloco; à primeira vista, isso parece contraditório com a forma interativa do Python. No entanto, se preferir, também pode usar a sessão interativa do TensorFlow para trabalhar de modo mais interativo com a biblioteca — especialmente útil se você está acostumado ao IPython.
Neste tutorial, vamos focar nessa segunda opção: ela ajuda a acelerar seu início com deep learning em TensorFlow. Mas, antes de avançar, vamos testar algumas coisinhas simples.
Primeiro, importe a biblioteca tensorflow com o alias tf, como vimos antes. Em seguida, inicialize duas variáveis que, na verdade, são constantes. Passe um array com quatro números para a função constant().
Observação: você também poderia passar um inteiro, mas na prática você quase sempre trabalha com arrays. Como vimos na introdução, tensores são sobre arrays! Então passe um array :) Depois, use multiply() para multiplicar as duas variáveis. Guarde o resultado na variável result. Por fim, imprima result com a função print().
Observação: no bloco de código acima, você definiu constantes. Mas existem outros dois tipos de valores que você pode usar: placeholders, que são valores não atribuídos e serão inicializados pela sessão quando executada (como o nome sugere, são “marcadores” para tensores que sempre serão alimentados quando a sessão rodar); e Variables, que são valores que podem mudar. Constantes, como você já deve ter percebido, não mudam.
O resultado dessas linhas é um tensor abstrato no grafo computacional. Porém, ao contrário do que você pode esperar, o result não é realmente calculado — você só definiu o modelo; nada foi executado para obter o resultado. Dá para ver isso no print: não aparece o valor que você queria (30). Isso significa que o TensorFlow usa avaliação tardia (lazy evaluation)!
Se quiser ver o resultado, rode esse código em uma sessão interativa. Há algumas formas de fazer isso, como mostrado abaixo:
Observação: você também pode iniciar uma sessão interativa, executar result e fechar a sessão automaticamente depois de imprimir output com o código a seguir:
Acima, você definiu uma sessão padrão, mas também pode passar opções. Por exemplo, especifique o argumento config e use o buffer de protocolo ConfigProto para adicionar opções de configuração à sua sessão.
Por exemplo, se você adicionar
config=tf.ConfigProto(log_device_placement=True)à sessão, garante o log do dispositivo (GPU ou CPU) atribuído a cada operação. Assim, você vê quais dispositivos são usados na sessão para cada operação. Você também pode usar a seguinte configuração quando fizer alocação flexível de dispositivos:
config=tf.ConfigProto(allow_soft_placement=True)Agora que o TensorFlow está instalado, importado e você passou pelo básico do pacote, é hora de focar nos dados. Como sempre, primeiro vamos explorar e entender melhor seus dados antes de partir para a rede neural.
Embora trânsito seja um tema familiar, vale passar rapidamente pelas observações incluídas neste conjunto de dados para garantir que tudo está claro antes de começar. Nesta seção, você obtém o conhecimento de domínio necessário para seguir adiante.
Claro que, como eu sou belga, vou trazer algumas curiosidades :)
Agora que você tem mais contexto, é hora de baixar o dataset aqui. Baixe os dois arquivos zip listados ao lado de "BelgiumTS for Classification (cropped images)", chamados "BelgiumTSC_Training" e "BelgiumTSC_Testing".
Dica: depois de baixar os arquivos (ou quando baixar após concluir o tutorial), dê uma olhada na estrutura de pastas. Você verá que as pastas de treino e teste contêm 61 subpastas, que são os 62 tipos de placas que usaremos para classificação. Além disso, os arquivos têm extensão .ppm (Portable Pixmap Format). Você baixou imagens das placas!
Vamos importar os dados para o seu ambiente. Comece com o código abaixo da função definida pelo usuário (UDF) load_data():
ROOT_PATH, o diretório onde estão as pastas de treino e teste.ROOT_PATH com join(). Guarde em train_data_directory e test_data_directory.load_data() passando train_data_directory.load_data() começa listando todos os subdiretórios de train_data_directory com list comprehension — uma forma natural de construir listas: para cada item encontrado, verifique se é diretório e, se for, adicione-o à lista. Lembrete: cada subdiretório representa um rótulo.labels e images. Em seguida, colete os caminhos das subpastas e os nomes dos arquivos de imagem nelas. Por fim, adicione os dados às listas com append().def load_data(data_directory):
directories = [d for d in os.listdir(data_directory)
if os.path.isdir(os.path.join(data_directory, d))]
labels = []
images = []
for d in directories:
label_directory = os.path.join(data_directory, d)
file_names = [os.path.join(label_directory, f)
for f in os.listdir(label_directory)
if f.endswith(".ppm")]
for f in file_names:
images.append(skimage.data.imread(f))
labels.append(int(d))
return images, labels
ROOT_PATH = "/your/root/path"
train_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Training")
test_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Testing")
images, labels = load_data(train_data_directory)Observação: no código acima, os dados de treino e teste estão em pastas chamadas "Training" e "Testing", ambas dentro do diretório "TrafficSigns". Em uma máquina local, poderia ser algo como "/Users/Nome/Downloads/TrafficSigns", com duas subpastas "Training" e "Testing".
Dica: relembre como escrever funções em Python no tutorial de funções em Python da DataCamp.
Com os dados carregados, é hora de inspecionar! Comece com uma análise simples usando os atributos ndim e size do array images:
Lembre que images e labels são listas; você pode precisar de np.array() para convertê-las em arrays no seu ambiente. Aqui isso já foi feito para você!
Observação: o images[0] que você imprimiu é, na verdade, uma única imagem representada por arrays dentro de arrays! Pode parecer contraintuitivo no começo, mas você se acostuma ao trabalhar com imagens em aplicações de machine learning ou deep learning.
Em seguida, dê uma olhada rápida nos labels — sem grandes surpresas neste ponto:
Esses números já dão uma noção do sucesso da importação e do tamanho exato dos dados. À primeira vista, tudo correu como esperado, e o tamanho do array é considerável — especialmente porque são arrays dentro de arrays.
Dica: experimente adicionar os atributos flags, itemsize e nbytes aos seus arrays para obter mais informações sobre o layout em memória, o tamanho em bytes de um elemento e o total de bytes consumidos pelos elementos. Você pode testar isso no console IPython no bloco acima!
Agora, veja também a distribuição das placas:
Mandou bem! Agora vamos olhar mais de perto o histograma que você criou!

De cara, dá para ver que alguns rótulos aparecem muito mais que outros: os rótulos 22, 32, 38 e 61 chamam atenção. Guarde isso — vamos retomar na próxima seção!
As análises rápidas acima já deram uma ideia dos dados, mas quando você trabalha com imagens, a melhor forma de explorar é visualizando.
Vamos ver algumas placas aleatórias:
pyplot do pacote matplotlib com o alias plt.images que você acabou de inspecionar. Aqui vamos de 300, 2250, 3650 e 4000.images correspondente ao índice i. No primeiro loop, passe 300 para images[], no segundo 2250 e assim por diante. Por fim, ajuste a largura entre os subplots.show()!Olha só:
# Import the `pyplot` module of `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images that you want to see
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images that you defined
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)

plt.show()
Como você pode inferir pelos 62 rótulos do dataset, os sinais são diferentes entre si.
Mas o que mais você percebe? Observe de novo as imagens abaixo:

As quatro imagens não têm o mesmo tamanho!
Você pode brincar com os números da lista traffic_signs e investigar melhor, mas essa é uma observação importante que precisaremos considerar ao preparar os dados para alimentar a rede neural.
Vamos confirmar a hipótese dos tamanhos diferentes imprimindo o shape, o valor mínimo e o máximo das imagens usadas nos subplots.
O código abaixo é bem parecido com o que gerou o gráfico anterior, mas aqui vamos alternar entre tamanhos e imagens, em vez de apenas plotá-las lado a lado:
# Import `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images and add shape, min and max values
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)
    plt.show()
    print("shape: {0}, min: {1}, max: {2}".format(images[traffic_signs[i]].shape,
                                                  images[traffic_signs[i]].min(),
images[traffic_signs[i]].max()))Observação: repare no uso de format() na string "shape: {0}, min: {1}, max: {2}" para preencher os argumentos {0}, {1} e {2}.

Agora que você viu imagens individuais, pode querer revisitar o histograma do início da exploração. Dá para fazer isso plotando uma visão geral das 62 classes, com uma imagem de cada uma:
# Import the `pyplot` module as `plt`
import matplotlib.pyplot as plt

# Get the unique labels
unique_labels = set(labels)

# Initialize the figure
plt.figure(figsize=(15, 15))

# Set a counter
i = 1

# For each unique label,
for label in unique_labels:
    # You pick the first image for each label
    image = images[labels.index(label)]
    # Define 64 subplots
    plt.subplot(8, 8, i)
    # Don't include axes
    plt.axis('off')
    # Add a title to each subplot
    plt.title("Label {0} ({1})".format(label, labels.count(label)))
    # Add 1 to the counter
    i += 1
    # And you plot this first image
    plt.imshow(image)

# Show the plot
plt.show()Observação: embora você defina 64 subplots, nem todos mostrarão imagens (são 62 rótulos!). E, de novo, sem eixos para manter o foco nas placas.

Como o histograma já indicava, há bem mais placas com os rótulos 22, 32, 38 e 61. Agora a hipótese fica confirmada: vemos 375 instâncias do rótulo 22, 316 do 32, 285 do 38 e 282 do 61.
Uma pergunta interessante é se existe alguma relação entre esses rótulos — talvez todos sejam sinais indicativos?
Analisando de perto: 22 e 32 são de proibição; 38 e 61 são indicativo e prioridade, respectivamente. Ou seja, não há uma conexão direta entre os quatro, exceto que metade dos rótulos mais frequentes é de proibição.

Agora que você explorou bem os dados, é hora de colocar a mão na massa! Recapitulando o que observamos para não esquecer nada na etapa de manipulação:
Com isso claro, vamos preparar os dados para alimentar a rede neural (ou outro modelo). Primeiro, vamos extrair algumas features — vamos redimensionar as imagens e convertê-las para tons de cinza. Essa conversão é útil porque, em tarefas de classificação como a nossa, a cor costuma importar menos. Já em detecção, a cor pode fazer bastante diferença, então essa etapa pode não ser desejável.
Para lidar com os tamanhos diferentes, vamos redimensionar as imagens. Isso é fácil com a biblioteca skimage (Scikit-Image), que reúne algoritmos de processamento de imagens.
Neste caso, o módulo transform será útil, pois oferece a função resize(). Vamos usar list comprehension (de novo!) para redimensionar cada imagem para 28 × 28 pixels. Para cada imagem em images, aplicamos a transformação do skimage e guardamos o resultado na variável images28:
# Import the `transform` module from `skimage`
from skimage import transform

# Rescale the images in the `images` array
images28 = [transform.resize(image, (28, 28)) for image in images]
Bem tranquilo, né?
Observação: agora as imagens são quadridimensionais: se você converter images28 em array e checar o atributo shape, verá (4575, 28, 28, 3). As imagens têm 784 dimensões (28 × 28 pixels).
Você pode conferir o resultado reutilizando o código que plota as 4 imagens aleatórias com a variável traffic_signs. Só não esqueça de trocar images por images28.
Veja o resultado:
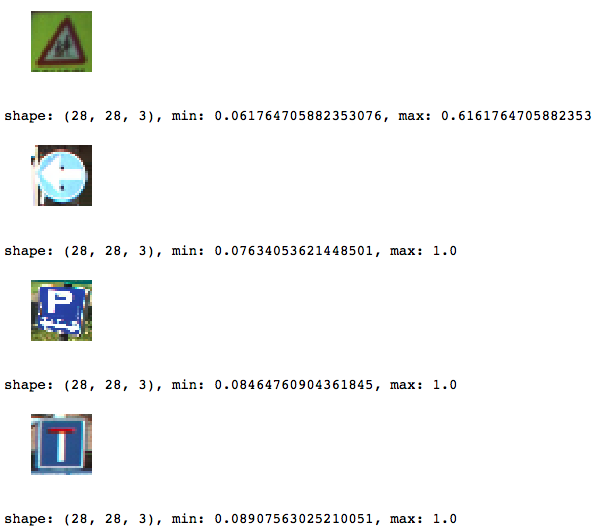
Observação: como redimensionamos, os valores min e max também mudaram; agora parecem estar nas mesmas faixas, o que é ótimo — pode dispensar normalização adicional!
Como dito na introdução desta seção, a cor importa menos para a nossa classificação, então vamos converter para grayscale.
Observação: você pode testar por conta própria o que acontece com os resultados finais se pular esta etapa.
Assim como no redimensionamento, podemos contar com o Scikit-Image. Aqui, usamos o módulo color com a função rgb2gray().
Bem simples!
Mas não esqueça de converter images28 de volta para array, pois rgb2gray() espera um array como argumento.
# Import `rgb2gray` from `skimage.color`
from skimage.color import rgb2gray

# Convert `images28` to an array
images28 = np.array(images28)

# Convert `images28` to grayscale
images28 = rgb2gray(images28)
Confira o resultado da conversão plotando algumas imagens; novamente, dá para reutilizar e adaptar o código para mostrar as imagens ajustadas:
import matplotlib.pyplot as plt

traffic_signs = [300, 2250, 3650, 4000]

for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images28[traffic_signs[i]], cmap="gray")
    plt.subplots_adjust(wspace=0.5)

# Show the plot
plt.show()Observação: é preciso informar o mapa de cores cmap como "gray" para plotar em tons de cinza. Isso porque o imshow() usa, por padrão, um mapa de cores do tipo “heatmap”. Saiba mais aqui.

Dica: como você reutilizou bastante essa função ao longo do tutorial, vale pensar em transformá-la em uma função própria :)
Esses dois passos são bem básicos; outras operações que você poderia testar incluem aumento de dados (rotação, desfoque, translação, alteração de brilho etc.). Se quiser, dá para montar um pipeline completo de manipulação pelo qual suas imagens passam.
Agora que você explorou e manipulou os dados, é hora de construir a arquitetura da rede neural com o TensorFlow!
Assim como no Keras, vamos construir a rede camada por camada.
Se ainda não fez, importe o tensorflow com o alias padrão tf. Depois, inicialize o grafo com Graph(). Essa função serve para definir a computação. Observação: com o grafo você não computa nada — ele não guarda valores; apenas define as operações que você quer executar depois.
Neste caso, você define um contexto padrão com as_default(), que retorna um gerenciador de contexto e torna esse grafo o padrão. Use quando quiser criar múltiplos grafos no mesmo processo — com ele, há um grafo global padrão ao qual todas as operações serão adicionadas se você não criar outro explicitamente.
Agora, vamos adicionar operações ao grafo. Como você deve lembrar do Keras, você constrói o modelo e, na compilação, define função de perda, otimizador e métrica. No TensorFlow “puro”, isso acontece em uma etapa:
run().flatten(), que gera um array de shape [None, 784] em vez de [None, 28, 28], que é o shape das imagens em tons de cinza.[None, 62]. Logits são as saídas não escaladas de camadas anteriores — a função trabalha com a escala relativa para interpretar as unidades linearmente.sparse_softmax_cross_entropy_with_logits()reduce_mean(), que calcula a média dos elementos ao longo das dimensões de um tensor.0.001.# Import `tensorflow`
import tensorflow as tf
# Initialize placeholders
x = tf.placeholder(dtype = tf.float32, shape = [None, 28, 28])
y = tf.placeholder(dtype = tf.int32, shape = [None])
# Flatten the input data
images_flat = tf.contrib.layers.flatten(x)
# Fully connected layer
logits = tf.contrib.layers.fully_connected(images_flat, 62, tf.nn.relu)
# Define a loss function
loss = tf.reduce_mean(tf.nn.sparse_softmax_cross_entropy_with_logits(labels = y,
logits = logits))
# Define an optimizer
train_op = tf.train.AdamOptimizer(learning_rate=0.001).minimize(loss)
# Convert logits to label indexes
correct_pred = tf.argmax(logits, 1)
# Define an accuracy metric
accuracy = tf.reduce_mean(tf.cast(correct_pred, tf.float32))Pronto! Você acabou de criar sua primeira rede neural com TensorFlow.
Se quiser, pode imprimir os valores (ou descrições) de algumas variáveis para revisar o que acabou de codar:
print("images_flat: ", images_flat)
print("logits: ", logits)
print("loss: ", loss)
print("predicted_labels: ", correct_pred)Dica: se aparecer um erro como “module 'pandas' has no attribute 'computation'”, tente atualizar o pacote dask com pip install --upgrade dask. Veja este post no StackOverflow para mais informações.
Com o modelo montado, é hora de rodar! Para isso, primeiro inicialize uma sessão com Session(). Em seguida, rode a sessão com run(), passando as operações inicializadas, como a variável init definida anteriormente.
Depois, use a sessão inicializada para começar as épocas (loops de treino). Aqui, escolhemos 201 para registrar o último loss_value. No loop, execute o otimizador de treino e a métrica de perda (ou acurácia) definidas antes. Passe também o argumento feed_dict, que alimenta o modelo com dados. A cada 10 épocas, um log mostra o custo/perda do modelo.
Como vimos no básico do TensorFlow, não é necessário fechar a sessão manualmente; isso pode ser feito automaticamente. Mas, se você iniciar uma sessão nomeada, pode fechá-la com sess.close(), como no exemplo:
tf.set_random_seed(1234)
sess = tf.Session()

sess.run(tf.global_variables_initializer())

for i in range(201):
        print('EPOCH', i)
        _, accuracy_val = sess.run([train_op, accuracy], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
            print("Loss: ", loss)
print('DONE WITH EPOCH')Lembre: você também pode rodar o trecho abaixo, que fecha a sessão automaticamente, como mostrado no começo do tutorial:
tf.set_random_seed(1234)

with tf.Session() as sess:
    sess.run(tf.global_variables_initializer())
    for i in range(201):
        _, loss_value = sess.run([train_op, loss], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
print("Loss: ", loss)Observação: usamos global_variables_initializer() porque initialize_all_variables() foi descontinuada.
Pronto — seu modelo foi treinado com sucesso! Tranquilo, né?
Ainda falta avaliar a rede. Para ter uma noção do desempenho, escolha 10 imagens aleatórias e compare os rótulos previstos com os reais.
Você pode apenas imprimir, mas por que não usar o matplotlib para exibir as placas e comparar visualmente?
 # Import `matplotlib`
import matplotlib.pyplot as plt
import random

# Pick 10 random images
sample_indexes = random.sample(range(len(images28)), 10)
sample_images = [images28[i] for i in sample_indexes]
sample_labels = [labels[i] for i in sample_indexes]

# Run the "correct_pred" operation
predicted = sess.run([correct_pred], feed_dict={x: sample_images})[0]

# Print the real and predicted labels
print(sample_labels)
print(predicted)

# Display the predictions and the ground truth visually.
fig = plt.figure(figsize=(10, 10))
for i in range(len(sample_images)):
    truth = sample_labels[i]
    prediction = predicted[i]
    plt.subplot(5, 2,1+i)
    plt.axis('off')
    color='green' if truth == prediction else 'red'
    plt.text(40, 10, "Truth:        {0}\nPrediction: {1}".format(truth, prediction),
             fontsize=12, color=color)
    plt.imshow(sample_images[i],  cmap="gray")

plt.show()
Só olhar imagens aleatórias, porém, não dá uma visão completa do desempenho. Por isso, vamos carregar os dados de teste.
Observação: vamos reutilizar a função load_data() definida no início do tutorial.
# Import `skimage`
from skimage import transform

# Load the test data
test_images, test_labels = load_data(test_data_directory)

# Transform the images to 28 by 28 pixels
test_images28 = [transform.resize(image, (28, 28)) for image in test_images]

# Convert to grayscale
from skimage.color import rgb2gray
test_images28 = rgb2gray(np.array(test_images28))

# Run predictions against the full test set.
predicted = sess.run([correct_pred], feed_dict={x: test_images28})[0]

# Calculate correct matches
match_count = sum([int(y == y_) for y, y_ in zip(test_labels, predicted)])

# Calculate the accuracy
accuracy = match_count / len(test_labels)

# Print the accuracy
print("Accuracy: {:.3f}".format(accuracy))
Lembre de fechar a sessão com sess.close() caso não tenha usado with tf.Session() as sess: para iniciá-la.
Se quiser continuar trabalhando com este dataset e o modelo do tutorial, experimente:
Não deixe de conferir o livro Machine Learning With TensorFlow, de Nishant Shukla.
Dica: explore também o TensorFlow Playground e o TensorBoard.
Se quiser continuar com imagens, veja o tutorial de scikit-learn da DataCamp, que aborda o dataset MNIST com PCA, K-Means e Máquinas de Vetores de Suporte (SVMs). Ou confira outros tutoriais, como este aqui, que usa o dataset de placas belgas.
Aprenda mais sobre Python e deep learning
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Bharath K
13 min
Tutorial
Tutorial
Zoumana Keita
14 min