Cours
Introduction à TensorFlow en Python
4 h
56.5K
L’apprentissage profond est un sous‑domaine de l’apprentissage automatique, un ensemble d’algorithmes inspirés de la structure et du fonctionnement du cerveau.
TensorFlow est le deuxième framework de Machine Learning créé par Google, utilisé pour concevoir, construire et entraîner des modèles d’apprentissage profond. Vous pouvez utiliser la bibliothèque TensorFlow pour réaliser des calculs numériques, ce qui n’a rien d’exceptionnel en soi, mais ces calculs sont exécutés au moyen de graphes de flux de données. Dans ces graphes, les nœuds représentent des opérations mathématiques, tandis que les arêtes représentent les données — le plus souvent des tableaux multidimensionnels, ou tenseurs — qui circulent entre ces arêtes.
Vous voyez ? Le nom « TensorFlow » vient des opérations que les réseaux de neurones effectuent sur ces tableaux multidimensionnels, les tenseurs : c’est littéralement un flux de tenseurs. Pour l’instant, c’est tout ce que vous devez savoir sur les tenseurs, mais vous irez plus loin dans les sections suivantes !
Le tutoriel TensorFlow du jour pour débutants vous présentera le deep learning de manière interactive :
Téléchargez le notebook de ce tutoriel ici.
Vous pourriez aussi être intéressé par un cours sur Deep Learning in Python, le tutoriel Keras de DataCamp ou le tutoriel keras avec R.
Pour bien comprendre les tenseurs, il est utile d’avoir quelques notions d’algèbre linéaire et de calcul vectoriel. Vous avez déjà lu en introduction que les tenseurs sont implémentés dans TensorFlow comme des tableaux de données multidimensionnels, mais un complément d’introduction vous aidera à bien saisir ce que sont les tenseurs et leur usage en apprentissage automatique.
Avant d’aborder les vecteurs plans, révisons brièvement la notion de « vecteur ». Les vecteurs sont des types particuliers de matrices, qui sont des tableaux rectangulaires de nombres. Parce que les vecteurs sont des collections ordonnées de nombres, on les représente souvent comme des matrices‑colonnes : une seule colonne et un certain nombre de lignes. Autrement dit, vous pouvez aussi considérer les vecteurs comme des grandeurs scalaires auxquelles on a associé une direction.
À retenir : un exemple de scalaire est « 5 mètres » ou « 60 m/s », tandis qu’un vecteur est par exemple « 5 mètres vers le nord » ou « 60 m/s vers l’est ». La différence, évidemment, est que le vecteur a une direction. Néanmoins, ces exemples peuvent sembler loin des vecteurs rencontrés dans des problèmes de Machine Learning. C’est normal ; La longueur d’un vecteur mathématique est un nombre pur : elle est absolue. La direction, en revanche, est relative : elle est mesurée par rapport à une direction de référence et s’exprime en radians ou en degrés. On suppose généralement que la direction est positive et mesurée dans le sens antihoraire à partir de la référence.
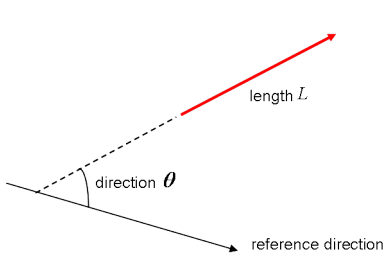
Visuellement, on représente les vecteurs par des flèches, comme sur l’illustration ci‑dessus. Cela signifie que vous pouvez aussi considérer les vecteurs comme des flèches dotées d’une direction et d’une longueur. La direction est indiquée par la pointe, tandis que la longueur est donnée par la taille de la flèche.
Et les vecteurs plans alors ?
Les vecteurs plans sont la forme la plus simple de tenseurs. Ils ressemblent aux vecteurs « classiques » décrits ci‑dessus, à ceci près qu’ils se situent dans un espace vectoriel. Pour mieux comprendre, prenons un exemple : vous avez un vecteur de taille 2 × 1. Cela signifie que le vecteur appartient à l’ensemble des réels pris par paires. Autrement dit, il fait partie du plan à deux dimensions. Dans ce cas, vous pouvez représenter les vecteurs sur le plan de coordonnées (x, y) à l’aide de flèches ou de rayons.
En partant d’un plan de coordonnées en position standard, où les vecteurs ont leur extrémité à l’origine (0,0), vous pouvez déduire la coordonnée x en regardant la première ligne du vecteur, et la coordonnée y dans la seconde. Bien sûr, cette position standard n’est pas obligatoire : les vecteurs peuvent se déplacer parallèlement à eux‑mêmes dans le plan sans changer.
Remarque : pour des vecteurs de taille 3 × 1, on parle d’espace à trois dimensions. Vous pouvez représenter le vecteur comme une figure 3D avec des flèches pointant vers des positions dans l’espace vectoriel, dessinées sur les axes x, y et z.
C’est utile d’avoir ces vecteurs et de les représenter sur le plan, mais l’essentiel est de pouvoir effectuer des opérations dessus, et l’une des choses qui aide est d’exprimer vos vecteurs en bases ou vecteurs unitaires.
Les vecteurs unitaires sont des vecteurs de norme un. On les reconnaît souvent à une lettre minuscule surmontée d’un « chapeau ». Ils sont pratiques lorsque vous voulez exprimer un vecteur 2D ou 3D comme somme de deux ou trois composantes orthogonales, par exemple selon les axes x et y, ou z.
Et quand vous exprimez un vecteur comme somme de composantes, vous parlez de vecteurs composants, c’est‑à‑dire de deux vecteurs ou plus dont la somme reconstitue le vecteur donné.
Astuce : regardez cette vidéo, qui explique les tenseurs avec des objets du quotidien !
Outre les vecteurs plans, les covecteurs et les opérateurs linéaires forment deux autres cas qui, avec les précédents, ont un point commun : ce sont des cas particuliers de tenseurs. Vous vous souvenez qu’un vecteur a été caractérisé plus haut comme une grandeur scalaire à laquelle on a donné une direction. Un tenseur, lui, est la représentation mathématique d’une entité physique qui peut être caractérisée par une grandeur et plusieurs directions.
Et, tout comme un scalaire se représente par un seul nombre et un vecteur par une suite de trois nombres en 3D par exemple, un tenseur peut être représenté par un tableau de 3^R nombres dans un espace à trois dimensions.
Le « R » dans cette notation représente le rang du tenseur : dans un espace 3D, un tenseur d’ordre 2 se représente par 3 à la puissance 2, soit 9 nombres. Dans un espace de dimension N, les scalaires requièrent toujours un seul nombre, les vecteurs N nombres et les tenseurs N^R nombres. C’est pourquoi on dit souvent que les scalaires sont des tenseurs de rang 0 : n’ayant pas de direction, un seul nombre suffit à les représenter.
Avec cela en tête, il est assez simple de reconnaître et distinguer scalaires, vecteurs et tenseurs : un scalaire par un nombre, un vecteur par un ensemble ordonné de nombres, un tenseur par un tableau de nombres.
Ce qui rend les tenseurs uniques, c’est la combinaison de composantes et de vecteurs de base : les vecteurs de base se transforment d’une certaine façon entre référentiels, et les composantes se transforment de manière à conserver la combinaison « composantes + vecteurs de base » inchangée.
Maintenant que vous en savez plus sur TensorFlow, il est temps d’installer la bibliothèque. Sachez que TensorFlow propose des API pour Python, C++, Haskell, Java, Go, Rust, et qu’il existe aussi un paquet tiers pour R nommé tensorflow.
Astuce : si vous voulez en savoir plus sur les bibliothèques de deep learning en R, consultez le tutoriel keras : Deep Learning in R de DataCamp.
Dans ce tutoriel, vous téléchargerez une version de TensorFlow qui vous permettra d’écrire votre projet d’apprentissage profond en Python. Sur la page d’installation de TensorFlow, vous trouverez les méthodes les plus courantes et les dernières instructions pour installer TensorFlow via virtualenv, pip, Docker, ainsi que d’autres moyens d’installation sur votre machine.
Remarque Vous pouvez aussi installer TensorFlow avec Conda si vous travaillez sous Windows. Cependant, l’installation étant supportée par la communauté, mieux vaut vérifier les instructions officielles.
Une fois l’installation terminée, vérifiez que tout fonctionne en important TensorFlow dans votre espace de travail sous l’alias tf :
import tensorflow as tfRemarque : l’alias utilisé ci‑dessus est une convention — il vous permet de rester cohérent avec les autres développeurs qui utilisent TensorFlow dans des projets data science, ainsi qu’avec les projets open source TensorFlow.
Vous écrirez généralement des programmes TensorFlow que vous exécuterez par blocs. À première vue, cela peut sembler contradictoire avec Python. Toutefois, si vous le souhaitez, vous pouvez aussi utiliser la session interactive de TensorFlow, pratique si vous avez l’habitude d’IPython.
Dans ce tutoriel, vous vous concentrerez sur cette seconde option : elle vous aidera à démarrer plus vite avec le deep learning dans TensorFlow. Mais avant d’aller plus loin, testons quelques éléments simples avant d’attaquer le lourd.
D’abord, importez la bibliothèque tensorflow sous l’alias tf, comme vu plus haut. Puis initialisez deux variables qui sont en réalité des constantes. Passez un tableau de quatre nombres à la fonction constant().
Remarque : vous pourriez aussi passer un entier, mais le plus souvent vous travaillerez avec des tableaux. Comme vous l’avez vu, les tenseurs, c’est avant tout des tableaux ! Assurez‑vous donc de passer un tableau :) Ensuite, utilisez multiply() pour multiplier vos deux variables. Stockez le résultat dans la variable result. Enfin, affichez result avec la fonction print().
Remarque : vous avez défini des constantes dans le bloc DataCamp Light ci‑dessus. Il existe toutefois deux autres types de valeurs possibles : les placeholders, valeurs non assignées qui seront initialisées par la session à l’exécution. Comme leur nom l’indique, ce sont des « emplacements réservés » pour un tenseur, toujours alimentés au moment d’exécuter la session ; et les Variables, qui sont des valeurs susceptibles d’évoluer. Les constantes, vous l’aurez compris, ne changent pas.
Le résultat des lignes de code est un tenseur abstrait dans le graphe de calcul. Contrairement à ce que vous pourriez attendre, result n’est pas réellement calculé. Vous avez défini le modèle, mais aucun processus ne tourne pour produire le résultat. Vous le voyez dans l’affichage : il n’y a pas la valeur (30) que vous souhaiteriez. TensorFlow procède donc par évaluation paresseuse !
Si vous voulez voir le résultat, exécutez ce code dans une session interactive. Plusieurs façons sont possibles, comme montré dans les blocs ci‑dessous :
Remarque : vous pouvez aussi utiliser les lignes suivantes pour démarrer une session interactive, exécuter result et fermer la session automatiquement après avoir affiché output :
Dans les blocs ci‑dessus, vous avez défini une session par défaut, mais sachez que vous pouvez aussi passer des options. Par exemple, vous pouvez préciser l’argument config et utiliser le buffer de protocole ConfigProto pour ajouter des options de configuration à votre session.
Par exemple, si vous ajoutez
config=tf.ConfigProto(log_device_placement=True)à votre session, vous journalisez le CPU ou GPU assigné à chaque opération. Vous obtiendrez ainsi des informations sur les périphériques utilisés dans la session pour chaque opération. Vous pouvez également utiliser la configuration suivante lorsque vous autorisez des contraintes souples de placement des opérations :
config=tf.ConfigProto(allow_soft_placement=True)Maintenant que TensorFlow est installé et importé dans votre espace de travail, et que vous avez vu les bases, mettons cela de côté pour un instant et concentrons‑nous sur les données. Comme toujours, vous allez d’abord prendre le temps de les explorer et de les comprendre avant de modéliser votre réseau de neurones.
Même si la thématique de la circulation est familière à tout le monde, un bref aperçu des observations contenues dans ce jeu de données ne fait pas de mal avant de commencer, pour vérifier que tout est clair. En substance, cette section vous mettra à niveau sur les connaissances métier nécessaires pour aller plus loin dans le tutoriel.
Et comme je suis Belge, attendez‑vous aussi à quelques anecdotes :)
Maintenant que vous avez un peu de contexte, téléchargez le jeu de données ici. Récupérez les deux fichiers zip listés à côté de « BelgiumTS for Classification (cropped images) », nommés « BelgiumTSC_Training » et « BelgiumTSC_Testing ».
Astuce : une fois les fichiers téléchargés (ou après ce tutoriel), examinez l’arborescence ! Vous verrez que les dossiers de test et d’entraînement contiennent 61 sous‑dossiers, correspondant aux 62 types de panneaux que vous utiliserez pour la classification. Vous noterez aussi l’extension .ppm (Portable Pixmap Format). Vous avez bien téléchargé des images de panneaux !
Importons les données dans votre espace de travail. Commencez sous la fonction load_data() (UDF) :
ROOT_PATH, le chemin du répertoire contenant vos données d’entraînement et de test.ROOT_PATH avec join(). Stockez‑les dans train_data_directory et test_data_directory.load_data() en lui passant train_data_directory.load_data() commence par récupérer tous les sous‑répertoires présents dans train_data_directory ; elle le fait via une compréhension de liste, manière naturelle de construire des listes : si vous trouvez quelque chose dans train_data_directory, vous vérifiez si c’est un répertoire et, si oui, vous l’ajoutez à la liste. À retenir : chaque sous‑répertoire représente un label.labels et images. Vous récupérez les chemins des sous‑répertoires et les noms de fichiers des images qu’ils contiennent, puis vous alimentez vos deux listes avec append().def load_data(data_directory):
directories = [d for d in os.listdir(data_directory)
if os.path.isdir(os.path.join(data_directory, d))]
labels = []
images = []
for d in directories:
label_directory = os.path.join(data_directory, d)
file_names = [os.path.join(label_directory, f)
for f in os.listdir(label_directory)
if f.endswith(".ppm")]
for f in file_names:
images.append(skimage.data.imread(f))
labels.append(int(d))
return images, labels
ROOT_PATH = "/your/root/path"
train_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Training")
test_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Testing")
images, labels = load_data(train_data_directory)Remarque : dans le code ci‑dessus, les données d’entraînement et de test se trouvent dans des dossiers « Training » et « Testing », sous‑répertoires d’un dossier « TrafficSigns ». En local, cela pourrait ressembler à « /Users/Nom/Downloads/TrafficSigns », avec deux sous‑dossiers « Training » et « Testing ».
Astuce : révisez l’écriture de fonctions en Python avec le tutoriel sur les fonctions Python de DataCamp.
Vos données chargées, place à l’inspection ! Commencez par une analyse simple avec les attributs ndim et size du tableau images :
Notez que les variables images et labels sont des listes ; vous pourriez avoir besoin de les convertir en tableaux avec np.array() dans votre espace de travail. C’est déjà fait ici !
Remarque : le images[0] que vous avez affiché est en fait une seule image, représentée par des tableaux imbriqués ! Cela peut sembler contre‑intuitif au départ, mais vous vous y habituerez en travaillant avec des images en Machine Learning ou deep learning.
Ensuite, jetez un œil aux labels ; sans grande surprise à ce stade :
Ces nombres vous donnent déjà un aperçu de la réussite de l’import et de la taille exacte des données. À première vue, tout s’est déroulé comme prévu, et vous voyez que la taille du tableau est conséquente si l’on tient compte des tableaux imbriqués.
Astuce : essayez d’ajouter les attributs flags, itemsize et nbytes à vos tableaux pour obtenir des informations sur l’agencement mémoire, la longueur en octets d’un élément et le nombre total d’octets consommés par les éléments. Testez‑le dans la console IPython du bloc DataCamp Light ci‑dessus !
Ensuite, regardez la distribution des panneaux :
Beau travail ! Regardons d’un peu plus près l’histogramme que vous avez produit.

À première vue, certains labels sont plus présents que d’autres : 22, 32, 38 et 61 ressortent nettement. Gardez‑le en tête : vous y reviendrez dans la section suivante.
Les petites vérifications précédentes vous ont donné une idée des données, mais lorsque vous travaillez principalement avec des images, la bonne approche exploratoire est la visualisation.
Affichons quelques panneaux au hasard :
pyplot de matplotlib sous l’alias plt.images que vous avez inspecté. Ici : 300, 2250, 3650 et 4000.images à l’index i : lors de la première boucle 300, puis 2250, etc. Enfin, ajustez l’espacement horizontal.show() !Voici :
# Import the `pyplot` module of `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images that you want to see
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images that you defined
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)

plt.show()
Comme le laissent supposer les 62 labels, les panneaux diffèrent les uns des autres.
Que remarquez‑vous d’autre ? Regardez de près les images ci‑dessous :

Ces quatre images n’ont pas la même taille !
Vous pouvez jouer avec les index de traffic_signs pour approfondir cette observation, mais c’est un point important à considérer lorsque vous préparerez les données pour alimenter le réseau.
Confirmons l’hypothèse des tailles différentes en affichant la forme, les valeurs minimale et maximale des images que vous avez incluses dans les sous‑graphiques.
Le code ci‑dessous ressemble beaucoup à celui utilisé pour le tracé précédent, mais ici, vous alternez tailles et images au lieu de simplement juxtaposer les images :
# Import `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images and add shape, min and max values
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)
    plt.show()
    print("shape: {0}, min: {1}, max: {2}".format(images[traffic_signs[i]].shape,
                                                  images[traffic_signs[i]].min(),
                                                  images[traffic_signs[i]].max()))
Remarque : vous utilisez la méthode format() sur la chaîne "shape: {0}, min: {1}, max: {2}" pour renseigner les arguments {0}, {1} et {2}.

Après avoir vu des images isolées, vous voudrez peut‑être revenir à l’histogramme affiché au début de l’exploration ; vous pouvez facilement tracer un aperçu des 62 classes avec une image par classe :
# Import the `pyplot` module as `plt`
import matplotlib.pyplot as plt

# Get the unique labels
unique_labels = set(labels)

# Initialize the figure
plt.figure(figsize=(15, 15))

# Set a counter
i = 1

# For each unique label,
for label in unique_labels:
    # You pick the first image for each label
    image = images[labels.index(label)]
    # Define 64 subplots
    plt.subplot(8, 8, i)
    # Don't include axes
    plt.axis('off')
    # Add a title to each subplot
    plt.title("Label {0} ({1})".format(label, labels.count(label)))
    # Add 1 to the counter
    i += 1
    # And you plot this first image
    plt.imshow(image)

# Show the plot
plt.show()
Remarque : même si vous définissez 64 sous‑graphes, ils ne seront pas tous remplis (il n’y a que 62 labels !). Et encore une fois, pas d’axes pour ne pas détourner l’attention du sujet : les panneaux !

Comme vous l’aviez deviné avec l’histogramme, il y a nettement plus d’images pour les labels 22, 32, 38 et 61. Le graphique le confirme : 375 occurrences pour 22, 316 pour 32, 285 pour 38 et 282 pour 61.
Une question intéressante est de savoir s’il existe un lien entre ces instances — peut‑être sont‑elles toutes des panneaux d’indication ?
Regardons de plus près : les labels 22 et 32 sont des panneaux d’interdiction, tandis que 38 et 61 sont respectivement un panneau d’indication et un panneau de priorité. Pas de lien évident entre ces quatre‑là, si ce n’est que la moitié des panneaux très présents sont des interdictions.

Après une exploration approfondie, il est temps de mettre les mains dans le cambouis ! Récapitulons brièvement pour ne rien oublier lors de la manipulation :
Maintenant que les axes d’amélioration sont clairs, vous pouvez préparer les données pour les injecter dans le réseau de neurones (ou tout autre modèle). Commençons par extraire quelques caractéristiques : vous allez redimensionner les images et convertir celles du tableau images en niveaux de gris. Cette conversion est pertinente ici car la couleur compte moins pour une tâche de classification comme la nôtre. Pour la détection, en revanche, la couleur joue souvent un rôle important !
Pour traiter les tailles différentes, vous allez redimensionner les images. La bibliothèque skimage (Scikit‑Image), une collection d’algorithmes de traitement d’images, fera l’affaire.
Ici, le module transform vous sera utile, avec sa fonction resize() ; vous l’utilisez dans une compréhension de liste (encore !) pour redimensionner chaque image en 28 × 28 pixels. Concrètement : pour chaque image du tableau images, vous appliquez la transformation de skimage. Enfin, vous stockez le résultat dans images28 :
# Import the `transform` module from `skimage`
from skimage import transform

# Rescale the images in the `images` array
images28 = [transform.resize(image, (28, 28)) for image in images]
Plutôt simple, n’est‑ce pas ?
Remarque : les images sont maintenant en 4D : si vous convertissez images28 en tableau et affichez son attribut shape, vous verrez (4575, 28, 28, 3). Les images sont de dimension 784 (28 × 28 pixels).
Vérifiez le résultat du redimensionnement en réutilisant le code qui affichait 4 images aléatoires via traffic_signs. N’oubliez pas de remplacer images par images28.
Voici le résultat :
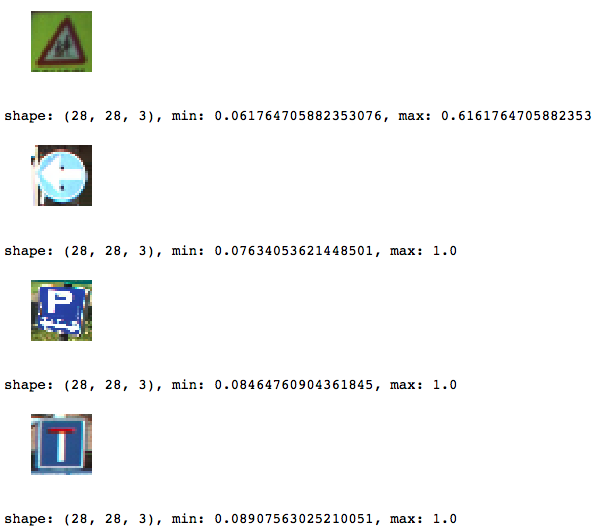
Remarque : comme vous avez redimensionné, vos valeurs min et max ont aussi changé ; elles semblent désormais dans les mêmes plages, ce qui est très positif : vous n’aurez pas forcément besoin de normaliser vos données.
Comme indiqué au début de cette section, la couleur compte moins pour notre objectif de classification. Vous allez donc convertir les images en niveaux de gris.
Remarque : vous pouvez évidemment tester ce qui se passe si vous sautez cette étape.
Comme pour le redimensionnement, comptez sur Scikit‑Image : cette fois, le module color et sa fonction rgb2gray().
C’est simple et rapide !
N’oubliez pas de reconvertir images28 en tableau, car rgb2gray() attend un tableau en argument.
# Import `rgb2gray` from `skimage.color`
from skimage.color import rgb2gray

# Convert `images28` to an array
images28 = np.array(images28)

# Convert `images28` to grayscale
images28 = rgb2gray(images28)
Vérifiez le résultat en traçant quelques images : vous pouvez réutiliser et adapter légèrement le code pour afficher les images ajustées :
import matplotlib.pyplot as plt

traffic_signs = [300, 2250, 3650, 4000]

for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images28[traffic_signs[i]], cmap="gray")
    plt.subplots_adjust(wspace=0.5)

# Show the plot
plt.show()
Remarque : vous devez effectivement préciser la carte de couleurs cmap à "gray" pour un affichage en niveaux de gris. Par défaut, imshow() utilise une palette type « heatmap ». Plus d’infos ici.

Astuce : puisque vous avez beaucoup réutilisé cette logique, envisagez d’en faire une fonction :)
Ces deux étapes sont très basiques ; d’autres opérations possibles incluent l’augmentation de données (rotation, flou, translation, modification de la luminosité, …). Vous pouvez aussi construire un pipeline complet de transformations et y faire passer vos images.
Maintenant que vous avez exploré et préparé les données, il est temps de construire l’architecture de votre réseau de neurones avec TensorFlow !
Comme avec Keras, vous allez bâtir votre réseau couche par couche.
Si ce n’est déjà fait, importez tensorflow sous l’alias tf. Initialisez ensuite le graphe avec Graph(). Cette fonction sert à définir le calcul. Remarque : le graphe ne calcule rien en soi ; il ne contient pas de valeurs, il ne fait que définir les opérations à exécuter plus tard.
Ici, vous définissez un contexte par défaut via as_default(), qui renvoie un gestionnaire de contexte rendant ce graphe spécifique « par défaut ». Utilisez cette méthode si vous souhaitez créer plusieurs graphes dans un même processus : sans graphe explicite, toutes les opérations seront ajoutées au graphe par défaut.
Vous êtes prêt à ajouter des opérations au graphe. Comme avec Keras, vous construisez le modèle, puis vous définissez fonction de perte, optimiseur et métrique. Avec TensorFlow « pur », cela se fait en une étape :
run() !flatten(), qui donne un tableau de forme [None, 784] au lieu de [None, 28, 28], la forme des images en niveaux de gris.[None, 62]. Les logits sont les sorties non mises à l’échelle des couches précédentes, exploitées sur une échelle linéaire.sparse_softmax_cross_entropy_with_logits()reduce_mean(), qui calcule la moyenne des éléments d’un tenseur.0.001.# Import `tensorflow`
import tensorflow as tf
# Initialize placeholders
x = tf.placeholder(dtype = tf.float32, shape = [None, 28, 28])
y = tf.placeholder(dtype = tf.int32, shape = [None])
# Flatten the input data
images_flat = tf.contrib.layers.flatten(x)
# Fully connected layer
logits = tf.contrib.layers.fully_connected(images_flat, 62, tf.nn.relu)
# Define a loss function
loss = tf.reduce_mean(tf.nn.sparse_softmax_cross_entropy_with_logits(labels = y,
logits = logits))
# Define an optimizer
train_op = tf.train.AdamOptimizer(learning_rate=0.001).minimize(loss)
# Convert logits to label indexes
correct_pred = tf.argmax(logits, 1)
# Define an accuracy metric
accuracy = tf.reduce_mean(tf.cast(correct_pred, tf.float32))Vous venez de créer votre premier réseau de neurones avec TensorFlow !
Si vous le souhaitez, affichez les valeurs (ou représentations) de la plupart des variables pour un rapide récapitulatif :
print("images_flat: ", images_flat)
print("logits: ", logits)
print("loss: ", loss)
print("predicted_labels: ", correct_pred)
Astuce : si vous voyez une erreur du type « module 'pandas' has no attribute 'computation' », envisagez de mettre à jour dask avec pip install --upgrade dask. Voir ce post StackOverflow.
Le modèle est prêt : exécutons‑le ! Pour cela, initialisez d’abord une session via Session() à laquelle vous pouvez passer votre graph défini précédemment. Ensuite, exécutez la session avec run() en lui passant les opérations initialisées sous la forme de la variable init définie plus haut.
Utilisez ensuite cette session initialisée pour lancer des époques (boucles d’entraînement). Ici, vous en prenez 201 pour pouvoir journaliser la dernière loss_value ; dans la boucle, vous exécutez l’optimiseur d’entraînement et la métrique de perte (ou de précision) définis précédemment. Vous passez aussi un argument feed_dict, avec lequel vous alimentez le modèle. Toutes les 10 époques, un log vous donne des informations sur la perte.
Comme vu plus haut, pas besoin de fermer manuellement la session ; c’est fait pour vous. Toutefois, si vous testez une autre configuration, vous devrez probablement le faire avec sess.close() si votre session s’appelle sess, comme ci‑dessous :
tf.set_random_seed(1234)
sess = tf.Session()

sess.run(tf.global_variables_initializer())

for i in range(201):
        print('EPOCH', i)
        _, accuracy_val = sess.run([train_op, accuracy], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
            print("Loss: ", loss)
        print('DONE WITH EPOCH')
Rappel : vous pouvez aussi exécuter le code suivant, qui fermera la session immédiatement après, comme vu en introduction :
tf.set_random_seed(1234)

with tf.Session() as sess:
    sess.run(tf.global_variables_initializer())
    for i in range(201):
        _, loss_value = sess.run([train_op, loss], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
            print("Loss: ", loss)
Remarque : vous utilisez global_variables_initializer() car initialize_all_variables() est obsolète.
Votre modèle est maintenant entraîné ! Pas si compliqué, n’est‑ce pas ?
Ce n’est pas tout à fait fini : il faut encore évaluer votre réseau. Vous pouvez d’abord avoir un aperçu rapide des performances en sélectionnant 10 images aléatoires et en comparant les labels prédits aux labels réels.
Vous pouvez les imprimer, mais pourquoi ne pas utiliser matplotlib pour afficher les panneaux et comparer visuellement ?
 # Import `matplotlib`
import matplotlib.pyplot as plt
import random

# Pick 10 random images
sample_indexes = random.sample(range(len(images28)), 10)
sample_images = [images28[i] for i in sample_indexes]
sample_labels = [labels[i] for i in sample_indexes]

# Run the "correct_pred" operation
predicted = sess.run([correct_pred], feed_dict={x: sample_images})[0]

# Print the real and predicted labels
print(sample_labels)
print(predicted)

# Display the predictions and the ground truth visually.
fig = plt.figure(figsize=(10, 10))
for i in range(len(sample_images)):
    truth = sample_labels[i]
    prediction = predicted[i]
    plt.subplot(5, 2,1+i)
    plt.axis('off')
    color='green' if truth == prediction else 'red'
    plt.text(40, 10, "Truth:        {0}\nPrediction: {1}".format(truth, prediction),
             fontsize=12, color=color)
    plt.imshow(sample_images[i],  cmap="gray")

plt.show()
Cependant, observer uniquement des images aléatoires n’apporte pas une vision globale des performances. Chargeons donc les données de test.
Remarque : on réutilise ici la fonction load_data() définie au début du tutoriel.
# Import `skimage`
from skimage import transform

# Load the test data
test_images, test_labels = load_data(test_data_directory)

# Transform the images to 28 by 28 pixels
test_images28 = [transform.resize(image, (28, 28)) for image in test_images]

# Convert to grayscale
from skimage.color import rgb2gray
test_images28 = rgb2gray(np.array(test_images28))

# Run predictions against the full test set.
predicted = sess.run([correct_pred], feed_dict={x: test_images28})[0]

# Calculate correct matches
match_count = sum([int(y == y_) for y, y_ in zip(test_labels, predicted)])

# Calculate the accuracy
accuracy = match_count / len(test_labels)

# Print the accuracy
print("Accuracy: {:.3f}".format(accuracy))
Rappel : pensez à fermer la session avec sess.close() si vous n’avez pas utilisé with tf.Session() as sess: pour la lancer.
Si vous souhaitez poursuivre avec ce dataset et le modèle construit ici, essayez :
Pensez à consulter le livre Machine Learning With TensorFlow de Nishant Shukla.
Astuce : jetez aussi un œil au TensorFlow Playground et à TensorBoard.
Si vous souhaitez continuer à travailler sur des images, découvrez le tutoriel scikit‑learn de DataCamp, qui traite le dataset MNIST avec PCA, K‑means et les machines à vecteurs de support (SVM). Ou explorez d’autres tutoriels comme celui‑ci utilisant le dataset des panneaux belges.
Approfondissez Python et l’apprentissage profond
Cours
Cours
Cours