Kurs
Einführung in TensorFlow mit Python
4 Std.
56.5K
Deep Learning ist ein Teilgebiet des Machine Learning und umfasst Algorithmen, die von Struktur und Funktion des Gehirns inspiriert sind.
TensorFlow ist das zweite Machine-Learning-Framework, das Google entwickelt hat, um Deep-Learning-Modelle zu entwerfen, zu bauen und zu trainieren. Mit der TensorFlow-Bibliothek kannst du numerische Berechnungen durchführen – an sich nichts Außergewöhnliches –, aber diese Berechnungen laufen in Datenflussgraphen. In diesen Graphen stehen Knoten für mathematische Operationen, während die Kanten die Daten repräsentieren, meist mehrdimensionale Arrays – sogenannte Tensors –, die zwischen den Knoten fließen.
Siehst du? Der Name „TensorFlow“ leitet sich von den Operationen ab, die neuronale Netze auf mehrdimensionalen Datenarrays, also Tensors, ausführen – es ist buchstäblich ein Fluss von Tensors. Fürs Erste reicht dieses Wissen, mehr zu Tensors folgt gleich!
Das heutige TensorFlow-Tutorial für Einsteiger führt dich interaktiv in Deep Learning ein:
Lade das Notebook zu diesem Tutorial hier herunter.
Interessant für dich sind vielleicht auch der Kurs Deep Learning in Python, DataCamps Keras-Tutorial oder das Keras-mit-R-Tutorial.
Um Tensors gut zu verstehen, hilft Basiswissen in Linearer Algebra und Vektorrechnung. Du hast in der Einführung gelesen, dass Tensors in TensorFlow als mehrdimensionale Datenarrays umgesetzt sind. Ein wenig mehr Kontext ist nützlich, um Tensors und ihren Einsatz im Machine Learning wirklich zu begreifen.
Bevor wir in Ebenenvektoren einsteigen, ein kurzer Blick auf das Konzept „Vektor“: Vektoren sind spezielle Matrizen, also rechteckige Anordnungen von Zahlen. Weil Vektoren geordnete Zahlensammlungen sind, werden sie oft als Spaltenmatrizen dargestellt: eine Spalte, mehrere Zeilen. Anders formuliert: Du kannst Vektoren auch als Skalare mit einer Richtung betrachten.
Merke: Ein Skalar ist zum Beispiel „5 Meter“ oder „60 m/s“, während ein Vektor etwa „5 Meter nach Norden“ oder „60 m/s nach Osten“ ist. Der offensichtliche Unterschied: Der Vektor hat eine Richtung. Diese Beispiele wirken vielleicht weit weg von den Vektoren, die dir in Machine-Learning-Aufgaben begegnen. Das ist normal. Die Länge eines mathematischen Vektors ist eine absolute Zahl. Die Richtung hingegen ist relativ: Sie wird relativ zu einer Referenzrichtung in Radiant oder Grad gemessen. Üblicherweise nimmst du an, dass die Richtung positiv ist und gegen den Uhrzeigersinn von der Referenzrichtung gemessen wird.
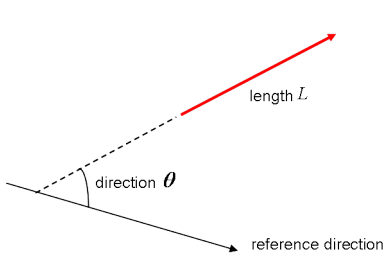
Visuell stellst du Vektoren als Pfeile dar, wie im Bild oben. Der Pfeilkopf zeigt die Richtung an, die Pfeillänge die Länge.
Und was sind nun Ebenenvektoren?
Ebenenvektoren sind die naheliegendste Ausprägung von Tensors. Sie ähneln den gerade beschriebenen Vektoren, mit dem Unterschied, dass sie in einem Vektorraum liegen. Ein Beispiel: Du hast einen Vektor der Form 2 × 1. Er gehört damit zur Menge der reellen Zahlen, die paarweise auftreten – also zum zweidimensionalen Raum. Solche Vektoren kannst du als Pfeile im Koordinatensystem (x,y) darstellen.
Im Standardfall legst du den Fußpunkt eines Vektors in den Ursprung (0,0). Die x-Koordinate liest du aus der ersten Zeile des Vektors, die y-Koordinate aus der zweiten. Natürlich muss die Standardposition nicht immer gelten: Vektoren können sich parallel zu sich selbst verschieben, ohne sich zu ändern.
Hinweis: Für Vektoren der Größe 3 × 1 sprichst du vom dreidimensionalen Raum. Du kannst sie als 3D-Figuren auf den Achsen x, y und z darstellen.
Damit du mit Vektoren rechnen kannst, ist es hilfreich, sie über Basen bzw. Einheitsvektoren auszudrücken.
Einheitsvektoren haben die Länge eins. Man erkennt sie häufig an einem Kleinbuchstaben mit „Hütchen“. Sie sind praktisch, wenn du einen 2D- oder 3D-Vektor als Summe von zwei bzw. drei orthogonalen Komponenten (x- und y-Achse bzw. z-Achse) darstellen willst.
Sprichst du davon, einen Vektor als Summe von Komponenten auszudrücken, geht es um Komponentenvektoren: zwei oder mehr Vektoren, deren Summe den gegebenen Vektor ergibt.
Tipp: Schau dir dieses Video an – eine einfache Erklärung von Tensors mit Haushaltsgegenständen!
Neben Ebenenvektoren gehören auch Kovektoren und lineare Operatoren zu den Fällen, die eines gemeinsam haben: Alle drei sind spezielle Formen von Tensors. Vektoren hast du eben als Skalare mit Richtung kennengelernt. Ein Tensor ist die mathematische Darstellung einer physikalischen Größe, die durch einen Betrag und mehrere Richtungen charakterisiert sein kann.
So wie du einen Skalar durch eine einzelne Zahl und einen Vektor in 3D z. B. durch eine Folge von drei Zahlen darstellst, kannst du einen Tensor in einem 3D-Raum durch ein Array aus 3^R Zahlen darstellen.
Das „R“ steht für den Rang des Tensors: In einem dreidimensionalen Raum lässt sich ein Tensor zweiten Rangs durch 3 hoch 2, also 9 Zahlen beschreiben. In einem N-dimensionalen Raum brauchst du für Skalare weiterhin eine Zahl, für Vektoren N Zahlen und für Tensors N^R Zahlen. Daher nennt man Skalare auch Tensors vom Rang 0: Ohne Richtung reichen sie mit einer Zahl.
Damit ist es leicht, Skalare, Vektoren und Tensors zu unterscheiden: Ein Skalar ist eine Zahl, ein Vektor eine geordnete Menge von Zahlen, ein Tensor ein Zahlenarray.
Das Besondere an Tensors ist das Zusammenspiel aus Komponenten und Basisvektoren: Basisvektoren transformieren sich zwischen Bezugssystemen auf eine bestimmte Weise, und die Komponenten transformieren komplementär dazu, sodass die Kombination erhalten bleibt.
Jetzt, wo du mehr über TensorFlow weißt, wird es Zeit für die Installation. TensorFlow bietet APIs für Python, C++, Haskell, Java, Go, Rust und ein Community-Paket für R namens tensorflow.
Tipp: Wenn du mehr über Deep-Learning-Pakete in R wissen möchtest, schau dir DataCamps Keras: Deep Learning in R Tutorial an.
In diesem Tutorial lädst du eine TensorFlow-Version, mit der du dein Deep-Learning-Projekt in Python umsetzt. Auf der TensorFlow-Installationsseite findest du gängige Wege und aktuelle Anleitungen zur Installation mit virtualenv, pip, Docker und weitere Optionen für die Installation auf deinem Rechner.
Hinweis Du kannst TensorFlow unter Windows auch mit Conda installieren. Da diese Installation Community-unterstützt ist, prüfe am besten die offiziellen Installationshinweise.
Nachdem die Installation durch ist, prüfst du, ob alles läuft, indem du TensorFlow unter dem Alias tf importierst:
import tensorflow as tfHinweis Der Alias aus der obigen Codezeile ist eine gängige Konvention – so bleibst du im Einklang mit anderen Entwicklerinnen und Entwicklern in Data-Science-Projekten und mit Open-Source-Projekten rund um TensorFlow.
TensorFlow-Programme schreibst du in der Regel so, dass sie als Block laufen. Das wirkt auf den ersten Blick widersprüchlich zu Python. Du kannst aber auch die Interactive Session von TensorFlow nutzen, um interaktiver zu arbeiten – besonders praktisch, wenn du IPython gewohnt bist.
In diesem Tutorial konzentrierst du dich auf die zweite Option – so kommst du schneller ins Deep Learning mit TensorFlow. Bevor es richtig losgeht, probieren wir ein kleines Beispiel.
Importiere zuerst die Bibliothek tensorflow als tf, wie eben gezeigt. Initialisiere dann zwei Variablen, die Konstanten sind. Übergebe jeweils ein Array aus vier Zahlen an die Funktion constant().
Hinweis Du könntest auch nur eine ganze Zahl übergeben, aber meist wirst du mit Arrays arbeiten. Wie in der Einführung: Bei Tensors dreht sich alles um Arrays! Nutze also ein Array :) Als Nächstes multiplizierst du die beiden Variablen mit multiply() und speicherst das Ergebnis in result. Zum Schluss gibst du result mit print() aus.
Hinweis Im DataCamp-Light-Block oben hast du Konstanten definiert. Daneben gibt es noch zwei weitere Wertetypen: Placeholders sind unzugewiesene Werte, die erst bei Ausführung der Session initialisiert werden – also Platzhalter für Tensors, die beim Lauf gefüttert werden. Außerdem gibt es Variables, also veränderliche Werte. Konstanten ändern sich – wie der Name sagt – nicht.
Das Ergebnis der Codezeilen ist ein abstrakter Tensor im Rechengraphen. Entgegen der Erwartung wird der result aber nicht berechnet – du hast nur das Modell definiert, es wurde noch kein Prozess ausgeführt. Das siehst du am Print-Out: Es gibt nicht das gewünschte Ergebnis (nämlich 30). TensorFlow bewertet also „lazy“.
Wenn du das Ergebnis sehen willst, musst du den Code in einer interaktiven Session ausführen. Das geht auf mehrere Arten, wie die folgenden DataCamp-Light-Blöcke zeigen:
Hinweis Du kannst die Session auch automatisch öffnen, result ausführen und danach wieder schließen, etwa so:
In den obigen Beispielen nutzt du eine Default-Session. Du kannst aber auch Optionen übergeben. Mit dem Argument config und dem Protokollpuffer ConfigProto fügst du Konfigurationen hinzu.
Zum Beispiel sorgt
config=tf.ConfigProto(log_device_placement=True)dafür, dass GPU- oder CPU-Zuweisungen für Operationen geloggt werden. Du siehst so, welche Geräte die Session für jede Operation nutzt. Eine weitere Option für weiche Gerätezuteilung ist:
config=tf.ConfigProto(allow_soft_placement=True)Jetzt hast du TensorFlow installiert, importiert und die Basics ausprobiert. Zeit, dich deinen Daten zu widmen. Wie immer gilt: Erst verstehen und erkunden, dann das neuronale Netz modellieren.
Auch wenn das Thema Verkehr jedem geläufig ist, lohnt sich ein kurzer Blick auf die Beobachtungen im Datensatz, um sicherzugehen, dass alles klar ist. In diesem Abschnitt baust du das nötige Domänenwissen auf, um weiterzumachen.
Und weil ich Belgier bin, gibt es ein paar Anekdoten dazu :)
Mit dem Hintergrundwissen im Gepäck lädst du den Datensatz hier herunter. Du brauchst die beiden Zip-Dateien neben „BelgiumTS for Classification (cropped images)“, genannt „BelgiumTSC_Training“ und „BelgiumTSC_Testing“.
Tipp: Schau dir nach dem Download die Ordnerstruktur an! Die Ordner für Training und Test enthalten jeweils 61 Unterordner, die den 62 Schildertypen entsprechen, die du in diesem Tutorial klassifizierst. Außerdem haben die Dateien die Endung .ppm (Portable Pixmap Format). Du hast also Bilder der Schilder geladen!
Importiere die Daten in deinen Workspace. Beginne mit dem Code unterhalb der selbst definierten Funktion (UDF) load_data():
ROOT_PATH, also den Pfad zum Verzeichnis mit Trainings- und Testdaten.join() die spezifischen Pfade zu Training und Test und speichere sie in train_data_directory und test_data_directory.load_data() mit train_data_directory auf.load_data() werden zunächst alle Unterordner von train_data_directory per Listenkomprehension gesammelt. Für jeden gefundenen Eintrag wird geprüft, ob es ein Ordner ist; falls ja, kommt er auf die Liste. Merke: Jeder Unterordner steht für ein Label.labels und images, sammelst die Pfade und Dateinamen der Bilder in den Unterordnern und fügst die Daten mit append() hinzu.def load_data(data_directory):
directories = [d for d in os.listdir(data_directory)
if os.path.isdir(os.path.join(data_directory, d))]
labels = []
images = []
for d in directories:
label_directory = os.path.join(data_directory, d)
file_names = [os.path.join(label_directory, f)
for f in os.listdir(label_directory)
if f.endswith(".ppm")]
for f in file_names:
images.append(skimage.data.imread(f))
labels.append(int(d))
return images, labels
ROOT_PATH = "/your/root/path"
train_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Training")
test_data_directory = os.path.join(ROOT_PATH, "TrafficSigns/Testing")
images, labels = load_data(train_data_directory)Hinweis Im obigen Code liegen die Trainings- und Testdaten in „Training“ und „Testing“, beides Unterordner von „TrafficSigns“. Lokal könnte das z. B. so aussehen: „/Users/Name/Downloads/TrafficSigns“ mit zwei Unterordnern „Training“ und „Testing“.
Tipp: Frische dein Wissen zu Funktionen in Python mit DataCamps Python Functions Tutorial auf.
Sind die Daten geladen, folgt die erste Inspektion! Starte mit einer einfachen Analyse über die Attribute ndim und size des images-Arrays:
Beachte: images und labels sind Listen. In deinem Workspace musst du sie eventuell mit np.array() in Arrays umwandeln. Hier ist das bereits erledigt!
Hinweis images[0] ist tatsächlich ein einzelnes Bild, dargestellt als Arrays in Arrays! Das wirkt anfangs ungewohnt, ist aber Standard bei Bilddaten im ML/DL-Kontext.
Als Nächstes schaust du dir kurz die labels an – keine großen Überraschungen zu erwarten:
Diese Zahlen geben dir ein erstes Gefühl für Größe und Importerfolg. Auf den ersten Blick passt alles – und die Größe ist beachtlich, bedenkt man die geschachtelten Arrays.
Tipp Hänge testweise die Attribute flags, itemsize und nbytes an, um mehr über Speicherlayout, Länge eines Elements in Bytes und gesamten Speicherverbrauch zu erfahren.
Untersuche nun die Verteilung der Verkehrsschilder:
Stark! Schauen wir uns das Histogramm genauer an.

Auf den ersten Blick stechen die Labels 22, 32, 38 und 61 hervor. Behalte das im Hinterkopf – im nächsten Abschnitt vertiefen wir das.
Die bisherigen Checks geben dir ein Gefühl für die Daten. Wenn deine Daten aus Bildern bestehen, solltest du sie unbedingt visualisieren.
Schauen wir uns ein paar zufällige Schilder an:
pyplot aus matplotlib als plt.images-Array auszuwählen: hier 300, 2250, 3650, 4000.i. Im ersten Durchlauf 300, im zweiten 2250 usw. Passe den Abstand zwischen den Subplots an.show() auf.So geht’s:
# Import the `pyplot` module of `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images that you want to see
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images that you defined
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)

plt.show()
Wie du an den 62 Labels schon vermutest: Die Schilder unterscheiden sich deutlich.
Was fällt noch auf? Schau dir die Bilder unten genau an:

Die vier Bilder haben nicht dieselbe Größe!
Du kannst mit den Indizes in traffic_signs spielen und das genauer prüfen. Wichtig ist: Diese Beobachtung musst du bei der Datenaufbereitung berücksichtigen, bevor du das Netz fütterst.
Bestätigen wir die Hypothese mit Shape sowie Minimal- und Maximalwerten der gezeigten Bilder.
Der folgende Code ähnelt dem vorherigen, gibt aber zusätzlich Maße und Werte aus:
# Import `matplotlib`
import matplotlib.pyplot as plt

# Determine the (random) indexes of the images
traffic_signs = [300, 2250, 3650, 4000]

# Fill out the subplots with the random images and add shape, min and max values
for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images[traffic_signs[i]])
    plt.subplots_adjust(wspace=0.5)
    plt.show()
    print("shape: {0}, min: {1}, max: {2}".format(images[traffic_signs[i]].shape,
                                                  images[traffic_signs[i]].min(),
                                                  images[traffic_signs[i]].max()))
Hinweis Du nutzt die format()-Methode auf dem String "shape: {0}, min: {1}, max: {2}", um die Argumente {0}, {1} und {2} zu füllen.

Nachdem du einzelne Bilder gesehen hast, lohnt sich ein Blick zurück aufs Histogramm: Erzeuge eine Übersicht über alle 62 Klassen mit je einem Beispielbild:
# Import the `pyplot` module as `plt`
import matplotlib.pyplot as plt

# Get the unique labels
unique_labels = set(labels)

# Initialize the figure
plt.figure(figsize=(15, 15))

# Set a counter
i = 1

# For each unique label,
for label in unique_labels:
    # You pick the first image for each label
    image = images[labels.index(label)]
    # Define 64 subplots
    plt.subplot(8, 8, i)
    # Don't include axes
    plt.axis('off')
    # Add a title to each subplot
    plt.title("Label {0} ({1})".format(label, labels.count(label)))
    # Add 1 to the counter
    i += 1
    # And you plot this first image
    plt.imshow(image)

# Show the plot
plt.show()
Hinweis Auch wenn du 64 Subplots definierst, werden nicht alle gefüllt (es gibt nur 62 Labels!). Und erneut: Keine Achsen, damit der Fokus auf den Schildern bleibt.

Wie schon im Histogramm vermutet, gibt es deutlich mehr Schilder mit den Labels 22, 32, 38 und 61: 375-mal Label 22, 316-mal Label 32, 285-mal Label 38 und 282-mal Label 61.
Spannende Frage: Gibt es eine Verbindung zwischen diesen Instanzen – etwa, dass sie alle Hinweisschilder sind?
Der genauere Blick zeigt: 22 und 32 sind Verbotschilder, 38 ist ein Hinweisschild und 61 ein Vorrangzeichen. Eine direkte Verbindung besteht also nicht – abgesehen davon, dass die Hälfte der häufigen Schilder Verbote sind.

Nachdem du die Daten gründlich erkundet hast, geht’s an die Aufbereitung. Kurz die wichtigsten Erkenntnisse, damit nichts untergeht:
Jetzt passt du die Daten so an, dass sie vom neuronalen Netz (oder einem anderen Modell) verarbeitet werden können. Wir starten mit der Feature-Extraktion: Du skalierst die Bilder um und wandelst sie in Graustufen um. Letzteres, weil die Farbe für diese Klassifikationsaufgabe weniger wichtig ist. Für Objekterkennung spielt Farbe dagegen oft eine große Rolle – dann würdest du nicht in Graustufen konvertieren.
Um die unterschiedlichen Bildgrößen zu vereinheitlichen, skalierst du sie – am einfachsten mit skimage (Scikit-Image), einer Sammlung von Bildverarbeitungsalgorithmen.
Das Modul transform bietet die Funktion resize(). Per Listenkomprehension skalierst du jedes Bild auf 28 × 28 Pixel und speicherst das Ergebnis in images28:
# Import the `transform` module from `skimage`
from skimage import transform

# Rescale the images in the `images` array
images28 = [transform.resize(image, (28, 28)) for image in images]
Gar nicht so schwer, oder?
Hinweis Die Bilder sind nun vierdimensional: Wenn du images28 in ein Array wandelst und shape ausgibst, siehst du (4575, 28, 28, 3). Jedes Bild hat 784 Pixel (28 × 28).
Prüfe das Ergebnis, indem du den Code zur Anzeige der 4 zufälligen Bilder erneut nutzt – ersetze nur images durch images28.
So sieht das aus:
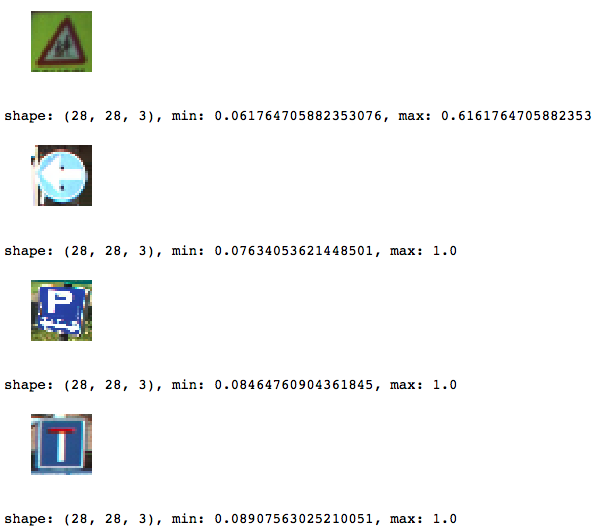
Hinweis Durch das Skalieren haben sich min- und max-Werte angeglichen. Das ist praktisch – eine zusätzliche Normalisierung ist ggf. nicht nötig.
Wie eingangs erwähnt, ist Farbe hier weniger wichtig. Daher wandelst du die Bilder in Graustufen um.
Hinweis Du kannst natürlich testen, wie sich das Weglassen dieses Schritts auf das Endergebnis auswirkt.
Auch hier hilft Scikit-Image: Aus dem Modul color nutzt du rgb2gray().
Wichtig: Wandle images28 vorher in ein Array um – rgb2gray() erwartet ein Array als Argument.
# Import `rgb2gray` from `skimage.color`
from skimage.color import rgb2gray

# Convert `images28` to an array
images28 = np.array(images28)

# Convert `images28` to grayscale
images28 = rgb2gray(images28)
Prüfe das Ergebnis, indem du einige Bilder erneut plottest – diesmal mit leichten Anpassungen:
import matplotlib.pyplot as plt

traffic_signs = [300, 2250, 3650, 4000]

for i in range(len(traffic_signs)):
    plt.subplot(1, 4, i+1)
    plt.axis('off')
    plt.imshow(images28[traffic_signs[i]], cmap="gray")
    plt.subplots_adjust(wspace=0.5)

# Show the plot
plt.show()
Hinweis Gib die Colormap cmap explizit als "gray" an, damit imshow() die Bilder nicht im Standard-Heatmap-Stil darstellt. Mehr dazu hier.

Tipp: Weil du diese Visualisierungslogik mehrfach nutzt, lohnt sich eine kleine Hilfsfunktion :)
Diese beiden Schritte sind sehr grundlegend. Weitere Optionen wären Data Augmentation (Drehen, Weichzeichnen, Verschieben, Helligkeit ändern, …). Du könntest auch eine komplette Pipeline von Verarbeitungsschritten aufsetzen.
Jetzt, da die Daten vorbereitet sind, baust du die Architektur deines neuronalen Netzes mit TensorFlow auf.
Ähnlich wie mit Keras baust du das Netz Schicht für Schicht.
Falls noch nicht geschehen, importiere tensorflow als tf. Initialisiere dann den Graphen mit Graph(). Damit definierst du die Berechnung. Hinweis Ein Graph rechnet nichts aus und hält keine Werte – er definiert nur die Operationen, die später ausgeführt werden.
Mit as_default() setzt du einen Standardkontext und machst diesen Graphen zum Default-Graphen. Das ist hilfreich, wenn du mehrere Graphen im gleichen Prozess brauchst.
Jetzt fügst du Operationen hinzu. Aus Keras kennst du das Muster: Modell bauen und beim Kompilieren Loss, Optimizer und Metrik festlegen. In TensorFlow passiert das in einem Schritt:
run() bzw. feed_dict.flatten() von [None, 28, 28] auf [None, 784] (Form der Graustufenbilder).[None, 62] erzeugt. Logits sind die unskalierten Ausgaben, auf deren relativer Skala weitere Funktionen arbeiten.sparse_softmax_cross_entropy_with_logits()reduce_mean(), um über die Dimensionen zu mitteln.0.001.# Import `tensorflow`
import tensorflow as tf
# Initialize placeholders
x = tf.placeholder(dtype = tf.float32, shape = [None, 28, 28])
y = tf.placeholder(dtype = tf.int32, shape = [None])
# Flatten the input data
images_flat = tf.contrib.layers.flatten(x)
# Fully connected layer
logits = tf.contrib.layers.fully_connected(images_flat, 62, tf.nn.relu)
# Define a loss function
loss = tf.reduce_mean(tf.nn.sparse_softmax_cross_entropy_with_logits(labels = y,
logits = logits))
# Define an optimizer
train_op = tf.train.AdamOptimizer(learning_rate=0.001).minimize(loss)
# Convert logits to label indexes
correct_pred = tf.argmax(logits, 1)
# Define an accuracy metric
accuracy = tf.reduce_mean(tf.cast(correct_pred, tf.float32))Damit hast du dein erstes neuronales Netz mit TensorFlow definiert!
Wenn du magst, gib Werte (bzw. Tensor-Objekte) aus, um einen schnellen Überblick zu bekommen:
print("images_flat: ", images_flat)
print("logits: ", logits)
print("loss: ", loss)
print("predicted_labels: ", correct_pred)Tipp: Falls ein Fehler wie „module 'pandas' has no attribute 'computation'“ auftaucht, aktualisiere dask mit pip install --upgrade dask. Mehr dazu in diesem StackOverflow-Post.
Jetzt wird das Modell tatsächlich trainiert. Lege zuerst eine Session mit Session() an. Dann startest du sie mit run() und übergibst die initialisierten Operationen (z. B. in init).
Nun beginnst du mit Epochen bzw. Trainingsschleifen. Hier wählst du 201 Iterationen, damit der letzte loss_value geloggt wird. In der Schleife führst du Optimizer und Loss (oder Accuracy) aus und übergibst Daten per feed_dict. Alle 10 Epochen wird geloggt.
Wie in den Basics gezeigt, musst du die Session nicht zwingend manuell schließen; willst du eine andere Variante testen, schließt du mit sess.close(), wenn die Session sess heißt, wie unten:
tf.set_random_seed(1234)
sess = tf.Session()

sess.run(tf.global_variables_initializer())

for i in range(201):
        print('EPOCH', i)
        _, accuracy_val = sess.run([train_op, accuracy], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
            print("Loss: ", loss)
        print('DONE WITH EPOCH')
Merke Du kannst auch die folgende Variante nutzen – sie schließt die Session automatisch, wie schon oben gesehen:
tf.set_random_seed(1234)

with tf.Session() as sess:
    sess.run(tf.global_variables_initializer())
    for i in range(201):
        _, loss_value = sess.run([train_op, loss], feed_dict={x: images28, y: labels})
        if i % 10 == 0:
            print("Loss: ", loss)
Hinweis Du nutzt global_variables_initializer(), weil initialize_all_variables() veraltet ist.
Damit hast du dein Modell trainiert. Gar nicht so schwer, oder?
Noch bist du nicht ganz fertig. Evaluieren wir das Netz. Für einen ersten Eindruck wählst du 10 zufällige Bilder und vergleichst Vorhersagen mit den echten Labels.
Du kannst die Labels ausgeben – oder gleich mit matplotlib die Schilder samt Vorhersagen visualisieren:
 # Import `matplotlib`
import matplotlib.pyplot as plt
import random

# Pick 10 random images
sample_indexes = random.sample(range(len(images28)), 10)
sample_images = [images28[i] for i in sample_indexes]
sample_labels = [labels[i] for i in sample_indexes]

# Run the "correct_pred" operation
predicted = sess.run([correct_pred], feed_dict={x: sample_images})[0]

# Print the real and predicted labels
print(sample_labels)
print(predicted)

# Display the predictions and the ground truth visually.
fig = plt.figure(figsize=(10, 10))
for i in range(len(sample_images)):
    truth = sample_labels[i]
    prediction = predicted[i]
    plt.subplot(5, 2,1+i)
    plt.axis('off')
    color='green' if truth == prediction else 'red'
    plt.text(40, 10, "Truth:        {0}\nPrediction: {1}".format(truth, prediction),
             fontsize=12, color=color)
    plt.imshow(sample_images[i],  cmap="gray")

plt.show()
Nur zufällige Bilder anzuschauen, liefert jedoch wenig Aussage über die Gesamtleistung. Daher lädst du nun die Testdaten.
Hinweis Du verwendest wieder die Funktion load_data() vom Anfang des Tutorials.
# Import `skimage`
from skimage import transform

# Load the test data
test_images, test_labels = load_data(test_data_directory)

# Transform the images to 28 by 28 pixels
test_images28 = [transform.resize(image, (28, 28)) for image in test_images]

# Convert to grayscale
from skimage.color import rgb2gray
test_images28 = rgb2gray(np.array(test_images28))

# Run predictions against the full test set.
predicted = sess.run([correct_pred], feed_dict={x: test_images28})[0]

# Calculate correct matches
match_count = sum([int(y == y_) for y, y_ in zip(test_labels, predicted)])

# Calculate the accuracy
accuracy = match_count / len(test_labels)

# Print the accuracy
print("Accuracy: {:.3f}".format(accuracy))
Merke Schließe die Session mit sess.close(), falls du nicht die Variante with tf.Session() as sess: genutzt hast.
Wenn du mit diesem Datensatz und dem Modell aus dem Tutorial weitermachen willst, probiere Folgendes:
Sieh dir das Buch Machine Learning With TensorFlow von Nishant Shukla an.
Tipp Schau dir auch den TensorFlow Playground und das TensorBoard an.
Wenn du mit Bildern weitermachen willst, schau dir DataCamps scikit-learn-Tutorial an – dort wird der MNIST-Datensatz mit PCA, K-Means und Support Vector Machines (SVMs) bearbeitet. Oder sieh dir dieses Tutorial zum belgischen Verkehrsschilder-Datensatz an.
Mehr über Python und Deep Learning lernen
Kurs
Kurs
Kurs