Curs
Lucrul cu Hugging Face
2 ore
40K
Practică și urmărește-ți progresul.
Continuă Cu GoogleLaboratoarele cu greutăți deschise au petrecut 2026 micșorând decalajul față de Anthropic și OpenAI la coding, iar Moonshot AI tocmai l-a redus din nou. Vinerea trecută, Moonshot a lansat Kimi K3.1 Pro, pe care îl numește cel mai capabil model open-weight din clasa 3T de până acum, și îl situează la un punct de Claude Opus 5.5 la coding agentic.
K3.1 Pro este o versiune puternic post-antrenată a lui Kimi K3, cu o fereastră de context de 1 milion de tokeni. Vine împreună cu o variantă mai rapidă, K3.1 Pro Highspeed, și este disponibil azi în aplicațiile Kimi, Kimi Code și Kimi API. Greutățile complete vor urma până pe 4 noiembrie 2026.
În acest articol, îți prezint tot ce e nou la Kimi K3.1 Pro: funcțiile noi, benchmarkurile și cum se compară prețurile cu Kimi K3. Ca să te pui la curent cu modelul pe care se bazează, vezi ghidurile noastre pentru Kimi K3 și tutorialul practic Kimi K3.
Kimi K3.1 Pro este modelul de limbaj de mari dimensiuni (LLM) vârf de gamă al Moonshot AI și primul model din noua serie K3.1. Păstrează baza lui Kimi K3, un model cu 2,8T parametri și o fereastră de context de 1M tokeni, și adaugă mult mai multă putere de post-antrenare peste.
Schimbarea este în antrenament, nu în arhitectură: Moonshot a rulat învățare prin întărire (RL) comună pe ceea ce numește „sute de domenii downstream” și și-a reconstruit cadrul RL, infrastructura de sandbox și programarea rollout-urilor astfel încât calculul suplimentar să producă câștiguri constante. Rezultatul, potrivit Moonshot, este îmbunătățire în toate domeniile măsurate, cu accent pe coding, creare 3D și cercetare financiară.
Afirmația principală este paritatea la coding agentic cu cele mai bune modele proprietare. Tabelul Moonshot îl plasează pe K3.1 Pro la un punct de Claude Opus 5.5 la sarcini de coding în terminal, în timp ce percepe o fracțiune din prețul Anthropic. Modelul este open-weight, dar greutățile nu sunt încă publice.
K3.1 Pro este un upgrade amplu, nu un singur truc nou. Următoarele patru capabilități sunt cele pentru care chiar mi-aș schimba fluxul de lucru.
K3.1 Pro poate rămâne pe o sarcină de coding lungă, în mai mulți pași, diagnosticându-și singur eșecurile în loc să încerce doar din nou. Demonstrația Moonshot este un simulator de mers uman construit pe modelul anatomic open-source human-atlas, cu 296 componente scheletice și 402 componente musculare.
Pe parcursul a 167 de misiuni și 420 de revizuiri independente, modelul a trecut de la un om simulat care se prăbușea în câteva secunde la mers cu pași alternanți timp de 11,2 secunde. Partea interesantă a venit când modelarea recompensei a încetat să mai ajute mișcarea brațului: K3.1 Pro a rulat probe open-loop ale simulatorului, a găsit 36 de erori în calculele momentului brațelor musculare ale umărului, le-a corectat și a reantrenat.
Asta este o singură demonstrație internă, așa că ia-o ca pe o ilustrare a cazului de utilizare intenționat, nu ca pe o dovadă. Totuși, arată pentru ce optimizează Moonshot: agenți care investighează și reiterează.
Moonshot spune că K3.1 Pro produce pagini front-end, scene Three.js și asseturi 3D cu „compoziție, tipografie, animație și finisaj mai solide.” Lucrează cu Unity, Unreal Engine și Godot și le poate combina cu căutare web și generare 3D pentru a asambla un proiect complet.
Pe partea de modelare, K3.1 Pro scrie și rulează direct scripturi pentru Blender și software CAD, fără conectori MCP, pentru a construi modele parametrice precum piese mecanice, modele arhitecturale și mobilier configurabil. Moonshot a lansat, de asemenea, 3D Make pe kimi.ai și în aplicația Kimi, unde poți previzualiza, edita și descărca modele gata de tipărire 3D.
Afirmația despre calitatea vizuală este și cea mai greu de verificat printr-un tabel de benchmarkuri, așa că tratează demo-urile Moonshot ca pe cele mai bune exemple ale vânzătorului, nu ca pe rezultatul tipic.
K3.1 Pro poate duce un flux financiar de la screening la un workbook finalizat, iar Moonshot a făcut corecții țintite la acuratețea factuală pentru acest tip de muncă. Pe benchmarkurile sale interne de finanțe, K3.1 Pro îmbunătățește Kimi K3 cu 7,2 puncte la Financial Modeling și 11,6 puncte la Financial Research și ajunge la aproximativ 4,2× scorul lui K3 la Business Operation, o sarcină de business simulată pe orizont lung.
Munca pe acuratețe se vede în testul de stres pentru halucinații al Moonshot. Pe Kimi Hallu Bench Hard, rata de halucinații la nivel de afirmație a scăzut de la 23,4% pentru K3 la 8,3% pentru K3.1 Pro. Moonshot subliniază că testul este construit să provoace erori, deci acele rate nu sunt rate de eroare de zi cu zi.
Kimi K3.1 Pro este competitiv cu Claude Opus 5.5 și GPT-6 Astra la coding agentic și muncă grea în instrumente, dar rămâne clar în urmă la raționament pur. Toate cifrele de mai jos vin din anunțul Moonshot, cu K3.1 Pro la efort max.
Aici K3.1 Pro arată cel mai puternic. Pe Terminal-Bench 4.0, care evaluează agenții de coding pe sarcini realiste, cu resurse limitate, în terminal, K3.1 Pro obține 65,7%. Asta este foarte puțin în urma lui Claude Opus 5.5 la 66,4% și bine înaintea lui GPT-6 Astra la 58,2%.
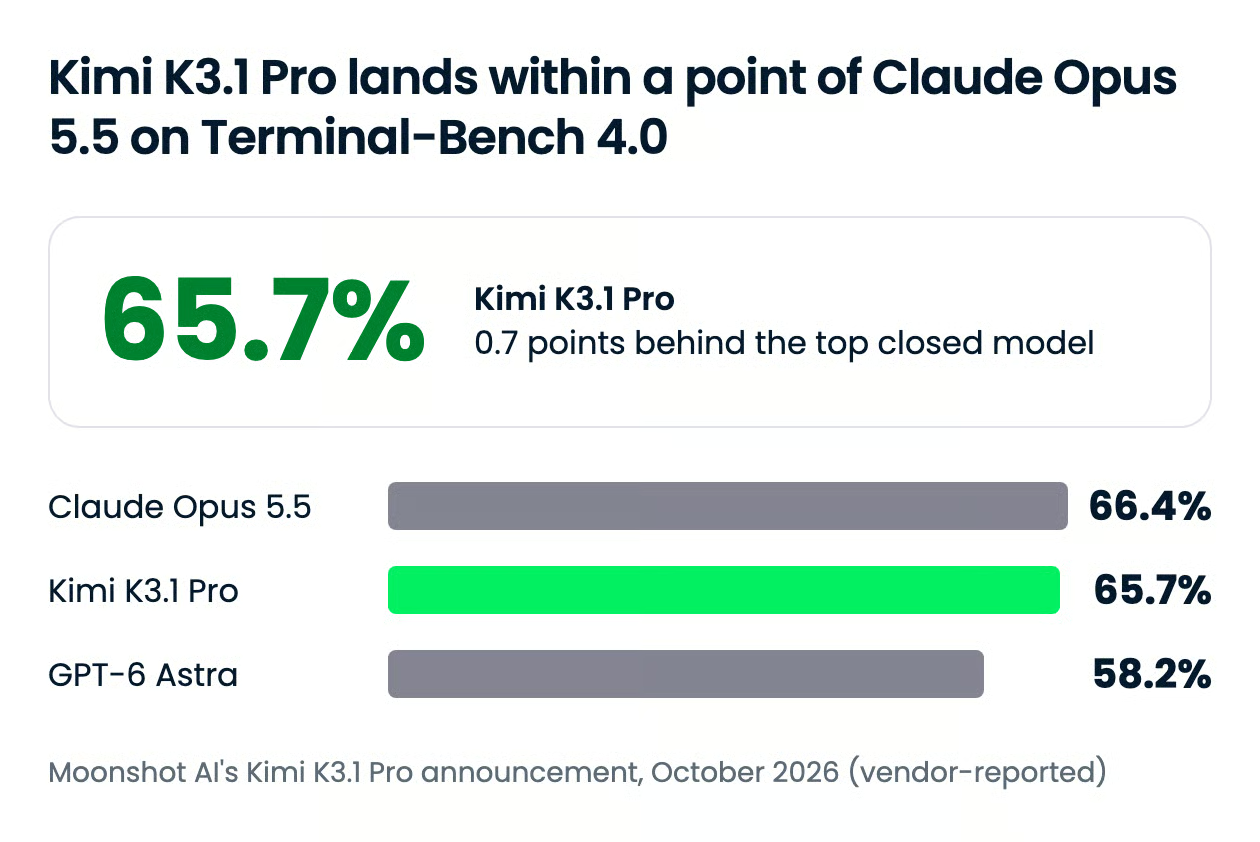
Restul rezultatelor la coding sunt mai mixte decât sugerează acest titlu. Toate scorurile sunt raportate de furnizori, cu cel mai bun scor pe fiecare rând îngroșat:
| Benchmark | Ce măsoară | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agenți de coding pe sarcini realiste în terminal | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 20 de sarcini de inginerie de câteva ore, fără internet | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 113 sarcini pe orizont lung, notate pe comportament | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (intern Moonshot) | Execuție în mai mulți pași și folosire de instrumente | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | Reconstruirea unui program din binar și specificație (sarcini care trec cel puțin 95% din teste) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | Agenți pe fluxuri de cercetare științifică | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro este la nivel cu cele mai bune modele închise pe sarcini lungi de inginerie și conduce comparația Moonshot la SWE-Marathon. Pe DeepSWE, fiecare laborator a rulat propriul setup, deci un ecart de 3 puncte e mai degrabă egalitate decât victorie. Cade mult în urmă când trebuie să reconstruiască un program doar din comportamentul observat sau să parcurgă un flux de lucru de cercetare științifică.
Față de predecesor, cel mai clar câștig este pe benchmarkul intern pe orizont lung al Moonshot, unde Kimi K3 a obținut 55,95%.
La munca de agenți orientată pe instrumente, K3.1 Pro conduce sau este la câteva puncte de Opus 5.5:
| Benchmark | Ce măsoară | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full cu instrumente | 2.500 de întrebări grele de cunoaștere și raționament, cu instrumente permise | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | Găsirea pe web a informațiilor greu de localizat | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | Analiză numerică pe PDF-uri financiare reale | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | Fluxuri investiționale de la screening la analiza profitabilității | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | Operarea unui computer desktop pentru a finaliza sarcini | 79.6% | 81.8% | 75.8% | 69.3% |
Excepția clară în tabelul Moonshot este folosirea computerului, unde Opus 5.5 rămâne înainte. Pe Frontier Finance, Claude Fable 5.1 (60,8) este liderul general, înaintea tuturor celor patru modele de aici.
Fără instrumente, K3.1 Pro rămâne clar în urmă față de modelele închise:
| Benchmark | Ce măsoară | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 de întrebări grele de cunoaștere și raționament | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | Submulțimea cea mai dificilă din HLE, cu 1.000 de întrebări | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | Întrebări de știință la nivel de studii postuniversitare | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | Întrebări care combină imagini și text | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (intern Moonshot, mai mic e mai bine) | Ponderea afirmațiilor factuale care sunt greșite | 5.4% | 6.8% | 4.2% | 13.1% |
Decalajul este cel mai mare pe HLE-Diamond, în timp ce GPQA-Diamond este aproape saturat, deci ecartul de 2 puncte spune puțin. Dacă munca ta este raționament greu, cu carte închisă, acesta nu este modelul la care să treci.
Moonshot a făcut ceva neobișnuit pentru o lansare open-weight: a publicat câtă capabilitate a eliminat deliberat. A constatat că conținutul legat de cybersecurity din datele de mid-training și mediile RL creștea constant abilitatea de cercetare a vulnerabilităților, așa că a eliminat acele date din ambele etape pentru lansarea open-weight.
Pe xdev-bench-hard, benchmarkul intern al Moonshot pentru dezvoltare de exploatări, un checkpoint fără eliminarea datelor a rezolvat 90,5% dintre probleme (pass@3). K3.1 Pro livrat rezolvă 81,0%, ceea ce este încă mult peste cei 33,3% ai lui Kimi K3. Pe benchmarkuri publice de cyber se situează sub fiecare model închis comparat de Moonshot, obținând 74,7 pe ExploitBench față de 91,0 al lui Opus 5.5.
Principiul declarat al Moonshot este să evite publicarea de greutăți deschise care împing frontiera absolută a capabilității cibernetice ofensive, crescând în schimb treptat nivelul open-weight. Dacă o reducere de 9,5 puncte este suficientă rămâne o chestiune de judecată, dar publicarea numărului este mai mult decât fac multe alte laboratoare.
K3.1 Pro standard este alegerea implicită potrivită pentru aproape toți. Varianta Highspeed își merită prețul mai mare doar când cineva stă în fața ecranului și așteaptă rezultatul.
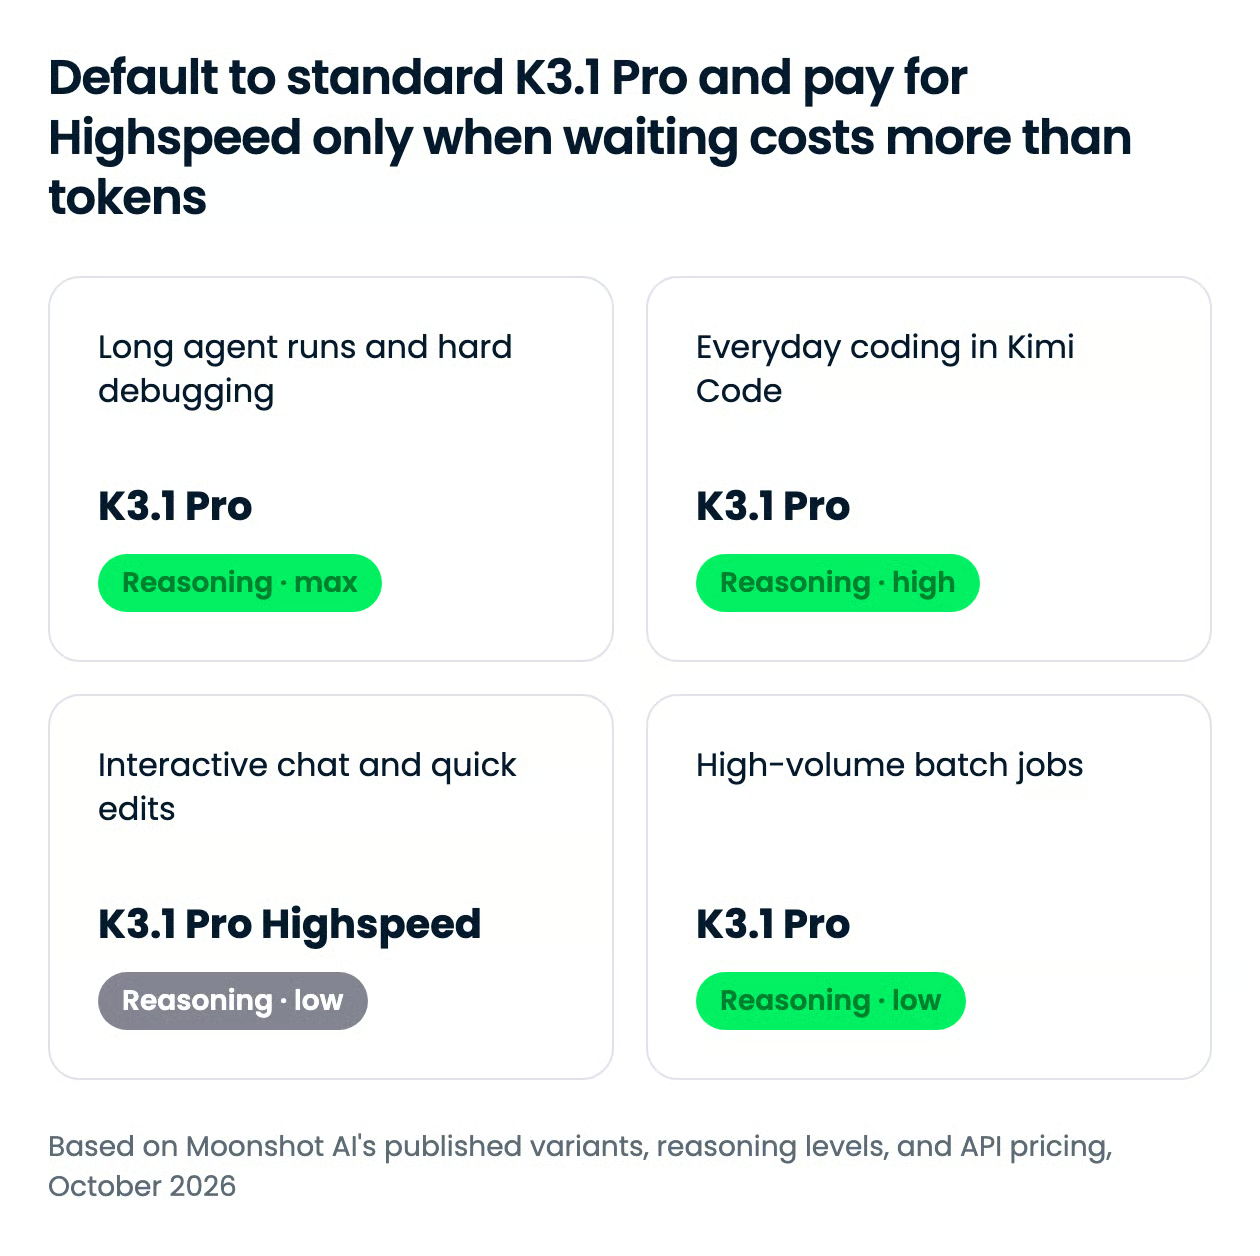
Moonshot vinde Highspeed strict pe viteza de execuție: rulează de 2–3× mai rapid, costă de două ori mai mult pe token de input și output și nu are rezultate de benchmark separate.
Ambele variante gândesc întotdeauna înainte de a răspunde și nu poți dezactiva asta. Alegi intensitatea cu trei niveluri de raționament: max pentru munca de agent cea mai dificilă, high ca mijloc echilibrat și low când timpul implicit de gândire e mai mult decât cere sarcina. API-ul are implicit max, setarea din spatele fiecărui scor din tabelul de benchmark al Moonshot, așa că coboară la high sau low dacă sarcina nu cere profunzime maximă.
| Caz de utilizare | Variantă | Nivel de raționament | De ce |
|---|---|---|---|
| Rulări lungi de agenți, debugging dificil | K3.1 Pro | max |
Setarea din spatele scorurilor la coding ale Moonshot; viteza contează mai puțin pe parcursul orelor |
| Coding de zi cu zi în Kimi Code | K3.1 Pro | high |
Majoritatea calității la o notă mai mică de tokeni |
| Chat interactiv și editări rapide | K3.1 Pro Highspeed | low |
Latența este blocajul, iar prompturile scurte mențin mic prețul de 2× |
| Joburi batch cu volum mare | K3.1 Pro | low |
Nimeni nu așteaptă, deci plătește tariful mai mic și limitează timpul de gândire |
Un aspect practic important din documentația Kimi Code: schimbarea nivelului de raționament în mijlocul sesiunii invalidează cache-ul de context, așa că alege un nivel per sesiune în loc să comuți înainte și înapoi.
Kimi K3.1 Pro costă 2,00 $ per milion de tokeni de input și 10,00 $ per milion de tokeni de output pe Kimi API, ceea ce este mai puțin decât Kimi K3. Prețul este plat pe toată fereastra de 1M tokeni, fără suprataxă pentru context lung.
| Model | Input | Output | Input din cache | Scriere cache 5 minute | Scriere cache 1 oră |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (generația anterioară) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Prețurile sunt per milion de tokeni și nu includ taxele. Cachingul este automat, cu 5 minute implicit, și poți solicita nivelul de 1 oră per apel.
Câteva detalii de acces merită știute înainte să te bazezi pe el:
Dacă ești încă pe modelele din seria K2, documentația Moonshot spune că nu vor mai fi disponibile pentru utilizatorii noi începând cu 31 octombrie 2026 și vor fi retrase până la finalul lui decembrie 2026.
Poți folosi Kimi K3.1 Pro astăzi prin Kimi API, OpenRouter și aplicațiile proprii Kimi, dar nu încă sub formă de greutăți descărcabile. Moonshot spune că greutățile complete vor fi lansate până pe 4 noiembrie 2026, iar anunțul nu menționează termenii de licență, așa că verifică fișa modelului când apar greutățile.
kimi-k3.1-pro și kimi-k3.1-pro-highspeed, pe un endpoint compatibil cu OpenAI.moonshotai/kimi-k3.1-pro./model. Documentația Moonshot acoperă și conectarea la Codex prin Kimi Responses API.Un apel minimal cu clientul OpenAI pentru Python arată astfel:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
După ce apar greutățile, ghidul nostru despre cum să rulezi local LLM-uri acoperă opțiunile de servire, iar explicația noastră despre OpenCode arată cum să conectezi un astfel de model la un agent de coding open-source.
Kimi K3.1 Pro este cel mai puternic argument de până acum că modelele open-weight pot egala frontiera închisă la coding agentic, la un preț sub predecesorul său. Nu este lider la raționament general, dar pentru coding lung și muncă de agenți intensă în instrumente stă chiar lângă Claude Opus 5.5 și înaintea GPT-6 Astra la mai multe sarcini.
Moonshot pariază, de asemenea, că publicarea compromisurilor pe zona cyber îi va aduce bunăvoință pentru lansările open. Dacă codezi cu agenți, ți-aș recomanda să-l încerci acum prin API și să revii la self-hosting odată ce apar greutățile și fișa modelului în noiembrie.
Dacă ești dornic să lucrezi cu modele deschise ca acesta, îți recomand să verifici skill track-ul nostru Hugging Face Fundamentals.
Învață AI cu DataCamp!
Curs
Traseu de învățare
Practică și urmărește-ți progresul.
Continuă Cu Google