

Kurs
Hugging Face ile Çalışmak
2 sa
40K
Alıştırma and program your progress.
Google Ile Devam EdinAçık ağırlık laboratuvarları, 2026 boyunca kodlama alanında Anthropic ve OpenAI ile arayı kapatmaya çalıştı ve Moonshot AI bu farkı bir kez daha azalttı. Geçtiğimiz Cuma, Moonshot Kimi K3.1 Pro'yu yayımladı; bunu şimdiye kadarki en yetenekli 3T sınıfı açık ağırlık modeli olarak tanımlıyor ve aracısal kodlamada Claude Opus 5.5'e bir puan mesafeye koyuyor.
K3.1 Pro, 1 milyon tokenlık bağlam penceresine sahip Kimi K3'ün yoğun biçimde sonradan eğitilmiş bir sürümü. Yanında daha hızlı bir varyant olan K3.1 Pro Highspeed ile geliyor ve bugün Kimi uygulamalarında, Kimi Code'da ve Kimi API'sinde canlı. Tam ağırlıklar 4 Kasım 2026'ya kadar paylaşılacak.
Bu yazıda, Kimi K3.1 Pro'daki tüm yenilikleri; yeni özellikleri, kıyaslamaları ve fiyatlandırmanın Kimi K3 ile nasıl karşılaştırıldığını ele alacağım. Üzerine inşa edildiği modele yetişmek için, Kimi K3 rehberlerimize ve Kimi K3 uygulamalı eğitimimize göz atın.
Kimi K3.1 Pro, Moonshot AI'ın amiral gemisi büyük dil modeli (LLM) ve yeni K3.1 serisinin ilk modeli. Kimi K3 tabanını, 1M-token bağlam penceresine sahip 2,8T parametreli modeli koruyor ve üzerine çok daha fazla sonradan eğitim hesaplaması ekliyor.
Değişim mimaride değil eğitimde: Moonshot, “yüzlerce aşağı akış alanı” üzerinde ortak pekiştirmeli öğrenim (RL) çalıştırdı ve ek hesaplamanın istikrarlı kazançlar getirmesi için RL çerçevesini, sandbox altyapısını ve rollout zamanlamasını yeniden inşa etti. Moonshot'a göre sonuç, ölçtükleri her alanda iyileşme; özellikle kodlama, 3D oluşturma ve finansal araştırma öne çıkıyor.
Manşet iddia, mülki modellerle aracısal kodlamada başa başlık. Moonshot'ın kendi tablosu, K3.1 Pro'yu terminal tabanlı kodlama görevlerinde Claude Opus 5.5'e bir puan mesafeye koyuyor ve Anthropic'in fiyatının bir kısmını talep ediyor. Model açık ağırlık; ancak ağırlıklar henüz herkese açık değil.
K3.1 Pro, tek bir numaradan ziyade kapsamlı bir yükseltme. Aşağıdaki dört yetenek, gerçekten iş akışını değiştirebilecek türden.
K3.1 Pro, uzun ve çok adımlı bir kodlama görevi üzerinde kalabiliyor; yalnızca yeniden denemek yerine kendi hatalarını teşhis edebiliyor. Moonshot'ın vitrin örneği, 296 iskelet ve 402 kas bileşenine sahip, açık kaynaklı human-atlas anatomik modeli üzerine kurulu bir insan yürüme simülatörü.
167 görev ve 420 bağımsız inceleme boyunca, model simüle edilen insanı saniyeler içinde çökmekten 11,2 saniye boyunca dönüşümlü adımlarla yürümeye taşıdı. İlginç kısım, ödül şekillendirme kol hareketine yardımcı olmayı bıraktığında geldi: K3.1 Pro simülatörü açık döngü yokladı, omuz-kas moment kolu hesaplamalarında 36 hata buldu, düzeltti ve yeniden eğitti.
Bu, tek bir dahili demo; dolayısıyla kanıt değil, amaçlanan kullanım örneğinin bir illüstrasyonu olarak değerlendirin. Yine de Moonshot'ın neye odaklandığını gösteriyor: araştırıp yineleyen ajanlar.
Moonshot, K3.1 Pro'nun “daha güçlü kompozisyon, tipografi, animasyon ve cilaya” sahip ön uç sayfaları, Three.js sahneleri ve 3D varlıklar ürettiğini söylüyor. Unity, Unreal Engine ve Godot ile çalışıyor; web araması ve 3D üretimiyle birleştirerek eksiksiz bir proje derleyebiliyor.
Modelleme tarafında, K3.1 Pro, mekanik parçalar, mimari modeller ve yapılandırılabilir mobilyalar gibi parametrik modeller oluşturmak için Blender ve CAD yazılımları için komut dosyalarını doğrudan, MCP bağlayıcıları olmadan yazıp çalıştırıyor. Moonshot ayrıca kimi.ai ve Kimi uygulamasında, 3D baskıya hazır modelleri önizleyip düzenleyip indirebileceğiniz 3D Make'i de başlattı.
Görsel kalite iddiası, bir kıyaslama tablosuna vurgu yapmak açısından da en zor olanı; bu nedenle Moonshot'ın demolarını tipik çıktıdan ziyade satıcının en iyi örnekleri olarak değerlendirin.
K3.1 Pro, bir finansal iş akışını taramadan bitmiş bir çalışma kitabına kadar götürebiliyor ve bu tür işler için olgusal doğruluğa yönelik hedefli düzeltmeler yapılmış. Dahili finans kıyaslarında, K3.1 Pro; Finansal Modelleme'de Kimi K3'e göre 7,2 puan, Finansal Araştırma'da 11,6 puan artış sağlıyor ve uzun ufuklu bir simüle iş görevi olan İşletme Operasyonu'nda K3'ün skorunun yaklaşık 4,2 katına ulaşıyor.
Doğruluk çalışması, Moonshot'ın halüsinasyon stres testinde de görülüyor. Kimi Hallu Bench Hard'da, iddia düzeyindeki halüsinasyon oranı K3 için %23,4'ten K3.1 Pro için %8,3'e düştü. Moonshot, testin hataları tetiklemek üzere tasarlandığını dikkatle belirtiyor; dolayısıyla bu oranlar günlük hata oranları değil.
Kimi K3.1 Pro, aracısal kodlama ve yoğun araç kullanımına dayalı işlerde Claude Opus 5.5 ve GPT-6 Astra ile rekabetçi, ancak salt akıl yürütmede onlardan belirgin şekilde geride. Aşağıdaki tüm rakamlar Moonshot'ın duyurusundan geliyor; K3.1 Pro max çabasında.
Aracısal kodlama, K3.1 Pro'nun en güçlü göründüğü yer. Gerçekçi, kaynak kısıtlı terminal görevlerinde kodlama ajanlarını notlayan Terminal-Bench 4.0'da K3.1 Pro %65,7 puan alıyor. Bu, %66,4 ile Claude Opus 5.5'in çok az gerisinde ve %58,2 ile GPT-6 Astra'nın oldukça önünde.
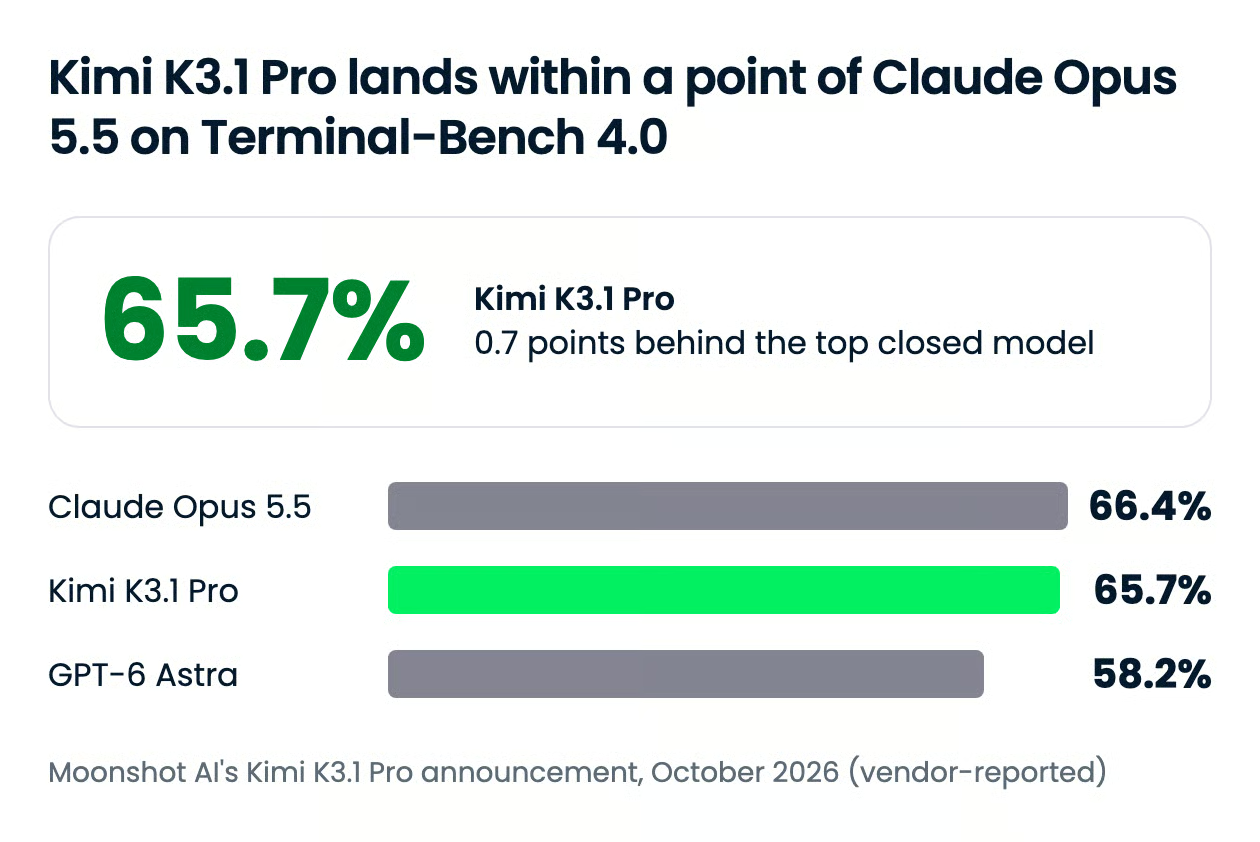
Kalan kodlama sonuçları, manşetin önerdiğinden daha karışık. Tüm skorlar satıcı tarafından bildirildi; her satırdaki en iyi skor kalın:
| Kıyaslama | Ne ölçüyor | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Gerçekçi terminal görevlerinde kodlama ajanları | %65,7 | %66,4 | %58,2 | %42,3 |
| SWE-Marathon v1.1 | İnternetsiz, birden çok saat süren 20 mühendislik görevi | %51,7 | %46,3 | %42,5 | %40,0 |
| DeepSWE v1.1 | Davranışa göre notlanan 113 uzun ufuklu görev | %75,5 | %74,2 | %74,1 | %77,0 |
| Kimi Code Bench 3.0 Long-horizon (Moonshot dahili) | Çok adımlı yürütme ve araç kullanımı | %61,2 | %58,5 | %66,5 | %51,5 |
| ProgramBench | Bir programı ikili dosya ve şartnameden yeniden kurma (testlerin en az %95'ini geçen görevler) | %31,5 | %65,0 | %50,0 | %29,1 |
| Terminal-Bench Science 0.1 | Bilimsel araştırma iş akışlarında ajanlar | %38,1 | %63,3 | %68,1 | %15,7 |
K3.1 Pro, uzun mühendislik görevlerinde en iyi kapalı modellerle aynı seviyede ve Moonshot'ın SWE-Marathon karşılaştırmasında önde. DeepSWE'de her laboratuvar kendi kurulumunu çalıştırdı; dolayısıyla 3 puanlık fark, galibiyetten ziyade beraberlik sayılır. Gözlenen davranıştan yalnızca bir programı yeniden inşa etmesi gerektiğinde veya bilimsel bir araştırma iş akışını yürüttüğünde belirgin şekilde geride kalıyor.
Önceki sürümüne karşı en net kazanç, Kimi K3'ün %55,95 aldığı Moonshot'ın kendi uzun ufuklu kıyaslamasında.
Araç kullanımının yoğun olduğu ajan işlerinde, K3.1 Pro önde ya da Opus 5.5'e birkaç puan mesafede:
| Kıyaslama | Ne ölçüyor | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | Araçlara izin verilen 2.500 zor bilgi ve akıl yürütme sorusu | %70,0 | %67,7 | %57,2 | %58,8 |
| BrowseComp | Web'de bulunması zor bilgiyi bulma | %92,1 | %90,8 | %91,5 | n/a |
| OfficeQA Pro v2 | Gerçek finansal PDF'lerde sayısal analiz | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Taramadan kârlılık analizine uzanan yatırım iş akışları | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Bir masaüstü bilgisayarı kullanarak görevleri tamamlama | %79,6 | %81,8 | %75,8 | %69,3 |
Moonshot'ın tablosundaki tek net istisna, bilgisayar kullanımı; burada Opus 5.5 önde kalıyor. Frontier Finance'te ise Claude Fable 5.1 (60,8) genel lider; burada gösterilen dört modelin hepsinin önünde.
Araçsız durumda, K3.1 Pro kapalı modellere kıyasla açıkça geride kalıyor:
| Kıyaslama | Ne ölçüyor | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 zor bilgi ve akıl yürütme sorusu | %51,1 | %59,8 | %53,6 | %42,6 |
| HLE-Diamond | HLE'nin 1.000 soruluk en zor alt kümesi | %39,4 | %60,9 | %65,8 | %21,6 |
| GPQA-Diamond | Lisansüstü düzey bilim soruları | %94,2 | %93,9 | %96,1 | %92,2 |
| MMMU-Pro | Görseller ve metni birleştiren sorular | %84,1 | %87,7 | %86,9 | %80,6 |
| Kimi Hallu Bench (Moonshot dahili, düşük daha iyi) | Yanlış olan olgusal iddiaların payı | %5,4 | %6,8 | %4,2 | %13,1 |
Fark, HLE-Diamond'da en geniş; GPQA-Diamond ise doygunluğa yakın, dolayısıyla 2 puanlık fark pek bir şey söylemiyor. İşiniz zorlu kapalı kitap akıl yürütmeye dayanıyorsa, bu geçiş yapacağınız model değil.
Moonshot, bir açık ağırlık sürümü için alışılmadık bir şey yaptı: Bilerek ne kadar yeteneği çıkardığını yayınladı. Orta eğitim verilerindeki ve RL ortamlarındaki siberle ilgili içeriğin, güvenlik açığı araştırma becerisini istikrarlı biçimde yükselttiğini saptadı; bu nedenle açık ağırlık sürümü için bu veriyi her iki aşamadan da çıkardı.
xdev-bench-hard üzerinde, Moonshot'ın dahili exploit geliştirme kıyaslamasında, veri kaldırma yapılmamış bir kontrol noktası sorunların %90,5'ini çözdü (pass@3). Yayınlanan K3.1 Pro %81,0 çözüyor; bu hâlâ Kimi K3'ün %33,3'ünün çok üzerinde. Genel siber kıyaslarda ise Moonshot'ın karşılaştırdığı tüm kapalı modellerin altında kalıyor; ExploitBench'te Opus 5.5'in 91,0'ına karşı 74,7 puan alıyor.
Moonshot'ın beyan ettiği ilke, açık ağırlıklarla saldırı amaçlı siber yeteneğin mutlak sınırını zorlamaktan kaçınırken açık ağırlık seviyesini kademeli olarak yükseltmek. 9,5 puanlık kesintinin yeterli olup olmadığı bir kanaat meselesi; ancak rakamı yayınlamak, birçok laboratuvarın yaptığından daha fazla şeffaflık.
Standart K3.1 Pro, neredeyse herkes için doğru varsayılandır. Highspeed varyantı, bir kişinin çıktıyı beklediği durumlarda daha yüksek fiyatını hak eder.
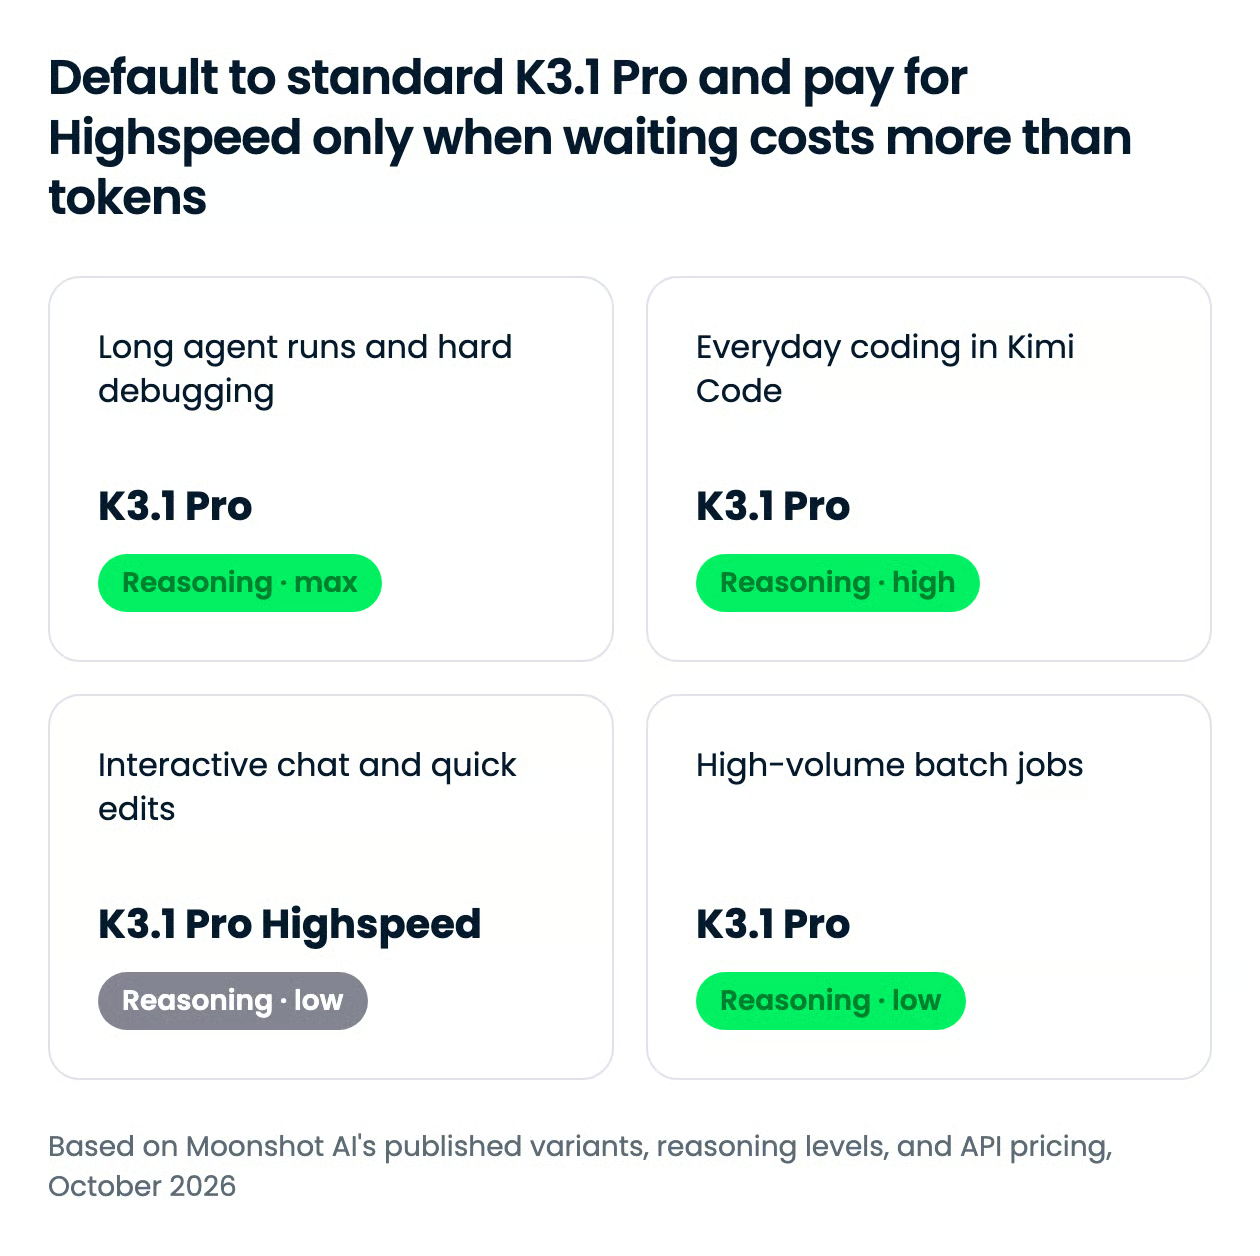
Moonshot, Highspeed'i tamamen hız üzerinden satıyor: 2–3× daha hızlı çalışıyor, giriş ve çıkış tokenı başına iki katına mal oluyor ve ayrı kıyaslama sonuçları yok.
Her iki varyant da yanıtlamadan önce daima düşünür ve bunu kapatamazsınız. Zorluk düzeyini üç akıl yürütme seviyesiyle belirlersiniz: en zorlu ajan işleri için max, makul bir orta yol olarak high ve varsayılan düşünme süresi görevin ihtiyacından fazlaysa low. API varsayılanı max; Moonshot'ın kıyaslama tablosundaki her skorun arkasındaki ayar budur; görev tam derinlik gerektirmiyorsa high veya low'a düşürün.
| Kullanım durumu | Varyant | Akıl yürütme seviyesi | Neden |
|---|---|---|---|
| Uzun ajan çalıştırmaları, zor hata ayıklama | K3.1 Pro | max |
Moonshot'ın kodlama skorlarının arkasındaki ayar; saatler süren işlerde hız daha az önemli |
| Kimi Code'da günlük kodlama | K3.1 Pro | high |
Daha düşük token faturasıyla kalitenin çoğu |
| Etkileşimli sohbet ve hızlı düzenlemeler | K3.1 Pro Highspeed | low |
Darboğaz gecikme; kısa istemler 2× fiyatı küçük tutar |
| Yüksek hacimli toplu işler | K3.1 Pro | low |
Bekleyen kimse yok; bu nedenle daha düşük ücret ödeyin ve düşünmeyi sınırlayın |
Kimi Code dokümanlarından önemli bir pratik not: oturum ortasında akıl yürütme seviyesini değiştirmek bağlam önbelleğini geçersiz kılar; bu nedenle gidip gelmek yerine oturum başına bir seviye seçin.
Kimi K3.1 Pro, Kimi API'de milyon giriş tokenı başına 2,00 $ ve milyon çıkış tokenı başına 10,00 $ tutuyor; bu Kimi K3'ten daha ucuz. Fiyatlandırma, uzun bağlam ek ücreti olmadan, tam 1M-token bağlam boyunca düz.
| Model | Girdi | Çıktı | Önbelleğe alınmış girdi | 5 dakikalık önbellek yazımı | 1 saatlik önbellek yazımı |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (önceki nesil) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Fiyatlar milyon token başınadır ve vergi hariçtir. Önbelleğe alma varsayılan olarak 5 dakikadır ve çağrı başına 1 saatlik katmanı talep edebilirsiniz.
Plan yapmadan önce bilmeye değer birkaç erişim detayı:
Hâlâ K2 serisi modellerdeyseniz, Moonshot dokümanları bunların 31 Ekim 2026'dan itibaren yeni kullanıcılara kapatılacağını ve 2026 Aralık sonuna kadar emekliye ayrılacağını söylüyor.
Kimi K3.1 Pro'yu bugün Kimi API, OpenRouter ve Kimi'nin kendi uygulamaları üzerinden kullanabilirsiniz; ancak indirilebilir ağırlıklar henüz yok. Moonshot, tam ağırlıkların 4 Kasım 2026'ya kadar yayımlanacağını söylüyor ve duyuruda lisans koşullarından bahsedilmiyor; bu nedenle ağırlıklar geldiğinde model kartını kontrol edin.
kimi-k3.1-pro ve kimi-k3.1-pro-highspeed.moonshotai/kimi-k3.1-pro olarak listelenmiş./model komutuyla seçin. Moonshot'ın dokümanları, Kimi Responses API üzerinden Codex'e bağlamayı da kapsıyor.OpenAI Python istemcisiyle minimal bir çağrı şöyle görünür:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Ağırlıklar geldikten sonra, LLM'leri yerelde çalıştırma rehberimiz sunum seçeneklerini kapsar ve OpenCode açıklayıcımız, bu tür bir modeli açık kaynaklı bir kodlama ajanına nasıl bağlayacağınızı gösterir.
Kimi K3.1 Pro, açık ağırlık modellerinin aracısal kodlamada kapalı sınırla başa baş gidebileceğine dair şimdiye kadarki en güçlü örnek; üstelik kendi selefinden daha düşük bir fiyatla. Genel akıl yürütmede lider değil; ancak uzun kodlama ve yoğun araç kullanan ajan işlerinde Claude Opus 5.5'in hemen yanında ve bazı görevlerde GPT-6 Astra'nın önünde.
Moonshot ayrıca siberle ilgili takaslarını yayımlayarak açık sürümleri için iyi niyet kazanmayı umuyor. Ajanlarla kod yazıyorsanız, şimdi API üzerinden deneyip ağırlıklar ve model kartı Kasım'da geldiğinde öz barındırmaya yeniden bakmanızı öneririm.
Bu tür açık modellerle çalışmaya hevesliyseniz, Hugging Face Fundamentals yetkinlik yolumuza göz atmanızı öneririm.
DataCamp ile Yapay Zekayı Öğrenin!
Kurs
Program
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



