

कोर्स
Hugging Face के साथ काम करना
2 घंटा
40K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंओपन-वेट लैब्स ने 2026 में कोडिंग पर Anthropic और OpenAI से दूरी कम करने में समय लगाया है, और Moonshot AI ने इसे फिर घटा दिया है। पिछले शुक्रवार, Moonshot ने Kimi K3.1 Pro जारी किया, जिसे वह अब तक का अपना सबसे सक्षम 3T-क्लास ओपन-वेट मॉडल कहता है, और एजेंटिक कोडिंग में इसे Claude Opus 5.5 के एक अंक के भीतर ले आता है।
K3.1 Pro, Kimi K3 का एक हेवी पोस्ट-ट्रेंड संस्करण है जिसमें 10 लाख टोकन का कॉन्टेक्स्ट विंडो है। इसके साथ एक तेज़ वेरिएंट, K3.1 Pro Highspeed, भी आता है, और यह आज Kimi ऐप्स, Kimi Code, और Kimi API में लाइव है। पूरे वेट्स 4 नवंबर, 2026 तक आएंगे।
इस लेख में, मैं Kimi K3.1 Pro की नई बातों को कवर करूँगा—नई विशेषताएँ, बेंचमार्क, और Kimi K3 की तुलना में कीमत कैसी है। जिस मॉडल पर यह बना है, उस पर पकड़ बनाने के लिए हमारे Kimi K3 गाइड और Kimi K3 हैंड्स-ऑन ट्यूटोरियल देखें।
Kimi K3.1 Pro Moonshot AI का फ्लैगशिप बड़ा भाषा मॉडल (LLM) है और उसकी नई K3.1 सीरीज़ का पहला मॉडल। यह Kimi K3 के बेस को रखता है—2.8T-पैरामीटर मॉडल 1M-टोकन कॉन्टेक्स्ट विंडो के साथ—और उसके ऊपर कहीं अधिक पोस्ट-ट्रेनिंग कंप्यूट जोड़ता है।
बदलाव आर्किटेक्चर में नहीं, बल्कि ट्रेनिंग में है: Moonshot ने संयुक्त रीइन्फोर्समेंट लर्निंग (RL) “सैकड़ों डाउनस्ट्रीम डोमेनों” में चलाई, और अपना RL फ़्रेमवर्क, सैंडबॉक्स इन्फ्रास्ट्रक्चर, और रोलआउट शेड्यूलिंग दोबारा बनाया, ताकि अतिरिक्त कंप्यूट से स्थिर लाभ मिलें। Moonshot के अनुसार, नतीजा हर मापे गए डोमेन में सुधार है, जिनमें कोडिंग, 3D क्रिएशन, और वित्तीय रिसर्च खास हैं।
सबसे बड़ा दावा बेहतरीन प्रोपर्टायटरी मॉडलों के साथ एजेंटिक कोडिंग में बराबरी का है। Moonshot की अपनी तालिका K3.1 Pro को टर्मिनल-आधारित कोडिंग कार्यों पर Claude Opus 5.5 से एक अंक के भीतर दिखाती है, और यह Anthropic की कीमत के एक अंश पर चार्ज करता है। मॉडल ओपन-वेट है, पर वेट्स अभी सार्वजनिक नहीं हैं।
K3.1 Pro किसी एक नए ट्रिक की बजाय एक व्यापक अपग्रेड है। नीचे दी गई चार क्षमताएँ वे हैं जिनके लिए मैं सच में वर्कफ़्लो बदलूँगा।
K3.1 Pro एक लंबे, बहु-चरणीय कोडिंग कार्य पर टिका रह सकता है, और सिर्फ़ रिट्राई करने की बजाय अपनी असफलताओं का निदान कर सकता है। Moonshot का शोकेस ओपन-सोर्स human-atlas एनाटॉमिकल मॉडल पर बना एक ह्यूमन वॉकिंग सिम्युलेटर है, जिसमें 296 कंकाली और 402 मसल कॉम्पोनेंट्स हैं।
167 मिशनों और 420 स्वतंत्र समीक्षाओं में, मॉडल ने सिम्युलेटेड मानव को कुछ ही सेकंड में ढहने से लेकर 11.2 सेकंड तक वैकल्पिक कदमों के साथ चलने तक पहुँचा दिया। दिलचस्प हिस्सा तब आया जब रिवॉर्ड शेपिंग से आर्म मोशन में मदद आनी बंद हो गई: K3.1 Pro ने सिम्युलेटर के ओपन-लूप प्रोब चलाए, शोल्डर-मसल मोमेंट-आर्म कैलकुलेशनों में 36 त्रुटियाँ ढूंढीं, उन्हें ठीक किया, और फिर से ट्रेनिंग की।
यह एक आंतरिक डेमो है, इसलिए इसे प्रमाण की बजाय इच्छित उपयोग के उदाहरण के रूप में लें। फिर भी, यह दिखाता है कि Moonshot किसके लिए ऑप्टिमाइज़ कर रहा है: ऐसे एजेंट जो जाँच-पड़ताल करें और दोहराएँ।
Moonshot कहता है कि K3.1 Pro फ्रंट-एंड पेज, Three.js सीन, और 3D एसेट “बेहतर कंपोज़िशन, टाइपोग्राफी, एनीमेशन, और पॉलिश” के साथ बनाता है। यह Unity, Unreal Engine, और Godot के साथ काम करता है, और वेब सर्च और 3D जेनरेशन के साथ मिलाकर पूरा प्रोजेक्ट तैयार कर सकता है।
मॉडलिंग साइड पर, K3.1 Pro Blender और CAD सॉफ़्टवेयर के लिए सीधे—बिना MCP कनेक्टर्स—स्क्रिप्ट लिखता और चलाता है, ताकि मैकेनिकल पार्ट्स, आर्किटेक्चरल मॉडल्स, और कॉन्फ़िगरेबल फ़र्नीचर जैसे पैरामीट्रिक मॉडल बनाए जा सकें। Moonshot ने kimi.ai और Kimi ऐप पर 3D Make भी लॉन्च किया है, जहाँ आप मॉडल्स का प्रीव्यू, एडिट, और 3D प्रिंटिंग के लिए तैयार डाउनलोड कर सकते हैं।
विज़ुअल-क्वालिटी का दावा बेंचमार्क तालिका से जाँचना सबसे कठिन भी है, इसलिए Moonshot के डेमो को औसत आउटपुट की बजाय विक्रेता के बेहतरीन उदाहरणों के रूप में लें।
K3.1 Pro वित्तीय वर्कफ़्लो को स्क्रीनिंग से लेकर तैयार वर्कबुक तक पहुँचा सकता है, और Moonshot ने इस तरह के काम के लिए तथ्यात्मक शुद्धता पर लक्षित सुधार किए हैं। अपनी आंतरिक फ़ाइनेंस बेंचमार्क्स पर, K3.1 Pro, Financial Modeling में Kimi K3 पर 7.2 अंक और Financial Research में 11.6 अंक का सुधार करता है, और Business Operation—एक लंबी अवधि के सिम्युलेटेड बिज़नेस टास्क—में K3 के स्कोर के लगभग 4.2× तक पहुँचता है।
सटीकता का काम Moonshot के हेलुसिनेशन स्ट्रेस टेस्ट में भी दिखता है। Kimi Hallu Bench Hard पर, क्लेम-लेवल हेलुसिनेशन दर K3 के 23.4% से घटकर K3.1 Pro के 8.3% पर आ गई। Moonshot सावधानी से कहता है कि टेस्ट त्रुटि उकसाने के लिए बनाया गया है, इसलिए ये दरें रोज़मर्रा की त्रुटि दरें नहीं हैं।
एजेंटिक कोडिंग और टूल-हेवी वर्क पर Kimi K3.1 Pro, Claude Opus 5.5 और GPT-6 Astra के मुकाबले में है, पर शुद्ध तर्क पर उनसे साफ़ पीछे है। नीचे की सभी संख्याएँ Moonshot की घोषणा से हैं, K3.1 Pro को max प्रयास पर चलाकर।
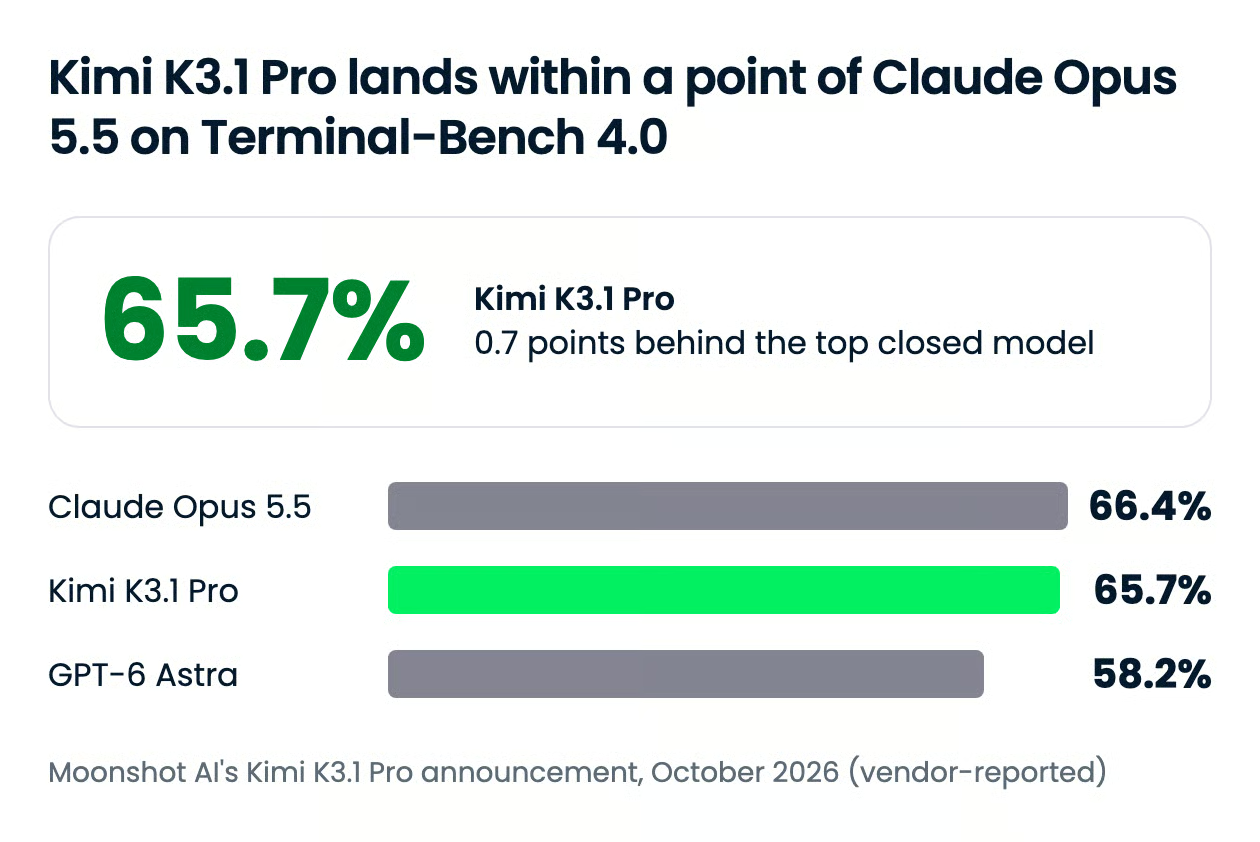
एजेंटिक कोडिंग वह जगह है जहाँ K3.1 Pro सबसे मज़बूत दिखता है। Terminal-Bench 4.0 पर, जो यथार्थवादी, सीमित संसाधन वाले टर्मिनल कार्यों पर कोडिंग एजेंट्स को ग्रेड करता है, K3.1 Pro 65.7% स्कोर करता है। यह Claude Opus 5.5 के 66.4% से बस थोड़ा सा पीछे है और GPT-6 Astra के 58.2% से कहीं आगे।
बाक़ी कोडिंग परिणाम उस हेडलाइन जितने एकतरफ़ा नहीं हैं। सभी स्कोर विक्रेता-रिपोर्टेड हैं, और हर पंक्ति में सबसे अच्छा स्कोर बोल्ड में है:
| बेंचमार्क | यह क्या मापता है | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | यथार्थवादी टर्मिनल कार्यों पर कोडिंग एजेंट्स | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 20 मल्टी-आवर इंजीनियरिंग टास्क, इंटरनेट नहीं | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 113 लॉन्ग-होराइज़न टास्क, व्यवहार पर ग्रेडेड | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (Moonshot आंतरिक) | मल्टी-स्टेप एग्ज़ीक्यूशन और टूल उपयोग | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | प्रोग्राम को उसके बाइनरी और स्पेक से फिर बनाना (टास्क जिनमें कम-से-कम 95% टेस्ट पास हों) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | वैज्ञानिक अनुसंधान वर्कफ़्लो पर एजेंट्स | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro लंबे इंजीनियरिंग कार्यों पर बेहतरीन क्लोज़्ड मॉडलों के बराबर है और Moonshot की SWE-Marathon तुलना में आगे है। DeepSWE पर हर लैब ने अपनी सेटअप चलाई, इसलिए 3 अंकों का फ़ासला जीत की बजाय बराबरी है। यह तब काफ़ी पीछे रह जाता है जब उसे सिर्फ़ देखे गए व्यवहार से प्रोग्राम दोबारा बनाना हो, या वैज्ञानिक रिसर्च वर्कफ़्लो से होकर गुजरना हो।
अपने पूर्ववर्ती के मुक़ाबले, सबसे साफ़ बढ़त Moonshot के अपने लॉन्ग-होराइज़न बेंचमार्क पर है, जहाँ Kimi K3 ने 55.95% स्कोर किया था।
टूल-हेवी एजेंट वर्क पर, K3.1 Pro आगे है या Opus 5.5 से कुछ अंकों के भीतर बैठता है:
| बेंचमार्क | यह क्या मापता है | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | 2,500 कठिन ज्ञान और तर्क प्रश्न, टूल्स की अनुमति | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | वेब पर ढूँढने में कठिन जानकारी खोजना | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | वास्तविक वित्तीय PDFs पर संख्यात्मक विश्लेषण | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | स्क्रीनिंग से लेकर लाभप्रदता विश्लेषण तक निवेश वर्कफ़्लोज़ | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | डेस्कटॉप कंप्यूटर चलाकर कार्य पूरे करना | 79.6% | 81.8% | 75.8% | 69.3% |
Moonshot की तालिका में एक स्पष्ट अपवाद कंप्यूटर उपयोग है, जहाँ Opus 5.5 आगे रहता है। Frontier Finance पर, Claude Fable 5.1 (60.8) समग्र लीडर है, यहाँ दिखाए गए सभी चार मॉडलों से आगे।
टूल्स के बिना, K3.1 Pro, क्लोज़्ड मॉडलों से साफ़ पीछे रह जाता है:
| बेंचमार्क | यह क्या मापता है | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2,500 कठिन ज्ञान और तर्क प्रश्न | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | HLE का 1,000-प्रश्नों वाला सबसे कठिन सबसेट | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | ग्रैजुएट-स्तर के विज्ञान प्रश्न | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | छवियों और पाठ को मिलाकर पूछे गए प्रश्न | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (Moonshot आंतरिक, कम बेहतर) | गलत तथ्यात्मक दावों का हिस्सा | 5.4% | 6.8% | 4.2% | 13.1% |
गैप HLE-Diamond पर सबसे चौड़ा है, जबकि GPQA-Diamond लगभग सैचुरेटेड है, इसलिए वहाँ 2 अंकों का फ़ासला बहुत कुछ नहीं कहता। अगर आपका काम कठिन क्लोज़्ड-बुक तर्क है, तो यह स्विच करने वाला मॉडल नहीं है।
Moonshot ने ओपन-वेट रिलीज़ के लिए एक असामान्य काम किया: उसने बताया कि उसने कितनी क्षमता जानबूझकर कम की। उसे मिला कि मिड-ट्रेनिंग डेटा और RL वातावरण में साइबर-संबंधित कंटेंट, वल्नरेबिलिटी रिसर्च स्किल को लगातार बढ़ा रहा था, इसलिए ओपन-वेट रिलीज़ के लिए उसने ये डेटा दोनों चरणों से हटा दिए।
xdev-bench-hard—Moonshot का आंतरिक एक्सप्लॉइट-डेवलपमेंट बेंचमार्क—पर, डेटा नहीं हटाने वाले एक चेकपॉइंट ने 90.5% समस्याएँ सुलझाईं (pass@3)। शिप किया गया K3.1 Pro 81.0% सुलझाता है, जो अब भी Kimi K3 के 33.3% से बहुत ऊपर है। पब्लिक साइबर बेंचमार्क्स पर, यह हर क्लोज़्ड मॉडल से नीचे बैठता है, ExploitBench पर Opus 5.5 के 91.0 के मुक़ाबले 74.7 स्कोर करते हुए।
Moonshot का घोषित सिद्धांत है कि ओपन वेट्स इस तरह न छोड़े जाएँ जो ऑफ़ेंसिव साइबर क्षमता के बिल्कुल अग्रिम मोर्चे को आगे धकेलें, बल्कि ओपन-वेट बार को धीरे-धीरे बढ़ाया जाए। 9.5 अंकों की कटौती काफ़ी है या नहीं, यह एक जजमेंट कॉल है, पर संख्या प्रकाशित करना कई अन्य लैब्स से ज़्यादा है।
लगभग सभी के लिए स्टैंडर्ड K3.1 Pro सही डिफ़ॉल्ट है। Highspeed वेरिएंट अपनी ऊँची कीमत तभी वसूलता है जब कोई व्यक्ति आउटपुट के सामने बैठा इंतज़ार कर रहा हो।
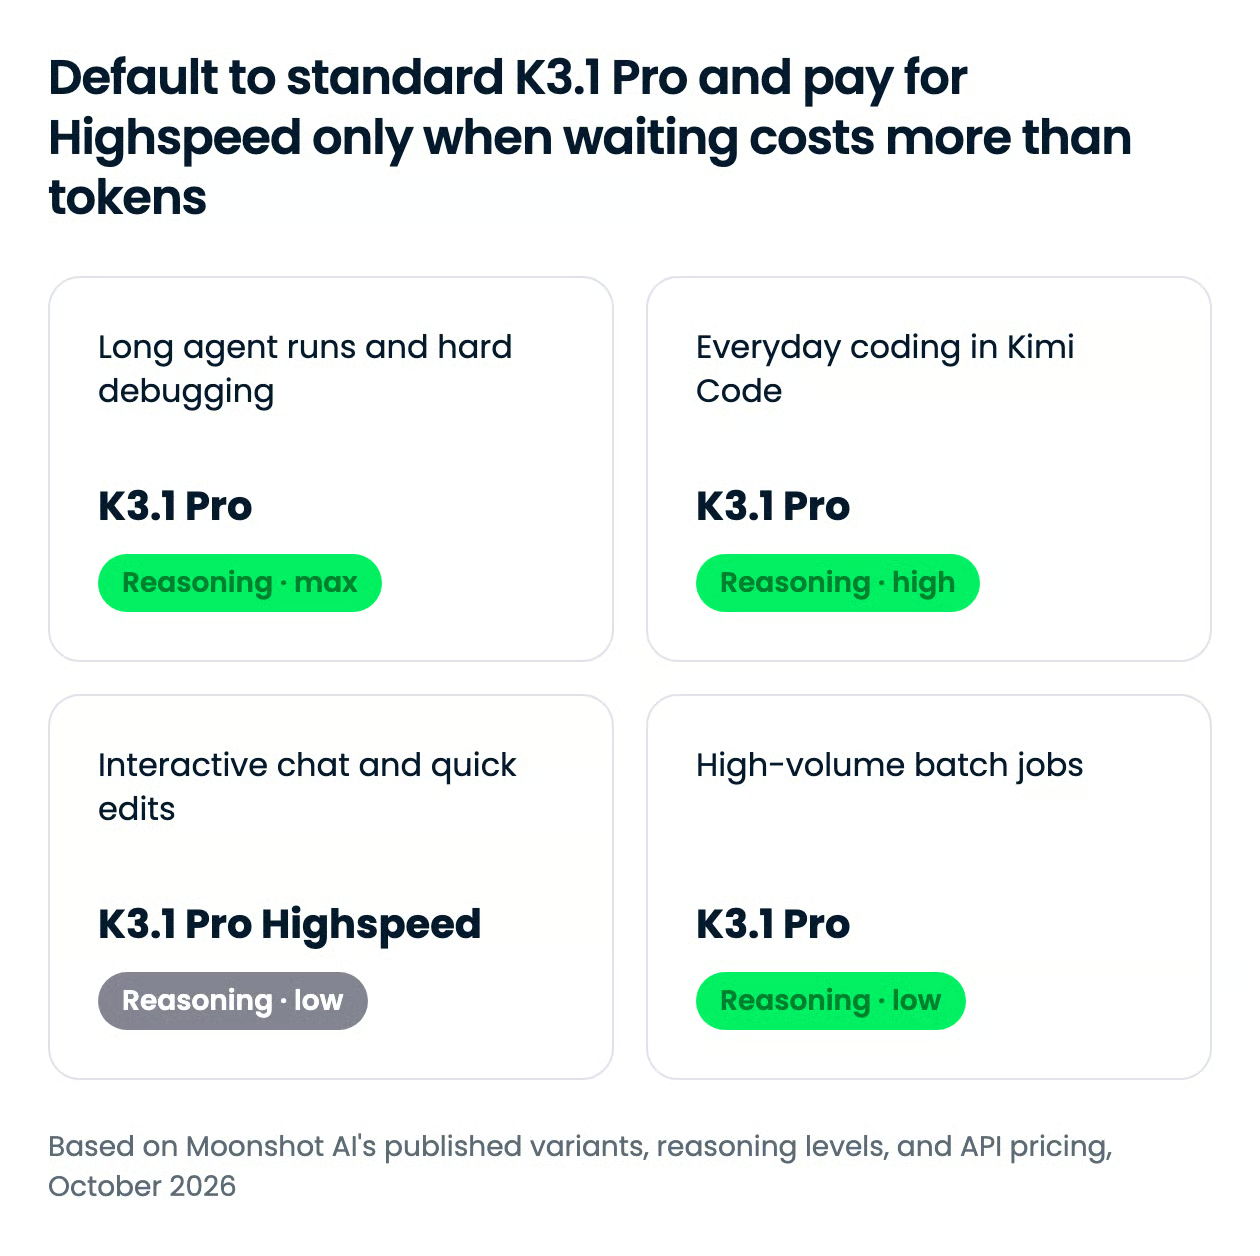
Moonshot Highspeed को केवल स्पीड पर बेचता है: यह 2–3× तेज़ चलता है, प्रति इनपुट और आउटपुट टोकन दोगुना खर्च कराता है, और इसके अलग बेंचमार्क परिणाम नहीं हैं।
दोनों वेरिएंट जवाब देने से पहले हमेशा सोचते हैं, और आप उसे बंद नहीं कर सकते। आप कठिनाई तीन रीजनिंग स्तरों से सेट करते हैं: सबसे कठिन एजेंट वर्क के लिए max, समझदारी भरा मध्य high, और जब डिफ़ॉल्ट सोचने का समय कार्य से ज़्यादा हो तो low। API का डिफ़ॉल्ट max है—यही सेटिंग Moonshot की बेंचमार्क तालिका के हर स्कोर के पीछे है—इसलिए जब तक कार्य को पूरी गहराई न चाहिए, इसे high या low पर लाएँ।
| उपयोग परिदृश्य | वेरिएंट | रीजनिंग स्तर | क्यों |
|---|---|---|---|
| लंबे एजेंट रन, कठिन डिबगिंग | K3.1 Pro | max |
Moonshot के कोडिंग स्कोर की सेटिंग; घंटों में स्पीड कम मायने रखती है |
| रोज़मर्रा की कोडिंग Kimi Code में | K3.1 Pro | high |
कम टोकन बिल पर ज़्यादातर क्वालिटी |
| इंटरैक्टिव चैट और त्वरित एडिट्स | K3.1 Pro Highspeed | low |
लेटेंसी बॉटलनेक है, और छोटे प्रॉम्प्ट 2× कीमत को छोटा रखते हैं |
| हाई-वॉल्यूम बैच जॉब्स | K3.1 Pro | low |
कोई इंतज़ार नहीं कर रहा, इसलिए कम रेट दें और सोचने का समय सीमित करें |
Kimi Code डॉक्यूमेंटेशन से एक अहम व्यावहारिक नोट: सेशन के बीच में रीजनिंग स्तर बदलने से कॉन्टेक्स्ट कैश अमान्य हो जाता है, इसलिए आगे-पीछे टॉगल करने की बजाय प्रति सेशन एक स्तर चुनें।
Kimi API पर Kimi K3.1 Pro की कीमत प्रति मिलियन इनपुट टोकन $2.00 और प्रति मिलियन आउटपुट टोकन $10.00 है, जो Kimi K3 से कम है। कीमतें पूरे 1M-टोकन कॉन्टेक्स्ट पर सपाट हैं—लॉन्ग-कॉन्टेक्स्ट सरचार्ज नहीं है।
| मॉडल | इनपुट | आउटपुट | कैश्ड इनपुट | 5-मिनट कैश राइट | 1-घंटा कैश राइट |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (पिछली पीढ़ी) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
कीमतें प्रति मिलियन टोकन हैं और टैक्स अलग है। कैशिंग स्वतः 5-मिनट डिफ़ॉल्ट के साथ होती है, और आप प्रति कॉल 1-घंटा टियर का अनुरोध कर सकते हैं।
योजना बनाने से पहले कुछ एक्सेस विवरण जानने लायक हैं:
अगर आप अभी भी K2-सीरीज़ मॉडलों पर हैं, तो Moonshot के डॉक्यूमेंट्स के अनुसार वे 31 अक्टूबर, 2026 से नए उपयोगकर्ताओं के लिए अनुपलब्ध होंगे और दिसंबर 2026 के अंत तक रिटायर कर दिए जाएँगे।
आप Kimi K3.1 Pro आज ही Kimi API, OpenRouter, और Kimi के अपने ऐप्स के ज़रिए इस्तेमाल कर सकते हैं, पर अभी डाउनलोडेबल वेट्स के तौर पर नहीं। Moonshot कहता है कि पूरे वेट्स 4 नवंबर, 2026 तक जारी होंगे, और इसकी घोषणा में लाइसेंस शर्तों का उल्लेख नहीं है, इसलिए वेट्स आने पर मॉडल कार्ड जाँचें।
kimi-k3.1-pro और kimi-k3.1-pro-highspeed, OpenAI-कम्पैटिबल एंडपॉइंट पर।moonshotai/kimi-k3.1-pro के रूप में सूचीबद्ध।/model कमांड से इसे चुनें। Moonshot के डॉक्यूमेंट्स में इसे Kimi Responses API के ज़रिए Codex से जोड़ना भी कवर है।OpenAI Python क्लाइंट के साथ न्यूनतम कॉल कुछ इस तरह दिखता है:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
वेट्स आने के बाद, हमारे लोकली LLMs चलाने वाले गाइड में सर्विंग विकल्प दिए गए हैं, और OpenCode पर हमारा एक्सप्लेनर दिखाता है कि ऐसे मॉडल को ओपन-सोर्स कोडिंग एजेंट में कैसे प्लग करें।
Kimi K3.1 Pro अब तक का सबसे मज़बूत केस है कि ओपन-वेट मॉडल्स एजेंटिक कोडिंग पर क्लोज़्ड फ्रंटियर की बराबरी कर सकते हैं—और वह भी अपने पूर्ववर्ती से कम कीमत पर। यह जनरल रीजनिंग लीडर नहीं है, लेकिन लंबी कोडिंग और टूल-हेवी एजेंट वर्क के लिए यह Claude Opus 5.5 के बिल्कुल बगल में बैठता है और कई टास्क पर GPT-6 Astra से आगे है।
Moonshot यह दांव भी लगा रहा है कि अपने साइबर ट्रेड-ऑफ़्स को प्रकाशित करने से इसकी ओपन रिलीज़ के लिए सद्भावना मिलेगी। अगर आप एजेंट्स के साथ कोड करते हैं, तो मैं इसे अभी API के ज़रिए आज़माने और नवंबर में वेट्स और मॉडल कार्ड आते ही सेल्फ-होस्टिंग पर फिर विचार करने की सलाह दूँगा।
अगर आप ऐसे ओपन मॉडलों के साथ काम करने के इच्छुक हैं, तो मैं हमारा Hugging Face Fundamentals स्किल ट्रैक देखने की सिफ़ारिश करता हूँ।
DataCamp के साथ AI सीखें!
कोर्स
लर्निंग पाथ
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें