강의
Hugging Face 활용하기
2시간
40K
실습 문제하고 트랙하세요.
Google로 계속하기오픈 웨이트 연구실들은 2026년 내내 코딩 분야에서 Anthropic과 OpenAI와의 격차를 줄여 왔고, Moonshot AI가 그 간극을 다시 좁혔습니다. 지난 금요일, Moonshot은 자사의 가장 강력한 3T급 오픈 웨이트 모델이라 부르는 Kimi K3.1 Pro를 공개했으며, 에이전트형 코딩에서 Claude Opus 5.5와 1점 차이 내에 들었다고 밝혔습니다.
K3.1 Pro는 100만 토큰 컨텍스트 윈도우를 가진 Kimi K3를 대폭 사후 학습(post-training)한 버전입니다. 더 빠른 변형인 K3.1 Pro Highspeed와 함께 제공되며, 오늘부터 Kimi 앱, Kimi Code, Kimi API에서 사용할 수 있습니다. 전체 웨이트는 2026년 11월 4일까지 공개됩니다.
이 글에서는 Kimi K3.1 Pro의 새로운 기능, 벤치마크, 그리고 Kimi K3 대비 가격 비교까지 핵심 업데이트를 모두 다룹니다. 기반이 된 모델이 궁금하시다면 우리의 Kimi K3 소개와 Kimi K3 실습 튜토리얼을 참고하세요.
Kimi K3.1 Pro는 Moonshot AI의 플래그십 대규모 언어 모델(LLM)로, 새로운 K3.1 시리즈의 첫 모델입니다. 100만 토큰 컨텍스트 윈도우를 가진 2.8T 파라미터의 Kimi K3를 기반으로 유지하면서, 그 위에 훨씬 많은 사후 학습 계산을 추가했습니다.
변화는 아키텍처가 아니라 학습에 있습니다. Moonshot은 이른바 "수백 개의 다운스트림 도메인" 전반에서 공동 강화 학습(RL)을 수행했고, 추가 계산이 꾸준한 이득으로 이어지도록 RL 프레임워크, 샌드박스 인프라, 롤아웃 스케줄링을 재구축했습니다. Moonshot에 따르면 그 결과 측정한 모든 영역에서 향상이 있었고, 특히 코딩, 3D 제작, 금융 리서치가 두드러졌습니다.
핵심 주장은 최고 수준의 독점 모델과 에이전트형 코딩에서 동등하다는 것입니다. Moonshot의 자체 표에 따르면, K3.1 Pro는 터미널 기반 코딩 작업에서 Anthropic의 가격 대비 일부만 청구하면서 Claude Opus 5.5와 1점 차이 내에 있습니다. 모델은 오픈 웨이트지만, 아직 웨이트는 공개되지 않았습니다.
K3.1 Pro는 단일 기능보다 폭넓은 업그레이드입니다. 실제로 워크플로를 바꿀 만한 능력 네 가지를 꼽으면 다음과 같습니다.
K3.1 Pro는 길고 다단계의 코딩 작업을 지속적으로 수행하며, 단순 재시도 대신 스스로 실패를 진단합니다. Moonshot의 데모는 오픈 소스 human-atlas 해부학 모델(296개의 골격, 402개의 근육 구성요소)을 기반으로 한 인간 보행 시뮬레이터입니다.
167개의 미션과 420건의 독립 리뷰 전반에서, 모델은 몇 초 만에 쓰러지던 시뮬레이션 인간을 교대로 보폭을 내디디며 11.2초간 걷게 만들었습니다. 흥미로운 부분은 보상 셰이핑이 팔 동작 향상에 더 이상 도움이 되지 않았을 때입니다. K3.1 Pro는 시뮬레이터를 오픈 루프로 탐색해 어깨 근육의 모멘트 암 계산에서 36개의 오류를 찾아내고 수정한 뒤 재학습을 진행했습니다.
이는 내부 데모 하나에 불과하므로, 증거라기보다 의도된 사용 사례를 보여주는 예시로 보세요. 그럼에도 Moonshot이 최적화하는 방향—탐구하고 반복하는 에이전트—을 잘 드러냅니다.
Moonshot에 따르면, K3.1 Pro는 프런트엔드 페이지, Three.js 장면, 3D 자산을 "더 탄탄한 구성, 타이포그래피, 애니메이션, 마감"으로 생성합니다. Unity, Unreal Engine, Godot을 지원하며, 웹 검색과 3D 생성을 결합해 완성형 프로젝트를 조립할 수 있습니다.
모델링 측면에서는, K3.1 Pro가 Blender와 CAD 소프트웨어용 스크립트를 MCP 커넥터 없이 직접 작성하고 실행하여, 기계 부품, 건축 모델, 구성 가능한 가구 같은 파라메트릭 모델을 구축합니다. Moonshot은 kimi.ai와 Kimi 앱에 3D Make도 출시해, 3D 프린팅 준비가 된 모델을 미리 보고, 편집하고, 다운로드할 수 있게 했습니다.
시각적 품질 주장은 벤치마크 표로 검증하기 가장 어려운 항목이기도 하므로, 벤더가 제시한 데모는 평균 성과가 아닌 최선의 예시로 보시는 편이 좋습니다.
K3.1 Pro는 스크리닝부터 완성된 워크북까지 금융 워크플로를 수행할 수 있으며, 이 유형의 작업에서 사실 정확성을 높이기 위한 표적 개선이 이뤄졌습니다. 내부 금융 벤치마크에서, K3.1 Pro는 Financial Modeling에서 Kimi K3 대비 7.2점, Financial Research에서 11.6점 향상했고, 장기 지평선의 시뮬레이션 비즈니스 과제인 Business Operation에서는 K3의 약 4.2배 점수에 도달했습니다.
정확성 개선은 Moonshot의 환각(할루시네이션) 스트레스 테스트에서도 드러납니다. Kimi Hallu Bench Hard에서, 주장 단위 환각률은 K3의 23.4%에서 K3.1 Pro의 8.3%로 낮아졌습니다. Moonshot은 이 테스트가 오류를 유발하도록 설계되었다고 분명히 밝히므로, 해당 수치가 일상적 오류율을 의미하지는 않습니다.
Kimi K3.1 Pro는 에이전트형 코딩과 도구 중심 작업에서 Claude Opus 5.5와 GPT-6 Astra와 경쟁하지만, 순수 추론에서는 분명 뒤처집니다. 아래 모든 수치는 Moonshot의 발표에서 가져왔으며, K3.1 Pro는 max 강도로 설정되어 있습니다.
에이전트형 코딩은 K3.1 Pro가 가장 강하게 보이는 영역입니다. 현실적이고 자원 제약이 있는 터미널 작업에서 코딩 에이전트를 채점하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록했습니다. 이는 Claude Opus 5.5의 66.4%에 아주 근소하게 뒤지며, GPT-6 Astra의 58.2%를 크게 앞섭니다.
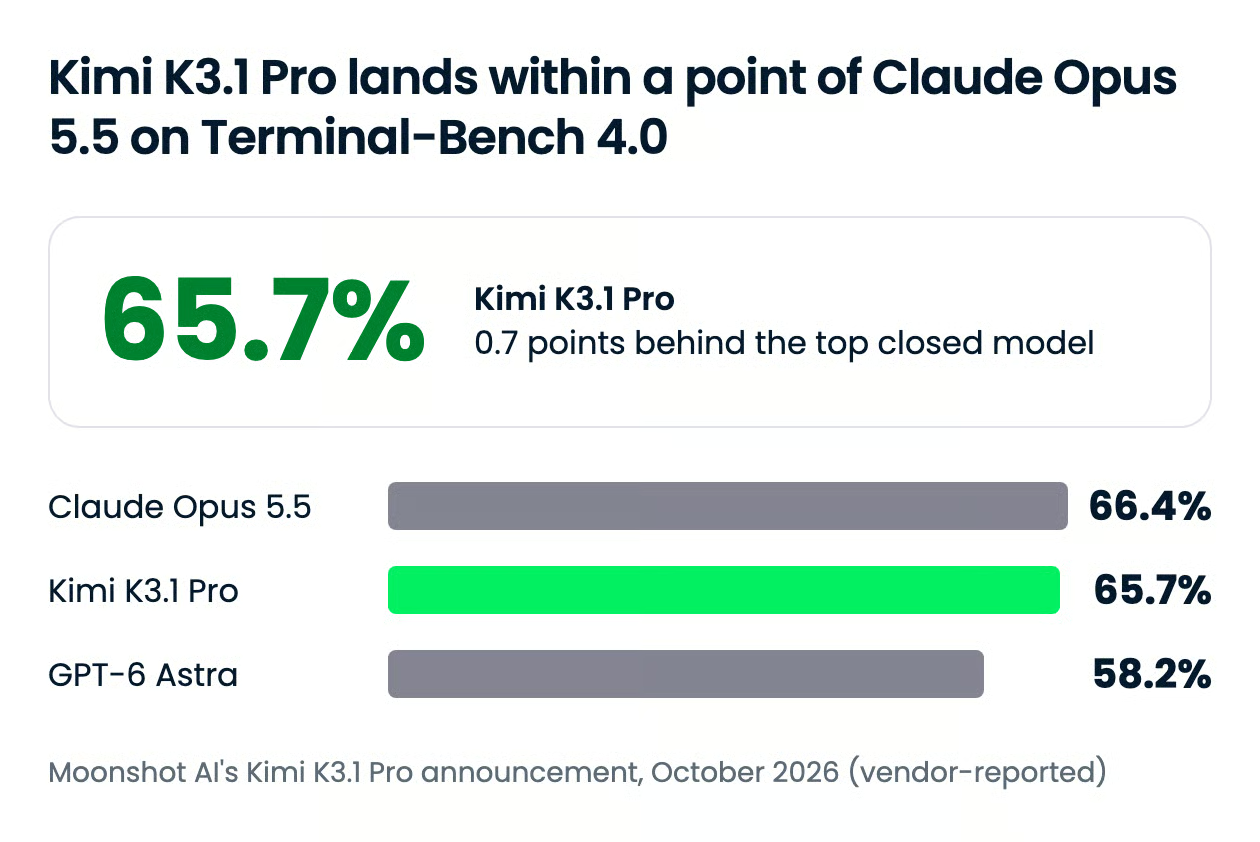
나머지 코딩 결과는 이 헤드라인만큼 일관되지는 않습니다. 모든 점수는 벤더가 보고했으며, 각 행의 최고 점수는 볼드로 표시했습니다:
| 벤치마크 | 평가 대상 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 현실적 터미널 작업에서의 코딩 에이전트 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 인터넷 없이 진행하는 20개의 수시간 엔지니어링 과제 | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 행동을 기준으로 채점하는 113개의 장기 과제 | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (Moonshot 내부) | 다단계 실행과 도구 사용 | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | 바이너리와 명세만으로 프로그램 재구성(테스트 95% 이상 통과 과제 비율) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | 과학 연구 워크플로에서의 에이전트 | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro는 긴 엔지니어링 과제에서 최고 폐쇄형 모델과 대등하며, Moonshot의 SWE-Marathon 비교에서는 선두입니다. DeepSWE의 경우 각 연구실이 자체 세팅을 사용했으므로 3점 격차는 승부라기보다 동률에 가깝습니다. 반면 관찰된 동작만으로 프로그램을 재구성하거나 과학 연구 워크플로를 수행해야 할 때는 크게 뒤처집니다.
전작 대비 가장 분명한 향상은 Moonshot의 자체 장기 벤치마크로, Kimi K3는 55.95%였습니다.
도구 중심의 에이전트 작업에서는, K3.1 Pro가 Opus 5.5에 근접하거나 앞섭니다:
| 벤치마크 | 평가 대상 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | 2,500개의 고난도 지식·추론 질문, 도구 사용 허용 | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | 웹에서 찾기 어려운 정보 탐색 | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | 실제 금융 PDF 전반에서의 수치 분석 | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | 스크리닝부터 수익성 분석까지의 투자 워크플로 | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | 데스크톱 컴퓨터 조작으로 과제 수행 | 79.6% | 81.8% | 75.8% | 69.3% |
Moonshot의 표에서 한 가지 분명한 예외는 컴퓨터 사용으로, 이 부분에서는 Opus 5.5가 앞섭니다. Frontier Finance에서는 Claude Fable 5.1(60.8)이 네 모델 모두를 제치고 전체 선두입니다.
도구 없이 순수하게 보면, K3.1 Pro는 폐쇄형 모델보다 확연히 뒤처집니다:
| 벤치마크 | 평가 대상 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2,500개의 고난도 지식·추론 질문 | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | HLE의 최난도 1,000문항 서브셋 | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | 대학원 수준의 과학 질문 | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | 이미지와 텍스트를 결합한 질문 | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (Moonshot 내부, 낮을수록 좋음) | 사실 주장 중 오류 비율 | 5.4% | 6.8% | 4.2% | 13.1% |
격차는 HLE-Diamond에서 가장 큽니다. GPQA-Diamond는 이미 포화에 가까워 2점 격차의 의미가 작습니다. 작업이 어려운 클로즈드 북 추론이라면, 이 모델로 교체할 이유는 크지 않습니다.
Moonshot은 오픈 웨이트 공개에서 이례적인 일을 했습니다. 의도적으로 얼마나 능력을 줄였는지 수치를 공개한 것입니다. 중간 단계 학습 데이터와 RL 환경의 사이버 관련 콘텐츠가 취약점 연구 역량을 꾸준히 끌어올린다는 사실을 확인하고, 오픈 웨이트 공개를 위해 두 단계 모두에서 그 데이터를 제거했습니다.
Moonshot의 내부 익스플로잇 개발 벤치마크인 xdev-bench-hard에서, 데이터 제거 전 체크포인트는 90.5%의 문제를 해결(pass@3)했습니다. 배포된 K3.1 Pro는 81.0%를 해결하며, 이는 여전히 Kimi K3의 33.3%를 크게 상회합니다. 공개 사이버 벤치마크에서는 Opus 5.5의 91.0에 비해 ExploitBench 74.7을 기록해, Moonshot이 비교한 모든 폐쇄형 모델보다 낮습니다.
Moonshot은 공격적 사이버 역량의 절대적 프런티어를 밀어 올리는 오픈 웨이트 공개를 피하되, 오픈 웨이트의 기준선을 점진적으로 높이겠다는 원칙을 밝히고 있습니다. 9.5포인트 삭감이 충분한지는 판단의 문제지만, 수치를 공개하는 것만으로도 많은 연구실보다 투명합니다.
대부분의 경우 표준 K3.1 Pro가 기본값으로 적합합니다. Highspeed 변형은 사람이 출력 대기 중일 때처럼 지연이 비용보다 중요할 때만 높은 가격을 정당화합니다.
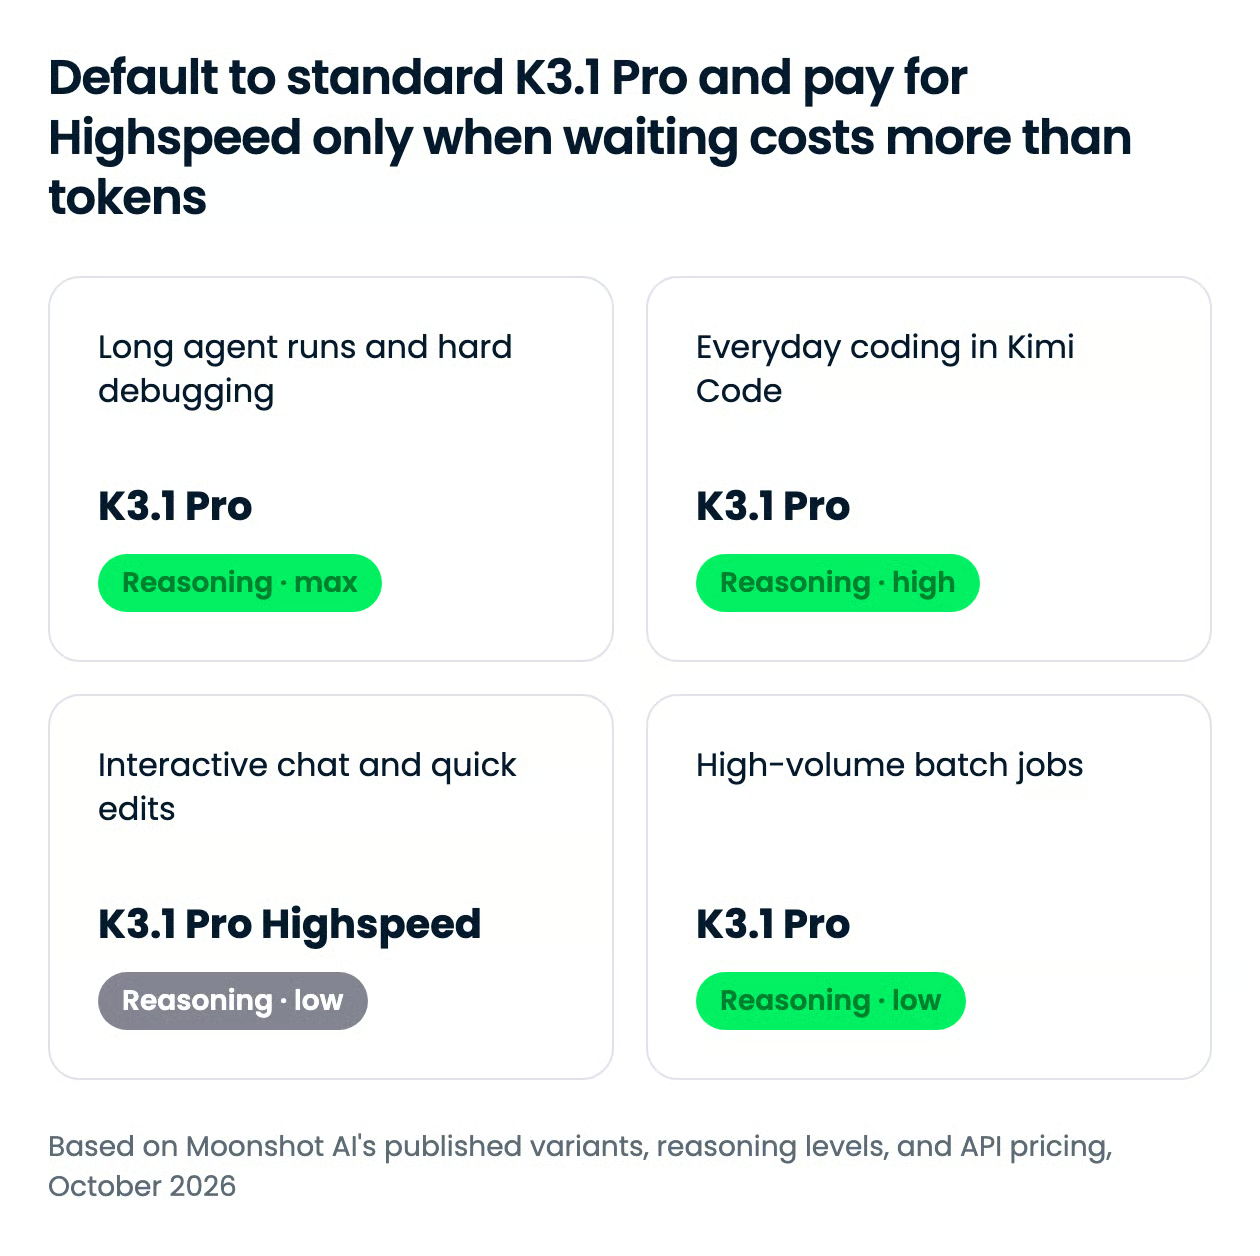
Moonshot은 Highspeed를 오직 속도로만 판매합니다. 2–3배 빠르게 실행되고, 입·출력 토큰당 비용이 2배이며, 별도의 벤치마크 결과는 없습니다.
두 변형 모두 답변 전 항상 사고 과정을 거치며, 이를 끌 수는 없습니다. 대신 세 가지 추론 수준으로 강도를 조절합니다. 가장 어려운 에이전트 작업에는 max, 합리적인 중간값인 high, 기본 사고 시간이 과제에 비해 과할 때는 low를 쓰세요. API 기본값은 Moonshot의 모든 벤치마크 점수에 사용된 max이므로, 과제가 풀 심도가 필요하지 않으면 high나 low로 낮추는 것이 좋습니다.
| 사용 사례 | 변형 | 추론 수준 | 이유 |
|---|---|---|---|
| 장시간 에이전트 실행, 난도 높은 디버깅 | K3.1 Pro | max |
Moonshot의 코딩 점수에 쓰인 설정; 수시간 작업에서는 속도 중요도가 낮음 |
| Kimi Code에서의 일상 코딩 | K3.1 Pro | high |
더 낮은 토큰 비용으로 대부분의 품질 확보 |
| 대화형 채팅과 빠른 수정 | K3.1 Pro Highspeed | low |
지연이 병목이며, 짧은 프롬프트는 2배 가격 부담을 작게 유지 |
| 대량 배치 작업 | K3.1 Pro | low |
대기자가 없으니 더 낮은 요금을 내고 사고 시간을 제한 |
Kimi Code 문서의 실무 팁: 세션 중간에 추론 수준을 바꾸면 컨텍스트 캐시가 무효화됩니다. 오가며 바꾸지 말고 세션당 하나를 선택하세요.
Kimi K3.1 Pro의 Kimi API 요금은 입력 토큰 백만 개당 $2.00, 출력 토큰 백만 개당 $10.00이며, Kimi K3보다 저렴합니다. 전체 100만 토큰 컨텍스트에 대해 일률 요금이며, 장문 컨텍스트 추가 요금이 없습니다.
| 모델 | 입력 | 출력 | 캐시된 입력 | 5분 캐시 기록 | 1시간 캐시 기록 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (이전 세대) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
가격은 토큰 백만 개당이며 세금은 별도입니다. 캐싱은 기본 5분으로 자동 적용되며, 호출 단위로 1시간 티어를 요청할 수 있습니다.
계획에 앞서 알아두면 좋은 접근 관련 사항은 다음과 같습니다.
아직 K2 시리즈 모델을 사용 중이라면, Moonshot 문서에 따르면 2026년 10월 31일부터 신규 사용자 이용이 중단되고, 2026년 12월 말까지 퇴역합니다.
Kimi K3.1 Pro는 오늘 기준 Kimi API, OpenRouter, Kimi 자체 앱에서 사용할 수 있으나, 아직 다운로드 가능한 웨이트는 아닙니다. Moonshot은 전체 웨이트를 2026년 11월 4일까지 공개한다고 밝혔으며, 발표문에는 라이선스 조건이 언급되지 않았으니 웨이트가 공개되면 모델 카드를 확인하세요.
kimi-k3.1-pro와 kimi-k3.1-pro-highspeed이며, OpenAI 호환 엔드포인트에서 제공합니다.moonshotai/kimi-k3.1-pro로 등재되어 있습니다./model 명령으로 선택합니다. Moonshot 문서에는 Kimi Responses API를 통해 Codex에 연결하는 방법도 포함되어 있습니다.OpenAI Python 클라이언트로 최소한의 호출 예시는 다음과 같습니다:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
웨이트가 공개되면, 로컬에서 LLM 실행 가이드에서 서빙 옵션을 확인할 수 있으며, OpenCode 설명서를 통해 이런 모델을 오픈 소스 코딩 에이전트에 연결하는 방법을 알아볼 수 있습니다.
Kimi K3.1 Pro는 오픈 웨이트 모델이 에이전트형 코딩에서 폐쇄형 프런티어와 대등해질 수 있음을 가장 강하게 보여주는 사례로, 전작보다도 낮은 가격을 제시합니다. 일반 추론의 선두주자는 아니지만, 장기 코딩과 도구 중심의 에이전트 작업에서는 Claude Opus 5.5와 어깨를 나란히 하며, 여러 과제에서 GPT-6 Astra를 앞섭니다.
Moonshot은 또한 사이버 관련 트레이드오프를 공개함으로써 오픈 공개에 대한 신뢰를 얻겠다는 승부수를 던졌습니다. 에이전트로 코딩한다면, 지금은 API로 써 보고, 11월에 웨이트와 모델 카드가 공개되면 셀프 호스팅을 다시 검토해 보세요.
이와 같은 오픈 모델에 관심이 있다면, 우리의 Hugging Face Fundamentals 스킬 트랙을 추천합니다.
DataCamp으로 AI를 배워보세요!
강의
트랙
실습 문제하고 트랙하세요.
Google로 계속하기