Curso
Trabajar con Hugging Face
2 h
40K
Practica y programa tu progreso.
Continuar Con GoogleLos laboratorios de modelos con pesos abiertos han pasado 2026 recortando distancias con Anthropic y OpenAI en programación, y Moonshot AI acaba de apretar aún más. El viernes pasado, Moonshot lanzó Kimi K3.1 Pro, su modelo open-weight más capaz de la clase 3T hasta la fecha, que se queda a un punto de Claude Opus 5.5 en agentic coding.
K3.1 Pro es una versión de Kimi K3 con post-entrenamiento intensivo y una ventana de contexto de 1 millón de tokens. Llega junto a una variante más rápida, K3.1 Pro Highspeed, y ya está disponible en las apps de Kimi, Kimi Code y la API de Kimi. Los pesos completos saldrán el 4 de noviembre de 2026.
En este artículo, repaso todo lo nuevo de Kimi K3.1 Pro: funciones, benchmarks y cómo quedan los precios frente a Kimi K3. Si quieres ponerte al día con el modelo en el que se basa, echa un vistazo a nuestras guías de Kimi K3 y al tutorial práctico de Kimi K3.
Kimi K3.1 Pro es el LLM insignia de Moonshot AI y el primero de su nueva serie K3.1. Mantiene la base de Kimi K3, un modelo de 2,8T parámetros con una ventana de contexto de 1M de tokens, y añade mucho más cómputo de post-entrenamiento por encima.
El cambio está en el entrenamiento, no en la arquitectura: Moonshot ejecutó aprendizaje por refuerzo (RL) conjunto en lo que denomina "cientos de dominios downstream", y rehízo su framework de RL, la infraestructura de sandbox y la planificación de rollouts para que el cómputo extra se tradujera en mejoras constantes. Según Moonshot, el resultado es una mejora en todos los dominios medidos, destacando programación, creación 3D e investigación financiera.
La gran promesa es la paridad en agentic coding con los mejores modelos propietarios. La propia tabla de Moonshot sitúa a K3.1 Pro a menos de un punto de Claude Opus 5.5 en tareas de programación basadas en terminal, cobrando una fracción del precio de Anthropic. El modelo es open-weight, aunque los pesos aún no son públicos.
K3.1 Pro es una mejora amplia, no un solo truco nuevo. Estas cuatro capacidades sí justifican cambiar un flujo de trabajo.
K3.1 Pro se mantiene en tareas de programación largas y multipaso, diagnosticando sus propios fallos en lugar de limitarse a reintentar. El ejemplo de Moonshot es un simulador de marcha humana construido sobre el modelo anatómico open-source human-atlas, con 296 elementos óseos y 402 componentes musculares.
En 167 misiones y 420 revisiones independientes, el modelo pasó de que el humano simulado se derrumbara a los pocos segundos a caminar con zancadas alternas durante 11,2 segundos. Lo interesante llegó cuando el reward shaping dejó de mejorar el movimiento del brazo: K3.1 Pro ejecutó pruebas open-loop del simulador, detectó 36 errores en los cálculos del momento de palanca de los músculos del hombro, los corrigió y volvió a entrenar.
Es una demo interna, así que tómatela como ilustración del caso de uso previsto, no como evidencia. Aun así, muestra la apuesta de Moonshot: agentes que investigan y reiteran.
Moonshot afirma que K3.1 Pro genera páginas front-end, escenas de Three.js y assets 3D con "mejor composición, tipografía, animación y acabado". Funciona con Unity, Unreal Engine y Godot, y puede combinarlos con búsqueda web y generación 3D para ensamblar un proyecto completo.
En la parte de modelado, K3.1 Pro escribe y ejecuta scripts para Blender y software CAD directamente, sin conectores MCP, para construir modelos paramétricos como piezas mecánicas, modelos arquitectónicos y mobiliario configurable. Moonshot también lanzó 3D Make en kimi.ai y la app de Kimi, donde puedes previsualizar, editar y descargar modelos listos para impresión 3D.
La promesa de calidad visual también es la más difícil de contrastar en una tabla de benchmarks, así que toma las demos de Moonshot como sus mejores ejemplos, no como resultado típico.
K3.1 Pro puede llevar un flujo financiero desde el screening hasta un workbook final, y Moonshot ha aplicado correcciones dirigidas a la exactitud factual para este tipo de tareas. En sus benchmarks internos de finanzas, K3.1 Pro mejora a Kimi K3 en 7,2 puntos en Financial Modeling y 11,6 puntos en Financial Research, y alcanza ~4,2× la puntuación de K3 en Business Operation, una tarea de negocio simulada a largo plazo.
Ese trabajo en precisión se nota en la prueba de estrés de alucinaciones de Moonshot. En Kimi Hallu Bench Hard, la tasa de alucinación a nivel de afirmación cayó del 23,4% en K3 al 8,3% en K3.1 Pro. Moonshot aclara que el test está diseñado para provocar errores, así que esas tasas no reflejan el día a día.
Kimi K3.1 Pro compite con Claude Opus 5.5 y GPT-6 Astra en agentic coding y tareas con mucho uso de herramientas, pero queda por detrás en razonamiento puro. Todas las cifras proceden del anuncio de Moonshot, con K3.1 Pro a esfuerzo max.
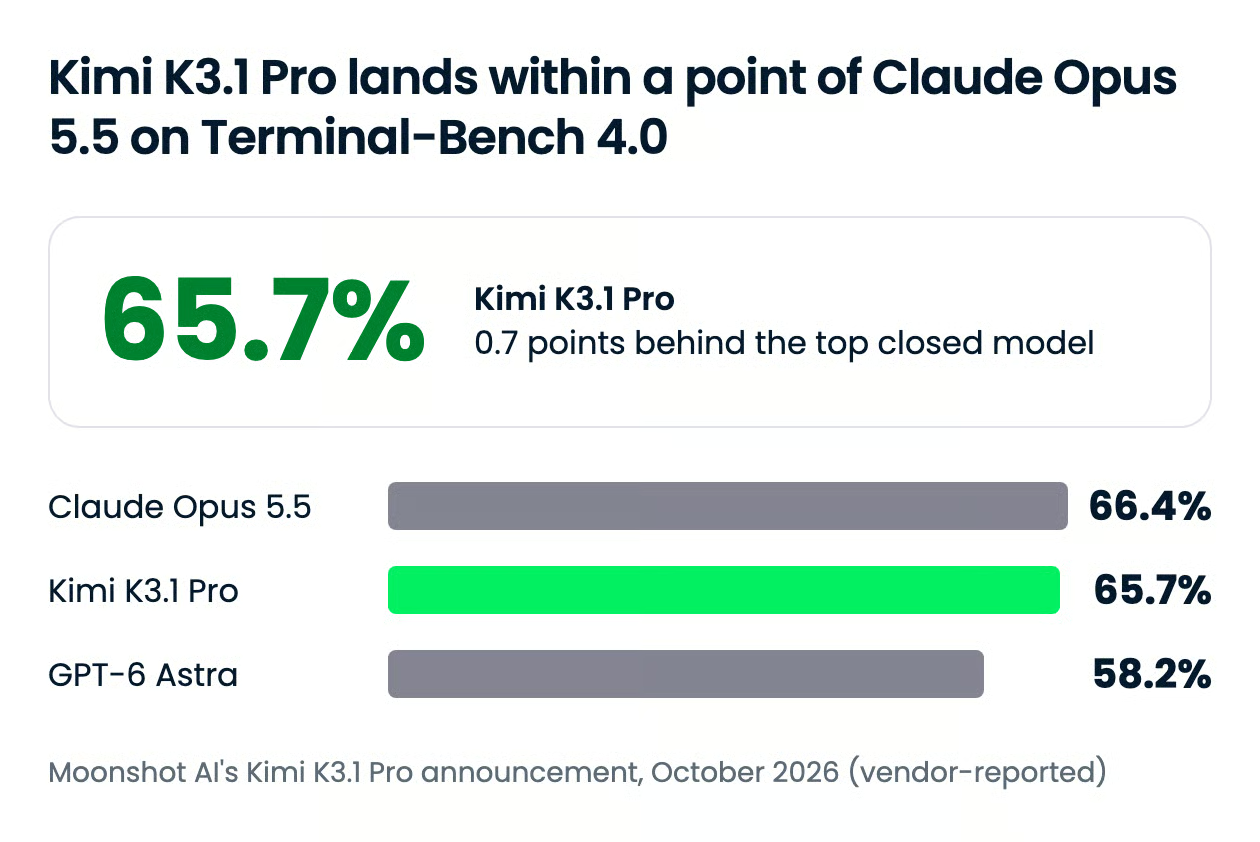
El agentic coding es donde K3.1 Pro se ve más fuerte. En Terminal-Bench 4.0, que evalúa agentes de código en tareas realistas y con recursos limitados en terminal, K3.1 Pro logra un 65,7%. Está a muy poco de Claude Opus 5.5 con 66,4% y por delante de GPT-6 Astra con 58,2%.
El resto de resultados en programación son más mixtos de lo que sugiere ese titular. Todas las puntuaciones son reportadas por los proveedores, con la mejor de cada fila en negrita:
| Benchmark | Qué mide | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agentes de código en tareas realistas de terminal | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 tareas de ingeniería de varias horas, sin internet | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 tareas a largo plazo, evaluadas por comportamiento | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (interno de Moonshot) | Ejecución multipaso y uso de herramientas | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Reconstruir un programa desde su binario y especificación (tareas con ≥95% de tests superados) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agentes en flujos de investigación científica | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro está a la par de los mejores modelos cerrados en tareas largas de ingeniería y lidera la comparación de SWE-Marathon de Moonshot. En DeepSWE, cada laboratorio corrió su propia configuración, así que una diferencia de 3 puntos es más un empate que una victoria. Se queda muy atrás cuando tiene que reconstruir un programa solo desde su comportamiento observado, o seguir un flujo de trabajo científico.
Frente a su predecesor, la mejora más clara es en el benchmark de largo plazo de Moonshot, donde Kimi K3 marcó 55,95%.
En tareas de agentes con mucho uso de herramientas, K3.1 Pro lidera o se queda a un par de puntos de Opus 5.5:
| Benchmark | Qué mide | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full con herramientas | 2.500 preguntas difíciles de conocimiento y razonamiento, con herramientas | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Encontrar información difícil de localizar en la web | 92,1% | 90,8% | 91,5% | n/a |
| OfficeQA Pro v2 | Análisis numérico en PDFs financieros reales | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Flujos de inversión: del screening al análisis de rentabilidad | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Manejar un ordenador de escritorio para completar tareas | 79,6% | 81,8% | 75,8% | 69,3% |
La excepción clara en la tabla de Moonshot es el uso del ordenador, donde Opus 5.5 se mantiene por delante. En Frontier Finance, Claude Fable 5.1 (60,8) es el líder general, por encima de los cuatro modelos mostrados aquí.
Sin herramientas, K3.1 Pro cae con claridad frente a los modelos cerrados:
| Benchmark | Qué mide | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 preguntas difíciles de conocimiento y razonamiento | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | Subconjunto más difícil de HLE (1.000 preguntas) | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Preguntas de ciencias a nivel posgrado | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Preguntas que combinan imágenes y texto | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (interno de Moonshot, menor es mejor) | Proporción de afirmaciones factuales erróneas | 5,4% | 6,8% | 4,2% | 13,1% |
La mayor brecha está en HLE-Diamond, mientras que GPQA-Diamond está casi saturado, así que sus 2 puntos dicen poco. Si tu trabajo es razonamiento duro en modo closed-book, este no es el modelo al que cambiar.
Moonshot hizo algo inusual en un lanzamiento open-weight: publicó cuánta capacidad retiró deliberadamente. Detectó que el contenido relacionado con ciberseguridad en sus datos de entrenamiento intermedios y entornos de RL elevaba de forma constante la habilidad en investigación de vulnerabilidades, así que eliminó esos datos en ambas etapas para el lanzamiento open-weight.
En xdev-bench-hard, el benchmark interno de desarrollo de exploits, un checkpoint sin esa eliminación resolvió el 90,5% de los problemas (pass@3). El K3.1 Pro publicado resuelve el 81,0%, aún muy por encima del 33,3% de Kimi K3. En benchmarks públicos de ciber, queda por debajo de todos los modelos cerrados comparados por Moonshot, con 74,7 en ExploitBench frente a 91,0 de Opus 5.5.
El principio declarado de Moonshot es evitar publicar pesos abiertos que empujen la frontera absoluta de capacidad ofensiva en ciberseguridad, elevando el listón open-weight de forma gradual. Si un recorte de 9,5 puntos es suficiente es discutible, pero publicar el dato ya es más de lo que hacen muchos laboratorios.
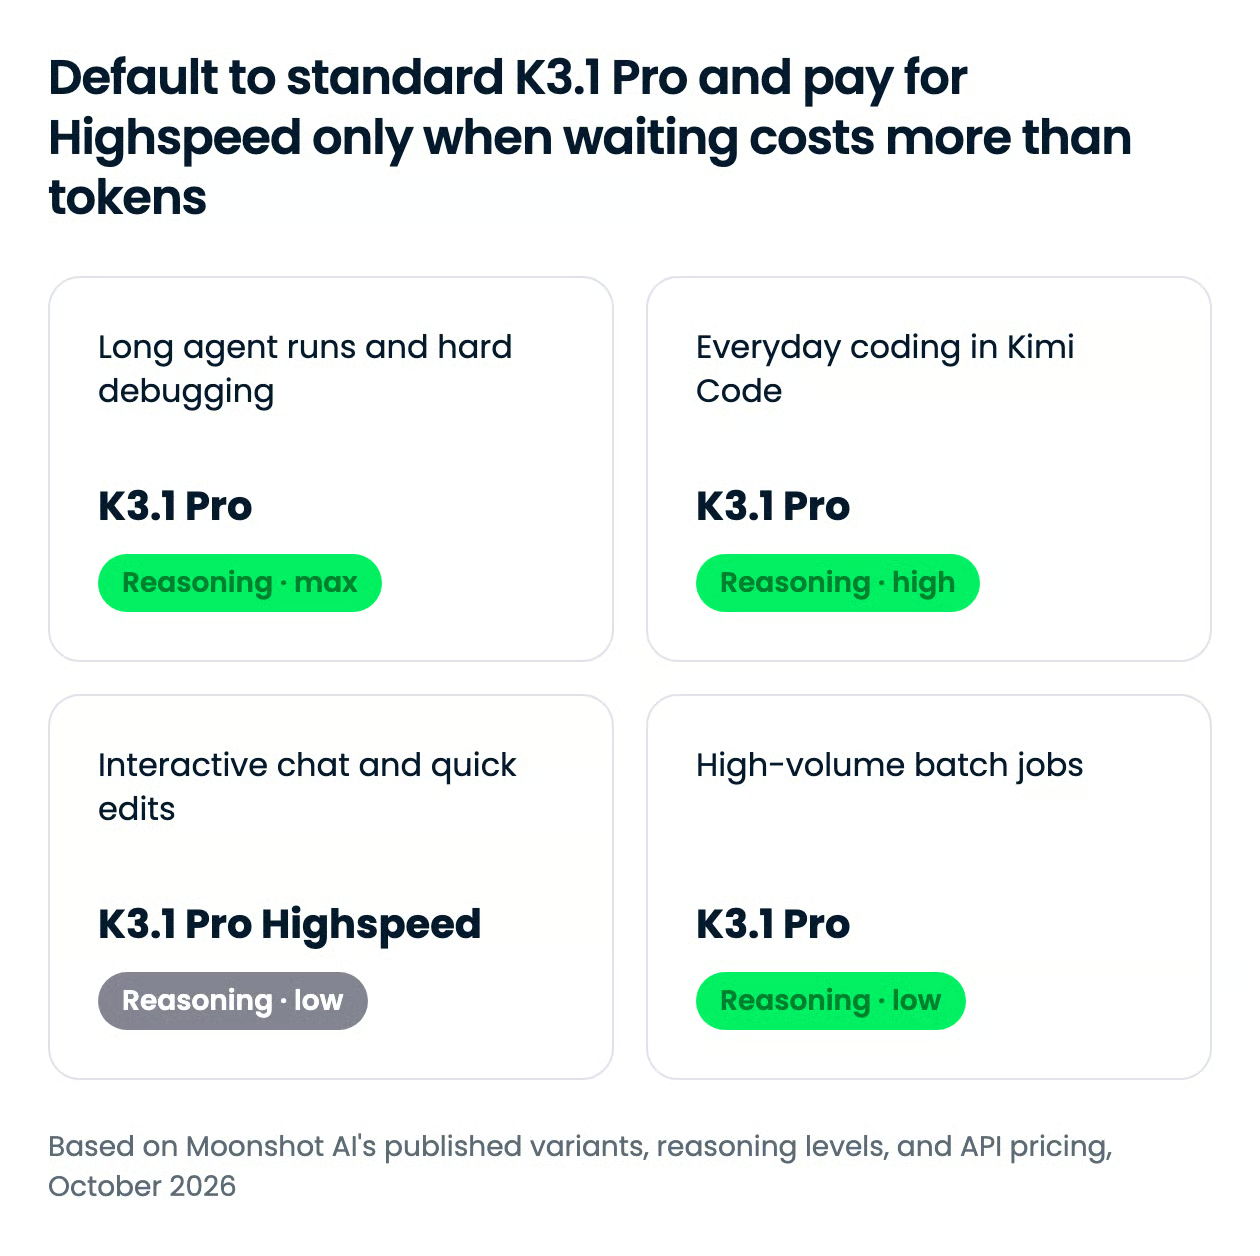
La versión estándar de K3.1 Pro es la elección por defecto para casi todo el mundo. La variante Highspeed solo compensa su mayor precio cuando hay una persona esperando la salida.
Moonshot vende Highspeed únicamente por velocidad: funciona 2–3× más rápido, cuesta el doble por token de entrada y salida, y no tiene resultados de benchmark propios.
Ambas variantes siempre "piensan" antes de responder, y no puedes desactivarlo. Tú decides cuánto con tres niveles de razonamiento: max para el trabajo de agente más exigente, high como punto medio sensato y low cuando el tiempo de reflexión por defecto es más del necesario. La API viene en max por defecto, el ajuste detrás de todas las puntuaciones de la tabla de Moonshot, así que bájalo a high o low salvo que la tarea requiera máxima profundidad.
| Caso de uso | Variante | Nivel de razonamiento | Por qué |
|---|---|---|---|
| Ejecuciones largas de agentes, debugging difícil | K3.1 Pro | max |
El ajuste detrás de las puntuaciones de programación de Moonshot; la velocidad importa menos a horas vista |
| Programación diaria en Kimi Code | K3.1 Pro | high |
Casi toda la calidad con una factura de tokens menor |
| Chat interactivo y ediciones rápidas | K3.1 Pro Highspeed | low |
La latencia es el cuello de botella, y los prompts cortos hacen pequeño el sobrecoste 2× |
| Procesos por lotes a gran escala | K3.1 Pro | low |
Nadie está esperando, así que paga menos y limita el tiempo de reflexión |
Una nota práctica importante de la documentación de Kimi Code: cambiar el nivel de razonamiento a mitad de sesión invalida la caché de contexto, así que elige un nivel por sesión en lugar de ir alternando.
Kimi K3.1 Pro cuesta 2,00 $ por millón de tokens de entrada y 10,00 $ por millón de tokens de salida en la API de Kimi, menos que Kimi K3. El precio es plano en todo el contexto de 1M de tokens, sin recargo por contexto largo.
| Modelo | Entrada | Salida | Entrada en caché | Escritura de caché 5 min | Escritura de caché 1 h |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 2,00 $ | 10,00 $ | 0,20 $ | 2,00 $ | 4,00 $ |
| Kimi K3.1 Pro Highspeed | 4,00 $ | 20,00 $ | 0,20 $ | 4,00 $ | 8,00 $ |
| Kimi K3 (generación anterior) | 3,00 $ | 15,00 $ | 0,30 $ | 3,00 $ | 6,00 $ |
Los precios son por millón de tokens y sin impuestos. La caché es automática con 5 minutos por defecto, y puedes solicitar el nivel de 1 hora por llamada.
Algunos detalles de acceso que conviene conocer antes de planificar:
Si aún usas modelos de la serie K2, la documentación de Moonshot indica que no estarán disponibles para nuevos usuarios a partir del 31 de octubre de 2026 y se retirarán a finales de diciembre de 2026.
Puedes usar Kimi K3.1 Pro hoy a través de la API de Kimi, OpenRouter y las apps de Kimi, pero aún no como pesos descargables. Moonshot afirma que los pesos completos se publicarán antes del 4 de noviembre de 2026 y no menciona términos de licencia en el anuncio, así que revisa la model card cuando salgan los pesos.
kimi-k3.1-pro y kimi-k3.1-pro-highspeed, en un endpoint compatible con OpenAI.moonshotai/kimi-k3.1-pro./model. La documentación de Moonshot también cubre la conexión con Codex mediante la Kimi Responses API.Una llamada mínima con el cliente de Python de OpenAI sería así:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Cuando salgan los pesos, nuestra guía sobre cómo ejecutar LLMs en local cubre las opciones de serving, y nuestro explicador sobre OpenCode muestra cómo conectar un modelo así a un agente de código open-source.
Kimi K3.1 Pro es la mejor prueba hasta ahora de que los modelos con pesos abiertos pueden medirse con la vanguardia cerrada en agentic coding, a un precio inferior al de su predecesor. No lidera en razonamiento general, pero para programación larga y agentes con muchas herramientas se sienta al lado de Claude Opus 5.5 y por delante de GPT-6 Astra en varias tareas.
Moonshot también apuesta por que publicar sus concesiones en ciberseguridad le gane buena voluntad para sus lanzamientos abiertos. Si programas con agentes, yo lo probaría ya vía API y reconsideraría el autoalojamiento cuando lleguen los pesos y la model card en noviembre.
Si te apetece trabajar con modelos abiertos como este, te recomiendo nuestro itinerario Hugging Face Fundamentals.
¡Aprende IA con DataCamp!
Curso
Programa
Practica y programa tu progreso.
Continuar Con Googleblog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
Tutorial
Abid Ali Awan
12 min