Kurs
Arbeiten mit Hugging Face
2 Std.
40K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleOpen-Weight-Labs haben 2026 den Rückstand beim Coden zu Anthropic und OpenAI verkleinert – und Moonshot AI hat ihn gerade erneut geschrumpft. Letzten Freitag brachte Moonshot Kimi K3.1 Pro heraus, laut Moonshot das bisher leistungsfähigste Open-Weight-Modell der 3T-Klasse – und auf Augenhöhe mit Claude Opus 5.5 beim agentischen Coden.
K3.1 Pro ist eine stark nachtrainierte Version von Kimi K3 mit einem Kontextfenster von 1 Million Tokens. Es erscheint zusammen mit einer schnelleren Variante, K3.1 Pro Highspeed, und ist ab sofort in den Kimi-Apps, in Kimi Code und über die Kimi API verfügbar. Die vollständigen Gewichte folgen bis zum 4. November 2026.
In diesem Artikel zeige ich alles Neue an Kimi K3.1 Pro: Features, Benchmarks und die Preise im Vergleich zu Kimi K3. Wenn du das zugrunde liegende Modell nachlesen möchtest, sieh dir unseren Guide zu Kimi K3 und unser praktisches Kimi K3-Tutorial an.
Kimi K3.1 Pro ist das Flaggschiff-Sprachmodell (LLM) von Moonshot AI und das erste Modell der neuen K3.1-Serie. Es behält die Basis von Kimi K3 – ein 2,8T-Parameter-Modell mit 1M-Token-Kontextfenster – und legt deutlich mehr Post-Training-Rechenzeit oben drauf.
Die Änderung liegt im Training, nicht in der Architektur: Moonshot führte gemeinsames Reinforcement Learning (RL) über „Hunderte nachgelagerter Domänen“ durch und baute sein RL-Framework, die Sandbox-Infrastruktur und das Rollout-Scheduling neu auf, sodass zusätzliche Rechenzeit stetige Zugewinne brachte. Laut Moonshot verbesserte sich das Modell in allen gemessenen Bereichen, besonders beim Coden, bei 3D-Erstellung und Finanzrecherche.
Die zentrale Aussage ist Parität beim agentischen Coden mit den besten proprietären Modellen. In Moonshots eigener Tabelle liegt K3.1 Pro bei terminalbasierten Coding-Aufgaben nur einen Punkt hinter Claude Opus 5.5 – bei einem Bruchteil des Anthropic-Preises. Das Modell ist Open-Weight, aber die Gewichte sind noch nicht öffentlich.
K3.1 Pro ist ein breites Upgrade, kein einzelner neuer Trick. Die folgenden vier Fähigkeiten sind die, für die ich tatsächlich Workflows anpassen würde.
K3.1 Pro bleibt bei langen, mehrstufigen Coding-Aufgaben am Ball und diagnostiziert eigene Fehler statt bloß neu zu versuchen. Moonshots Showcase ist ein Simulator für menschliches Gehen, aufgebaut auf dem Open-Source-human-atlas-Anatomiemodell mit 296 Skelett- und 402 Muskelkomponenten.
Über 167 Missionen und 420 unabhängige Reviews brachte das Modell den simulierten Menschen vom Zusammenbrechen nach Sekunden zu alternierenden Schritten über 11,2 Sekunden. Interessant wurde es, als Reward Shaping den Armbewegungen nicht mehr half: K3.1 Pro führte Open-Loop-Probes des Simulators aus, fand 36 Fehler in den Moment-Arm-Berechnungen der Schultermuskeln, behob sie und trainierte neu.
Das ist eine interne Demo – also eher als Illustration des Ziel-Use-Cases denn als Beweis sehen. Es zeigt aber klar, worauf Moonshot optimiert: Agents, die untersuchen und iterieren.
Moonshot sagt, K3.1 Pro liefert Frontend-Seiten, Three.js-Szenen und 3D-Assets mit „stärkerer Komposition, Typografie, Animation und Polish“. Es arbeitet mit Unity, Unreal Engine und Godot und kann das mit Websuche und 3D-Generierung kombinieren, um komplette Projekte zusammenzusetzen.
Auf der Modellierungsseite schreibt und führt K3.1 Pro Skripte für Blender und CAD-Software direkt aus – ohne MCP-Connectoren –, um parametrische Modelle wie Maschinenteile, Architekturmodelle und konfigurierbare Möbel zu erstellen. Moonshot startete außerdem 3D Make auf kimi.ai und in der Kimi-App, wo du Modelle für den 3D-Druck vorab ansehen, bearbeiten und herunterladen kannst.
Der Anspruch an die visuelle Qualität ist am schwersten gegen Benchmarks zu prüfen. Nimm Moonshots Demos daher als die besten Beispiele des Anbieters, nicht als typischen Output.
K3.1 Pro trägt einen Finanzworkflow von Screening bis zur fertigen Arbeitsmappe und Moonshot hat die Faktentreue gezielt für diese Arbeit verbessert. Auf internen Finanzbenchmarks legt K3.1 Pro gegenüber Kimi K3 um 7,2 Punkte bei Financial Modeling und 11,6 Punkte bei Financial Research zu und erreicht etwa das 4,2×-Fache von K3 bei Business Operation, einer langlaufenden simulierten Business-Aufgabe.
Die Genauigkeitsarbeit zeigt sich im Halluzinations-Stresstest von Moonshot. Auf Kimi Hallu Bench Hard sank die Halluzinationsrate auf Claim-Ebene von 23,4% (K3) auf 8,3% (K3.1 Pro). Moonshot betont, dass der Test Fehler provozieren soll – die Raten sind also keine Alltagsfehlerraten.
Kimi K3.1 Pro ist beim agentischen Coden und toollastiger Arbeit konkurrenzfähig mit Claude Opus 5.5 und GPT-6 Astra, liegt aber beim reinen Reasoning klar hinter ihnen. Alle Zahlen stammen aus Moonshots Ankündigung, mit K3.1 Pro auf max-Effort.
Beim agentischen Coden wirkt K3.1 Pro am stärksten. Auf Terminal-Bench 4.0, das Coding-Agents in realistischen, ressourcenbegrenzten Terminal-Aufgaben bewertet, erzielt K3.1 Pro 65,7%. Das liegt nur sehr knapp hinter Claude Opus 5.5 mit 66,4% und deutlich vor GPT-6 Astra mit 58,2%.
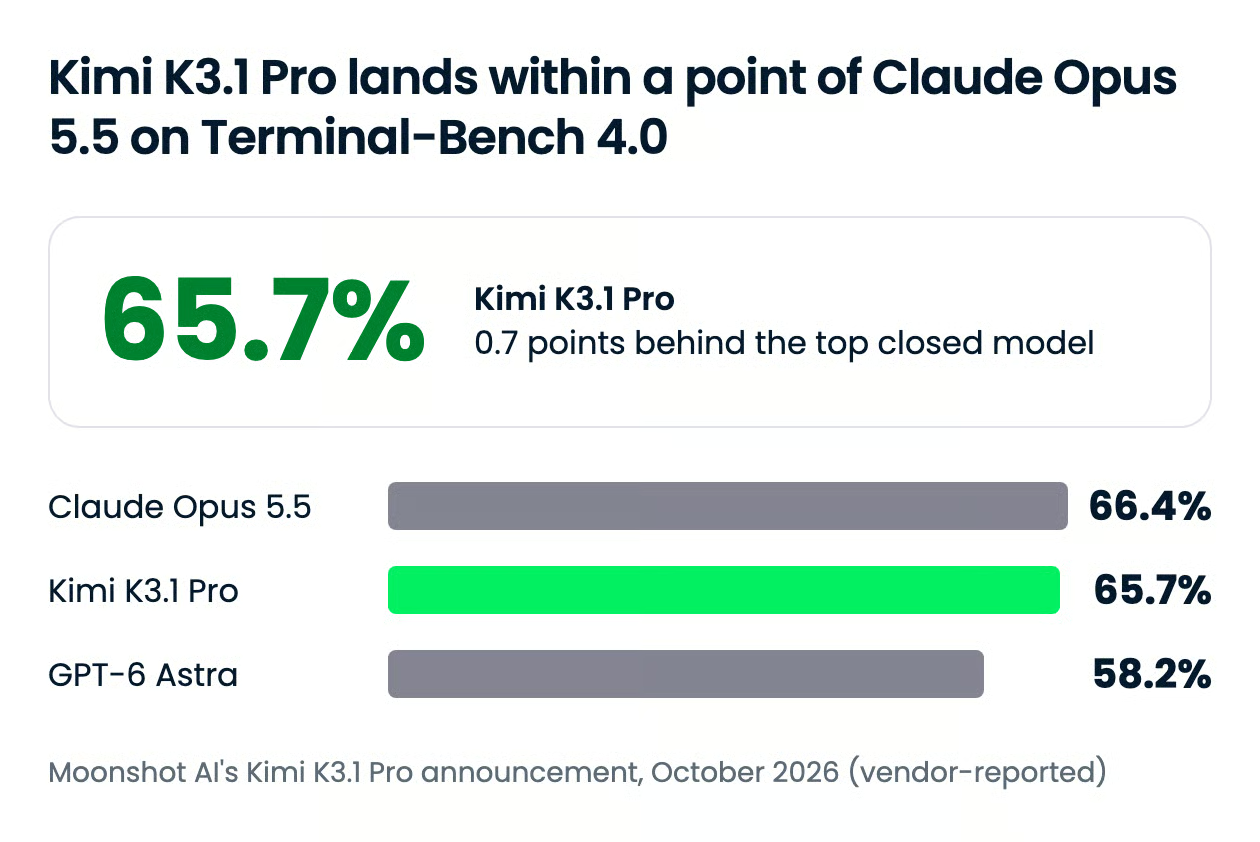
Der Rest der Coding-Ergebnisse ist gemischter, als die Headline vermuten lässt. Alle Werte sind Anbieterangaben, der beste Wert je Zeile ist fett markiert:
| Benchmark | Was gemessen wird | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Coding-Agents bei realistischen Terminal-Aufgaben | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 mehrstündige Engineering-Aufgaben, ohne Internet | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 Langstreckenaufgaben, bewertet nach Verhalten | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (Moonshot intern) | Mehrschritt-Ausführung und Toolnutzung | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Programm aus Binary und Spezifikation rekonstruieren (Tasks mit ≥95% Test-Pass) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agents in wissenschaftlichen Research-Workflows | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro liegt bei langen Engineering-Aufgaben auf einem Niveau mit den besten geschlossenen Modellen und führt Moonshots SWE-Marathon-Vergleich an. Bei DeepSWE lief jedes Lab mit eigenem Setup – ein 3-Punkte-Abstand ist hier eher ein Unentschieden als ein Sieg. Deutlich schwächer ist das Modell, wenn es ein Programm rein aus beobachtetem Verhalten rekonstruieren oder einen wissenschaftlichen Workflow abarbeiten muss.
Gegenüber dem Vorgänger ist der eindeutigste Gewinn auf Moonshots eigenem Long-Horizon-Benchmark zu sehen, wo Kimi K3 55,95% erzielte.
Bei toollastiger Agentenarbeit liegt K3.1 Pro vorn oder nur wenige Punkte hinter Opus 5.5:
| Benchmark | Was gemessen wird | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full mit Tools | 2.500 anspruchsvolle Wissens- und Reasoning-Fragen, Tools erlaubt | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Schwer auffindbare Informationen im Web finden | 92,1% | 90,8% | 91,5% | n/a |
| OfficeQA Pro v2 | Numerische Analysen über echte Finanz-PDFs | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Investment-Workflows von Screening bis Profitabilitätsanalyse | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Einen Desktop-Computer bedienen, um Aufgaben zu erledigen | 79,6% | 81,8% | 75,8% | 69,3% |
Die klare Ausnahme in Moonshots Tabelle ist die Computerbedienung – hier bleibt Opus 5.5 vorn. Bei Frontier Finance liegt insgesamt Claude Fable 5.1 (60,8) vorn, vor allen vier hier gezeigten Modellen.
Ohne Tools fällt K3.1 Pro klar hinter die geschlossenen Modelle zurück:
| Benchmark | Was gemessen wird | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 anspruchsvolle Wissens- und Reasoning-Fragen | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | 1.000 Fragen, härtestes HLE-Subset | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Fragen auf Graduiertenniveau in den Naturwissenschaften | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Fragen mit Bildern und Text | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (Moonshot intern, niedriger ist besser) | Anteil faktisch falscher Aussagen | 5,4% | 6,8% | 4,2% | 13,1% |
Die größte Lücke zeigt HLE-Diamond, während GPQA-Diamond fast gesättigt ist – der 2-Punkte-Abstand sagt wenig aus. Wenn dein Job hartes Closed-Book-Reasoning ist, ist das nicht das Modell für den Wechsel.
Moonshot tat für ein Open-Weight-Release Ungewöhnliches: Es veröffentlichte, wie viel Fähigkeit es absichtlich entfernt hat. Cyber-bezogene Inhalte in Mid-Training-Daten und RL-Umgebungen erhöhten stetig die Fähigkeiten in Vulnerability Research. Für das Open-Weight-Release entfernte Moonshot diese Daten aus beiden Phasen.
Auf xdev-bench-hard, Moonshots internem Exploit-Entwicklungsbenchmark, löste ein Checkpoint ohne Datenentfernung 90,5% der Probleme (pass@3). Das ausgelieferte K3.1 Pro löst 81,0% – immer noch deutlich über Kimi K3 mit 33,3%. Auf öffentlichen Cyber-Benchmarks liegt es unter allen geschlossenen Modellen im Vergleich von Moonshot und erzielt 74,7 auf ExploitBench gegenüber 91,0 bei Opus 5.5.
Moonshots Prinzip: Keine offenen Gewichte veröffentlichen, die die absolute Offensive-Cyber-Grenze weiter hinausschieben – die Open-Weight-Leistung soll schrittweise steigen. Ob ein Abschlag von 9,5 Punkten genügt, ist Ermessenssache – die Zahl zu publizieren ist aber mehr, als viele andere Labs tun.
Standard-K3.1 Pro ist für fast alle der richtige Default. Die Highspeed-Variante lohnt ihren höheren Preis nur, wenn jemand vor dem Output sitzt und wartet.
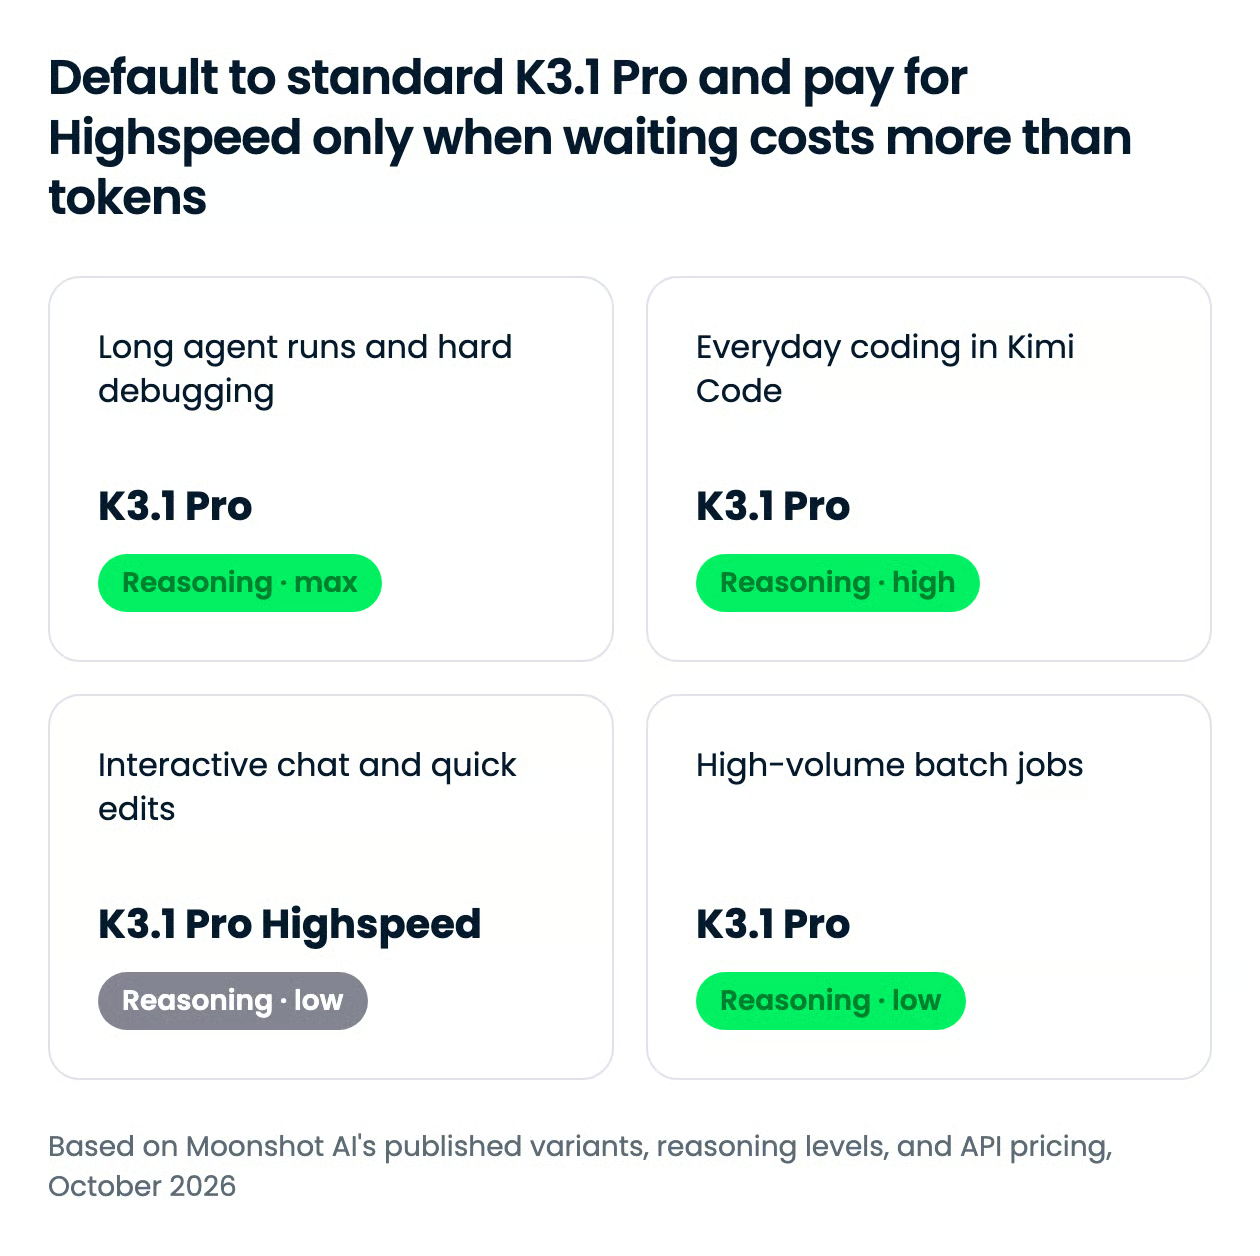
Moonshot verkauft Highspeed ausschließlich über Tempo: 2–3× schneller, doppelte Kosten pro Eingabe- und Ausgabe-Token, keine separaten Benchmark-Ergebnisse.
Beide Varianten „denken“ vor der Antwort – das lässt sich nicht abschalten. Du steuerst die Intensität über drei Reasoning-Stufen: max für die härteste Agentenarbeit, high als sinnvollen Mittelweg und low, wenn die Standard-Denkzeit mehr ist, als die Aufgabe braucht. Die API setzt standardmäßig auf max – die Einstellung hinter allen Werten in Moonshots Benchmark-Tabelle. Senke auf high oder low, wenn die Aufgabe keine volle Tiefe benötigt.
| Use Case | Variante | Reasoning-Level | Warum |
|---|---|---|---|
| Lange Agent-Runs, hartes Debugging | K3.1 Pro | max |
Einstellung hinter Moonshots Coding-Scores; über Stunden zählt Tempo weniger |
| Alltägliches Coden in Kimi Code | K3.1 Pro | high |
Fast die volle Qualität bei geringerer Token-Rechnung |
| Interaktiver Chat und schnelle Edits | K3.1 Pro Highspeed | low |
Latenz ist der Engpass, kurze Prompts halten den 2×-Preis klein |
| Hochvolumige Batch-Jobs | K3.1 Pro | low |
Niemand wartet – also niedriger Satz und Denken deckeln |
Ein wichtiger Praxis-Hinweis aus den Kimi-Code-Dokus: Ein Wechsel des Reasoning-Levels mitten in der Session macht den Kontext-Cache ungültig. Wähle also pro Session ein Level und wechsle nicht hin und her.
Kimi K3.1 Pro kostet $2,00 pro Million Eingabetokens und $10,00 pro Million Ausgabetokens über die Kimi API – günstiger als Kimi K3. Die Preise gelten über den vollen 1M-Token-Kontext ohne Langkontext-Aufschlag.
| Modell | Input | Output | Gecachter Input | 5-Minuten-Cache-Write | 1-Stunden-Cache-Write |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2,00 | $10,00 | $0,20 | $2,00 | $4,00 |
| Kimi K3.1 Pro Highspeed | $4,00 | $20,00 | $0,20 | $4,00 | $8,00 |
| Kimi K3 (Vorgängergeneration) | $3,00 | $15,00 | $0,30 | $3,00 | $6,00 |
Preise gelten pro Million Tokens und exklusive Steuern. Caching ist automatisch mit 5-Minuten-Default, die 1-Stunden-Stufe kannst du pro Call anfordern.
Ein paar Zugangsdetails solltest du kennen, bevor du darauf planst:
Wenn du noch auf K2-Modellen bist: Laut Moonshot-Dokus sind sie ab dem 31. Oktober 2026 für neue Nutzer:innen nicht mehr verfügbar und werden bis Ende Dezember 2026 außer Betrieb genommen.
Du kannst Kimi K3.1 Pro heute über die Kimi API, OpenRouter und Kimi-Apps nutzen – aber noch nicht als herunterladbare Gewichte. Moonshot sagt, die vollständigen Gewichte erscheinen bis zum 4. November 2026. In der Ankündigung fehlen Lizenzdetails, also prüfe die Model Card, sobald die Gewichte verfügbar sind.
kimi-k3.1-pro und kimi-k3.1-pro-highspeed auf einem OpenAI-kompatiblen Endpoint.moonshotai/kimi-k3.1-pro./model auswählen. Moonshots Dokus beschreiben auch die Anbindung an Codex über die Kimi Responses API.Ein Minimalaufruf mit dem OpenAI-Python-Client sieht so aus:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Sobald die Gewichte verfügbar sind, findest du in unserem Guide zum lokalen Ausführen von LLMs die Serving-Optionen, und unser Erklärstück zu OpenCode zeigt, wie du ein solches Modell in einen Open-Source-Coding-Agent integrierst.
Kimi K3.1 Pro ist der bisher stärkste Beleg, dass Open-Weight-Modelle beim agentischen Coden mit der geschlossenen Spitze mithalten können – und das zu einem Preis unter dem des eigenen Vorgängers. Es ist kein Leader im allgemeinen Reasoning, aber bei langen Coding- und toolintensiven Agent-Aufgaben sitzt es direkt neben Claude Opus 5.5 und vor GPT-6 Astra in mehreren Disziplinen.
Moonshot setzt außerdem darauf, mit der Veröffentlichung seiner Cyber-Trade-offs Goodwill für offene Releases zu schaffen. Wenn du mit Agents codest, probiere es jetzt über die API aus und prüfe Self-Hosting erneut, sobald Gewichte und Model Card im November landen.
Wenn du mit offenen Modellen wie diesem arbeiten willst, empfehle ich unseren Skill Track Hugging Face Fundamentals.
Lerne KI mit DataCamp!
Kurs
Lernpfad
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.