コース
Hugging Faceを使いこなす
2時間
40K
練習とトラックであなたの進捗を記録しましょう。
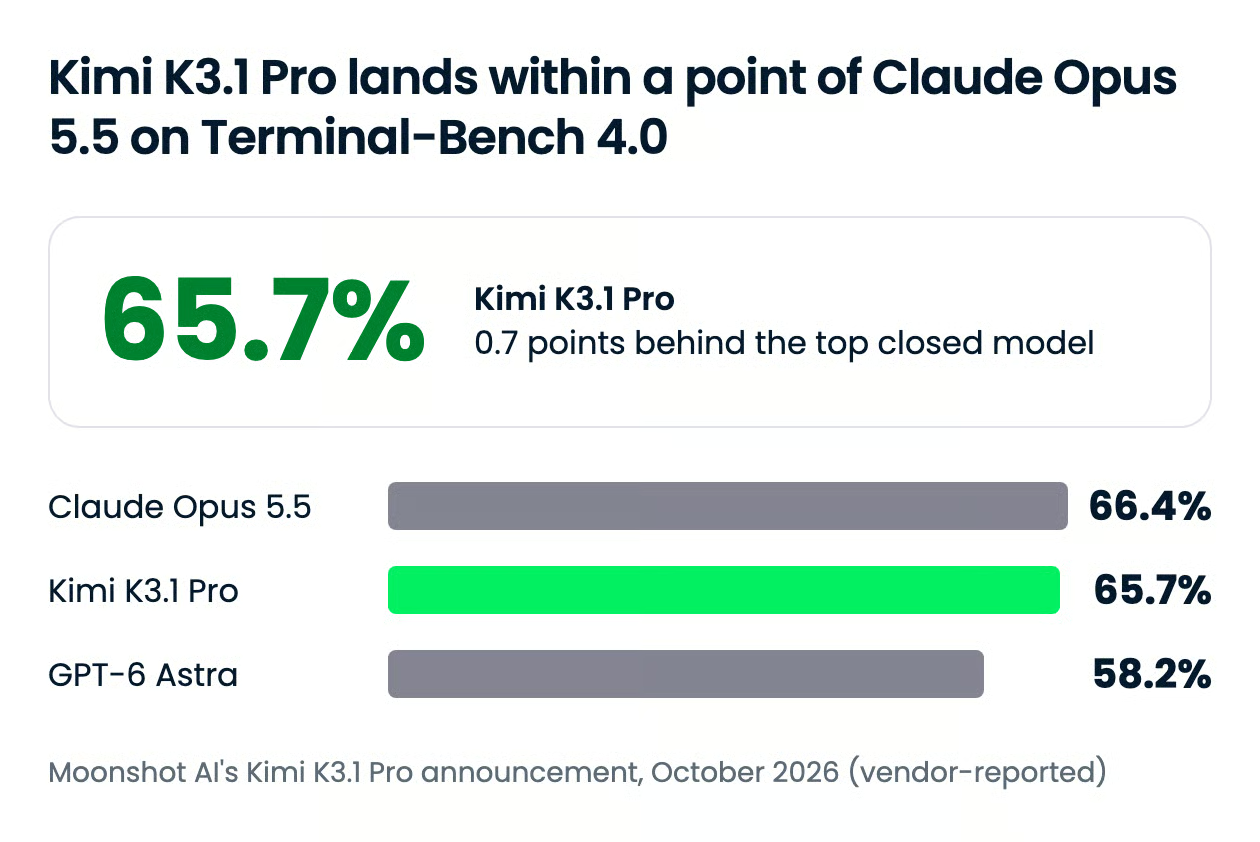
Googleで登録2026年、オープンウェイトの研究所はコーディング分野でAnthropicやOpenAIとの差を縮めてきましたが、Moonshot AIがさらに差を詰めました。先週金曜、MoonshotはKimi K3.1 Proを発表。これまでで最も高性能な3Tクラスのオープンウェイトモデルだと位置づけ、エージェント型コーディングでClaude Opus 5.5に1ポイント差まで迫っています。
K3.1 Proは、1百万トークンのコンテキストウィンドウを備えたKimi K3の重強化後学習版です。より高速な派生モデルK3.1 Pro Highspeedも同時提供され、Kimiアプリ、Kimi Code、Kimi APIで本日から利用可能。完全なウェイトは2026年11月4日までに公開予定です。
本記事では、Kimi K3.1 Proの新機能、ベンチマーク、価格がKimi K3とどう違うかをまとめます。ベースとなるモデルについては、Kimi K3の解説とKimi K3ハンズオンチュートリアルも併せてご覧ください。
Kimi K3.1 ProはMoonshot AIのフラッグシップ大規模言語モデル(LLM)で、新しいK3.1シリーズの最初のモデルです。Kimi K3(2.8Tパラメータ、100万トークンのコンテキスト)を土台に、はるかに大規模な強化後学習を施しています。
変化はアーキテクチャではなく学習方法にあります。Moonshotは「数百の下流ドメイン」に跨る共同の強化学習(RL)を実行し、余剰計算資源が着実な性能向上につながるよう、RLフレームワーク、サンドボックス基盤、ロールアウト計画を作り直しました。その結果、Moonshotによると測定した全ドメインで改善が見られ、特にコーディング、3D制作、金融リサーチでの伸びが顕著です。
看板の主張は、最良のプロプライエタリモデルと同等のエージェント型コーディング能力。Moonshotの表では、K3.1 Proはターミナルベースのコーディング課題でClaude Opus 5.5に1ポイント差まで迫り、価格はAnthropicの一部にとどまります。モデルはオープンウェイトですが、ウェイトはまだ未公開です。
K3.1 Proは単一の新機能ではなく、広範な強化です。以下の4点は、実際にワークフローを変えうる能力です。
K3.1 Proは、長く多段のコーディング課題に粘り強く取り組み、単なるリトライではなく自ら失敗を診断できます。Moonshotがデモしたのは、オープンソースのhuman-atlas解剖モデル(骨格296、筋肉402コンポーネント)を用いた二足歩行シミュレータです。
167のミッションと420の独立レビューを通じて、モデルは数秒で崩れ落ちていた被験体を、交互のストライドで11.2秒歩行させるまでに到達しました。報酬設計の調整が腕の動作に効かなくなった段階では、K3.1 Proがシミュレータのオープンループ探索を行い、肩筋のモーメントアーム計算に36の誤りを発見・修正して再学習しました。
これは社内デモであり、用途のイメージであって証拠ではありません。ただしMoonshotが最適化している方向性—調査と反復を行うエージェント—は見えてきます。
Moonshotによれば、K3.1 Proはフロントエンドページ、Three.jsシーン、3Dアセットで「構成、タイポグラフィ、アニメーション、仕上げ」が強化されています。Unity、Unreal Engine、Godotに対応し、ウェブ検索や3D生成と組み合わせてプロジェクト一式を組み立てられます。
モデリング面では、K3.1 ProはBlenderやCADのスクリプトをMCPコネクタなしで直接作成・実行し、機械部品、建築モデル、カスタマイズ可能な家具などのパラメトリックモデルを構築します。Moonshotはkimi.aiとKimiアプリ上で3D Makeも開始し、3Dプリント可能なモデルのプレビュー、編集、ダウンロードが可能です。
視覚品質の主張はベンチマークで検証しづらいため、Moonshotのデモはベンダーのベスト例であり、平均的な出力とは限らない点に留意してください。
K3.1 Proはスクリーニングから完成済みワークブックまで金融ワークフローを通しでこなし、この種の業務に向け事実精度を狙い撃ちで改善しています。社内の金融ベンチマークでは、Financial ModelingでKimi K3比+7.2ポイント、Financial Researchで+11.6ポイント、長期的なビジネス課題であるBusiness OperationではK3の約4.2倍に到達。
精度改善はMoonshotの幻覚(ハルシネーション)ストレステストにも現れています。Kimi Hallu Bench Hardで、主張レベルの幻覚率はK3の23.4%からK3.1 Proで8.3%へ低下。これは誤りを誘発する設計のテストであり、日常的な誤り率とは異なるとMoonshotは注意書きしています。
Kimi K3.1 Proはエージェント型コーディングやツール多用の作業でClaude Opus 5.5やGPT-6 Astraと競合しますが、純粋な推論では明確に後れを取ります。以下の数値はすべてMoonshotの発表に基づき、K3.1 Proはmax設定です。
K3.1 Proが最も強さを見せるのはここです。現実的でリソース制約のあるターミナル課題でコーディングエージェントを評価するTerminal-Bench 4.0で、K3.1 Proは65.7%。Claude Opus 5.5の66.4%にごく僅差で迫り、GPT-6 Astraの58.2%を大きく上回ります。
その他のコーディング結果は見出しほど一貫していません。いずれもベンダー公表値で、各行の最良スコアを太字で示します。
| Benchmark | 何を測るか | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 現実的なターミナル課題でのコーディングエージェント | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | インターネットなしの複数時間にわたる20のエンジニアリング課題 | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 挙動で採点される113の長期課題 | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon(Moonshot内製) | 多段実行とツール使用 | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | バイナリと仕様からプログラムを再構築(テスト95%以上合格の課題割合) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | 科学リサーチのワークフローにおけるエージェント | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Proは長時間のエンジニアリング課題で最良のクローズドモデルに肩を並べ、SWE-MarathonではMoonshotの比較で首位。DeepSWEは各研究所が独自設定で実施しているため、3ポイント差は勝利というより同着に近いでしょう。一方、観測された挙動のみからプログラムを再構築する場合や、科学研究のワークフローでは大きく後れます。
前世代比では、Moonshot内製の長期ベンチマーク(Kimi K3は55.95%)での伸びが最も明確です。
ツールを多用するエージェント作業では、K3.1 ProはOpus 5.5に対し首位か数ポイント差で食い下がります。
| Benchmark | 何を測るか | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | 困難な知識・推論2500問、ツール使用可 | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | ウェブ上の見つけにくい情報の探索 | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | 実在の金融PDFにまたがる数値分析 | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | スクリーニングから収益性分析までの投資ワークフロー | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | デスクトップPCを操作してタスクを完遂 | 79.6% | 81.8% | 75.8% | 69.3% |
Moonshotの表で明確に劣後するのはPC操作で、ここはOpus 5.5が優勢です。Frontier Financeでは、Claude Fable 5.1(60.8)が全モデル中トップでした。
ツールなしでは、K3.1 Proはクローズドモデルに明確に後れます。
| Benchmark | 何を測るか | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 困難な知識・推論2500問 | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | HLEのうち最難の1000問 | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | 大学院レベルの科学問題 | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | 画像とテキストを組み合わせた問題 | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench(Moonshot内製・低いほど良い) | 事実主張の誤り率 | 5.4% | 6.8% | 4.2% | 13.1% |
差が最も大きいのはHLE-Diamond。一方GPQA-Diamondはほぼ飽和しており、2ポイント差は意味が薄いでしょう。ハードなクローズドブック推論が中心なら、本モデルに乗り換える理由は弱いです。
Moonshotはオープンウェイト公開にあたり、意図的に削った能力の規模を公表するという珍しい対応をしました。中間学習データやRL環境におけるサイバー関連コンテンツが脆弱性研究スキルを着実に高めていたため、オープンウェイト公開に際して両段階からそのデータを除去したのです。
内製の脆弱性開発ベンチマークxdev-bench-hardでは、データ除去なしのチェックポイントが90.5%(pass@3)を解きました。公開版のK3.1 Proは81.0%で、Kimi K3の33.3%よりはるかに高い一方、公開のサイバーベンチでは比較対象のクローズドモデルを下回り、ExploitBenchで74.7(Opus 5.5は91.0)。
Moonshotの原則は、攻撃的サイバー能力の絶対的最前線を押し上げるオープンウェイトは出さず、段階的に水準を引き上げること。9.5ポイントの「減速」が十分かは判断が分かれるところですが、数値を公表した点は多くの研究所を上回ります。
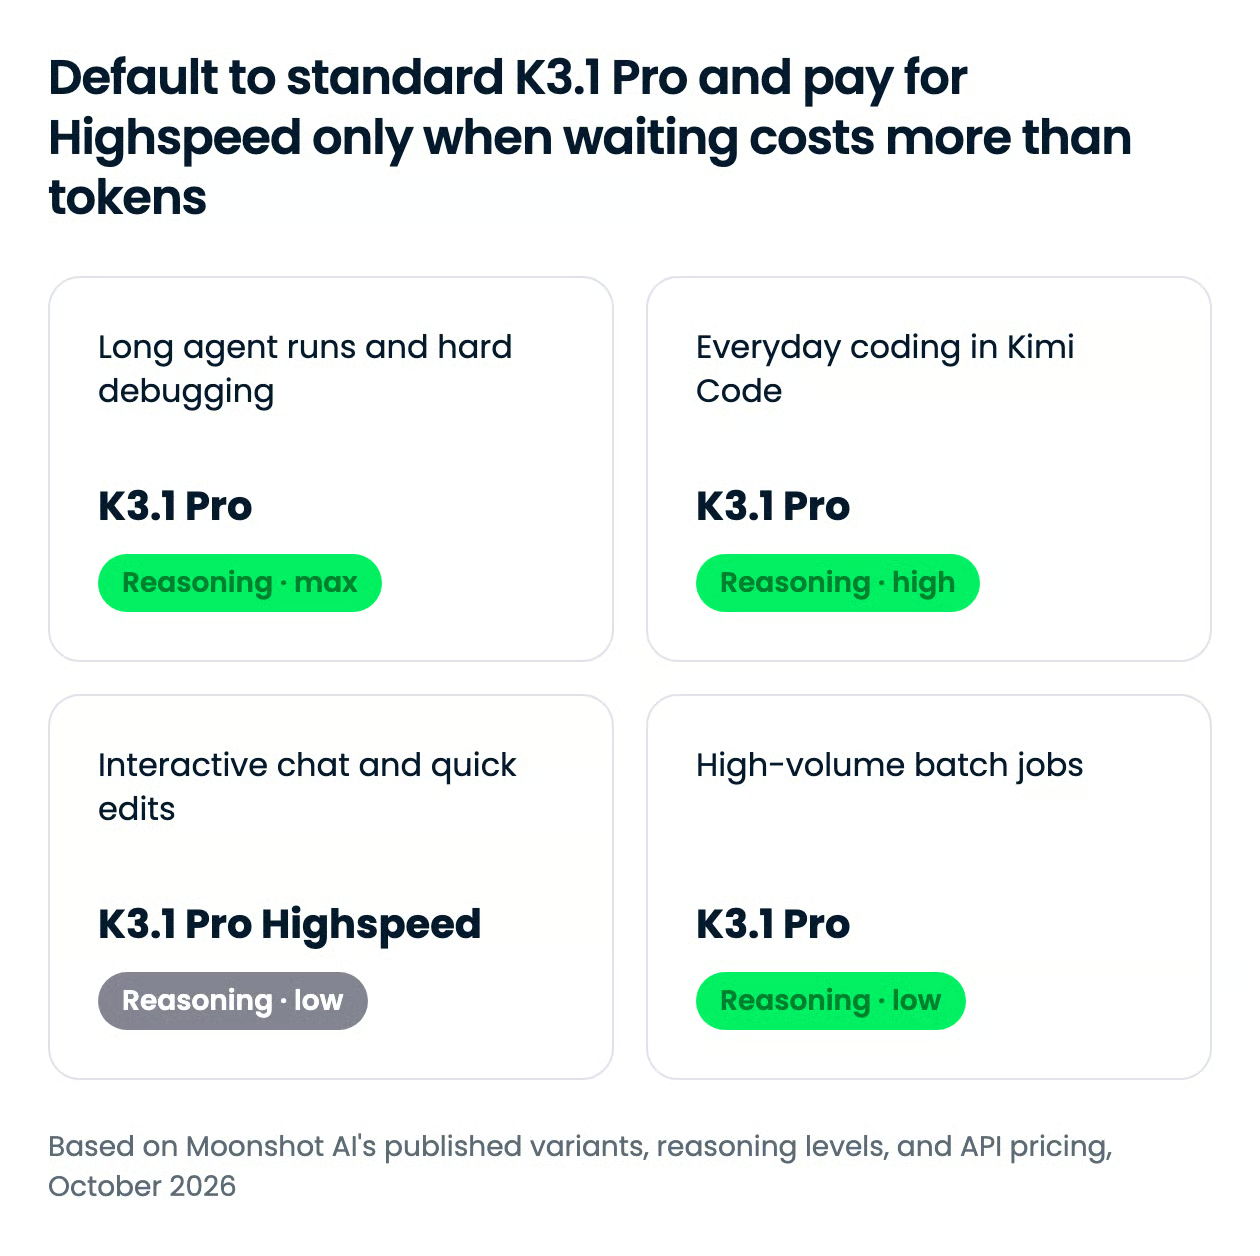
標準のK3.1 Proが、ほとんどの方にとって最適なデフォルトです。Highspeedは、人が出力を待っている状況でのみ、上位価格に見合います。
MoonshotがHighspeedを売りにするのは純粋に速度です。2〜3倍速く、入出力トークン単価は2倍、別個のベンチマーク結果はありません。
どちらのバリアントも回答前に必ず思考を行い、それはオフにできません。強度は3段階:最難のエージェント作業向けのmax、使い勝手のよい中庸のhigh、タスクに対しデフォルト思考時間が過剰な場合のlow。APIのデフォルトはmaxで、Moonshotの全ベンチマークはこの設定に基づきます。必要な場合を除き、highかlowに下げてください。
| ユースケース | バリアント | 推論レベル | 理由 |
|---|---|---|---|
| 長時間のエージェント実行、難易度の高いデバッグ | K3.1 Pro | max |
Moonshotのコーディングスコアの設定。数時間単位では速度の重要度が下がる |
| 日常的なKimi Codeでのコーディング | K3.1 Pro | high |
低コストで品質の大半を確保 |
| インタラクティブなチャットや軽微な編集 | K3.1 Pro Highspeed | low |
律速はレイテンシ。短いプロンプトなら2倍価格の影響は小さい |
| 大量バッチ処理 | K3.1 Pro | low |
待機者がいないため、安価で思考量も抑える |
Kimi Codeドキュメントの重要な注意:セッション途中で推論レベルを切り替えるとコンテキストキャッシュが無効になります。切り替えを繰り返さず、セッションごとにレベルを選んでください。
Kimi K3.1 ProはKimi APIで入力100万トークンあたり$2.00、出力100万トークンあたり$10.00。Kimi K3より安価です。100万トークンのフルコンテキストで均一料金、長文追加料金はありません。
| モデル | 入力 | 出力 | キャッシュ済み入力 | 5分キャッシュ書き込み | 1時間キャッシュ書き込み |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3(前世代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
価格は100万トークンあたり・税抜。キャッシュはデフォルトで5分自動、1時間のレベルは呼び出しごとに指定可能です。
計画前に知っておきたいアクセス条件:
なおK2シリーズは、ドキュメントによれば2026年10月31日以降は新規ユーザーに提供されず、2026年12月末までにリタイア予定です。
Kimi K3.1 ProはKimi API、OpenRouter、Kimiの各アプリで本日から利用できますが、ウェイトのダウンロードはまだできません。Moonshotは完全なウェイトを2026年11月4日までに公開するとしており、発表ではライセンス条件に触れていないため、公開時にモデルカードを確認してください。
kimi-k3.1-proとkimi-k3.1-pro-highspeed。OpenAI互換エンドポイント。moonshotai/kimi-k3.1-proとして掲載。/modelコマンドで選択。Kimi Responses API経由でCodexに接続する手順もドキュメントに記載。OpenAI Pythonクライアントでの最小コードは次のとおりです。
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)ウェイトが公開されたら、LLMをローカルで動かす方法ガイドで提供方法を確認し、OpenCodeの解説で、こうしたモデルをオープンソースのコーディングエージェントに接続する方法をご覧ください。
Kimi K3.1 Proは、オープンウェイトモデルがエージェント型コーディングでクローズド最前線に肩を並べうることを、かつ自モデルの前世代より低価格で示した最有力例です。一般推論のリーダーではありませんが、長時間のコーディングやツール多用のエージェント作業では、Claude Opus 5.5に並び、いくつかの課題ではGPT-6 Astraを上回ります。
またMoonshotは、サイバー能力に関するトレードオフの公表によって、オープン公開への理解を得られると踏んでいます。エージェントでコーディングするなら、まずはAPIで試し、ウェイトとモデルカードが11月に出そろったらセルフホスティングを再検討するとよいでしょう。
このようなオープンモデルに取り組みたい方は、Hugging Face Fundamentalsのスキルトラックもぜひご覧ください。
DataCampでAIを学ぼう!
コース
トラック
練習とトラックであなたの進捗を記録しましょう。
Googleで登録