คอร์ส
การใช้งาน Hugging Face
2 ชม.
40K
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย Googleห้องทดลองโมเดลแบบ open-weight ใช้เวลาตลอดปี 2026 เพื่อลดช่องว่างด้านความสามารถในการเขียนโค้ดให้ใกล้เคียง Anthropic และ OpenAI และล่าสุด Moonshot AI ก็ขยับเข้าใกล้อีกขั้น เมื่อวันศุกร์ที่ผ่านมา Moonshot เปิดตัว Kimi K3.1 Pro ซึ่งเรียกว่าเป็นโมเดล open-weight ระดับ 3T ที่ทรงพลังที่สุดของตนจนถึงปัจจุบัน และทำคะแนนงานโค้ดแบบเอเจนต์ไล่ทัน Claude Opus 5.5 ภายในส่วนต่างเพียง 1 คะแนน
K3.1 Pro คือรุ่นที่ผ่านการ post-training หนักเป็นพิเศษจาก Kimi K3 พร้อมหน้าต่างบริบท 1 ล้านโทเค็น เปิดตัวเคียงข้างรุ่นที่เร็วกว่าในชื่อ K3.1 Pro Highspeed และพร้อมใช้งานแล้ววันนี้บนแอป Kimi, Kimi Code และ Kimi API โดยน้ำหนักโมเดลเต็มจะตามมาไม่เกินวันที่ 4 พฤศจิกายน 2026
ในบทความนี้จะสรุปทุกสิ่งที่ใหม่ใน Kimi K3.1 Pro ครอบคลุมฟีเจอร์ ผลทดสอบ และราคาเทียบกับ Kimi K3 หากต้องการทำความเข้าใจกับโมเดลที่เป็นพื้นฐาน ลองดูคู่มือของเราเกี่ยวกับ Kimi K3 และ คู่มือใช้งาน Kimi K3 ฉบับลงมือทำ
Kimi K3.1 Pro คือโมเดลภาษาขนาดใหญ่ (LLM) เรือธงของ Moonshot AI และเป็นรุ่นแรกในตระกูล K3.1 ใหม่ ใช้ฐานของ Kimi K3 โมเดลพารามิเตอร์ 2.8T พร้อมบริบท 1M โทเค็น แล้วเพิ่มการคำนวณ post-training อย่างมากเข้ามา
ความเปลี่ยนแปลงอยู่ที่การฝึก ไม่ใช่สถาปัตยกรรม: Moonshot รัน reinforcement learning (RL) แบบผสานรวมครอบคลุม “หลายร้อยโดเมนปลายน้ำ” และสร้างใหม่ทั้งเฟรมเวิร์ก RL โครงสร้างพื้นฐาน sandbox และการจัดตาราง rollout เพื่อให้ compute เพิ่มนำไปสู่การพัฒนาอย่างสม่ำเสมอ ผลลัพธ์ตามที่ Moonshot ระบุ คือการปรับปรุงในทุกโดเมนที่วัด โดยเน้นพิเศษที่การเขียนโค้ด การสร้าง 3D และงานวิจัยการเงิน
ข้ออ้างหลักคือความเท่าเทียมในการโค้ดแบบเอเจนต์กับโมเดลปิดชั้นนำ ตารางของ Moonshot เองชี้ว่า K3.1 Pro ทำคะแนนงานโค้ดบนเทอร์มินัลใกล้เคียง Claude Opus 5.5 มาก ขณะที่คิดค่าบริการเพียงเศษเสี้ยวของราคา Anthropic โมเดลเป็น open-weight แต่ยังไม่เผยน้ำหนักสู่สาธารณะ
K3.1 Pro เป็นการอัปเกรดในวงกว้าง ไม่ใช่เพียงทริกเดียว ความสามารถ 4 ข้อต่อไปนี้คือสิ่งที่จะเปลี่ยนเวิร์กโฟลว์ได้จริง
K3.1 Pro สามารถทำงานโค้ดยาวหลายขั้นตอนต่อเนื่อง วินิจฉัยข้อผิดพลาดของตนเองแทนการลองใหม่อย่างเดียว เดโมหลักของ Moonshot คือซิมูเลเตอร์การเดินของมนุษย์ ที่สร้างบนโมเดลกายวิภาคแบบโอเพนซอร์ส human-atlas ซึ่งมีองค์ประกอบกระดูก 296 ชิ้นและกล้ามเนื้อ 402 ชิ้น
ตลอด 167 ภารกิจและการรีวิวอิสระ 420 ครั้ง โมเดลพาจำลองมนุษย์จากการทรุดลงภายในไม่กี่วินาที ไปสู่การเดินสลับก้าวได้นาน 11.2 วินาที ช่วงที่น่าสนใจคือเมื่อการปรับรางวัลไม่ช่วยการเคลื่อนไหวของแขน: K3.1 Pro รันการสำรวจแบบ open-loop กับซิมูเลเตอร์ พบข้อผิดพลาด 36 จุดในคำนวณ moment-arm ของกล้ามเนื้อไหล่ แก้ไข แล้วฝึกใหม่
นี่เป็นเดโมภายใน จึงควรดูเป็นภาพประกอบกรณีใช้งานที่ตั้งใจ มากกว่าหลักฐานเชิงสถิติ แต่ก็ชี้ให้เห็นสิ่งที่ Moonshot มุ่งเพิ่มประสิทธิภาพ: เอเจนต์ที่สืบค้นและทำซ้ำ
Moonshot ระบุว่า K3.1 Pro สร้างเพจฟรอนต์เอนด์ ฉาก Three.js และแอสเซ็ต 3D ที่ “องค์ประกอบ การจัดวางตัวอักษร แอนิเมชัน และความเนี้ยบ” แข็งแรงขึ้น ทำงานร่วมกับ Unity, Unreal Engine และ Godot ได้ และผสานการค้นเว็บกับการสร้าง 3D เพื่อประกอบโปรเจกต์ครบชุด
ด้านการสร้างแบบ โมเดลเขียนและรันสคริปต์สำหรับ Blender และซอฟต์แวร์ CAD ได้โดยตรงโดยไม่ต้องใช้ตัวเชื่อม MCP เพื่อสร้างโมเดลพาราเมตริก เช่น ชิ้นส่วนเครื่องกล แบบสถาปัตยกรรม และเฟอร์นิเจอร์ปรับแต่งได้ Moonshot ยังเปิดตัว 3D Make บน kimi.ai และแอป Kimi ให้พรีวิว แก้ไข และดาวน์โหลดโมเดลพร้อมพิมพ์ 3D
ข้ออ้างด้านคุณภาพภาพก็เป็นสิ่งที่ตรวจสอบกับตารางเกณฑ์ยากที่สุดเช่นกัน จึงควรมองเดโมของ Moonshot เป็นตัวอย่างที่ดีที่สุดของผู้ขาย มากกว่าผลลัพธ์โดยทั่วไป
K3.1 Pro ทำเวิร์กโฟลว์ด้านการเงินได้ตั้งแต่คัดกรองจนเป็นเวิร์กบุ๊กสมบูรณ์ และ Moonshot แก้จงใจเรื่องความถูกต้องเชิงข้อเท็จจริงสำหรับงานลักษณะนี้ บนเกณฑ์ภายในด้านการเงิน K3.1 Pro ดีขึ้นจาก Kimi K3 อยู่ 7.2 คะแนนในหัวข้อ Financial Modeling และ 11.6 คะแนนใน Financial Research และทำได้ราว 4.2× ของคะแนน K3 บน Business Operation งานธุรกิจจำลองระยะยาว
งานด้านความแม่นยำสะท้อนในแบบทดสอบหลอนข้อมูลของ Moonshot บน Kimi Hallu Bench Hard อัตราอ้างข้อเท็จจริงผิดลดลงจาก 23.4% ของ K3 เหลือ 8.3% สำหรับ K3.1 Pro โดย Moonshot ระบุชัดว่าการทดสอบออกแบบมาเพื่อยั่วยุให้เกิดข้อผิดพลาด จึงไม่ใช่อัตราข้อผิดพลาดในชีวิตจริง
Kimi K3.1 Pro แข่งขันได้กับ Claude Opus 5.5 และ GPT-6 Astra ในงานโค้ดแบบเอเจนต์และงานที่พึ่งเครื่องมือหนัก แต่ตามหลังก่อนชัดเจนในงานให้เหตุผลล้วน ตัวเลขทั้งหมดด้านล่างมาจาก ประกาศ ของ Moonshot โดยใช้ระดับความคิด max
งานโค้ดแบบเอเจนต์คือจุดที่ K3.1 Pro ดูแข็งแรงที่สุด บน Terminal-Bench 4.0 ซึ่งให้คะแนนเอเจนต์โค้ดในงานเทอร์มินัลที่สมจริงและจำกัดทรัพยากร K3.1 Pro ทำได้ 65.7% ตามหลัง Claude Opus 5.5 เพียงเล็กน้อยที่ 66.4% และนำ GPT-6 Astra ที่ 58.2% อย่างชัดเจน
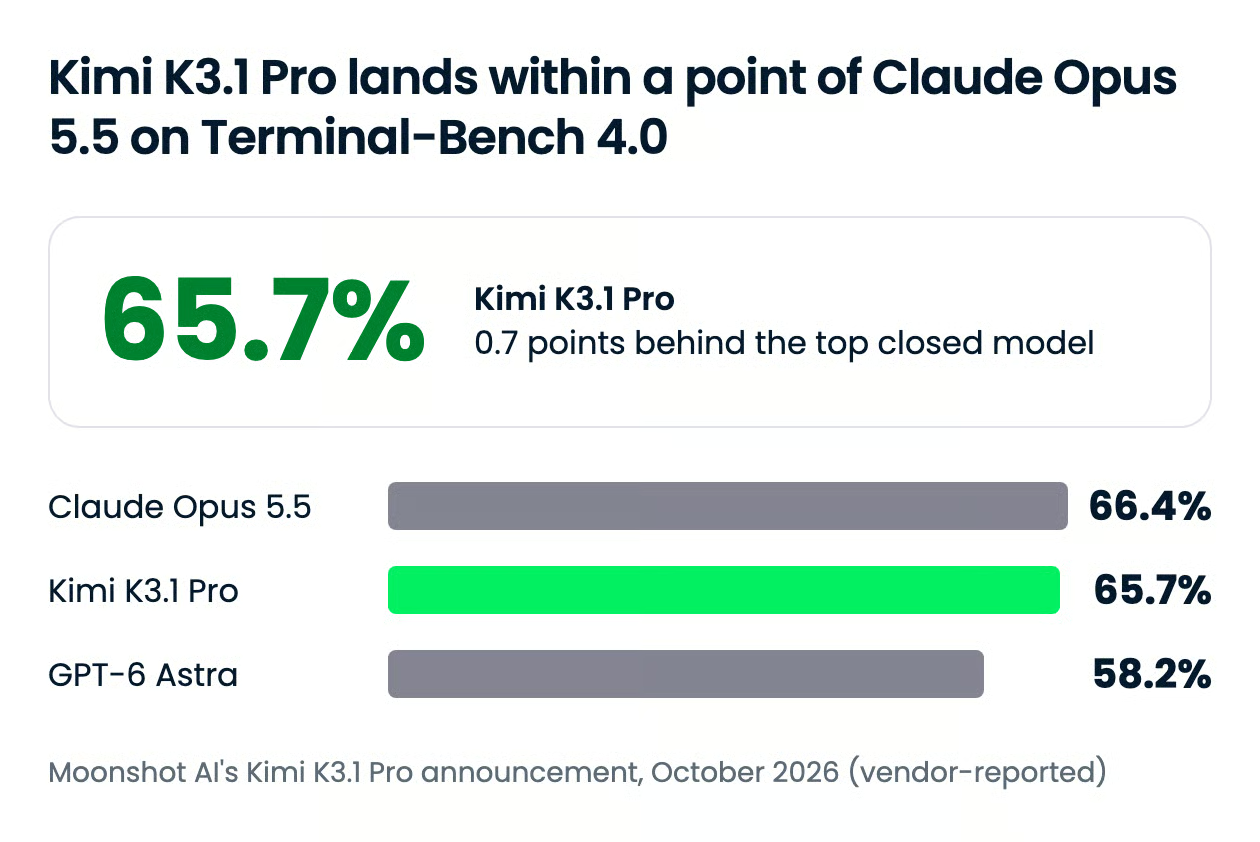
ผลด้านโค้ดส่วนที่เหลือปะปนมากกว่าพาดหัวข้างต้น คะแนนทั้งหมดรายงานโดยผู้ผลิต โดยเน้นคะแนนสูงสุดของแต่ละแถวเป็นตัวหนา:
| เกณฑ์ทดสอบ | วัดอะไร | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | เอเจนต์โค้ดบนงานเทอร์มินัลสมจริง | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | งานวิศวกรรมหลายชั่วโมง 20 งาน ไม่มีอินเทอร์เน็ต | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | งานระยะยาว 113 งาน ให้คะแนนตามพฤติกรรม | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (ภายใน Moonshot) | การรันหลายขั้นและใช้เครื่องมือ | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | ประกอบโปรแกรมจากไบนารีและสเปก (งานที่ผ่านอย่างน้อย 95% ของเทสต์) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | เอเจนต์บนเวิร์กโฟลว์วิจัยทางวิทยาศาสตร์ | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro สูสีกับโมเดลปิดที่ดีที่สุดในงานวิศวกรรมระยะยาว และนำในตารางเทียบ SWE-Marathon ของ Moonshot บน DeepSWE แต่ละแลปใช้การตั้งค่าของตนเอง ช่วงต่าง 3 คะแนนจึงนับเป็นเสมอมากกว่าชนะ อย่างไรก็ดี เมื่อต้องประกอบโปรแกรมจากพฤติกรรมที่สังเกตได้เพียงอย่างเดียว หรือทำเวิร์กโฟลว์วิจัยวิทยาศาสตร์ จะตามหลังมาก
เมื่อเทียบกับรุ่นก่อน จุดชัดสุดคือบนเกณฑ์ระยะยาวของ Moonshot เอง ที่ Kimi K3 เคยทำได้ 55.95%
ในงานเอเจนต์ที่พึ่งเครื่องมือหนัก K3.1 Pro นำหรืออยู่ในระยะห่างเพียงไม่กี่คะแนนจาก Opus 5.5:
| เกณฑ์ทดสอบ | วัดอะไร | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | คำถามความรู้และเหตุผลยาก 2,500 ข้อ อนุญาตเครื่องมือ | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | ค้นหาข้อมูลหายากบนเว็บ | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | วิเคราะห์ตัวเลขจากไฟล์ PDF การเงินจริง | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | เวิร์กโฟลว์การลงทุนตั้งแต่คัดกรองถึงวิเคราะห์กำไรขาดทุน | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | ใช้งานคอมพิวเตอร์เดสก์ท็อปเพื่อทำงานให้เสร็จ | 79.6% | 81.8% | 75.8% | 69.3% |
ข้อยกเว้นชัดเจนในตารางของ Moonshot คือการใช้คอมพิวเตอร์ ซึ่ง Opus 5.5 ยังนำอยู่ บน Frontier Finance Claude Fable 5.1 (60.8) เป็นผู้นำโดยรวม เหนือทั้งสี่โมเดลที่แสดงนี้
เมื่อไม่มีเครื่องมือ K3.1 Pro ตามหลังโมเดลปิดอย่างชัดเจน:
| เกณฑ์ทดสอบ | วัดอะไร | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | คำถามความรู้และเหตุผลยาก 2,500 ข้อ | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | เซ็ตยากที่สุด 1,000 ข้อของ HLE | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | คำถามวิทยาศาสตร์ระดับบัณฑิตศึกษา | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | คำถามที่ผสานภาพและข้อความ | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (ภายใน Moonshot ยิ่งต่ำยิ่งดี) | สัดส่วนข้ออ้างอิงข้อเท็จจริงที่ผิด | 5.4% | 6.8% | 4.2% | 13.1% |
ช่องว่างกว้างสุดบน HLE-Diamond ขณะที่ GPQA-Diamond ใกล้ถึงเพดานแล้ว จึงอ่านค่าแตกต่าง 2 คะแนนได้ไม่มาก หากงานของคุณคือการให้เหตุผลแบบปิดหนังสือยากๆ โมเดลนี้ไม่ใช่ตัวที่จะสลับไปใช้
Moonshot ทำสิ่งที่ไม่ค่อยเห็นในเวอร์ชัน open-weight: เผยว่าตัดขีดความสามารถออกไปเท่าไร โดยพบว่าเนื้อหาที่เกี่ยวกับไซเบอร์ในข้อมูลกลางการฝึกและสภาพแวดล้อม RL ยกระดับทักษะวิจัยช่องโหว่อย่างต่อเนื่อง จึงตัดข้อมูลเหล่านั้นออกจากทั้งสองช่วงสำหรับเวอร์ชัน open-weight
บน xdev-bench-hard เกณฑ์ภายในสำหรับพัฒนาการโจมตี เช็คพอยต์ที่ไม่ได้ตัดข้อมูลแก้ปัญหาได้ 90.5% (pass@3) ส่วน K3.1 Pro เวอร์ชันส่งมอบแก้ได้ 81.0% ซึ่งยังสูงกว่า Kimi K3 ที่ 33.3% มาก บนเกณฑ์ไซเบอร์สาธารณะ โมเดลอยู่ต่ำกว่าทุกโมเดลปิดที่ Moonshot เทียบ โดยทำได้ 74.7 บน ExploitBench เทียบกับ 91.0 ของ Opus 5.5
หลักการที่ Moonshot ระบุคือหลีกเลี่ยงการปล่อยน้ำหนักแบบเปิดที่ดันขอบความสามารถเชิงรุกด้านไซเบอร์ให้ไกลขึ้น ในขณะที่ยกระดับมาตรฐาน open-weight อย่างค่อยเป็นค่อยไป ว่าการหั่น 9.5 คะแนนจะพอหรือไม่เป็นเรื่องของดุลพินิจ แต่การเผยตัวเลขดังกล่าวก็ทำมากกว่าหลายห้องทดลองแล้ว
K3.1 Pro มาตรฐานเหมาะเป็นค่าเริ่มต้นสำหรับแทบทุกคน รุ่น Highspeed คุ้มราคาที่สูงกว่าเมื่อมีคนรอผลลัพธ์อยู่ตรงหน้าเท่านั้น
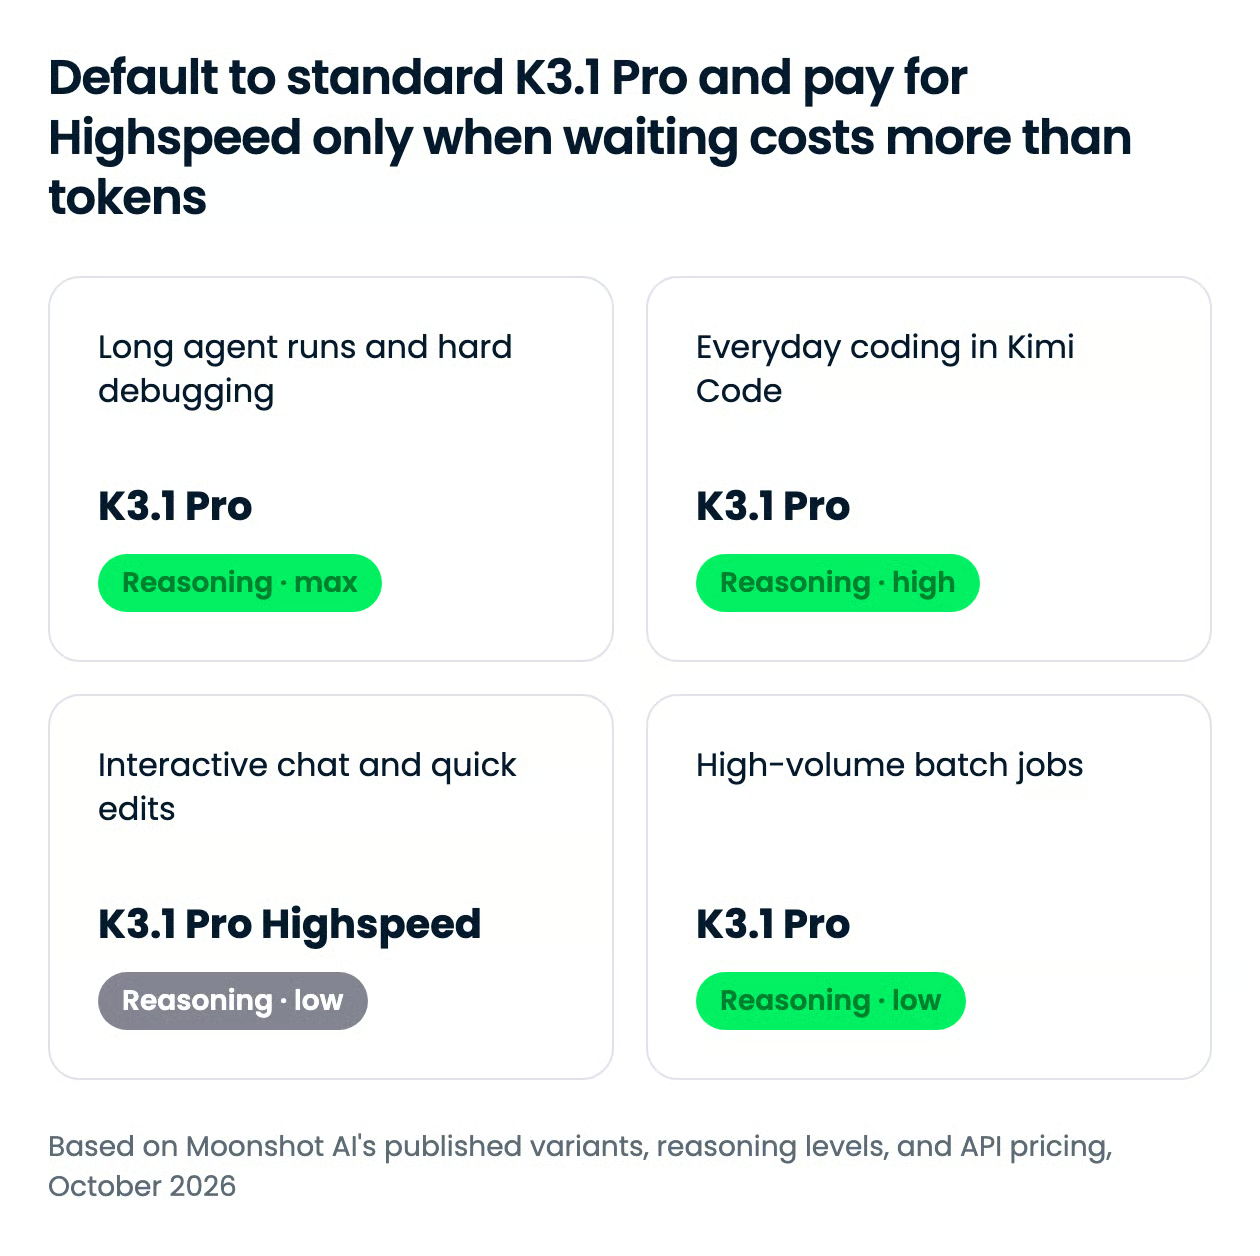
Moonshot ขาย Highspeed ด้วยความเร็วล้วนๆ: รันเร็วขึ้น 2–3× คิดราคาสองเท่าต่อโทเค็นขาเข้าและขาออก และไม่มีผลทดสอบแยกต่างหาก
ทั้งสองรุ่นจะ “คิดก่อนตอบ” เสมอ และปิดไม่ได้ กำหนดความหนักเบาได้สามระดับการให้เหตุผล: max สำหรับงานเอเจนต์ที่ยากที่สุด high เป็นค่ากลางที่เหมาะสม และ low เมื่อเวลาคิดค่าเริ่มต้นมากเกินสิ่งที่งานต้องการ API ตั้งค่าเริ่มต้นเป็น max ซึ่งเป็นค่าหลังทุกคะแนนในตารางของ Moonshot ดังนั้นให้ลดเป็น high หรือ low เว้นแต่งานต้องการความลึกเต็มที่
| กรณีใช้งาน | รุ่น | ระดับการให้เหตุผล | เหตุผล |
|---|---|---|---|
| การรันเอเจนต์ยาว ดีบักยาก | K3.1 Pro | max |
ค่าที่อยู่เบื้องหลังคะแนนโค้ดของ Moonshot; ความเร็วสำคัญน้อยเมื่อกินเวลาหลายชั่วโมง |
| เขียนโค้ดทุกวันใน Kimi Code | K3.1 Pro | high |
ได้คุณภาพส่วนใหญ่ด้วยบิลโทเค็นที่ต่ำกว่า |
| แชตโต้ตอบและแก้ไขด่วน | K3.1 Pro Highspeed | low |
ความหน่วงเป็นคอขวด และพรอมป์ตสั้นทำให้ราคา 2× ไม่บาน |
| งานแบตช์ปริมาณมาก | K3.1 Pro | low |
ไม่มีใครรอ จ่ายเรทราคาต่ำกว่าและจำกัดเวลาคิด |
ข้อควรทราบสำคัญจากเอกสาร Kimi Code: การสลับระดับการให้เหตุผลกลางเซสชันจะทำให้แคชบริบทใช้ไม่ได้ ดังนั้นควรเลือกระดับต่อเซสชัน แทนการสลับไปมา
Kimi K3.1 Pro คิด $2.00 ต่อหนึ่งล้านโทเค็นขาเข้า และ $10.00 ต่อหนึ่งล้านโทเค็นขาออกบน Kimi API ซึ่งถูกกว่า Kimi K3 ราคาเป็นอัตราเดียวตลอดบริบท 1M โทเค็น โดยไม่มีค่าบริการบริบทยาว
| โมเดล | ขาเข้า | ขาออก | ขาเข้าจากแคช | เขียนแคช 5 นาที | เขียนแคช 1 ชั่วโมง |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (รุ่นก่อนหน้า) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
ราคาต่อหนึ่งล้านโทเค็นและไม่รวมภาษี ระบบแคชทำงานอัตโนมัติด้วยค่าเริ่มต้น 5 นาที และสามารถขอระดับ 1 ชั่วโมงต่อการเรียกใช้งานได้
รายละเอียดการเข้าถึงบางอย่างที่ควรรู้ก่อนวางแผนใช้งาน:
หากยังใช้งานซีรีส์ K2 เอกสารของ Moonshot ระบุว่าจะปิดไม่ให้ผู้ใช้ใหม่ตั้งแต่ 31 ตุลาคม 2026 และยุติให้บริการภายในสิ้นเดือนธันวาคม 2026
สามารถใช้ Kimi K3.1 Pro ได้วันนี้ผ่าน Kimi API, OpenRouter และแอปของ Kimi เอง แต่ยังไม่เปิดให้น้ำหนักโมเดลดาวน์โหลด Moonshot ระบุว่าจะปล่อยน้ำหนักเต็มภายใน 4 พฤศจิกายน 2026 และประกาศไม่ได้พูดถึงเงื่อนไขสัญญาอนุญาต จึงควรตรวจการ์ดโมเดลเมื่อปล่อยน้ำหนักแล้ว
kimi-k3.1-pro และ kimi-k3.1-pro-highspeed บนเอ็นด์พอยต์ที่เข้ากันได้กับ OpenAImoonshotai/kimi-k3.1-pro/model เอกสารของ Moonshot ยังครอบคลุมการเชื่อมต่อกับ Codex ผ่าน Kimi Responses APIตัวอย่างเรียกแบบมินิมอลด้วยไคลเอนต์ OpenAI ภาษา Python มีดังนี้:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
เมื่อน้ำหนักโมเดลปล่อยแล้ว คู่มือของเราว่าด้วยวิธี รัน LLM บนเครื่อง ครอบคลุมตัวเลือกการให้บริการ และบทความอธิบายเรื่อง OpenCode จะแสดงวิธีเสียบโมเดลลักษณะนี้เข้ากับเอเจนต์โค้ดโอเพนซอร์ส
Kimi K3.1 Pro เป็นกรณีที่แข็งแรงที่สุดจนถึงตอนนี้ว่าโมเดล open-weight สามารถไล่ทันแนวหน้าสายปิดในงานโค้ดแบบเอเจนต์ ในราคาที่ต่ำกว่ารุ่นก่อนของตนเอง แม้จะไม่ใช่ผู้นำการให้เหตุผลทั่วไป แต่สำหรับงานโค้ดยาวและเอเจนต์ที่ใช้เครื่องมือหนัก มันยืนเคียงข้าง Claude Opus 5.5 และนำหน้า GPT-6 Astra ในหลายงาน
Moonshot ยังเดิมพันว่าการเปิดเผยการแลกเปลี่ยนด้านไซเบอร์จะสร้างความไว้วางใจให้กับการปล่อย open-weight หากทำงานโค้ดกับเอเจนต์ แนะนำให้ลองใช้ผ่าน API ตอนนี้ และกลับมาพิจารณาโฮสต์เองอีกครั้งเมื่อมีน้ำหนักและการ์ดโมเดลในเดือนพฤศจิกายน
หากสนใจทำงานกับโมเดลแบบเปิดเช่นนี้ แนะนำให้ดูเส้นทางทักษะ Hugging Face Fundamentals ของเรา
เรียนรู้ AI กับ DataCamp!
คอร์ส
แทร็ก
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย Google