

课程
使用 Hugging Face
2 小时
40K
实践并学习路径你的进步。
使用 Google 继续开放权重实验室在 2026 年把编码能力与 Anthropic 和 OpenAI 之间的差距越拉越小,Moonshot AI 刚刚又把差距缩小了一步。上周五,Moonshot 发布了 Kimi K3.1 Pro,称其为迄今最强的 3T 级开放权重模型,并在智能体编码上把差距缩小到与 Claude Opus 5.5 仅有 1 分之内。
K3.1 Pro 是 Kimi K3 的重度后训练版本,具备 100 万 token 的上下文窗口。它同时发布了更快的变体 K3.1 Pro Highspeed,并已在 Kimi 应用、Kimi Code 和 Kimi API 上线。完整权重将于 2026 年 11 月 4 日前公布。
本文将全面介绍 Kimi K3.1 Pro 的新变化,包括新功能、各项基准成绩,以及与 Kimi K3 的定价对比。若您想先了解其基础模型,请参阅我们的 Kimi K3 指南 以及 Kimi K3 上手教程。
Kimi K3.1 Pro 是 Moonshot AI 的旗舰大型语言模型(LLM),也是 K3.1 系列的首款模型。它沿用了 Kimi K3 的基础——一个拥有 2.8T 参数与 100 万 token 上下文窗口的模型,并在此之上加入更多后训练算力。
变化主要在训练而非架构:Moonshot 在其所谓的“数百个下游领域”上联合进行 强化学习(RL),并重构了 RL 框架、沙盒基础设施与 rollout 调度,以确保额外算力带来持续收益。据 Moonshot 称,其测量的所有领域都有提升,尤其是在编码、3D 创作与金融研究方面。
最醒目的主张是:在智能体编码上与最强专有模型实现对标。Moonshot 自家的表格显示,K3.1 Pro 在基于终端的编码任务上与 Claude Opus 5.5 的差距只在 1 分以内,而价格只是 Anthropic 的一小部分。该模型为开放权重,但权重暂未公开。
K3.1 Pro 是一次全面升级,而非单一新技巧。以下四项能力足以让人重新调整工作流。
K3.1 Pro 能够持续推进长时、多步骤的编码任务,能自我诊断失败原因,而不仅仅是重试。Moonshot 展示的案例是基于开源 human-atlas 解剖模型的人体行走模拟器,包含 296 个骨骼与 402 个肌肉组件。
在 167 个任务与 420 次独立评审中,该模型把模拟人从数秒内即倒下,提升为能交替迈步行走 11.2 秒。更有意思的是,当“奖励塑形”不再改善手臂动作时:K3.1 Pro 对模拟器进行了开环探测,发现肩部肌肉力臂计算中有 36 处错误,修复后再训练。
这只是一个内部演示,应将其视为意图用例的说明而非证据。但它展示了 Moonshot 的优化方向:能主动调查并反复迭代的智能体。
据 Moonshot 称,K3.1 Pro 生成的前端页面、Three.js 场景与 3D 资产在“版式编排、字体排印、动画与整体打磨”上更胜一筹。它可配合 Unity、Unreal Engine 与 Godot 使用,并能结合网页搜索与 3D 生成来组装完整项目。
在建模方面,K3.1 Pro 可直接为 Blender 与 CAD 软件编写并运行脚本(无需 MCP 连接器),以构建参数化模型,如机械部件、建筑模型与可配置家具。Moonshot 还在 kimi.ai 与 Kimi 应用中上线了 3D Make,您可以在其中预览、编辑并下载可直接 3D 打印的模型。
关于视觉质量的说法也最难用基准表量化验证,因此应把 Moonshot 的演示视为厂商最佳示例,而非平均输出。
K3.1 Pro 能把金融工作流从筛选一路推进到成品工作簿,Moonshot 还针对这类工作进行了事实准确性的专项修正。在其内部金融基准上,K3.1 Pro 在 Financial Modeling 上较 Kimi K3 提升 7.2 分,在 Financial Research 上提升 11.6 分,并在 Business Operation(长周期的模拟商业任务)上达到约为 K3 的 4.2 倍。
准确性工作也反映在 Moonshot 的幻觉压力测试中。在 Kimi Hallu Bench Hard 上,K3 的逐条断言幻觉率为 23.4%,而 K3.1 Pro 降至 8.3%。Moonshot 强调该测试旨在诱发错误,因此这些比率并不等同于日常错误率。
在智能体编码与重工具工作上,Kimi K3.1 Pro 可与 Claude Opus 5.5 和 GPT-6 Astra 竞争,但在纯推理方面明显落后。以下数据均来自 Moonshot 的发布公告,K3.1 Pro 的设置为 max。
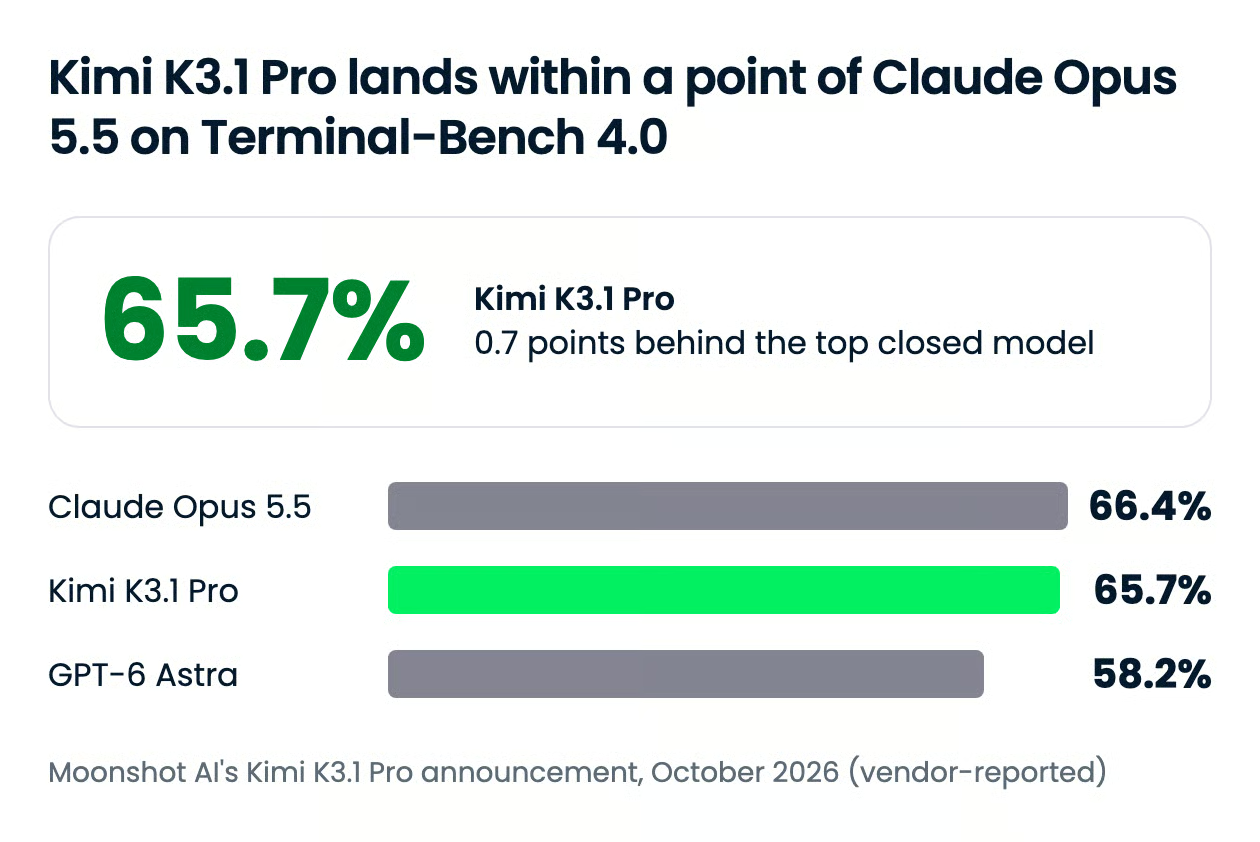
智能体编码是 K3.1 Pro 最强的领域。在 Terminal-Bench 4.0(以真实、资源受限的终端任务评测编码智能体)上,K3.1 Pro 得分 65.7%。这只比 Claude Opus 5.5 的 66.4% 略低,且明显领先 GPT-6 Astra 的 58.2%。
其余编码结果较标题亮点更为参差。以下成绩均为厂商自报,每行最优分以粗体显示:
| Benchmark | 衡量内容 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 在真实终端任务上的编码智能体 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 20 个多小时工程任务,无网络 | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 113 个长周期任务,按行为评分 | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon(Moonshot 内部) | 多步骤执行与工具使用 | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | 从二进制与规格反向重建程序(至少通过 95% 测试的任务) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | 科研工作流上的智能体 | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro 在长时工程任务上与最强封闭模型打成平手,并在 Moonshot 的 SWE-Marathon 对比中领先。就 DeepSWE 而言,各实验室各用各的设置,3 分的差距更像是平手而非胜出。当需要仅凭观测行为重建程序或推进科研工作流时,它则明显落后。
与前代相比,最清晰的提升体现在 Moonshot 自家的长周期基准上,Kimi K3 当时得分为 55.95%。
在重工具的智能体工作上,K3.1 Pro 领先或与 Opus 5.5 相差仅几个百分点:
| Benchmark | 衡量内容 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full(含工具) | 2,500 道高难度知识与推理问题,允许用工具 | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | 在网页上查找难以定位的信息 | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | 跨真实金融 PDF 的数值分析 | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | 从筛选到盈利分析的投资工作流 | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | 操作桌面电脑完成任务 | 79.6% | 81.8% | 75.8% | 69.3% |
Moonshot 表中一个明显的例外是电脑操作,Opus 5.5 依然领先。在 Frontier Finance 上,Claude Fable 5.1(60.8)总体领先,高于此处展示的四个模型。
在不使用工具时,K3.1 Pro 明显落后于封闭模型:
| Benchmark | 衡量内容 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2,500 道高难度知识与推理问题 | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | HLE 中最难的 1,000 题子集 | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | 研究生水平的科学问题 | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | 图文结合的问题 | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench(Moonshot 内部,数值越低越好) | 错误事实断言占比 | 5.4% | 6.8% | 4.2% | 13.1% |
差距在 HLE-Diamond 上最为显著,而 GPQA-Diamond 基本接近“饱和”,2 分的差距意义不大。若您的工作以高难度的闭卷推理为主,这并非值得切换的模型。
Moonshot 在开放权重发布中做了件不寻常的事:公开了其有意削减的能力幅度。它发现中期训练数据与 RL 环境中的网络安全相关内容会稳步提升漏洞研究能力,因此在开放权重版本中将这类数据从两个阶段都移除。
在 Moonshot 的内部漏洞开发基准 xdev-bench-hard 上,未移除数据的检查点能解决 90.5% 的问题(pass@3)。发布的 K3.1 Pro 能解决 81.0%,仍显著高于 Kimi K3 的 33.3%。在公开网络安全基准上,它低于 Moonshot 对比的所有封闭模型,在 ExploitBench 上得分 74.7,对比 Opus 5.5 的 91.0。
Moonshot 表示其原则是在逐步提升开放权重水平的同时,避免发布在攻防网络安全能力上推动绝对前沿的开放权重。9.5 分的“削减”是否足够,见仁见智,但把数字公之于众已超出许多实验室所做。
标准版 K3.1 Pro 对几乎所有人来说都是正确默认。Highspeed 只有在有人在前端等待输出的场景下,才值回其更高的价格。
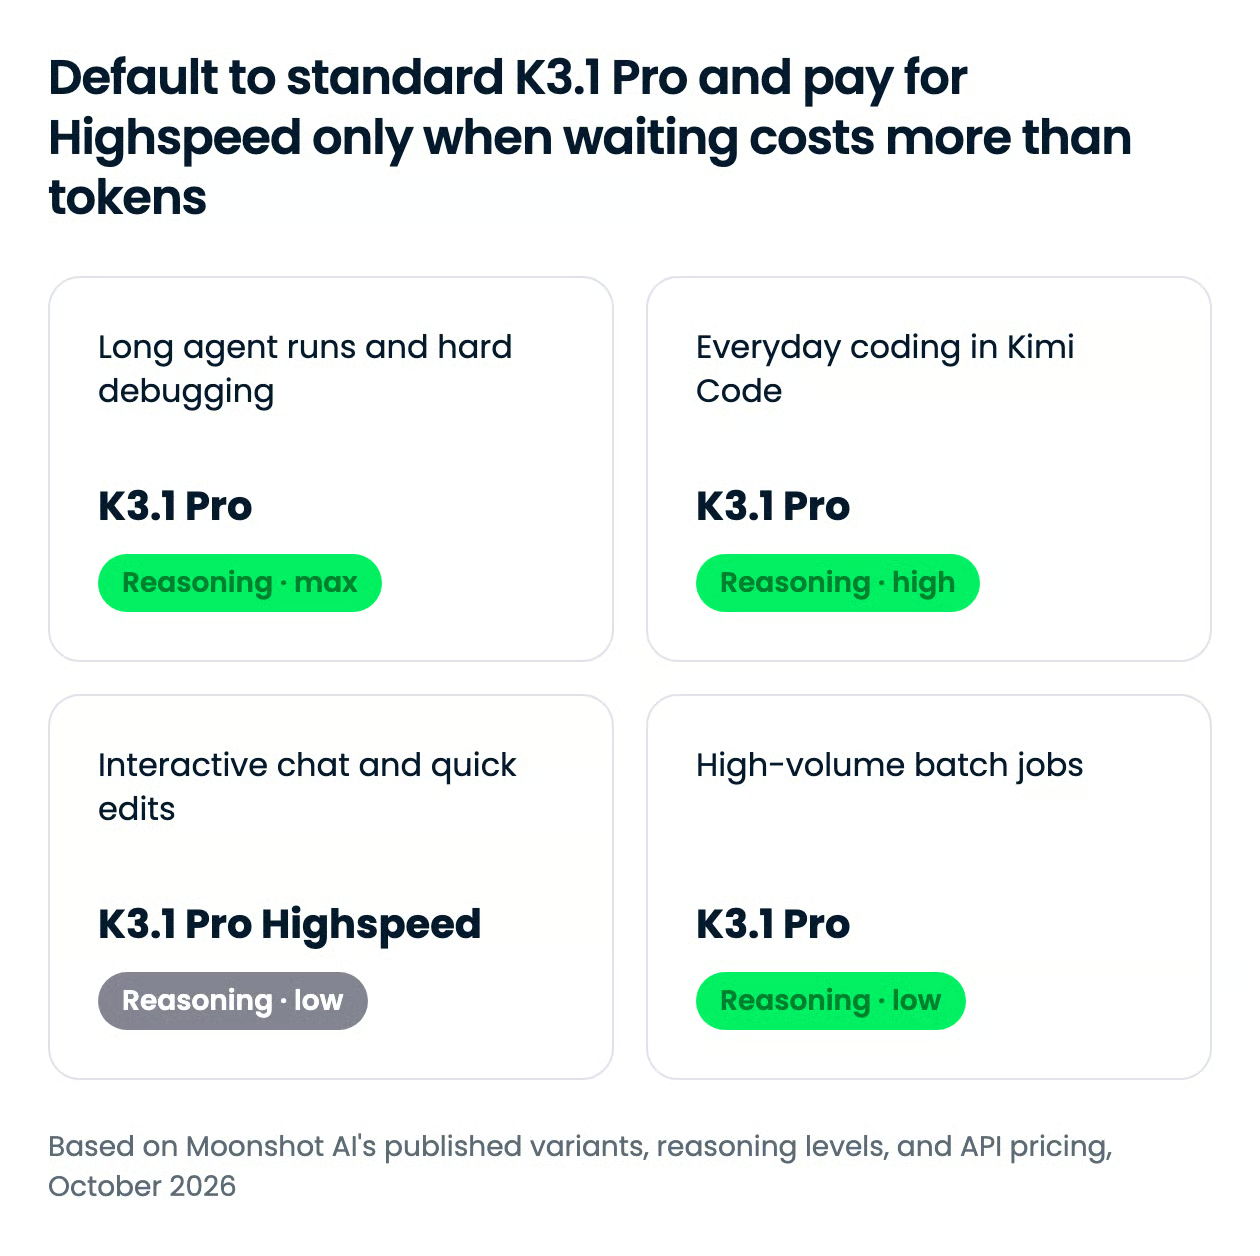
Moonshot 对 Highspeed 的卖点只有速度:运行速度快 2–3 倍,输入与输出 token 价格翻倍,且无单独的基准成绩。
两个变体都会在回答前“思考”,且无法关闭。您可以通过三个推理等级来设定强度:max 用于最难的智能体工作,high 作为合理的中档,low 适用于默认思考时间超过任务所需的场景。API 默认使用 max,Moonshot 基准表中的所有成绩都基于该设置,因此除非任务确实需要全力推理,否则请下调至 high 或 low。
| 使用场景 | 变体 | 推理等级 | 原因 |
|---|---|---|---|
| 长时智能体运行、疑难调试 | K3.1 Pro | max |
Moonshot 编码成绩所用设置;以小时计时的任务,速度相对不重要 |
| 日常在 Kimi Code 中编码 | K3.1 Pro | high |
以更低的 Token 成本获得大部分质量 |
| 交互式对话与快速小改动 | K3.1 Pro Highspeed | low |
延迟是瓶颈,且短提示让 2× 价格的增量可控 |
| 大批量离线作业 | K3.1 Pro | low |
无人等待,选择更低费率并限制思考时间 |
来自 Kimi Code 文档的一个重要实用提示:在会话中途切换推理等级会使上下文缓存失效,因此建议为每个会话固定一个等级,避免来回切换。
Kimi K3.1 Pro 在 Kimi API 上的价格为每百万输入 token 2.00 美元、每百万输出 token 10.00 美元,低于 Kimi K3。定价在整个 100 万 token 上下文范围内保持统一,不收取长上下文附加费。
| 模型 | 输入 | 输出 | 缓存输入 | 5 分钟缓存写入 | 1 小时缓存写入 |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
以上价格均为每百万 token,未含税。缓存默认自动开启(5 分钟),您也可以在每次调用中申请 1 小时档。
在规划前,以下接入细节值得注意:
如果您仍在使用 K2 系列模型,Moonshot 文档称其将于 2026 年 10 月 31 日起不再向新用户提供,并将在 2026 年 12 月底前退役。
您今天即可通过 Kimi API、OpenRouter 和 Kimi 自家应用使用 Kimi K3.1 Pro,但暂不可下载权重。Moonshot 称完整权重将于 2026 年 11 月 4 日前发布,其公告未提及许可证条款,待权重发布后请查阅模型卡。
kimi-k3.1-pro 与 kimi-k3.1-pro-highspeed,采用兼容 OpenAI 的端点。moonshotai/kimi-k3.1-pro。/model 命令选择。Moonshot 文档亦涵盖通过 Kimi Responses API 将其接入 Codex。使用 OpenAI Python 客户端的最简调用如下:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)一旦权重发布,我们的本地运行 LLM 指南涵盖了部署选项,关于 OpenCode 的解读也展示了如何将这类模型接入开源编码智能体。
Kimi K3.1 Pro 进一步证明开放权重模型能够在智能体编码上匹敌封闭前沿,同时价格低于上一代。它并非通用推理的领跑者,但在长时编码与重工具的智能体工作上,已能紧贴 Claude Opus 5.5,并在多项任务上领先 GPT-6 Astra。
Moonshot 也押注于公开其在网络安全取舍上的做法,为开放发布赢得善意。如果您在用智能体写代码,建议现在通过 API 试用,并在 11 月权重与模型卡发布后再考虑自托管。
如果您希望深入使用这类开放模型,推荐查看我们的 Hugging Face 基础技能路径。
与 DataCamp 一起学习 AI!
课程
学习路径
实践并学习路径你的进步。
使用 Google 继续