

Corso
Lavorare con Hugging Face
2 ore
40K
Pratica and corso your progress.
Continua Con GoogleI laboratori open-weight hanno passato il 2026 a ridurre il divario con Anthropic e OpenAI sul coding, e Moonshot AI lo ha ristretto di nuovo. Venerdì scorso, Moonshot ha rilasciato Kimi K3.1 Pro, che definisce il suo modello open-weight più capace nella classe 3T finora, portandolo a un punto da Claude Opus 5.5 nel coding agentico.
K3.1 Pro è una versione pesantemente post-addestrata di Kimi K3 con una finestra di contesto da 1 milione di token. Arriva insieme a una variante più veloce, K3.1 Pro Highspeed, ed è disponibile già oggi nelle app Kimi, in Kimi Code e nell'API Kimi. I pesi completi seguiranno entro il 4 novembre 2026.
In questo articolo, ti racconto tutte le novità di Kimi K3.1 Pro: nuove funzionalità, benchmark e come si confronta il prezzo con Kimi K3. Per ripassare il modello su cui si basa, dai un'occhiata alle nostre guide su Kimi K3 e al nostro tutorial pratico su Kimi K3.
Kimi K3.1 Pro è il modello linguistico di grandi dimensioni (LLM) di punta di Moonshot AI e il primo modello della nuova serie K3.1. Mantiene la base di Kimi K3, un modello da 2,8T parametri con finestra di contesto da 1M di token, e aggiunge molto più compute di post-training.
Il cambiamento è nell'addestramento, non nell'architettura: Moonshot ha eseguito reinforcement learning (RL) congiunto su quelle che definisce "centinaia di domini downstream", e ha ricostruito il framework RL, l'infrastruttura sandbox e la pianificazione dei rollout in modo che il compute extra producesse progressi costanti. Il risultato, secondo Moonshot, è un miglioramento in ogni dominio misurato, con coding, creazione 3D e ricerca finanziaria messi in evidenza.
La dichiarazione principale è la parità nel coding agentico con i migliori modelli proprietari. La tabella di Moonshot colloca K3.1 Pro a un punto da Claude Opus 5.5 nei compiti di coding basati su terminale, a una frazione del prezzo di Anthropic. Il modello è open-weight, ma i pesi non sono ancora pubblici.
K3.1 Pro è un upgrade ampio, non un singolo trucco nuovo. Le quattro capacità seguenti sono quelle per cui cambierei davvero un flusso di lavoro.
K3.1 Pro riesce a seguire compiti di coding lunghi e multi-step, diagnosticando i propri fallimenti invece di limitarsi a riprovare. Il caso dimostrativo di Moonshot è un simulatore di camminata umana basato sul modello anatomico open-source human-atlas, con 296 componenti scheletrici e 402 muscolari.
Su 167 missioni e 420 revisioni indipendenti, il modello ha portato l'umano simulato dal collassare in pochi secondi al camminare con passi alternati per 11,2 secondi. La parte interessante è arrivata quando il reward shaping ha smesso di aiutare il movimento delle braccia: K3.1 Pro ha eseguito sonde open-loop del simulatore, trovato 36 errori nei calcoli dei moment arm dei muscoli della spalla, li ha corretti e ha riaddestrato.
È una demo interna, quindi trattala come un'illustrazione del caso d'uso previsto più che come prova. Resta il fatto che mostra l'obiettivo di Moonshot: agenti che indagano e iterano.
Moonshot afferma che K3.1 Pro produce pagine front-end, scene Three.js e asset 3D con "composizione, tipografia, animazione e finitura" più solide. Funziona con Unity, Unreal Engine e Godot, e può combinarli con la ricerca web e la generazione 3D per assemblare un progetto completo.
Sul lato modellazione, K3.1 Pro scrive ed esegue script per Blender e software CAD direttamente, senza connettori MCP, per costruire modelli parametrici come parti meccaniche, modelli architettonici e arredi configurabili. Moonshot ha anche lanciato 3D Make su kimi.ai e sull'app Kimi, dove puoi visualizzare in anteprima, modificare e scaricare modelli pronti per la stampa 3D.
Anche la pretesa di qualità visiva è la più difficile da verificare con una tabella di benchmark, quindi considera le demo di Moonshot come i migliori esempi del fornitore, non come output tipico.
K3.1 Pro può portare un flusso di lavoro finanziario dallo screening a un workbook finito, e Moonshot ha fatto correzioni mirate all'accuratezza fattuale per questo tipo di lavoro. Sui suoi benchmark interni di finanza, K3.1 Pro migliora Kimi K3 di 7,2 punti su Financial Modeling e 11,6 punti su Financial Research, e raggiunge circa 4,2× il punteggio di K3 su Business Operation, un compito simulato a lungo orizzonte.
Il lavoro sull'accuratezza emerge nel test da stress sulle allucinazioni di Moonshot. Su Kimi Hallu Bench Hard, il tasso di allucinazioni a livello di affermazione è sceso dal 23,4% di K3 all'8,3% di K3.1 Pro. Moonshot precisa che il test è costruito per provocare errori, quindi quei tassi non sono i tassi d'errore quotidiani.
Kimi K3.1 Pro è competitivo con Claude Opus 5.5 e GPT-6 Astra nel coding agentico e nel lavoro pesante di strumenti, ma chiaramente dietro su puro ragionamento. Tutte le cifre sotto provengono dall'annuncio di Moonshot, con K3.1 Pro a sforzo max.
Il coding agentico è dove K3.1 Pro appare più forte. Su Terminal-Bench 4.0, che valuta agenti di coding su compiti realistici e vincolati in risorse da terminale, K3.1 Pro segna il 65,7%. È solo di pochissimo dietro a Claude Opus 5.5 con il 66,4% e ben avanti di GPT-6 Astra con il 58,2%.
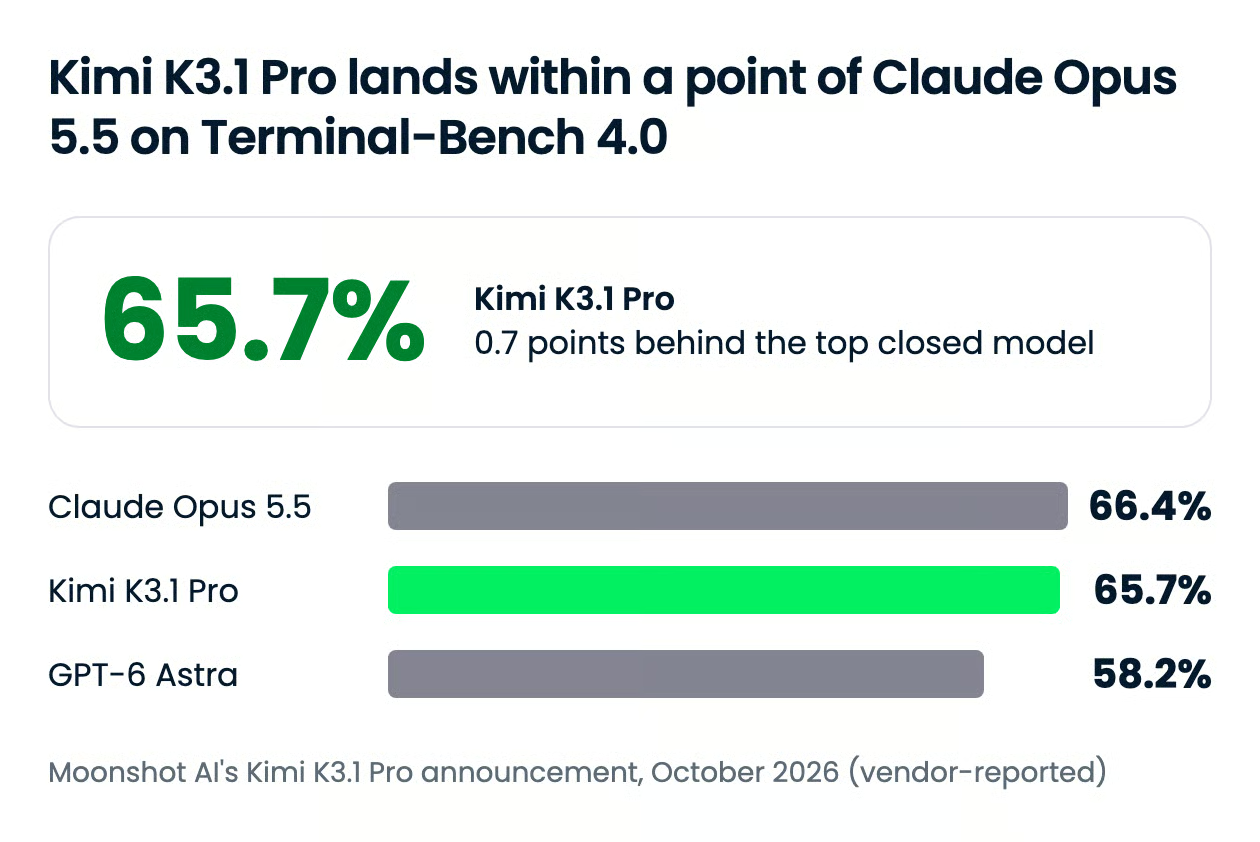
Il resto dei risultati sul coding è più sfumato di quanto suggerisca il titolo. Tutti i punteggi sono riportati dal fornitore, con il migliore in ogni riga in grassetto:
| Benchmark | Cosa misura | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agenti di coding su compiti realistici da terminale | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 compiti di ingegneria multi-ora, senza internet | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 compiti a lungo orizzonte, valutati sul comportamento | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (interno Moonshot) | Esecuzione multi-step e uso di strumenti | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Ricostruire un programma dal suo binario e dalla specifica (task che passano almeno il 95% dei test) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agenti su flussi di lavoro di ricerca scientifica | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro è al livello dei migliori modelli chiusi su lunghi compiti di ingegneria e guida il confronto SWE-Marathon di Moonshot. Su DeepSWE, ogni laboratorio ha eseguito il proprio setup, quindi una forbice di 3 punti è un pareggio più che una vittoria. Rimane molto indietro quando deve ricostruire un programma solo dal comportamento osservato, o affrontare un flusso di lavoro di ricerca scientifica.
Rispetto al suo predecessore, il guadagno più chiaro è sul benchmark a lungo orizzonte interno di Moonshot, dove Kimi K3 segnava 55,95%.
Nel lavoro di agenti pesante sugli strumenti, K3.1 Pro guida o si colloca a pochi punti da Opus 5.5:
| Benchmark | Cosa misura | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full con strumenti | 2.500 domande difficili di conoscenza e ragionamento, con strumenti consentiti | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Trovare informazioni difficili da reperire sul web | 92,1% | 90,8% | 91,5% | n/d |
| OfficeQA Pro v2 | Analisi numerica su PDF finanziari reali | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Flussi di lavoro d'investimento dallo screening all'analisi della redditività | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Usare un computer desktop per completare task | 79,6% | 81,8% | 75,8% | 69,3% |
L'unica eccezione chiara nella tabella di Moonshot è l'uso del computer, dove Opus 5.5 resta avanti. Su Frontier Finance, Claude Fable 5.1 (60,8) è il leader complessivo, davanti a tutti e quattro i modelli mostrati qui.
Senza strumenti, K3.1 Pro rimane chiaramente dietro ai modelli chiusi:
| Benchmark | Cosa misura | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 domande difficili di conoscenza e ragionamento | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | Sottoinsieme più difficile di HLE con 1.000 domande | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Domande di scienza a livello graduate | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Domande che combinano immagini e testo | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (interno Moonshot, più basso è meglio) | Quota di affermazioni fattuali sbagliate | 5,4% | 6,8% | 4,2% | 13,1% |
Il divario è più ampio su HLE-Diamond, mentre GPQA-Diamond è quasi saturo, quindi i 2 punti di differenza dicono poco. Se il tuo lavoro è ragionamento closed-book difficile, questo non è il modello su cui passare.
Moonshot ha fatto qualcosa di insolito per un rilascio open-weight: ha pubblicato quanta capacità ha rimosso deliberatamente. Ha rilevato che i contenuti legati al cyber nei dati di metà addestramento e negli ambienti RL stavano aumentando costantemente l'abilità di ricerca sulle vulnerabilità, quindi ha rimosso quei dati da entrambe le fasi per il rilascio open-weight.
Su xdev-bench-hard, il benchmark interno di Moonshot per lo sviluppo di exploit, un checkpoint senza rimozione dei dati ha risolto il 90,5% dei problemi (pass@3). Il K3.1 Pro rilasciato risolve l'81,0%, che è comunque molto sopra al 33,3% di Kimi K3. Sugli standard pubblici di cyber si colloca sotto ogni modello chiuso confrontato da Moonshot, segnando 74,7 su ExploitBench contro i 91,0 di Opus 5.5.
Il principio dichiarato di Moonshot è evitare di rilasciare pesi aperti che spingano il confine assoluto della capacità cyber offensiva, alzando invece gradualmente l'asticella open-weight. Se un taglio di 9,5 punti sia sufficiente è una valutazione soggettiva, ma pubblicare il numero è più di quanto facciano molti altri laboratori.
K3.1 Pro standard è la scelta giusta di default quasi per tutti. La variante Highspeed si giustifica al prezzo più alto solo quando una persona è davanti all'output in attesa.
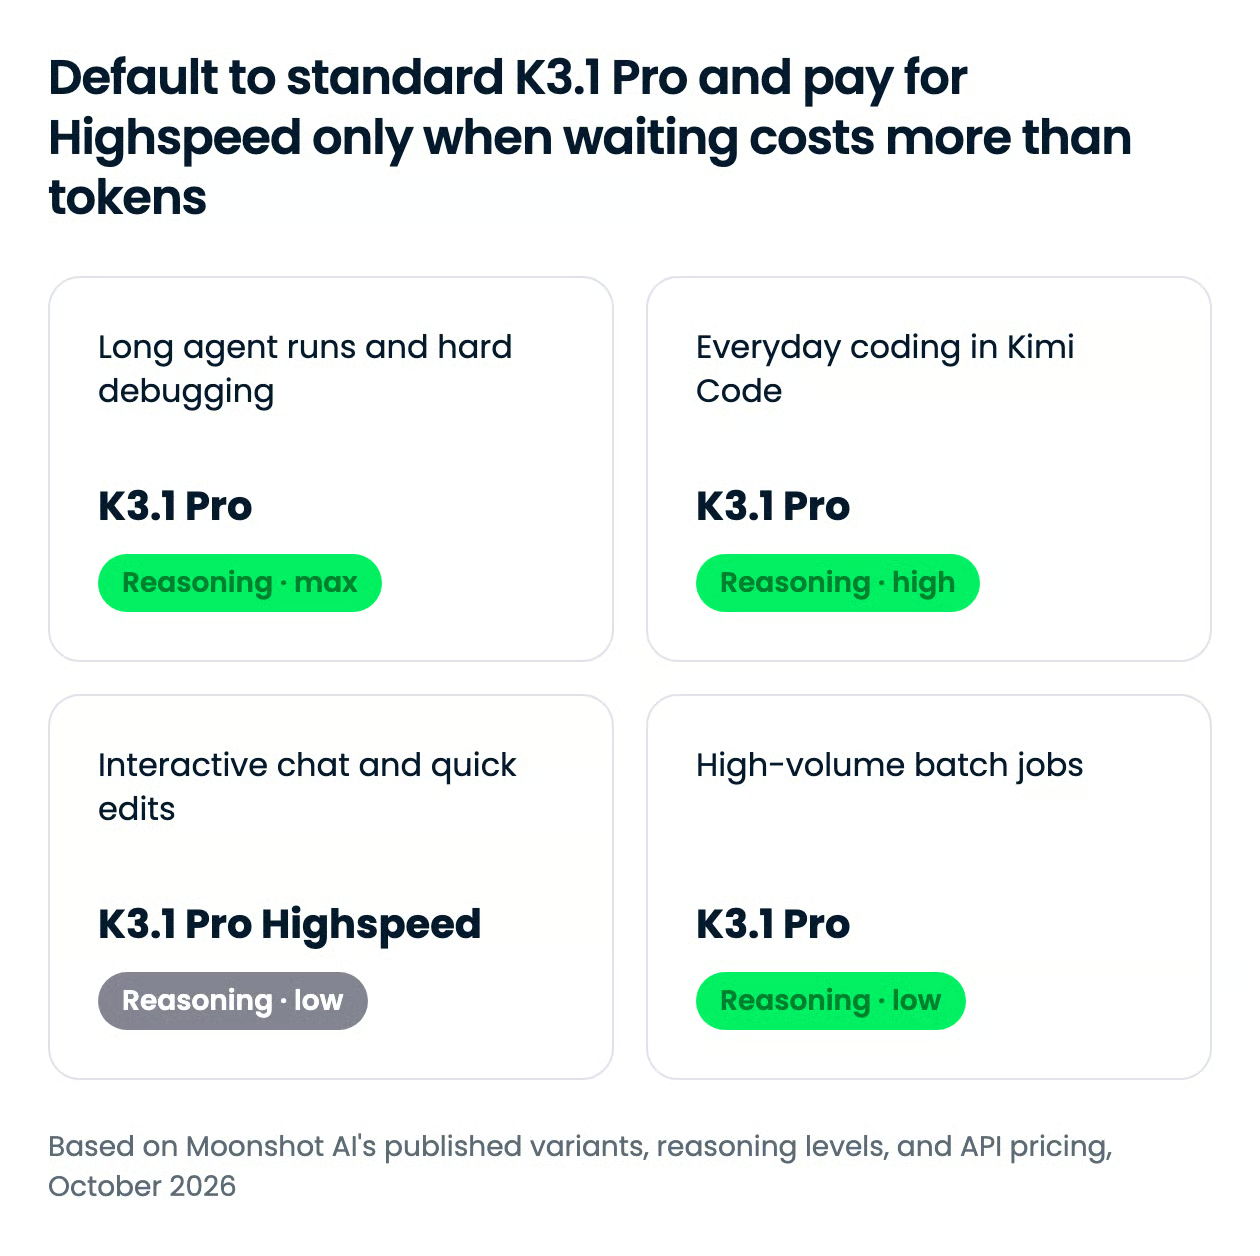
Moonshot vende Highspeed esclusivamente sulla velocità: va 2–3× più veloce, costa il doppio per token in input e output, e non ha risultati di benchmark separati.
Entrambe le varianti pensano sempre prima di rispondere, e non puoi disattivarlo. Imposti l'intensità con tre livelli di ragionamento: max per il lavoro agentico più duro, high come via di mezzo sensata e low quando il tempo di pensiero di default è più di quanto serva. L'API predefinisce max, l'impostazione dietro ogni punteggio nella tabella di Moonshot: quindi abbassala a high o low a meno che il compito richieda la massima profondità.
| Caso d'uso | Variante | Livello di ragionamento | Perché |
|---|---|---|---|
| Lunghe esecuzioni di agenti, debug difficile | K3.1 Pro | max |
L'impostazione dietro i punteggi di coding di Moonshot; su ore la velocità conta meno |
| Coding quotidiano in Kimi Code | K3.1 Pro | high |
Quasi tutta la qualità con un conto token più basso |
| Chat interattiva e modifiche rapide | K3.1 Pro Highspeed | low |
La latenza è il collo di bottiglia, e prompt brevi tengono basso il prezzo 2× |
| Job batch ad alto volume | K3.1 Pro | low |
Nessuno sta aspettando, quindi paga meno e limita il thinking |
Nota pratica importante dalla documentazione di Kimi Code: cambiare il livello di ragionamento a sessione in corso invalida la cache di contesto, quindi scegli un livello per sessione invece di alternarlo.
Kimi K3.1 Pro costa $2,00 per milione di token in input e $10,00 per milione di token in output sull'API Kimi, meno di Kimi K3. Il prezzo è uniforme su tutto il contesto da 1M di token, senza sovrapprezzo per contesti lunghi.
| Modello | Input | Output | Input in cache | Scrittura cache 5 minuti | Scrittura cache 1 ora |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2,00 | $10,00 | $0,20 | $2,00 | $4,00 |
| Kimi K3.1 Pro Highspeed | $4,00 | $20,00 | $0,20 | $4,00 | $8,00 |
| Kimi K3 (generazione precedente) | $3,00 | $15,00 | $0,30 | $3,00 | $6,00 |
I prezzi sono per milione di token ed escludono le tasse. Il caching è automatico con default a 5 minuti, e puoi richiedere il tier da 1 ora per chiamata.
Alcuni dettagli di accesso da conoscere prima di pianificare:
Se usi ancora i modelli della serie K2, la documentazione di Moonshot indica che non saranno disponibili per i nuovi utenti dal 31 ottobre 2026 e verranno ritirati entro fine dicembre 2026.
Puoi usare Kimi K3.1 Pro oggi tramite l'API Kimi, OpenRouter e le app di Kimi, ma non ancora come pesi scaricabili. Moonshot afferma che i pesi completi verranno rilasciati entro il 4 novembre 2026 e l'annuncio non menziona i termini di licenza, quindi controlla la model card quando i pesi arriveranno.
kimi-k3.1-pro e kimi-k3.1-pro-highspeed, su un endpoint compatibile con OpenAI.moonshotai/kimi-k3.1-pro./model. La documentazione di Moonshot copre anche il collegamento a Codex tramite la Kimi Responses API.Una chiamata minimale con il client Python di OpenAI è questa:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Una volta disponibili i pesi, la nostra guida su come eseguire LLM in locale copre le opzioni di serving, e il nostro approfondimento su OpenCode mostra come collegare un modello come questo a un agente di coding open-source.
Kimi K3.1 Pro è la prova più convincente finora che i modelli open-weight possono raggiungere i modelli chiusi all’avanguardia nel coding agentico, a un prezzo inferiore al suo stesso predecessore. Non è un leader nel ragionamento generale, ma per lunghi compiti di coding e lavoro di agenti ricco di strumenti si colloca accanto a Claude Opus 5.5 e davanti a GPT-6 Astra in diversi task.
Moonshot punta anche sul fatto che pubblicare i compromessi sul cyber le porterà credito per i rilasci open. Se fai coding con agenti, io lo proverei subito via API e riprenderei in considerazione il self-hosting quando i pesi e la model card arriveranno a novembre.
Se ti interessa lavorare con modelli open come questo, ti consiglio di dare un'occhiata al nostro percorso di competenze Hugging Face Fundamentals.
Impara l'AI con DataCamp!
Corso
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



