Curso
Trabalhando com Hugging Face
2 h
40K
Pratique e programa seu progresso.
Continuar Com O GoogleLaboratórios de modelos com pesos abertos passaram 2026 reduzindo a distância para Anthropic e OpenAI em coding, e a Moonshot AI acabou de encurtar ainda mais. Na última sexta, a Moonshot lançou o Kimi K3.1 Pro, que ela chama de seu modelo open-weight de classe 3T mais capaz até agora — e que fica a um ponto do Claude Opus 5.5 em coding com agentes.
O K3.1 Pro é uma versão com pós-treinamento intenso do Kimi K3, com janela de contexto de 1 milhão de tokens. Ele vem acompanhado de uma variante mais rápida, a K3.1 Pro Highspeed, e já está disponível nos apps Kimi, no Kimi Code e na API do Kimi. Os pesos completos chegam até 4 de novembro de 2026.
Neste artigo, vou cobrir tudo o que há de novo no Kimi K3.1 Pro: os recursos, os benchmarks e como os preços se comparam ao Kimi K3. Para entender o modelo em que ele se baseia, confira nossos guias do Kimi K3 e o nosso tutorial prático do Kimi K3.
O Kimi K3.1 Pro é o LLM carro-chefe da Moonshot AI e o primeiro modelo da nova linha K3.1. Ele mantém a base do Kimi K3, um modelo com 2,8T de parâmetros e janela de contexto de 1M de tokens, e adiciona muito mais computação de pós-treinamento por cima.
A mudança está no treinamento, não na arquitetura: a Moonshot rodou aprendizado por reforço (RL) conjunto em "centenas de domínios downstream", como ela descreve, e reconstruiu seu framework de RL, a infraestrutura de sandbox e o agendamento de rollouts para que o aumento de compute gerasse ganhos consistentes. O resultado, segundo a Moonshot, é melhora em todos os domínios medidos, com destaque para coding, criação 3D e pesquisa financeira.
A principal alegação é paridade em coding com agentes em relação aos melhores modelos proprietários. A própria tabela da Moonshot coloca o K3.1 Pro a um ponto do Claude Opus 5.5 em tarefas de coding no terminal, cobrando uma fração do preço da Anthropic. O modelo é open-weight, mas os pesos ainda não são públicos.
O K3.1 Pro é um upgrade amplo, não um truque único. As quatro capacidades abaixo são as que realmente mudam um fluxo de trabalho.
O K3.1 Pro consegue manter o foco em tarefas longas e complexas de coding, diagnosticando as próprias falhas em vez de só tentar de novo. A vitrine da Moonshot é um simulador de caminhada humana construído sobre o modelo anatômico open-source human-atlas, com 296 componentes esqueléticos e 402 músculos.
Ao longo de 167 missões e 420 avaliações independentes, o modelo levou o humano simulado de cair em segundos para caminhar com passadas alternadas por 11,2 segundos. A parte interessante veio quando o ajuste de recompensas parou de ajudar o movimento do braço: o K3.1 Pro fez sondagens open-loop no simulador, encontrou 36 erros nos cálculos de momento dos músculos do ombro, corrigiu e re-treinou.
É um demo interno, então trate como ilustração do caso de uso pretendido, não como prova definitiva. Ainda assim, mostra o foco da Moonshot: agentes que investigam e iteram.
Segundo a Moonshot, o K3.1 Pro produz páginas front-end, cenas em Three.js e assets 3D com "composição, tipografia, animação e acabamento mais fortes". Ele trabalha com Unity, Unreal Engine e Godot, e pode combinar isso com busca na web e geração 3D para montar um projeto completo.
No lado de modelagem, o K3.1 Pro escreve e executa scripts para Blender e softwares CAD diretamente, sem conectores MCP, para construir modelos paramétricos como peças mecânicas, modelos arquitetônicos e móveis configuráveis. A Moonshot também lançou o 3D Make no kimi.ai e no app Kimi, onde você pode pré-visualizar, editar e baixar modelos prontos para impressão 3D.
A alegação de qualidade visual também é a mais difícil de verificar em uma tabela de benchmark, então encare os demos da Moonshot como os melhores exemplos do fornecedor, não como saída típica.
O K3.1 Pro consegue levar um fluxo financeiro do screening até uma planilha finalizada, e a Moonshot fez correções direcionadas de exatidão factual para esse tipo de trabalho. Em seus benchmarks internos de finanças, o K3.1 Pro melhora o Kimi K3 em 7,2 pontos em Financial Modeling e 11,6 pontos em Financial Research, e atinge cerca de 4,2× a pontuação do K3 em Business Operation, uma tarefa de negócio simulada de longo horizonte.
O trabalho de acurácia aparece no teste de estresse de alucinações da Moonshot. No Kimi Hallu Bench Hard, a taxa de alucinação por afirmação caiu de 23,4% no K3 para 8,3% no K3.1 Pro. A Moonshot ressalta que o teste é feito para provocar erros, então essas taxas não representam o dia a dia.
O Kimi K3.1 Pro é competitivo com o Claude Opus 5.5 e o GPT-6 Astra em coding com agentes e trabalho pesado com ferramentas, mas fica claramente atrás em raciocínio puro. Todos os números abaixo vêm do anúncio da Moonshot, com o K3.1 Pro em esforço max.
É onde o K3.1 Pro parece mais forte. No Terminal-Bench 4.0, que avalia agentes de coding em tarefas realistas e com recursos limitados no terminal, o K3.1 Pro marca 65,7%. Fica muito pouco atrás do Claude Opus 5.5, com 66,4%, e bem à frente do GPT-6 Astra, com 58,2%.
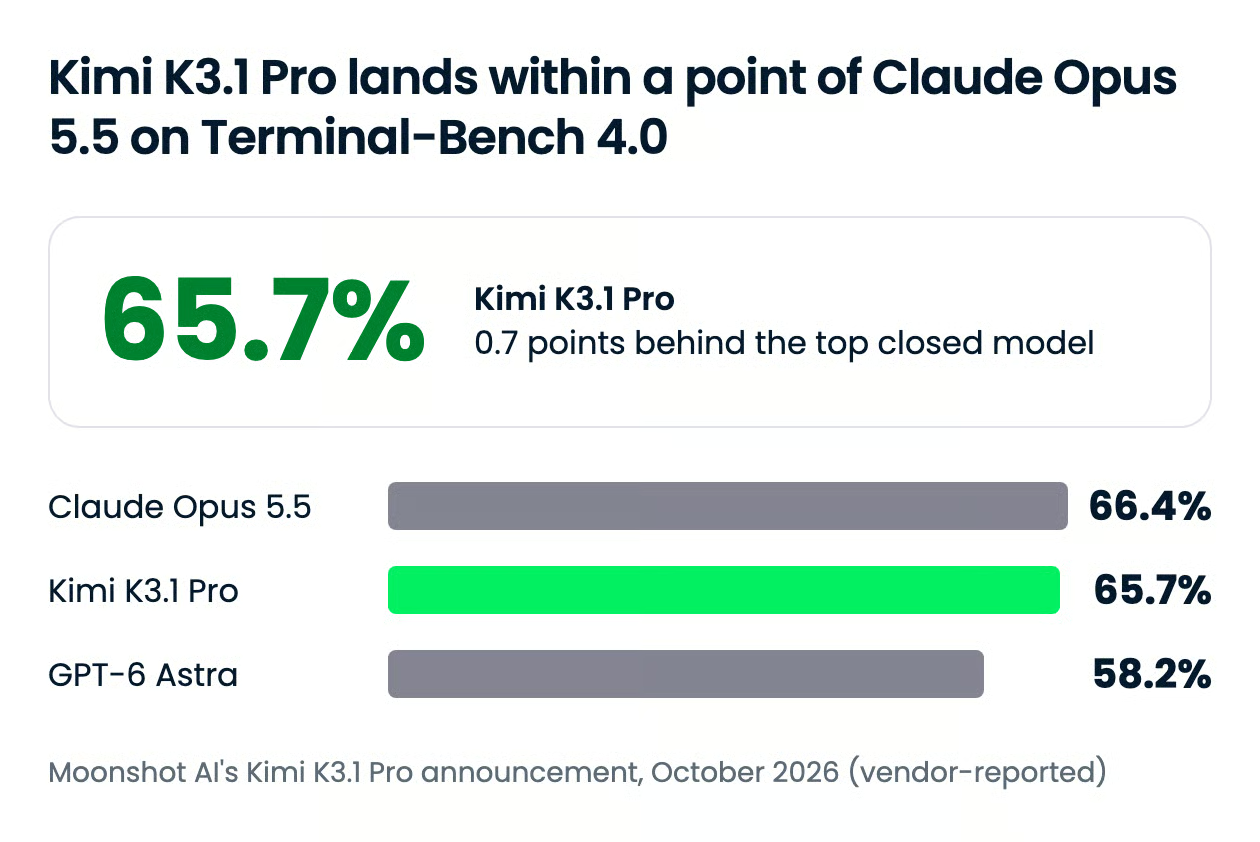
O restante dos resultados de coding é mais misto do que o título sugere. Todas as pontuações são reportadas pelos fornecedores, com a melhor em cada linha em negrito:
| Benchmark | O que mede | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agentes de coding em tarefas realistas no terminal | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 tarefas de engenharia de várias horas, sem internet | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 tarefas de longo horizonte, avaliadas por comportamento | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (interno da Moonshot) | Execução em múltiplas etapas e uso de ferramentas | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Reconstruir um programa a partir do binário e da especificação (tarefas com pelo menos 95% dos testes) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agentes em fluxos de pesquisa científica | 38,1% | 63,3% | 68,1% | 15,7% |
O K3.1 Pro empata com os melhores modelos fechados em tarefas longas de engenharia e lidera a comparação SWE-Marathon da Moonshot. No DeepSWE, cada laboratório rodou sua própria configuração, então uma diferença de 3 pontos é mais um empate do que uma vitória. Ele fica bem atrás quando precisa reconstruir um programa apenas pelo comportamento observado ou seguir um fluxo de pesquisa científica.
Contra o antecessor, o ganho mais claro é no benchmark interno de longo horizonte da Moonshot, em que o Kimi K3 marcou 55,95%.
Em trabalho com agentes pesado em ferramentas, o K3.1 Pro lidera ou fica a poucos pontos do Opus 5.5:
| Benchmark | O que mede | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full com ferramentas | 2.500 perguntas difíceis de conhecimento e raciocínio, com ferramentas | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Encontrar informações difíceis na web | 92,1% | 90,8% | 91,5% | n/a |
| OfficeQA Pro v2 | Análise numérica em PDFs financeiros reais | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Fluxos de investimento do screening à análise de lucratividade | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Operar um desktop para concluir tarefas | 79,6% | 81,8% | 75,8% | 69,3% |
A exceção clara na tabela da Moonshot é o uso do computador, onde o Opus 5.5 segue na frente. No Frontier Finance, o Claude Fable 5.1 (60,8) é o líder geral, à frente dos quatro modelos mostrados aqui.
Sem ferramentas, o K3.1 Pro fica claramente atrás dos modelos fechados:
| Benchmark | O que mede | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 perguntas difíceis de conhecimento e raciocínio | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | 1.000 perguntas mais difíceis do HLE | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Perguntas de ciências em nível de pós-graduação | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Perguntas que combinam imagens e texto | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (interno da Moonshot, menor é melhor) | Parcela de afirmações factuais incorretas | 5,4% | 6,8% | 4,2% | 13,1% |
A diferença é maior no HLE-Diamond, enquanto o GPQA-Diamond está quase saturado, então uma diferença de 2 pontos diz pouco. Se o seu trabalho é raciocínio fechado de alta dificuldade, este não é o modelo para migrar.
A Moonshot fez algo incomum para um lançamento com pesos abertos: publicou quanto de capacidade ela removeu de propósito. A empresa observou que conteúdo relacionado a cyber em seus dados de meio de treinamento e nos ambientes de RL estava elevando de forma constante a habilidade de pesquisa de vulnerabilidades, então removeu esses dados de ambas as etapas para o lançamento open-weight.
No xdev-bench-hard, benchmark interno de desenvolvimento de exploits, um checkpoint sem a remoção de dados resolveu 90,5% dos problemas (pass@3). O K3.1 Pro disponibilizado resolve 81,0%, ainda muito acima dos 33,3% do Kimi K3. Em benchmarks públicos de cyber, ele fica abaixo de todos os modelos fechados comparados pela Moonshot, marcando 74,7 no ExploitBench contra 91,0 do Opus 5.5.
O princípio declarado da Moonshot é evitar liberar pesos abertos que empurrem a fronteira absoluta da capacidade ofensiva em cyber, elevando a barra open-weight de forma gradual. Se um corte de 9,5 pontos é suficiente, é questão de julgamento — mas publicar o número já é mais do que muitos laboratórios fazem.
O K3.1 Pro padrão é a escolha certa para quase todo mundo. A variante Highspeed só compensa o preço maior quando tem alguém esperando a resposta.
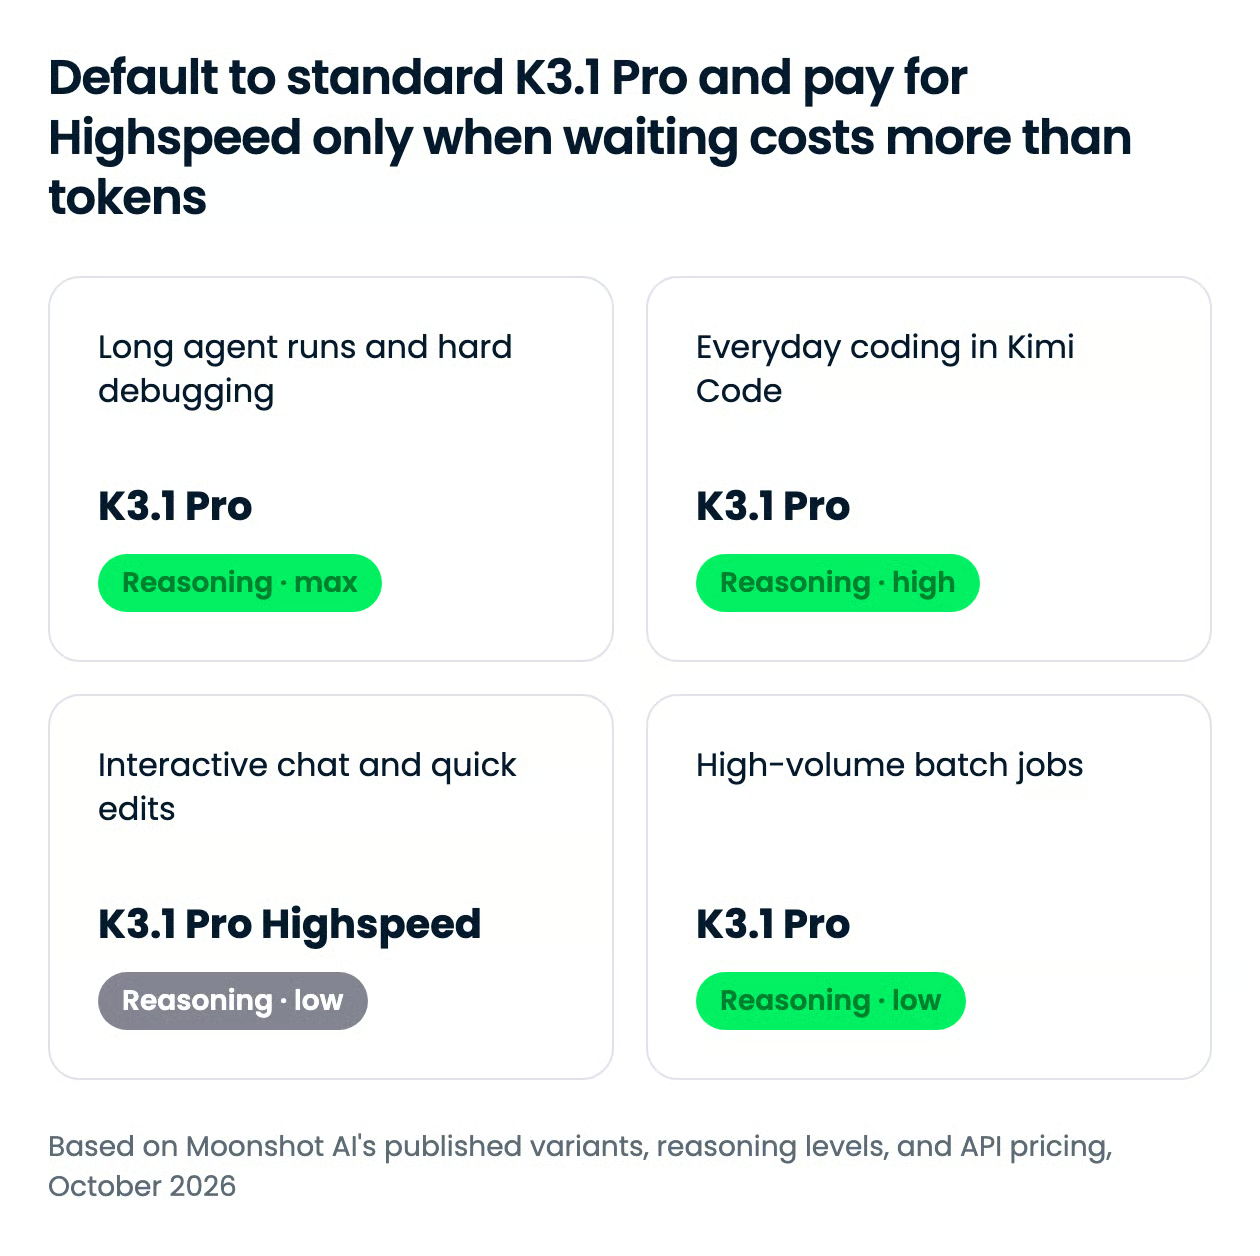
A Moonshot vende o Highspeed puramente pela velocidade: ele roda de 2 a 3× mais rápido, custa o dobro por token de entrada e saída, e não tem resultados de benchmark separados.
Ambas as variantes sempre "pensam" antes de responder, e você não pode desativar isso. Você define a intensidade com três níveis de raciocínio: max para o trabalho mais pesado com agentes, high como meio-termo sensato e low quando o tempo padrão de raciocínio é mais do que a tarefa exige. A API vem em max por padrão — o ajuste por trás de todas as notas na tabela de benchmarks da Moonshot — então reduza para high ou low a menos que a tarefa precise de profundidade total.
| Caso de uso | Variante | Nível de raciocínio | Por quê |
|---|---|---|---|
| Execuções longas com agentes, debugging difícil | K3.1 Pro | max |
O ajuste por trás das notas de coding da Moonshot; velocidade importa menos em horas |
| Coding do dia a dia no Kimi Code | K3.1 Pro | high |
Quase toda a qualidade com uma conta menor de tokens |
| Chat interativo e edições rápidas | K3.1 Pro Highspeed | low |
Latência é o gargalo, e prompts curtos mantêm pequeno o preço 2× |
| Jobs em lote de alto volume | K3.1 Pro | low |
Ninguém está esperando; pague menos e limite o raciocínio |
Um ponto prático importante dos docs do Kimi Code: trocar o nível de raciocínio no meio da sessão invalida o cache de contexto; então escolha um nível por sessão em vez de ficar alternando.
O Kimi K3.1 Pro custa US$ 2,00 por milhão de tokens de entrada e US$ 10,00 por milhão de tokens de saída na API do Kimi, menos do que o Kimi K3. O preço é flat em todo o contexto de 1M de tokens, sem sobretaxa para contexto longo.
| Modelo | Entrada | Saída | Entrada em cache | Gravação de cache 5 min | Gravação de cache 1 h |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | US$ 2,00 | US$ 10,00 | US$ 0,20 | US$ 2,00 | US$ 4,00 |
| Kimi K3.1 Pro Highspeed | US$ 4,00 | US$ 20,00 | US$ 0,20 | US$ 4,00 | US$ 8,00 |
| Kimi K3 (geração anterior) | US$ 3,00 | US$ 15,00 | US$ 0,30 | US$ 3,00 | US$ 6,00 |
Os preços são por milhão de tokens e sem impostos. O cache é automático, com padrão de 5 minutos, e você pode solicitar a faixa de 1 hora por chamada.
Alguns detalhes de acesso valem atenção antes de planejar:
Se você ainda usa modelos da série K2, os docs da Moonshot dizem que eles ficarão indisponíveis para novos usuários a partir de 31 de outubro de 2026 e serão descontinuados até o fim de dezembro de 2026.
Você já pode usar o Kimi K3.1 Pro pela API do Kimi, pelo OpenRouter e pelos próprios apps do Kimi, mas ainda não como pesos para download. A Moonshot diz que os pesos completos serão liberados até 4 de novembro de 2026, e o anúncio não menciona termos de licença — então confira o model card quando os pesos chegarem.
kimi-k3.1-pro e kimi-k3.1-pro-highspeed, em endpoint compatível com OpenAI.moonshotai/kimi-k3.1-pro./model. Os docs da Moonshot também cobrem a conexão com o Codex via Kimi Responses API.Uma chamada mínima com o cliente Python da OpenAI fica assim:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Assim que os pesos chegarem, nosso guia sobre como rodar LLMs localmente cobre as opções de serving, e nosso explicador sobre OpenCode mostra como plugar um modelo como este em um agente de coding open-source.
O Kimi K3.1 Pro é o argumento mais forte até agora de que modelos com pesos abertos podem encostar nos modelos fechados de ponta em coding com agentes — e por um preço menor do que o próprio antecessor. Ele não lidera em raciocínio geral, mas para coding longo e trabalho com agentes pesados em ferramentas fica lado a lado com o Claude Opus 5.5 e à frente do GPT-6 Astra em várias tarefas.
A Moonshot também aposta que publicar seus trade-offs em cyber vai gerar boa vontade para seus lançamentos abertos. Se você programa com agentes, vale testar agora via API e reavaliar o self-hosting quando os pesos e o model card chegarem em novembro.
Se você quer trabalhar com modelos abertos como este, recomendo explorar nossa trilha de habilidades Hugging Face Fundamentals.
Aprenda IA com a DataCamp!
Curso
Programa
Pratique e programa seu progresso.
Continuar Com O Googleblog
Richie Cotton
7 min
blog
Richie Cotton
blog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min