

Khóa học
Làm việc với Hugging Face
2 giờ
40K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCác phòng lab trọng số mở đã dành năm 2026 để thu hẹp khoảng cách với Anthropic và OpenAI về mã hóa, và Moonshot AI vừa tiếp tục rút ngắn khoảng cách đó. Thứ Sáu tuần trước, Moonshot ra mắt Kimi K3.1 Pro, mà họ gọi là mẫu trọng số mở hạng 3T mạnh nhất từ trước đến nay, và đưa nó tiến sát trong một điểm so với Claude Opus 5.5 ở mảng mã hóa tác vụ tự động.
K3.1 Pro là phiên bản được huấn luyện hậu kỳ mạnh của Kimi K3 với cửa sổ ngữ cảnh 1 triệu token. Nó phát hành kèm biến thể nhanh hơn, K3.1 Pro Highspeed, và hiện đã có trên ứng dụng Kimi, Kimi Code, và Kimi API. Trọn bộ trọng số sẽ theo sau vào ngày 4 tháng 11 năm 2026.
Trong bài viết này, tôi sẽ điểm qua mọi thứ mới ở Kimi K3.1 Pro, gồm các tính năng, điểm chuẩn, và cách định giá so với Kimi K3. Để xem lại mẫu mà nó phát triển dựa trên đó, hãy xem hướng dẫn của chúng tôi về Kimi K3 và hướng dẫn thực hành Kimi K3.
Kimi K3.1 Pro là mô hình ngôn ngữ lớn (LLM) flagship của Moonshot AI và là mẫu đầu tiên trong dòng K3.1 mới. Nó giữ nền tảng của Kimi K3, một mô hình 2,8T tham số với cửa sổ ngữ cảnh 1M token, và bổ sung rất nhiều tài nguyên hậu huấn luyện.
Khác biệt nằm ở quá trình huấn luyện, không phải kiến trúc: Moonshot chạy học tăng cường (RL) kết hợp trên cái họ gọi là “hàng trăm miền hạ nguồn”, và xây dựng lại khung RL, hạ tầng sandbox, cùng lịch triển khai để tài nguyên bổ sung mang lại tiến bộ đều đặn. Kết quả, theo Moonshot, là cải thiện ở mọi miền được đo, với mã hóa, tạo dựng 3D, và nghiên cứu tài chính được nhấn mạnh.
Tuyên bố nổi bật là đạt ngang hàng về mã hóa tác vụ tự động với các mẫu độc quyền hàng đầu. Bảng của chính Moonshot đặt K3.1 Pro sát trong một điểm so với Claude Opus 5.5 ở các tác vụ mã hóa dựa trên terminal, trong khi chỉ tính phí bằng một phần nhỏ so với Anthropic. Mẫu là trọng số mở, nhưng trọng số chưa công khai.
K3.1 Pro là một nâng cấp toàn diện hơn là một “mẹo” đơn lẻ. Bốn khả năng sau là những thứ tôi thực sự sẽ thay đổi quy trình làm việc vì chúng.
K3.1 Pro có thể bám theo một tác vụ mã hóa dài, nhiều bước, tự chẩn đoán thất bại thay vì chỉ thử lại. Màn trình diễn của Moonshot là bộ mô phỏng đi bộ của người, xây dựng trên mô hình giải phẫu mã nguồn mở human-atlas, với 296 thành phần xương và 402 thành phần cơ.
Qua 167 nhiệm vụ và 420 lượt đánh giá độc lập, mô hình đưa người mô phỏng từ chỗ đổ gục trong vài giây đến chỗ đi với bước chân luân phiên trong 11,2 giây. Phần thú vị là khi việc định hình phần thưởng không còn giúp cải thiện chuyển động cánh tay: K3.1 Pro chạy các phép thăm dò open-loop trên bộ mô phỏng, tìm 36 lỗi trong tính toán moment-arm của cơ vai, sửa chúng, và huấn luyện lại.
Đó là một bản demo nội bộ, nên xem như minh họa cho trường hợp sử dụng dự định hơn là bằng chứng. Dù vậy, nó cho thấy Moonshot đang tối ưu vì điều gì: các tác nhân biết điều tra và lặp lại.
Moonshot cho biết K3.1 Pro tạo ra trang front-end, cảnh Three.js, và tài sản 3D với “bố cục, kiểu chữ, hoạt ảnh và độ hoàn thiện” tốt hơn. Nó làm việc với Unity, Unreal Engine, và Godot, và có thể kết hợp với tìm kiếm web và tạo dựng 3D để lắp ghép một dự án hoàn chỉnh.
Ở mảng mô hình hóa, K3.1 Pro viết và chạy script cho Blender và phần mềm CAD trực tiếp, không cần kết nối MCP, để xây dựng các mô hình tham số như chi tiết cơ khí, mô hình kiến trúc, và đồ nội thất cấu hình được. Moonshot cũng ra mắt 3D Make trên kimi.ai và ứng dụng Kimi, nơi bạn có thể xem trước, chỉnh sửa, và tải xuống các mô hình sẵn sàng để in 3D.
Tuyên bố về chất lượng hình ảnh cũng là điều khó kiểm chứng nhất qua bảng điểm chuẩn, nên xem các demo của Moonshot là ví dụ tốt nhất của nhà cung cấp, không phải đầu ra điển hình.
K3.1 Pro có thể đảm đương quy trình tài chính từ sàng lọc đến sổ làm việc hoàn chỉnh, và Moonshot đã sửa mục tiêu vào độ chính xác thực tế cho loại công việc này. Trên các điểm chuẩn tài chính nội bộ, K3.1 Pro cải thiện so với Kimi K3 thêm 7,2 điểm ở Financial Modeling và 11,6 điểm ở Financial Research, và đạt khoảng 4,2× điểm của K3 ở Business Operation, một tác vụ kinh doanh mô phỏng tầm dài.
Công việc tăng độ chính xác thể hiện ở bài kiểm tra ảo giác của Moonshot. Trên Kimi Hallu Bench Hard, tỷ lệ ảo giác ở cấp phát biểu giảm từ 23,4% với K3 xuống 8,3% với K3.1 Pro. Moonshot lưu ý bài test được thiết kế để kích phát lỗi, nên các tỷ lệ đó không phải là lỗi thường ngày.
Kimi K3.1 Pro cạnh tranh được với Claude Opus 5.5 và GPT-6 Astra ở mã hóa tác vụ tự động và công việc nặng về công cụ, nhưng thua rõ ở suy luận thuần. Tất cả số liệu dưới đây đến từ thông báo của Moonshot, với K3.1 Pro ở mức nỗ lực max.
Đây là nơi K3.1 Pro mạnh nhất. Trên Terminal-Bench 4.0, bài chấm điểm tác nhân mã hóa ở các tác vụ terminal thực tế, ràng buộc tài nguyên, K3.1 Pro đạt 65,7%. Chỉ kém rất sát so với Claude Opus 5.5 ở 66,4% và vượt khá xa GPT-6 Astra ở 58,2%.
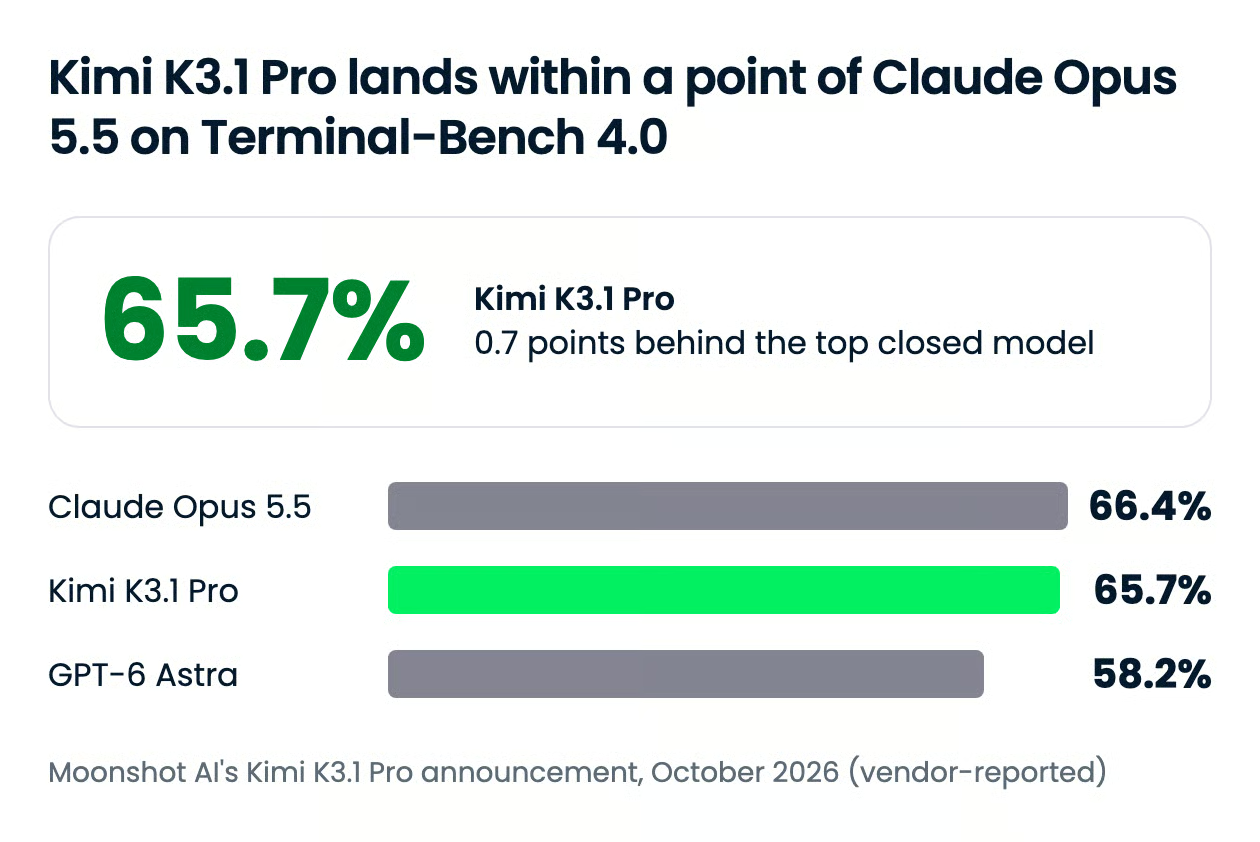
Các kết quả mã hóa còn lại pha trộn hơn so với tiêu đề gợi ý. Tất cả điểm số do nhà cung cấp báo cáo, với điểm cao nhất mỗi hàng in đậm:
| Benchmark | Đo lường gì | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Tác nhân mã hóa ở tác vụ terminal thực tế | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 20 tác vụ kỹ thuật nhiều giờ, không internet | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 113 tác vụ tầm dài, chấm theo hành vi | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (nội bộ Moonshot) | Thực thi nhiều bước và dùng công cụ | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | Xây lại chương trình từ binary và đặc tả (nhiệm vụ vượt ít nhất 95% test) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | Tác nhân trên quy trình nghiên cứu khoa học | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro ngang bằng với các mẫu đóng tốt nhất ở các tác vụ kỹ thuật dài và dẫn đầu trong so sánh SWE-Marathon của Moonshot. Ở DeepSWE, mỗi phòng lab chạy thiết lập riêng, nên chênh 3 điểm coi như hòa chứ không phải thắng. Nó tụt xa khi phải xây lại chương trình chỉ từ hành vi quan sát được, hoặc đi qua quy trình nghiên cứu khoa học.
So với tiền nhiệm, mức tăng rõ nhất là trên điểm chuẩn tầm dài nội bộ của Moonshot, nơi Kimi K3 đạt 55,95%.
Ở công việc tác nhân nặng công cụ, K3.1 Pro dẫn đầu hoặc nằm trong vài điểm so với Opus 5.5:
| Benchmark | Đo lường gì | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | 2.500 câu hỏi khó về kiến thức và suy luận, cho phép dùng công cụ | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | Tìm thông tin khó trên web | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | Phân tích số liệu trên các PDF tài chính thực | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | Quy trình đầu tư từ sàng lọc đến phân tích lợi nhuận | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | Vận hành máy tính để hoàn thành tác vụ | 79.6% | 81.8% | 75.8% | 69.3% |
Ngoại lệ rõ ràng trong bảng của Moonshot là dùng máy tính, nơi Opus 5.5 vẫn dẫn trước. Ở Frontier Finance, Claude Fable 5.1 (60,8) là dẫn đầu chung, vượt cả bốn mẫu hiển thị ở đây.
Khi không có công cụ, K3.1 Pro tụt rõ sau các mẫu đóng:
| Benchmark | Đo lường gì | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 câu hỏi khó về kiến thức và suy luận | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | Tập con 1.000 câu khó nhất của HLE | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | Câu hỏi khoa học trình độ sau đại học | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | Câu hỏi kết hợp hình ảnh và văn bản | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (nội bộ Moonshot, thấp hơn là tốt hơn) | Tỷ lệ phát biểu thực tế bị sai | 5.4% | 6.8% | 4.2% | 13.1% |
Khoảng cách rộng nhất ở HLE-Diamond, còn GPQA-Diamond gần như bão hòa nên chênh 2 điểm không nói lên nhiều. Nếu công việc của bạn là suy luận đóng sách khó, đây không phải mẫu để chuyển sang.
Moonshot làm điều khác thường với bản phát hành trọng số mở: công bố mức năng lực mà họ cố ý loại bỏ. Họ phát hiện nội dung liên quan an ninh mạng trong dữ liệu giữa kỳ và môi trường RL đang nâng dần kỹ năng nghiên cứu lỗ hổng, nên đã loại dữ liệu đó khỏi cả hai giai đoạn cho bản trọng số mở.
Trên xdev-bench-hard, điểm chuẩn phát triển khai thác nội bộ của Moonshot, một checkpoint không loại dữ liệu giải được 90,5% vấn đề (pass@3). Bản K3.1 Pro phát hành giải được 81,0%, vẫn cao hơn nhiều so với 33,3% của Kimi K3. Trên các điểm chuẩn an ninh công khai, nó thấp hơn mọi mẫu đóng mà Moonshot so sánh, đạt 74,7 trên ExploitBench so với 91,0 của Opus 5.5.
Nguyên tắc tuyên bố của Moonshot là tránh phát hành trọng số mở đẩy ranh giới tuyệt đối của năng lực tấn công mạng, trong khi nâng dần mặt bằng trọng số mở. Việc “cắt” 9,5 điểm có đủ hay không là vấn đề đánh giá, nhưng việc công bố con số đã hơn nhiều phòng lab khác.
K3.1 Pro chuẩn là mặc định đúng cho hầu hết mọi người. Biến thể Highspeed chỉ đáng giá cao hơn khi có người đang ngồi chờ kết quả.
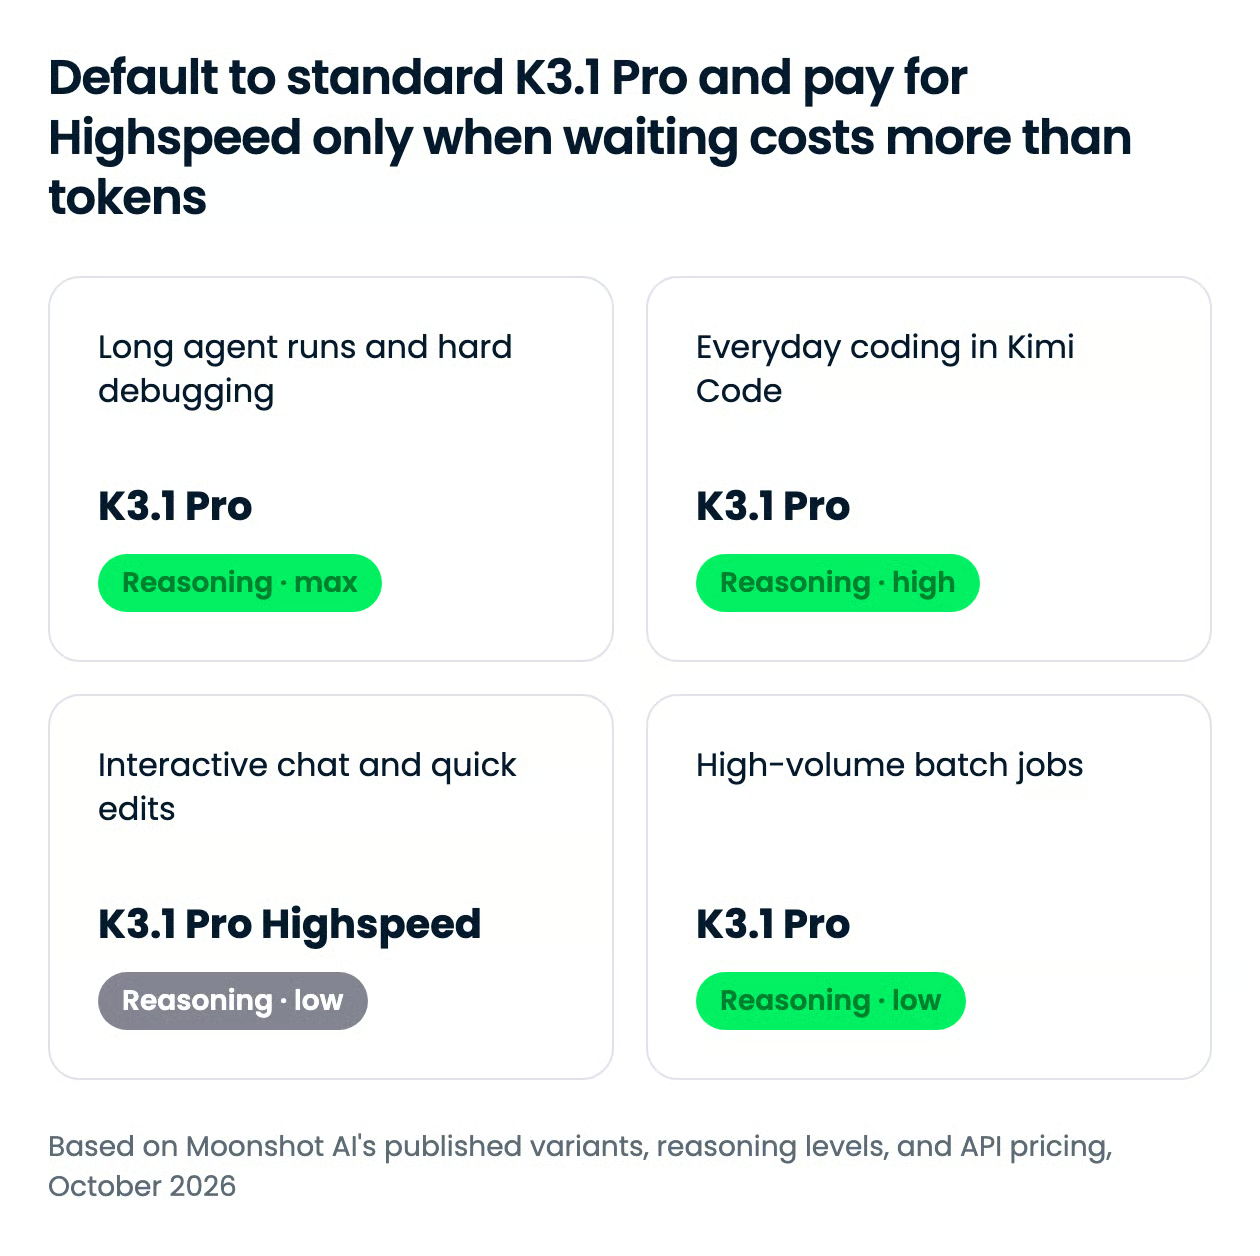
Moonshot bán Highspeed thuần về tốc độ: chạy nhanh hơn 2–3×, tốn gấp đôi mỗi token vào/ra, và không có điểm chuẩn riêng.
Cả hai biến thể luôn “nghĩ” trước khi trả lời, và bạn không tắt được. Bạn đặt mức “cố gắng” với ba cấp độ suy luận: max cho công việc tác nhân khó nhất, high là mức trung dung hợp lý, và low khi thời gian suy nghĩ mặc định nhiều hơn nhu cầu tác vụ. API mặc định ở max, mức đứng sau mọi điểm trong bảng điểm chuẩn của Moonshot, nên hạ xuống high hoặc low trừ khi tác vụ cần độ sâu tối đa.
| Trường hợp sử dụng | Biến thể | Mức suy luận | Lý do |
|---|---|---|---|
| Chạy agent dài, debug khó | K3.1 Pro | max |
Cài đặt đứng sau điểm mã hóa của Moonshot; tốc độ kém quan trọng trong nhiều giờ |
| Mã hóa hằng ngày trong Kimi Code | K3.1 Pro | high |
Phần lớn chất lượng với hóa đơn token thấp hơn |
| Chat tương tác và chỉnh nhanh | K3.1 Pro Highspeed | low |
Độ trễ là nút thắt, và prompt ngắn giữ chi phí 2× nhỏ |
| Job hàng loạt lưu lượng cao | K3.1 Pro | low |
Không ai chờ, nên trả mức thấp và giới hạn suy nghĩ |
Một lưu ý thực tiễn quan trọng từ tài liệu Kimi Code: đổi mức suy luận giữa phiên sẽ làm mất hiệu lực bộ nhớ đệm ngữ cảnh, nên hãy chọn một mức cho mỗi phiên thay vì chuyển qua lại.
Kimi K3.1 Pro có giá $2,00 mỗi triệu token đầu vào và $10,00 mỗi triệu token đầu ra trên Kimi API, rẻ hơn Kimi K3. Giá phẳng trên toàn bộ ngữ cảnh 1M token, không phụ phí ngữ cảnh dài.
| Model | Input | Output | Cached input | Ghi cache 5 phút | Ghi cache 1 giờ |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (thế hệ trước) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Giá tính trên mỗi triệu token và chưa gồm thuế. Bộ nhớ đệm là tự động với mặc định 5 phút, và bạn có thể yêu cầu mức 1 giờ theo từng lệnh gọi.
Một vài chi tiết truy cập đáng lưu ý trước khi bạn lên kế hoạch:
Nếu bạn vẫn dùng các mẫu dòng K2, tài liệu của Moonshot cho biết chúng sẽ không còn khả dụng với người dùng mới từ ngày 31/10/2026, và ngừng hoạt động vào cuối tháng 12/2026.
Bạn có thể dùng Kimi K3.1 Pro ngay hôm nay qua Kimi API, OpenRouter, và các ứng dụng của Kimi, nhưng chưa thể tải trọng số. Moonshot cho biết trọn bộ trọng số sẽ phát hành trước ngày 4/11/2026, và thông báo không đề cập điều khoản giấy phép, nên hãy kiểm tra thẻ mô hình khi trọng số được đăng.
kimi-k3.1-pro và kimi-k3.1-pro-highspeed, trên endpoint tương thích OpenAI.moonshotai/kimi-k3.1-pro./model. Tài liệu của Moonshot cũng hướng dẫn kết nối nó với Codex qua Kimi Responses API.Một lệnh gọi tối thiểu bằng client Python của OpenAI như sau:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Khi trọng số có mặt, hướng dẫn của chúng tôi về cách chạy LLM cục bộ sẽ bao quát các tùy chọn phục vụ, và bài giải thích về OpenCode cho thấy cách cắm một mô hình như thế này vào tác nhân mã nguồn mở.
Kimi K3.1 Pro là minh chứng mạnh mẽ nhất đến nay rằng các mô hình trọng số mở có thể sánh ngang tiền tuyến đóng ở mã hóa tác vụ tự động, với mức giá thấp hơn chính tiền nhiệm của nó. Nó không dẫn đầu về suy luận tổng quát, nhưng cho mã hóa dài và công việc tác nhân nặng công cụ, nó đứng ngay cạnh Claude Opus 5.5 và vượt GPT-6 Astra ở vài tác vụ.
Moonshot cũng đặt cược rằng việc công bố các đánh đổi về an ninh mạng sẽ giúp họ ghi điểm thiện chí cho các bản phát hành mở. Nếu bạn lập trình với tác nhân, tôi khuyên thử ngay qua API và xem xét tự triển khai lại khi trọng số và thẻ mô hình có mặt vào tháng 11.
Nếu bạn muốn làm việc với các mô hình mở như thế này, tôi khuyến nghị xem Hugging Face Fundamentals.
Học AI cùng DataCamp!
Khóa học
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
