Cours
Travailler avec Hugging Face
2 h
40K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleEn 2026, les laboratoires open weights ont comblé l'écart avec Anthropic et OpenAI sur le coding — et Moonshot AI vient de le réduire encore. Vendredi dernier, Moonshot a lancé Kimi K3.1 Pro, présenté comme son modèle open weight 3T le plus performant à ce jour, à un point de Claude Opus 5.5 sur le coding agentique.
K3.1 Pro est une version fortement post-entraînée de Kimi K3 avec une fenêtre de contexte d'un million de tokens. Il est accompagné d'une variante plus rapide, K3.1 Pro Highspeed, et est disponible dès aujourd'hui dans les applications Kimi, Kimi Code et l'API Kimi. Les poids complets suivront d'ici au 4 novembre 2026.
Dans cet article, je passe en revue tout ce qui change avec Kimi K3.1 Pro : nouvelles fonctionnalités, benchmarks, et comparaison tarifaire avec Kimi K3. Pour rattraper le contexte, consultez nos guides sur Kimi K3 et notre tutoriel pratique Kimi K3.
Kimi K3.1 Pro est le LLM phare de Moonshot AI et le premier modèle de sa nouvelle série K3.1. Il conserve la base de Kimi K3, un modèle de 2,8 T paramètres avec une fenêtre de contexte d'1 million de tokens, et ajoute beaucoup plus de calcul post-entraînement.
Le changement tient à l'entraînement, pas à l'architecture : Moonshot a exécuté un apprentissage par renforcement (RL) conjoint sur ce qu'il appelle « des centaines de domaines aval », et a reconçu son cadre RL, son infrastructure de bac à sable et sa planification des rollouts pour que le surplus de calcul produise des gains réguliers. Résultat : des progrès dans tous les domaines mesurés, avec une mention spéciale pour le code, la création 3D et la recherche financière.
La promesse phare est la parité en coding agentique avec les meilleurs modèles propriétaires. Le tableau de Moonshot place K3.1 Pro à un point de Claude Opus 5.5 sur des tâches de codage en terminal, pour une fraction du prix d'Anthropic. Le modèle est open weight, mais les poids ne sont pas encore publics.
K3.1 Pro est une mise à niveau générale, pas un seul tour de passe-passe. Voici quatre capacités qui valent un vrai changement de flux de travail.
K3.1 Pro peut rester focalisé sur une tâche de code longue et multi-étapes, en diagnostiquant ses propres échecs plutôt que de simplement retenter. La démo de Moonshot est un simulateur de marche humaine construit sur le modèle anatomique open source human-atlas, avec 296 composants squelettiques et 402 muscles.
Sur 167 missions et 420 revues indépendantes, le modèle a fait passer l'humain simulé d'un effondrement en quelques secondes à une marche à foulées alternées pendant 11,2 secondes. Le point intéressant est venu quand l'ajustement des récompenses n'a plus aidé le mouvement des bras : K3.1 Pro a lancé des sondes en boucle ouverte du simulateur, trouvé 36 erreurs dans les calculs de bras de levier des muscles de l'épaule, les a corrigées et a réentraiîné.
Ce n'est qu'une démo interne : à prendre comme illustration de l'usage visé plutôt que comme preuve. Elle montre toutefois l'objectif de Moonshot : des agents qui enquêtent et itèrent.
Moonshot affirme que K3.1 Pro produit des pages front-end, des scènes Three.js et des assets 3D avec « une meilleure composition, typographie, animation et finition ». Il fonctionne avec Unity, Unreal Engine et Godot, et peut les combiner avec la recherche web et la génération 3D pour assembler un projet complet.
Côté modélisation, K3.1 Pro écrit et exécute directement des scripts pour Blender et des logiciels de CAO, sans connecteurs MCP, afin de construire des modèles paramétriques : pièces mécaniques, maquettes architecturales, mobilier configurable. Moonshot a également lancé 3D Make sur kimi.ai et l'app Kimi, où vous pouvez prévisualiser, éditer et télécharger des modèles prêts pour l'impression 3D.
La promesse qualitative visuelle est aussi la plus difficile à recouper avec un benchmark : considérez les démos de Moonshot comme leurs meilleurs cas, pas comme la moyenne.
K3.1 Pro peut mener un flux financier du screening jusqu'à un classeur finalisé, et Moonshot a apporté des correctifs ciblés sur la justesse factuelle pour ce type de travaux. Sur ses benchmarks internes finance, K3.1 Pro gagne 7,2 points sur Financial Modeling et 11,6 points sur Financial Research par rapport à Kimi K3, et atteint environ 4,2× le score de K3 sur Business Operation, une tâche d'entreprise simulée à long horizon.
Ce travail sur la précision se voit dans le stress test d'hallucinations de Moonshot. Sur Kimi Hallu Bench Hard, le taux d'hallucinations au niveau des énoncés est passé de 23,4 % pour K3 à 8,3 % pour K3.1 Pro. Moonshot précise que le test est conçu pour provoquer des erreurs : ces taux ne reflètent pas le quotidien.
Kimi K3.1 Pro est compétitif avec Claude Opus 5.5 et GPT-6 Astra sur le coding agentique et les travaux très outillés, mais nettement derrière sur le raisonnement pur. Toutes les valeurs ci-dessous proviennent de l'annonce de Moonshot, avec K3.1 Pro en mode max.
C'est là que K3.1 Pro paraît le plus solide. Sur Terminal-Bench 4.0, qui évalue des agents de code sur des tâches réalistes et contraintes en ressources en terminal, K3.1 Pro obtient 65,7 %. C'est à peine derrière Claude Opus 5.5 à 66,4 % et bien devant GPT-6 Astra à 58,2 %.
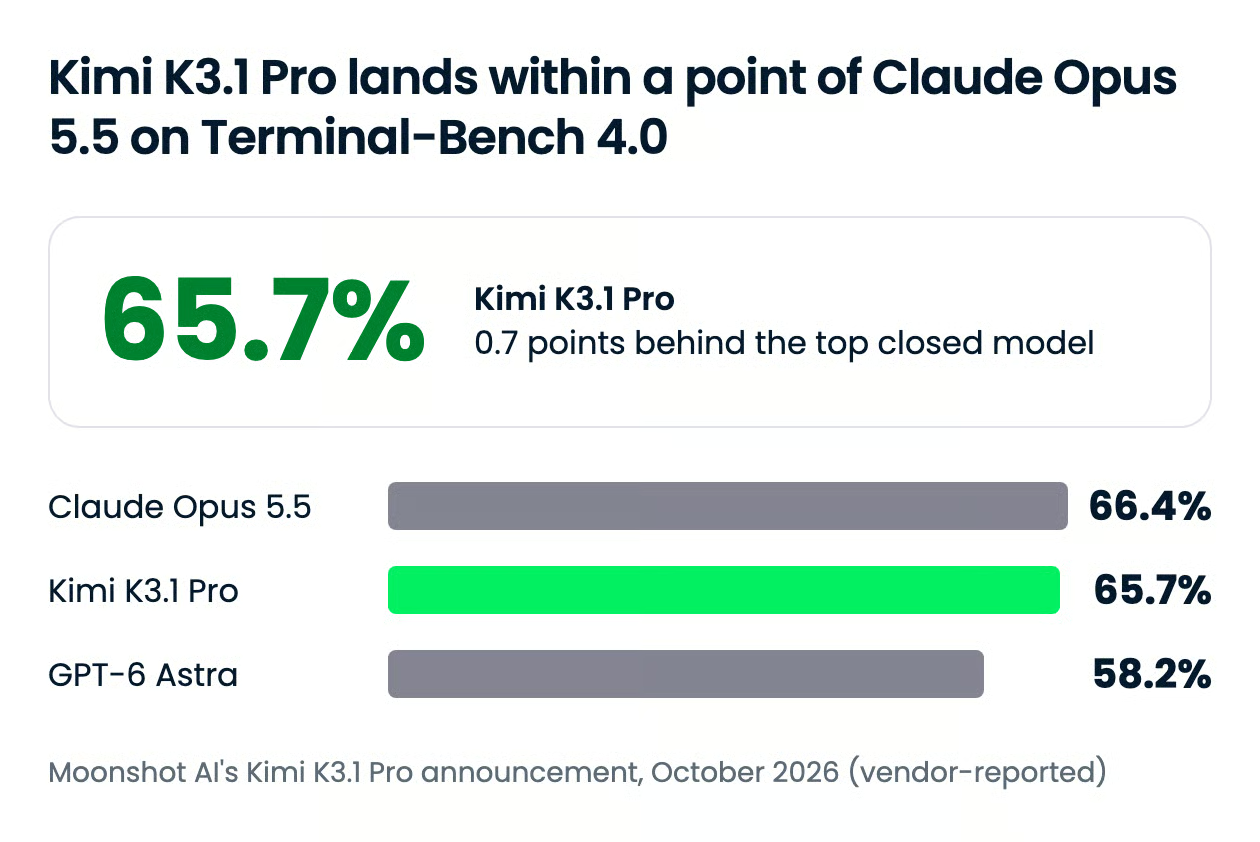
Le reste des résultats en code est plus contrasté que ce titre ne le laisse entendre. Tous les scores sont déclarés par les éditeurs, avec le meilleur de chaque ligne en gras :
| Benchmark | Ce qui est mesuré | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agents de code sur des tâches réalistes en terminal | 65,7 % | 66,4 % | 58,2 % | 42,3 % |
| SWE-Marathon v1.1 | 20 tâches d'ingénierie de plusieurs heures, sans Internet | 51,7 % | 46,3 % | 42,5 % | 40,0 % |
| DeepSWE v1.1 | 113 tâches à long horizon, notées sur le comportement | 75,5 % | 74,2 % | 74,1 % | 77,0 % |
| Kimi Code Bench 3.0 Long-horizon (interne Moonshot) | Exécution multi-étapes et usage d'outils | 61,2 % | 58,5 % | 66,5 % | 51,5 % |
| ProgramBench | Reconstruire un programme à partir de son binaire et de son spéc (tâches réussissant ≥ 95 % des tests) | 31,5 % | 65,0 % | 50,0 % | 29,1 % |
| Terminal-Bench Science 0.1 | Agents sur des workflows de recherche scientifique | 38,1 % | 63,3 % | 68,1 % | 15,7 % |
K3.1 Pro est au niveau des meilleurs modèles fermés sur les longues tâches d'ingénierie et mène la comparaison SWE-Marathon de Moonshot. Sur DeepSWE, chaque labo a exécuté sa propre configuration : un écart de 3 points s'apparente à une égalité. Il chute nettement lorsqu'il doit reconstruire un programme à partir de son seul comportement observé, ou suivre un workflow de recherche scientifique.
Face à son prédécesseur, le gain le plus clair est sur le benchmark interne long-horizon de Moonshot, où Kimi K3 obtenait 55,95 %.
Sur les travaux d'agents très outillés, K3.1 Pro mène ou se situe à quelques points d'Opus 5.5 :
| Benchmark | Ce qui est mesuré | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full avec outils | 2 500 questions ardues de connaissances et de raisonnement, outils autorisés | 70,0 % | 67,7 % | 57,2 % | 58,8 % |
| BrowseComp | Recherche d'informations difficiles à trouver sur le web | 92,1 % | 90,8 % | 91,5 % | n/a |
| OfficeQA Pro v2 | Analyse numérique à partir de vrais PDF financiers | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Workflows d'investissement du screening à l'analyse de rentabilité | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Utiliser un ordinateur de bureau pour finir des tâches | 79,6 % | 81,8 % | 75,8 % | 69,3 % |
La seule exception nette du tableau de Moonshot est l'usage de l'ordinateur, où Opus 5.5 garde l'avantage. Sur Frontier Finance, Claude Fable 5.1 (60,8) mène devant les quatre modèles listés ici.
Sans outils, K3.1 Pro accuse clairement le coup face aux modèles fermés :
| Benchmark | Ce qui est mesuré | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2 500 questions ardues de connaissances et de raisonnement | 51,1 % | 59,8 % | 53,6 % | 42,6 % |
| HLE-Diamond | Sous-ensemble de 1 000 questions, le plus difficile d'HLE | 39,4 % | 60,9 % | 65,8 % | 21,6 % |
| GPQA-Diamond | Questions de sciences niveau master | 94,2 % | 93,9 % | 96,1 % | 92,2 % |
| MMMU-Pro | Questions combinant images et texte | 84,1 % | 87,7 % | 86,9 % | 80,6 % |
| Kimi Hallu Bench (interne Moonshot, plus bas est mieux) | Part des assertions factuelles erronées | 5,4 % | 6,8 % | 4,2 % | 13,1 % |
L'écart est maximal sur HLE-Diamond, tandis que GPQA-Diamond est presque saturé, donc 2 points y disent peu. Si votre travail repose sur du raisonnement difficile à livre fermé, ce n'est pas le modèle à adopter.
Moonshot a fait quelque chose d'inhabituel pour une publication open weight : indiquer combien de capacité il a délibérément retirée. Il a constaté que le contenu lié au cyber dans ses données de mi-parcours et ses environnements de RL faisait progresser régulièrement l'expertise en recherche de vulnérabilités, et a donc retiré ces données aux deux étapes pour la release open weight.
Sur xdev-bench-hard, le benchmark interne de développement d'exploits de Moonshot, un checkpoint sans retrait de données résolvait 90,5 % des problèmes (pass@3). La version livrée de K3.1 Pro en résout 81,0 %, ce qui reste bien au-dessus des 33,3 % de Kimi K3. Sur les benchmarks publics cyber, il est en dessous de tous les modèles fermés comparés, avec 74,7 sur ExploitBench contre 91,0 pour Opus 5.5.
Le principe affiché de Moonshot est d'éviter de publier des poids ouverts qui poussent la frontière absolue en capacité offensive, tout en relevant progressivement la barre open weight. Savoir si une coupe de 9,5 points suffit relève du jugement, mais publier le chiffre va déjà plus loin que beaucoup d'autres labos.
K3.1 Pro standard est le bon choix par défaut pour presque tout le monde. La variante Highspeed ne justifie son tarif supérieur que lorsqu'une personne attend la réponse devant l'écran.
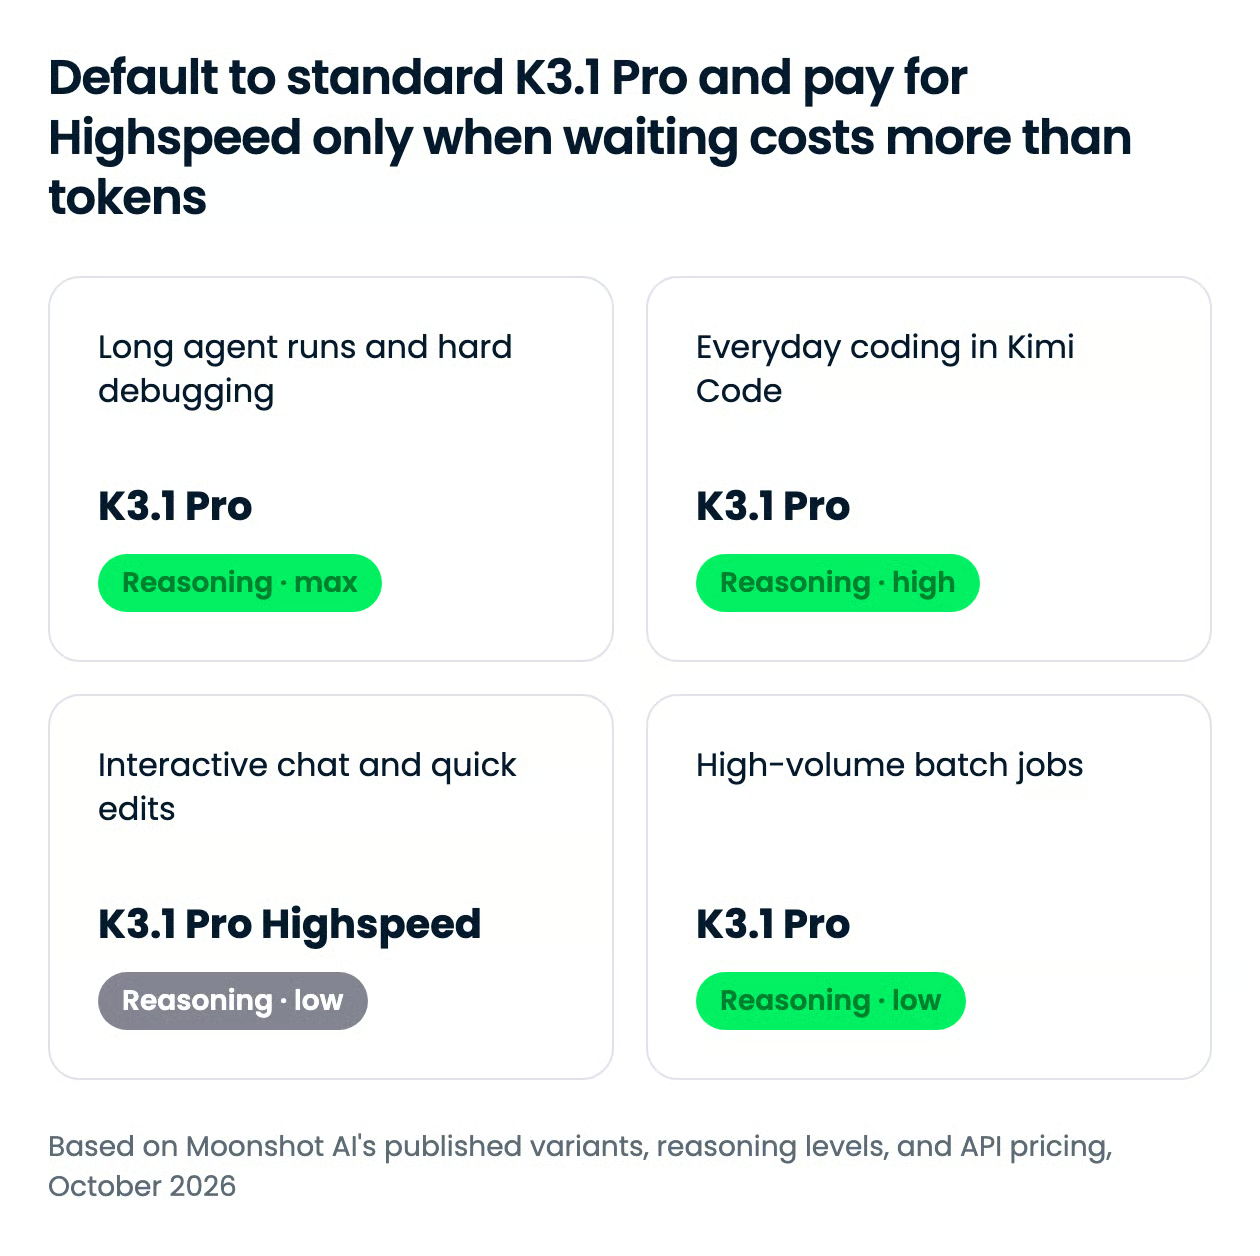
Moonshot vend Highspeed uniquement sur la vitesse : 2–3× plus rapide, deux fois plus cher par token en entrée et en sortie, sans résultats de benchmark séparés.
Les deux variantes réfléchissent toujours avant de répondre, et vous ne pouvez pas le désactiver. Vous réglez l'intensité avec trois niveaux de raisonnement : max pour les travaux d'agents les plus durs, high comme bon compromis, et low quand le temps de réflexion par défaut dépasse le besoin. L'API est par défaut en max, le réglage derrière chaque score du tableau de Moonshot : baissez-le en high ou low sauf si la tâche exige une profondeur totale.
| Cas d'usage | Variante | Niveau de raisonnement | Pourquoi |
|---|---|---|---|
| Longs runs d'agents, débogage difficile | K3.1 Pro | max |
Le réglage derrière les scores de code de Moonshot ; la vitesse compte moins sur des heures |
| Code au quotidien dans Kimi Code | K3.1 Pro | high |
La majeure partie de la qualité pour une facture token plus basse |
| Chat interactif et éditions rapides | K3.1 Pro Highspeed | low |
La latence est le goulot d'étranglement, et des prompts courts limitent le surcoût 2× |
| Jobs batch à fort volume | K3.1 Pro | low |
Personne n'attend : payez moins et plafonnez la réflexion |
Point pratique important depuis la documentation Kimi Code : changer de niveau de raisonnement en cours de session invalide le cache de contexte ; choisissez un niveau par session plutôt que d'alterner.
Kimi K3.1 Pro coûte 2,00 $ par million de tokens en entrée et 10,00 $ par million en sortie via l'API Kimi, moins cher que Kimi K3. La tarification est plate sur tout le contexte 1M, sans surtaxe long contexte.
| Modèle | Entrée | Sortie | Entrée en cache | Écriture cache 5 min | Écriture cache 1 h |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 2,00 $ | 10,00 $ | 0,20 $ | 2,00 $ | 4,00 $ |
| Kimi K3.1 Pro Highspeed | 4,00 $ | 20,00 $ | 0,20 $ | 4,00 $ | 8,00 $ |
| Kimi K3 (génération précédente) | 3,00 $ | 15,00 $ | 0,30 $ | 3,00 $ | 6,00 $ |
Les prix sont par million de tokens, hors taxes. Le caching est automatique avec 5 minutes par défaut, et vous pouvez demander le palier 1 heure par appel.
Quelques détails d'accès à connaître avant de planifier :
Si vous utilisez encore les modèles série K2, la documentation de Moonshot indique qu'ils ne seront plus accessibles aux nouveaux utilisateurs à partir du 31 octobre 2026 et retirés d'ici fin décembre 2026.
Vous pouvez utiliser Kimi K3.1 Pro aujourd'hui via l'API Kimi, OpenRouter et les applications Kimi, mais pas encore sous forme de poids téléchargeables. Moonshot indique que les poids complets seront publiés d'ici au 4 novembre 2026 et son annonce ne précise pas les conditions de licence : vérifiez la model card quand les poids arriveront.
kimi-k3.1-pro et kimi-k3.1-pro-highspeed, sur un endpoint compatible OpenAI.moonshotai/kimi-k3.1-pro./model. La documentation de Moonshot couvre aussi la connexion à Codex via l'API Kimi Responses.Un appel minimal avec le client Python OpenAI ressemble à ceci :
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Une fois les poids publiés, notre guide pour exécuter des LLMs en local couvre les options de serving, et notre explication sur OpenCode montre comment brancher un modèle comme celui-ci à un agent de codage open source.
Kimi K3.1 Pro est la meilleure démonstration à ce jour que des modèles open weights peuvent rivaliser avec la frontière fermée en coding agentique, à un prix inférieur à son propre prédécesseur. Ce n'est pas un champion du raisonnement général, mais pour le code long et les travaux d'agents très outillés, il se place juste à côté de Claude Opus 5.5 et devant GPT-6 Astra sur plusieurs tâches.
Moonshot parie aussi que publier ses arbitrages cyber lui vaudra du crédit pour ses releases ouvertes. Si vous codez avec des agents, testez-le dès maintenant via l'API et reconsidérez l'auto-hébergement une fois les poids et la model card publiés en novembre.
Si vous souhaitez travailler avec des modèles ouverts comme celui-ci, je vous recommande notre parcours de compétences Hugging Face Fundamentals.
Apprenez l'IA avec DataCamp !
Cours
Cursus
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
blog
Kurtis Pykes
15 min
Tutoriel
Dr Ana Rojo-Echeburúa
12 min
Tutoriel