Kurs
Arbeta med Hugging Face
2 tim
40K
Öva och håll koll på dina framsteg.
Fortsätt Med GoogleLaboratorier med öppna vikter har ägnat 2026 åt att minska gapet till Anthropic och OpenAI inom kodning, och Moonshot AI har just krympt det igen. I fredags släppte Moonshot Kimi K3.1 Pro, som de kallar sin mest kapabla öppen-vikt-modell i 3T-klassen hittills, och placerar den inom en poäng från Claude Opus 5.5 på agentisk kodning.
K3.1 Pro är en kraftigt eftertränad version av Kimi K3 med ett kontextfönster på 1 miljon token. Den lanseras tillsammans med en snabbare variant, K3.1 Pro Highspeed, och är tillgänglig i Kimi-apparna, Kimi Code och Kimi API redan idag. Fullständiga vikter följer senast den 4 november 2026.
I den här artikeln går jag igenom allt som är nytt i Kimi K3.1 Pro: nya funktioner, benchmarkresultat och hur prissättningen står sig mot Kimi K3. För bakgrunden till modellen den bygger på, läs våra guider till Kimi K3 och vår praktiska guide till Kimi K3.
Kimi K3.1 Pro är Moonshot AIs flaggskepps-LLM och den första modellen i deras nya K3.1-serie. Den behåller grunden från Kimi K3, en modell med 2,8T parametrar och 1M-token-kontextfönster, och lägger på betydligt mer efterträningsberäkning ovanpå.
Förändringen ligger i träningen snarare än i arkitekturen: Moonshot körde gemensam reinforcement learning (RL) över vad de kallar "hundratals nedströmsdomäner" och byggde om sitt RL-ramverk, sandbox-infrastruktur och rollout-planering så att extra beräkning gav jämna förbättringar. Resultatet, enligt Moonshot, är förbättring i alla mätta domäner, med kodning, 3D-skapande och finansiell forskning utpekade.
Huvudpåståendet är agentisk kodningsparitet med de bästa proprietära modellerna. Moonshots egen tabell placerar K3.1 Pro inom en poäng från Claude Opus 5.5 på terminalbaserade kodningsuppgifter, till en bråkdel av Anthropics pris. Modellen har öppna vikter, men vikterna är inte offentliga ännu.
K3.1 Pro är en bred uppgradering snarare än ett enskilt nytt trick. Följande fyra förmågor är de jag faktiskt skulle ändra arbetsflöde för.
K3.1 Pro kan hålla i en lång, flerstegs kodningsuppgift och diagnostisera sina egna fel istället för att bara försöka igen. Moonshots demo är en mänsklig gångsimulator byggd på den öppna human-atlas anatomiska modellen, med 296 skelett- och 402 muskelkomponenter.
Över 167 uppdrag och 420 oberoende granskningar tog modellen den simulerade människan från att kollapsa inom några sekunder till att gå med växelvisa steg i 11,2 sekunder. Det intressanta kom när rewards shaping slutade hjälpa armrörelsen: K3.1 Pro körde öppna sonder av simulatorn, hittade 36 fel i beräkningarna av momentarmar för axelns muskler, åtgärdade dem och tränade om.
Det är en intern demo, så se det som en illustration av avsett användningsfall snarare än bevis. Men det visar vad Moonshot optimerar för: agenter som undersöker och itererar.
Moonshot säger att K3.1 Pro producerar frontendsidor, Three.js-scener och 3D-tillgångar med "starkare komposition, typografi, animation och finish." Den fungerar med Unity, Unreal Engine och Godot, och kan kombinera dem med webbsökning och 3D-generering för att sätta ihop ett komplett projekt.
På modelleringssidan skriver och kör K3.1 Pro skript för Blender och CAD-program direkt, utan MCP-kopplingar, för att bygga parametriska modeller som maskindelar, arkitekturmodeller och konfigurerbara möbler. Moonshot lanserade också 3D Make på kimi.ai och i Kimi-appen, där du kan förhandsgranska, redigera och ladda ned modeller redo för 3D-utskrift.
Påståendet om visuell kvalitet är också svårast att kontrollera mot en benchmarktabell, så se Moonshots demos som leverantörens bästa exempel snarare än typiskt utfall.
K3.1 Pro kan bära ett finansiellt arbetsflöde från screening till en färdig arbetsbok, och Moonshot har gjort riktade förbättringar av faktakorrekthet för den här typen av arbete. På sina interna finansbenchmarks förbättrar K3.1 Pro Kimi K3 med 7,2 poäng på Financial Modeling och 11,6 poäng på Financial Research, och når cirka 4,2× K3:s poäng på Business Operation, en långhorisontell simulerad affärsuppgift.
Arbetet med noggrannhet syns i Moonshots hallucinationstresstest. På Kimi Hallu Bench Hard sjönk andelen hallucinationer på påståendenivå från 23,4% för K3 till 8,3% för K3.1 Pro. Moonshot är noga med att säga att testet är byggt för att framkalla fel, så de nivåerna är inte vardagliga felfrekvenser.
Kimi K3.1 Pro är konkurrenskraftig med Claude Opus 5.5 och GPT-6 Astra på agentisk kodning och verktygstungt arbete, men tydligt bakom dem på rent resonemang. Alla siffror nedan kommer från Moonshots annonsering, med K3.1 Pro på max ansträngning.
Agentisk kodning är där K3.1 Pro ser starkast ut. På Terminal-Bench 4.0, som betygsätter kodningsagenter på realistiska, resursbegränsade terminaluppgifter, får K3.1 Pro 65,7%. Det är bara mycket knappt bakom Claude Opus 5.5 på 66,4% och klart före GPT-6 Astra på 58,2%.
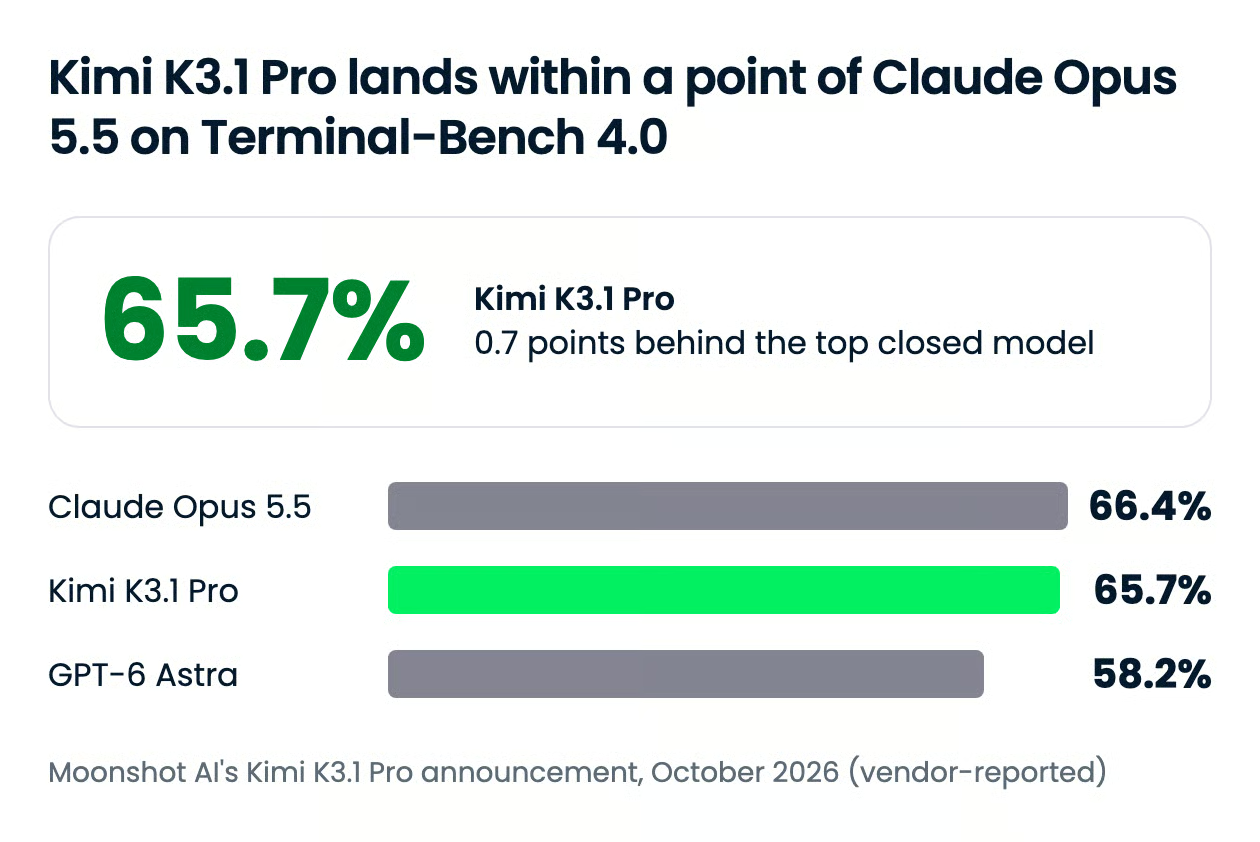
Resten av kodningsresultaten är mer blandade än rubriken antyder. Alla poäng är leverantörrapporterade, med bästa poäng i varje rad i fetstil:
| Benchmark | Vad den mäter | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Kodningsagenter på realistiska terminaluppgifter | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 flertimmars ingenjörsuppgifter, ingen internetåtkomst | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 långhorisontella uppgifter, betygsatta på beteende | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (Moonshot internt) | Flerstegs exekvering och verktygsanvändning | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Återskapa ett program från dess binär och spec (uppgifter som klarar minst 95% av testen) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agenter på vetenskapliga forskningsarbetsflöden | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro ligger i nivå med de bästa slutna modellerna på långa ingenjörsuppgifter och leder Moonshots jämförelse på SWE-Marathon. På DeepSWE körde varje labb sin egen uppsättning, så en spridning på 3 poäng är oavgjort snarare än seger. Den halkar långt efter när den måste återskapa ett program enbart från observerat beteende, eller ta sig igenom ett vetenskapligt arbetsflöde.
Jämfört med föregångaren är den tydligaste vinsten på Moonshots eget långhorisontella benchmark, där Kimi K3 fick 55,95%.
På verktygstungt agentarbete leder K3.1 Pro eller ligger inom ett par poäng från Opus 5.5:
| Benchmark | Vad den mäter | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full med verktyg | 2 500 svåra kunskaps- och resonemangsfrågor, verktyg tillåtna | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Hitta svåråtkomlig information på webben | 92,1% | 90,8% | 91,5% | n/a |
| OfficeQA Pro v2 | Numerisk analys över riktiga finansiella PDF:er | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Investeringsarbetsflöden från screening till lönsamhetsanalys | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Använda en stationär dator för att slutföra uppgifter | 79,6% | 81,8% | 75,8% | 69,3% |
Det tydliga undantaget i Moonshots tabell är datoranvändning, där Opus 5.5 ligger före. På Frontier Finance är Claude Fable 5.1 (60,8) totalledare, före alla fyra modellerna här.
Utan verktyg faller K3.1 Pro tydligt efter de slutna modellerna:
| Benchmark | Vad den mäter | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2 500 svåra kunskaps- och resonemangsfrågor | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | 1 000 frågor, den svåraste delmängden av HLE | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Frågor på forskarnivå inom naturvetenskap | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Frågor som kombinerar bilder och text | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (Moonshot internt, lägre är bättre) | Andel faktapåståenden som är fel | 5,4% | 6,8% | 4,2% | 13,1% |
Gapet är som störst på HLE-Diamond, medan GPQA-Diamond nästan är mättad, så en spridning på 2 poäng säger lite. Om ditt arbete kräver hårt closed-book-resonemang är det här inte modellen att byta till.
Moonshot gjorde något ovanligt för en öppenviktslansering: de publicerade hur mycket kapacitet de medvetet tog bort. De fann att cyberrelaterat innehåll i data för mittträning och RL-miljöer stadigt höjde sårbarhetsforskningsförmågan, så de tog bort dessa data från båda stegen för öppenviktsutgåvan.
På xdev-bench-hard, Moonshots interna benchmark för exploit-utveckling, löste en checkpoint utan databorttagningen 90,5% av problemen (pass@3). Den levererade K3.1 Pro löser 81,0%, vilket fortfarande är långt över Kimi K3:s 33,3%. På publika cyberbenchmarks ligger den under alla slutna modeller Moonshot jämförde med, och får 74,7 på ExploitBench mot Opus 5.5:s 91,0.
Moonshots uttalade princip är att undvika att släppa öppna vikter som flyttar den absoluta frontlinjen för offensiv cyberförmåga, samtidigt som de gradvis höjer ribban för öppna vikter. Om en nedskärning på 9,5 poäng är tillräcklig är en bedömningsfråga, men att publicera siffran är mer än vad många andra labb gör.
Standard K3.1 Pro är rätt utgångsläge för nästan alla. Highspeed-varianten förtjänar bara sitt högre pris när en person sitter och väntar på utdata.
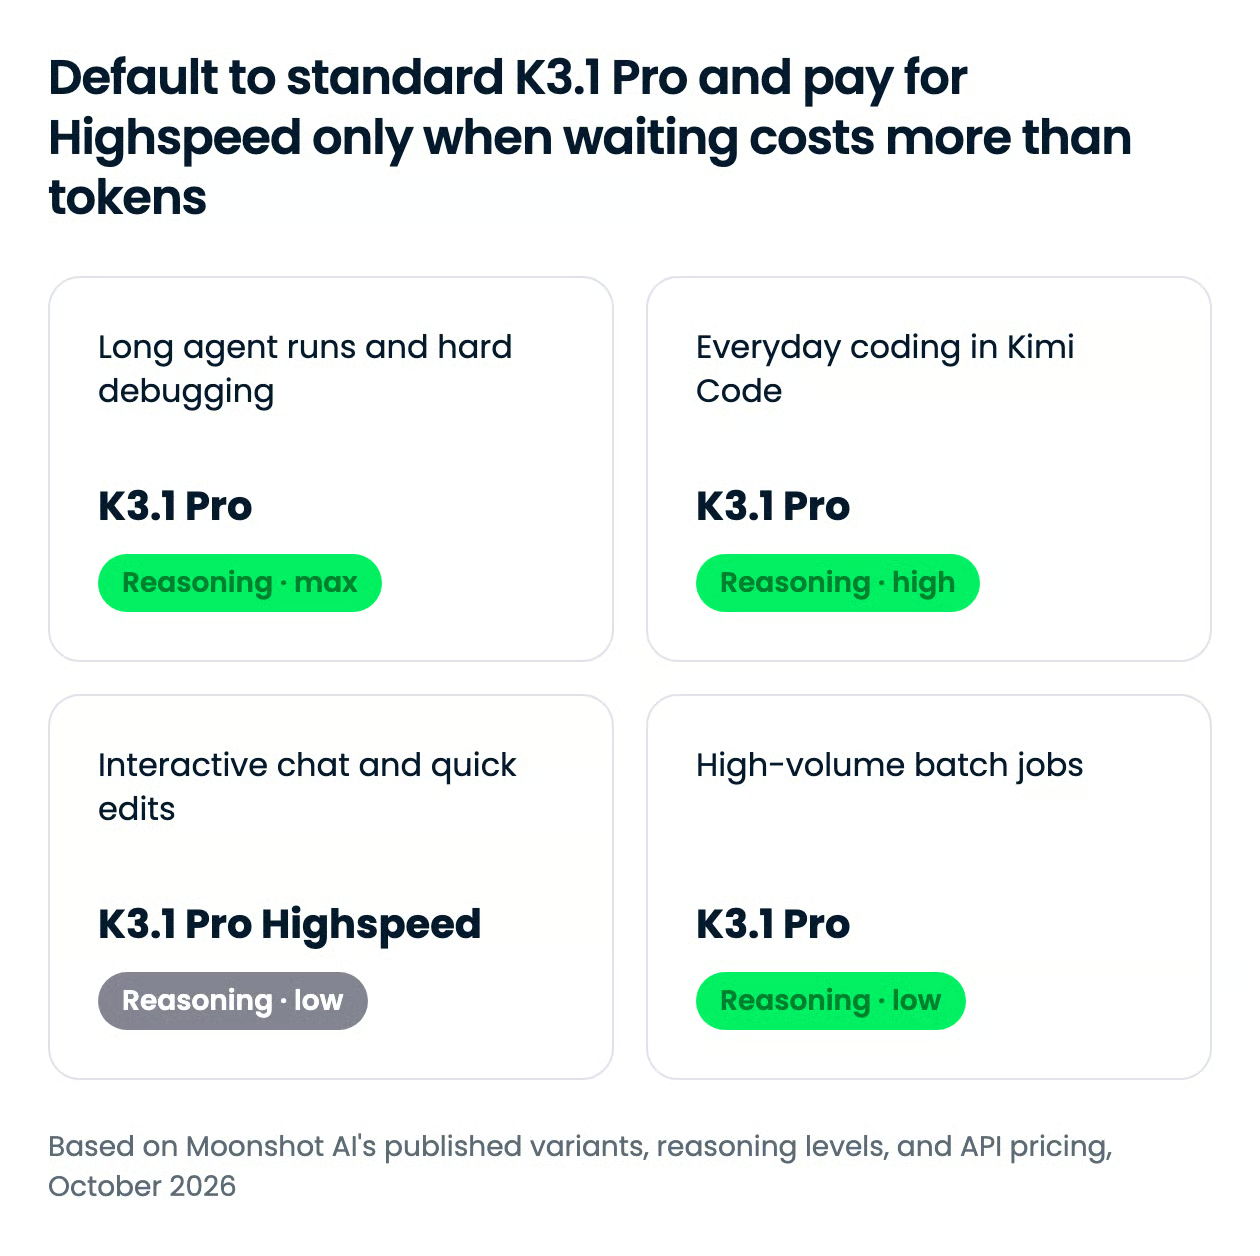
Moonshot säljer Highspeed enbart på hastighet: den kör 2–3× snabbare, kostar dubbelt så mycket per in- och utgående token och har inga separata benchmarkresultat.
Båda varianterna tänker alltid innan de svarar, och du kan inte stänga av det. Du ställer in nivån med tre resonemangslägen: max för det tuffaste agentarbetet, high som en rimlig mitt, och low när standardtiden för tänkande är mer än uppgiften kräver. API:t är som standard inställt på max, inställningen bakom varje poäng i Moonshots benchmarktabell, så sänk till high eller low om inte uppgiften kräver full djupdykning.
| Användningsfall | Variant | Resonemangsnivå | Varför |
|---|---|---|---|
| Långa agentkörningar, svår felsökning | K3.1 Pro | max |
Inställningen bakom Moonshots kodningspoäng; hastighet spelar mindre roll över timmar |
| Vardaglig kodning i Kimi Code | K3.1 Pro | high |
Det mesta av kvaliteten till en lägre tokennota |
| Interaktiv chat och snabba ändringar | K3.1 Pro Highspeed | low |
Latens är flaskhalsen, och korta prompts gör att 2×-priset blir litet |
| Batchjobb i stor volym | K3.1 Pro | low |
Ingen väntar, så betala lägre taxa och begränsa tänkandet |
En viktig praktisk not från Kimi Code-dokumentationen: att byta resonemangsnivå mitt i en session ogiltigförklarar kontextcachen, så välj en nivå per session istället för att hoppa fram och tillbaka.
Kimi K3.1 Pro kostar 2,00 $ per miljon inkommande token och 10,00 $ per miljon utgående token via Kimi API, vilket är mindre än Kimi K3. Priset är platt över hela 1M-token-kontexten, utan tillägg för lång kontext.
| Modell | Inkommande | Utgående | Cachead inkommande | 5-minuters cache-skrivning | 1-timmes cache-skrivning |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (föregående generation) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Priserna är per miljon token och exklusive skatt. Cachelagring är automatisk med 5 minuters standard, och du kan begära 1-timmarsnivån per anrop.
Några åtkomstdetaljer är bra att känna till innan du planerar kring det:
Om du fortfarande använder K2-serien säger Moonshots dokumentation att de inte kommer att vara tillgängliga för nya användare från den 31 oktober 2026 och tas ur bruk i slutet av december 2026.
Du kan använda Kimi K3.1 Pro redan idag via Kimi API, OpenRouter och Kimi:s egna appar, men ännu inte som nedladdningsbara vikter. Moonshot säger att fullständiga vikter släpps senast den 4 november 2026, och deras annonsering nämner inte licensvillkor, så kolla modellkortet när vikterna publiceras.
kimi-k3.1-pro och kimi-k3.1-pro-highspeed, på en OpenAI-kompatibel endpoint.moonshotai/kimi-k3.1-pro./model. Moonshots dokumentation täcker också hur du ansluter den till Codex via Kimi Responses API.Ett minimalt anrop med OpenAIs Python-klient ser ut så här:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
När vikterna publiceras täcker vår guide om hur man kör LLM:er lokalt alternativen för servering, och vår förklaring av OpenCode visar hur du kopplar in en sådan här modell i en öppen källkods-kodningsagent.
Kimi K3.1 Pro är det starkaste argumentet hittills för att öppenviktsmodeller kan matcha den slutna frontlinjen på agentisk kodning, till ett pris under sin egen föregångare. Den leder inte inom allmänt resonemang, men för lång kodning och verktygstungt agentarbete sitter den precis bredvid Claude Opus 5.5 och före GPT-6 Astra på flera uppgifter.
Moonshot satsar också på att publicera sina cyberavvägningar för att vinna goodwill för sina öppna utgåvor. Om du kodar med agenter skulle jag prova den nu via API:t och återbesöka självvärd när vikterna och modellkortet landar i november.
Om du vill arbeta med öppna modeller som den här rekommenderar jag att du kollar in vår Hugging Face Fundamentals-kompetensväg.
Lär dig AI med DataCamp!
Kurs
Lärstig
Öva och håll koll på dina framsteg.
Fortsätt Med Google