

Kursus
Bekerja dengan Hugging Face
2 jam
40K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleLaboratorium open-weight menghabiskan 2026 untuk mengejar ketertinggalan dari Anthropic dan OpenAI dalam hal coding, dan Moonshot AI baru saja memperkecil jarak itu lagi. Jumat lalu, Moonshot merilis Kimi K3.1 Pro, yang mereka sebut sebagai model open-weight kelas 3T paling andal hingga saat ini, dan menempatkannya hanya terpaut satu poin dari Claude Opus 5.5 pada agentic coding.
K3.1 Pro adalah versi Kimi K3 yang sangat dipost-train dengan jendela konteks 1 juta token. Model ini hadir bersamaan dengan varian yang lebih cepat, K3.1 Pro Highspeed, dan sudah tersedia hari ini di aplikasi Kimi, Kimi Code, dan Kimi API. Bobot penuh akan menyusul sebelum 4 November 2026.
Di artikel ini, saya membahas semua hal baru di Kimi K3.1 Pro: fitur, benchmark, dan perbandingan harga dengan Kimi K3. Untuk memahami model yang menjadi dasarnya, lihat panduan kami tentang Kimi K3 dan tutorial praktis Kimi K3.
Kimi K3.1 Pro adalah model bahasa besar (LLM) flagship Moonshot AI dan model pertama di seri K3.1. Ia mempertahankan basis Kimi K3, model 2,8T parameter dengan jendela konteks 1M token, dan menambahkan komputasi post-training yang jauh lebih besar di atasnya.
Perubahannya ada pada pelatihan, bukan arsitektur: Moonshot menjalankan reinforcement learning (RL) bersama di apa yang mereka sebut "ratusan domain hilir", serta membangun ulang kerangka RL, infrastruktur sandbox, dan penjadwalan rollout agar komputasi ekstra menghasilkan peningkatan stabil. Hasilnya, menurut Moonshot, adalah peningkatan di setiap domain yang diukur, dengan coding, pembuatan 3D, dan riset keuangan disorot.
Klaim utama adalah paritas agentic coding dengan model proprietari terbaik. Tabel Moonshot sendiri menempatkan K3.1 Pro hanya terpaut satu poin dari Claude Opus 5.5 pada tugas coding berbasis terminal, dengan biaya sebagian kecil dari harga Anthropic. Model ini open-weight, tetapi bobotnya belum dipublikasikan.
K3.1 Pro adalah peningkatan luas, bukan satu trik baru. Empat kemampuan berikut adalah yang benar-benar akan mengubah alur kerja.
K3.1 Pro dapat bertahan pada tugas coding panjang dan multi-langkah, mendiagnosis kegagalannya sendiri alih-alih sekadar mencoba ulang. Demo Moonshot adalah simulator manusia berjalan yang dibangun di atas model anatomi open-source human-atlas, dengan 296 komponen rangka dan 402 komponen otot.
Melintasi 167 misi dan 420 peninjauan independen, model membawa manusia simulasi dari roboh dalam hitungan detik menjadi berjalan dengan langkah bergantian selama 11,2 detik. Bagian menarik terjadi ketika pembentukan reward tidak lagi membantu gerak lengan: K3.1 Pro menjalankan probe open-loop pada simulator, menemukan 36 kesalahan dalam perhitungan momen lengan-otot bahu, memperbaikinya, dan melatih ulang.
Itu adalah satu demo internal, jadi anggaplah sebagai ilustrasi kasus penggunaan yang dimaksudkan, bukan bukti. Namun, ini menunjukkan fokus optimasi Moonshot: agen yang menyelidiki dan mengiterasi.
Moonshot mengatakan K3.1 Pro menghasilkan halaman front-end, scene Three.js, dan aset 3D dengan "komposisi, tipografi, animasi, dan kerapian" yang lebih kuat. Ia bekerja dengan Unity, Unreal Engine, dan Godot, serta dapat menggabungkannya dengan penelusuran web dan generasi 3D untuk merangkai proyek lengkap.
Di sisi pemodelan, K3.1 Pro menulis dan menjalankan skrip untuk Blender dan perangkat lunak CAD secara langsung, tanpa konektor MCP, untuk membangun model parametrik seperti komponen mekanik, model arsitektur, dan furnitur yang dapat dikonfigurasi. Moonshot juga meluncurkan 3D Make di kimi.ai dan aplikasi Kimi, tempat Anda dapat mempratinjau, mengedit, dan mengunduh model siap cetak 3D.
Klaim kualitas visual juga yang paling sulit diverifikasi terhadap tabel benchmark, jadi anggap demo Moonshot sebagai contoh terbaik vendor, bukan output tipikal.
K3.1 Pro dapat menjalankan alur kerja keuangan dari penyaringan hingga buku kerja final, dan Moonshot melakukan perbaikan terarah pada ketepatan fakta untuk jenis pekerjaan ini. Pada benchmark keuangan internalnya, K3.1 Pro meningkat 7,2 poin pada Financial Modeling dan 11,6 poin pada Financial Research dibanding Kimi K3, serta mencapai sekitar 4,2× skor K3 pada Business Operation, tugas bisnis tersimulasi berjangka panjang.
Pekerjaan akurasi ini terlihat pada uji stres halusinasi Moonshot. Pada Kimi Hallu Bench Hard, tingkat halusinasi per klaim turun dari 23,4% pada K3 menjadi 8,3% pada K3.1 Pro. Moonshot menegaskan bahwa tes tersebut dirancang untuk memicu kesalahan, jadi angka ini bukan tingkat kesalahan sehari-hari.
Kimi K3.1 Pro kompetitif dengan Claude Opus 5.5 dan GPT-6 Astra pada agentic coding dan pekerjaan sarat alat, tetapi jelas tertinggal pada penalaran murni. Semua angka di bawah berasal dari pengumuman Moonshot, dengan K3.1 Pro pada upaya max.
Agentic coding adalah area terkuat K3.1 Pro. Pada Terminal-Bench 4.0, yang menilai agen coding pada tugas terminal yang realistis dan terbatas sumber daya, K3.1 Pro meraih 65,7%. Itu hanya sedikit di belakang Claude Opus 5.5 dengan 66,4% dan jauh di atas GPT-6 Astra dengan 58,2%.
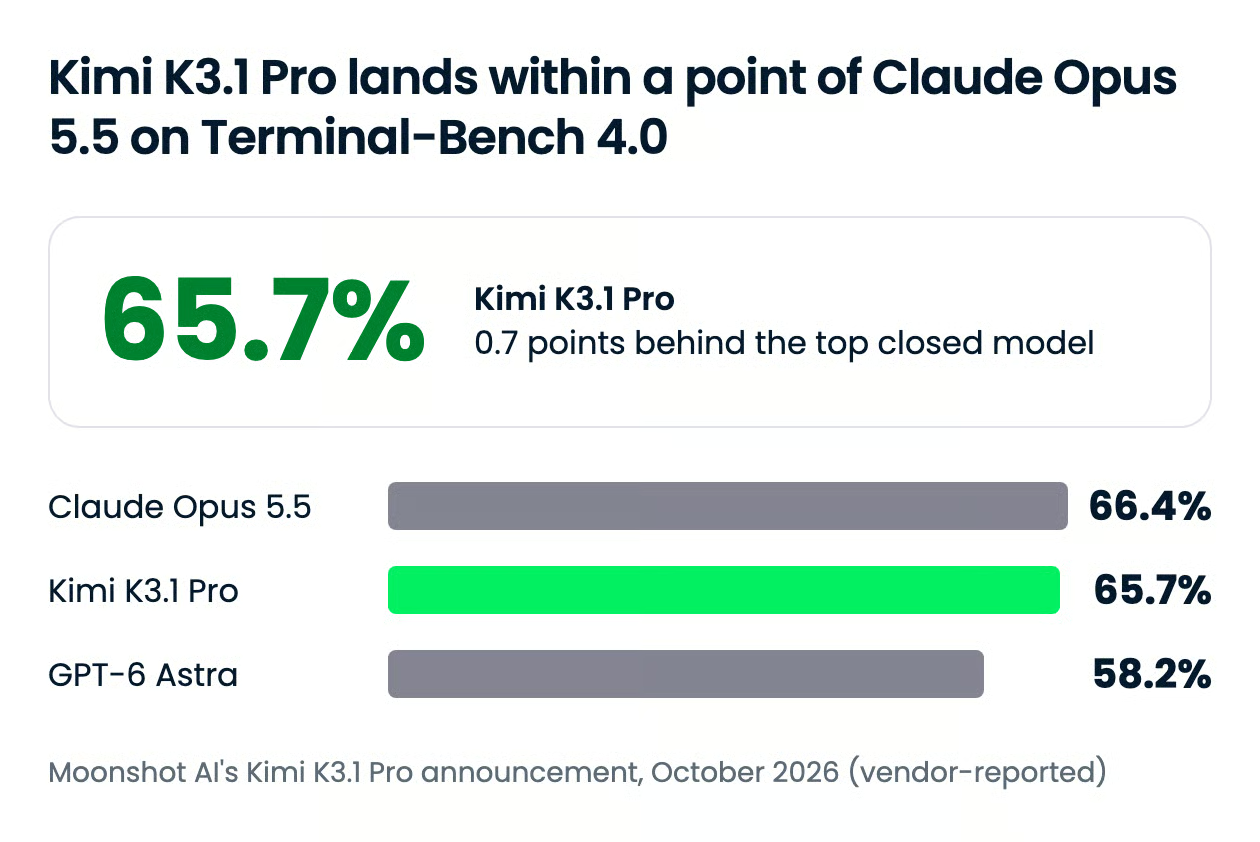
Sisa hasil coding lebih beragam dari yang disiratkan tajuk utama. Semua skor dilaporkan vendor, dengan skor terbaik di setiap baris dicetak tebal:
| Benchmark | Apa yang diukur | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agen coding pada tugas terminal yang realistis | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 tugas rekayasa berdurasi jam, tanpa internet | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 tugas berjangka panjang, dinilai berdasarkan perilaku | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (internal Moonshot) | Eksekusi multi-langkah dan penggunaan alat | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Membangun ulang program dari biner dan spesifikasi (tugas yang lulus setidaknya 95% tes) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agen pada alur kerja riset ilmiah | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro setara dengan model tertutup terbaik pada tugas rekayasa panjang dan memimpin perbandingan SWE-Marathon Moonshot. Pada DeepSWE, setiap lab menjalankan setelannya sendiri, jadi selisih 3 poin lebih tepat dianggap seri daripada menang. Ia tertinggal jauh ketika harus membangun ulang program murni dari perilaku yang diamati, atau menuntaskan alur kerja riset ilmiah.
Dibanding pendahulunya, peningkatan paling jelas ada pada benchmark long-horizon internal Moonshot, di mana Kimi K3 meraih 55,95%.
Pada kerja agen yang sarat alat, K3.1 Pro memimpin atau hanya terpaut beberapa poin dari Opus 5.5:
| Benchmark | Apa yang diukur | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full dengan alat | 2.500 pertanyaan pengetahuan dan penalaran sulit, alat diperbolehkan | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Menemukan informasi yang sulit dicari di web | 92,1% | 90,8% | 91,5% | n/a |
| OfficeQA Pro v2 | Analisis numerik pada PDF keuangan nyata | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Alur kerja investasi dari penyaringan hingga analisis profitabilitas | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Mengoperasikan komputer desktop untuk menyelesaikan tugas | 79,6% | 81,8% | 75,8% | 69,3% |
Pengecualian yang jelas di tabel Moonshot adalah penggunaan komputer, di mana Opus 5.5 tetap unggul. Pada Frontier Finance, Claude Fable 5.1 (60,8) adalah pemimpin keseluruhan, di atas keempat model yang ditampilkan di sini.
Tanpa alat, K3.1 Pro jelas tertinggal dari model tertutup:
| Benchmark | Apa yang diukur | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 pertanyaan pengetahuan dan penalaran sulit | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | 1.000 pertanyaan subset tersulit HLE | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Pertanyaan sains tingkat pascasarjana | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Pertanyaan yang menggabungkan gambar dan teks | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (internal Moonshot, lebih rendah lebih baik) | Porsi klaim faktual yang salah | 5,4% | 6,8% | 4,2% | 13,1% |
Kesenjangan terlebar ada pada HLE-Diamond, sementara GPQA-Diamond hampir jenuh, jadi selisih 2 poin kurang bermakna. Jika pekerjaan Anda adalah penalaran closed-book yang sulit, ini bukan model untuk beralih.
Moonshot melakukan hal yang tidak biasa untuk rilis open-weight: mereka memublikasikan seberapa besar kapabilitas yang sengaja dihapus. Mereka menemukan bahwa konten terkait siber dalam data mid-training dan lingkungan RL terus meningkatkan kemampuan riset kerentanan, sehingga data tersebut dihapus dari kedua tahap untuk rilis open-weight.
Pada xdev-bench-hard, benchmark pengembangan eksploit internal Moonshot, sebuah checkpoint tanpa penghapusan data menyelesaikan 90,5% masalah (pass@3). K3.1 Pro yang dikirim menyelesaikan 81,0%, yang masih jauh di atas 33,3% milik Kimi K3. Pada benchmark siber publik, model ini berada di bawah setiap model tertutup yang dibandingkan Moonshot, dengan skor 74,7 pada ExploitBench versus 91,0 milik Opus 5.5.
Prinsip yang dinyatakan Moonshot adalah menghindari merilis bobot terbuka yang mendorong garis depan absolut kemampuan siber ofensif, sambil menaikkan standar open-weight secara bertahap. Apakah pengurangan 9,5 poin itu cukup adalah soal penilaian, tetapi memublikasikan angkanya sudah lebih dari yang dilakukan banyak lab lain.
K3.1 Pro standar adalah default yang tepat bagi hampir semua orang. Varian Highspeed hanya sepadan dengan harganya yang lebih tinggi ketika seseorang duduk menunggu hasilnya.
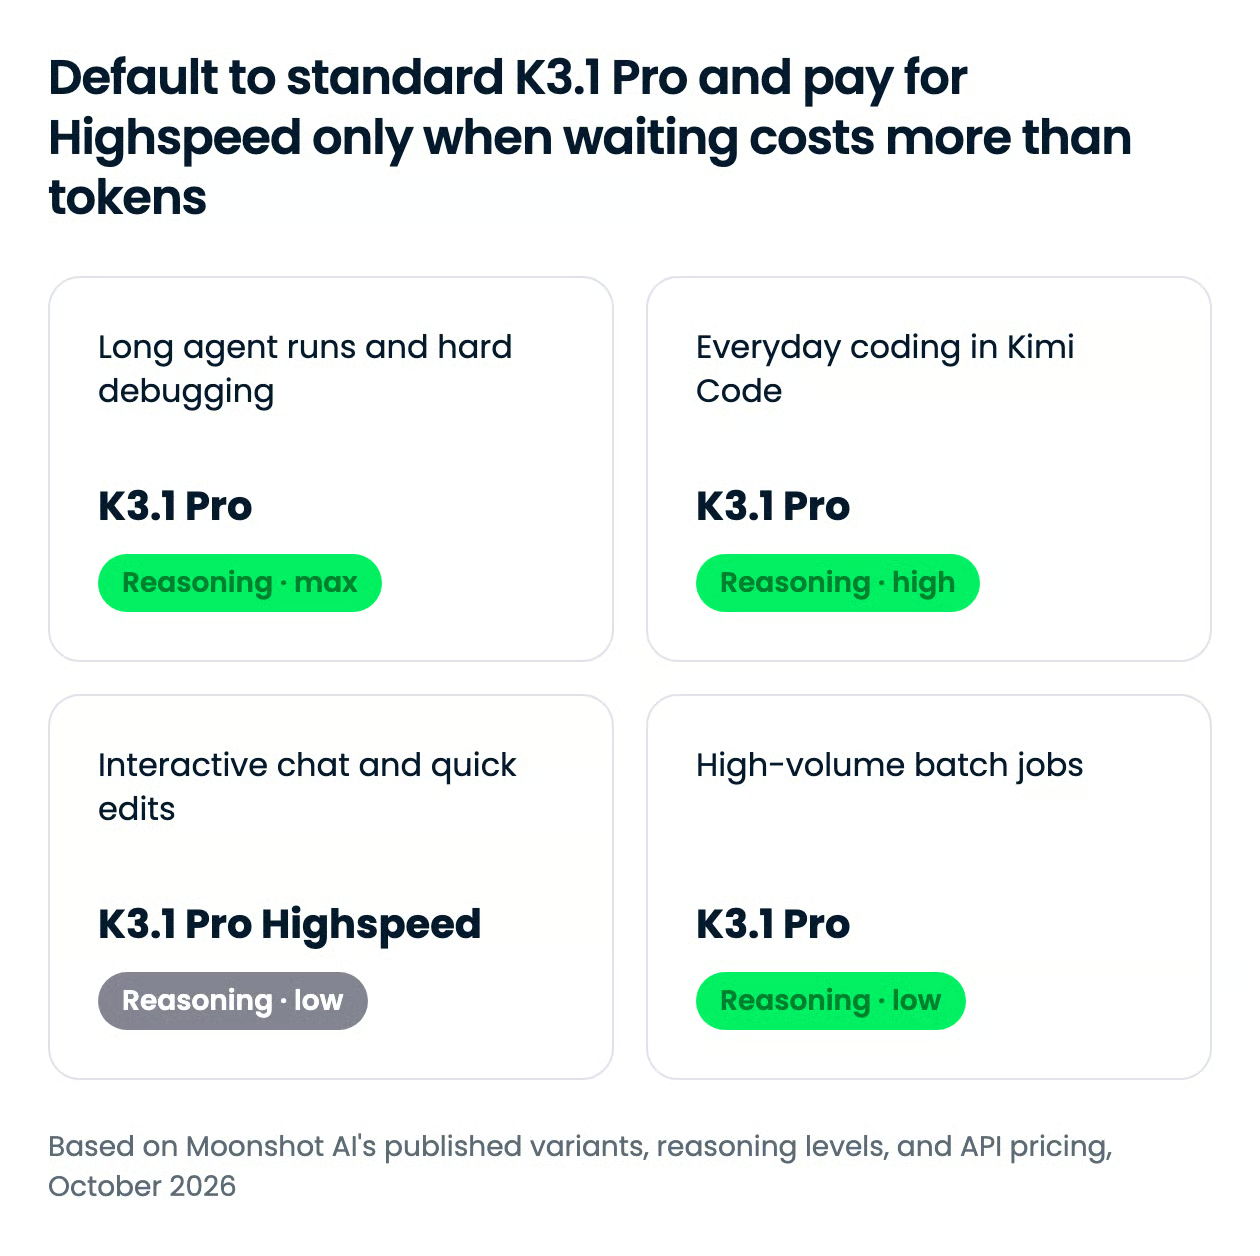
Moonshot menjual Highspeed murni karena kecepatan: berjalan 2–3× lebih cepat, biaya dua kali lipat per token input dan output, dan tidak memiliki hasil benchmark terpisah.
Kedua varian selalu "berpikir" sebelum menjawab, dan Anda tidak bisa mematikannya. Anda mengatur tingkat upaya dengan tiga level penalaran: max untuk kerja agen paling berat, high sebagai tengah yang masuk akal, dan low ketika waktu pikir default lebih dari yang dibutuhkan tugas. API default ke max, setelan di balik setiap skor di tabel benchmark Moonshot, jadi turunkan ke high atau low kecuali tugasnya butuh kedalaman penuh.
| Kasus penggunaan | Varian | Tingkat penalaran | Alasan |
|---|---|---|---|
| Jalankan agen panjang, debugging sulit | K3.1 Pro | max |
Setelan di balik skor coding Moonshot; kecepatan kurang penting dalam hitungan jam |
| Coding harian di Kimi Code | K3.1 Pro | high |
Kualitas sebagian besar dengan biaya token lebih rendah |
| Chat interaktif dan edit cepat | K3.1 Pro Highspeed | low |
Latensi adalah hambatan, dan prompt pendek membuat harga 2× tetap kecil |
| Pekerjaan batch volume tinggi | K3.1 Pro | low |
Tidak ada yang menunggu, jadi bayar tarif lebih rendah dan batasi waktu pikir |
Satu catatan praktis penting dari dokumentasi Kimi Code: mengganti tingkat penalaran di tengah sesi akan membuat cache konteks tidak berlaku, jadi pilih satu tingkat per sesi alih-alih bolak-balik.
Kimi K3.1 Pro berharga $2,00 per juta token input dan $10,00 per juta token output di Kimi API, lebih murah dari Kimi K3. Harga flat untuk seluruh konteks 1M token, tanpa biaya tambahan konteks panjang.
| Model | Input | Output | Input cache | Tulis cache 5 menit | Tulis cache 1 jam |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2,00 | $10,00 | $0,20 | $2,00 | $4,00 |
| Kimi K3.1 Pro Highspeed | $4,00 | $20,00 | $0,20 | $4,00 | $8,00 |
| Kimi K3 (generasi sebelumnya) | $3,00 | $15,00 | $0,30 | $3,00 | $6,00 |
Harga adalah per juta token dan belum termasuk pajak. Caching berlangsung otomatis dengan default 5 menit, dan Anda dapat meminta tier 1 jam per panggilan.
Beberapa detail akses yang perlu diketahui sebelum Anda mengandalkannya:
Jika Anda masih menggunakan model seri K2, dokumen Moonshot menyebut model tersebut tidak tersedia bagi pengguna baru mulai 31 Oktober 2026, dan akan dipensiunkan pada akhir Desember 2026.
Anda dapat menggunakan Kimi K3.1 Pro hari ini melalui Kimi API, OpenRouter, dan aplikasi Kimi, tetapi belum tersedia sebagai bobot yang dapat diunduh. Moonshot mengatakan bobot penuh akan dirilis sebelum 4 November 2026, dan pengumumannya tidak menyebut syarat lisensi, jadi periksa kartu model saat bobotnya tersedia.
kimi-k3.1-pro dan kimi-k3.1-pro-highspeed, pada endpoint yang kompatibel dengan OpenAI.moonshotai/kimi-k3.1-pro./model. Dokumentasi Moonshot juga membahas penyambungan ke Codex melalui Kimi Responses API.Panggilan minimal dengan klien OpenAI Python seperti ini:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Setelah bobot tersedia, panduan kami tentang cara menjalankan LLM secara lokal membahas opsi penyajian, dan penjelasan kami tentang OpenCode menunjukkan cara menyambungkan model seperti ini ke agen coding open-source.
Kimi K3.1 Pro adalah argumen terkuat sejauh ini bahwa model open-weight dapat menyamai garis depan tertutup pada agentic coding, dengan harga di bawah pendahulunya sendiri. Ia bukan pemimpin penalaran umum, tetapi untuk coding panjang dan kerja agen yang sarat alat, posisinya tepat di sebelah Claude Opus 5.5 dan unggul atas GPT-6 Astra pada beberapa tugas.
Moonshot juga bertaruh bahwa memublikasikan kompromi sibernya akan mendapatkan penerimaan baik untuk rilis terbukanya. Jika Anda melakukan coding dengan agen, saya akan mencobanya sekarang lewat API dan meninjau kembali opsi self-hosting saat bobot dan kartu model hadir di November.
Jika Anda tertarik bekerja dengan model terbuka seperti ini, saya merekomendasikan untuk melihat Hugging Face Fundamentals skill track kami.
Belajar AI Bersama DataCamp!
Kursus
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



