Kurs
Praca z Hugging Face
2 godz.
40K
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z GoogleLaboratoria pracujące nad modelami z otwartymi wagami spędziły rok 2026 na domykaniu dystansu do Anthropic i OpenAI w obszarze kodowania, a Moonshot AI znów go zmniejszył. W zeszły piątek Moonshot wypuścił Kimi K3.1 Pro, nazywając go swoim najsprawniejszym do tej pory modelem 3T klasy open-weight, który w agentycznym kodowaniu mieści się w jednym punkcie od Claude Opus 5.5.
K3.1 Pro to mocno post-trenowana wersja Kimi K3 z kontekstem 1 mln tokenów. Towarzyszy mu szybszy wariant, K3.1 Pro Highspeed, a oba są już dostępne w aplikacjach Kimi, Kimi Code i API Kimi. Pełne wagi mają trafić do publicznego użytku do 4 listopada 2026 r.
W tym artykule omawiam wszystko, co nowe w Kimi K3.1 Pro: nowe funkcje, benchmarki oraz porównanie cen z Kimi K3. Jeśli chcesz nadrobić podstawy modelu, na którym się opiera, zajrzyj do naszych przewodników po Kimi K3 oraz do naszego praktycznego tutorialu Kimi K3.
Kimi K3.1 Pro to flagowy duży model językowy (LLM) Moonshot AI i pierwszy model w nowej serii K3.1. Zachowuje bazę Kimi K3, modelu z 2,8T parametrów i kontekstem 1M tokenów, dodając do tego znacznie więcej mocy post-treningowej.
Zmiana dotyczy treningu, nie architektury: Moonshot uruchomił łączone uczenie ze wzmocnieniem (RL) w „setkach zadań downstream” i przebudował swoje ramy RL, infrastrukturę sandboxa i harmonogram rolloutów tak, by dodatkowa moc obliczeniowa dawała stałe przyrosty. Efekt, według Moonshot, to poprawa w każdym mierzonym obszarze, z naciskiem na kodowanie, tworzenie 3D i research finansowy.
Najgłośniejsza teza to parytet agentycznego kodowania z najlepszymi modelami komercyjnymi. W tabeli Moonshot K3.1 Pro mieści się w jednym punkcie od Claude Opus 5.5 w zadaniach terminalowych, kosztując ułamek ceny Anthropic. Model ma otwarte wagi, ale nie są jeszcze publiczne.
K3.1 Pro to szeroki upgrade, a nie jeden trik. Poniższe cztery możliwości to te, dla których naprawdę zmieniłbym workflow.
K3.1 Pro potrafi utrzymać kurs na długim, wieloetapowym zadaniu programistycznym, diagnozując własne błędy zamiast tylko ponawiać próby. Prezentacja Moonshot to symulator chodu człowieka zbudowany na otwartym human-atlas modelu anatomicznym, z 296 elementami kostnymi i 402 mięśniowymi.
W 167 misjach i 420 niezależnych recenzjach model przeszedł od upadku w ciągu sekund do 11,2 s marszu z naprzemiennymi krokami. Ciekawy moment przyszedł, gdy kształtowanie nagród przestało pomagać w ruchu ręki: K3.1 Pro przeprowadził otwartopętlowe sondy symulatora, znalazł 36 błędów w obliczeniach momentów ramion mięśni barku, poprawił je i ponownie wytrenował sterowanie.
To wewnętrzne demo, więc potraktuj je jako ilustrację zamierzonego zastosowania, nie dowód. Pokazuje jednak, na co celuje Moonshot: agentów, którzy badają i iterują.
Moonshot twierdzi, że K3.1 Pro generuje strony front-end, sceny Three.js i assety 3D o „mocniejszej kompozycji, typografii, animacji i wykończeniu”. Współpracuje z Unity, Unreal Engine i Godot, a także potrafi połączyć je z wyszukiwaniem w sieci i generowaniem 3D, by złożyć kompletny projekt.
Po stronie modelowania K3.1 Pro pisze i uruchamia skrypty dla Blendera i oprogramowania CAD bezpośrednio, bez łączników MCP, budując modele parametryczne, takie jak części mechaniczne, modele architektoniczne i konfigurowalne meble. Moonshot uruchomił też 3D Make na kimi.ai i w aplikacji Kimi, gdzie możesz podglądać, edytować i pobierać modele gotowe do druku 3D.
Twierdzenie o jakości wizualnej jest też najtrudniejsze do weryfikacji w tabeli benchmarków, więc potraktuj dema Moonshot jak najlepsze przykłady dostawcy, a nie typowe wyniki.
K3.1 Pro potrafi przeprowadzić workflow finansowy od screeningu do gotowego arkusza, a Moonshot wprowadził ukierunkowane poprawki w dokładności faktów dla takiej pracy. Na wewnętrznych benchmarkach finansowych K3.1 Pro poprawia Kimi K3 o 7,2 pkt w Financial Modeling i 11,6 pkt w Financial Research oraz osiąga ok. 4,2× wyniku K3 w Business Operation, długohoryzontalnym symulowanym zadaniu biznesowym.
Efekt prac nad dokładnością widać w teście na halucynacje Moonshot. W Kimi Hallu Bench Hard odsetek halucynacji na poziomie pojedynczych twierdzeń spadł z 23,4% dla K3 do 8,3% dla K3.1 Pro. Moonshot podkreśla, że test prowokuje błędy, więc te stawki nie są codziennymi wskaźnikami błędów.
Kimi K3.1 Pro konkuruje z Claude Opus 5.5 i GPT-6 Astra w agentycznym kodowaniu i pracy silnie narzędziowej, ale wyraźnie za nimi zostaje w czystym rozumowaniu. Wszystkie liczby poniżej pochodzą z ogłoszenia Moonshot, z K3.1 Pro na wysiłku max.
Agenticzne kodowanie to najsilniejsza strona K3.1 Pro. W Terminal-Bench 4.0, który ocenia agentów kodujących na realistycznych, zasoboograniczonych zadaniach terminalowych, K3.1 Pro uzyskuje 65,7%. To tylko odrobinę mniej niż Claude Opus 5.5 z 66,4% i wyraźnie przed GPT-6 Astra z 58,2%.
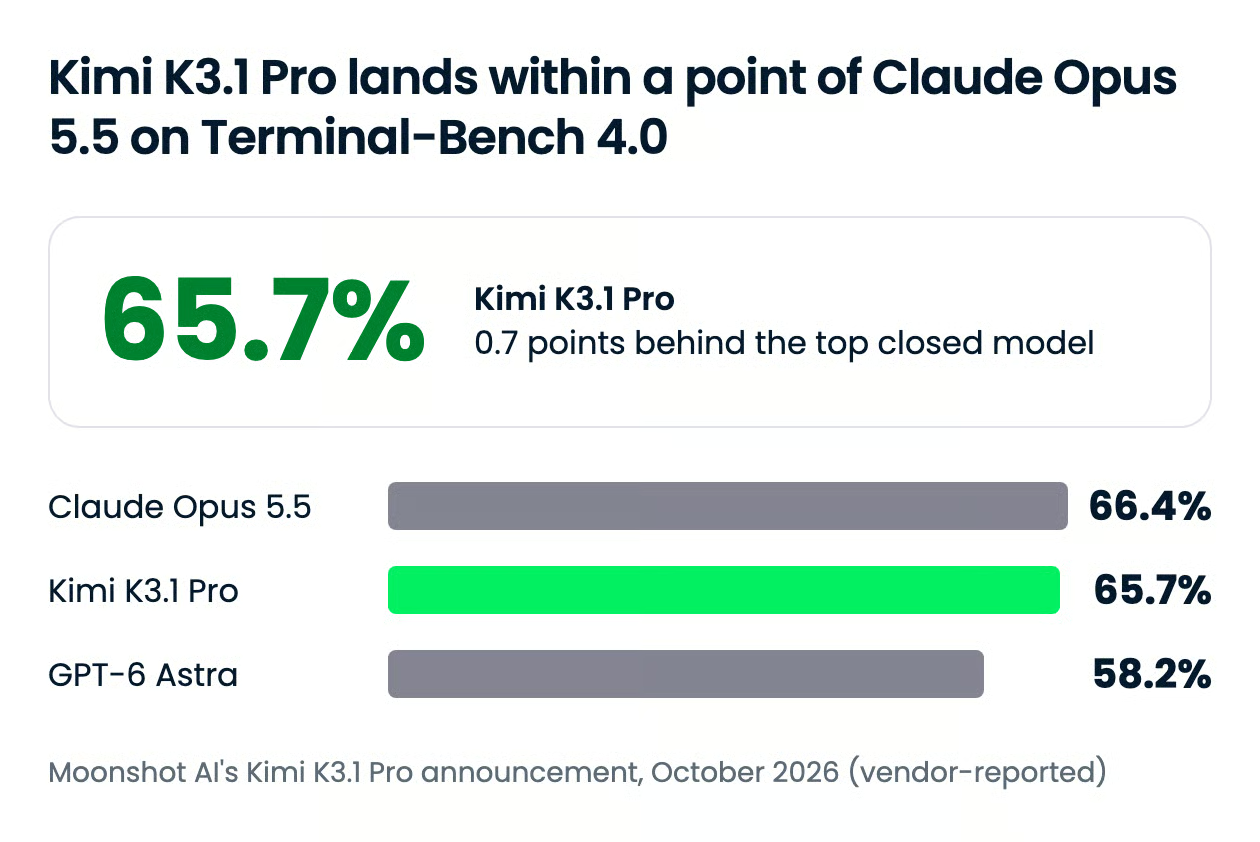
Reszta wyników z kodowania jest bardziej mieszana, niż sugeruje to nagłówek. Wszystkie wyniki są raportowane przez dostawców, a najlepszy wynik w każdym wierszu jest pogrubiony:
| Benchmark | Co mierzy | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agentów kodujących na realistycznych zadaniach terminalowych | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 20 wielogodzinnych zadań inżynieryjnych, bez internetu | 51,7% | 46,3% | 42,5% | 40,0% |
| DeepSWE v1.1 | 113 długohoryzontalnych zadań, ocenianych po zachowaniu | 75,5% | 74,2% | 74,1% | 77,0% |
| Kimi Code Bench 3.0 Long-horizon (wewnętrzny Moonshot) | Wieloetapowe wykonywanie i użycie narzędzi | 61,2% | 58,5% | 66,5% | 51,5% |
| ProgramBench | Odtworzenie programu z binarki i specyfikacji (zadania zdające ≥95% testów) | 31,5% | 65,0% | 50,0% | 29,1% |
| Terminal-Bench Science 0.1 | Agentów w przepływach pracy badań naukowych | 38,1% | 63,3% | 68,1% | 15,7% |
K3.1 Pro dorównuje najlepszym zamkniętym modelom w długich zadaniach inżynieryjnych i prowadzi w porównaniu Moonshot w SWE-Marathon. W DeepSWE każde laboratorium miało własną konfigurację, więc różnica 3 punktów to raczej remis niż wygrana. Mocno odstaje, gdy musi odtworzyć program wyłącznie z obserwowanego zachowania albo przejść przez workflow badań naukowych.
Na tle poprzednika najwyraźniejszy zysk to wewnętrzny długohoryzontalny benchmark Moonshot, gdzie Kimi K3 uzyskał 55,95%.
W pracy agentów silnie opartej na narzędziach K3.1 Pro prowadzi lub mieści się w kilku punktach od Opus 5.5:
| Benchmark | Co mierzy | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full with tools | 2 500 trudnych pytań z wiedzy i rozumowania, z narzędziami | 70,0% | 67,7% | 57,2% | 58,8% |
| BrowseComp | Znajdowanie trudno dostępnych informacji w sieci | 92,1% | 90,8% | 91,5% | n/d |
| OfficeQA Pro v2 | Analiza numeryczna w prawdziwych finansowych PDF-ach | 64,4 | 62,2 | 54,4 | 40,4 |
| Frontier Finance | Procesy inwestycyjne od screeningu po analizę rentowności | 58,6 | 56,7 | 45,0 | 54,5 |
| OSWorld V2.1 | Obsługa komputera desktop do ukończenia zadań | 79,6% | 81,8% | 75,8% | 69,3% |
Jedyny wyraźny wyjątek w tabeli Moonshot to obsługa komputera, gdzie Opus 5.5 pozostaje z przodu. W Frontier Finance ogólnym liderem jest Claude Fable 5.1 (60,8), przed wszystkimi czterema pokazanymi tu modelami.
Bez narzędzi K3.1 Pro wyraźnie ustępuje modelom zamkniętym:
| Benchmark | Co mierzy | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2 500 trudnych pytań z wiedzy i rozumowania | 51,1% | 59,8% | 53,6% | 42,6% |
| HLE-Diamond | 1 000 najtrudniejszych pytań z HLE | 39,4% | 60,9% | 65,8% | 21,6% |
| GPQA-Diamond | Pytania z nauk na poziomie magisterskim | 94,2% | 93,9% | 96,1% | 92,2% |
| MMMU-Pro | Pytania łączące obrazy i tekst | 84,1% | 87,7% | 86,9% | 80,6% |
| Kimi Hallu Bench (wewnętrzny Moonshot, mniej = lepiej) | Udział błędnych twierdzeń faktycznych | 5,4% | 6,8% | 4,2% | 13,1% |
Najszersza luka jest w HLE-Diamond, natomiast GPQA-Diamond jest niemal nasycony, więc różnica 2 punktów niewiele mówi. Jeśli twoja praca to twarde rozumowanie bez dostępu do źródeł, to nie jest model do przesiadki.
Moonshot zrobił coś nietypowego jak na wydanie open-weight: opublikował, ile zdolności celowo usunął. Odkrył, że treści cyber w danych śródtreningowych i środowiskach RL systematycznie podnosiły umiejętności w researchu podatności, więc usunął te dane z obu etapów dla wydania open-weight.
W xdev-bench-hard, wewnętrznym benchmarku rozwoju exploitów Moonshot, checkpoint bez usuwania danych rozwiązał 90,5% problemów (pass@3). Wypuszczony K3.1 Pro rozwiązuje 81,0%, co i tak jest znacznie powyżej 33,3% Kimi K3. W publicznych benchmarkach cyber plasuje się poniżej każdego porównywanego modelu zamkniętego, uzyskując 74,7 w ExploitBench wobec 91,0 dla Opus 5.5.
Deklarowana zasada Moonshot to niewypuszczanie otwartych wag, które przesuwają absolutną czołówkę ofensywnych możliwości cyber, przy jednoczesnym stopniowym podnoszeniu poprzeczki open-weight. Czy „ścięcie” o 9,5 punktu wystarczy — to kwestia oceny, ale samo ujawnienie liczby to więcej niż robi wiele innych laboratoriów.
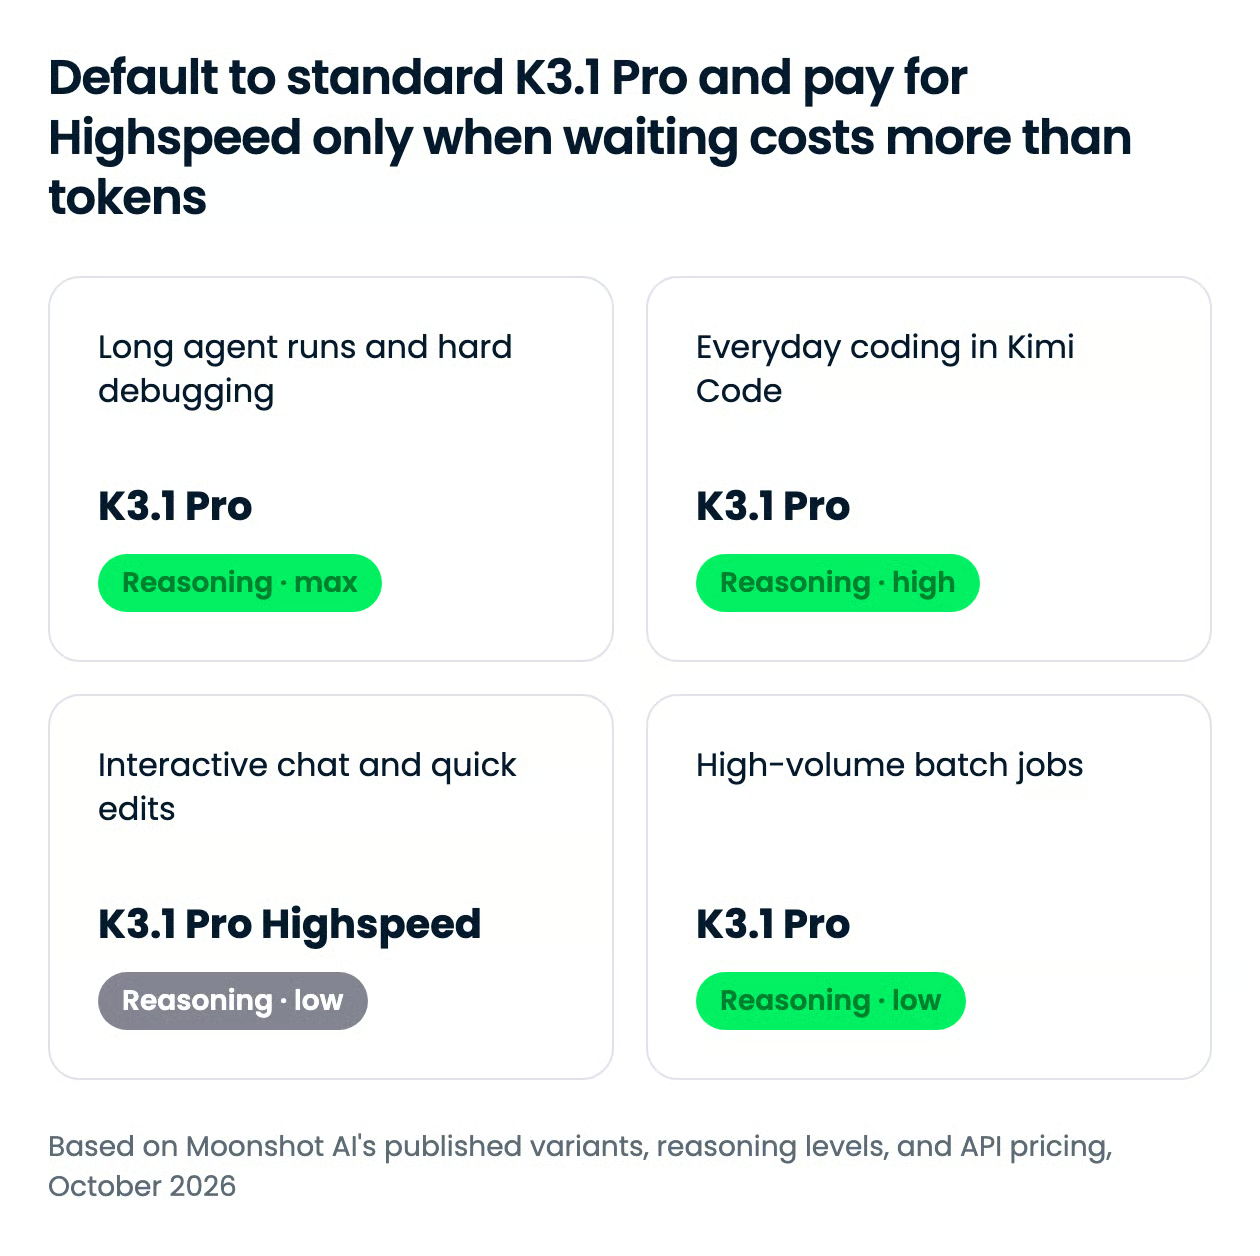
Standardowy K3.1 Pro to właściwy domyślny wybór dla prawie wszystkich. Wariant Highspeed zasługuje na wyższą cenę tylko wtedy, gdy ktoś siedzi przed ekranem i czeka.
Moonshot sprzedaje Highspeed wyłącznie szybkością: działa 2–3× szybciej, kosztuje dwa razy więcej za token wejściowy i wyjściowy i nie ma osobnych wyników benchmarków.
Oba warianty zawsze „myślą” przed odpowiedzią i nie da się tego wyłączyć. Ustawiasz intensywność trzema poziomami rozumowania: max do najtrudniejszej pracy agentów, high jako rozsądny środek i low, gdy domyślny czas myślenia jest większy niż potrzeba. API domyślnie ustawia max, za którym stoją wszystkie wyniki w tabeli Moonshot, więc zredukuj do high lub low, chyba że zadanie wymaga pełnej głębokości.
| Zastosowanie | Wariant | Poziom rozumowania | Dlaczego |
|---|---|---|---|
| Długie przebiegi agentów, twardy debugging | K3.1 Pro | max |
Ustawienie stojące za wynikami w kodowaniu Moonshot; szybkość ma mniejsze znaczenie przy godzinach pracy |
| Codzienne kodowanie w Kimi Code | K3.1 Pro | high |
Większość jakości przy niższym rachunku za tokeny |
| Interaktywny czat i szybkie poprawki | K3.1 Pro Highspeed | low |
Wąskim gardłem jest opóźnienie, a krótkie prompty utrzymują 2× cenę w ryzach |
| Wysokowolumenowe zadania wsadowe | K3.1 Pro | low |
Nikt nie czeka, więc płać niższą stawkę i ogranicz myślenie |
Ważna praktyczna uwaga z dokumentacji Kimi Code: zmiana poziomu rozumowania w trakcie sesji unieważnia cache kontekstu, więc wybieraj poziom na całą sesję zamiast przełączać się w tę i z powrotem.
Kimi K3.1 Pro kosztuje $2,00 za milion tokenów wejściowych i $10,00 za milion tokenów wyjściowych w API Kimi, co jest mniej niż w Kimi K3. Cennik jest płaski w całym kontekście 1M tokenów, bez dopłat za długi kontekst.
| Model | Wejście | Wyjście | Cache wejścia | Cache 5 min | Cache 1 godz. |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (poprzednia generacja) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Ceny są za milion tokenów i nie zawierają podatku. Cache działa automatycznie z domyślnym 5-minutowym oknem, a na żądanie możesz skorzystać z wariantu 1-godzinnego.
Kilka szczegółów dostępu warto znać, zanim na nim oprzesz plany:
Jeśli nadal korzystasz z modeli serii K2, dokumentacja Moonshot mówi, że będą niedostępne dla nowych użytkowników od 31 października 2026 r. i wycofane do końca grudnia 2026 r.
Możesz korzystać z Kimi K3.1 Pro już dziś przez API Kimi, OpenRouter i aplikacje Kimi, ale jeszcze nie jako pobieralne wagi. Moonshot zapowiada, że pełne wagi zostaną wydane do 4 listopada 2026 r., a w ogłoszeniu nie ma wzmianki o licencji, więc sprawdź kartę modelu, gdy wagi się pojawią.
kimi-k3.1-pro i kimi-k3.1-pro-highspeed, na endpointzie zgodnym z OpenAI.moonshotai/kimi-k3.1-pro./model. Dokumentacja Moonshot opisuje też podłączenie do Codex przez Kimi Responses API.Minimalne wywołanie z klientem Python OpenAI wygląda tak:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Gdy wagi się pojawią, nasz przewodnik o tym, jak uruchamiać LLM-y lokalnie, omawia opcje serwowania, a nasz materiał o OpenCode pokazuje, jak wpiąć taki model w otwartoźródłowego agenta do kodowania.
Kimi K3.1 Pro to jak dotąd najmocniejszy dowód, że modele z otwartymi wagami mogą dorównać zamkniętej czołówce w agentycznym kodowaniu, i to taniej niż jego własny poprzednik. Nie jest liderem w ogólnym rozumowaniu, ale w długim kodowaniu i narzędziowej pracy agentów siedzi tuż obok Claude Opus 5.5 i przed GPT-6 Astra w kilku zadaniach.
Moonshot stawia też na to, że publikacja kompromisów cyber zbuduje przychylność dla otwartych wydań. Jeśli kodujesz z agentami, spróbuj już teraz przez API i wróć do samodzielnego hostowania, gdy w listopadzie pojawią się wagi i karta modelu.
Jeśli chcesz pracować z takimi otwartymi modelami, polecam nasz skill track Hugging Face Fundamentals.
Ucz się AI z DataCamp!
Kurs
Ścieżka
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z Google