พรีวิวชิ้นถัดไปแสดงตัวอักษรแทนเทโตรอมิโน — O, I, T, S, Z — แทนที่จะวาดรูปทรง อ่านรู้เรื่องเมื่อคุ้นสัญกรณ์ แต่ต้องเสียจังหวะทุกครั้งที่ชำเลืองดู ซึ่งในความเร็วมีผล ทั้งที่ไม่มีโมเดลใดถูกขอให้ทำพรีวิวเลย นี่คือทางเลือกที่ Sol เสนอเองแต่ทำไม่สุด จุดเดียวที่งานซึ่งขัดเกลาดีกว่ากลับอ่านยากกว่า
ผลงานของ Claude Opus 5.5
Opus 5.5 ใช้ 3 เทิร์นและ 2 คอลเครื่องมือ หนึ่ง glob และหนึ่ง write เพื่อส่ง index.html ขนาด 19 KB ชื่อ "Flip Tetris" คอมเมนต์หัวไฟล์เป็นสเปกที่ละเอียดกว่าของทั้งคู่: ตัวสุ่มแบบ 7-bag บนซีดคงที่ การหมุนพร้อมวอลคิก การยุบแถวแยกตามกอง และบันทึกว่าชิ้นที่กำลังร่วงจะกลับทิศทางทันทีเมื่อแรงโน้มถ่วงพลิก
เกมทำงานตรงตามที่อธิบายและเสถียรพอ ๆ กับของ Sol มี ghost piece และแถบเคาน์ต์ดาวน์ที่เปลี่ยนเป็นสีแดงก่อนแต่ละครั้งที่พลิก พรีวิวชิ้นถัดไปวาดรูปทรงจริง ซึ่งเป็นทางเลือกที่ถูกต้อง และเป็นสิ่งเดียวที่ทำได้ดีกว่า Sol เมื่อมองผ่าน ๆ
ยังเพิ่มตัวนับเลเวลที่ไม่มีใครขอมา ซึ่งนับว่าเท่าเดิมไม่ใช่ข้อดี: เลเวลเพิ่มช้าเกินกว่าจะมีผลจนลึกเกินช่วงที่เกมทั้งสองนี้จะถูกเล่นจริง จุดที่ Opus แพ้คือ "ฟีล" มากกว่าตรรกะ: เลย์เอาต์เรียบกว่าของ Sol และ soft drop ไม่ลื่นเท่า จึงเสียหนึ่งคะแนนด้านคุณภาพภาพ และอีกหนึ่งด้านความสมบูรณ์
ผลลัพธ์
| ตัวชี้วัด | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| จำนวนเทิร์น | 6 | 3 |
| คอลเครื่องมือ | 9 | 2 |
| ค่าใช้จ่าย | $0.26 | $0.87 |
| โทเทิลโทเค็น | 120,226 | 107,958 |
| โทเค็นการให้เหตุผล | 8,123 | 22,551 |
| รันได้ | ผ่าน | ผ่าน |
| กลไกการพลิก | 5 | 5 |
| ความสมบูรณ์ของเกม | 5 | 4 |
| คุณภาพภาพและฟีล | 5 | 4 |
| คะแนนรูบริก (ค่าเฉลี่ยสามแกน) | 5 | 4.3 |
GPT-6 Sol ชนะการทดสอบนี้ แต่เฉือนกัน และไม่ใช่บนส่วนที่ยาก ทั้งคู่ทำแรงโน้มถ่วงพลิกได้ถูกต้อง จึงวัดกันที่ความประณีต และความลื่นกับความเนี้ยบด้านภาพของ Sol ให้ความได้เปรียบเหนือ Opus เล็กน้อย
สิ่งที่ต่างกันชัดเจนกว่าคือต้นทุนการรัน Opus 5.5 ใช้ $0.87 เทียบกับ $0.26 ของ Sol มากกว่าสามเท่า และทำแบบนั้นด้วยโทเค็นรวมน้อยกว่า: 108k เทียบกับ 120k ความต่างคือการให้เหตุผล: Opus คิดหนักต่อเทิร์นราวสามเท่า ไปถึงงานที่ถูกต้องในครึ่งจำนวนเทิร์น แล้วหยุด ส่วน Sol ไต่แก้ในไฟล์แทน ในราคาถูกกว่า และได้เปรียบเล็กน้อยด้านฟีล
นี่คือการรันครั้งเดียวของงานเดียวที่การตั้งค่าความพยายามเดียว และทดสอบลูปเกมในไฟล์เดียว ไม่ใช่งานรีโประยะยาวที่ทั้งสองค่ายใช้เบนช์มาร์ก ตัวเลขต้นทุนเป็นจุดข้อมูลจุดเดียว ไม่ใช่ค่าเฉลี่ย
ควรเลือก GPT-6 Sol หรือ Claude Opus 5.5 เมื่อใด
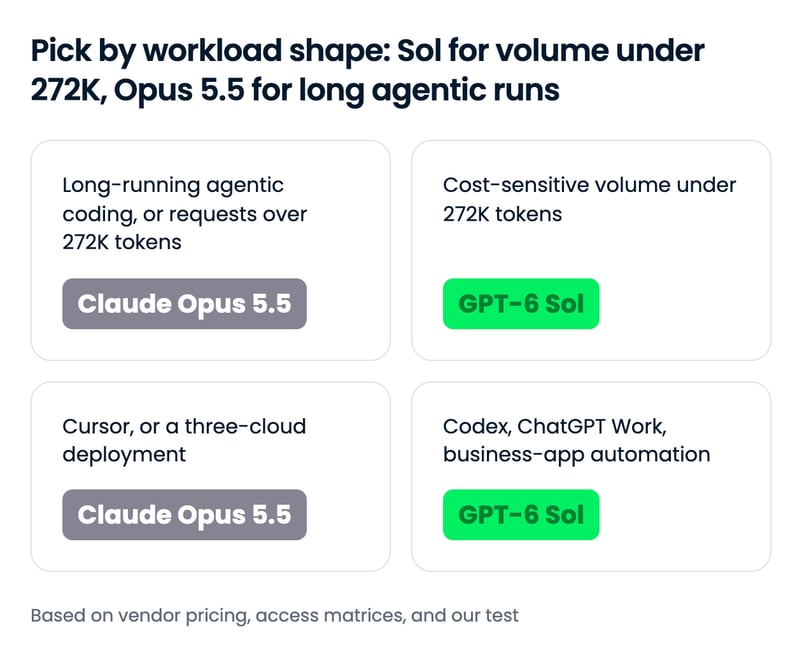
ทางแยกคือขนาดคำขอและทรงเวิร์กโหลด มากกว่าความสามารถดิบ: ต่ำกว่า 272K โทเค็นต่อคำขอ ส่วนลดของ Sol เป็นของจริง; สูงกว่านั้น หรือบนลูปที่พึ่งแคชหนัก บิลสองฝั่งเข้าหากัน และความได้เปรียบที่เผยแพร่ของ Opus 5.5 บนงานตัวแทนคือสิ่งที่จ่ายเพิ่ม
เลือก GPT-6 Sol ถ้า...
- รันตัวแทนปริมาณสูงที่คำขอแต่ละครั้งอยู่ใต้เกณฑ์บริบทยาว ราคาปลีกครึ่งหนึ่งทบต้นบนคำขอนับล้าน และเรทอ่านแคชก็เท่ากันอยู่แล้ว
- ทีมทำงานใน Codex หรือ ChatGPT Work อยู่แล้ว Sol มีให้ใช้งานบนทุกแพลนที่ชำระเงิน และ Codex คือฮาร์เนสที่ OpenAI ปรับจูนเพื่อมัน
- ทำออโตเมชันเวิร์กโฟลว์ธุรกิจด้วยงบจำกัด การรัน AutomationBench ของ Sol มีค่า $0.27 ต่อภารกิจ และข้ออ้างต้นทุนต่อภารกิจของ OpenAI คือจุดแข็งที่สุด
- ต้องการบันไดระดับความพยายามที่ลงได้จนสุด การตั้งค่า
noneของ Sol และการเปลี่ยนระดับความพยายามที่ไม่ทำลายแคชช่วยให้ตัวแทนทำขั้นตามน้ำราคาถูกได้ และค่อยยกระดับเฉพาะขั้นยาก
เลือก Claude Opus 5.5 ถ้า...
- งานคือการโค้ดเชิงตัวแทนแบบรันยาว: มายเกรชัน การออดิท และงานหลายรีโป Opus 5.5 เผยคะแนนที่แข็งแรงกว่าบนทุกเบนช์มาร์กการโค้ดเชิงตัวแทนที่รายงาน และเกร็ดเล่าจากผู้ทดสอบคือจ็อบที่รันกันเป็นชั่วโมง
- คำขอมักเกินเกณฑ์บริบทยาวของ Sol Anthropic คิดราคาเต็มหน้าต่าง 1M ที่เรทมาตรฐาน และค่าธรรมเนียมของ Sol ปิดช่องว่างราคาส่วนใหญ่ที่ขนาดนั้น
- ต้องใช้โมเดลใน Cursor หรือบนคลาวด์ไฮเปอร์สเกลทั้งสามวันนี้ Opus 5.5 มีใน Cursor และบน Bedrock, Vertex AI และ Microsoft Foundry; Sol ยังไม่มีใน Cursor และ Vertex AI
- รันตัวแทนแบบไม่มีคนดูแลและต้องการโมเดลที่ระมัดระวังมากกว่า การประเมินการกักกันของ Anthropic และมาตรการระดับ Fable ถูกออกแบบมาเพื่อสิ่งนี้ พอ ๆ กับที่งานไม่ใช่ไซเบอร์ซีเคียวริตี้
วิธีเริ่มต้นกับ GPT-6 Sol และ Claude Opus 5.5
| พื้นผิวการใช้งาน | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| แอปผู้บริโภค | ChatGPT Work และ Codex บนแพลน Plus, Pro, Business, Enterprise และ Edu; ยังไม่มีใน Chat ของ ChatGPT | แอป Claude; เพิ่มลิมิตการใช้งานบนแพลน Pro, Max, Team และ Enterprise ตอนเปิดตัว |
| API ต้นสังกัด | มี, OpenAI API (แนะนำ Responses API) | มี, Claude API |
| แพลตฟอร์มคลาวด์ | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| เอเจนต์โค้ด | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| รูตเตอร์ของบุคคลที่สาม | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| รหัสโมเดล API | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 เปิดตัวบนคลาวด์หลักทั้งสามและใน Cursor ตั้งแต่วันแรก ขณะที่ Sol อยู่บนสองคลาวด์และยังไม่ปรากฏในรายการโมเดลของ Cursor บน API ใช้สตริง gpt-6-sol และ claude-opus-5-5
การใช้ GPT-6 Sol และ Claude Opus 5.5 ในเอเจนต์โค้ด
แต่ละโมเดลมาพร้อมเอเจนต์ของค่ายตนเอง คือ Codex สำหรับ Sol และ Claude Code สำหรับ Opus 5.5 และทั้งคู่เลือกใช้ใน GitHub Copilot ได้ หากต้องการฮาร์เนสเดียวใช้ได้กับทั้งสอง เอเจนต์ที่ต่อรูตเตอร์อย่าง OpenCode จะเข้าถึงผ่าน OpenRouter ในชื่อ openai/gpt-6-sol และ anthropic/claude-opus-5.5 ซึ่งเป็นวิธีที่การทดสอบของเราเรียกใช้ด้วยเครื่องมือเหมือนกันเป๊ะ
การเรียก API โดยตรงใช้ SDK ต่างกัน ดังนั้นการสลับคือเปลี่ยนไคลเอนต์และสตริงโมเดล ไม่ใช่แค่บรรทัดเดียว:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)สำหรับการตั้งค่าเอเจนต์เต็มรูปแบบ บทเรียน Codex CLI และ บทเรียน Claude Code ของเราครอบคลุมการติดตั้งและเวิร์กโฟลว์ และ บทเปรียบเทียบ Codex vs Claude Code ของเราชั่งน้ำหนักฮาร์เนสทั้งสอง
ข้อคิดส่งท้าย
หากเวิร์กโหลดคือการโค้ดเชิงตัวแทนแบบยาว หรือคำขอเกินเกณฑ์บริบทยาว ให้ใช้ Claude Opus 5.5: มันเผยตัวเลขเชิงตัวแทนที่แข็งแรงกว่า และการตั้งราคาของมันไม่ลงโทษคำขอใหญ่ หากรันปริมาณใต้เกณฑ์นั้น อาศัยอยู่ใน Codex หรือ ChatGPT Work หรือทำออโตเมชันแอปธุรกิจแบบประหยัด ให้ใช้ GPT-6 Sol และเก็บส่วนต่าง
สิ่งที่น่าสนใจคือไม่มีค่ายใดสามารถใส่โมเดลใหม่ของอีกฝ่ายในตารางของตนได้ และจุดเดียวที่เราเปรียบเทียบเองได้ คือการสร้างแบบปิดตัวเอง โมเดลที่ถูกกว่ากลับเด่นกว่าในแง่ความเนี้ยบ
หากอยากเริ่มสร้างด้วยโมเดลใด ๆ แนะนำคอร์ส Working with the OpenAI API และคอร์ส Introduction to Claude Models ของเรา
FAQs
ควรใช้ GPT-6 Sol แทน Claude Opus 5.5 เมื่อใด?
ใช้ GPT-6 Sol เมื่อคำขออยู่ต่ำกว่า 272K โทเค็นอินพุตและปริมาณสำคัญ: ราคาปลีกอยู่ที่ $2 ต่อ 1M โทเค็นอินพุต และ $10 ต่อ 1M โทเค็นเอาต์พุต ซึ่งเป็นครึ่งหนึ่งของ Claude Opus 5.5 ที่ $4 และ $20 อีกทั้งเป็นตัวเลือกธรรมชาติหากทีมทำงานใน Codex หรือ ChatGPT Work เลือก Opus 5.5 สำหรับการโค้ดเชิงตัวแทนแบบรันยาว สำหรับคำขอเกิน 272K โทเค็น หรือเมื่อจำเป็นต้องมีโมเดลใน Cursor หรือบนคลาวด์หลักทั้งสาม
GPT-6 Sol ถูกกว่า Claude Opus 5.5 แค่ไหน?
ตามราคาปลีก Claude Opus 5.5 มีราคาเท่าตัว GPT-6 Sol ทั้งอินพุต ($4 เทียบกับ $2 ต่อ 1M โทเค็น) เอาต์พุต ($20 เทียบกับ $10) และการเขียนแคช ($5 เทียบกับ $2.50) การอ่านแคชมีราคา $0.20 ต่อ 1M โทเค็นทั้งคู่ Sol คิดราคาอินพุตคูณ 2 และเอาต์พุตคูณ 1.5 กับคำขอที่เกิน 272K โทเค็นอินพุต ขณะที่ Anthropic คิดราคาหน้าต่าง 1M เต็มที่เรทมาตรฐาน ดังนั้นช่องว่างหดเหลือราว 8% บนการค้นคืนบริบทยาว และราว 33% บนลูปตัวแทนที่พึ่งแคชหนัก
รหัสโมเดล API ของ GPT-6 Sol และ Claude Opus 5.5 คืออะไร?
บน OpenAI API GPT-6 Sol คือ gpt-6-sol บน Claude API Claude Opus 5.5 คือ claude-opus-5-5 และบน Amazon Bedrock คือ anthropic.claude-opus-5-5 ผ่าน OpenRouter ทั้งสองคือ openai/gpt-6-sol และ anthropic/claude-opus-5.5
เข้าถึง GPT-6 Sol และ Claude Opus 5.5 ได้ที่ไหน?
GPT-6 Sol ใช้งานได้ใน ChatGPT Work และ Codex สำหรับผู้ใช้ Plus, Pro, Business, Enterprise และ Edu ผ่าน OpenAI API บน Azure AI Foundry และ AWS Bedrock ใน GitHub Copilot และผ่าน OpenRouter; ยังไม่มีในแชทสำหรับผู้บริโภคของ ChatGPT Claude Opus 5.5 ใช้งานได้ในแอป Claude ผ่าน Claude API บน AWS Bedrock, Google Cloud Vertex AI และ Microsoft Foundry และใน Claude Code, Cursor และ GitHub Copilot
ตัวไหนดีกว่าสำหรับการโค้ด ระหว่าง GPT-6 Sol กับ Claude Opus 5.5?
บนเบนช์มาร์กที่เผยแพร่ Claude Opus 5.5 นำหน้า: Anthropic รายงาน 66.4% บน Terminal-Bench 4.0 และ 54.4% บน FrontierCode ขณะที่ OpenAI ระบุว่า GPT-6 Sol เทียบ Claude Fable 5.1 บน FrontierCode ซึ่ง Anthropic ให้ไว้ที่ 50.3% ในการทดสอบลงมือทำของเราเอง เกม Tetris แบบไฟล์เดียวพร้อมแรงโน้มถ่วงพลิก โมเดลทั้งคู่ทำตรรกะถูก และ GPT-6 Sol ได้ 5.0 เทียบกับ 4.3 ของ Opus 5.5 ในด้านความเนี้ยบและฟีล
ความสนใจต่อโมเดลใหม่ของ Anthropic อยู่ได้ราวชั่วโมงเดียวในศึกชิงโมเดลระดับแนวหน้าที่มีประสิทธิภาพคุ้มค่าและเข้าถึงได้มากขึ้น
Claude Opus 5.5 ของพวกเขาเป็นโมเดลตัวแรกในตระกูล Claude 5.5 ชูจุดขายว่าให้ประสิทธิภาพระดับ Fable 5.1 ด้วยต้นทุนรันที่ต่ำกว่า Opus 5
OpenAI ตอบสนองอย่างรวดเร็ว เผยแพร่ GPT-6 Sol เป็นรุ่นระดับกลางของตระกูล GPT-6 ฝึกด้วยวิธีเดียวกับรุ่นเรือธง GPT-6 Astra และเปิดราคาผ่าน API ที่ครึ่งหนึ่งของรุ่นก่อนหน้า GPT-5.6 Sol
ในบทความนี้ จะเปรียบเทียบ GPT-6 Sol และ Claude Opus 5.5 ในหลายหมวดประสิทธิภาพ มาตรการคุ้มกัน และการตั้งราคา พร้อมการทดสอบสร้างจริงแบบลงมือทำที่รันกับทั้งสองโมเดล
สรุปสั้น
GPT-6 Sol คืออะไร?
GPT-6 Sol เป็นโมเดลระดับกลางของ GPT-6 จาก OpenAI เปิดตัวเมื่อวันที่ 22 กันยายน 2026 พร้อมกับ GPT-6 Luna และอยู่ต่ำกว่ารุ่นเรือธง GPT-6 Astra
จุดขายคือสูตรการฝึกของ Astra ที่ครึ่งหนึ่งของราคา API ของ GPT-5.6 Sol พร้อมการแคชพรอมต์ที่ยังใช้ได้แม้เปลี่ยนระดับความพยายามในการให้เหตุผลหรือเครื่องมือกลางบทสนทนา
คู่มือ GPT-6 Sol และ Luna ของเราครอบคลุมการเปิดตัว และ บทเรียน API ของ GPT-6 Astra อธิบายเครื่องมือแบบอะซิงก์และการควบคุมของทั้งตระกูล
Claude Opus 5.5 คืออะไร?
Claude Opus 5.5 เป็นโมเดล Claude 5.5 ตัวแรกของ Anthropic เปิดตัวเมื่อวันที่ 22 กันยายน 2026 ในฐานะโมเดลชั้นนำใหม่ของบริษัทสำหรับการโค้ดเชิงตัวแทนที่รันยาวและงานความรู้
จุดขายคือผลลัพธ์ระดับ Fable ในราคา Opus: Anthropic ระบุว่าทำได้เทียบ Claude Fable 5.1 ในงานส่วนใหญ่ และมาพร้อมมาตรการคุ้มกันไซ버ซีเคียวริตี้และชีววิทยาระดับ Fable
คู่มือ Opus 5.5 ของเราครอบคลุมการเปิดตัว และ บทเรียน API ของ Claude Opus 5 ครอบคลุม API รุ่นก่อน
GPT-6 Sol เทียบกับ Claude Opus 5.5: เผชิญหน้ากัน
เพราะช่วงเปิดตัวใกล้กันมาก ไม่มีผู้ขายรายใดใส่โมเดลใหม่ของอีกรายในตารางเปิดตัว จึงมีเบนช์มาร์กซ้อนกันเพียงสองตัว และ Opus 5.5 นำทั้งคู่ ฝั่ง Sol อาศัยราคาและผลจากการทดสอบของเราเอง
noneถึงmax; มีการอ้างอิงที่ทำให้เข้าใจผิดเกี่ยวกับงานโค้ดน้อยกว่า GPT-5.6 Solเวิร์กโฟลว์การโค้ดและเชิงตัวแทน
Opus 5.5 เผยตัวเลขการโค้ดเชิงตัวแทนที่แข็งแรงกว่า และโพสต์ของ Sol ก็ไม่ได้โต้แย้งโดยตรง Anthropic รายงาน Opus 5.5 บน Terminal-Bench 4.0, FrontierCode และ CursorBench; OpenAI รายงาน Sol บน DeepSWE และบรรยายผล FrontierCode เพียงว่าเทียบ Claude Fable 5.1 ที่ระดับ xhigh Anthropic ให้คะแนน Fable 5.1 ที่ 50.3% บน FrontierCode เทียบกับ 54.4% สำหรับ Opus 5.5 ดังนั้นหากทั้งสองอ้างถูก Sol จะอยู่ราวสี่คะแนนหลัง Opus 5.5 บนเบนช์มาร์กเดียวที่ทั้งสองฝ่ายเอ่ยถึง
ทั้งสองค่ายพึ่งพาเกร็ดเล่าระยะยาวมากกว่าคะแนนร่วมกัน ด้าน Anthropic โปรเจ็กต์เขียนใหม่ HAProxy จาก C เป็น Rust ทำให้ Opus 5.5 จบใน 9.5 ชั่วโมง เทียบกับ 12 ชั่วโมงของ Fable 5.1 ที่ต้นทุนต่ำกว่าราว 51% ด้าน OpenAI โต้ด้วยต้นทุนต่อภารกิจ: Sol ทำคะแนน DeepSWE ห่าง Fable 5 ราวหนึ่งจุดที่ต้นทุนต่ำกว่าประมาณ 80%
สองเหตุผลที่ควรอ่านตารางเหล่านี้อย่างระมัดระวัง:
บนกระดาษ Opus 5.5 เป็นโมเดลโค้ดที่แข็งแรงกว่า; ช่องว่างนั้นไม่ปรากฏในบททดสอบสร้างเดี่ยวของเราด้านล่าง
เวิร์กโฟลว์ธุรกิจและการใช้งานคอมพิวเตอร์
Opus 5.5 นำหน้าทั้งสองเบนช์มาร์กที่ทั้งคู่มีร่วมกัน และช่องว่างบน AutomationBench เป็นตัวเลขที่ใสที่สุดในบทความ: 40.0% สำหรับ Opus 5.5 เทียบกับ 33.2% สำหรับ Sol บนการทดสอบตัวแทนของ Zapier ที่ทำงานข้ามเครื่องมือธุรกิจ 47 รายการ
ข้อโต้แย้งของ Sol คือบิล: OpenAI วางกรอบว่า Sol ชนะ Claude Opus 5 ที่ 9% ของต้นทุนต่อภารกิจของ Opus 5 แม้การเปรียบเทียบจะอยู่กับ Opus รุ่นก่อนหน้า ไม่ใช่รุ่นนี้
Opus 5.5 แข็งแกร่งกว่าในฐานะตัวแทนตามคะแนน; Sol คือโมเดลที่รันได้กับทุกทิกเก็ตโดยไม่เจ็บตัว
งานความรู้และความน่าเชื่อถือเชิงข้อเท็จจริง
Opus 5.5 มีตัวเลขข้ามผู้ขายเพียงรายการเดียวที่นี่: 1846 Elo บน GDPval-AA v2.1 นำหน้าคะแนนของ GPT-6 Astra และ GPT-5.6 Sol ในตารางของ Anthropic; ตัว Sol เองไม่ได้ระบุ ในการทดสอบเขียนรายงานของ Anthropic ที่ตัวเลขแต่งใด ๆ ทำให้สอบตก 16 จาก 18 รายงานของ Opus 5.5 ผ่าน และทั้ง Fable 5.1 กับ Opus 5 ไม่ผ่านเลย
หลักฐานของ Sol เทียบกับรุ่นก่อน: บนชุดข้อเท็จจริงภายในของ OpenAI Sol ทำผิดพลาดประมาณครึ่งหนึ่งของ GPT-5.6 Sol การทดสอบ AA-Omniscience ของ Artificial Analysis ก็สอดคล้อง แต่มีข้อแม้: อัตราหลอนของ Sol ลดจาก 92% เหลือ 60% ขณะตอบเพียง 83% ของคำถาม เทียบกับ 99% ของรุ่นก่อน
ทั้งคู่ระมัดระวังยิ่งกว่ารุ่นก่อน ๆ; มีเพียง Opus 5.5 ที่แสดงต่อคู่แข่งให้เห็น
มาตรการคุ้มกันและข้อจำกัด API
Sol เป็น API ที่ถูกจำกัดน้อยกว่า ส่วน Opus 5.5 ถูกกำกับดูแลมากกว่า
Opus 5.5 ไม่สามารถรันโดยปิดการคิด ปฏิเสธการบังคับใช้เครื่องมือ และผูกบล็อกการคิดกับโมเดลและบทสนทนาที่สร้างมันขึ้นมา ดังนั้นคอนเท็กซ์ที่แก้ไขจะล้มเหลวด้วยข้อผิดพลาด 400 บนบัญชีที่สร้างหลัง 31 สิงหาคม 2026 งานไซเบอร์ซีเคียวริตี้ส่วนใหญ่ถูกเปลี่ยนเส้นทางไปยัง Opus 4.8 นอกโปรแกรมยืนยันความถูกต้องด้านไซเบอร์ และงานชีววิทยาต้องใช้โปรแกรมยืนยันด้านชีววิทยา
บันไดของ Sol มีตั้งแต่
noneถึงmaxสามารถเปลี่ยนระดับความพยายามกลางบทสนทนาโดยไม่ทำให้แคชเสีย และ OpenAI รายงานว่ามีการอ้างงานโค้ดที่ทำให้เข้าใจผิดน้อยกว่า GPT-5.6 Solนี่คือการแลกที่ตั้งใจไว้: Opus 5.5 พยายามข้ามขอบเขตการควบคุมน้อยกว่า Opus 5 ราว 85% ซึ่งสำคัญสำหรับตัวแทนที่รันโดยไม่มีคนดูแล
ราคา: สิ่งที่จ่ายจริง
Opus 5.5 มีราคาเท่าตัวของ Sol ตามเรทพาดหัว แต่กลไกจริงที่ตัวแทนจ่ายทำให้แพตเทิร์นแตก: ค่าอ่านจากแคชเท่ากัน และ Sol มีค่าใช้จ่ายเพิ่มสำหรับคำขอที่เกิน 272K โทเค็น ซึ่ง Anthropic ไม่มี
เรทโทเค็นเทียบกันข้าง ๆ
ส่วนต่างราคาเป็นเส้นตรงทั้งอินพุต เอาต์พุต และการเขียนแคช จึงกระทบทุกทรงเวิร์กโหลดเท่า ๆ กันจนกว่าจะมีการแคชหรือบริบทยาว ค่าอ่านจากแคชเป็นข้อยกเว้น และ Anthropic ระบุว่าคิดเป็นส่วนใหญ่ของต้นทุนงานตัวแทนและการโค้ด ไม่มีผู้ขายรายใดเผยเรทแยกสำหรับโทเค็นการให้เหตุผล จึงควรตั้งงบไว้ที่เรทเอาต์พุต
เวิร์กโหลดจริงมีค่าใช้จ่ายเท่าใด
แถวเกินเกณฑ์คือประเด็น: เมื่อทุกคำขอข้ามเกณฑ์ ค่าธรรมเนียมของ Sol จะดันบิลให้ห่างจาก Opus 5.5 เพียง 8% ดังนั้นไปป์ไลน์ค้นคืนบริบทยาวแทบไม่ได้ส่วนลดจากการเลือก Sol ลูปพึ่งแคชหนักทำให้ช่องว่างแคบลงเหลือ 33% ด้วยเหตุผลต่างกัน: การอ่านแคช 1,000 ครั้งมีราคาเท่ากันในทั้งสองโมเดล และมีเพียงโทเค็นสดเท่านั้นที่โดนราคาแพงคูณ 2
ทั้งสองโมเดลใช้ตัวตัดโทเค็นต่างกัน และไม่มีผู้ขายรายใดเผยจำนวนโทเค็นสำหรับเวิร์กโหลดร่วม จึงควรตีความยอดรวมเหล่านี้เป็นการเปรียบเทียบเรทมากกว่าบิลจริง Anthropic ระบุว่า Opus 5.5 ใช้โทเค็นต่อภารกิจน้อยกว่า Opus 5 แต่ไม่ได้บอกว่าเทียบกับ Sol อย่างไร
ประสิทธิภาพของ GPT-6 Sol และ Claude Opus 5.5
เบนช์มาร์กจากสองผู้ขายที่ไม่ได้ทดสอบโมเดลของอีกฝ่ายไปได้จำกัด จึงรันงานสร้างหนึ่งงานกับทั้งสองโดยใช้พรอมต์และเครื่องมือเหมือนกันทุกประการ
การทดสอบ
ให้ทั้งคู่สร้างเกม Tetris แบบไฟล์เดียวบนกระดาน 12×24 โดยมีลูกเล่น: แรงโน้มถ่วงพลิกทุก 20 วินาที สองอย่างที่พรอมต์กำหนดทำให้งานยาก: หลังการพลิก ชิ้นต้องตกขึ้นด้านบนไปยังเพดานและล็อกกับกองที่สองตรงนั้น โดยแถวเต็มเคลียร์ได้ทั้งสองกอง และเซลล์ที่ล็อกแล้วต้องไม่ขยับเลย
ทั้งสองรันใน OpenCode ด้วยพื้นผิวเครื่องมือที่ปักหมุดเหมือนกัน: อ่านไฟล์ ค้นหา และแก้ไขเท่านั้น ไม่มีเชลล์และไม่มีเครือข่าย ทั้งคู่รันที่ระดับการให้เหตุผล
highครั้งละหนึ่งความพยายาม ไม่รีทราย และพรอมต์ถูกส่งแบบไบต์ต่อไบต์ไปยังเซสชันใหม่มีอสมมาตรหนึ่งข้อที่ควรจำ:
highอยู่ต่ำกว่าระดับสูงสุดสองขั้นในบันไดของทั้งคู่ แต่บันไดของ Sol มีขั้นnoneเพิ่มที่ก้นบันได ดังนั้นhighจึงเป็นขั้นที่สี่จากหกของ Sol และขั้นที่สามจากห้าของ Opus 5.5นี่คือพรอมต์:
ได้บันทึกต้นทุนและให้คะแนนทั้งคู่ตามรูบริกสามข้อด้านล่าง โดยให้คะแนน 1 ถึง 5:
ผลงานของ GPT-6 Sol
Sol ใช้ 6 เทิร์นและ 9 คอลเครื่องมือ: ลิสต์ ค้นหา และอ่านพื้นที่ทำงานเปล่าก่อนจะเขียน
index.htmlขนาด 22 KB แล้วแพตช์อีกหนึ่งครั้ง ผลงานที่ออกมามีการสร้างแบรนด์ของตัวเอง "Fall / Rise, a game of shifting ground" พร้อมพาเนลแรงโน้มถ่วงที่เปลี่ยนสีจากอำพันเป็นสีเทียลตอนพลิก มีเคาน์ต์ดาวน์ถึงการพลิกครั้งถัดไป และการ์ดกติกาที่ขอบมันทำตามที่ควรและทำงานได้ลื่นไหลและเสถียร: กองที่พื้นอยู่กับที่ตอนพลิก ชิ้นส่วนลอยขึ้นและล็อกบนเพดาน แถวเคลียร์ได้ทั้งสองกอง และการ soft drop ตอบสนองดี ทำให้เล่นสนุกกว่าของอีกฝั่ง