
Program
AI Temelleri
10 sa
Mythos 5, Anthropic’in test ettiği tüm başlıca yetenek alanlarında Mythos Preview’e kıyasla bir seviye atlıyor. Kazanımlar, özellikle bilimsel akıl yürütme ve görsel görevlerin yer aldığı uzun ufuklu otonom çalışmalarda en görünür düzeyde. İşte pratikte nasıl göründüğü.
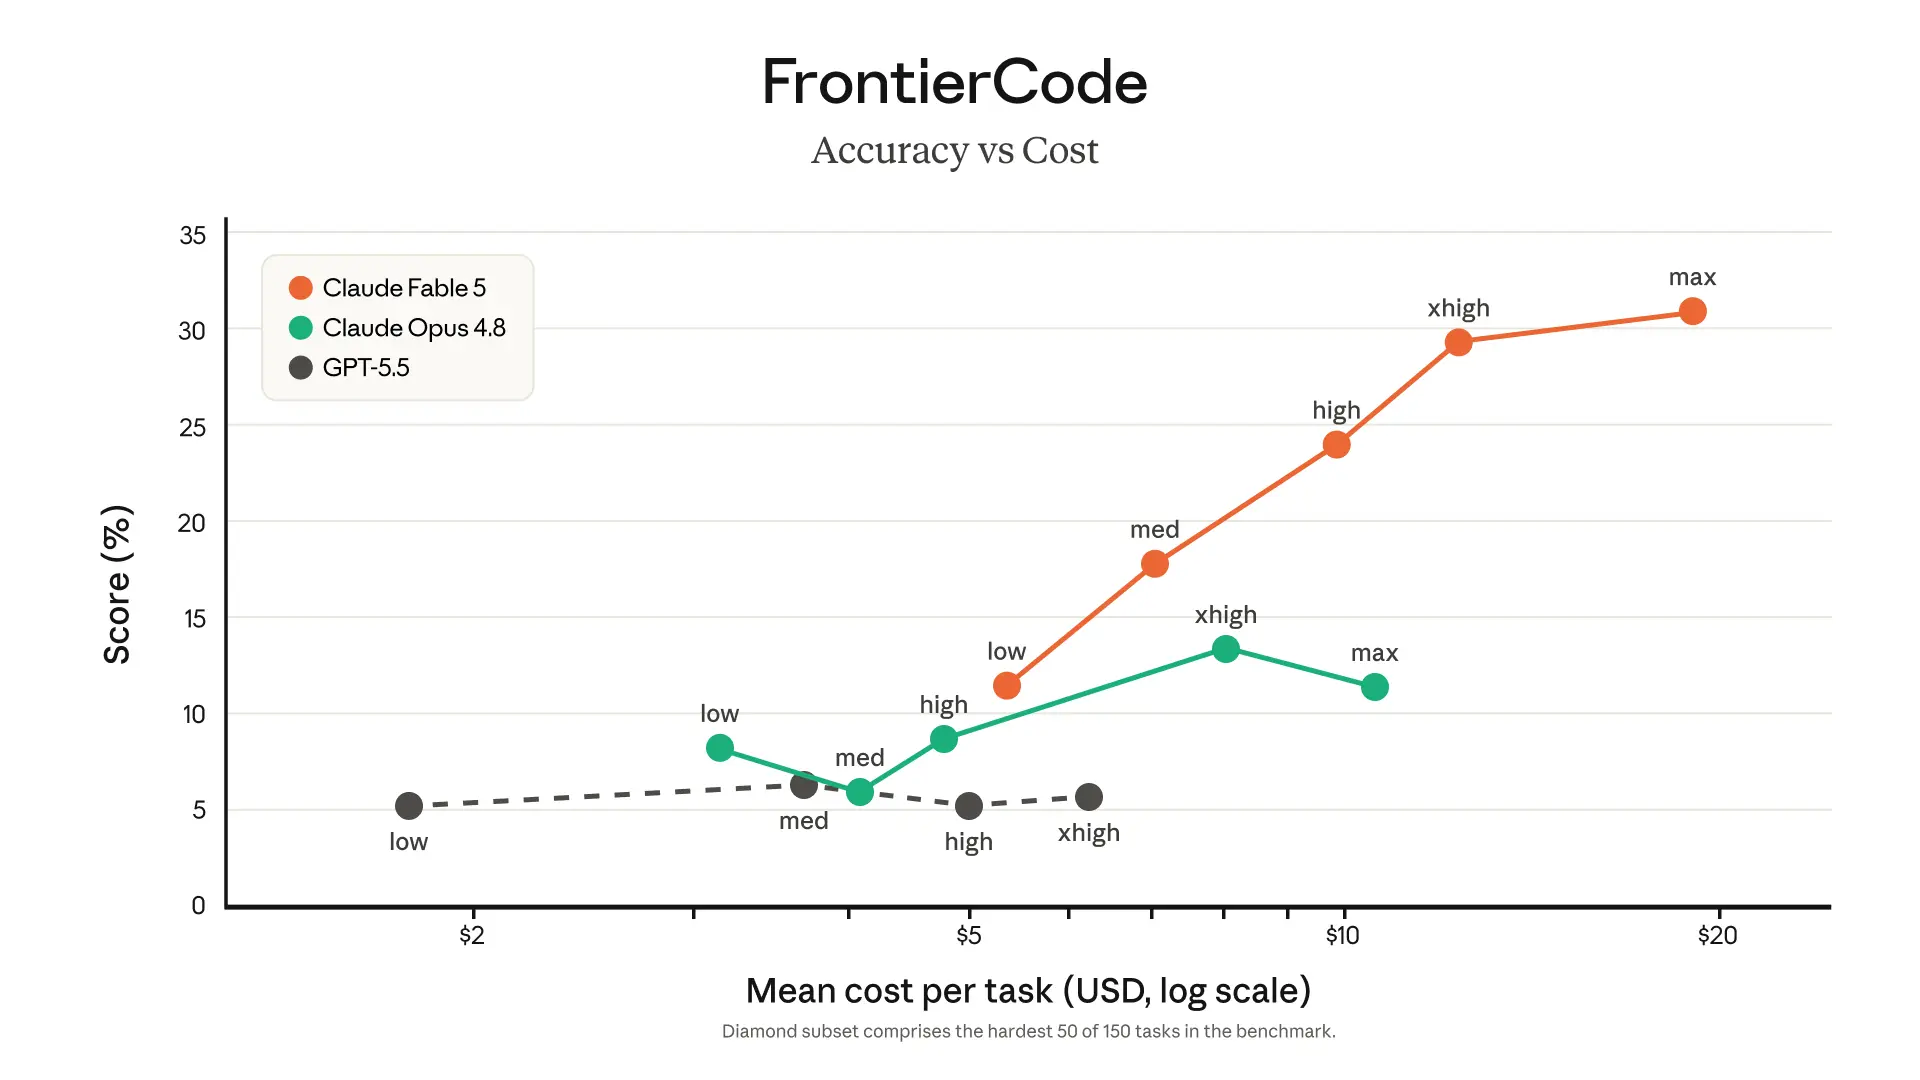
Mythos 5, önceki hiçbir Claude modelinden daha uzun süre büyük kod tabanlarında otonom çalışabiliyor. Stripe, modelin aylar sürecek mühendislik işini günlere indirdiğini; 50 milyon satırlık bir Ruby kod tabanı genelinde tek günde kapsamlı bir geçişi tamamladığını bildirdi. FrontierCode (Diamond) kıyaslamasında, orta çaba seviyesinde bile sınır modelleri arasında en yüksek puanı alıyor.
Güvenlik çalışmalarında Mythos 5, Mythos Preview’i Project Glasswing ortakları için değerli kılan yetenekleri genişletiyor. Bu ortaklar, Mythos Preview ile üretim sistemlerinde 10.000’den fazla yüksek ve kritik güvenlik açığını tespit etti.
Anthropic’in dahili protein tasarım ekibi, Mythos 5 ile ilaç tasarımını yaklaşık on kat hızlandırdı. Kontrollü bir karşılaştırmada Mythos 5, 14 protein hedefinin tamamında aşağıdaki adımlarda yetkin insan operatörlerle başa baş gitti veya onları geçti:
Dokuzu, şu anda araştırılan güçlü ilaç tasarımı adayları verdi.
Mythos 5, mevcut literatürü özetlemek yerine tutarlı biçimde yeni bilimsel hipotezler üreten Anthropic’in ilk modelidir. Kör karşılaştırmalarda, Anthropic’in bilim insanları moleküler biyoloji hipotezlerini yaklaşık %80 oranında tercih etti ve bunlardan birkaçı deneysel değerlendirmeye taşındı. Yeni bir E. coli protein mekanizmasına dair hipotezlerden biri, aynı sorun üzerinde çalışan bağımsız bir laboratuvar tarafından doğrulandı.
Mythos 5, büyük ölçüde otonom geçen bir haftadan uzun bir çalışmada yeni genomik araştırmalar yürüttü; tek hücreli verileri 138 hayvan türünde milyonlarca hücre için derledi ve uzak akraba organizmalar arasında denk hücre tiplerini belirlemek üzere özel bir ML modeli eğitti. Eğitilen model, 100 kat daha küçük olmasına rağmen yakın zamanda Science’ta yayımlanan bir modeli geride bıraktı.
Mythos 5, araçlarla CharXiv Reasoning’de %93,2 puan alıyor ve ayrıntılı bilimsel figürlerden hassas sayılar çıkarabiliyor veya yalnızca ekran görüntülerinden bir web uygulamasını yeniden inşa edebiliyor. Uzun bağlam görevlerinde, Mythos 5’e dosya tabanlı bellek vermek, aynı kurulumun Opus 4.8’i iyileştirdiğinden üç kat fazla iyileştirme sağladı ve Slay the Spire’ın final bölümüne üç kat daha sık ulaştı.
Mythos 5, Anthropic’in test ettiği neredeyse tüm kıyaslamalarda lider veya birinciliği paylaşıyor; kazanımlar tek bir alanda yoğunlaşmak yerine kategoriler genelinde Opus 4.8’e kıyasla tutarlı. Karşılaştırma tablosu, onu Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 ve Gemini 3.1 Pro ile yan yana koyuyor.
| Kategori | Kıyaslama | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Aracılı kodlama | SWE-Bench Pro | %80,3 | %77,8 | %69,2 | %58,6 | %54,2 |
| Aracılı kodlama | FrontierCode (Diamond) | %29,3 (xhigh) | — | %13,4 (xhigh) | %5,7 (xhigh) | — |
| Bilgi işi | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Görsel bilgi işi | GDP.pdf | %29,8 (araçsız) | — | %22,5 (araçsız) | %24,9 (araçsız) | %16,7 (araçsız) |
| Mekânsal akıl yürütme | Blueprint-Bench 2 | %38,6 | — | %14,5 | %36,2 | %26,5 |
| Araç kullanımı | AutomationBench | %17,4 | — | %15,5 | %12,9 | %9,6 |
| Bilgisayar kullanımı | OSWorld-Verified | %85,0 | %85,4 | %83,4 | %78,7 | %76,2 |
| Hukuk | Legal Agent Benchmark | %13,3 | — | %10,4 | %2,1 | %0,0 |
| Çok disiplinli akıl yürütme | Humanity's Last Exam (araçsız) | %59,0* | %56,8 | %49,8 | %41,4 | %44,4 |
| Çok disiplinli akıl yürütme | Humanity's Last Exam (araçlarla) | %64,5* | %64,7 | %57,9 | %52,2 | %51,4 |
| Biyoloji | BioMysteryBench (zor) | %46,1* | %29,6 | %40,0 | — | — |
| Biyoloji | BioMysteryBench (insan tarafından çözülen) | %83,9* | %82,6 | %80,4 | — | — |
| Aracılı kodlama | Terminal-Bench 2.1 | %88,0* | — | %82,7 | %83,4 (Codex CLI) | %70,7 (Gemini CLI) |
| Siber güvenlik | ExploitBench (Cap%) | %78,0* | %69,0 | %40,0 | %34,0 | — |
| Sağlık | HealthBench Professional | %66,0* | %64,7 | %56,9 | %51,8 | — |
Anthropic, Mythos 5 ve Fable 5 puanlarını birlikte raporlayarak, çoğu durumda aralarındaki farkın 1–3 yüzde puanı içinde kaldığını belirtiyor. Yıldızlı (*) kıyaslamalarda fark daha büyüktür; çünkü Fable 5’in güvenlik sınıflandırıcıları hassas sorguları Opus 4.8’e yönlendirir; bu kıyaslarda Fable 5, performans olarak Opus sınıfına daha yakındır.
SWE-Bench Pro’da Mythos 5 %80,3 puan alıyor; Mythos Preview %77,8, Opus 4.8 %69,2, GPT 5.5 %58,6 ve Gemini 3.1 Pro %54,2. Yerleşik gerçek yanıt sızıntısına dirençli bir kıyaslamada Opus 4.8’e karşı 11 puanlık fark kayda değer.
Ham görev tamamlama yerine yüksek kaliteli ve sürdürülebilir aracılı kod için, FrontierCode (Diamond) ile ölçüldüğünde ayrım daha da keskin. Mythos 5, xhigh çaba düzeyinde %29,3 puan alırken, Opus 4.8 %13,4 ve GPT 5.5 %5,7 puanda kalıyor.
Terminal ortamında ise Mythos 5, tacı OpenAI’dan Anthropic’e geri getiriyor: Mythos 5, Terminal-Bench 2.1’de %88,0* puan alırken; Opus 4.8 %82,7, GPT 5.5 (Codex CLI) %83,4 ve Gemini 3.1 Pro (Gemini CLI ile) %70,7 puan alıyor.
GDPval-AA, bilgi işi performansını sayısal bir ölçekte değerlendirir. Mythos 5, Opus 4.8 için 1890, GPT 5.5 için 1769 ve Gemini 3.1 Pro için 1314’e kıyasla 1932 puan alıyor.
Araçsız PDF belgeleri üzerindeki bilgi işi için bu fark daha da artar. Mythos 5, GDPpdf’de %29,8 puan alırken; Opus 4.8 %22,5, GPT 5.5 %24,9 ve Gemini 3.1 Pro %16,7 puan alıyor.
Humanity's Last Exam (HLE), fen, matematik ve beşeri bilimlerde lisansüstü düzey akıl yürütmeyi test eder. Mythos 5, araçsız %59,0* ve araçlarla %64,5* puan alıyor. Mythos Preview sırasıyla %56,8 ve %64,7 puan alıyor—araçlarla neredeyse başa baş, araçsızda ise 2 puan geride. Opus 4.8’e mesafe zaten belirgin (araçsız %49,8; araçlarla %57,9), amiral gemisi rakiplere ise daha da büyük (GPT 5.5: %41,4 ve %52,2; Gemini 3.1 Pro: %44,4 ve %51,4).
Mythos 5 ile alanın geri kalanı arasındaki fark, araçsız koşulda en net; burada Opus 4.8’e 9 puandan fazla fark atıyor. Bu puanlar yıldızlıdır; yani Fable 5, güvenlik sınıflandırıcıları nedeniyle bir miktar daha düşük performans sergiler.
Gerçek bir bilgisayar arayüzünde görev tamamlama yeteneğini test eden OSWorld-Verified’da Mythos 5 %85,0 puan alıyor. Mythos Preview %85,4 ile az farkla öne çıkıyor; bu, Mythos Preview’in lider olduğu tek kıyas. Opus 4.8 %83,4 ile oldukça yakın; rakipler ise biraz geride: GPT 5.5 %78,7, Gemini 3.1 Pro %76,2.
AutomationBench, araç kullanma kabiliyetlerini ölçer. Mythos 5 %17,4; Opus 4.8 %15,5; GPT 5.5 %12,9 ve Gemini 3.1 Pro %9,6 puan alıyor. Genel olarak düşük mutlak değerler, araç kullanımının tüm sınır modeller için hâlâ zor bir problem olduğunu ima ediyor.
Mekânsal akıl yürütme, Mythos 5’in en büyük fark yarattığı alanlardan biri. Blueprint-Bench 2’de %38,6 puan alıyor; bu, Opus 4.8’in %14,5’inin iki katından fazla. GPT 5.5 %36,2 ile daha yakın; Gemini 3.1 Pro %26,5 puanda.
Bunlar, sürüm notlarında muhtemelen en çok öne çıkan iki alandı ve sonuçlar nedenini gösteriyor.
ExploitBench, modelin başarıyla yeniden üretebildiği açıkların oranını (Cap%) ölçer. Mythos 5 %78,0* puan alıyor; bu, Mythos Preview’in %69,0’ından belirgin biçimde yüksek ve Opus 4.8’in %40,0’ı ile GPT 5.5’in %34,0’ına kıyasla dramatik bir artış.
Opus 4.8’e karşı 38 puanlık fark, karşılaştırma tablosundaki tekil kıyaslarda en büyük liderlik ve Fable 5 için siber güvenlik önlemlerinin neden var olduğunu açıklıyor. Anthropic’in dış red team çalışmaları, uzun biçimli aracılı görevlerde evrensel bir jailbreak bulamadı; ancak Birleşik Krallık AISI, ilk test penceresinde buna doğru ilerleme kaydetti.
BioMysteryBench, iki zorluk seviyesinde biyolojik akıl yürütmeyi test eder. Zor alt kümede Mythos 5 %46,1* puan alırken; Mythos Preview %29,6 ve Opus 4.8 %40,0 puan alıyor. İnsan tarafından çözülen alt kümede Mythos 5 %83,9*; Mythos Preview %82,6 ve Opus 4.8 %80,4 puanda. GPT 5.5 ve Gemini 3.1 Pro’nun bu alt kümelerde raporlanan puanları yok.
ExploitBench’te olduğu gibi, Fable 5’in puanları biyolojiye ilişkin güvenlik sınıflandırıcıları nedeniyle Opus 4.8’e daha yakındır.
Claude Mythos 5, doğruluğun ve akıl yürütme kalitesinin gerçek dünyada sonuçlar doğurduğu iki yüksek riskli profesyonel alanda—tıp ve hukuk—dikkat çekici güç sergiliyor.
HealthBench Professional’da Mythos 5 %66,0* puan alıyor; Mythos Preview %64,7. Opus 4.8 %56,9, GPT 5.5 %51,8 puanda.
Legal Agent Benchmark’ta Mythos 5 %13,3; Opus 4.8 %10,4; GPT 5.5 ise yalnızca %2,1 puan alıyor. Mutlak puanlar düşük olsa da Mythos 5 ile GPT 5.5 veya Gemini arasındaki fark çarpıcı. Hukuki akıl yürütme, tüm modeller için zorlu bir sınır olmaya devam ediyor.
Claude Mythos 5’in fiyatı milyon başına giriş belirteci için 10 ABD doları ve milyon başına çıkış belirteci için 50 ABD dolarıdır. Bu, Claude Mythos Preview’in (25/125 ABD doları) fiyatının yarısından az; bu da mevcut Glasswing ortakları için yükseltmeyi kolaylaştırıyor. Geliştiriciler modele, model kimliği claude-mythos-5 ile Claude API üzerinden erişebilir.
Erişim şu anda iki grupla sınırlıdır:
Anthropic, zaman içinde her iki programı da genişletmeyi planlıyor.
Daha geniş bir güvenilir erişim programının, ABD Hükümeti ile istişare içinde siber güvenlik kuruluşlarının daha sistematik başvuru yapabilmesi için planlandığı belirtiliyor. Genel erişim için bir zaman çizelgesi açıklanmadı. Çoğu geliştirici için bugün pratik seçenek, aynı temel modele sahip ve standart abonelik ile API planları üzerinden erişilebilen Claude Fable 5.
Dikkate değer bir operasyonel ayrıntı: Anthropic, tüm Mythos sınıfı model trafiği için 30 günlük veri saklama politikası getirdi. Veriler eğitim için kullanılmıyor ve neredeyse tüm durumlarda 30 gün sonra siliniyor; ancak güvenlik izleme amacıyla tutuluyor. Mythos 5 üzerinde hassas verilerle geliştiriyorsanız, canlıya almadan önce bu politikaya ilişkin Anthropic destek dokümantasyonunu inceleyin.
Claude Mythos 5, Anthropic’in sınır yapay zekâyı yüksek riskli profesyonel bağlamlarda kullanıma sunma konusundaki ciddiyetini şimdiye kadarki en net şekilde ortaya koyuyor ve sonuçlar bunu destekliyor.
SWE-bench Pro farkı (%80,3’e karşı %69,2), Terminal-Bench 2.1 farkı (%88,0’a karşı %82,7) ve ExploitBench farkı (%78,0’a karşı %40,0), modelin en zor görevleri mevcut diğer her şeyden daha güvenilir biçimde ele aldığını gösteriyor.
İkili kullanım riskleri göz önüne alındığında sınırlı erişim modeli makul bir yaklaşım ve ExploitBench puanları, en yetkin saldırı güvenliği araçlarının kamuya açık olmaması gerektiğine dair ikna edici bir kanıt sunuyor. Daha zor soru, Anthropic’in güvenilir erişim programını, rakipler farkı kapatmadan önce daha geniş güvenlik ve biyomedikal araştırma topluluklarına fayda sağlayacak kadar hızlı genişletip genişletemeyeceği.
Uygunluk sağlayan kuruluşlar için Mythos Preview’den yükseltme, fiyatın yarısından daha düşük olmasıyla oldukça kolay.
En İyi Yapay Zekâ Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



