Programa
Fundamentos de la IA
10 h
Mythos 5 supone un salto respecto a Mythos Preview en todas las áreas de capacidad que Anthropic ha evaluado. Las mejoras se notan especialmente en trabajo autónomo de largo recorrido, sobre todo en dominios científicos de razonamiento y tareas de visión. Así se traduce en la práctica.
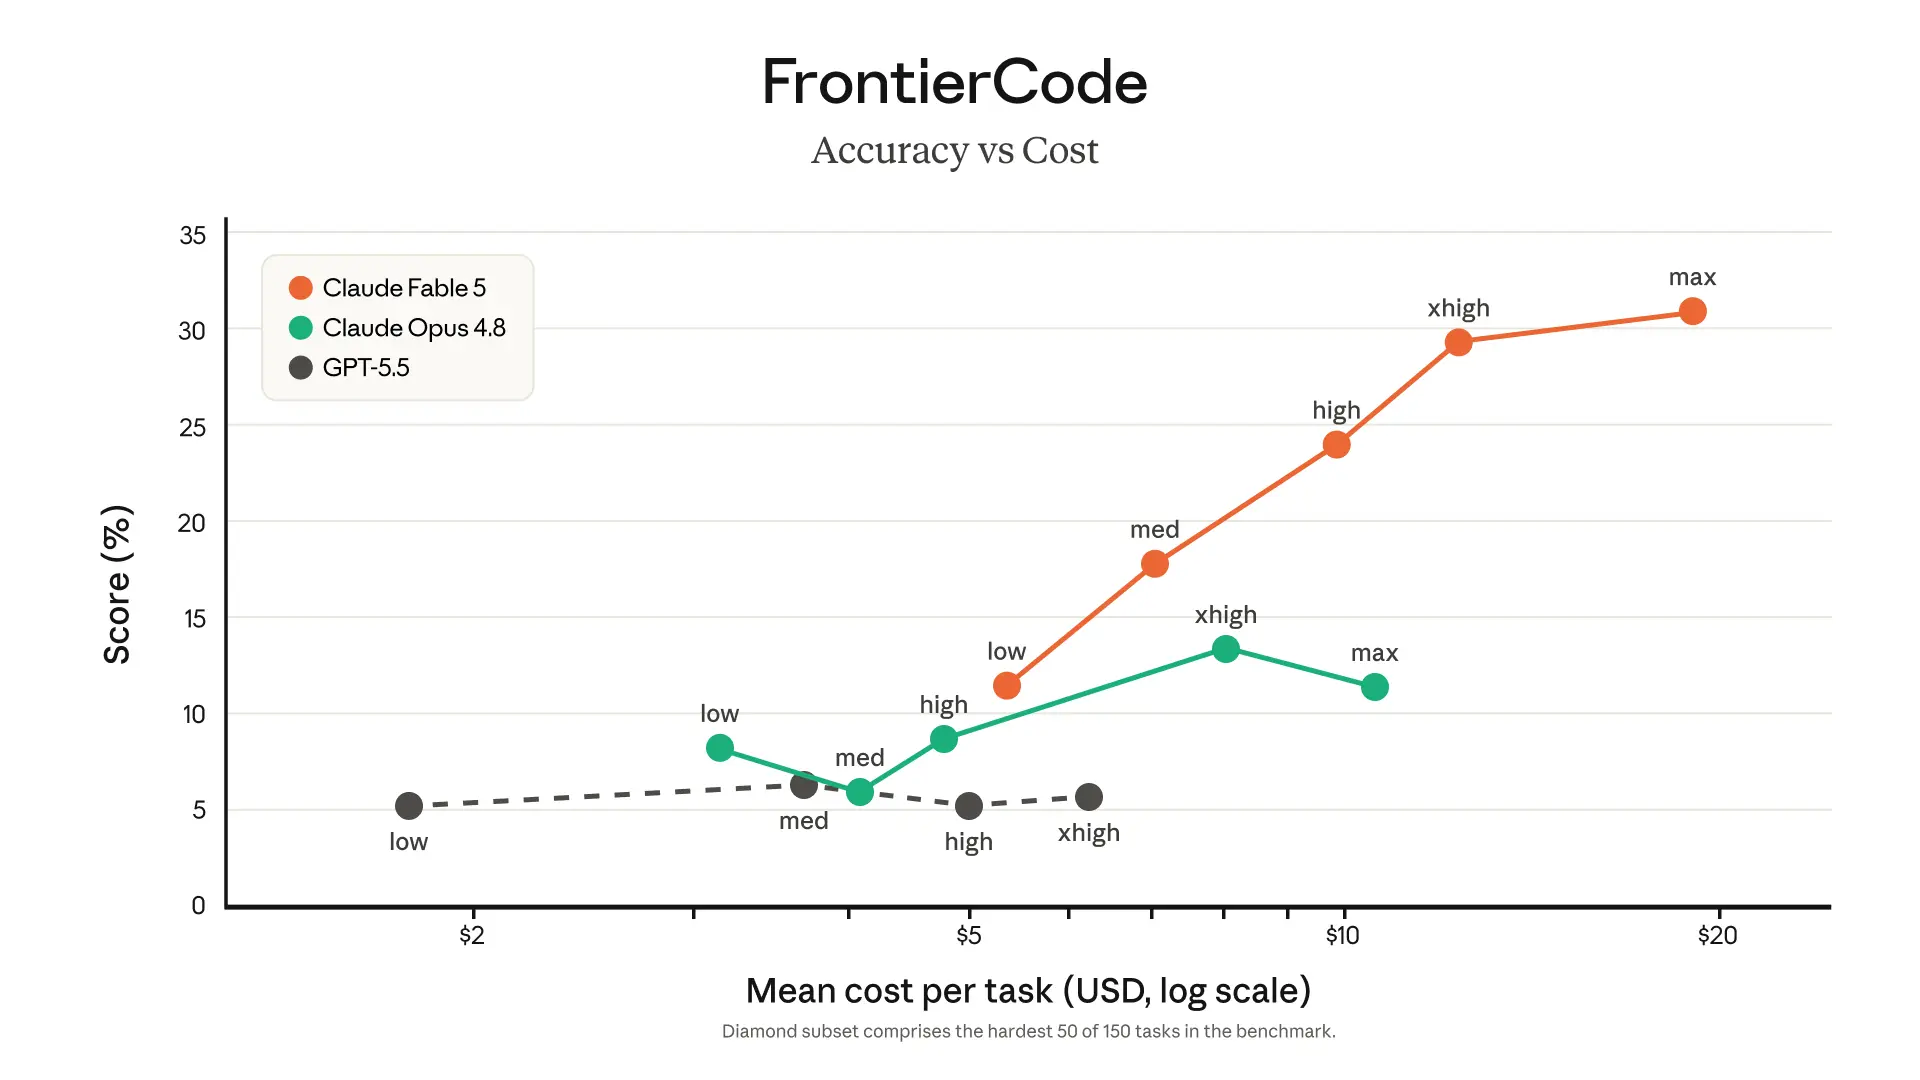
Mythos 5 puede trabajar de forma autónoma sobre grandes bases de código durante más tiempo que cualquier modelo anterior de Claude. Stripe informó de que el modelo comprimió meses de trabajo de ingeniería en días, completando en un solo día una migración a escala de código en una base de 50 millones de líneas en Ruby. En FrontierCode (Diamond), obtiene la mejor puntuación entre los modelos de vanguardia incluso con esfuerzo medio.
Para tareas de seguridad, Mythos 5 amplía las capacidades que hicieron que Mythos Preview fuera valioso para los socios de Project Glasswing. Esos socios usaron Mythos Preview para identificar más de 10.000 fallos de seguridad altos y críticos en sistemas en producción.
El equipo interno de diseño de proteínas de Anthropic utilizó Mythos 5 para acelerar el diseño de fármacos aproximadamente por diez. En una comparación controlada, Mythos 5 igualó o superó a operadores humanos expertos en 14 dianas proteicas a lo largo de toda la canalización:
Nueve arrojaron candidatos sólidos a fármacos que ahora están en investigación.
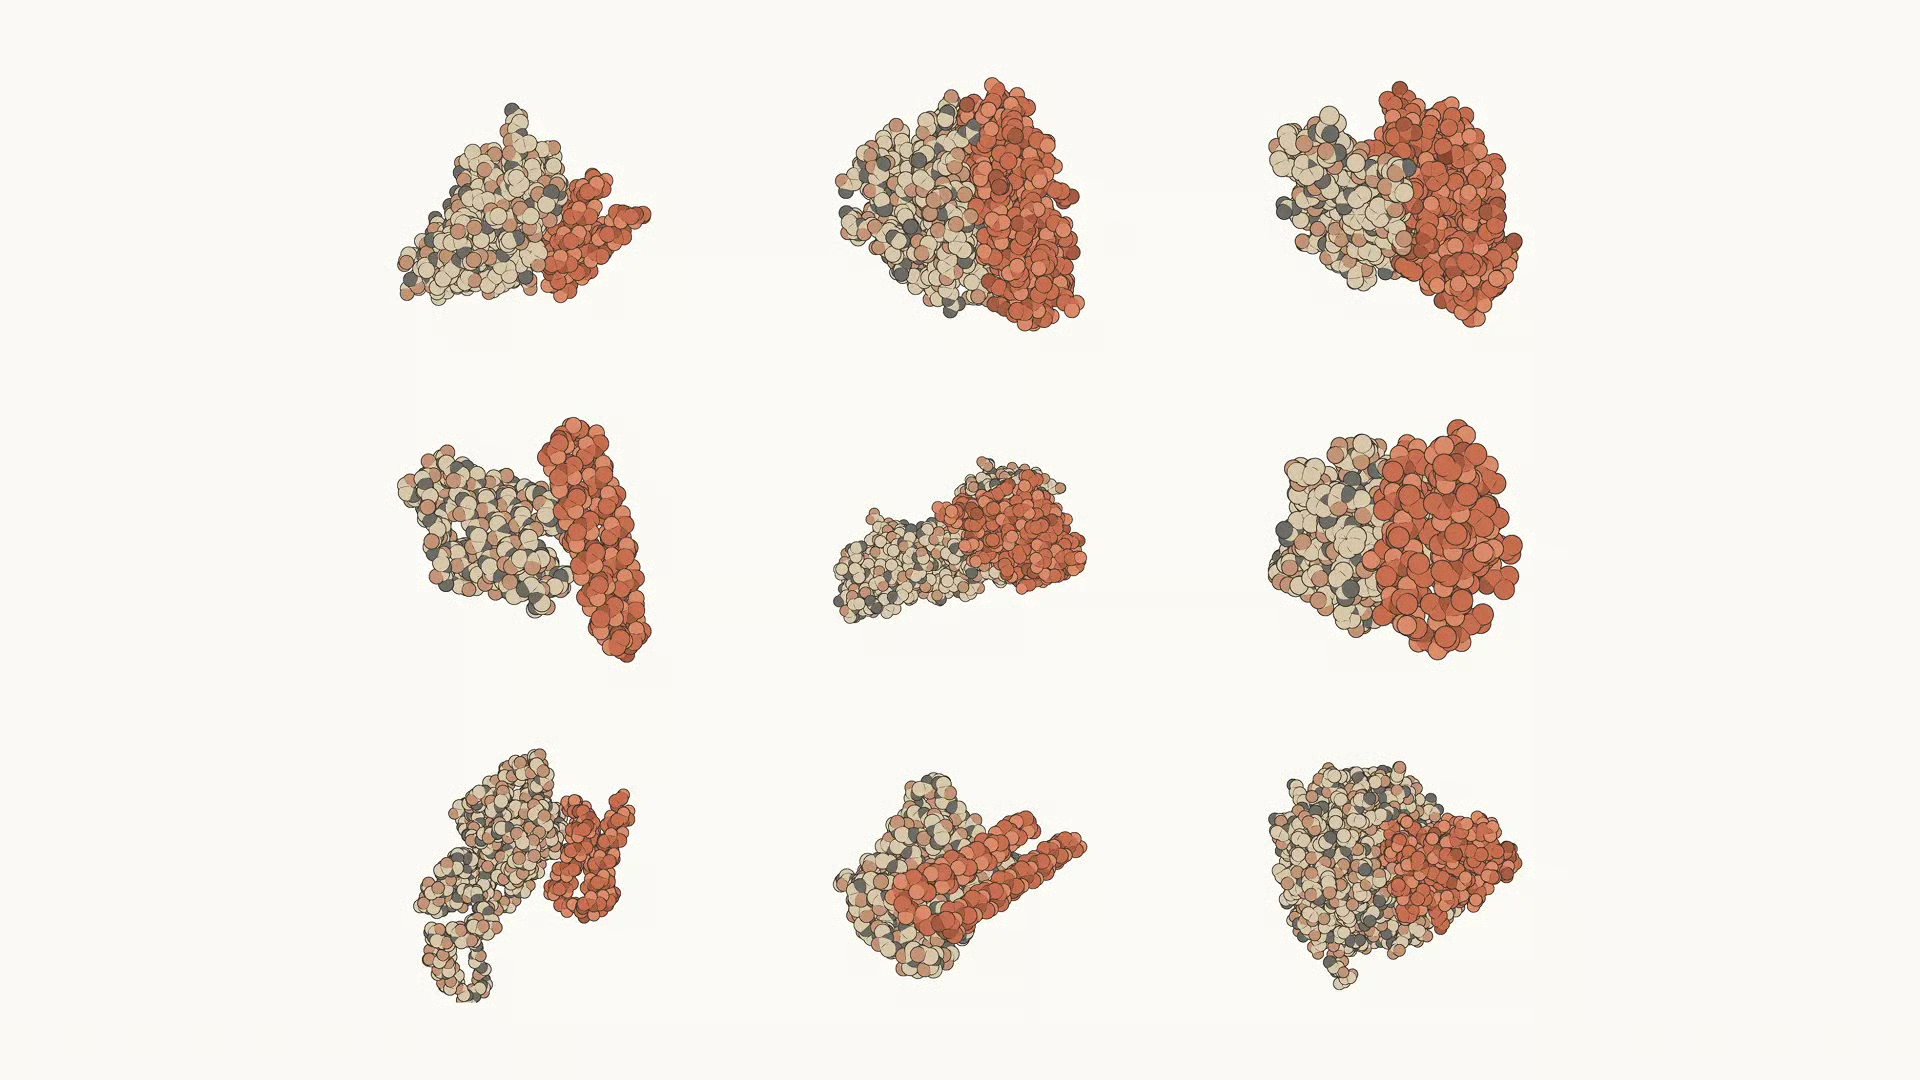
Mythos 5 es el primer modelo de Anthropic que produce de forma consistente hipótesis científicas nuevas en lugar de resumir literatura existente. En comparativas a ciegas, los científicos de Anthropic prefirieron sus hipótesis de biología molecular en torno al 80% de las veces, y varias han pasado a evaluación experimental. Una hipótesis sobre un mecanismo proteico novedoso en E. coli fue corroborada de forma independiente por un laboratorio que trabajaba en el mismo problema.
Mythos 5 llevó a cabo investigación novedosa en genómica durante más de una semana de trabajo mayormente autónomo, ensamblando datos de célula única para millones de células de 138 especies animales y entrenando un modelo de ML a medida para identificar tipos celulares equivalentes en organismos lejanamente emparentados. El modelo entrenado superó a un modelo publicado en Science recientemente a pesar de ser 100 veces más pequeño.
Mythos 5 logra un 93,2% en CharXiv Reasoning con herramientas y puede extraer cifras precisas de gráficos científicos detallados o reconstruir una aplicación web solo a partir de capturas de pantalla. En tareas de contexto largo, darle a Mythos 5 memoria basada en archivos triplicó su rendimiento frente a la misma configuración en Opus 4.8, y llegó al acto final de Slay the Spire tres veces más a menudo.
Mythos 5 lidera o empata en casi todos los benchmarks evaluados por Anthropic, con mejoras sobre Opus 4.8 consistentes en categorías diversas y no concentradas en un único ámbito. La tabla comparativa lo enfrenta a Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 y Gemini 3.1 Pro.
| Categoría | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Programación agente | SWE-Bench Pro | 80,3% | 77,8% | 69,2% | 58,6% | 54,2% |
| Programación agente | FrontierCode (Diamond) | 29,3% (xhigh) | — | 13,4% (xhigh) | 5,7% (xhigh) | — |
| Trabajo de conocimiento | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Trabajo de conocimiento con visión | GDP.pdf | 29,8% (sin herramientas) | — | 22,5% (sin herramientas) | 24,9% (sin herramientas) | 16,7% (sin herramientas) |
| Razonamiento espacial | Blueprint-Bench 2 | 38,6% | — | 14,5% | 36,2% | 26,5% |
| Uso de herramientas | AutomationBench | 17,4% | — | 15,5% | 12,9% | 9,6% |
| Uso de ordenador | OSWorld-Verified | 85,0% | 85,4% | 83,4% | 78,7% | 76,2% |
| Legal | Legal Agent Benchmark | 13,3% | — | 10,4% | 2,1% | 0,0% |
| Razonamiento multidisciplinar | Humanity's Last Exam (sin herramientas) | 59,0%* | 56,8% | 49,8% | 41,4% | 44,4% |
| Razonamiento multidisciplinar | Humanity's Last Exam (con herramientas) | 64,5%* | 64,7% | 57,9% | 52,2% | 51,4% |
| Biología | BioMysteryBench (difícil) | 46,1%* | 29,6% | 40,0% | — | — |
| Biología | BioMysteryBench (resuelto por humanos) | 83,9%* | 82,6% | 80,4% | — | — |
| Programación agente | Terminal-Bench 2.1 | 88,0%* | — | 82,7% | 83,4% (Codex CLI) | 70,7% (Gemini CLI) |
| Ciberseguridad | ExploitBench (Cap%) | 78,0%* | 69,0% | 40,0% | 34,0% | — |
| Salud | HealthBench Professional | 66,0%* | 64,7% | 56,9% | 51,8% | — |
Anthropic informa conjuntamente las puntuaciones de Mythos 5 y Fable 5, señalando que suelen diferir entre 1 y 3 puntos porcentuales. Los benchmarks marcados con asterisco (*) muestran una brecha mayor porque los clasificadores de seguridad de Fable 5 redirigen consultas sensibles a Opus 4.8; en esos casos, Fable 5 rinde más cercano a la clase Opus.
En SWE-Bench Pro, Mythos 5 consigue un 80,3%, frente al 77,8% de Mythos Preview, el 69,2% de Opus 4.8, el 58,6% de GPT 5.5 y el 54,2% de Gemini 3.1 Pro. La diferencia de 11 puntos respecto a Opus 4.8 es notable en un benchmark diseñado para evitar fugas de ground truth.
Si medimos la calidad y mantenibilidad del código agente y no solo la finalización de tareas, con FrontierCode (Diamond) la separación es aún mayor. Mythos 5 alcanza el 29,3% en el nivel de esfuerzo xhigh, frente al 13,4% de Opus 4.8 y el 5,7% de GPT 5.5.
Para trabajo en terminal, Mythos 5 devuelve la corona a Anthropic desde OpenAI: obtiene un 88,0%* en Terminal-Bench 2.1, frente al 82,7% de Opus 4.8, el 83,4% de GPT 5.5 (Codex CLI) y el 70,7% de Gemini 3.1 Pro (con Gemini CLI).
GDPval-AA mide el rendimiento en trabajo de conocimiento en una escala numérica. Mythos 5 consigue 1932, frente a 1890 de Opus 4.8, 1769 de GPT 5.5 y 1314 de Gemini 3.1 Pro.
La brecha aumenta en trabajo de conocimiento sobre documentos PDF sin acceso a herramientas. Mythos 5 logra un 29,8% en GDPpdf, frente al 22,5% de Opus 4.8, el 24,9% de GPT 5.5 y el 16,7% de Gemini 3.1 Pro.
Humanity's Last Exam (HLE) evalúa razonamiento a nivel de posgrado en ciencias, matemáticas y humanidades. Mythos 5 logra un 59,0%* sin herramientas y un 64,5%* con herramientas. Mythos Preview obtiene un 56,8% y un 64,7% respectivamente—prácticamente empatados con herramientas pero 2 puntos por detrás sin ellas. La distancia con Opus 4.8 ya es importante (49,8% sin, 57,9% con), y mayor aún con los modelos competidores insignia (GPT 5.5: 41,4% y 52,2%; Gemini 3.1 Pro: 44,4% y 51,4%).
La ventaja de Mythos 5 frente al resto es más clara en la condición sin herramientas, donde supera a Opus 4.8 por más de 9 puntos. Son puntuaciones con asterisco, lo que implica que Fable 5 rinde algo por debajo debido a sus clasificadores de seguridad.
En OSWorld-Verified, que evalúa la capacidad del modelo para completar tareas en una interfaz de ordenador real, Mythos 5 alcanza el 85,0%. Mythos Preview queda ligeramente por delante con un 85,4%, siendo este el único benchmark donde lidera. Opus 4.8 se queda cerca (83,4%), y los competidores algo por detrás: GPT 5.5 con 78,7% y Gemini 3.1 Pro con 76,2%.
AutomationBench mide capacidades de uso de herramientas. Mythos 5 obtiene un 17,4%, frente al 15,5% de Opus 4.8, el 12,9% de GPT 5.5 y el 9,6% de Gemini 3.1 Pro. Las cifras absolutas bajas en todos los casos sugieren que el uso de herramientas sigue siendo un reto para los modelos de vanguardia.
El razonamiento espacial es una de las áreas donde la ventaja de Mythos 5 es mayor. Logra un 38,6% en Blueprint-Bench 2, más del doble que el 14,5% de Opus 4.8. GPT 5.5 se acerca con 36,2% y Gemini 3.1 Pro obtiene 26,5%.
Son las dos áreas que probablemente acapararon más atención en las notas de lanzamiento, y los resultados explican por qué.
ExploitBench mide la fracción de exploits que el modelo puede reproducir con éxito (Cap%). Mythos 5 alcanza un 78,0%*, una mejora significativa incluso respecto a Mythos Preview (69,0%) y un salto enorme frente al 40,0% de Opus 4.8 y el 34,0% de GPT 5.5.
La diferencia de 38 puntos sobre Opus 4.8 es la mayor ventaja en un único benchmark de toda la tabla y explica la existencia de salvaguardas cibernéticas en Fable 5. Los ejercicios de red teaming externos de Anthropic no encontraron jailbreaks universales en tareas agente de formato largo, aunque la AISI del Reino Unido avanzó hacia uno en una ventana inicial de pruebas.
BioMysteryBench evalúa el razonamiento biológico en dos niveles de dificultad. En el subconjunto difícil, Mythos 5 logra un 46,1%*, frente al 29,6% de Mythos Preview y el 40,0% de Opus 4.8. En el subconjunto resuelto por humanos, Mythos 5 consigue 83,9%*, Mythos Preview 82,6% y Opus 4.8 80,4%. GPT 5.5 y Gemini 3.1 Pro no tienen resultados publicados en ninguno de los subconjuntos.
Como en ExploitBench, las puntuaciones de Fable 5 se acercan más a Opus 4.8 debido a sus clasificadores de seguridad relacionados con biología.
Claude Mythos 5 muestra una fortaleza notable en dos ámbitos profesionales de alto riesgo donde la precisión y la calidad del razonamiento tienen consecuencias reales: medicina y derecho.
En HealthBench Professional, Mythos 5 obtiene un 66,0%*, ligeramente por encima del 64,7% de Mythos Preview. Opus 4.8 logra un 56,9% y GPT 5.5 un 51,8%.
En Legal Agent Benchmark, Mythos 5 alcanza un 13,3%, frente al 10,4% de Opus 4.8 y solo el 2,1% de GPT 5.5. Las puntuaciones absolutas son bajas, pero la distancia entre Mythos 5 y GPT 5.5 o Gemini es marcada. El razonamiento jurídico sigue siendo un reto para todos los modelos.
Claude Mythos 5 cuesta 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida. Es menos de la mitad del precio de Claude Mythos Preview (25 $ / 125 $), lo que facilita la actualización para los socios actuales de Glasswing. Los desarrolladores pueden acceder al modelo a través de la API de Claude usando el ID de modelo claude-mythos-5.
El acceso está restringido actualmente a dos grupos:
Anthropic prevé expandir ambos programas con el tiempo.
Se está preparando un programa de acceso de confianza más amplio para que las organizaciones de ciberseguridad puedan solicitarlo de forma más sistemática, en consulta con el Gobierno de EE. UU. Anthropic no ha anunciado un calendario para la disponibilidad general. Para la mayoría de desarrolladores, Claude Fable 5 es hoy la opción práctica, con el mismo modelo subyacente y acceso mediante suscripción estándar y planes de API.
Un detalle operativo a tener en cuenta: Anthropic ha introducido una política de retención de datos de 30 días para todo el tráfico de modelos de clase Mythos. Los datos no se usan para entrenamiento y se eliminan tras 30 días en casi todos los casos, pero se conservan para monitorización de seguridad. Si vas a construir con Mythos 5 sobre datos sensibles, revisa la documentación de soporte de Anthropic sobre esta política antes de desplegar.
Claude Mythos 5 es la declaración más clara de Anthropic de que va en serio con el despliegue de IA de vanguardia en contextos profesionales de alto impacto, y los resultados lo respaldan.
La brecha en SWE-bench Pro (80,3% vs 69,2%), en Terminal-Bench 2.1 (88,0% vs 82,7%) y en ExploitBench (78,0% vs 40,0%) apunta a un modelo que resuelve las tareas más difíciles con más fiabilidad que cualquier otra alternativa disponible.
El acceso restringido es razonable dadas las posibilidades de doble uso, y las puntuaciones en ExploitBench justifican que las herramientas ofensivas más potentes no estén disponibles públicamente. La gran incógnita es si Anthropic podrá ampliar el programa de acceso de confianza con la rapidez necesaria para resultar útil a la comunidad más amplia de seguridad e investigación biomédica antes de que los competidores recorten distancias.
Para las organizaciones que cumplan los requisitos, la actualización desde Mythos Preview es directa y cuesta menos de la mitad.
Los mejores cursos de IA
Programa
Curso
Curso
blog
Ryan Ong
8 min
blog
Abid Ali Awan
10 min
blog
Josep Ferrer
8 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
12 min
Tutorial
Moez Ali
11 min