Cursus
Principes fondamentaux de l'IA
10 h
S'entraîner et cursus vos progrès.
Continuer Avec GoogleMythos 5 marque une progression par rapport à Mythos Preview sur toutes les grandes capacités testées par Anthropic. Les gains sont particulièrement visibles sur les travaux autonomes de longue haleine, notamment pour le raisonnement scientifique et les tâches de vision. Voici ce que cela donne concrètement.
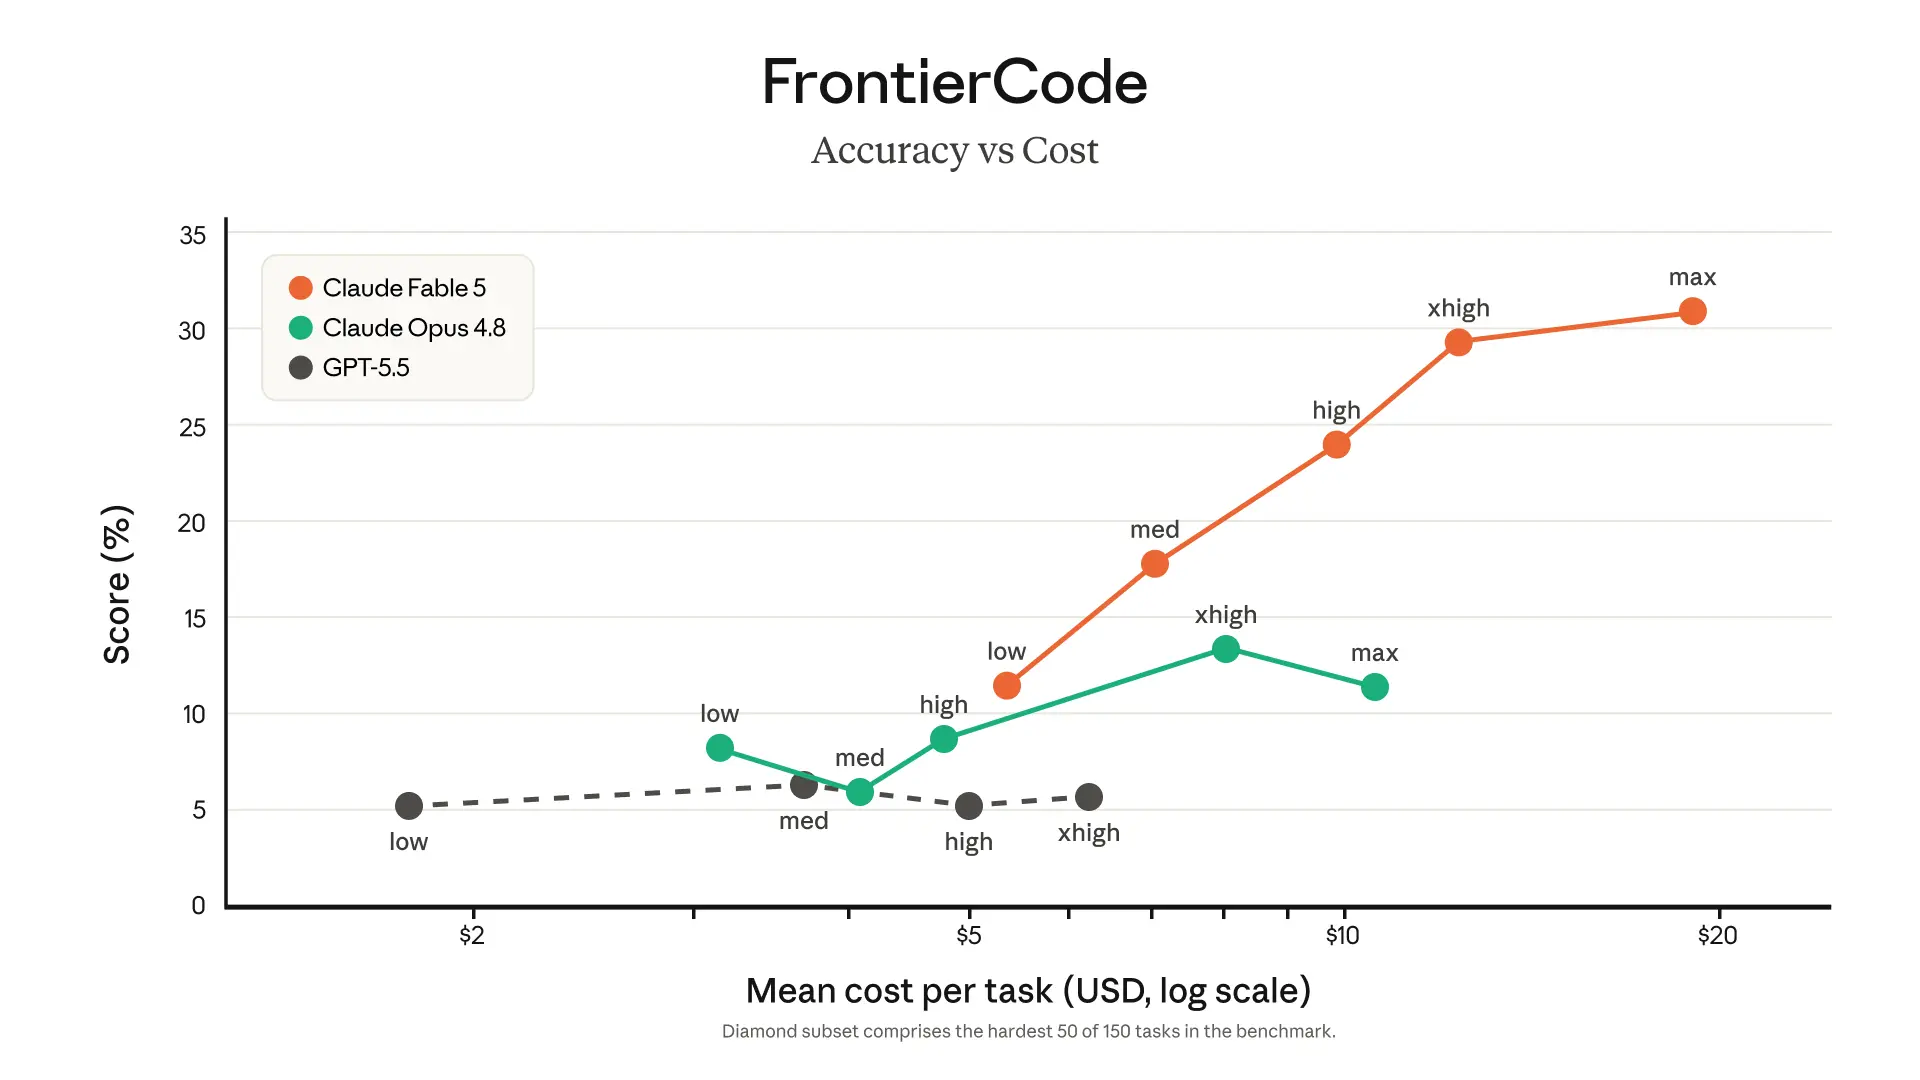
Mythos 5 peut travailler de manière autonome sur de vastes bases de code plus longtemps que tout autre modèle Claude. Stripe a indiqué que le modèle a compressé des mois de travail d’ingénierie en quelques jours, en menant une migration à l’échelle d’un code Ruby de 50 millions de lignes en une seule journée. Sur FrontierCode (Diamond), il obtient les meilleurs scores parmi les modèles de pointe, même à effort moyen.
Pour les missions de sécurité, Mythos 5 étend les capacités qui avaient fait la valeur de Mythos Preview pour les partenaires de Project Glasswing. Ces partenaires ont utilisé Mythos Preview pour identifier plus de 10 000 vulnérabilités majeures et critiques sur des systèmes en production.
L’équipe interne de conception de protéines d’Anthropic a utilisé Mythos 5 pour accélérer la conception de médicaments par un facteur d’environ dix. Dans une comparaison contrôlée, Mythos 5 a égalé ou surpassé des opérateurs humains expérimentés sur 14 cibles protéiques pour l’ensemble du pipeline :
Neuf ont produit des candidats médicaments prometteurs actuellement à l’étude.
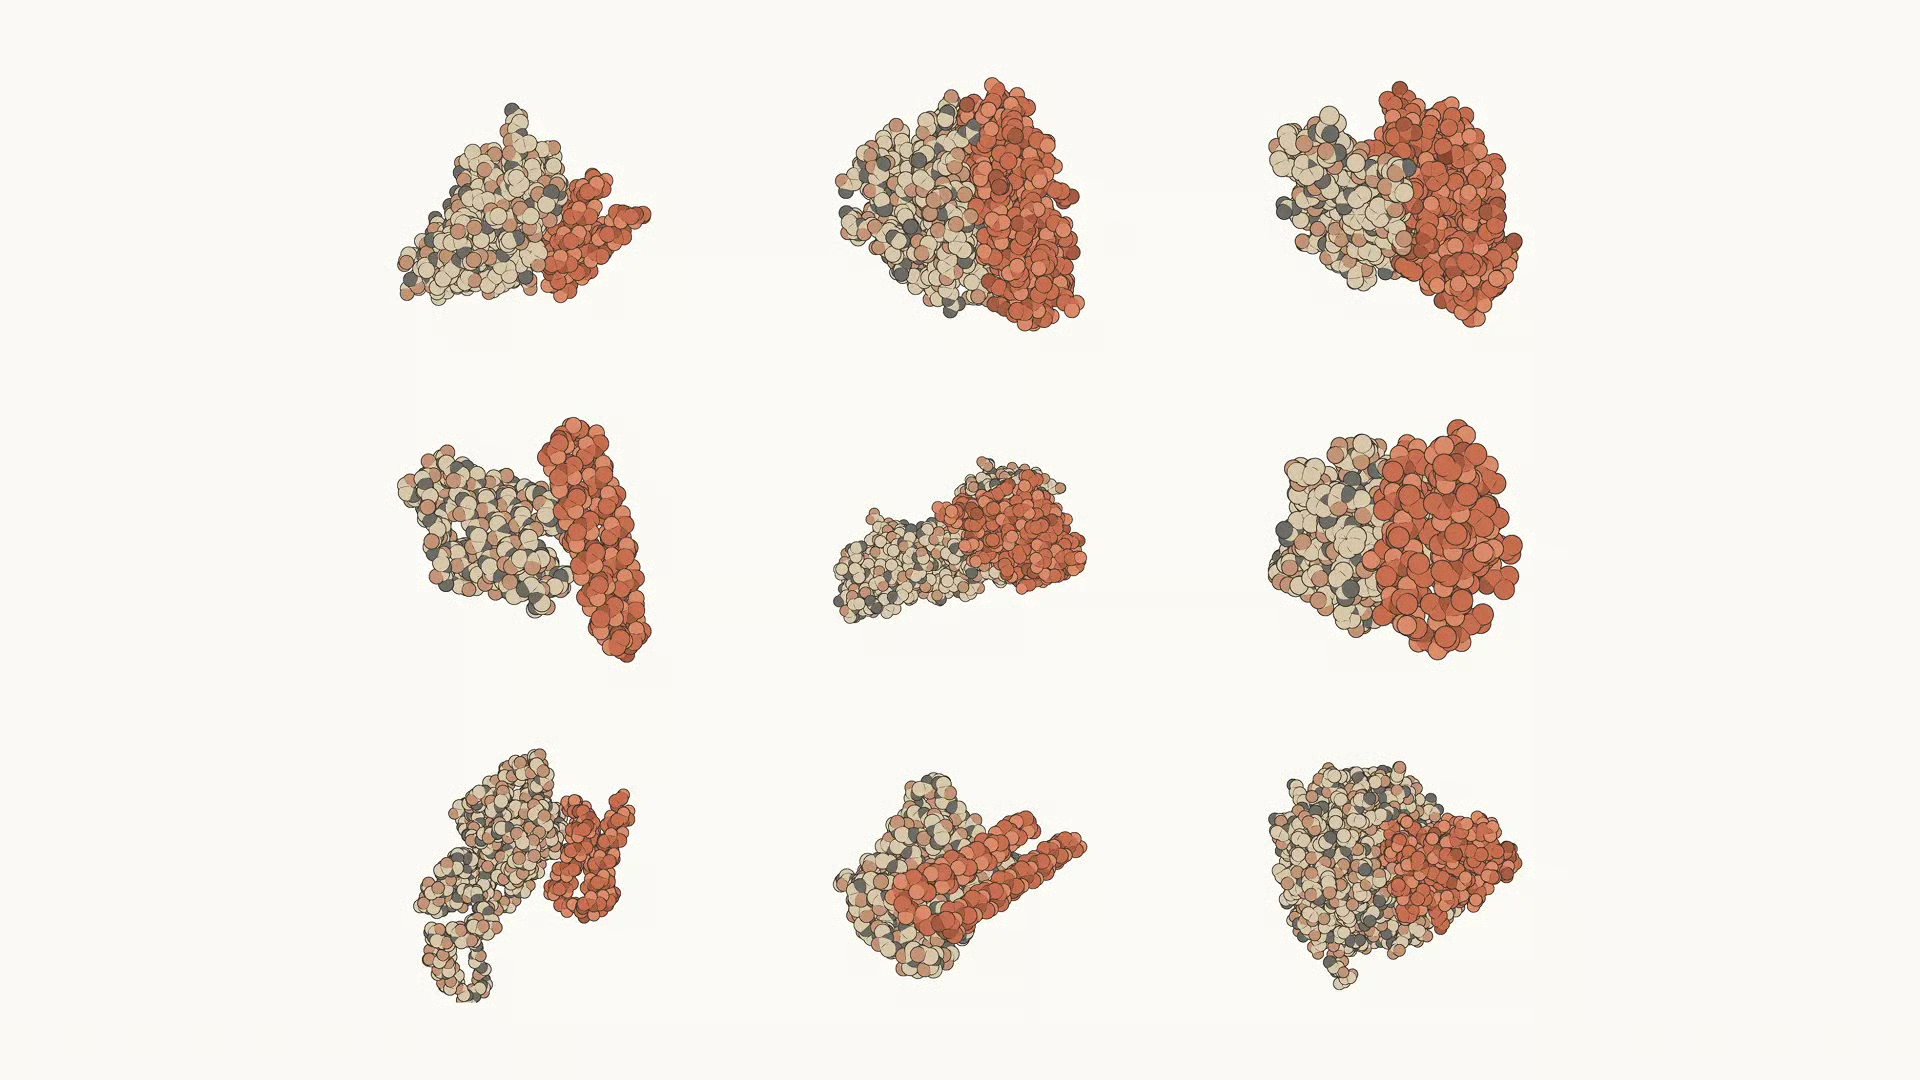
Mythos 5 est le premier modèle d’Anthropic à produire régulièrement des hypothèses scientifiques originales, et non de simples synthèses de la littérature. Lors de comparaisons en aveugle, les scientifiques d’Anthropic ont préféré ses hypothèses en biologie moléculaire dans environ 80 % des cas, et plusieurs ont été avancées à l’évaluation expérimentale. Une hypothèse concernant un nouveau mécanisme protéique chez E. coli a été corroborée indépendamment par un laboratoire travaillant sur le même sujet.
Mythos 5 a mené une recherche génomique inédite pendant plus d’une semaine de travail largement autonome, en assemblant des données monocellulaires pour des millions de cellules sur 138 espèces animales et en entraînant un modèle de ML personnalisé pour identifier des types cellulaires équivalents chez des organismes éloignés. Le modèle entraîné a surpassé un modèle récemment publié dans Science tout en étant 100 fois plus petit.
Mythos 5 atteint 93,2 % sur CharXiv Reasoning avec outils et peut extraire des chiffres précis à partir de figures scientifiques détaillées ou reconstruire une application web à partir de simples captures d’écran. Sur les tâches à long contexte, l’ajout d’une mémoire basée sur des fichiers a triplé son gain de performance par rapport à une configuration identique avec Opus 4.8, et il a atteint l’acte final de Slay the Spire trois fois plus souvent.
Mythos 5 mène ou égalise sur quasiment tous les benchmarks testés par Anthropic, avec des gains sur Opus 4.8 cohérents entre catégories plutôt que concentrés sur un seul domaine. Le tableau comparatif l’oppose à Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 et Gemini 3.1 Pro.
| Catégorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Code agentique | SWE-Bench Pro | 80,3 % | 77,8 % | 69,2 % | 58,6 % | 54,2 % |
| Code agentique | FrontierCode (Diamond) | 29,3 % (xhigh) | — | 13,4 % (xhigh) | 5,7 % (xhigh) | — |
| Travail de connaissance | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Travail de connaissance vision | GDP.pdf | 29,8 % (sans outils) | — | 22,5 % (sans outils) | 24,9 % (sans outils) | 16,7 % (sans outils) |
| Raisonnement spatial | Blueprint-Bench 2 | 38,6 % | — | 14,5 % | 36,2 % | 26,5 % |
| Utilisation d’outils | AutomationBench | 17,4 % | — | 15,5 % | 12,9 % | 9,6 % |
| Utilisation de l’ordinateur | OSWorld-Verified | 85,0 % | 85,4 % | 83,4 % | 78,7 % | 76,2 % |
| Légal | Legal Agent Benchmark | 13,3 % | — | 10,4 % | 2,1 % | 0,0 % |
| Raisonnement pluridisciplinaire | Humanity's Last Exam (sans outils) | 59,0 %* | 56,8 % | 49,8 % | 41,4 % | 44,4 % |
| Raisonnement pluridisciplinaire | Humanity's Last Exam (avec outils) | 64,5 %* | 64,7 % | 57,9 % | 52,2 % | 51,4 % |
| Biologie | BioMysteryBench (difficile) | 46,1 %* | 29,6 % | 40,0 % | — | — |
| Biologie | BioMysteryBench (résolu par l’humain) | 83,9 %* | 82,6 % | 80,4 % | — | — |
| Code agentique | Terminal-Bench 2.1 | 88,0 %* | — | 82,7 % | 83,4 % (Codex CLI) | 70,7 % (Gemini CLI) |
| Cybersécurité | ExploitBench (Cap%) | 78,0 %* | 69,0 % | 40,0 % | 34,0 % | — |
| Santé | HealthBench Professional | 66,0 %* | 64,7 % | 56,9 % | 51,8 % | — |
Anthropic annonce des scores communs pour Mythos 5 et Fable 5, en précisant qu’ils varient généralement de 1 à 3 points. Les benchmarks marqués d’un astérisque (*) affichent un écart plus important, car les classifieurs de sécurité de Fable 5 redirigent les requêtes sensibles vers Opus 4.8 ; sur ces benchmarks, Fable 5 se rapproche des performances de la classe Opus.
Sur SWE-Bench Pro, Mythos 5 atteint 80,3 %, contre 77,8 % pour Mythos Preview, 69,2 % pour Opus 4.8, 58,6 % pour GPT 5.5 et 54,2 % pour Gemini 3.1 Pro. L’écart de 11 points avec Opus 4.8 est significatif sur un benchmark conçu pour éviter les fuites de vérité terrain.
Pour la qualité et la maintenabilité du code agentique, mesurées par FrontierCode (Diamond), l’écart est encore plus marqué. Mythos 5 obtient 29,3 % au niveau d’effort xhigh, contre 13,4 % pour Opus 4.8 et 5,7 % pour GPT 5.5.
Pour le travail en terminal, Mythos 5 redonne l’avantage à Anthropic face à OpenAI : Mythos 5 obtient 88,0 %* sur Terminal-Bench 2.1, contre 82,7 % pour Opus 4.8, 83,4 % pour GPT 5.5 (Codex CLI) et 70,7 % pour Gemini 3.1 Pro (avec Gemini CLI).
GDPval-AA évalue le travail de connaissance sur une échelle numérique. Mythos 5 obtient 1932, contre 1890 pour Opus 4.8, 1769 pour GPT 5.5 et 1314 pour Gemini 3.1 Pro.
L’écart s’accentue pour le travail de connaissance sur PDF sans accès aux outils. Mythos 5 atteint 29,8 % sur GDPpdf, contre 22,5 % pour Opus 4.8, 24,9 % pour GPT 5.5 et 16,7 % pour Gemini 3.1 Pro.
Humanity's Last Exam (HLE) teste un raisonnement de niveau master en sciences, mathématiques et sciences humaines. Mythos 5 obtient 59,0 %* sans outils et 64,5 %* avec outils. Mythos Preview atteint respectivement 56,8 % et 64,7 % — pratiquement à égalité avec outils mais à 2 points derrière sans outils. L’écart avec Opus 4.8 est déjà marqué (49,8 % sans, 57,9 % avec), et encore plus avec les modèles phares concurrents (GPT 5.5 : 41,4 % et 52,2 %, Gemini 3.1 Pro : 44,4 % et 51,4 %).
L’avantage de Mythos 5 apparaît le plus nettement sans outils, où il devance Opus 4.8 de plus de 9 points. Ces scores sont étoilés, ce qui signifie que Fable 5 performe un peu moins en raison de ses classifieurs de sécurité.
Sur OSWorld-Verified, qui évalue la capacité du modèle à réaliser des tâches sur une véritable interface ordinateur, Mythos 5 atteint 85,0 %. Mythos Preview le devance légèrement à 85,4 %, ce qui en fait le seul benchmark où Mythos Preview est en tête. Opus 4.8 suit de près (83,4 %), tandis que les concurrents décrochent : GPT 5.5 à 78,7 % et Gemini 3.1 Pro à 76,2 %.
AutomationBench mesure l’aptitude à utiliser des outils. Mythos 5 atteint 17,4 %, contre 15,5 % pour Opus 4.8, 12,9 % pour GPT 5.5 et 9,6 % pour Gemini 3.1 Pro. Les valeurs absolues faibles suggèrent que l’orchestration d’outils demeure un défi pour tous les modèles de pointe.
Le raisonnement spatial est un domaine où l’avance de Mythos 5 est la plus nette. Il obtient 38,6 % sur Blueprint-Bench 2, soit plus du double des 14,5 % d’Opus 4.8. GPT 5.5 est plus proche à 36,2 %, et Gemini 3.1 Pro atteint 26,5 %.
Ce sont sans doute les deux domaines les plus mis en avant dans les notes de version, et les résultats l’expliquent.
ExploitBench mesure la fraction d’exploits que le modèle peut reproduire avec succès (Cap%). Mythos 5 atteint 78,0 %*, une progression notable par rapport à Mythos Preview (69,0 %) et un bond spectaculaire face à Opus 4.8 (40,0 %) et GPT 5.5 (34,0 %).
L’écart de 38 points avec Opus 4.8 est le plus important du tableau comparatif, et il justifie l’existence de garde-fous cyber pour Fable 5. Les tests d’intrusion externes d’Anthropic n’ont trouvé aucun jailbreak universel sur des tâches agentiques longues, même si l’UK AISI a progressé vers l’un d’eux lors d’une première fenêtre de test.
BioMysteryBench évalue le raisonnement biologique à deux niveaux de difficulté. Sur le sous-ensemble difficile, Mythos 5 obtient 46,1 %*, contre 29,6 % pour Mythos Preview et 40,0 % pour Opus 4.8. Sur le sous-ensemble « résolu par l’humain », Mythos 5 atteint 83,9 %*, Mythos Preview 82,6 % et Opus 4.8 80,4 %. GPT 5.5 et Gemini 3.1 Pro n’affichent pas de scores rapportés sur ces sous-ensembles.
Comme pour ExploitBench, les scores de Fable 5 se rapprochent d’Opus 4.8 en raison de ses classifieurs de sécurité liés à la biologie.
Claude Mythos 5 montre une solidité notable dans deux domaines professionnels à forts enjeux, où la précision et la qualité du raisonnement ont des conséquences concrètes : la médecine et le droit.
Sur HealthBench Professional, Mythos 5 obtient 66,0 %*, un peu au-dessus des 64,7 % de Mythos Preview. Opus 4.8 atteint 56,9 % et GPT 5.5 51,8 %.
Sur le Legal Agent Benchmark, Mythos 5 atteint 13,3 %, contre 10,4 % pour Opus 4.8 et seulement 2,1 % pour GPT 5.5. Les scores absolus restent faibles, mais l’écart avec GPT 5.5 et Gemini est marqué. Le raisonnement juridique demeure un défi pour tous les modèles.
Claude Mythos 5 est facturé 10 $ par million de tokens en entrée et 50 $ par million de tokens en sortie. C’est moins de la moitié du prix de Claude Mythos Preview (25 $/125 $), ce qui facilite la mise à niveau pour les partenaires Glasswing existants. Les développeurs peuvent accéder au modèle via l’API Claude avec l’identifiant claude-mythos-5.
L’accès est actuellement limité à deux groupes :
Anthropic prévoit d’étendre ces deux programmes au fil du temps.
Un programme d’accès de confiance plus large est envisagé pour permettre aux organisations de cybersécurité de candidater de manière plus systématique, en concertation avec le gouvernement américain. Anthropic n’a pas communiqué de calendrier pour une disponibilité générale. Pour la plupart des développeurs, Claude Fable 5 est aujourd’hui l’option la plus pratique, avec le même modèle sous-jacent et un accès via les abonnements et l’API standard.
Un point opérationnel à noter : Anthropic a instauré une politique de rétention des données de 30 jours pour tout le trafic des modèles de classe Mythos. Les données ne sont pas utilisées pour l’entraînement et sont supprimées au bout de 30 jours dans quasiment tous les cas, mais elles sont conservées à des fins de sécurité. Si vous développez avec Mythos 5 sur des données sensibles, consultez la documentation d’assistance d’Anthropic sur cette politique avant le déploiement.
Claude Mythos 5 est, à ce jour, la preuve la plus claire qu’Anthropic entend déployer une IA de pointe dans des contextes professionnels à forts enjeux, et les résultats le confirment.
L’écart sur SWE-bench Pro (80,3 % vs 69,2 %), sur Terminal-Bench 2.1 (88,0 % vs 82,7 %) et sur ExploitBench (78,0 % vs 40,0 %) pointe vers un modèle qui gère les tâches les plus difficiles de manière plus fiable que toute alternative disponible.
Le modèle d’accès restreint est une approche raisonnable au vu des risques de double usage, et les scores ExploitBench plaident pour que les outils offensifs les plus puissants ne soient pas accessibles au grand public. La vraie question est de savoir si Anthropic pourra étendre suffisamment vite le programme d’accès de confiance pour servir la communauté sécurité et biomédicale plus large, avant que les concurrents ne comblent l’écart.
Pour les organisations éligibles, la mise à niveau depuis Mythos Preview est simple et à moins de la moitié du prix.
Meilleures formations IA
Cursus
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Nathaniel Taylor-Leach
8 min
Tutoriel
Tutoriel
Josef Waples
8 min