Yakın zamanda bir yapay zekâ şirketiyle olan sözleşmemi tamamladım. Diğer şeylerin yanı sıra, araştırmacıların LLM’leri sonradan eğitmesine yardımcı oluyorlar. Bir matematik doktora mezunu olarak, sınırdaki yapay zekâ modellerini zorlayan matematik yönergeleri (prompt) hazırladım. Kurnazlık içeren yönergeler sayılmıyordu; yönergelerin akıl yürütme hatalarını açığa çıkarması gerekiyordu.
Bu çalışma sırasında, "İnsanlığın Son Sınavı"na yapılan tekrar tekrar atıflar duydum. Bunun, birçok akademik alanda akıl yürütmeyi test etmek için tasarlanmış bir yapay zekâ kıyaslaması olduğunu öğrendim. Merakım beni HLE’nin ne olduğuna ve bize yapay zekânın akıl yürütme konusundaki mevcut sınırları hakkında ne söylediğine daha derinlemesine bakmaya yöneltti.
Yapay zekâ ve kıyaslamalara yeniyseniz, AI Fundamentals yetkinlik yolunu öneririm.
“İnsanlığın Son Sınavı” Nedir?
LLM’ler ilerledikçe, araştırmacılar performansı karşılaştırmak ve ilerlemeyi takip etmek için kıyaslamalar olarak bilinen değerlendirme soru koleksiyonlarına güveniyor. Humanity's Last Exam (HLE), bir LLM’nin sadece örüntü eşleştirme becerisini değil, akıl yürütme yeteneklerini ölçmek için tasarlanmış bir kıyaslamadır. Bir modelin pek çok akademik alanda uzman düzeyindeki sorunlarla ne kadar iyi başa çıktığını değerlendirmeyi amaçlar.
Neden “Son Sınav”a İhtiyacımız Var?
Zaten pek çok kıyaslama varken, neden bir yenisi daha? MMLU gibi bir zamanlar LLM’leri zorlayan kıyaslamalar artık doygunluk noktasında ve modeller sıklıkla yüzde 90’ın üzerinde puan alıyor. Bu noktada, bu kıyaslamalar modeller arasındaki anlamlı farkları ölçmeyi bırakıyor.
HLE, yalnızca yüzeysel örüntü eşleştirmeyi hatırlamayı değil, çok adımlı akıl yürütmeyi gerektiren uzman yapımı soruları bir araya getirerek zorluk düzeyini artıran yeni nesil bir kıyaslamadır.
HLE Nasıl Geliştirildi?
2024’ün sonlarında, yapay zekâ güvenliği alanında faaliyet gösteren kar amacı gütmeyen Centre for AI Safety, veri şirketi Scale AI ile daha zorlu bir yapay zekâ kıyaslaması geliştirmek için ortaklık kurdu. Projeye Dan Hendrycks liderlik etti.
Ekip, birden fazla akademik disiplinden yüksek lisans düzeyinde soruları kitlesel kaynakla topladı ve önemli ödüller sundu: En iyi 50 katkıda bulunanın her biri 5000 $ kazandı, sonraki 500 kişi ise 500 $ aldı.
Sonuç; matematik, bilgisayar bilimi, edebiyat, müzik analizi ve tarih gibi birçok konuda uzman düzeyinde geniş bir soru havuzu oldu.
Humanity's Last Exam Neleri İçeriyor?
HLE makalesi kıyaslamayı "...geniş akademik beceriler için son kapalı uçlu kıyaslama" olarak tanımlar. Soruları, modellerin tahminde bulunmasını veya yanıtları ezberlemesini engelleyen çok adımlı akıl yürütme gerektirir.
HLE, 2.500 herkese açık soru ve özel bir yedekte yaklaşık 500 ek sorudan oluşur.
Her soru özgün olmalı, tek bir doğru cevaba sahip olmalı ve basit bir web araması veya veritabanı sorgusuyla bulunmaya dayanıklı olmalıdır. Soruların yaklaşık %76’sı birebir eşleşen cevap formatını, kalan %24’ü çoktan seçmeli formatı kullanır. Soruların yaklaşık %14’ü hem metin hem görsel içeren çok modludur.
HLE ekibi sorular için sıkı bir değerlendirme süreci uyguladı.
- Kabul edilmek için soruların bir sınır LLM’sini şaşırtması gerekiyordu. Yaklaşık yetmiş bin soru bu ölçütü karşıladı.
- Uzman hakemler toplamı on üç bin soruya kadar iyileştirip süzdü.
- Düzenleyiciler ve uzman hakemler bu sorulardan altı binini manuel olarak onayladı.
- Araştırmacılar bu soru havuzunu 2.500 soruluk bir herkese açık set ve yaklaşık 500 soruluk bir yedek set olarak ikiye ayırdı.
Humanity’s Last Exam’e Yönelik Eleştiriler
Erken sonuçlar, sınır modellerin sorularda başlangıçta düşük puan aldığını ancak yüksek güven ifade ettiğini gösterdi. Bu fark, halüsinasyonlara işaret ediyor.
Bağımsız gruplar da endişelerini dile getirdi. Future House adlı kar amacı gütmeyen araştırma laboratuvarı, "İnsanlığın Son Sınavı’ndaki kimya/biyoloji yanıtlarının yaklaşık %30’u muhtemelen yanlış" başlıklı bir blog yayımladı.
Analizleri, inceleme protokolüne odaklandı. Soru yazarları doğru cevapları beyan etti, ancak hakemlere cevap doğruluğunu incelemek için yalnızca beş dakika harcamaları talimatı verildi. Bu sürecin, bilimsel literatürle sıklıkla çelişen aşırı karmaşık, yapay veya muğlak cevapların aradan sıyrılmasına izin verdiğini savunuyorlar.
HLE’nin bakımını üstlenenler, tartışmalı alt küme için üç uzmanlı bir inceleme görevlendirerek gönderiye yanıt verdi. 16 Eylül 2025 itibarıyla, HLE için kademeli bir inceleme süreci duyurmayı planlıyorlardı.
Yapay Zekâ Kıyaslamaları Manzarası
HLE, LLM yeteneğinin farklı yönlerini test eden daha geniş bir kıyaslama ekosistemi içinde yer alır.
Bilgi ve akıl yürütme
Bu kıyaslamalar akademik bilgi ve akıl yürütmeyi değerlendirir.
- Massive Multitask Language Understanding (MMLU). MMLU, elli yedi farklı konuda sıfır atış (zero-shot) performansı test eder.
- MMLU-Pro/MMLU Pro+. Artırılmış soru karmaşıklığı ve daha üst düzey akıl yürütmeye odaklanma.
- Google Proof Q&A (GPQA). Google’a karşı dayanıklı, yüksek lisans düzeyi STEM kıyaslaması; 448 çoktan seçmeli soru içerir.
- Humanity's Last Exam (HLE). HLE, hatırlamadan ziyade akıl yürütmeyi vurgulayan uzman düzeyinde seçilmiş problemler kullanır.
Çok modlu anlama
Bu kıyaslamalar hem metin hem görsel içeren akıl yürütmeyi ölçer.
- Massive Multi-discipline Multimodal Understanding and Reasoning (MMMU). Sınavlar, kısa sınavlar ve ders kitaplarından derlenen yaklaşık 1.500 çok modlu, çok disiplinli soru.
- MMMU-Pro kıyaslaması, yalnızca metinle çözülebilen soruları kaldırır, yanıt seçeneklerini daha sağlam hale getirir ve tüm yönergenin bir görsel içine gömülü olduğu yalnızca görsel ayarı tanıtır.
Yazılım mühendisliği ve araç kullanımı
Diğer bazı kıyaslamalar ise özellikle yazılım mühendisliği ve araç kullanımına odaklanır.
- SWE-bench. On iki Python deposundan gerçek GitHub sorunlarından oluşturuldu. Model kod tabanını okur, sorunun açıklamasını yorumlar ve bir yama önerir.
- SWE-bench Verified. Aşırı spesifik testleri düzelten, muğlak sorun açıklamalarını netleştiren ve ortam kurulumunu stabilize eden geliştirilmiş SWE-bench sürümü.
- SWE-bench-Live. 93 depoda 1319 göreve sahip, ölçeklenebilir ve sürekli güncellenen bir sürüm.
Bütüncül, çok ölçütlü değerlendirme çerçeveleri
Stanford Foundation Models Research Center (CRFM), sorumlu yapay zekâ değerlendirmesini desteklemek için Holistic Evaluation of Language Models (HELM) geliştirdi.
HELM, modelleri soru yanıtlama, özetleme, güvenlik açısından kritik sorgular ve sosyal/etik içerik gibi standartlaştırılmış bir dizi senaryoda değerlendirir. Bu senaryolar yalnızca doğruluk açısından değil; kalibrasyon, sağlamlık ve toksisite gibi birden çok boyutta puanlanır.
HELM, ilgili çerçevelerden oluşan bir aileye dönüştü.
- HELM Capabilities. LM’leri değerlendirmek için genel amaçlı bir liderlik tablosu.
- Audio. Ses ve konuşma ile ilgili görevler için değerlendirmeler.
- HELM Lite. Hızlı karşılaştırmalar için daha küçük ve hızlı bir alt küme.
- HELM Finance. Finansal görevlere uyarlanmış HELM.
- MedHELM. Sağlıkla ilgili akıl yürütme ve güvenlik değerlendirmeleri.
Güvenlik ve tehlikeli yetenek değerlendirmeleri
Güvenlik çerçeveleri entelektüel yetkinlikten ziyade riski ölçer.
- Model Evaluation & Threat Research (METR), siber saldırılar, kapatılmayı önleme girişimleri veya yapay zekâ Ar-Ge’sini otomatikleştirme yeteneği gibi potansiyel olarak tehlikeli yetenekleri değerlendiren, kar amacı gütmeyen bir araştırma kuruluşudur. Misyonu, felaket risklerini erken tespit etmektir.
- Google DeepMind'ın Frontier Safety Framework’ü. Kritik yetenek seviyelerini (CCL) tanımlar, sınır modellerin bu seviyelere yaklaşıp yaklaşmadığını izler ve yaklaştıklarında azaltım planlarını uygular.
Güncel Yapay Zekâ Modelleri Kıyaslamalarda Kaç Puan Alıyor?
Birçok herkese açık liderlik tablosu, LLM performansını çeşitli ölçütler üzerinden takip eder.
Liderlik tabloları
Bu yazının yazıldığı Aralık 2025 itibarıyla bazı puanlar aşağıdadır.
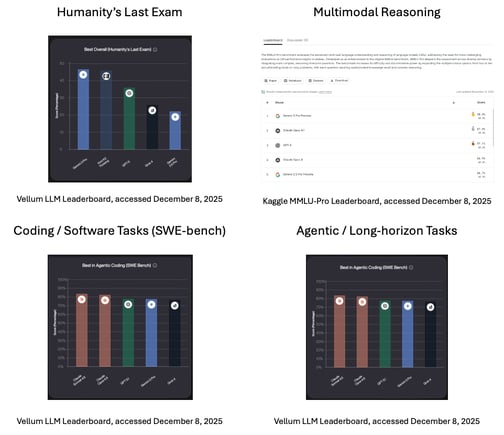
- Humanity's Last Exam. Vellum liderlik tablosuna göre, şu anki lider (bu yazı itibarıyla) Google’ın amiral gemisi üretken çok modlu yapay zekâ modeli Gemini 3 Pro.
- Çok Modlu Akıl Yürütme. Tek bir sistemde kipleri birleştirmek üzere tasarlanan Gemini 3 Pro, Kaggle MMLU-Pro liderlik tablosuna göre çok modlu akıl yürütmede lider konumda.
- Kodlama / Yazılım Görevleri (SWE-bench). Dikkatli akıl yürütmeyi önceleyen Anthropic’in Claude Sonnet 4.5 modeli, Vellum liderlik tablosuna göre kodlama ve gerçek dünya yazılım görevlerinde ilk sırada yer alıyor.
- Aracısal / Uzun Ufuklu Görevler. Vellum liderlik tablosuna göre Claude Sonnet 4.5, aracısal ve uzun ufuklu görevlerde de lider.
Güvenlik/tehlikeli yetenekler
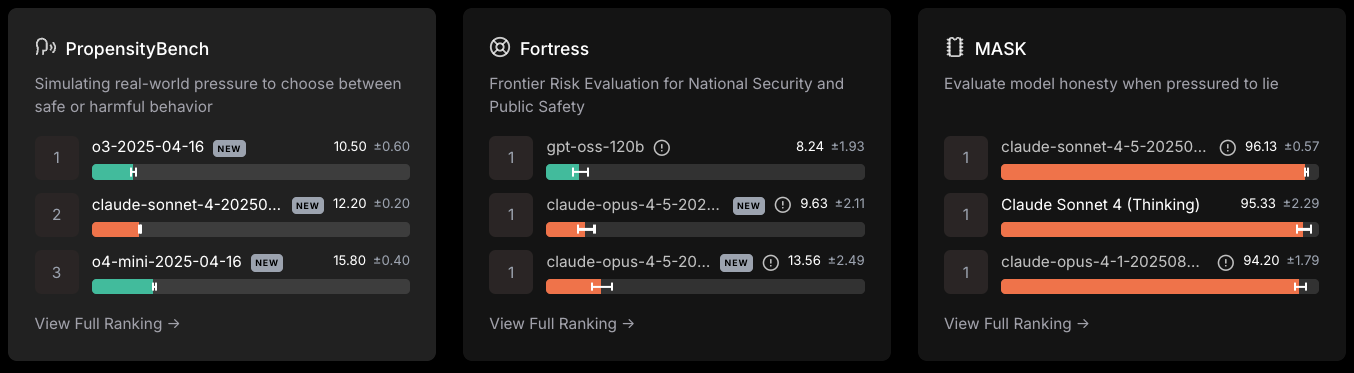
Scale LLM Safety Leaderboard, erişim tarihi: 8 Aralık 2025
- OpenAI’nin o3-2024-04-18 modeli, güvenli veya zararlı davranış arasında seçim yapma eğilimini ölçen PropensityBench’te liderdi.
- GPT-oss-120b liderdi; Ulusal Güvenlik ve Kamu Güvenliği için Sınır Risk Değerlendirmesi’nde.
- Claude Sonnet-4.5 yalan söyleme baskısına en çok direnen model oldu.
Humanity’s Last Exam Nasıl Kullanılıyor
Şimdiye kadar HLE’nin ne olduğunu ve nasıl geliştirildiğini özetledim. Şimdi de testin pratikte nasıl kullanıldığına bakalım.
Araştırma ekipleri için
HLE, alanlar arasında standartlaştırılmış bir değerlendirme yöntemi sunar. Bir modelin güçlü ve zayıf yönlerini öne çıkarır. Model ile insan uzman performansı arasındaki farkı ortaya koyar. Ekipler bu örüntüleri model geliştirme ve odaklı sonradan eğitim için kullanabilir.
Politika yapıcılar için
HLE, yapay zekâ akıl yürütmesindeki ilerlemenin kamuya açık, küresel bir ölçütünü sağlar. Ülkeler ve düzenleyici kurumlar arasında ortak bir referans noktası oluşturur ve eşikler, denetim ve yönetişimle ilgili tartışmaları abartıdan değil, gerçeklikten hareketle temellendirebilir.
Sonuç
Yapay zekâ kıyaslamaları, yapay zekâ ilerlemesini nasıl ölçtüğümüzü şekillendirir. Önceki kıyaslamalar doygunluğa ulaştıkça, yalnızca hatırlamaya veya örüntü eşleştirmeye değil, akıl yürütmeye odaklanan yeni bir kıyaslamaya ihtiyaç duyulduğu ortaya çıktı.
Humanity's Last Exam, dünya çapındaki uzmanlardan yüksek lisans düzeyinde soruları kitlesel kaynakla toplayarak LLM’lerin sınırlılıklarını açığa çıkarmaya çalışır. Son söz değildir, ancak yapay zekânın bugün insan uzman akıl yürütmesine kıyasla nerede durduğunu netleştirir.
LLM’ler ve nasıl çalıştıkları hakkında daha fazla bilgi için aşağıdaki kaynakları öneririm:





Yakın zamanda bir yapay zekâ şirketiyle olan sözleşmemi tamamladım. Diğer şeylerin yanı sıra, araştırmacıların LLM’leri sonradan eğitmesine yardımcı oluyorlar. Bir matematik doktora mezunu olarak, sınırdaki yapay zekâ modellerini zorlayan matematik yönergeleri (prompt) hazırladım. Kurnazlık içeren yönergeler sayılmıyordu; yönergelerin akıl yürütme hatalarını açığa çıkarması gerekiyordu.
Bu çalışma sırasında, "İnsanlığın Son Sınavı"na yapılan tekrar tekrar atıflar duydum. Bunun, birçok akademik alanda akıl yürütmeyi test etmek için tasarlanmış bir yapay zekâ kıyaslaması olduğunu öğrendim. Merakım beni HLE’nin ne olduğuna ve bize yapay zekânın akıl yürütme konusundaki mevcut sınırları hakkında ne söylediğine daha derinlemesine bakmaya yöneltti.
Yapay zekâ ve kıyaslamalara yeniyseniz, AI Fundamentals yetkinlik yolunu öneririm.
“İnsanlığın Son Sınavı” Nedir?
LLM’ler ilerledikçe, araştırmacılar performansı karşılaştırmak ve ilerlemeyi takip etmek için kıyaslamalar olarak bilinen değerlendirme soru koleksiyonlarına güveniyor. Humanity's Last Exam (HLE), bir LLM’nin sadece örüntü eşleştirme becerisini değil, akıl yürütme yeteneklerini ölçmek için tasarlanmış bir kıyaslamadır. Bir modelin pek çok akademik alanda uzman düzeyindeki sorunlarla ne kadar iyi başa çıktığını değerlendirmeyi amaçlar.
Neden “Son Sınav”a İhtiyacımız Var?
Zaten pek çok kıyaslama varken, neden bir yenisi daha? MMLU gibi bir zamanlar LLM’leri zorlayan kıyaslamalar artık doygunluk noktasında ve modeller sıklıkla yüzde 90’ın üzerinde puan alıyor. Bu noktada, bu kıyaslamalar modeller arasındaki anlamlı farkları ölçmeyi bırakıyor.
HLE, yalnızca yüzeysel örüntü eşleştirmeyi hatırlamayı değil, çok adımlı akıl yürütmeyi gerektiren uzman yapımı soruları bir araya getirerek zorluk düzeyini artıran yeni nesil bir kıyaslamadır.
HLE Nasıl Geliştirildi?
2024’ün sonlarında, yapay zekâ güvenliği alanında faaliyet gösteren kar amacı gütmeyen Centre for AI Safety, veri şirketi Scale AI ile daha zorlu bir yapay zekâ kıyaslaması geliştirmek için ortaklık kurdu. Projeye Dan Hendrycks liderlik etti.
Ekip, birden fazla akademik disiplinden yüksek lisans düzeyinde soruları kitlesel kaynakla topladı ve önemli ödüller sundu: En iyi 50 katkıda bulunanın her biri 5000 $ kazandı, sonraki 500 kişi ise 500 $ aldı.
Sonuç; matematik, bilgisayar bilimi, edebiyat, müzik analizi ve tarih gibi birçok konuda uzman düzeyinde geniş bir soru havuzu oldu.
Humanity's Last Exam Neleri İçeriyor?
HLE makalesi kıyaslamayı "...geniş akademik beceriler için son kapalı uçlu kıyaslama" olarak tanımlar. Soruları, modellerin tahminde bulunmasını veya yanıtları ezberlemesini engelleyen çok adımlı akıl yürütme gerektirir.
HLE, 2.500 herkese açık soru ve özel bir yedekte yaklaşık 500 ek sorudan oluşur.
Her soru özgün olmalı, tek bir doğru cevaba sahip olmalı ve basit bir web araması veya veritabanı sorgusuyla bulunmaya dayanıklı olmalıdır. Soruların yaklaşık %76’sı birebir eşleşen cevap formatını, kalan %24’ü çoktan seçmeli formatı kullanır. Soruların yaklaşık %14’ü hem metin hem görsel içeren çok modludur.
HLE ekibi sorular için sıkı bir değerlendirme süreci uyguladı.
Humanity’s Last Exam’e Yönelik Eleştiriler
Erken sonuçlar, sınır modellerin sorularda başlangıçta düşük puan aldığını ancak yüksek güven ifade ettiğini gösterdi. Bu fark, halüsinasyonlara işaret ediyor.
Bağımsız gruplar da endişelerini dile getirdi. Future House adlı kar amacı gütmeyen araştırma laboratuvarı, "İnsanlığın Son Sınavı’ndaki kimya/biyoloji yanıtlarının yaklaşık %30’u muhtemelen yanlış" başlıklı bir blog yayımladı.
Analizleri, inceleme protokolüne odaklandı. Soru yazarları doğru cevapları beyan etti, ancak hakemlere cevap doğruluğunu incelemek için yalnızca beş dakika harcamaları talimatı verildi. Bu sürecin, bilimsel literatürle sıklıkla çelişen aşırı karmaşık, yapay veya muğlak cevapların aradan sıyrılmasına izin verdiğini savunuyorlar.
HLE’nin bakımını üstlenenler, tartışmalı alt küme için üç uzmanlı bir inceleme görevlendirerek gönderiye yanıt verdi. 16 Eylül 2025 itibarıyla, HLE için kademeli bir inceleme süreci duyurmayı planlıyorlardı.
Yapay Zekâ Kıyaslamaları Manzarası
HLE, LLM yeteneğinin farklı yönlerini test eden daha geniş bir kıyaslama ekosistemi içinde yer alır.
Bilgi ve akıl yürütme
Bu kıyaslamalar akademik bilgi ve akıl yürütmeyi değerlendirir.
Çok modlu anlama
Bu kıyaslamalar hem metin hem görsel içeren akıl yürütmeyi ölçer.
Yazılım mühendisliği ve araç kullanımı
Diğer bazı kıyaslamalar ise özellikle yazılım mühendisliği ve araç kullanımına odaklanır.
Bütüncül, çok ölçütlü değerlendirme çerçeveleri
Stanford Foundation Models Research Center (CRFM), sorumlu yapay zekâ değerlendirmesini desteklemek için Holistic Evaluation of Language Models (HELM) geliştirdi.
HELM, modelleri soru yanıtlama, özetleme, güvenlik açısından kritik sorgular ve sosyal/etik içerik gibi standartlaştırılmış bir dizi senaryoda değerlendirir. Bu senaryolar yalnızca doğruluk açısından değil; kalibrasyon, sağlamlık ve toksisite gibi birden çok boyutta puanlanır.
HELM, ilgili çerçevelerden oluşan bir aileye dönüştü.
Güvenlik ve tehlikeli yetenek değerlendirmeleri
Güvenlik çerçeveleri entelektüel yetkinlikten ziyade riski ölçer.
Güncel Yapay Zekâ Modelleri Kıyaslamalarda Kaç Puan Alıyor?
Birçok herkese açık liderlik tablosu, LLM performansını çeşitli ölçütler üzerinden takip eder.
Liderlik tabloları
Bu yazının yazıldığı Aralık 2025 itibarıyla bazı puanlar aşağıdadır.
Güvenlik/tehlikeli yetenekler
Scale LLM Safety Leaderboard, erişim tarihi: 8 Aralık 2025
Humanity’s Last Exam Nasıl Kullanılıyor
Şimdiye kadar HLE’nin ne olduğunu ve nasıl geliştirildiğini özetledim. Şimdi de testin pratikte nasıl kullanıldığına bakalım.
Araştırma ekipleri için
HLE, alanlar arasında standartlaştırılmış bir değerlendirme yöntemi sunar. Bir modelin güçlü ve zayıf yönlerini öne çıkarır. Model ile insan uzman performansı arasındaki farkı ortaya koyar. Ekipler bu örüntüleri model geliştirme ve odaklı sonradan eğitim için kullanabilir.
Politika yapıcılar için
HLE, yapay zekâ akıl yürütmesindeki ilerlemenin kamuya açık, küresel bir ölçütünü sağlar. Ülkeler ve düzenleyici kurumlar arasında ortak bir referans noktası oluşturur ve eşikler, denetim ve yönetişimle ilgili tartışmaları abartıdan değil, gerçeklikten hareketle temellendirebilir.
Sonuç
Yapay zekâ kıyaslamaları, yapay zekâ ilerlemesini nasıl ölçtüğümüzü şekillendirir. Önceki kıyaslamalar doygunluğa ulaştıkça, yalnızca hatırlamaya veya örüntü eşleştirmeye değil, akıl yürütmeye odaklanan yeni bir kıyaslamaya ihtiyaç duyulduğu ortaya çıktı.
Humanity's Last Exam, dünya çapındaki uzmanlardan yüksek lisans düzeyinde soruları kitlesel kaynakla toplayarak LLM’lerin sınırlılıklarını açığa çıkarmaya çalışır. Son söz değildir, ancak yapay zekânın bugün insan uzman akıl yürütmesine kıyasla nerede durduğunu netleştirir.
LLM’ler ve nasıl çalıştıkları hakkında daha fazla bilgi için aşağıdaki kaynakları öneririm: