

लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंAnthropic द्वारा परीक्षण की गई हर प्रमुख क्षमता में Mythos 5, Mythos Preview से एक कदम आगे है। सबसे बड़े लाभ लंबे-क्षितिज वाले स्वायत्त कार्यों में दिखते हैं, खासकर वैज्ञानिक तर्क और विज़न टास्क के वैज्ञानिक डोमेनों में। व्यावहारिक रूप में यह कुछ यूँ दिखता है।
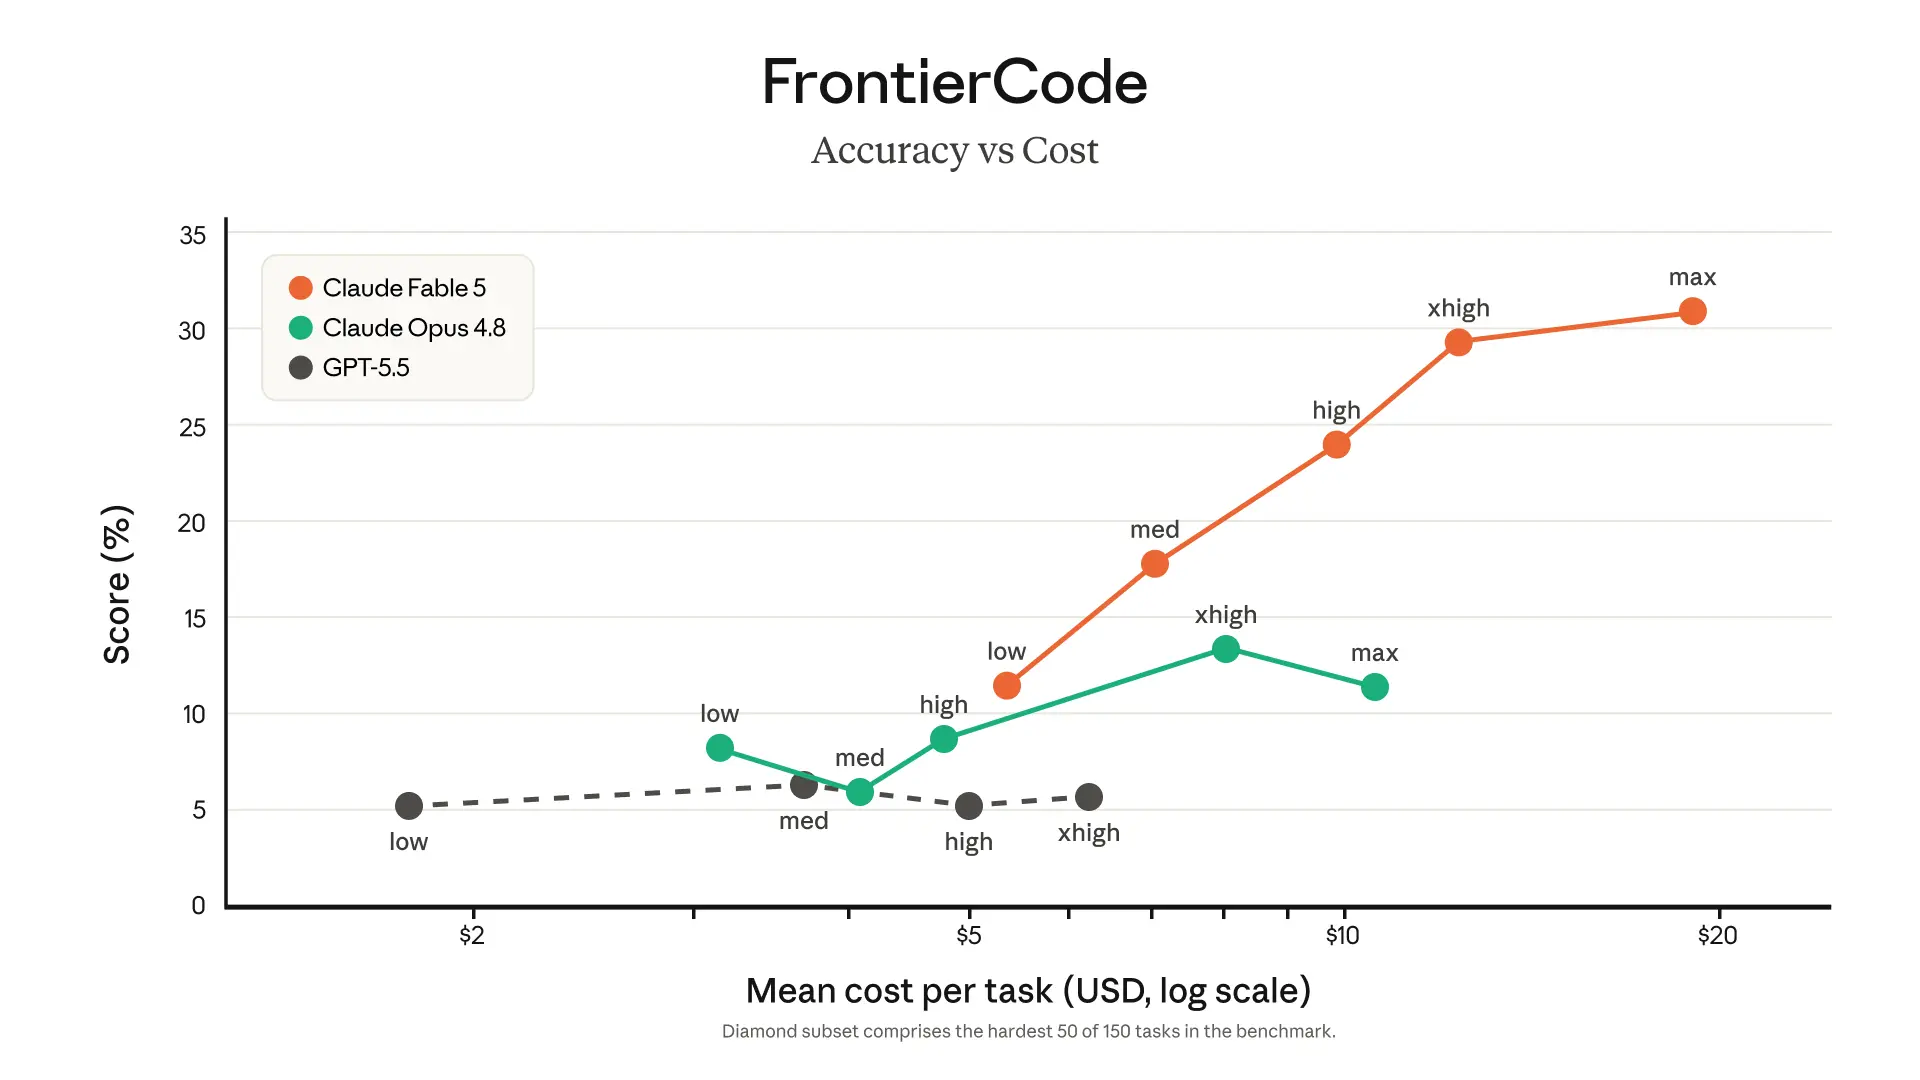
Mythos 5 किसी भी पूर्व Claude मॉडल की तुलना में बड़े कोडबेस पर अधिक देर तक स्वायत्त रूप से काम कर सकता है। Stripe ने रिपोर्ट किया कि मॉडल ने महीनों के इंजीनियरिंग कार्य को दिनों में समेट दिया, और 5 करोड़-लाइनों वाले Ruby कोडबेस में एक दिन में कोडबेस-वाइड माइग्रेशन पूरा किया। FrontierCode (Diamond) पर, यह मध्यम प्रयास पर भी फ्रंटियर मॉडलों में सबसे ऊपर स्कोर करता है।
सुरक्षा कार्य के लिए, Mythos 5 ने वे क्षमताएँ और आगे बढ़ाईं जिनसे Mythos Preview Project Glasswing भागीदारों के लिए मूल्यवान साबित हुआ था। उन भागीदारों ने Mythos Preview का उपयोग कर प्रोडक्शन सिस्टम्स में 10,000 से अधिक उच्च और क्रिटिकल सुरक्षा खामियाँ पहचानीं।
Anthropic की आंतरिक प्रोटीन डिज़ाइन टीम ने Mythos 5 की मदद से दवा डिज़ाइन की गति लगभग दस गुना बढ़ाई। एक नियंत्रित तुलना में, Mythos 5 ने 14 प्रोटीन लक्ष्यों पर पूरी पाइपलाइन में कुशल मानव ऑपरेटरों की बराबरी की या उन्हें पीछे छोड़ा:
इनमें से नौ ने मज़बूत दवा डिज़ाइन उम्मीदवार दिए हैं जिनकी जाँच चल रही है।
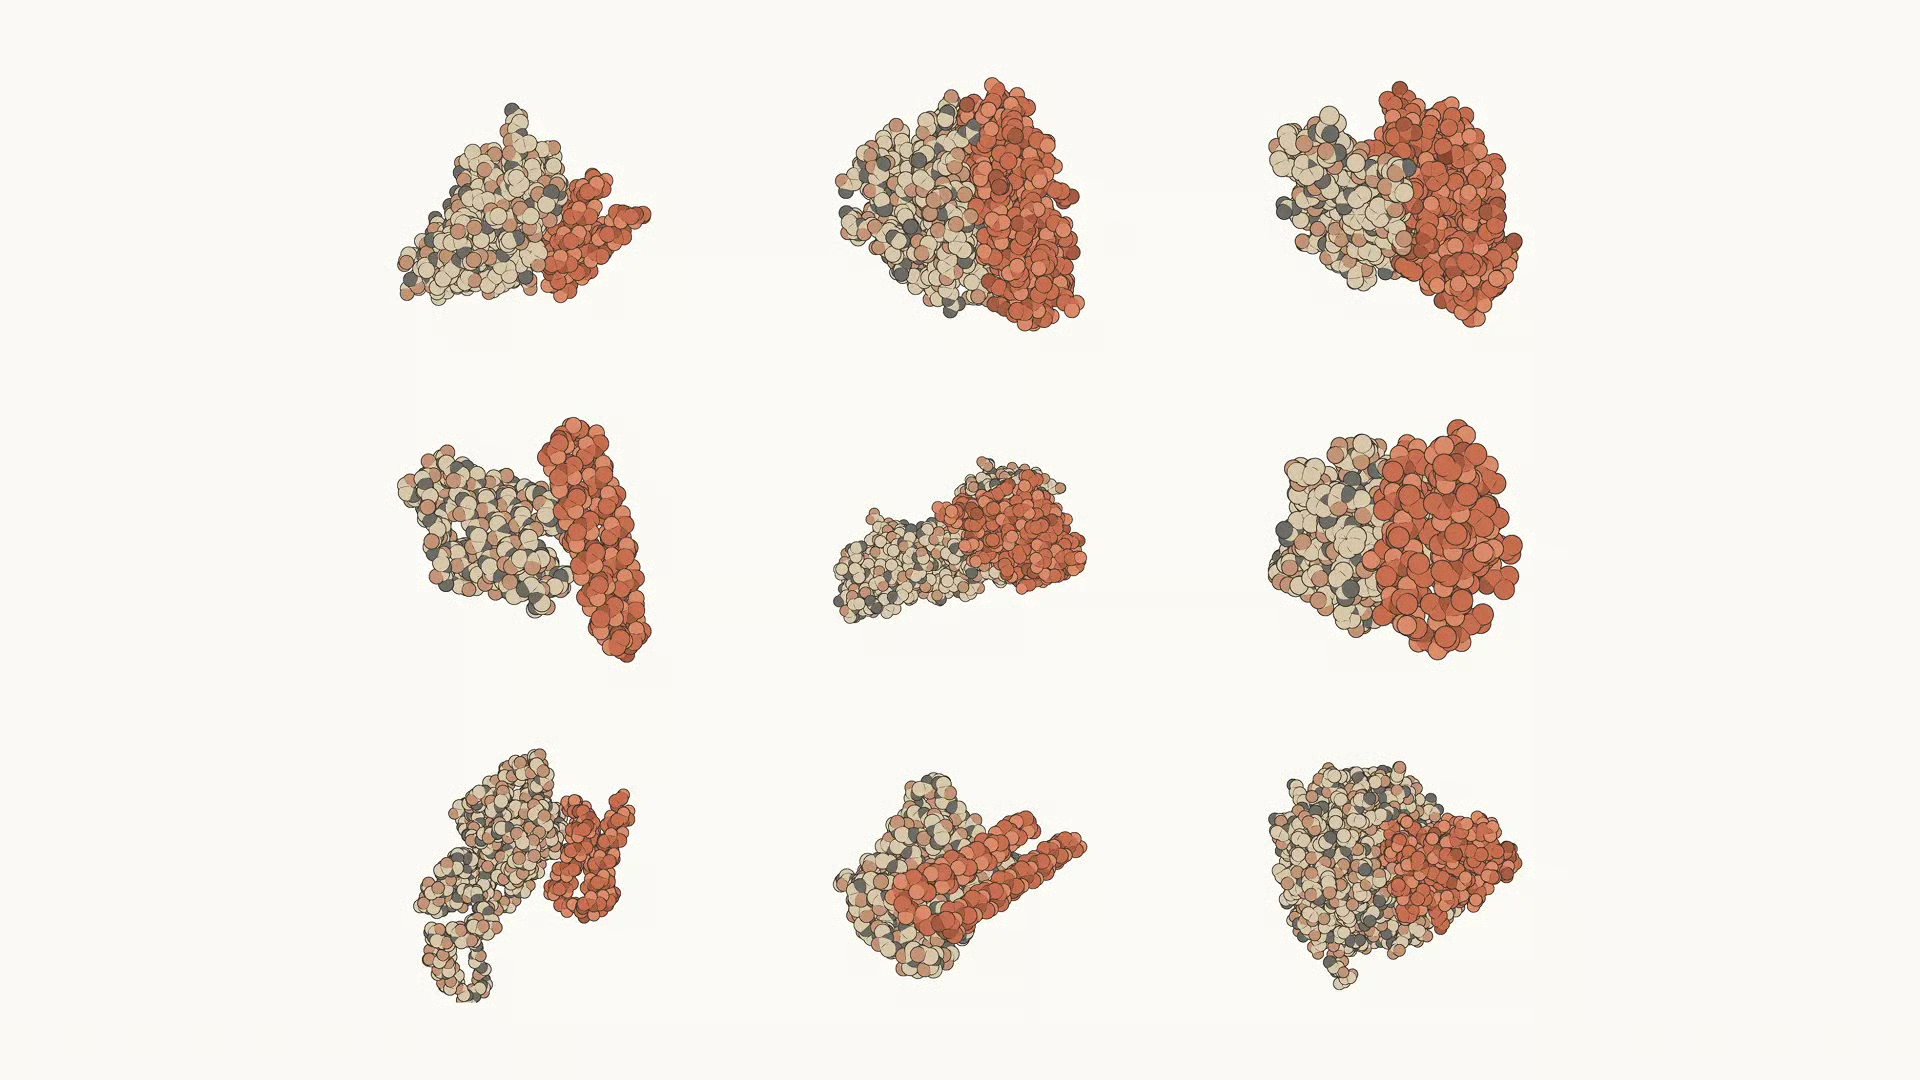
Mythos 5, Anthropic का पहला मॉडल है जो मौजूदा साहित्य का सार प्रस्तुत करने के बजाय निरंतर नई वैज्ञानिक परिकल्पनाएँ उत्पन्न करता है। ब्लाइंडेड तुलना में, Anthropic के वैज्ञानिकों ने आणविक जीवविज्ञान पर इसकी परिकल्पनाओं को लगभग 80% मामलों में प्राथमिकता दी, और कई को प्रायोगिक मूल्यांकन तक आगे बढ़ाया गया है। E. coli के एक नए प्रोटीन तंत्र के बारे में एक परिकल्पना को उसी समस्या पर काम कर रही एक लैब ने स्वतंत्र रूप से पुष्ट किया।
Mythos 5 ने एक सप्ताह से अधिक के बड़े पैमाने पर स्वायत्त कार्य में नवीन जीनोमिक्स अनुसंधान किया, एकल-कोशिका डाटा को 138 पशु प्रजातियों में लाखों कोशिकाओं के लिए संकलित किया और दूर से संबंधित जीवों में समकक्ष कोशिका प्रकारों की पहचान करने हेतु एक कस्टम ML मॉडल को प्रशिक्षित किया। प्रशिक्षित मॉडल ने एक हालिया Science-पब्लिश्ड मॉडल को पछाड़ दिया, जबकि यह 100 गुना छोटा था।
Mythos 5 CharXiv Reasoning with tools पर 93.2% स्कोर करता है और विस्तृत वैज्ञानिक चित्रों से सटीक संख्याएँ निकाल सकता है या सिर्फ स्क्रीनशॉट से एक वेब ऐप को फिर से बना सकता है। लंबी-संदर्भ कार्यों पर, Mythos 5 को फाइल-आधारित मेमोरी देने से इसका प्रदर्शन Opus 4.8 की तुलना में तीन गुना अधिक सुधरा, और यह Slay the Spire के अंतिम एक्ट तक तीन गुना अधिक बार पहुँचा।
Anthropic द्वारा परीक्षण किए लगभग हर बेंचमार्क पर Mythos 5 आगे है या बराबरी पर है, और Opus 4.8 पर इसके लाभ श्रेणियों में व्यापक रूप से सुसंगत हैं—सिर्फ किसी एक क्षेत्र में केंद्रित नहीं। तुलना तालिका में इसे Claude Mythos Preview, Claude Opus 4.8, GPT 5.5, और Gemini 3.1 Pro के विरुद्ध रखा गया है।
| श्रेणी | बेंचमार्क | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| एजेंटिक कोडिंग | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| एजेंटिक कोडिंग | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| नॉलेज वर्क | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| नॉलेज वर्क विज़न | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| स्पैशल रीजनिंग | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| टूल उपयोग | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| कंप्यूटर उपयोग | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| कानूनी | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| बहु-विषयी तर्क | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| बहु-विषयी तर्क | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| जीवविज्ञान | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| जीवविज्ञान | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| एजेंटिक कोडिंग | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| साइबर सुरक्षा | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| स्वास्थ्य | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Anthropic, Mythos 5 और Fable 5 के स्कोर साथ रिपोर्ट करता है, यह उल्लेख करते हुए कि वे अधिकांश मामलों में 1–3 प्रतिशत अंकों के भीतर होते हैं। जिन बेंचमार्क्स पर तारांकन (*) है वहाँ अंतर बड़ा है क्योंकि Fable 5 के सुरक्षा क्लासिफायर संवेदनशील क्वेरीज़ को Opus 4.8 की ओर रूट करते हैं; उन बेंचमार्क्स पर Fable 5 का प्रदर्शन Opus क्लास के करीब होता है।
SWE-Bench Pro पर, Mythos 5 80.3% स्कोर करता है, जबकि Mythos Preview 77.8%, Opus 4.8 69.2%, GPT 5.5 58.6%, और Gemini 3.1 Pro 54.2% स्कोर करते हैं। Opus 4.8 पर 11-पॉइंट की बढ़त उस बेंचमार्क पर उल्लेखनीय है जो ग्राउंड-ट्रुथ लीकेज का प्रतिरोध करने के लिए डिज़ाइन किया गया है।
कच्चे टास्क कम्प्लीशन के बजाय उच्च-गुणवत्ता और सँभालने योग्य एजेंटिक कोड के लिए, जिसे FrontierCode (Diamond) मापता है, अलगाव और स्पष्ट है। Mythos 5 xhigh प्रयास स्तर पर 29.3% स्कोर करता है, जबकि Opus 4.8 13.4% और GPT 5.5 5.7% पर है।
टर्मिनल कार्य के लिए, Mythos 5 ने OpenAI से ताज Anthropic को वापस दिलाया: Mythos 5 Terminal-Bench 2.1 पर 88.0%* स्कोर करता है, जबकि Opus 4.8 82.7%, GPT 5.5 (Codex CLI) 83.4%, और Gemini 3.1 Pro (Gemini CLI के साथ) 70.7% स्कोर करते हैं।
GDPval-AA ज्ञान-कार्य प्रदर्शन को एक संख्यात्मक स्केल पर मापता है। Mythos 5 का स्कोर 1932 है, जबकि Opus 4.8 का 1890, GPT 5.5 का 1769, और Gemini 3.1 Pro का 1314 है।
बिना टूल एक्सेस के PDF दस्तावेजों पर ज्ञान-कार्य के लिए यह अंतर और बढ़ जाता है। Mythos 5, GDPpdf पर 29.8% स्कोर करता है, जबकि Opus 4.8 22.5%, GPT 5.5 24.9%, और Gemini 3.1 Pro 16.7% स्कोर करते हैं।
Humanity's Last Exam (HLE) विज्ञान, गणित, और मानविकी में स्नातकोत्तर-स्तरीय तर्क की जाँच करता है। Mythos 5 बिना टूल्स 59.0%* और टूल्स के साथ 64.5%* स्कोर करता है। Mythos Preview क्रमशः 56.8% और 64.7% स्कोर करता है—टूल्स के साथ लगभग बराबरी पर, लेकिन बिना टूल्स 2 पॉइंट पीछे। Opus 4.8 से दूरी पहले ही उल्लेखनीय है (बिना टूल्स 49.8%, टूल्स के साथ 57.9%), और प्रमुख प्रतिस्पर्धी मॉडलों से और भी बड़ी है (GPT 5.5: 41.4% और 52.2%, Gemini 3.1 Pro: 44.4% और 51.4%)।
बिना टूल्स की स्थिति में Mythos 5 और बाकी क्षेत्र के बीच का अंतर सबसे स्पष्ट है, जहाँ यह Opus 4.8 पर 9 से अधिक पॉइंट आगे है। ये स्टार लगे स्कोर हैं, यानी Fable 5 अपने सुरक्षा क्लासिफायरों के कारण कुछ कम प्रदर्शन करता है।
OSWorld-Verified पर, जो वास्तविक कंप्यूटर इंटरफ़ेस पर कार्य पूरे करने की मॉडल की क्षमता को जाँचता है, Mythos 5 85.0% स्कोर करता है। Mythos Preview 85.4% पर थोड़ा आगे है—यह एकमात्र बेंचमार्क है जहाँ Mythos Preview आगे है। Opus 4.8 काफ़ी करीब है (83.4%), जबकि प्रतियोगी थोड़ा पीछे हैं। GPT 5.5 78.7% और Gemini 3.1 Pro 76.2% स्कोर करते हैं।
AutomationBench टूल उपयोग क्षमताओं को मापता है। Mythos 5 17.4% स्कोर करता है, जबकि Opus 4.8 15.5%, GPT 5.5 12.9%, और Gemini 3.1 Pro 9.6% पर हैं। सभी के कम कुल स्कोर संकेत देते हैं कि टूल उपयोग अब भी सभी फ्रंटियर मॉडलों के लिए कठिन समस्या बनी हुई है।
स्पैशल रीजनिंग वह क्षेत्र है जहाँ Mythos 5 की बढ़त सबसे बड़ी है। यह Blueprint-Bench 2 में 38.6% स्कोर करता है—Opus 4.8 के 14.5% से दोगुने से भी अधिक। GPT 5.5 36.2% पर क़रीब है, और Gemini 3.1 Pro 26.5% स्कोर करता है।
रिलीज़ नोट्स में शायद ये दो क्षेत्र सबसे अधिक केंद्र में रहे, और परिणाम बताते हैं क्यों।
ExploitBench मॉडल द्वारा सफलतापूर्वक पुनरुत्पादित किए जा सकने वाले एक्सप्लॉइट्स के अंश (Cap%) को मापता है। Mythos 5 78.0%* स्कोर करता है—जो Mythos Preview (69.0%) से भी एक उल्लेखनीय सुधार है—और Opus 4.8 के 40.0% तथा GPT 5.5 के 34.0% की तुलना में नाटकीय बढ़त है।
Opus 4.8 पर 38-पॉइंट का अंतर तुलना तालिका में सबसे बड़ा एकल-बेंचमार्क लीड है, और यह बताता है कि Fable 5 के लिए साइबर संबंधी सुरक्षा उपाय क्यों मौजूद हैं। Anthropic की बाहरी रेड-टीमिंग को दीर्घ-रूप एजेंटिक कार्यों पर कोई सार्वभौमिक जेलब्रेक नहीं मिला, हालाँकि UK AISI ने प्रारंभिक परीक्षण विंडो में एक की दिशा में प्रगति की।
BioMysteryBench दो कठिनाई स्तरों पर जैविक तर्क को जाँचता है। कठिन उपसमूह पर, Mythos 5 46.1%* स्कोर करता है, जबकि Mythos Preview 29.6% और Opus 4.8 40.0% पर हैं। मानव-सॉल्व्ड उपसमूह पर, Mythos 5 83.9%*, Mythos Preview 82.6%, और Opus 4.8 80.4% स्कोर करते हैं। GPT 5.5 और Gemini 3.1 Pro के किसी भी उपसमूह पर रिपोर्टेड स्कोर नहीं हैं।
ExploitBench की तरह, जीवविज्ञान-संबंधी सुरक्षा क्लासिफायरों के कारण Fable 5 के स्कोर Opus 4.8 के करीब आते हैं।
Claude Mythos 5 ने दो उच्च-जोखिम वाले पेशेवर क्षेत्रों—चिकित्सा और क़ानून—में उल्लेखनीय मज़बूती दर्शाई है, जहाँ सटीकता और तर्क की गुणवत्ता के वास्तविक दुनिया में परिणाम होते हैं।
HealthBench Professional में, Mythos 5 66.0%* स्कोर करता है, जो Mythos Preview के 64.7% से थोड़ा ऊपर है। Opus 4.8 56.9% और GPT 5.5 51.8% स्कोर करते हैं।
Legal Agent Benchmark पर, Mythos 5 13.3% स्कोर करता है, जबकि Opus 4.8 10.4% और GPT 5.5 केवल 2.1% पर है। कुल स्कोर भले कम हों, लेकिन Mythos 5 और GPT 5.5 या Gemini के बीच फासला स्पष्ट है। कानूनी तर्क अब भी सभी मॉडलों के लिए चुनौतीपूर्ण फ्रंटियर है।
Claude Mythos 5 की कीमत प्रति मिलियन इनपुट टोकन $10 और प्रति मिलियन आउटपुट टोकन $50 है। यह Claude Mythos Preview ($25/$125) की तुलना में आधे से भी कम है, जिससे मौजूदा Glasswing भागीदारों के लिए अपग्रेड सीधा हो जाता है। डेवलपर्स मॉडल ID claude-mythos-5 का उपयोग कर Claude API के माध्यम से मॉडल तक पहुँच सकते हैं।
वर्तमान में पहुँच दो समूहों तक सीमित है:
Anthropic समय के साथ दोनों कार्यक्रमों का विस्तार करने की योजना बना रहा है।
एक व्यापक विश्वसनीय पहुँच कार्यक्रम की योजना साइबर सुरक्षा संगठनों के लिए अमेरिकन सरकार के परामर्श में अधिक व्यवस्थित रूप से आवेदन करने हेतु बनाई गई है। Anthropic ने सामान्य उपलब्धता के लिए समयरेखा की घोषणा नहीं की है। अधिकांश डेवलपर्स के लिए, Claude Fable 5 आज का व्यावहारिक विकल्प है—वही आधारभूत मॉडल और मानक सब्सक्रिप्शन और API योजनाओं के माध्यम से पहुँच।
एक संचालन-संबंधी विवरण ध्यान देने योग्य है: Anthropic ने सभी Mythos-क्लास मॉडल ट्रैफ़िक के लिए 30-दिन का डेटा रिटेंशन पॉलिसी लागू किया है। डेटा का उपयोग प्रशिक्षण के लिए नहीं किया जाता और लगभग सभी मामलों में 30 दिनों के बाद हटा दिया जाता है, लेकिन इसे सुरक्षा मॉनिटरिंग के लिए रखा जाता है। यदि आप Mythos 5 पर संवेदनशील डेटा के साथ निर्माण कर रहे हैं, तो परिनियोजन से पहले इस नीति पर Anthropic के सहायता दस्तावेज़ों की समीक्षा करें।
Claude Mythos 5 इस बात का Anthropic की ओर से अब तक का सबसे स्पष्ट संकेत है कि कंपनी उच्च-जोखिम वाले पेशेवर संदर्भों में फ्रंटियर AI की तैनाती को गंभीरता से लेती है—और परिणाम इसकी पुष्टि करते हैं।
SWE-bench Pro का अंतर (80.3% बनाम 69.2%), Terminal-Bench 2.1 का अंतर (88.0% बनाम 82.7%), और ExploitBench का अंतर (78.0% बनाम 40.0%)—ये सभी इस ओर इशारा करते हैं कि यह मॉडल सबसे कठिन कार्यों को किसी भी अन्य उपलब्ध विकल्प से अधिक विश्वसनीयता से संभालता है।
द्वि-उपयोग जोखिमों को देखते हुए प्रतिबंधित पहुँच मॉडल उचित है, और ExploitBench के स्कोर एक ठोस तर्क देते हैं कि सबसे सक्षम आक्रामक सुरक्षा उपकरण सार्वजनिक रूप से उपलब्ध नहीं होने चाहिए। कठिन प्रश्न यह है कि क्या Anthropic विश्वसनीय एक्सेस कार्यक्रम का विस्तार इतनी तेज़ी से कर सकता है कि व्यापक सुरक्षा और बायोमेडिकल शोध समुदायों के लिए यह उपयोगी हो, इससे पहले कि प्रतिस्पर्धी अंतर कम कर लें।
जो संगठन योग्य हैं, उनके लिए Mythos Preview से अपग्रेड आधे से भी कम कीमत पर सीधा है।
शीर्ष AI पाठ्यक्रम
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें