

Lernpfad
Grundlagen der KI
10 Std.
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleMythos 5 legt in sämtlichen zentralen Fähigkeitsbereichen zu, die Anthropic getestet hat. Die Fortschritte zeigen sich besonders deutlich bei langfristigen autonomen Aufgaben, vor allem in wissenschaftlichen Domänen des wissenschaftlichen Denkens sowie bei Vision-Aufgaben. So sieht das in der Praxis aus.
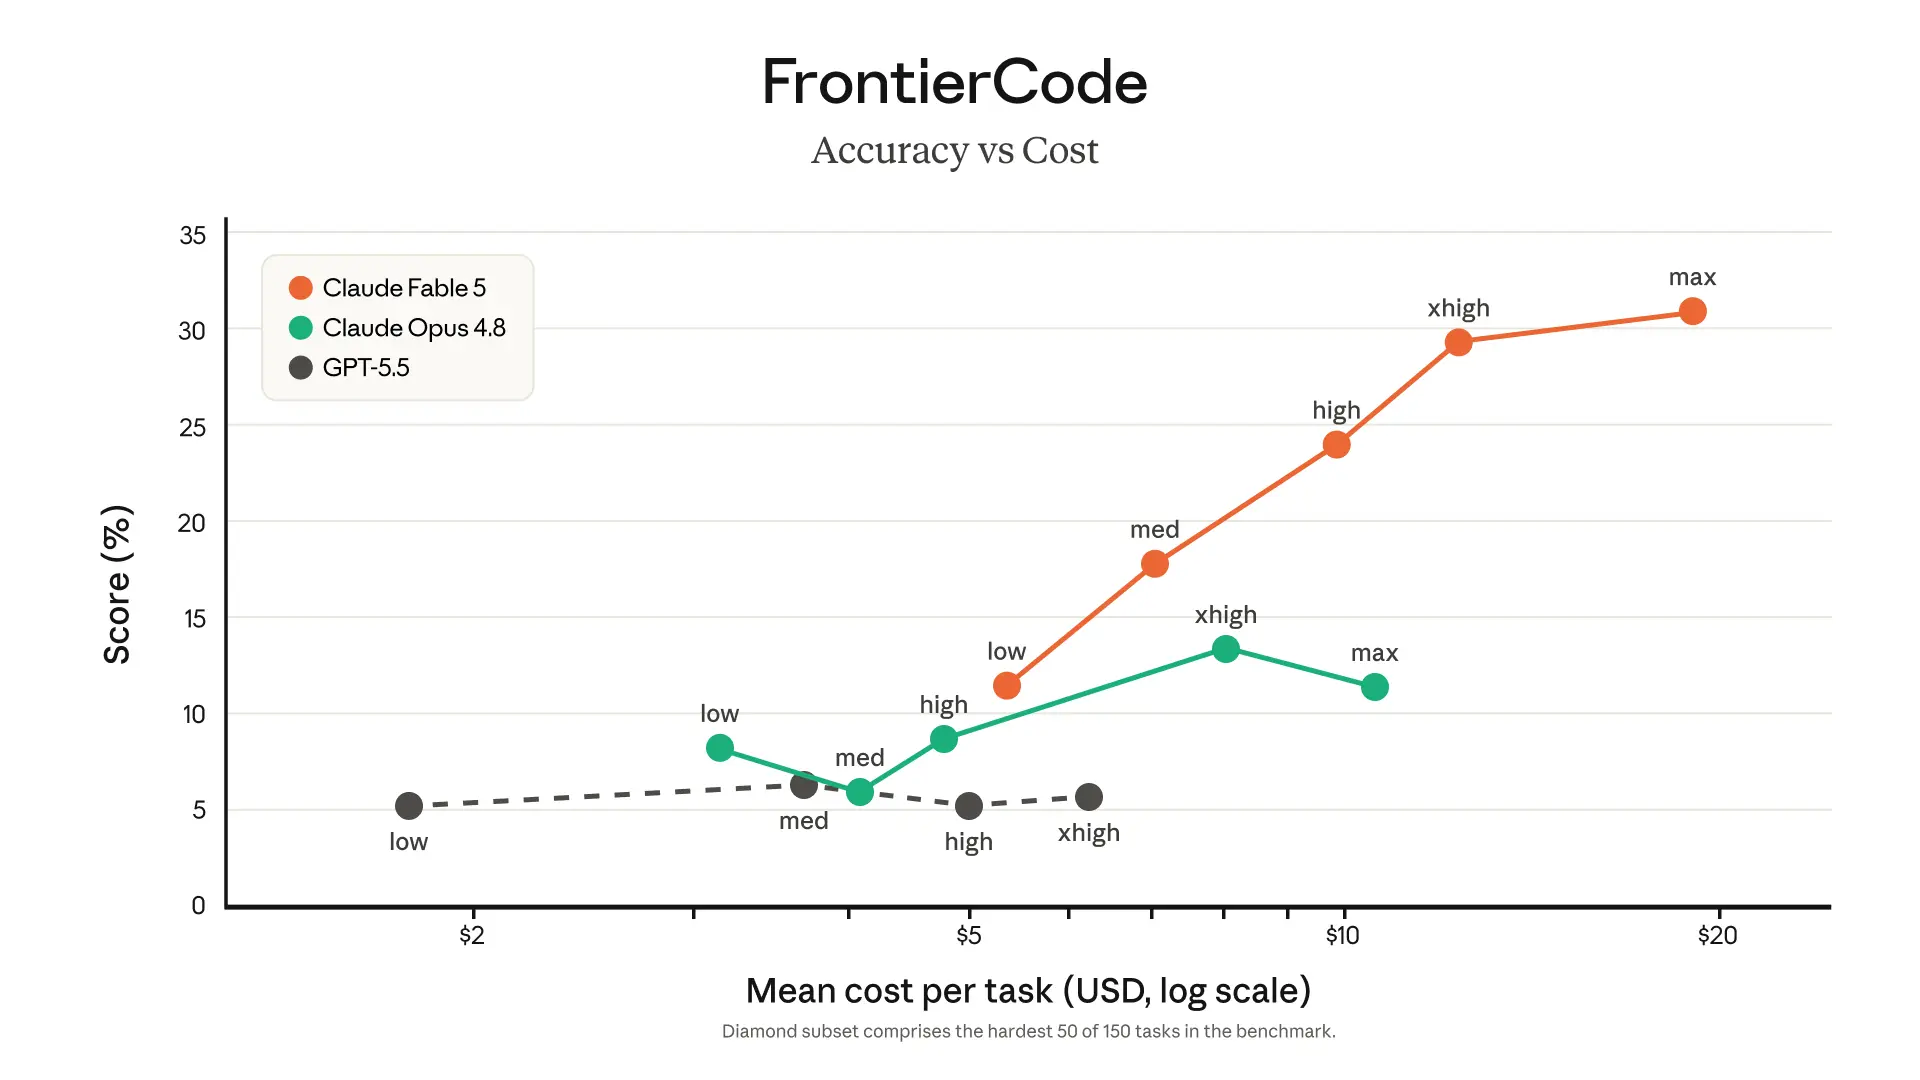
Mythos 5 kann länger und eigenständig an großen Codebasen arbeiten als jedes frühere Claude-Modell. Stripe berichtet, dass das Modell Monate an Engineering-Arbeit in Tage komprimierte und eine codebaseweite Migration über eine Ruby-Codebasis mit 50 Millionen Zeilen an einem einzigen Tag abschloss. Auf FrontierCode (Diamond) erzielt es unter den Frontier-Modellen die höchsten Werte, selbst bei mittlerem Aufwand.
Für Security-Aufgaben erweitert Mythos 5 die Fähigkeiten, die Mythos Preview für Project-Glasswing-Partner so wertvoll machten. Diese Partner fanden mit Mythos Preview über 10.000 schwerwiegende Sicherheitslücken in Produktionssystemen.
Anthropics internes Protein-Designteam beschleunigte mit Mythos 5 das Wirkstoffdesign um etwa den Faktor zehn. In einem kontrollierten Vergleich erreichte oder übertraf Mythos 5 über 14 Proteinziele hinweg die Leistung erfahrener Humanoperatoren für die gesamte Pipeline:
Neun davon lieferten vielversprechende Wirkstoffkandidaten, die derzeit untersucht werden.
Mythos 5 ist Anthropics erstes Modell, das konsistent neuartige wissenschaftliche Hypothesen erzeugt, statt lediglich bestehende Literatur zusammenzufassen. In verblindeten Vergleichen bevorzugten Anthropics Wissenschaftler seine Hypothesen zur Molekularbiologie in etwa 80% der Fälle, und mehrere wurden in die experimentelle Prüfung überführt. Eine Hypothese zu einem neuartigen E.-coli-Proteinmechanismus wurde unabhängig von einem Labor bestätigt, das am selben Problem arbeitet.
Mythos 5 führte über mehr als eine Woche weitgehend autonom neuartige Genomikforschung durch, indem es Single-Cell-Daten für Millionen Zellen über 138 Tierarten hinweg zusammenstellte und ein eigenes ML-Modell trainierte, um äquivalente Zelltypen in entfernt verwandten Organismen zu identifizieren. Das trainierte Modell übertraf ein kürzlich in Science veröffentlichtes Modell, obwohl es 100-mal kleiner war.
Mythos 5 erreicht 93,2% auf CharXiv Reasoning mit Tools und kann präzise Zahlen aus detaillierten wissenschaftlichen Abbildungen extrahieren oder eine Web-App nur anhand von Screenshots rekonstruieren. Bei Langkontextaufgaben verbesserte Speicher auf Dateibasis die Leistung von Mythos 5 dreimal so stark wie bei Opus 4.8, und es erreichte den letzten Akt von Slay the Spire dreimal häufiger.
Mythos 5 führt oder liegt gleichauf bei nahezu allen von Anthropic getesteten Benchmarks, mit durchgängig höheren Werten als Opus 4.8 — nicht nur in einer einzelnen Kategorie. Der Vergleich stellt es Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 und Gemini 3.1 Pro gegenüber.
| Kategorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentic Coding | SWE-Bench Pro | 80,3% | 77,8% | 69,2% | 58,6% | 54,2% |
| Agentic Coding | FrontierCode (Diamond) | 29,3% (xhigh) | — | 13,4% (xhigh) | 5,7% (xhigh) | — |
| Wissensarbeit | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Wissensarbeit Vision | GDP.pdf | 29,8% (ohne Tools) | — | 22,5% (ohne Tools) | 24,9% (ohne Tools) | 16,7% (ohne Tools) |
| Räumliches Denken | Blueprint-Bench 2 | 38,6% | — | 14,5% | 36,2% | 26,5% |
| Toolnutzung | AutomationBench | 17,4% | — | 15,5% | 12,9% | 9,6% |
| Computerbedienung | OSWorld-Verified | 85,0% | 85,4% | 83,4% | 78,7% | 76,2% |
| Recht | Legal Agent Benchmark | 13,3% | — | 10,4% | 2,1% | 0,0% |
| Multidisziplinäres Denken | Humanity's Last Exam (ohne Tools) | 59,0%* | 56,8% | 49,8% | 41,4% | 44,4% |
| Multidisziplinäres Denken | Humanity's Last Exam (mit Tools) | 64,5%* | 64,7% | 57,9% | 52,2% | 51,4% |
| Biologie | BioMysteryBench (schwierig) | 46,1%* | 29,6% | 40,0% | — | — |
| Biologie | BioMysteryBench (menschlich gelöst) | 83,9%* | 82,6% | 80,4% | — | — |
| Agentic Coding | Terminal-Bench 2.1 | 88,0%* | — | 82,7% | 83,4% (Codex CLI) | 70,7% (Gemini CLI) |
| Cybersicherheit | ExploitBench (Cap%) | 78,0%* | 69,0% | 40,0% | 34,0% | — |
| Gesundheit | HealthBench Professional | 66,0%* | 64,7% | 56,9% | 51,8% | — |
Anthropic berichtet die Werte für Mythos 5 und Fable 5 gemeinsam und merkt an, dass sie in den meisten Fällen innerhalb von 1–3 Prozentpunkten liegen. Mit einem Sternchen (*) markierte Benchmarks zeigen größere Abstände, weil Fable 5s Sicherheitsklassifizierer sensible Anfragen an Opus 4.8 umleiten; auf diesen Benchmarks liegt Fable 5 näher an der Opus-Klasse.
Auf SWE-Bench Pro erzielt Mythos 5 80,3%, gegenüber 77,8% für Mythos Preview, 69,2% für Opus 4.8, 58,6% für GPT 5.5 und 54,2% für Gemini 3.1 Pro. Der Vorsprung von 11 Punkten gegenüber Opus 4.8 ist beachtlich auf einem Benchmark, der Ground-Truth-Leakage gezielt erschwert.
Bei qualitativ hochwertigem, wartbarem agentischen Code statt reiner Aufgabenerfüllung, gemessen von FrontierCode (Diamond), ist die Trennung noch deutlicher. Mythos 5 erreicht 29,3% auf dem xhigh-Aufwandsniveau, gegenüber 13,4% für Opus 4.8 und 5,7% für GPT 5.5.
Für Terminalaufgaben holt Mythos 5 die Krone von OpenAI zurück zu Anthropic: Mythos 5 erzielt 88,0%* auf Terminal-Bench 2.1, gegenüber 82,7% für Opus 4.8, 83,4% für GPT 5.5 (Codex CLI) und 70,7% für Gemini 3.1 Pro (mit Gemini CLI).
GDPval-AA misst die Leistung in Wissensarbeit auf einer numerischen Skala. Mythos 5 erreicht 1932, gegenüber 1890 für Opus 4.8, 1769 für GPT 5.5 und 1314 für Gemini 3.1 Pro.
Dieser Abstand vergrößert sich bei Wissensarbeit auf PDF-Dokumenten ohne Toolzugriff. Mythos 5 erzielt 29,8% auf GDPpdf, gegenüber 22,5% für Opus 4.8, 24,9% für GPT 5.5 und 16,7% für Gemini 3.1 Pro.
Humanity's Last Exam (HLE) prüft Denkvermögen auf Master-Niveau in Naturwissenschaften, Mathematik und Geisteswissenschaften. Mythos 5 erreicht 59,0%* ohne Tools und 64,5%* mit Tools. Mythos Preview kommt auf 56,8% bzw. 64,7% — mit Tools praktisch gleichauf, ohne Tools zwei Punkte dahinter. Der Abstand zu Opus 4.8 ist bereits deutlich (49,8% ohne, 57,9% mit), zu den Flaggschiff-Konkurrenten noch größer (GPT 5.5: 41,4% und 52,2%, Gemini 3.1 Pro: 44,4% und 51,4%).
Am deutlichsten ist der Vorsprung von Mythos 5 im Szenario ohne Tools, wo es Opus 4.8 um über 9 Punkte übertrifft. Das sind mit Sternchen markierte Werte, d. h. Fable 5 liegt hier aufgrund der Sicherheitsklassifizierer etwas niedriger.
Auf OSWorld-Verified, das die Fähigkeit testet, Aufgaben in einer echten Computeroberfläche zu erledigen, erreicht Mythos 5 85,0%. Mythos Preview liegt mit 85,4% knapp vorn — der einzige Benchmark, auf dem Preview führt. Opus 4.8 folgt dicht (83,4%), die Konkurrenz fällt etwas zurück: GPT 5.5 erzielt 78,7%, Gemini 3.1 Pro 76,2%.
AutomationBench misst die Toolnutzung. Mythos 5 erreicht 17,4%, gegenüber 15,5% für Opus 4.8, 12,9% für GPT 5.5 und 9,6% für Gemini 3.1 Pro. Die niedrigen absoluten Werte deuten darauf hin, dass Toolnutzung für alle Frontier-Modelle weiterhin anspruchsvoll ist.
Räumliches Denken ist ein Bereich, in dem der Vorsprung von Mythos 5 am größten ist. Es erzielt 38,6% im Blueprint-Bench 2 — mehr als doppelt so viel wie Opus 4.8 mit 14,5%. GPT 5.5 liegt mit 36,2% näher dran, Gemini 3.1 Pro erreicht 26,5%.
Das sind die beiden Bereiche, die in den Release Notes wohl am meisten Aufmerksamkeit bekamen — und die Ergebnisse zeigen warum.
ExploitBench misst den Anteil der Exploits, die das Modell erfolgreich reproduzieren kann (Cap%). Mythos 5 erreicht 78,0%* — ein klarer Sprung selbst gegenüber Mythos Preview (69,0%) und ein dramatischer Vorsprung gegenüber Opus 4.8 mit 40,0% sowie GPT 5.5 mit 34,0%.
Der Abstand von 38 Punkten zu Opus 4.8 ist der größte Einzelvorsprung im Vergleich und erklärt, warum es für Fable 5 Cyber-Schutzmechanismen gibt. Anthropics externes Red-Teaming fand keine universellen Jailbreaks bei langformatigen agentischen Aufgaben, wenngleich die UK AISI in einem ersten Testfenster Fortschritte in diese Richtung machte.
BioMysteryBench prüft biologisches Schlussfolgern in zwei Schwierigkeitsgraden. Im schwierigen Teil erreicht Mythos 5 46,1%*, gegenüber 29,6% für Mythos Preview und 40,0% für Opus 4.8. Im „human-solved“-Teil erzielt Mythos 5 83,9%*, Mythos Preview 82,6% und Opus 4.8 80,4%. Für GPT 5.5 und Gemini 3.1 Pro liegen in beiden Teilmengen keine Werte vor.
Wie bei ExploitBench liegen Fable 5s Werte wegen Biologie-bezogener Schutzmechanismen näher bei Opus 4.8.
Claude Mythos 5 zeigt besondere Stärke in zwei hochkritischen Professionen, in denen Genauigkeit und Begründungsqualität reale Auswirkungen haben: Medizin und Recht.
In HealthBench Professional erreicht Mythos 5 66,0%*, knapp über Mythos Preview mit 64,7%. Opus 4.8 erzielt 56,9%, GPT 5.5 kommt auf 51,8%.
Im Legal Agent Benchmark erzielt Mythos 5 13,3%, gegenüber 10,4% für Opus 4.8 und nur 2,1% für GPT 5.5. Die absoluten Werte sind niedrig, aber der Abstand zwischen Mythos 5 und GPT 5.5 bzw. Gemini ist deutlich. Juristisches Schlussfolgern bleibt für alle Modelle eine Herausforderung.
Claude Mythos 5 kostet 10 US-Dollar pro Million Eingabetokens und 50 US-Dollar pro Million Ausgabetokens. Das ist weniger als die Hälfte des Preises von Claude Mythos Preview (25/125 US-Dollar) und macht das Upgrade für bestehende Glasswing-Partner naheliegend. Entwickler können über die Claude API mit der Modell-ID claude-mythos-5 auf das Modell zugreifen.
Der Zugriff ist derzeit auf zwei Gruppen beschränkt:
Anthropic plant, beide Programme im Laufe der Zeit auszuweiten.
Ein breiteres Trusted-Access-Programm ist für Cybersicherheitsorganisationen in Abstimmung mit der US-Regierung geplant. Einen Zeitplan für die allgemeine Verfügbarkeit hat Anthropic nicht bekanntgegeben. Für die meisten Entwickler ist Claude Fable 5 heute die praktikable Option — mit demselben Grundmodell und Zugriff über Standard-Abos und API-Pläne.
Ein wichtiger operativer Hinweis: Anthropic hat für sämtlichen Traffic der Mythos-Klasse eine 30-tägige Datenaufbewahrung eingeführt. Die Daten werden nicht zum Training genutzt und in fast allen Fällen nach 30 Tagen gelöscht, jedoch für Sicherheitsmonitoring vorgehalten. Wenn du mit Mythos 5 und sensiblen Daten arbeitest, lies vor dem Go-live die Support-Dokumentation von Anthropic zu dieser Richtlinie.
Claude Mythos 5 ist Anthropics bisher deutlichstes Signal, dass das Unternehmen Frontier-KI in professionellen Hochrisikoumgebungen ernsthaft einsetzen will — und die Ergebnisse stützen das.
Die Lücken bei SWE-bench Pro (80,3% vs. 69,2%), Terminal-Bench 2.1 (88,0% vs. 82,7%) und ExploitBench (78,0% vs. 40,0%) deuten auf ein Modell hin, das die schwierigsten Aufgaben verlässlicher meistert als alles andere am Markt.
Das Zugriffsmodell mit Beschränkung ist angesichts der Dual-Use-Risiken plausibel, und die ExploitBench-Werte sprechen dafür, die leistungsfähigsten Offensiv-Security-Tools nicht öffentlich verfügbar zu machen. Die spannendere Frage ist, ob Anthropic das Trusted-Access-Programm schnell genug erweitern kann, um der breiteren Security- und biomedizinischen Forschungsgemeinschaft zu nutzen, bevor Wettbewerber aufschließen.
Für qualifizierte Organisationen ist das Upgrade von Mythos Preview bei weniger als der Hälfte der Kosten ein No-Brainer.
Top-Kurse zu KI
Lernpfad
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
8 Min.


