50% de desconto no DataCamp Premium. Mais de 700 cursos pela metade do preço. Comece a aprender hoje.
O Mythos 5 representa um salto em relação ao Mythos Preview em todas as áreas de capacidade que a Anthropic testou. Os ganhos aparecem principalmente em trabalho autônomo de longo prazo, especialmente em domínios científicos de raciocínio e tarefas de visão. Veja como isso se traduz na prática.
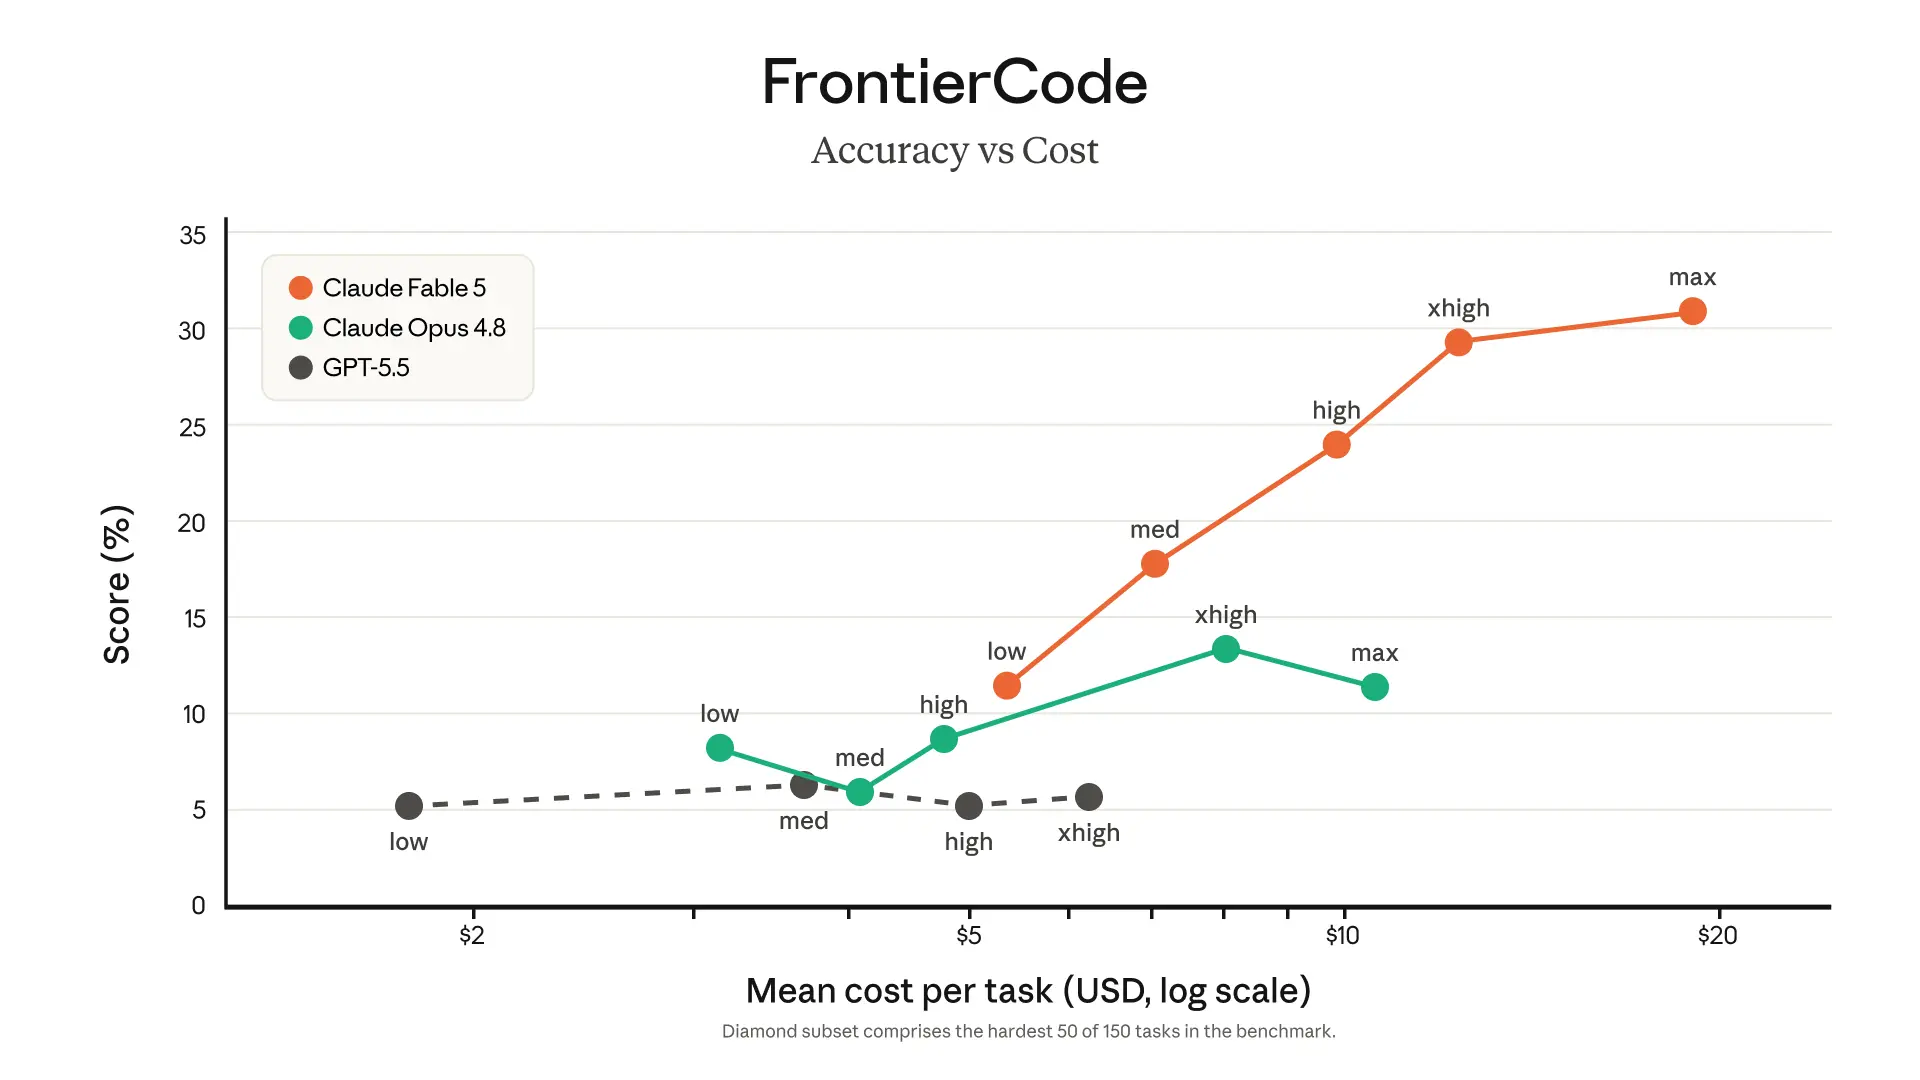
O Mythos 5 consegue atuar de forma autônoma em bases de código grandes por mais tempo do que qualquer Claude anterior. A Stripe relatou que o modelo condensou meses de trabalho de engenharia em dias, concluindo uma migração em toda a base de um código Ruby de 50 milhões de linhas em um único dia. No FrontierCode (Diamond), ele tem a maior pontuação entre os modelos de fronteira mesmo em esforço médio.
Para segurança, o Mythos 5 amplia as capacidades que tornaram o Mythos Preview valioso para os parceiros do Project Glasswing. Esses parceiros usaram o Mythos Preview para identificar mais de 10.000 falhas de segurança de alta e crítica severidade em sistemas de produção.
A equipe interna de design de proteínas da Anthropic usou o Mythos 5 para acelerar o design de fármacos em cerca de dez vezes. Em uma comparação controlada, o Mythos 5 igualou ou superou operadores humanos experientes em 14 alvos proteicos ao longo de todo o pipeline:
Nove resultaram em candidatos promissores a fármacos, atualmente em investigação.
O Mythos 5 é o primeiro modelo da Anthropic a produzir de forma consistente hipóteses científicas inéditas, em vez de apenas resumir a literatura. Em comparações às cegas, os cientistas da Anthropic preferiram suas hipóteses em biologia molecular em cerca de 80% dos casos, e várias avançaram para avaliação experimental. Uma hipótese sobre um novo mecanismo proteico em E. coli foi corroborada de forma independente por um laboratório que trabalhava no mesmo problema.
O Mythos 5 conduziu pesquisa inédita em genômica por mais de uma semana de trabalho majoritariamente autônomo, compilando dados de célula única para milhões de células em 138 espécies animais e treinando um modelo de ML customizado para identificar tipos celulares equivalentes em organismos distantes. O modelo treinado superou um modelo publicado na Science recentemente, apesar de ser 100 vezes menor.
O Mythos 5 marca 93,2% no CharXiv Reasoning com ferramentas e consegue extrair números precisos de figuras científicas detalhadas ou reconstruir um app web apenas a partir de capturas de tela. Em tarefas de longo contexto, dar ao Mythos 5 uma memória baseada em arquivos melhorou seu desempenho três vezes mais do que a mesma configuração melhorou o Opus 4.8, e ele alcançou o ato final de Slay the Spire três vezes com mais frequência.
O Mythos 5 lidera ou empata em praticamente todos os benchmarks testados pela Anthropic, com ganhos sobre o Opus 4.8 consistentes entre categorias, não concentrados em uma só área. A tabela de comparação o coloca frente ao Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 e Gemini 3.1 Pro.
| Categoria | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Codificação agentiva | SWE-Bench Pro | 80,3% | 77,8% | 69,2% | 58,6% | 54,2% |
| Codificação agentiva | FrontierCode (Diamond) | 29,3% (xhigh) | — | 13,4% (xhigh) | 5,7% (xhigh) | — |
| Trabalho do conhecimento | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Trabalho do conhecimento com visão | GDP.pdf | 29,8% (sem ferramentas) | — | 22,5% (sem ferramentas) | 24,9% (sem ferramentas) | 16,7% (sem ferramentas) |
| Raciocínio espacial | Blueprint-Bench 2 | 38,6% | — | 14,5% | 36,2% | 26,5% |
| Uso de ferramentas | AutomationBench | 17,4% | — | 15,5% | 12,9% | 9,6% |
| Uso de computador | OSWorld-Verified | 85,0% | 85,4% | 83,4% | 78,7% | 76,2% |
| Jurídico | Legal Agent Benchmark | 13,3% | — | 10,4% | 2,1% | 0,0% |
| Raciocínio multidisciplinar | Humanity's Last Exam (sem ferramentas) | 59,0%* | 56,8% | 49,8% | 41,4% | 44,4% |
| Raciocínio multidisciplinar | Humanity's Last Exam (com ferramentas) | 64,5%* | 64,7% | 57,9% | 52,2% | 51,4% |
| Biologia | BioMysteryBench (difícil) | 46,1%* | 29,6% | 40,0% | — | — |
| Biologia | BioMysteryBench (resolvido por humanos) | 83,9%* | 82,6% | 80,4% | — | — |
| Codificação agentiva | Terminal-Bench 2.1 | 88,0%* | — | 82,7% | 83,4% (Codex CLI) | 70,7% (Gemini CLI) |
| Cibersegurança | ExploitBench (Cap%) | 78,0%* | 69,0% | 40,0% | 34,0% | — |
| Saúde | HealthBench Professional | 66,0%* | 64,7% | 56,9% | 51,8% | — |
A Anthropic reporta as pontuações de Mythos 5 e Fable 5 juntas, observando que elas variam 1–3 pontos percentuais na maioria dos casos. Os benchmarks marcados com asterisco (*) mostram um gap maior porque os classificadores de segurança do Fable 5 redirecionam consultas sensíveis para o Opus 4.8; nesses benchmarks, o Fable 5 se aproxima mais da classe Opus.
No SWE-Bench Pro, o Mythos 5 marca 80,3%, ante 77,8% do Mythos Preview, 69,2% do Opus 4.8, 58,6% do GPT 5.5 e 54,2% do Gemini 3.1 Pro. A diferença de 11 pontos em relação ao Opus 4.8 é significativa em um benchmark projetado para evitar vazamento de gabarito.
Quando a métrica é qualidade e manutenibilidade do código agentivo, medida pelo FrontierCode (Diamond), a separação é ainda mais nítida. O Mythos 5 marca 29,3% no nível de esforço xhigh, contra 13,4% do Opus 4.8 e 5,7% do GPT 5.5.
Para trabalho em terminal, o Mythos 5 devolve a coroa à Anthropic frente à OpenAI: ele marca 88,0%* no Terminal-Bench 2.1, ante 82,7% do Opus 4.8, 83,4% do GPT 5.5 (Codex CLI) e 70,7% do Gemini 3.1 Pro (com Gemini CLI).
O GDPval-AA mede desempenho em trabalho do conhecimento em uma escala numérica. O Mythos 5 marca 1932, contra 1890 do Opus 4.8, 1769 do GPT 5.5 e 1314 do Gemini 3.1 Pro.
Essa diferença aumenta em trabalho do conhecimento em PDFs sem acesso a ferramentas. O Mythos 5 marca 29,8% no GDPpdf, contra 22,5% do Opus 4.8, 24,9% do GPT 5.5 e 16,7% do Gemini 3.1 Pro.
O Humanity's Last Exam (HLE) testa raciocínio em nível de pós-graduação em ciências, matemática e humanidades. O Mythos 5 marca 59,0%* sem ferramentas e 64,5%* com ferramentas. O Mythos Preview marca 56,8% e 64,7%, respectivamente—praticamente empatado com ferramentas, mas 2 pontos atrás sem. A distância para o Opus 4.8 já é grande (49,8% sem e 57,9% com), e fica ainda maior para os concorrentes principais (GPT 5.5: 41,4% e 52,2%; Gemini 3.1 Pro: 44,4% e 51,4%).
O gap entre o Mythos 5 e o restante do campo fica mais claro na condição sem ferramentas, onde ele lidera o Opus 4.8 por mais de 9 pontos. Essas são pontuações com asterisco, o que significa que o Fable 5 performa um pouco abaixo por conta de seus classificadores de segurança.
No OSWorld-Verified, que testa a capacidade do modelo de concluir tarefas em uma interface de computador real, o Mythos 5 marca 85,0%. O Mythos Preview fica ligeiramente à frente com 85,4%, sendo este o único benchmark em que o Mythos Preview lidera. O Opus 4.8 chega perto (83,4%), enquanto os concorrentes ficam um pouco para trás. O GPT 5.5 marca 78,7% e o Gemini 3.1 Pro, 76,2%.
O AutomationBench mede capacidades de uso de ferramentas. O Mythos 5 marca 17,4%, contra 15,5% do Opus 4.8, 12,9% do GPT 5.5 e 9,6% do Gemini 3.1 Pro. Os números absolutos baixos sugerem que o uso de ferramentas continua sendo um desafio para todos os modelos de fronteira.
Raciocínio espacial é uma das áreas em que a liderança do Mythos 5 é maior. Ele marca 38,6% no Blueprint-Bench 2, mais que o dobro dos 14,5% do Opus 4.8. O GPT 5.5 fica mais perto com 36,2%, e o Gemini 3.1 Pro marca 26,5%.
Essas foram, provavelmente, as duas áreas com mais destaque nas notas de lançamento, e os resultados mostram o motivo.
O ExploitBench mede a fração de exploits que o modelo consegue reproduzir com sucesso (Cap%). O Mythos 5 marca 78,0%*, um avanço considerável em relação ao Mythos Preview (69,0%) e um salto dramático em comparação aos 40,0% do Opus 4.8 e 34,0% do GPT 5.5.
O gap de 38 pontos sobre o Opus 4.8 é a maior liderança em um único benchmark na tabela de comparação, e explica por que existem salvaguardas cibernéticas no Fable 5. A avaliação externa de red teaming da Anthropic não encontrou jailbreaks universais em tarefas agentivas de formato longo, embora o UK AISI tenha feito progresso em direção a um durante uma janela inicial de testes.
O BioMysteryBench testa raciocínio biológico em dois níveis de dificuldade. No subconjunto difícil, o Mythos 5 marca 46,1%*, contra 29,6% do Mythos Preview e 40,0% do Opus 4.8. No subconjunto resolvido por humanos, o Mythos 5 marca 83,9%*, o Mythos Preview 82,6% e o Opus 4.8 80,4%. GPT 5.5 e Gemini 3.1 Pro não têm pontuações reportadas em nenhum dos subconjuntos.
Assim como no ExploitBench, as pontuações do Fable 5 ficam mais próximas do Opus 4.8 por conta dos classificadores de segurança relacionados a biologia.
O Claude Mythos 5 mostra força notável em dois domínios profissionais críticos, onde precisão e qualidade de raciocínio têm consequências reais: medicina e direito.
No HealthBench Professional, o Mythos 5 marca 66,0%*, pouco acima dos 64,7% do Mythos Preview. O Opus 4.8 marca 56,9% e o GPT 5.5, 51,8%.
No Legal Agent Benchmark, o Mythos 5 marca 13,3%, contra 10,4% do Opus 4.8 e apenas 2,1% do GPT 5.5. As pontuações absolutas são baixas, mas a distância entre o Mythos 5 e o GPT 5.5 ou o Gemini é grande. Raciocínio jurídico continua sendo um desafio para todos os modelos.
O Claude Mythos 5 custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída. É menos da metade do preço do Claude Mythos Preview (US$ 25/US$ 125), o que torna a atualização simples para os parceiros do Glasswing. Desenvolvedores podem acessar o modelo via Claude API usando o ID claude-mythos-5.
O acesso está, por enquanto, limitado a dois grupos:
A Anthropic planeja expandir ambos os programas ao longo do tempo.
Um programa mais amplo de acesso confiável está previsto para que organizações de cibersegurança possam se candidatar de forma mais sistemática, em consulta com o governo dos EUA. A Anthropic não anunciou um cronograma para disponibilidade geral. Para a maioria dos desenvolvedores, o Claude Fable 5 é a opção prática hoje, com o mesmo modelo base e acesso via assinaturas e planos de API padrão.
Um ponto operacional importante: a Anthropic introduziu uma política de retenção de dados de 30 dias para todo o tráfego de modelos da classe Mythos. Os dados não são usados para treinamento e são excluídos após 30 dias na quase totalidade dos casos, mas são retidos para monitoramento de segurança. Se você pretende usar o Mythos 5 com dados sensíveis, revise a documentação de suporte da Anthropic sobre essa política antes de fazer o deploy.
O Claude Mythos 5 é a sinalização mais clara da Anthropic de que a empresa pretende implantar IA de fronteira em contextos profissionais de alto risco—e os resultados comprovam isso.
O gap no SWE-bench Pro (80,3% vs 69,2%), no Terminal-Bench 2.1 (88,0% vs 82,7%) e no ExploitBench (78,0% vs 40,0%) indica um modelo que encara tarefas das mais difíceis com mais confiabilidade do que qualquer outra opção disponível.
O acesso restrito é uma abordagem razoável diante dos riscos de uso dual, e as pontuações no ExploitBench sustentam a ideia de que as ferramentas mais poderosas de segurança ofensiva não devem ser públicas. A questão é se a Anthropic vai conseguir expandir rápido o programa de acesso confiável para atender as comunidades mais amplas de segurança e pesquisa biomédica antes que os concorrentes reduzam a distância.
Para organizações que se qualificam, a atualização do Mythos Preview é simples e sai por menos da metade do preço.
Principais cursos de IA
{count, plural, one {Programa} other {Programas}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Khalid Abdelaty
15 min
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
9 min
{count, plural, one {blog} other {blogs}}
Ryan Ong
8 min
{count, plural, one {blog} other {blogs}}
Richie Cotton
7 min
{count, plural, one {blog} other {blogs}}
Natasha Al-Khatib
14 min
{count, plural, one {Tutorial} other {Tutoriais}}
Abid Ali Awan