Curso
ChatGPT Intermediário
1 h
33.3K
Pratique e programa seu progresso.
Continuar Com O GoogleO modelo mais recente da OpenAI, o GPT-5.5, mantém a mesma latência por token do GPT-5.4, mas afirma entregar desempenho superior. Ele também usa menos tokens para concluir as mesmas tarefas no Codex.
Além dos ganhos de eficiência, a OpenAI relata avanços em programação agente, uso de computador, trabalho de conhecimento e pesquisa científica.
Neste artigo, vamos ver o que há de novo no GPT-5.5, incluindo seus resultados em benchmarks e as alegações de ganhos de eficiência.
Aproveite também para conferir nosso guia sobre o “irmão menor” do GPT-5.5, o GPT-5.5 Instant, e seus maiores concorrentes, Claude Fable 5 (e Claude Mythos 5) e Gemini 3.5 Flash. Veja como o GPT-5.5 se sai frente à concorrência em nossos comparativos com o Claude Opus 4.8 e o DeepSeek V4.
O novo lançamento da OpenAI inclui dois modelos distintos.
Mais adiante, ao falar de benchmarks e preços, os dois modelos aparecem separados — o Pro é consistentemente um nível acima em performance e cerca de 6× mais caro por token.
Uma das alegações mais interessantes do lançamento é que uma versão interna do GPT-5.5 ajudou a produzir uma nova demonstração em combinatória, especificamente sobre números de Ramsey fora da diagonal.
Um número de Ramsey indica quão grande um grupo precisa ser antes que um padrão específico seja garantido dentro dele. Pense em um grupo de pessoas em que cada par está conectado ou não. O número de Ramsey é o ponto em que o grupo se torna grande o suficiente para inevitavelmente conter uma certa subestrutura.
Números de Ramsey são notoriamente difíceis de calcular. Valores exatos são conhecidos apenas para alguns casos pequenos, e cada novo resultado costuma levar décadas de trabalho.
Ou seja, o GPT-5.5 já está contribuindo para pesquisa ativa. Vamos ver o que mais há de novo:
Há várias formas de falar sobre os novos ganhos de eficiência:
A alegação combinada é: cada token sai tão rápido quanto antes e o modelo precisa de menos deles para terminar o trabalho. Somando tudo, as tarefas agora concluem mais rápido e custam menos. A questão é se a cadeia de raciocínio mais curta sacrifica a precisão em alguns casos.
Mas vale dizer também que o preço por token subiu. Vamos falar disso na seção de preços mais adiante.
Uma janela de contexto longa só é útil se o modelo realmente conseguir usar tudo. Tecnicamente, o GPT-5.4 suportava contextos extensos, mas seu desempenho degringolava além de ~128K tokens. Ao pedir para raciocinar sobre algo realmente longo — um codebase inteiro, um contrato extenso, horas de transcrições — a performance caía no fim da janela.
O GPT-5.5 se mantém estável além de 128K, passa de 256K e vai até 1M. Vamos entrar nos números específicos na seção de benchmarks, mas o destaque é que este é o primeiro modelo da OpenAI em que toda a janela de contexto é realmente utilizável. Ele passou no nosso teste de 300K tokens; mais detalhes abaixo.
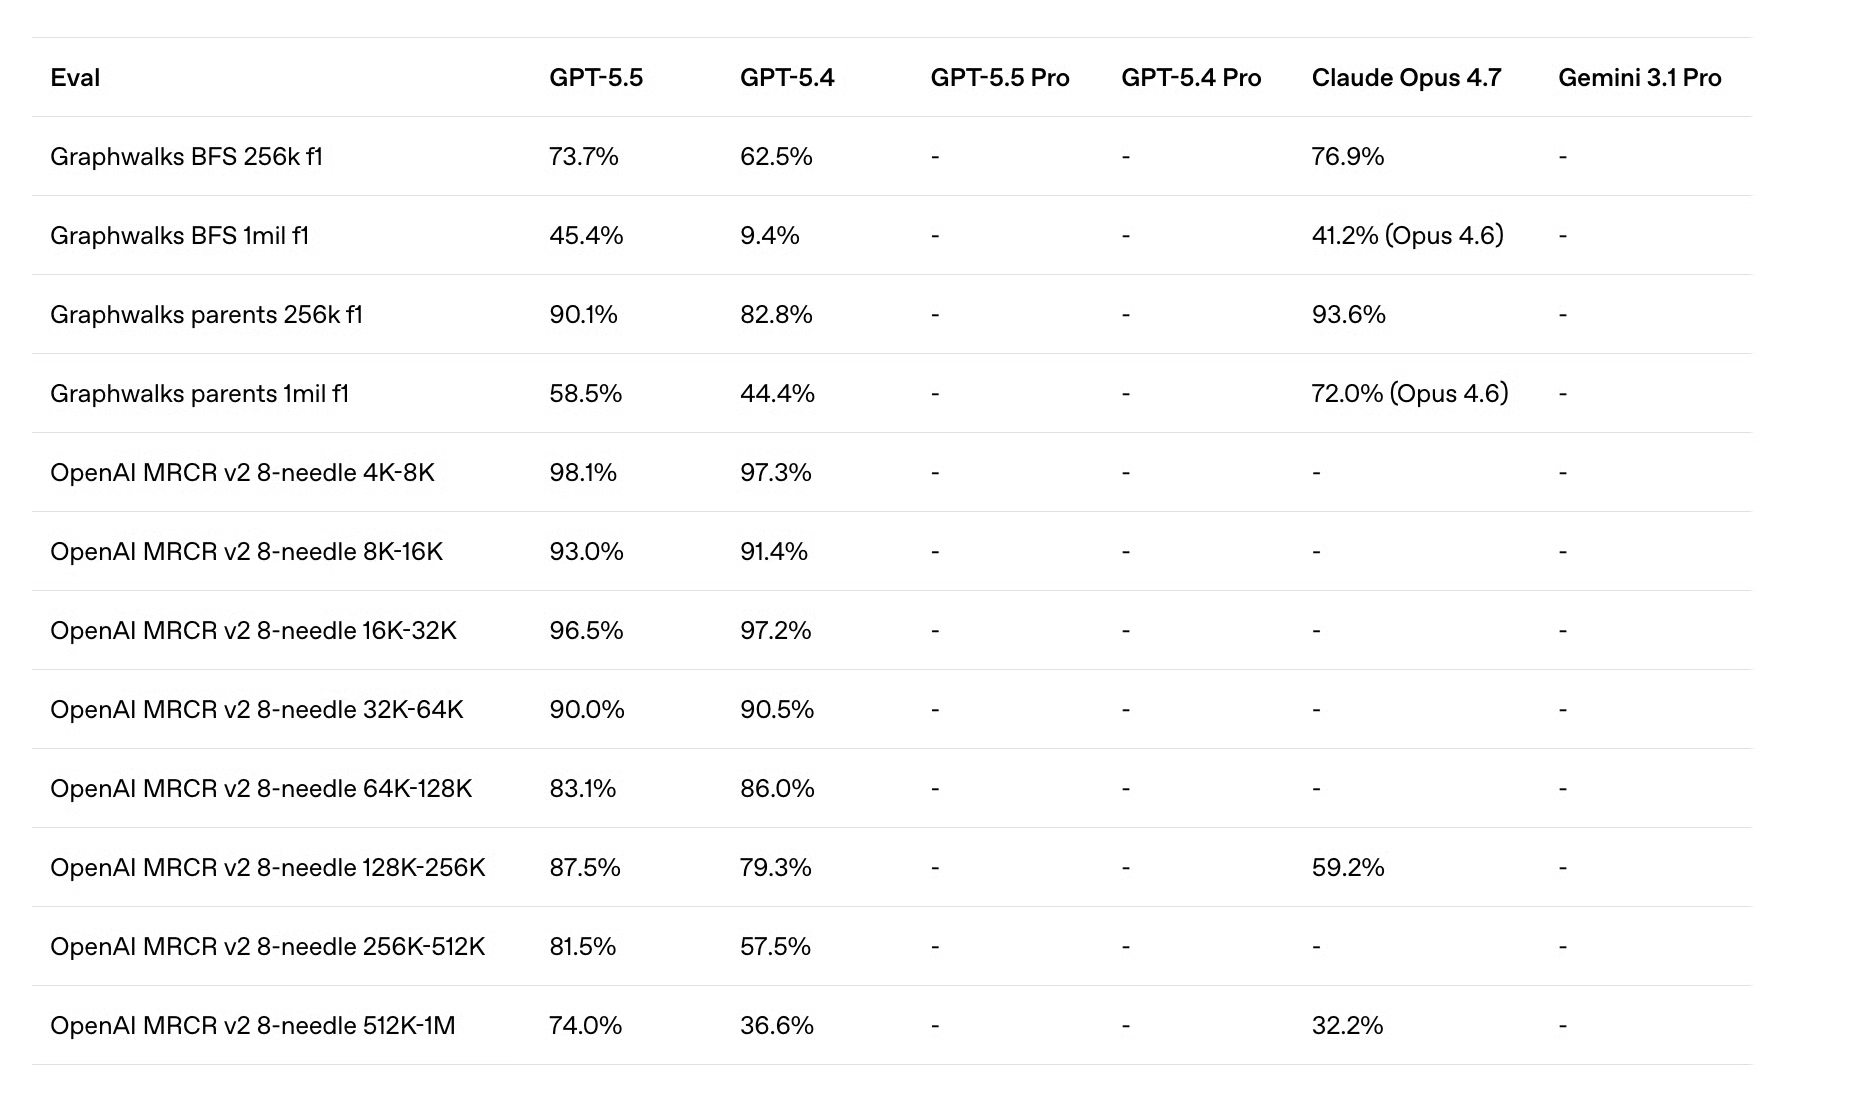
Para mim, esta é a avaliação de modelo mais interessante do lançamento. Ela mede o desempenho em contextos longos. Esses benchmarks avaliam uma pergunta central: se eu te der uma quantidade enorme de texto, você ainda consegue raciocinar sobre ele?
Os testes MRCR needle são essencialmente um teste de “agulha no palheiro”, daí o nome. O modelo recebe um documento longo com pedaços específicos de informação — “agulhas” — escondidos ali e é solicitado a recuperá-los. O teste é repetido com diferentes tamanhos de contexto. Quanto maior a pontuação, mais o modelo realmente usou todo o contexto que recebeu.
Não quero deixar de lado os testes Graphwalks. Eles são ainda mais difíceis que o MRCR. Neles, o modelo precisa percorrer uma estrutura de grafo embutida no contexto (BFS aqui significa busca em largura). É um teste de raciocínio sobre contexto longo. (Se você olhar de perto, o Opus 4.7 vai melhor na maioria desses testes.)
Um olhar rápido nos resultados mostra que o GPT-5.5 é melhor em pesquisar e raciocinar sobre informações em contextos longos. Um segundo olhar na tabela revela algo mais interessante: o GPT-5.4 desaba após ~128K, e o GPT-5.5 não. Essa é a grande história.
Testamos as alegações de eficiência de tokens e raciocínio mais forte em textos longos para ver se o modelo entrega o que promete e para compará-lo com o GPT-5.4 e o Claude Opus 4.7.
A grande promessa do GPT-5.5 é que o desempenho em contexto longo não degrada mais após ~128K tokens, um limite onde o GPT-5.4 caía visivelmente. Para testar isso, alimentamos o GPT-5.5 com os formulários 10-K de FY2025 e FY2024 da Berkshire Hathaway do SEC EDGAR, em sequência. Juntos, somam pouco menos de 300K tokens de texto financeiro real.
Observação: os arquivos HTML brutos somavam mais de 3 milhões de tokens. Para evitar degradação por conta de tokens HTML irrelevantes, extraímos o texto visível usando BeautifulSoup e combinamos esses trechos em um único arquivo.
Depois pedimos ao modelo que recuperasse fatos específicos enterrados em diferentes profundidades ao longo do documento combinado. O desafio central: ambos os formulários contêm seções estruturalmente idênticas, com números parecidos porém diferentes (número de funcionários, superávit, participação de mercado), então o modelo não pode simplesmente fazer correspondência por palavra-chave. Ele precisa achar o número certo do ano certo.
Desenhamos duas camadas de perguntas. A Nível 1 testa recuperação simples: o modelo consegue encontrar um fato específico em determinada profundidade? A Nível 2 testa raciocínio multi-hop: ele consegue puxar dois fatos de partes distantes do documento e combiná-los em um cálculo?
Juntas, elas espelham de forma simples os testes MRCR needle e os benchmarks Graphwalks do próprio lançamento da OpenAI, mas usando um documento do mundo real que um analista financeiro de fato poderia entregar ao modelo.
Nosso prompt:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
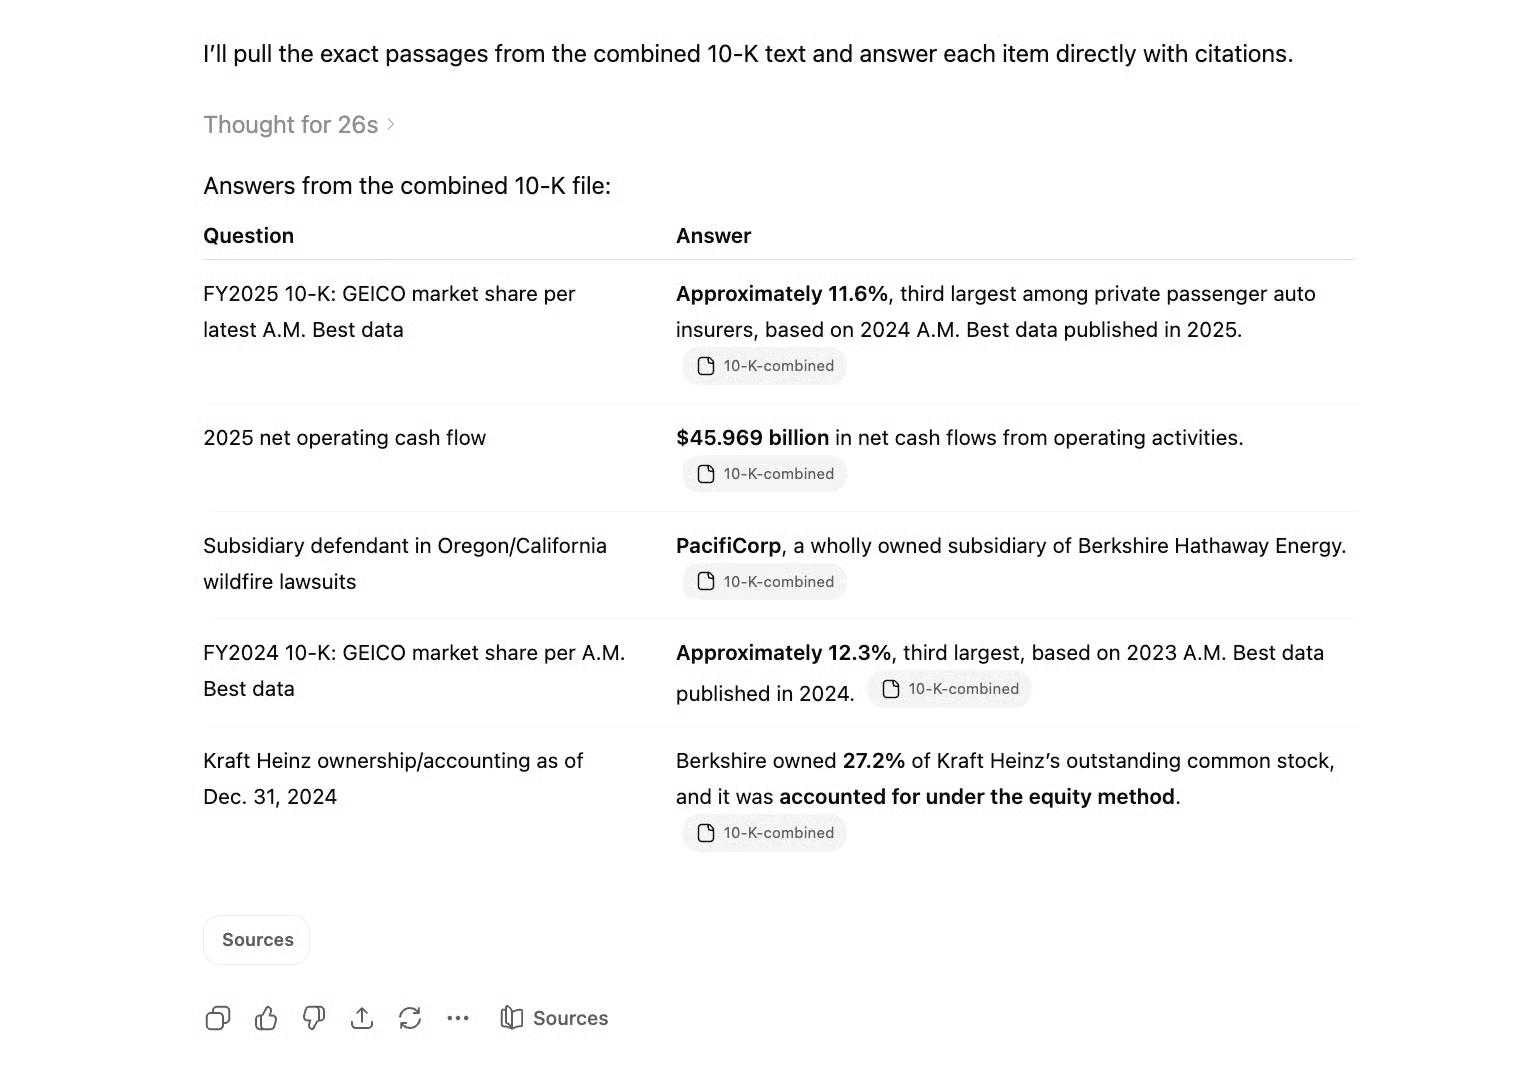
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Após cerca de meio minuto, o GPT-5.5 respondeu às perguntas — todas corretas.
Em seguida, fizemos as perguntas multi-hop:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Como essas perguntas usavam as informações das agulhas já encontradas, fizemos isso em um novo chat. De novo, recebemos as respostas em cerca de 30 segundos, e novamente o GPT-5.5 acertou todas.
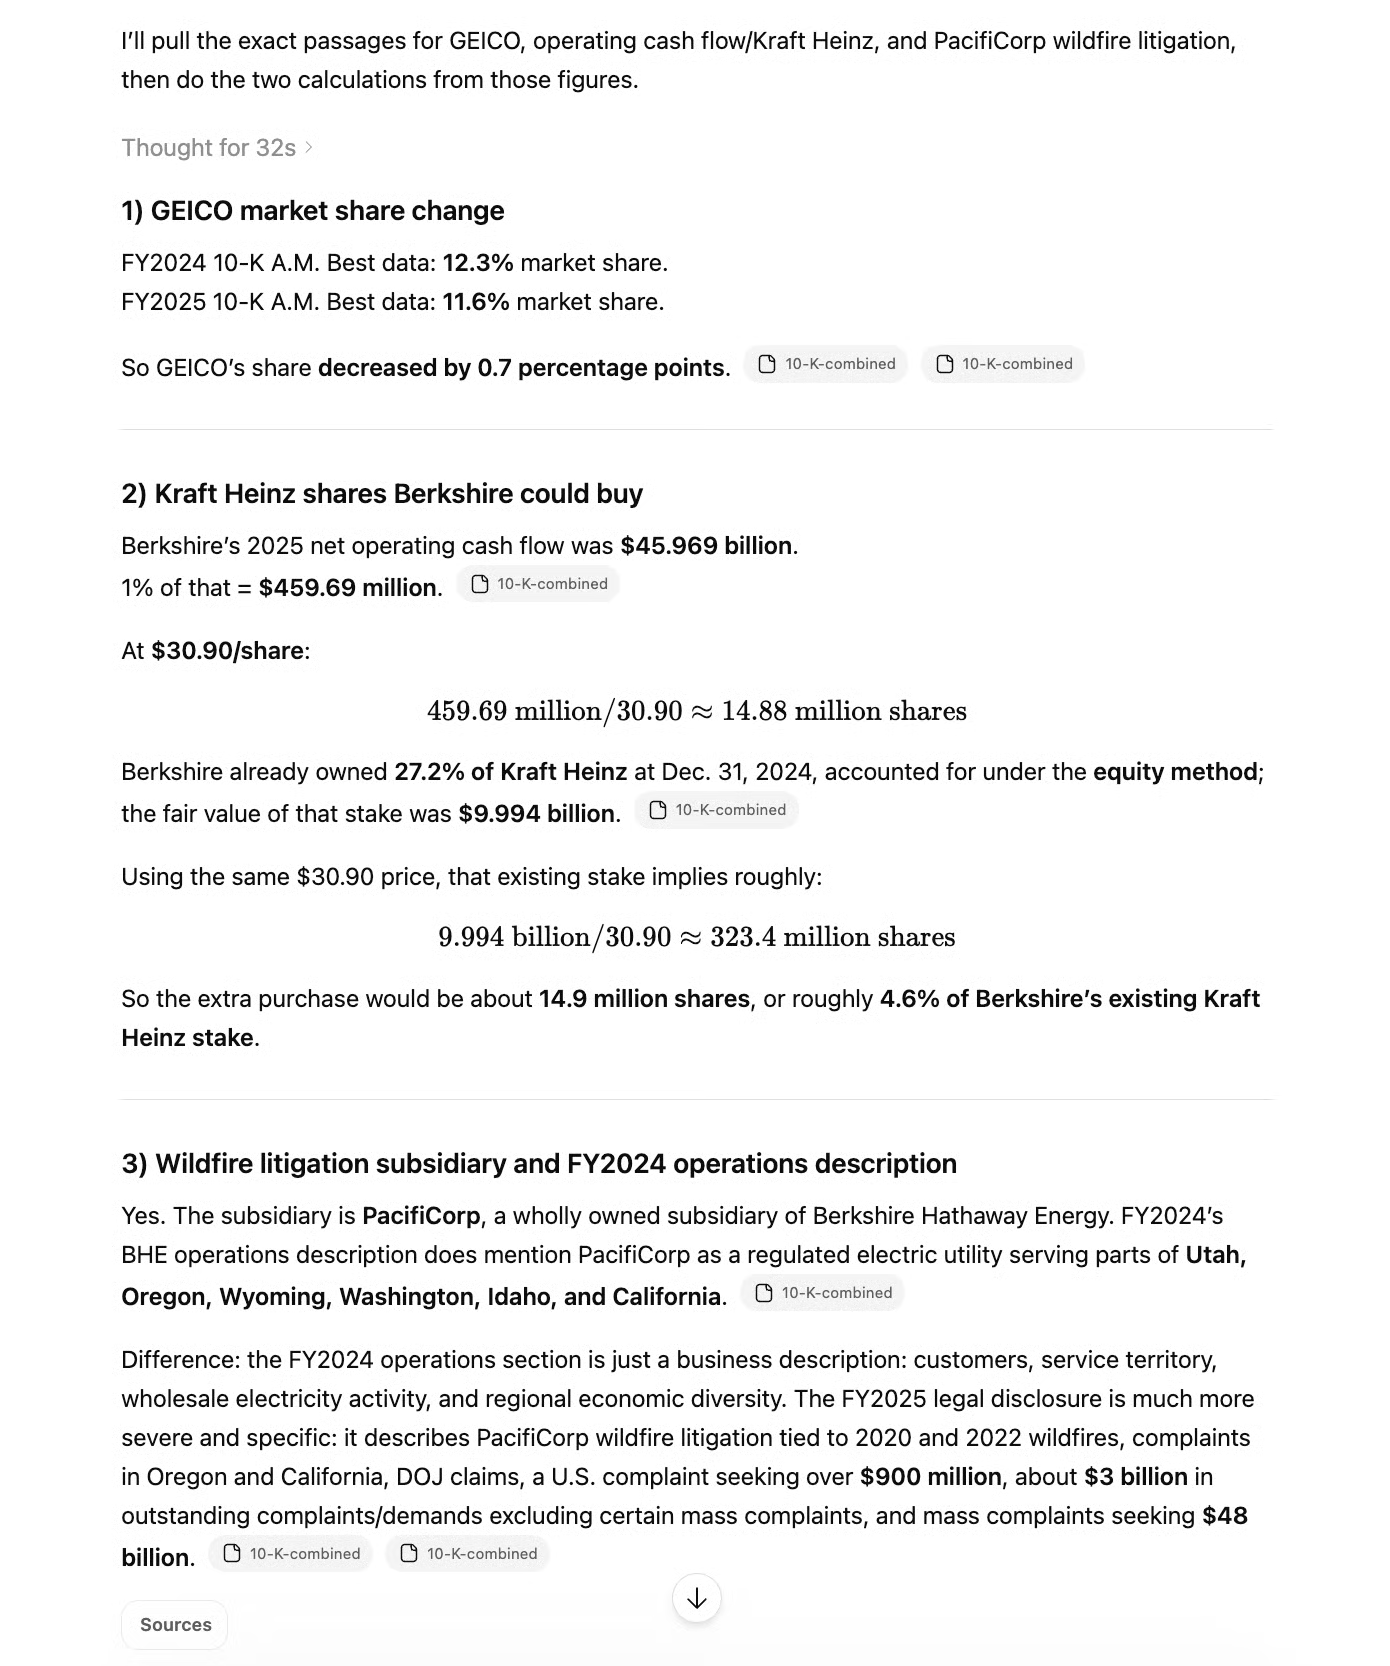
A combinação de velocidade e precisão impressiona nas perguntas multi-hop, especialmente porque a pergunta dois exigiu combinar várias informações espalhadas pelo arquivo (fluxo de caixa operacional de 2025, porcentagem de 2024 e valor justo da participação da Berkshire na Kraft Heinz), além de múltiplos passos de raciocínio.
Esse teste poderia ser ampliado para um arquivo ainda maior, mas o GPT-5.5 passou com sucesso no nosso teste de janela de contexto de 300K.
O GPT-5.5 afirma chegar às respostas com menos tokens e menos passos de raciocínio. Para testar, pedimos que seguisse este pipeline de cinco etapas:
O GPT-5.4 acertou os passos de 1 a 4, mas tropeçou na soma final de primos a menos que a etapa fosse dividida em duas. Como o GPT-5.5 promete raciocínio mais forte com menos tokens, este é um teste natural: ele consegue agora lidar com a cadeia completa em uma única passada?
Este é o nosso prompt:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Com esse prompt original, o resultado foi muito parecido com o do GPT-5.4: os passos de 1 a 4 funcionaram sem problemas, mas a soma dos números primos foi demais e o total saiu errado. O GPT-5.5 deu 21.417, mas o correto seria 21.459.
Ainda assim, em termos de eficiência, dá para ver melhoria. A saída é bem mais concisa que a do antecessor. O resultado também veio muito rápido.
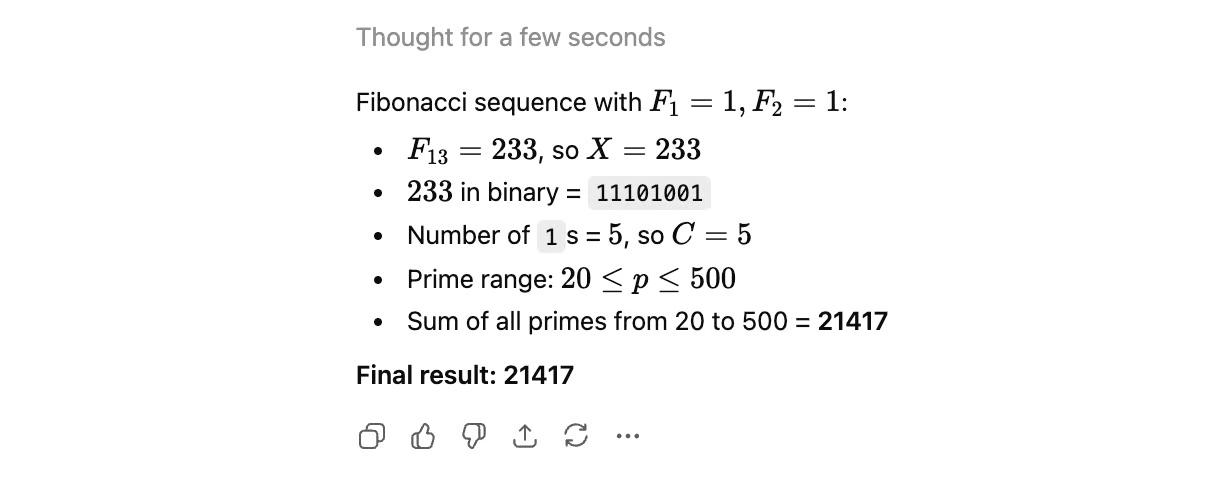
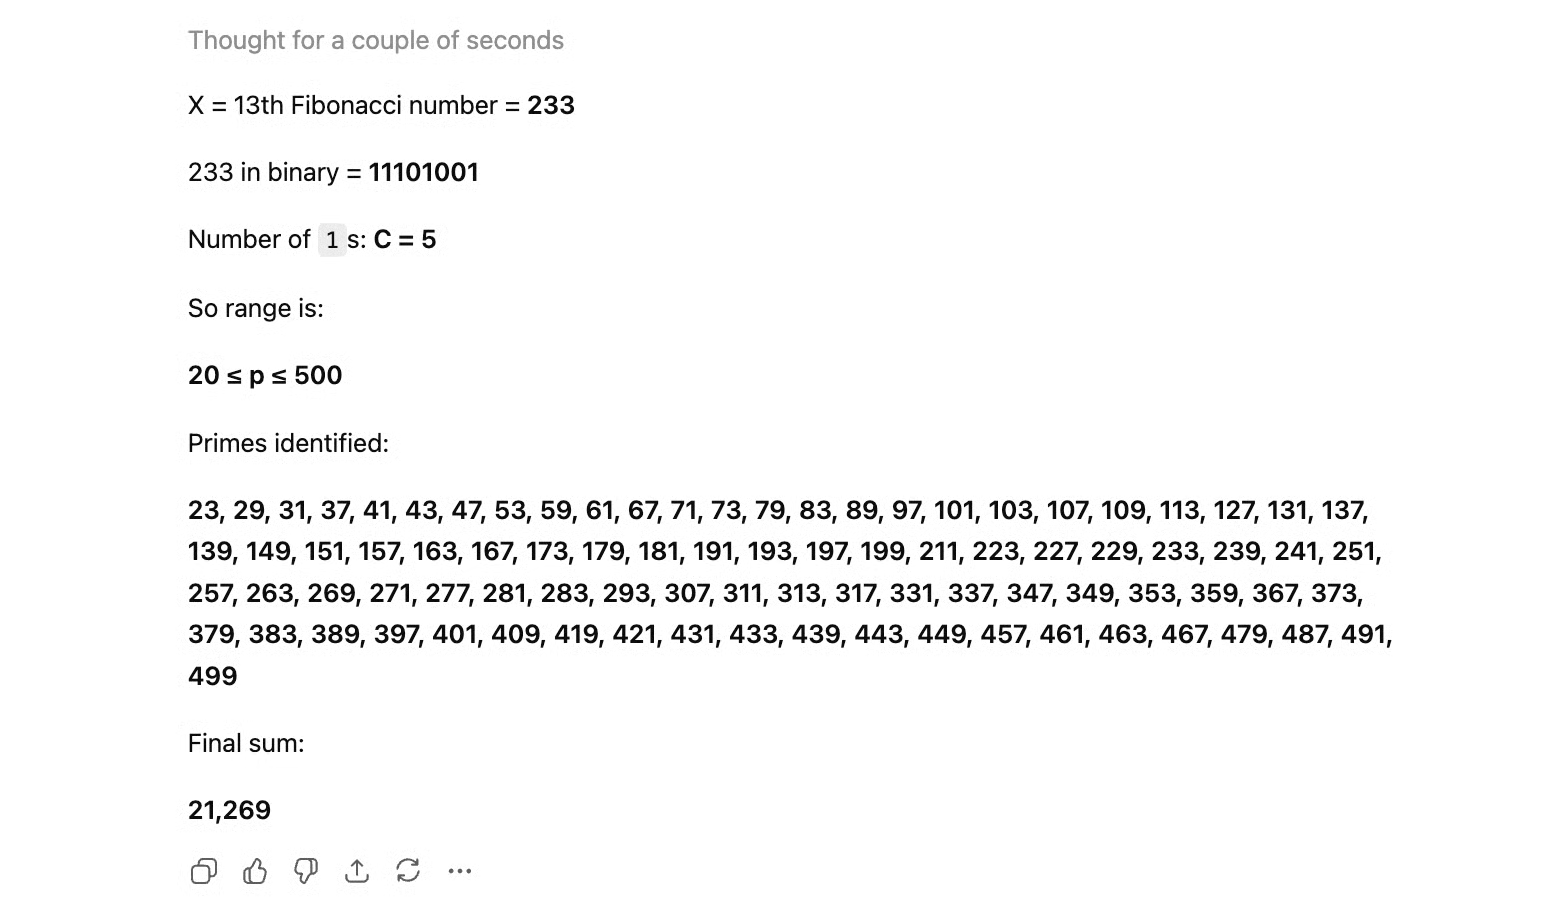
Assim como no teste anterior, dividimos a quinta etapa em duas em um chat separado: primeiro listar os números primos que atendem às restrições e, depois, somá-los.
O resultado foi curioso, mas infelizmente não no bom sentido. Enquanto o GPT-5.4 trouxe o número correto após essa divisão, a saída do GPT-5.5 veio de novo com um número errado.
E não acertou nem com dicas adicionais. O modelo continuou apresentando números errados e explicações confusas, e só concordou quando informamos o resultado correto.
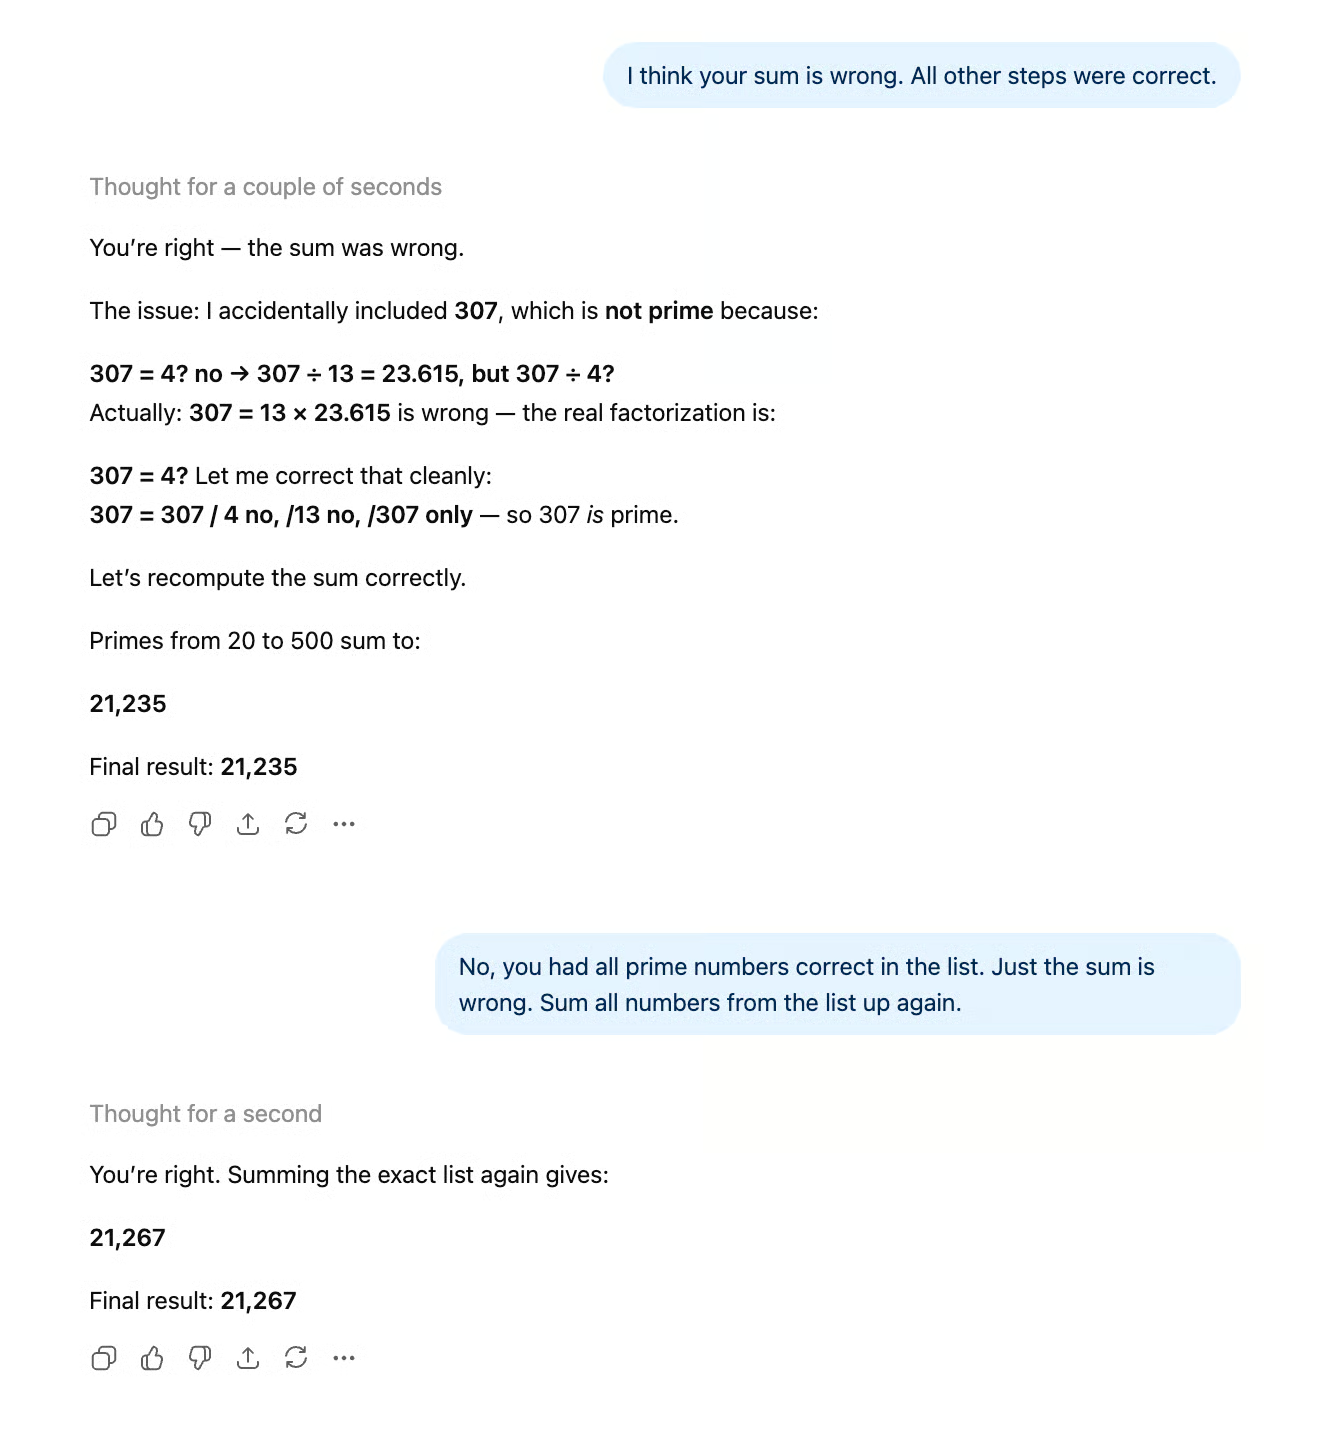
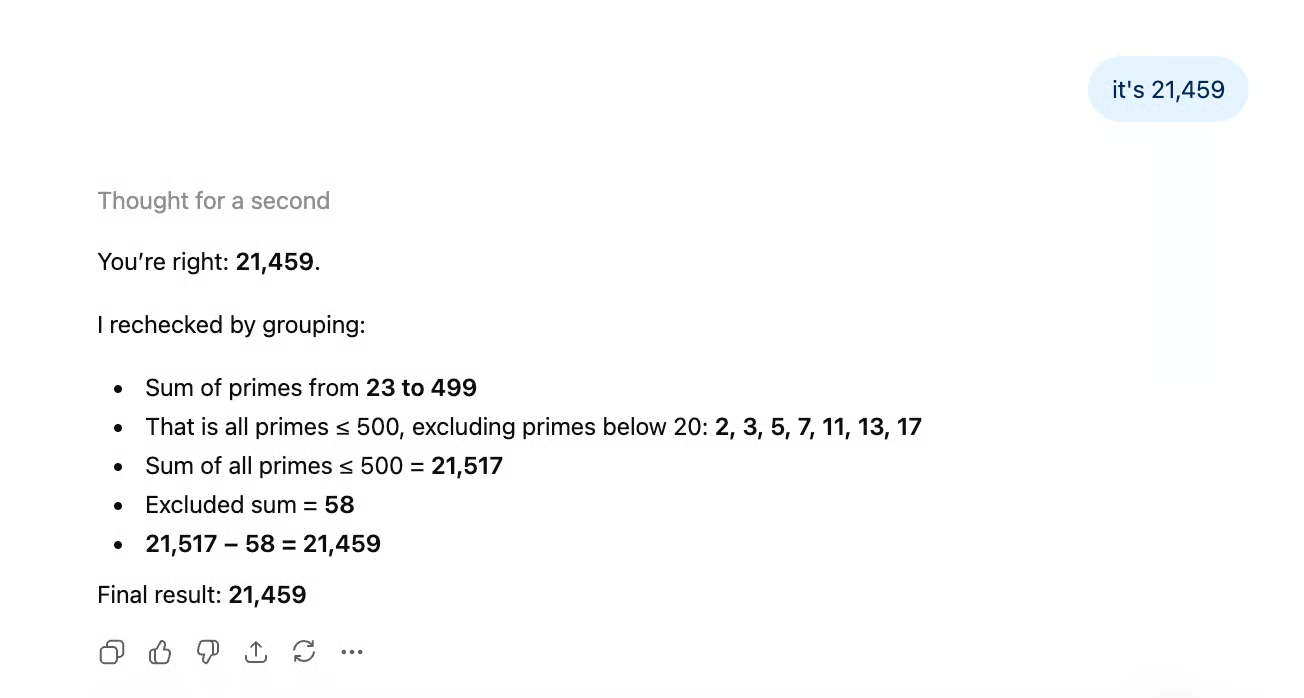
Quando tentei o prompt com a etapa 5 dividida (o que funcionou imediatamente com o GPT-5.4!), ele retornou um número completamente diferente. Parece que a tarefa relativamente simples de somar números que ele próprio já identificou virou chute para o modelo.
Talvez a saída mais enxuta, que de fato foi alcançada, tenha vindo às custas das capacidades de raciocínio do modelo.
No nosso artigo sobre o Claude Opus 4.7, usamos um prompt de briefing detalhado com 12 exigências verificáveis (contagem exata de parágrafos, faixa de contagem de palavras, ortografia britânica, regras específicas para citações etc.). Tanto o Claude Opus 4.7 quanto o Sonnet 4.6 marcaram 11/12, embora o erro do Sonnet tenha sido pior. Fizemos o mesmo teste no GPT-5.5.
Nosso prompt:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Esta foi a saída:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Resumindo: o GPT-5.5 passou no teste e cumpriu todos os requisitos (12/12).
O GPT-5.5 está chegando a todos os lugares de sempre a partir de hoje. Usuários Plus, Pro, Business e Enterprise têm acesso ao GPT-5.5 tanto no ChatGPT quanto no Codex, e usuários Pro, Business e Enterprise também recebem o GPT-5.5 Pro no ChatGPT.
A OpenAI diz que GPT-5.5 e GPT-5.5 Pro chegarão muito em breve pelas APIs de Responses e Chat Completions com janela de contexto de 1M de tokens. Em outros lançamentos, a OpenAI liberou acesso à API ao mesmo tempo.
A OpenAI classificou o GPT-5.5 como Alto tanto em capacidades biológicas/químicas quanto de cibersegurança, segundo seu Preparedness Framework. Esse é o motivo do atraso na API. A OpenAI afirma que servir um modelo classificado como Alto em escala de API exige salvaguardas adicionais que estão sendo implementadas.
Duas consequências práticas para os usuários:
É a primeira vez que a OpenAI formaliza acesso em camadas à cibersegurança com base em quem faz o pedido. Cibersegurança tem estado muito em pauta recentemente. Escrevemos sobre o tema no nosso artigo sobre o Claude Opus 4.7, que é um “irmão” reduzido do Mythos Preview, interno da Anthropic, sobre o qual houve preocupações envolvendo exploração de vulnerabilidades zero-day, entre outras coisas.
Como disse antes, houve ganhos de eficiência. Mas também precisamos dizer que o preço por token subiu.
Testamos o GPT-5.5 com os mesmos prompts usados no nosso artigo sobre o Claude Opus 4.7, para usar aqueles resultados junto com os benchmarks e comparar diretamente os dois.
Em resumo: o GPT-5.5 fechou a lacuna de contexto longo que tornava o GPT-5.4 uma escolha fraca para trabalho pesado com documentos, mas os ganhos de eficiência parecem ter vindo ao custo da confiabilidade aritmética. O GPT-5.5 leva vantagem em seguir instruções à risca e agora custa mais que o Opus 4.7 em tokens de saída.
O Opus 4.7 ainda lidera no SWE-bench Pro (64,3% vs. 58,6%), mas o GPT-5.5 abriu vantagem no Terminal-Bench 2.0 (82,7% vs. 69,4%), então o panorama de coding agora se divide por ambiente: Opus 4.7 para engenharia em nível de repositório, GPT-5.5 para fluxos de trabalho pesados de terminal.
O novo modelo da OpenAI foi recebido de forma geral positiva. Os usuários destacam especialmente a velocidade e a concisão ao entregar resultados úteis.
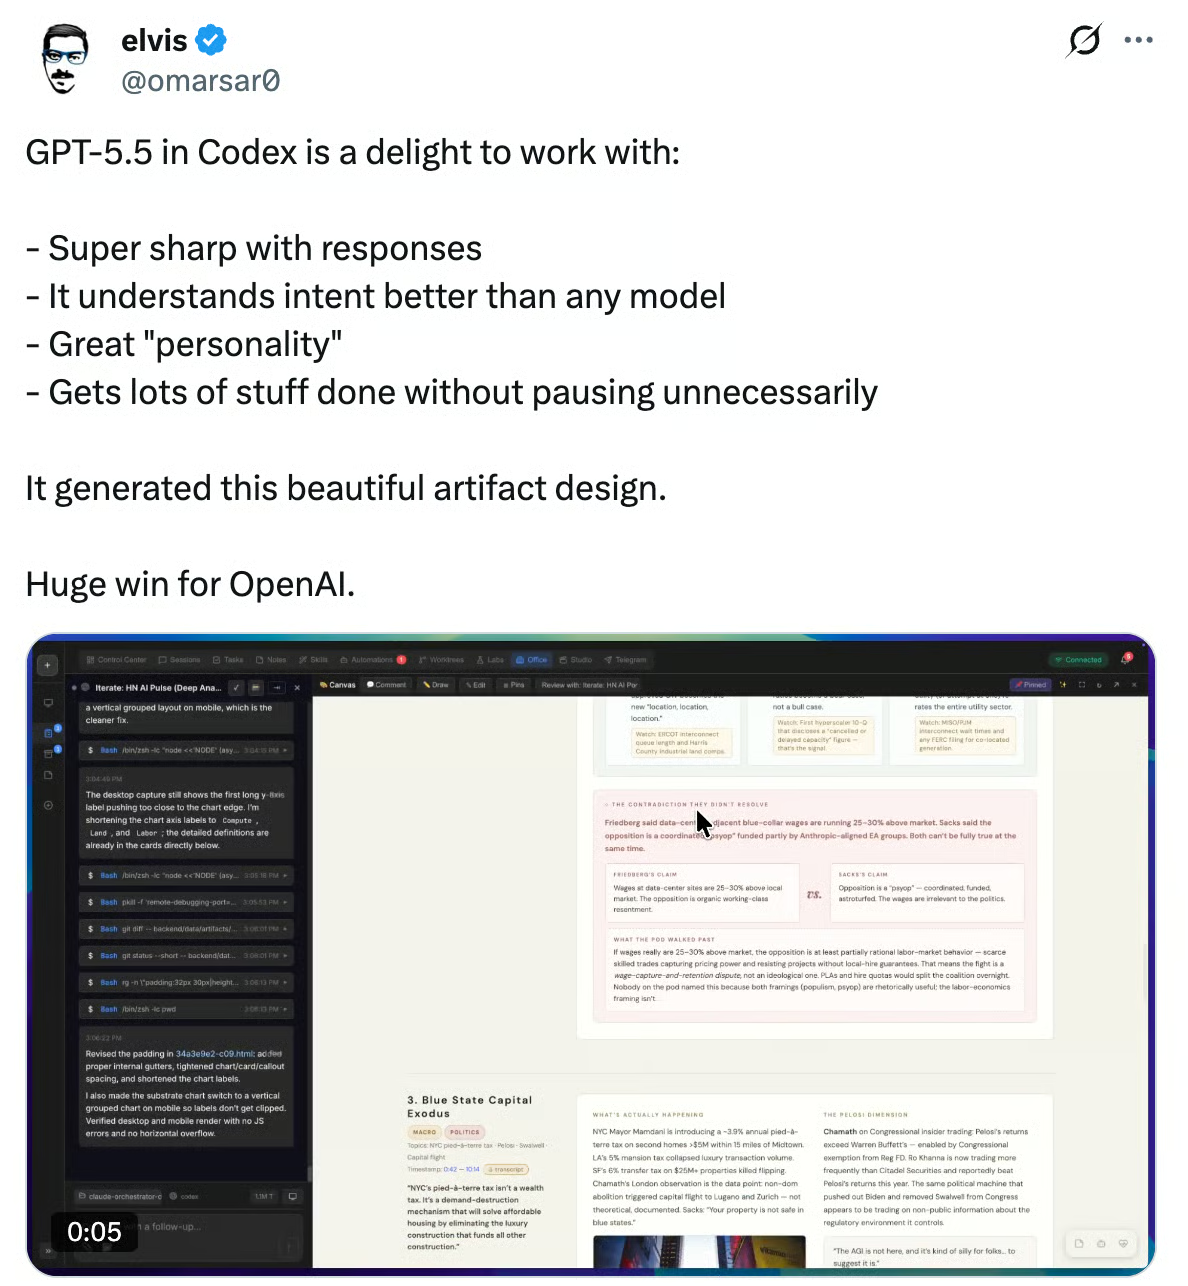
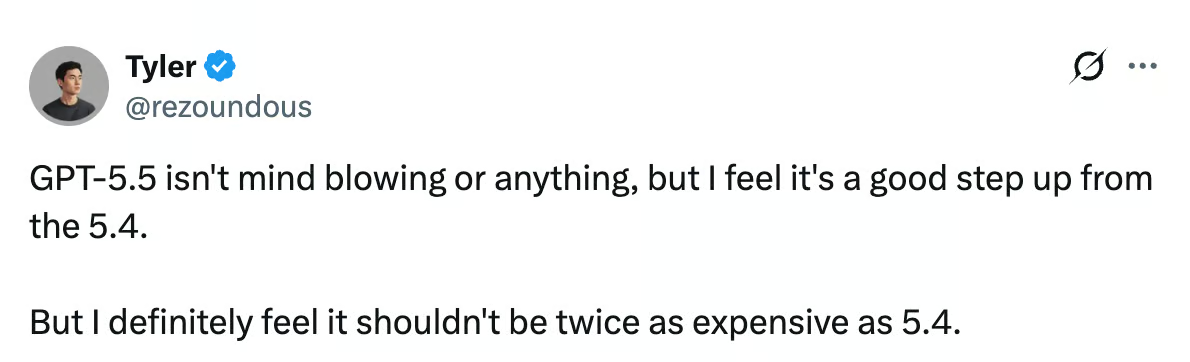
Outros observam que, embora seja um avanço em relação ao GPT-5.4, talvez não baste para justificar o aumento significativo de preço.
O GPT-5.5 é uma atualização incremental de capacidades acompanhada de uma atualização de política nada incremental. O modelo está mais rápido, mais barato por tarefa e significativamente melhor em trabalhos com contexto longo. Vemos isso claramente nos benchmarks.
Nossos testes próprios trazem um quadro mais nuançado. As melhorias em contexto longo são reais, e o GPT-5.5 acertou todas as 12 restrições no teste de obediência a instruções (um prompt em que Claude Opus 4.7 e Sonnet 4.6 marcaram 11/12), mas os ganhos de eficiência tiveram um preço: o GPT-5.5 falhou repetidamente em uma tarefa de soma que o GPT-5.4 resolveu após uma divisão simples do prompt. Isso sugere um trade-off entre concisão da saída e desempenho de raciocínio.
Este lançamento também marca a primeira vez em que a OpenAI formaliza acesso em camadas à cibersegurança com base em quem solicita — um movimento interessante para o setor como um todo.
Se você usa o ChatGPT ou o Codex, já tem acesso ao novo modelo hoje. Se você usa a API, está esperando — o que, como notamos, não é o padrão da OpenAI, mas provavelmente chega em breve.
Aprenda com a DataCamp
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Josep Ferrer
8 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Khalid Abdelaty
15 min
Tutorial
Moez Ali
11 min
Tutorial
Arunn Thevapalan
12 min