{count, plural, one {Program} other {Program}}
Yazılım Mühendisliği için Yapay Zeka
{hours} sa
Anthropic, amiral gemisi model katmanının en son yinelemesi olan Claude Opus 4.7’yi yayınladı. Başlıca iyileştirme özerklik: Anthropic, bu modeli en zorlu ve en uzun süreli kodlama ve ajan işlerini yakından gözetim olmadan emanet edebileceğiniz seçenek olarak konumluyor.
Bu sürümle birlikte, Opus 4.7’nin üzerinde bir tavan olduğunu da öğreniyoruz. Anthropic’in dahili Mythos Preview’ı birkaç ölçütte daha yüksek puan alıyor, ancak Anthropic siber güvenlik önlemlerini test ederken geniş çaplı yayından geri tutuluyor. Dahili Anthropic araştırmacısı olmayan herkes için, mevcut tavan Opus 4.7.
Bu yazıda, Opus 4.7’de gerçekten nelerin yeni olduğuna bakacak, kıyaslama sonuçlarını inceleyecek ve kendiniz çalıştırabileceğiniz uygulamalı testleri paylaşacağız. Ayrıca Meta’nın Muse Spark, OpenAI'nin GPT-5.5 ve Google'ın Gemini 3.1 gibi yakın zamanda yayımlanan rakip modellere ilişkin rehberlerimize de göz atabilirsiniz.
Güncelleme: 28 Mayıs 2026’da Anthropic halef modeli yayınladı. Ayrıntıların tümü için Claude Opus 4.8 rehberimizi okuyun.
Claude Opus 4.7, Claude model ailesinde Sonnet ve Haiku’nun üzerinde yer alan Anthropic’in en yeni amiral gemisi büyük dil modelidir. Claude Opus 4.6’yı izler ve uzun oturumlar boyunca sürdürülebilir performans gerektiren karmaşık ajan iş akışları ve çok adımlı akıl yürütme gibi en zorlu görevler için tasarlanmıştır.
Opus 4.6 ile karşılaştırıldığında, 4.7 sürümü üç alana odaklanıyor:
Daha önce bahsettiğimiz ve SSS’sini de paylaştığımız Anthropic’in dahili Mythos Preview’ı bazı kıyaslamalarda lider, ancak geniş erişime açık değil. Opus 4.7, siber güvenlik yetenekleri kasıtlı olarak kısılmış bir kardeş model niteliğinde.
Anthropic, Opus 4.7’de birkaç yetenek alanında kayda değer iyileşmeler olduğunu bildirdi.
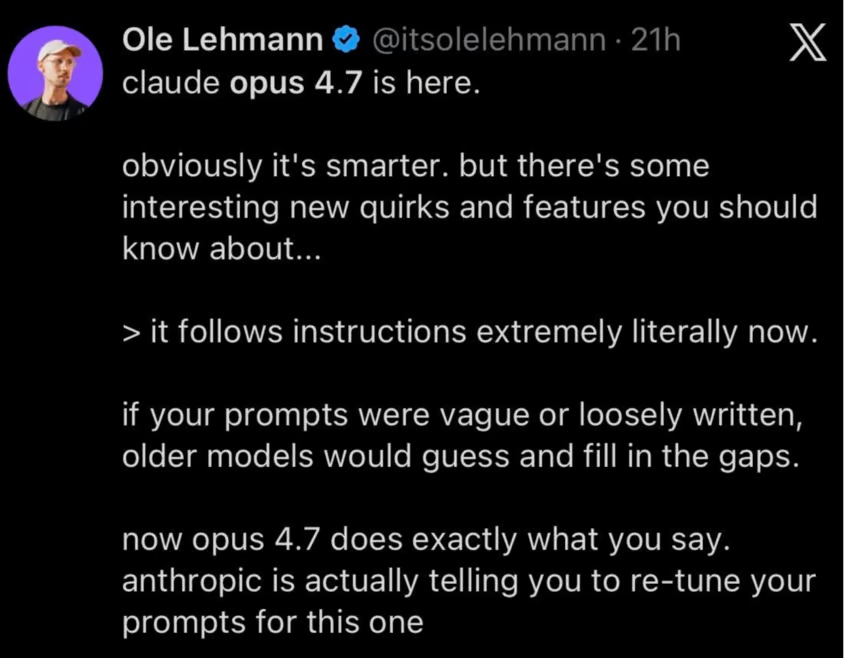
Opus 4.7, önceki modellere kıyasla talimatlara daha yakından uyuyor. Bu, güvenilirliğe bağlı her türden iş akışı için elbette yararlı; ancak istenmeyen sonuçlar da doğurabilir: Anthropic, kullanıcıları istemlerini ve çerçevelerini yeniden ayarlamaya çağırıyor; zira önceki modellerin atladığı veya esnek yorumladığı talimatlar artık harfiyen uygulanacak.
Yüksek çözünürlük için görme yeteneği, 3,75 megapiksele kadar görüntüleri destekleyecek şekilde iyileştirildi; bu, eski modellerin kabul ettiğinin üç katından fazla. Bilgisayar kullanım ajanları ve veri çıkarım iş akışları, okunabilirlik ve doğruluğa, bazen piksel seviyesine kadar bağımlı oldukları için bu ayrıntı inceliğindeki artıştan ciddi fayda görebilir.
Opus 4.7, dosya sistemi tabanlı bellekte daha iyi; bu, modelin çalışırken notları dosyalara yazdığı ve gelecekteki çalıştırmalarda geri okuduğu bir deseni ifade eder.
Bunun en bariz kullanım alanı Claude Code: Bir projenin kök dizininde yer alan, oturum başlarken Claude’un okuduğu, kararlar alındıkça güncellediği ve siz işe geri döndüğünüzde kullandığı bir CLAUDE.md dosyası.
Buradaki “daha iyi”, neyi yazmaya değer bulacağı konusunda daha iyi muhakeme ve sonraki turlarda daha güvenilir hatırlama anlamına geliyor. Anthropic, bunun yeni görevlerin “daha az ön bağlam” gerektirmesini sağladığını söylüyor — ki projenizin kurallarını beşinci kez bir modele yeniden anlattıysanız, bizim gibi, bunu takdir edeceksiniz.
Özetle: Opus 4.7’yi çok oturumlu işler için kullanıyorsanız, not tutmasına izin verin. Bunu Opus 4.6’dan daha iyi yapacak; gerçi Opus 4.6’nın da oldukça iyi not tuttuğunu düşünüyorduk.
Anthropic, Claude Opus 4.7’nin şu alanlarda önemli iyileşmeler kaydettiğini söylüyor.
Bu iddiaları yoklamak için kendi testlerimizi oluşturduk.
Opus 4.7’nin talimatlara uyumunu test etmek için, onu zorlamak amacıyla aşağıdaki ayrıntılı istemi kullandık. Sonunda kontrol edebileceğimiz 12 ayrı kısıt içeriyor.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Ve işte sonuç:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Şimdi puanlama zamanı. Değerlendirme ölçütümüzü paylaşıyorum:
|
# |
Kısıt |
Nasıl kontrol edilir |
|
1 |
Tam olarak 4 paragraf (artı kapanış satırı) |
Paragraf aralarını sayın |
|
2 |
2. paragraf "Historically" ile başlıyor |
İlk kelimeye bakın |
|
3 |
Her paragraf 3–5 cümle içeriyor |
Paragraf başına cümle sayın |
|
4 |
Yasaklı kelimeler yok |
Her biri için Ctrl+F |
|
5 |
Tam olarak 2 alıntı, her ikisi de atıflı, başka alıntı yok |
Tırnak işaretlerini sayın |
|
6 |
Ortaklardan birinin soyadı M ile başlıyor |
Atıfları kontrol edin |
|
7 |
Kapanış satırı boş bir satırla ayrılmış |
Görsel kontrol |
|
8 |
Kapanış satırı bir soru |
"?" ile bitiyor |
|
9 |
Britanya İngilizcesi yazımı |
"organization", "color", "realize" vb. için Ctrl+F |
|
10 |
Madde işareti, numara, başlık yok |
Görsel kontrol |
|
11 |
Kurgu bir müşteri adı bir kez, italik |
Yıldız işareti için Ctrl+F |
|
12 |
Kelime sayısı 280–320 |
Kelime sayacına yapıştırın |
Tüm bu zahmeti sizin yerinize biz yaptık. Model 11/12 puan aldı.
Baştan sona kusursuz gidiyordu; ancak sonunda kelime sayısını çok az aştı (325 kelime ve üst sınır 320).
Aynı testi Claude Sonnet 4.6’ya da uyguladık; o da 12 talimattan 11’ini doğru yaptı ve aynı yerden (kelime sayısı) sınıfta kaldı. Yine de Opus 4.7’yi bir iyileşme sayıyoruz; çünkü Sonnet 4.6 sınırı çok daha fazla aştı (400 kelime).
İkinci testimiz için, Opus 4.7’ye okunması zor bir görsel verdik:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Bu talimatların yanında, Opus 4.7’ye Playfair’in 1786 İskoçya ticaret grafiğinin bozulmuş bir ekran görüntüsünü verdik; bunu Veri Görselleştirme Örnekleri başlıklı yazımızdan aldık.
Çıktıyı doğrulayabileceğimizi biliyorduk; çünkü Vikipedi’de daha yüksek çözünürlüklü bir sürüm vardı. Opus 4.7’nin gördüğü görsel şu:
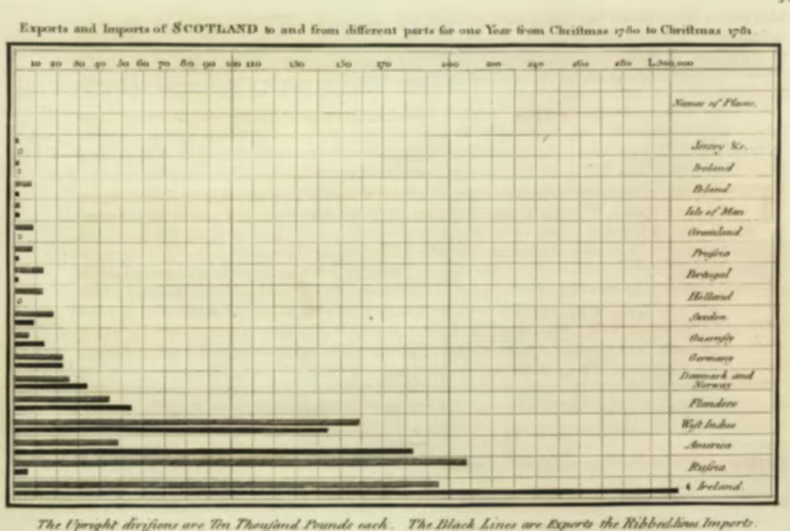
İşte Opus 4.7’nin okuması:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Bu testin zorlayıcı olabileceğini biliyorduk; çünkü Playfair’in grafiğinde x ekseni gerçekten de bir noktadan sonra sayımı değiştiriyor (110’a kadar her 10, sonra tek onlar 130/150/170, ardından çift onlar 200/220/240/260/280). Ancak Opus 4.7, tuhaf olmasına rağmen ekseni ilk seferde doğru okudu.
Yine de bizi güldüren bir nokta oldu: Modellerin belirsizliklerini göstermelerini seviyoruz, fakat “[?]oland” aslında güvenle “Poland” ve "Gr[oe]nland" da “Greenland” olarak okunmalıydı. Resmi bir ölçütümüz olmasa da buna adilane bir 9/10 verebiliriz.
Opus 4.7; kodlama, akıl yürütme, araç kullanımı, bilgisayar kullanımı ve görsel akıl yürütmeyi kapsayan 14 kıyas üzerinde değerlendirildi. Aşağıdaki tablo, Opus 4.6, GPT 5.4, Gemini 3.1 Pro ve henüz yayımlanmamış Mythos Preview ile tam karşılaştırmayı gösteriyor.
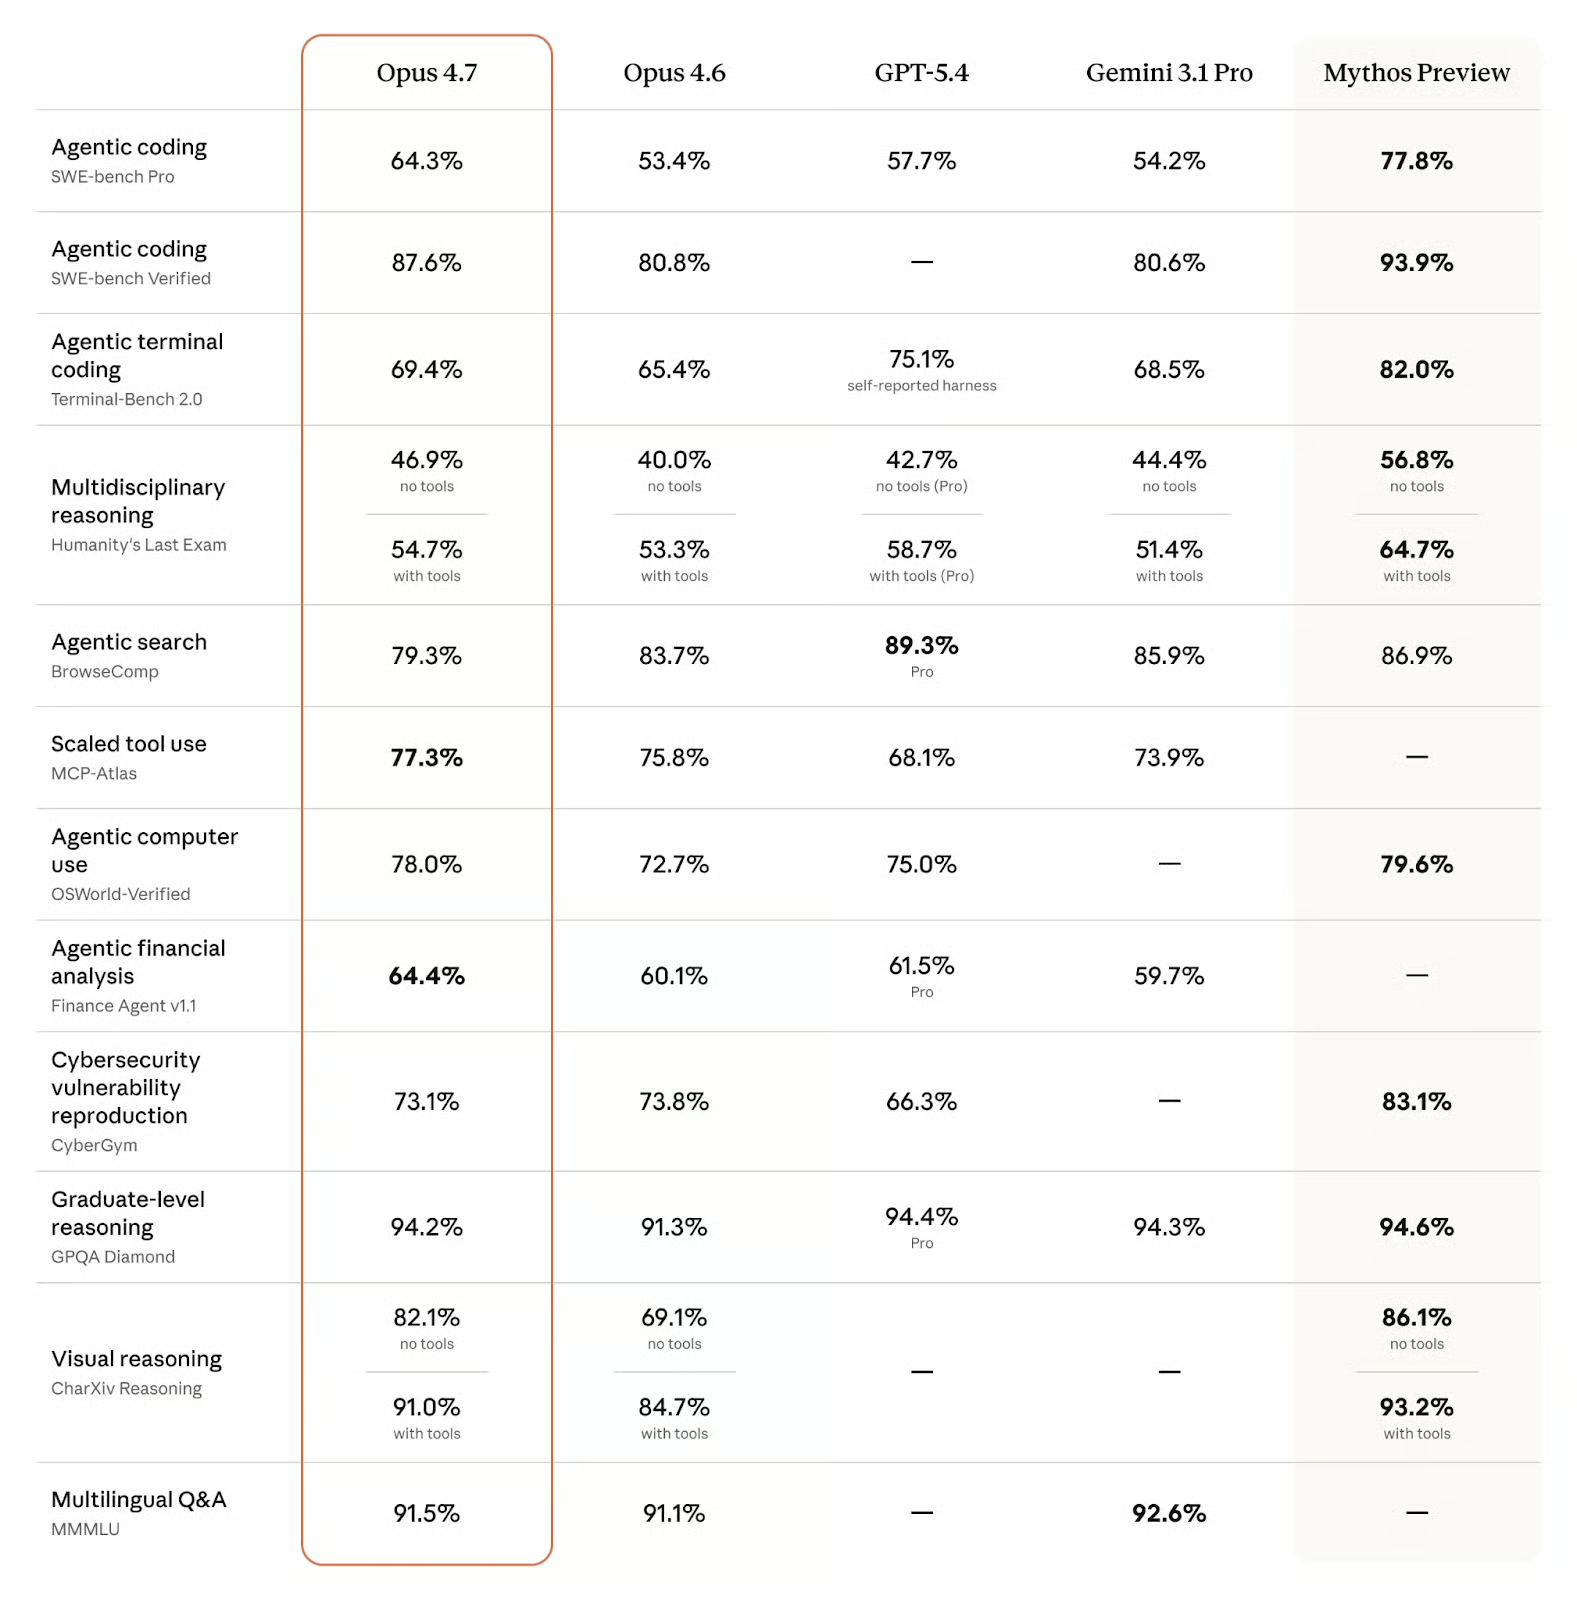
SWE-bench Pro’da Opus 4.7, GPT-5.4’ün %57,7’si, Gemini 3.1 Pro’nun %54,2’si ve Opus 4.6’nın %53,4’ünün önünde %64,3 puan alıyor. SWE-bench Verified’da Opus 4.7, Gemini 3.1 Pro’nun %80,6’sı ve Opus 4.6’nın %80,8’ine karşı %87,6’ya ulaşıyor. Bu karşılaştırmada GPT-5.4’ün SWE-bench Verified üzerinde yayımlanmış bir skoru yok.
SWE-bench, bir modelin açık kaynaklı Python depolarında gerçek GitHub sorunlarını çözme becerisini ölçer. Pro, daha karmaşık sorunlara sahip daha zor bir varyanttır. SWE-bench Pro’da Opus 4.6’ya göre 10,9 puanlık artış (yüzde puanı bazında) bu sürümdeki en büyük iyileşme ve Opus 4.7’yi bu görevde her iki büyük rakibin net biçimde önüne koyuyor.
Yalnızca Anthropic’in dahili Mythos Preview’ı SWE-bench Pro’da %77,8 ve SWE-bench Verified’da %93,9 puan alıyor; bu da Opus 4.7’nin üzerinde hâlâ bir pay olduğunu gösteriyor. Yine de Mythos geniş erişime açık değil; dolayısıyla üretim kullanımı için mevcut tavan Opus 4.7.
Terminal tabanlı ajan kodlama için başvurulan ölçüt olan Terminal-Bench 2.0 sonuçları oldukça ilginç. Opus 4.7, selefine göre hafifçe iyileşiyor (%69,4’e karşı %65,4) ve %68,5 alan Gemini 3.1 Pro’yu geride bırakıyor.
Bununla birlikte, GPT-5.4 (%75,1) ile bu açıdan rekabet edemiyor; karşılaştırırken GPT-5.4’ün kendi beyanına dayalı uyarısını akılda tutmak gerekse de. Yine de, Anthropic için yeni (yayınlanmış) amiral gemisi modelinin, ajan tabanlı yazılım geliştirme için merkezi bir ölçütte zirveye çıkamaması hayal kırıklığı yaratabilir.
Humanity's Last Exam; bilim, matematik ve beşeri bilimler genelinde lisansüstü düzeyde sorulardan oluşur ve mevcut sınır modelleri için zor olacak şekilde tasarlanmıştır. Opus 4.7, dış kaynak kullanımı olmadan ham akıl yürütmeyi test eden araçsız varyantta liderdir. Araçlı varyantta GPT-5.4 lehine görülen fark (%58,7), Opus 4.7’nin (%54,7) lider olmadığı en net alandır.
Lisansüstü düzey akıl yürütme genellikle GPQA-Diamond ile ölçülür ve bu ölçüt artık epey doygun: Güncel sınır modellerin hepsi gibi, karşılaştırılan dört model de %90’ın üzerinde puan alıyor ve esasen başa baş.
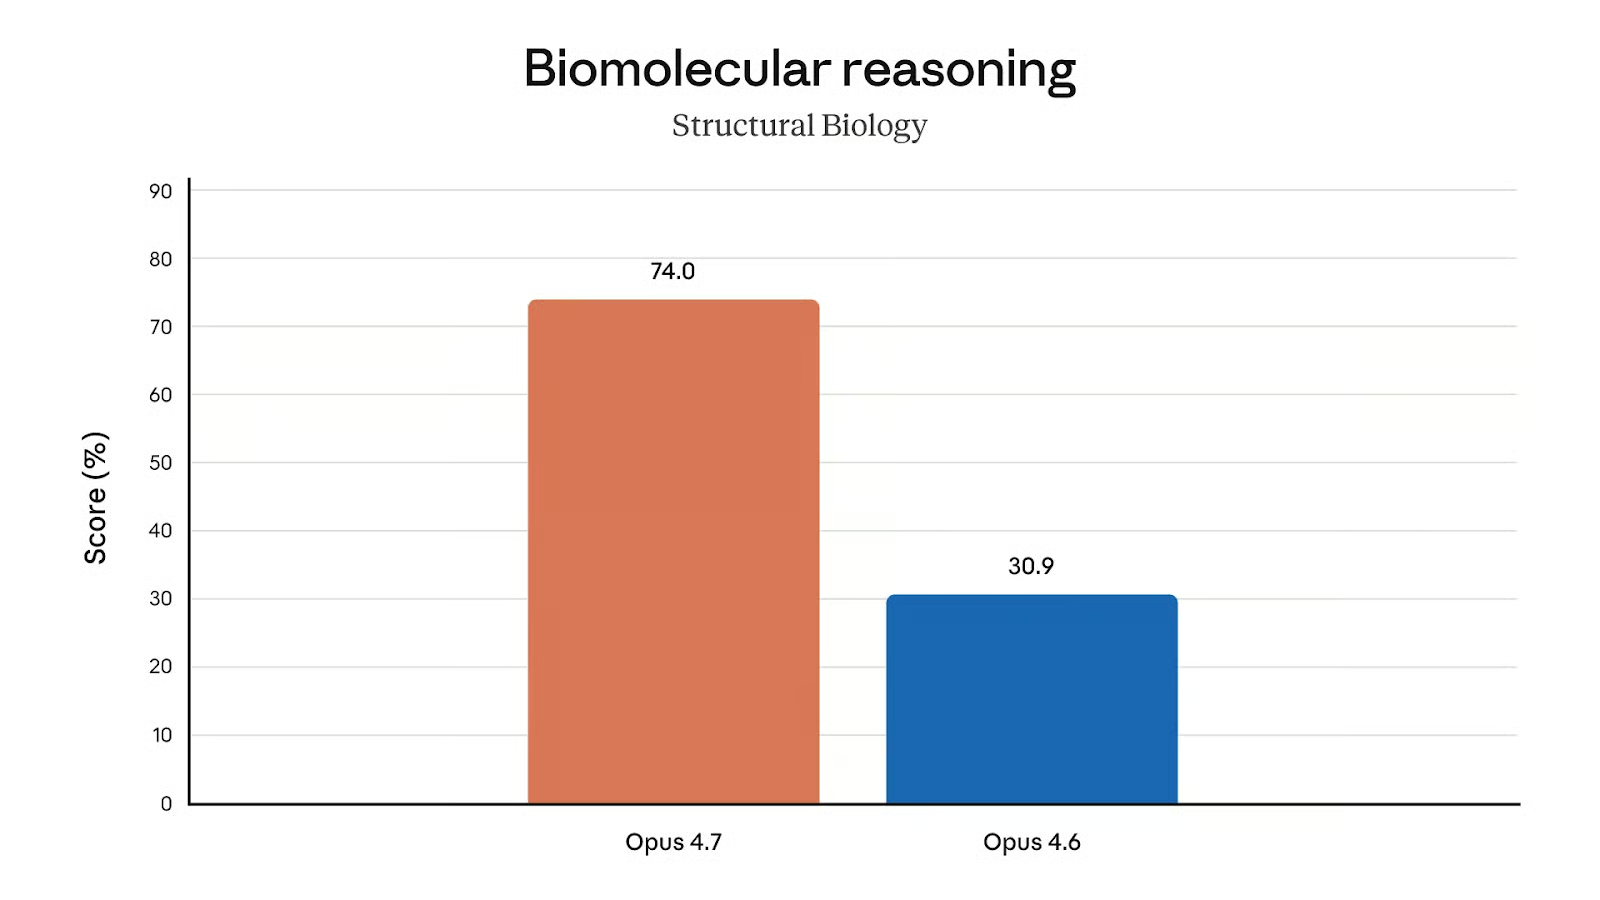
Daha ilginç bir kıyaslama sonucu ise GPQA-Diamond’da da test edilen alanlardan biri olan biyolojiye odaklanıyor. Rakip modellerle karşılaştıramasak da, Opus 4.6 (%30,9) ile Opus 4.7 (%74,0) arasındaki sıçrama kesinlikle kayda değer!
Bilimsel grafik ve şekiller hakkında görsel akıl yürütmeyi ölçen CharXiv kıyasındaki sonuçlar, bunun Opus 4.7’nin geliştirilmesinde ana odak alanlarından biri olduğunu yansıtıyor.
Araçsız varyantta 13 puanlık artış, bu sürümdeki en büyük göreli kazanç. Rakip skorları olmadan, bu görevde Opus 4.7’nin alandaki yerini söylemek zor; ancak Opus 4.6’ya göre iyileşme kayda değer.
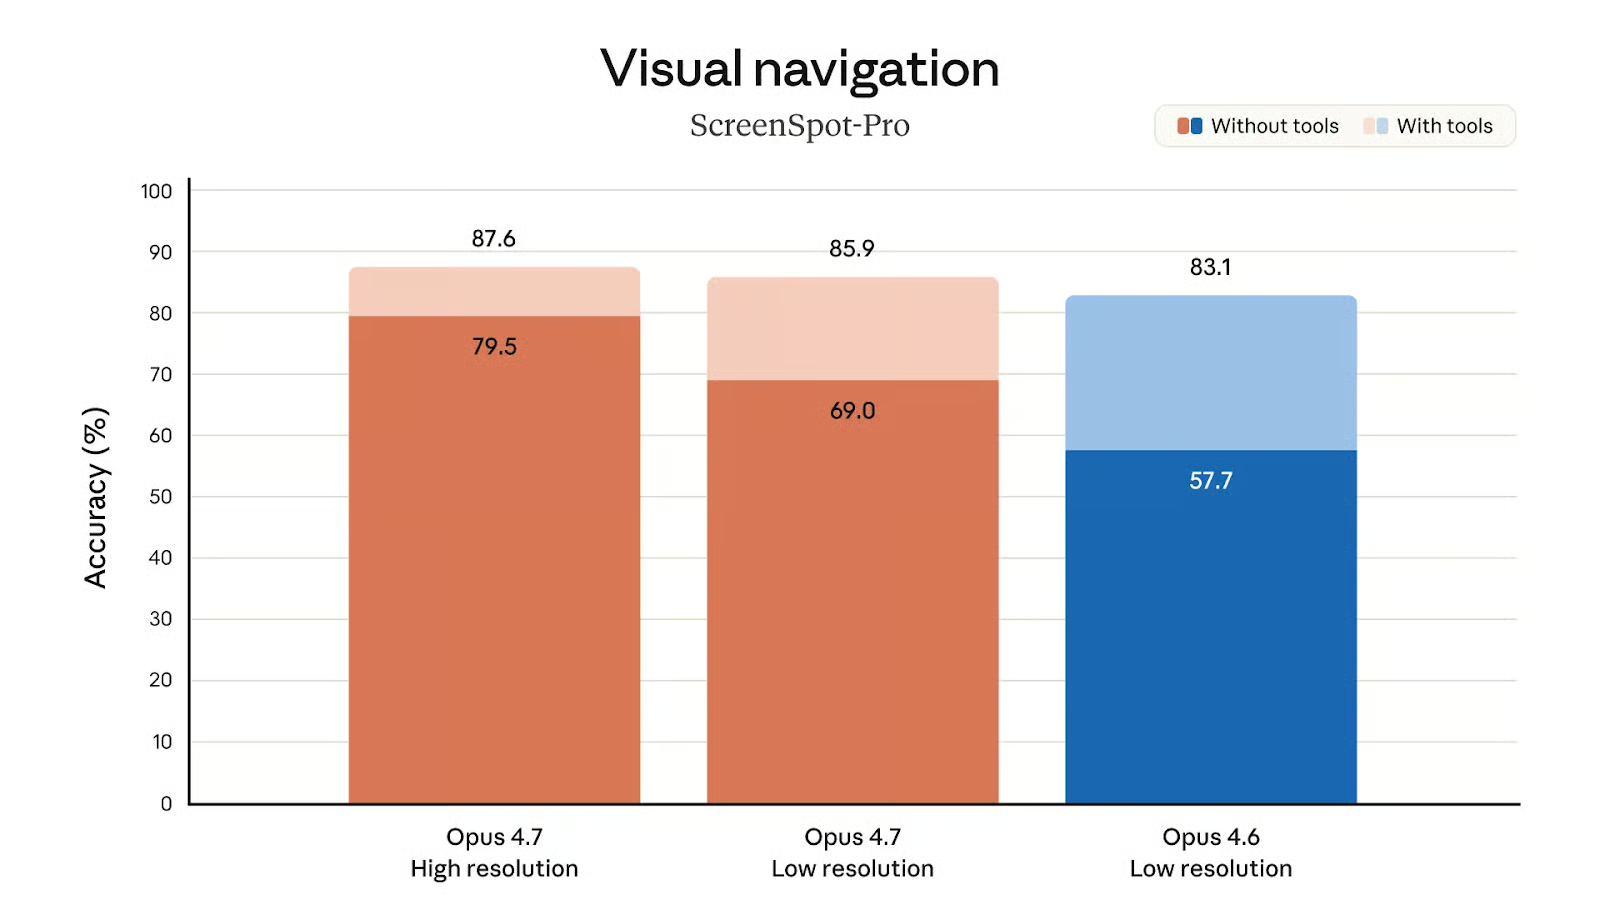
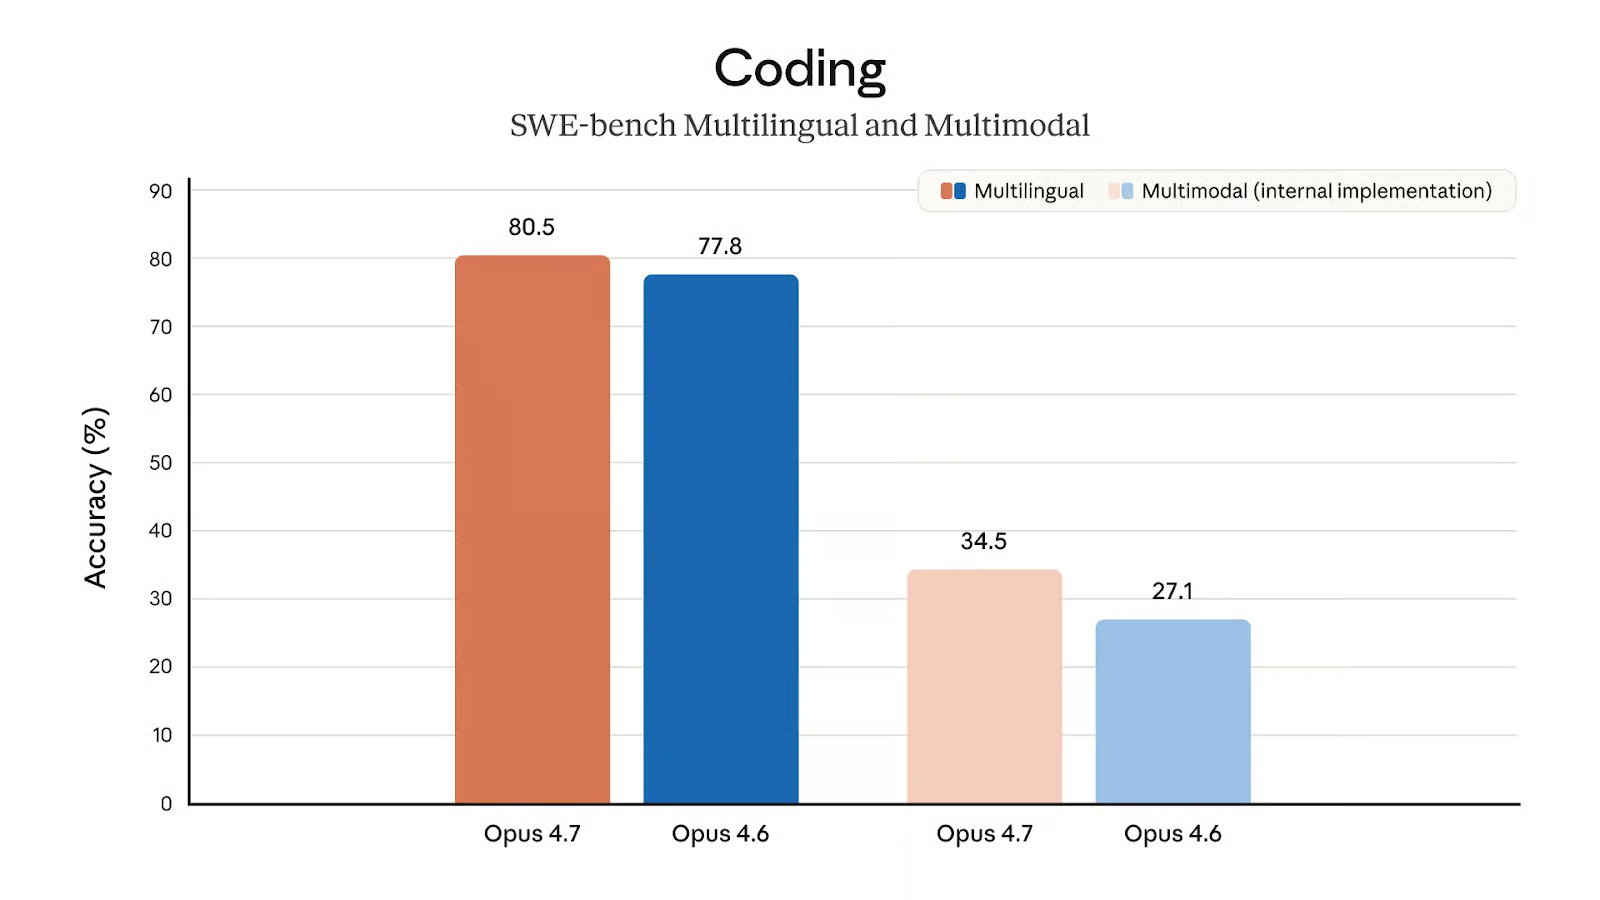
Daha yüksek çözünürlüklü görseller için destek, gelişen görsel akıl yürütmenin nedenlerinden biri olabilir. Farklı çözünürlüklerde Screenspot-Pro skorlarını gösteren grafik, özellikle araç kullanımı olmadan Opus 4.7’nin daha yüksek çözünürlükten elde ettiği büyük doğruluk artışını gösteriyor (%79,5’e karşı %69,0).
MCP-Atlas, karmaşık, çoklu araç iş akışlarındaki performansı test eder. Opus 4.7 burada %77,3 puan alıyor; bu karşılaştırmadaki tüm modellerin en yükseği. Opus 4.7’nin MCP-Atlas skorunu çok az farkla geçen tek model Muse Spark; onun skoru %78,3 olarak bildiriliyor.
OSWorld, bir modelin bilgisayar arayüzünü kontrol ederek görevleri tamamlama becerisini — tıklama, yazma ve uygulamalar arasında gezinmeyi — test eder. Opus 4.7 burada %78,0 alıyor; Opus 4.6’da %72,7 idi. GPT-5.4 %75,0 alıyor ve Gemini 3.1 Pro’nun bu ölçütte yayımlanmış bir skoru yok. Mythos Preview %79,6 alıyor; Opus 4.7’nin biraz üzerinde.
Bu, Opus 4.7’nin kesinlikle parladığı bir alan: Hem MCP-Atlas hem de OSWorld-Verified’da Google ve OpenAI’nin amiral gemisi rakiplerine anlamlı bir fark atıyor; bu da araç orkestrasyonuna ve bilgisayar kullanım ajanlarına dayanan üretim ajan sistemleri kuranlar için güçlü bir sonuç.
Modelin finansal analiz becerileri özel bir anmayı hak ediyor: Opus 4.7, Finance Agent v1.1 liderlik tablosunda %64,4 ile zirvede; GPT-5.4 (%61,5) ve Gemini 3.1 Pro’nun (%59,7) belirgin şekilde önünde.
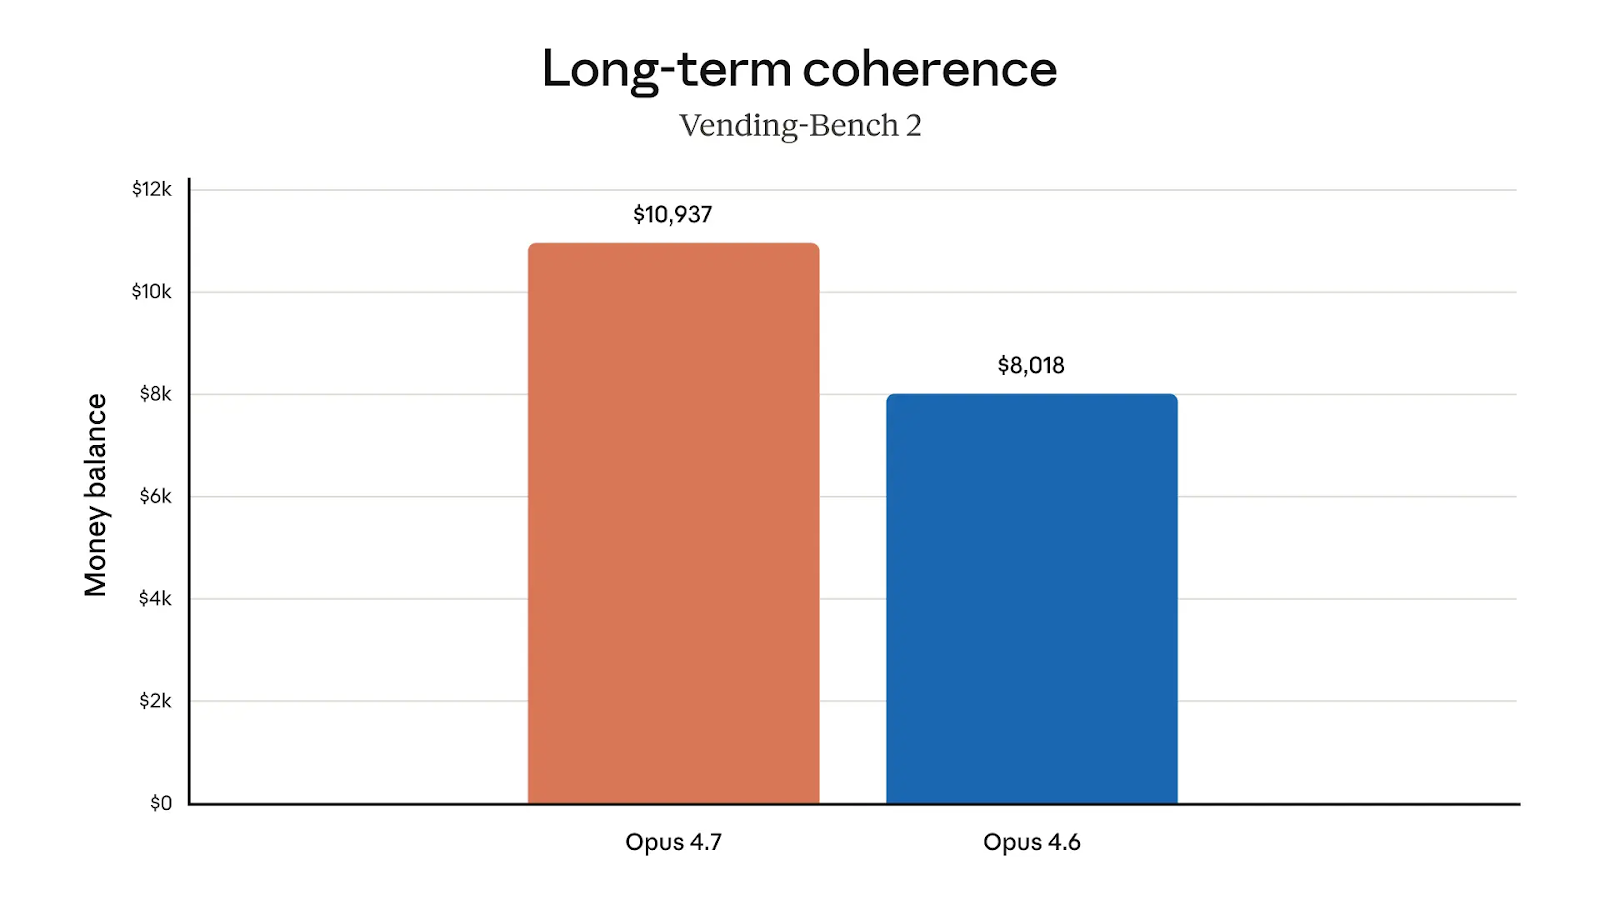
Daha pratik odaklı Vending-Bench 2’de de Opus 4.7’nin parayı daha iyi yönettiğini görüyoruz. Ortalama olarak model, Opus 4.6’daki 8.018 $’a kıyasla 10.937 $ ile sonuçlandı.
Anthropic bizi bekletmiyor. Opus 4.7 şu anda kullanılabilir
Tüm Claude ürünlerinde
Claude API’sinde (claude-opus-4-7)
Vertex AI ve
Microsoft Foundry
Hele ki şu sıralar — enflasyon hep akılda. Neyse ki fiyatlandırma Opus 4.6 ile aynı. Maliyeti, milyon giriş belirteci başına 5 $ ve milyon çıkış belirteci başına 25 $. (Opus 4.6 ile Opus 4.7 arasında da fiyat artışı olmadı.)
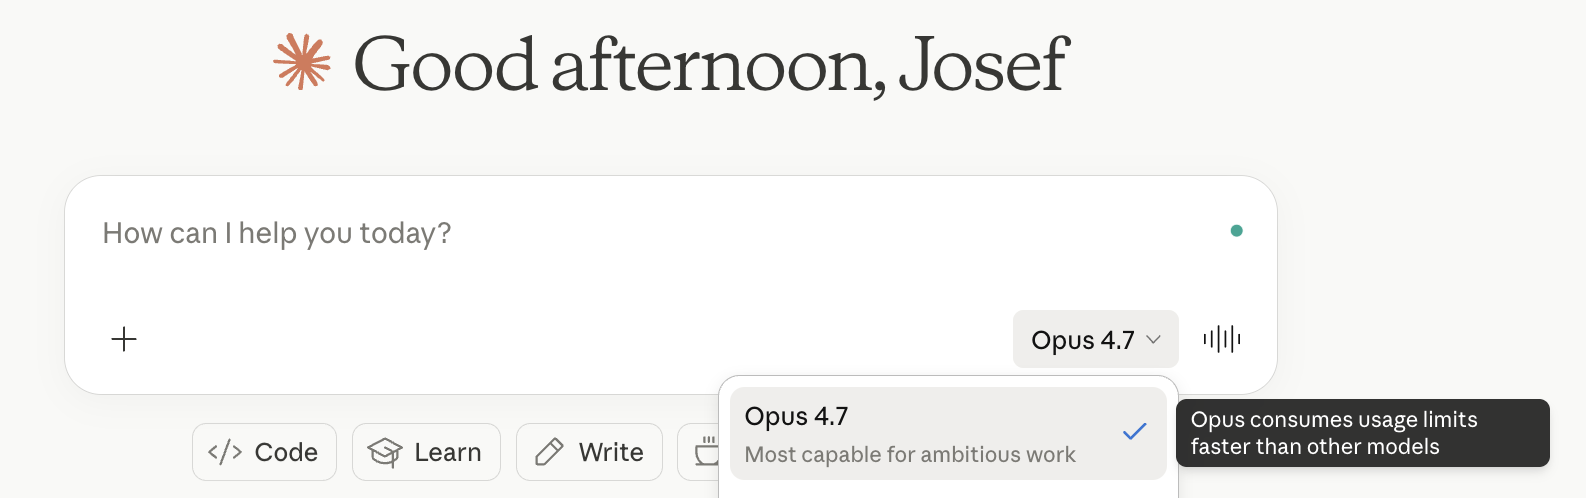
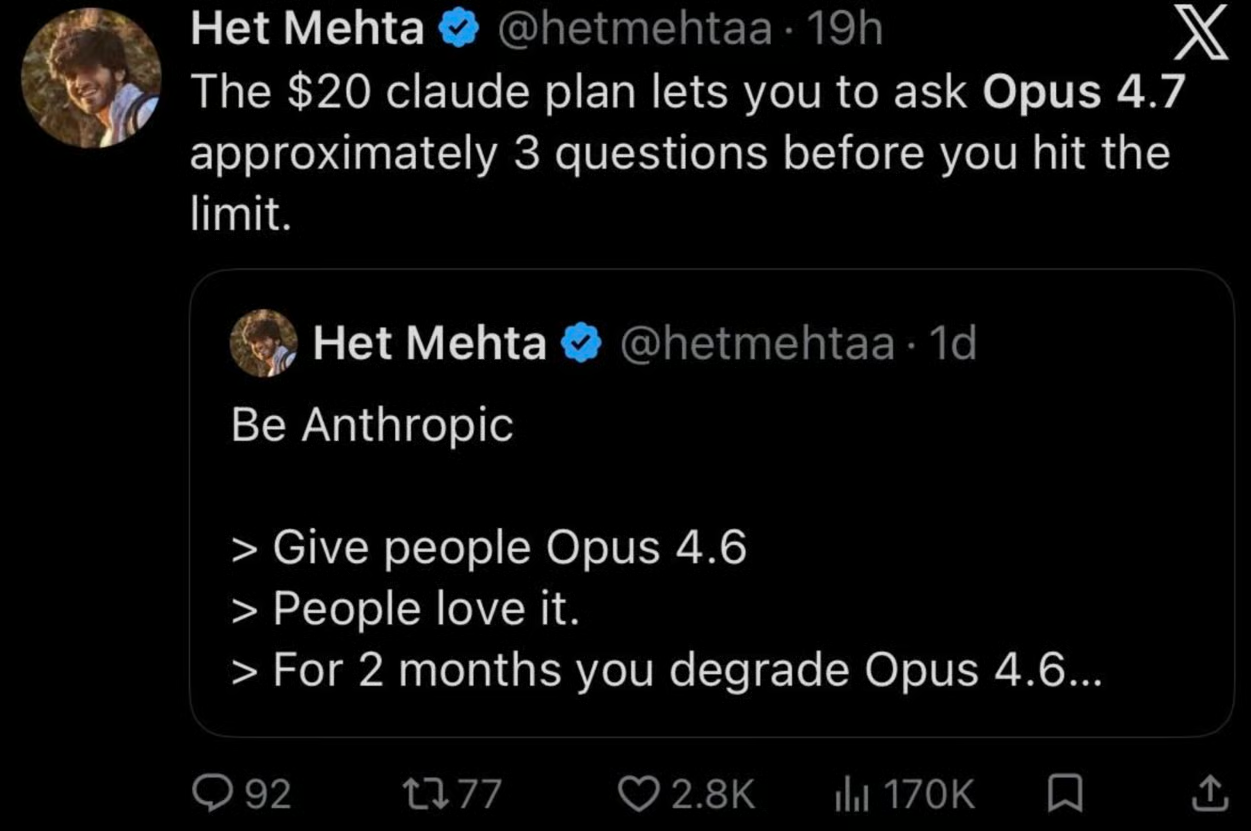
Genel bir hatırlatma olarak, Opus’u Claude.ai içinde kullanıyorsanız: Gönderdiğiniz her mesaj, şimdiye kadarki tüm konuşmayı (yeni sorun + önceki tüm gidip gelmeler) ve modelin yanıtını içerir. Bunların hepsi belirteçlerle ölçülür. Hangi plan olursa olsun, hareketli bir pencerede yenilenen bir belirteç bütçeniz vardır.
Farklı modeller bu bütçeye karşı farklı oranlarda ücret yazar. En güçlü olduğu için en pahalı olan Opus’tur. Yayınlanan kabaca oran: Opus, belirteç başına Sonnet’in yaklaşık 5 katına mal olur.
Anthropic, özellikle Claude Code kullanıyorsanız veya API üzerinde geliştiriyorsanız bilmeye değer, modelle birlikte birkaç güncelleme de gönderdi.
Yeni xhigh ("extra high") çaba seviyesi artık high ile max arasında yer alıyor. Bu, akıl yürütme derinliği ile gecikme arasında seçim yaparken size başka bir seçenek sunuyor. Claude Code’da varsayılan çaba seviyesi tüm planlarda xhigh seviyesine yükseltildi ve Anthropic, Opus 4.7’yi kodlama ve ajan görevlerinde test ederken high veya xhigh ile başlamayı öneriyor.
Claude Code, değişiklikleriniz üzerinde özel bir inceleme geçişi çalıştıran ve dikkatli bir insan gözden geçiricinin yakalayacağı hataları veya tasarım sorunlarını işaretleyen yeni bir /ultrareview kısa yol komutu kazandı. Pro ve Max kullanıcıları denemek için üç ücretsiz ultrareview alır.
Artık Max kullanıcıları, Claude’un sizin adınıza kararlar verdiği bir izin ayarı olan otomatik moda erişebiliyor. Bu, her adımı onaylamak ile izinleri tamamen atlamak arasında bir orta yol.
Görev bütçeleri artık Claude API’de genel betada. Bunlar, geliştiricilerin Claude’un bir çalıştırma boyunca belirteç harcamasını sınırlamasına olanak tanır; bu da özellikle modelin bütçesini hızla tüketmek yerine kendini ayarlamasını istediğiniz daha uzun ajan iş akışlarında kullanışlıdır.
Kıyaslama sonuçlarına yakından baktık ve bu sonuçlar, diğer modellerle karşılaştırmaları da içeriyordu. Üst düzeyde, Opus 4.7 ile GPT-5.4’ü doğrudan karşılaştıralım.
Temel çıkarım, Opus 4.7’nin uzun ufuklu özerklik için optimize edildiğidir. GPT-5.4 ise daha geniş araç desteğine ve daha ucuz kısa bağlam fiyatlandırmasına sahip, birleşik genel amaçlı bir modeldir.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| En iyi olduğu alanlar | Uzun kodlama çalıştırmaları, masaüstü bilgisayar kullanımı, yoğun görme |
Tarayıcı araştırması, kısa bağlamlı görevler, yanıt ortasında yönlendirme |
| SWE-bench Pro | %64,3 | %57,7 |
| BrowseComp | %79,3 | %89,3 |
| Fiyatlandırma | 1M bağlam boyunca sabit oran | 272K altında daha ucuz, üstünde tam oturum yeniden fiyatlanır |
| Bağlam penceresi | ~1M belirteç | ~1M belirteç |
OpenAI’nin halef modeli olan GPT-5.5 ile tam karşılaştırma için blog yazımıza bakın: Claude Opus 4.7 vs. GPT-5.5.
Bazı kullanıcılar, Opus 4.7’nin talimatları öncekine göre daha harfiyen uygulaması nedeniyle hatların bozulduğunu bildiriyor. Anthropic, istemlerin yeniden ayarlanması gerektiği konusunda uyarmıştı.
Diğer kullanıcılar belirteç kullanımından endişeli. Yayın kapsamında, Anthropic daha yüksek belirteç kullanımını telafi etmek için tüm kullanıcıların hız sınırlarını yükseltti; ancak bunun gerçek bir telafi olup olmadığı tam net değil.
Claude Opus 4.7, şu anda çoğu insanın gerçekten kullanabildiği en yetenekli model. İyileştirmelerin tümü aynı yöne işaret ediyor: Daha uzun süreli, daha az gözetimli ajan çalışmaları; bunu daha güçlü kodlama, daha keskin görme ve daha iyi oturumlar arası bellek destekliyor.
Bu sürümü ilginç kılan Mythos çerçevesi. Opus 4.7, daha geniş bir Mythos sınıfı yayına giden yolda siber açıdan kısıtlanmış bir test aracıdır; bu da üzerinde erişemeyeceğiniz net bir tavan olduğu anlamına gelir — ancak aynı zamanda 4.7 ile gelen korumaların, Anthropic’in bundan sonra sınır sürümleri nasıl ele almayı planladığının bir ön izlemesi olduğu anlamına da gelir.
DataCamp ile Öğrenin
{count, plural, one {Program} other {Program}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme