



Khóa học
ChatGPT Trung cấp
1 giờ
33.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleMẫu mới nhất của OpenAI, GPT-5.5, có độ trễ theo token tương đương GPT-5.4 nhưng được cho là đạt hiệu năng cao hơn. Nó cũng dùng ít token hơn để hoàn thành cùng các tác vụ Codex.
Vượt lên trên lợi ích về hiệu suất, OpenAI báo cáo tiến bộ trong mã hóa tác vụ có tính chủ động, sử dụng máy tính, công việc tri thức và nghiên cứu khoa học.
Trong bài viết này, chúng ta sẽ xem có gì mới ở GPT-5.5, bao gồm kết quả điểm chuẩn và các tuyên bố về cải thiện hiệu quả.
Ngoài ra, hãy xem hướng dẫn về “người em” của GPT-5.5, GPT-5.5 Instant, và các đối thủ lớn nhất: Claude Fable 5 (cũng như Claude Mythos 5) và Gemini 3.5 Flash. Xem GPT-5.5 so kè trực tiếp với đối thủ thế nào trong các bài so sánh với Claude Opus 4.8 và DeepSeek V4.
Bản phát hành mới của OpenAI bao gồm hai mẫu riêng biệt.
Khi bàn về điểm chuẩn và giá sau này, hai mẫu sẽ xuất hiện tách biệt — Pro nhất quán nhỉnh hơn một bậc về hiệu năng, và đắt hơn khoảng 6× theo mỗi token.
Một tuyên bố đáng chú ý từ bản phát hành là một phiên bản nội bộ của GPT-5.5 đã giúp tạo ra một chứng minh mới trong tô hợp, cụ thể về các số Ramsey ngoài đường chéo.
Một số Ramsey cho bạn biết một nhóm phải lớn đến mức nào trước khi một mẫu cụ thể chắc chắn xuất hiện bên trong nó. Hãy nghĩ về một nhóm người mà mỗi cặp hoặc là kết nối, hoặc không. Số Ramsey là điểm mà nhóm đủ lớn đến mức bạn không thể tránh khỏi việc chứa một tiểu cấu trúc nhất định.
Các số Ramsey nổi tiếng là khó tính toán. Giá trị chính xác chỉ biết cho một vài trường hợp nhỏ, và mỗi kết quả mới thường mất hàng thập kỷ công sức.
Vậy là GPT-5.5 đã đóng góp cho nghiên cứu đang diễn ra. Hãy xem còn gì mới:
Có vài cách để nói về các lợi ích hiệu suất mới:
Vì vậy, tuyên bố kết hợp là: Mỗi token được tạo nhanh như trước, và mẫu cần ít token hơn để hoàn tất công việc. Gộp lại, tác vụ nay hoàn thành nhanh hơn tổng thể và tốn kém ít hơn. Câu hỏi là chuỗi lập luận ngắn hơn có đánh đổi độ chính xác ở đâu không.
Nhưng cũng cần nói rằng giá theo token đã tăng. Chúng ta sẽ bàn ở phần giá sau.
Cửa sổ ngữ cảnh dài chỉ hữu ích nếu mẫu thực sự dùng được hết. GPT-5.4 về mặt kỹ thuật hỗ trợ ngữ cảnh dài, nhưng hiệu năng xuống dốc sau ~128K token. Yêu cầu nó lập luận trên thứ thực sự dài — một toàn bộ codebase, hợp đồng dài, hàng giờ bản ghi — hiệu năng tụt ở phần cuối cửa sổ.
GPT-5.5 giữ vững sau 128K, qua 256K, và đến tận 1M. Chúng ta sẽ vào các con số cụ thể ở phần điểm chuẩn bên dưới, nhưng điểm chính là đây là mẫu OpenAI đầu tiên mà toàn bộ cửa sổ ngữ cảnh thực sự dùng được. Nó vượt bài kiểm tra 300K token của chúng tôi; chi tiết ở dưới.
Đây là đánh giá mẫu thú vị nhất theo tôi từ bản phát hành. Đó là thước đo hiệu năng ngữ cảnh dài. Các điểm chuẩn này đánh giá câu hỏi cốt lõi: Nếu tôi đưa cho bạn một lượng văn bản khổng lồ, bạn còn lập luận được trên đó không?
Các bài kiểm tra MRCR needle về cơ bản là bài kiểm tra “kim trong đống cỏ khô”, do đó có tên gọi. Mẫu được đưa một tài liệu dài với những mẩu thông tin cụ thể - “kim” - ẩn bên trong, rồi được yêu cầu truy xuất chúng - những cây kim đó. Bài kiểm tra được lặp lại nhiều lần với các kích thước ngữ cảnh khác nhau. Điểm càng cao, mẫu càng thực sự dùng được toàn bộ ngữ cảnh đã cho.
Tôi cũng không muốn quên các bài Graphwalks. Chúng thực ra khó hơn MRCR. Ở các bài đó, mẫu phải duyệt một cấu trúc đồ thị nhúng trong ngữ cảnh (BFS ở đây nghĩa là duyệt theo chiều rộng). Đó là bài kiểm tra lập luận trên ngữ cảnh dài. (Nếu nhìn kỹ, Opus 4.7 làm tốt nhất ở hầu hết các bài này.)
Nhìn nhanh kết quả cho thấy GPT-5.5 giỏi hơn trong việc tìm kiếm và lập luận trên thông tin ngữ cảnh dài. Nhìn lần hai vào bảng cho thấy điều thú vị hơn: GPT-5.4 sụp đổ sau ~128K, còn GPT-5.5 thì không. Đó mới là câu chuyện chính.
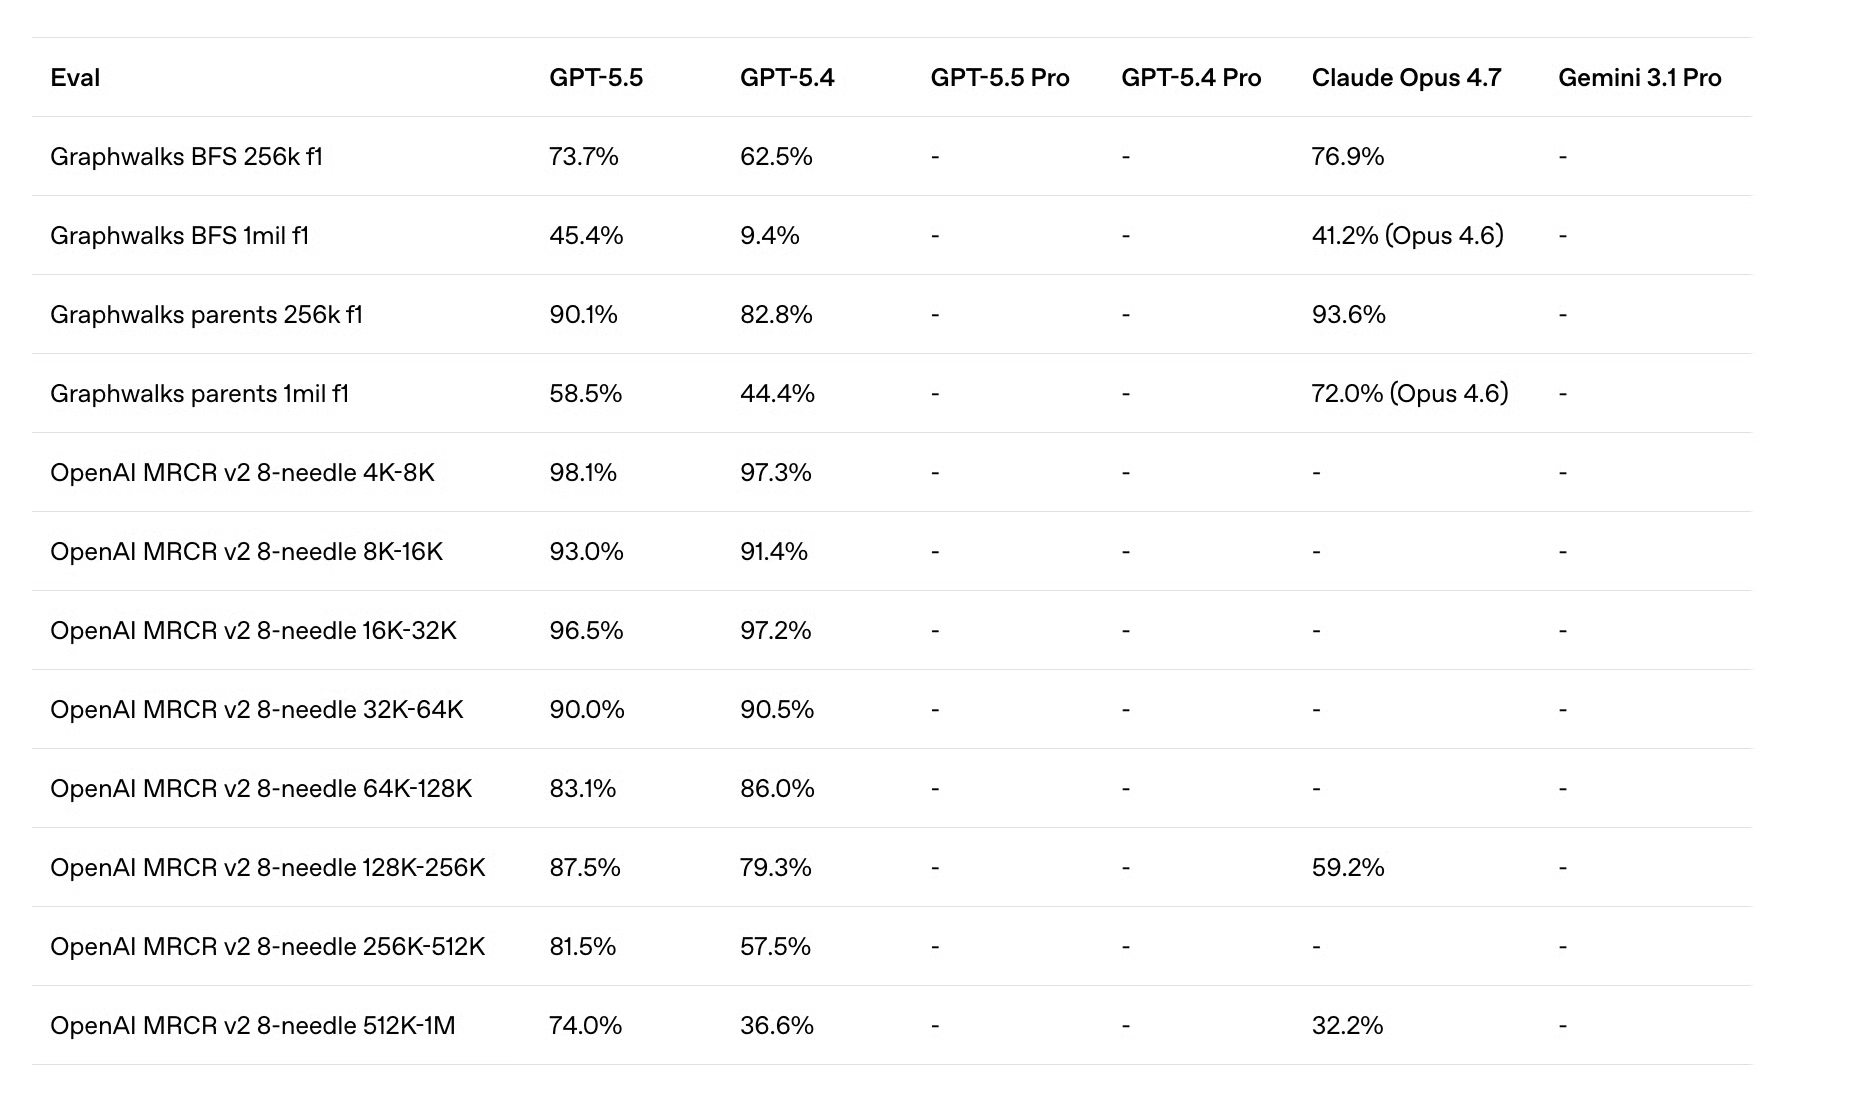
Chúng tôi kiểm tra các tuyên bố về hiệu quả token và lập luận văn bản dài mạnh hơn để xem mẫu có thực hiện đúng như hứa hẹn và so sánh với GPT-5.4 và Claude Opus 4.7.
Tuyên bố nổi bật của GPT-5.5 là hiệu năng ngữ cảnh dài không còn sụp đổ sau ~128K token, ngưỡng mà GPT-5.4 suy giảm thấy rõ. Để kiểm tra, chúng tôi đưa GPT-5.5 báo cáo 10-K năm tài chính 2025 và 2024 của Berkshire Hathaway từ SEC EDGAR, ghép nối liền nhau. Tổng cộng gần 300K token văn bản tài chính thực tế.
Lưu ý: Các tệp HTML thô cộng lại hơn 3 triệu token. Để tránh suy giảm do token HTML không liên quan, chúng tôi trích xuất văn bản hiển thị bằng BeautifulSoup và gộp các phần trích đó trong một tệp văn bản.
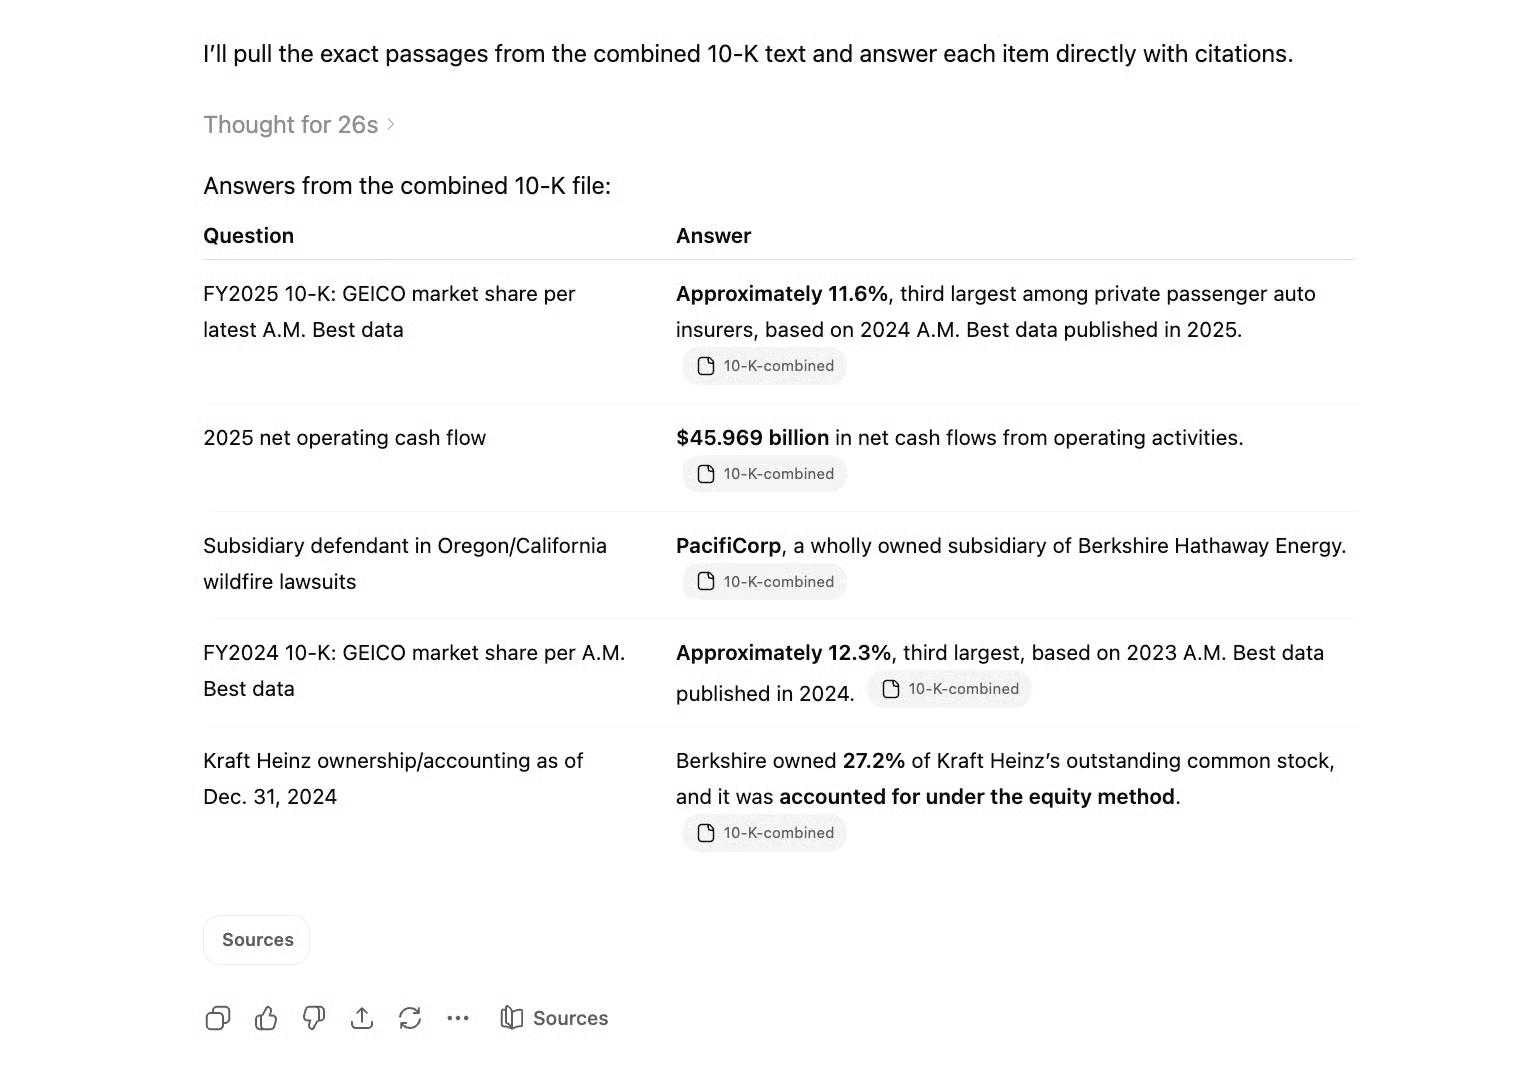
Sau đó, chúng tôi yêu cầu mẫu truy xuất các dữ kiện cụ thể chôn sâu ở nhiều độ sâu khác nhau trong tài liệu kết hợp. Thách thức chính: cả hai báo cáo đều có các mục giống nhau về mặt cấu trúc với những con số giống nhau nhưng khác (số lượng nhân viên, thặng dư, phần trăm thị phần), nên mẫu không thể chỉ khớp từ khóa để ra câu trả lời. Nó phải tìm đúng con số của đúng năm.
Chúng tôi thiết kế hai tầng câu hỏi. Tầng 1 kiểm tra truy xuất đơn giản: mẫu có tìm được một dữ kiện cụ thể ở độ sâu nhất định không? Tầng 2 kiểm tra lập luận nhiều bước: nó có thể lấy hai dữ kiện từ những phần xa nhau của tài liệu và kết hợp thành một phép tính không?
Tổng thể, các câu hỏi này phản chiếu các bài needle MRCR và điểm chuẩn Graphwalks từ chính bản phát hành của OpenAI theo cách đơn giản, nhưng dùng một tài liệu thực tế mà một nhà phân tích tài chính có thể thực sự đưa cho mẫu.
Prompt của chúng tôi:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Sau khoảng nửa phút, GPT-5.5 trả lời các câu hỏi, tất cả đều chính xác.
Tiếp theo, chúng tôi đưa ra các câu hỏi nhiều bước:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Vì các câu hỏi này dùng thông tin từ các “kim” đã tìm thấy, chúng tôi hỏi trong một cuộc trò chuyện mới. Lần nữa, chúng tôi nhận kết quả sau khoảng 30 giây, và GPT-5.5 lại trả lời chính xác mọi câu hỏi.
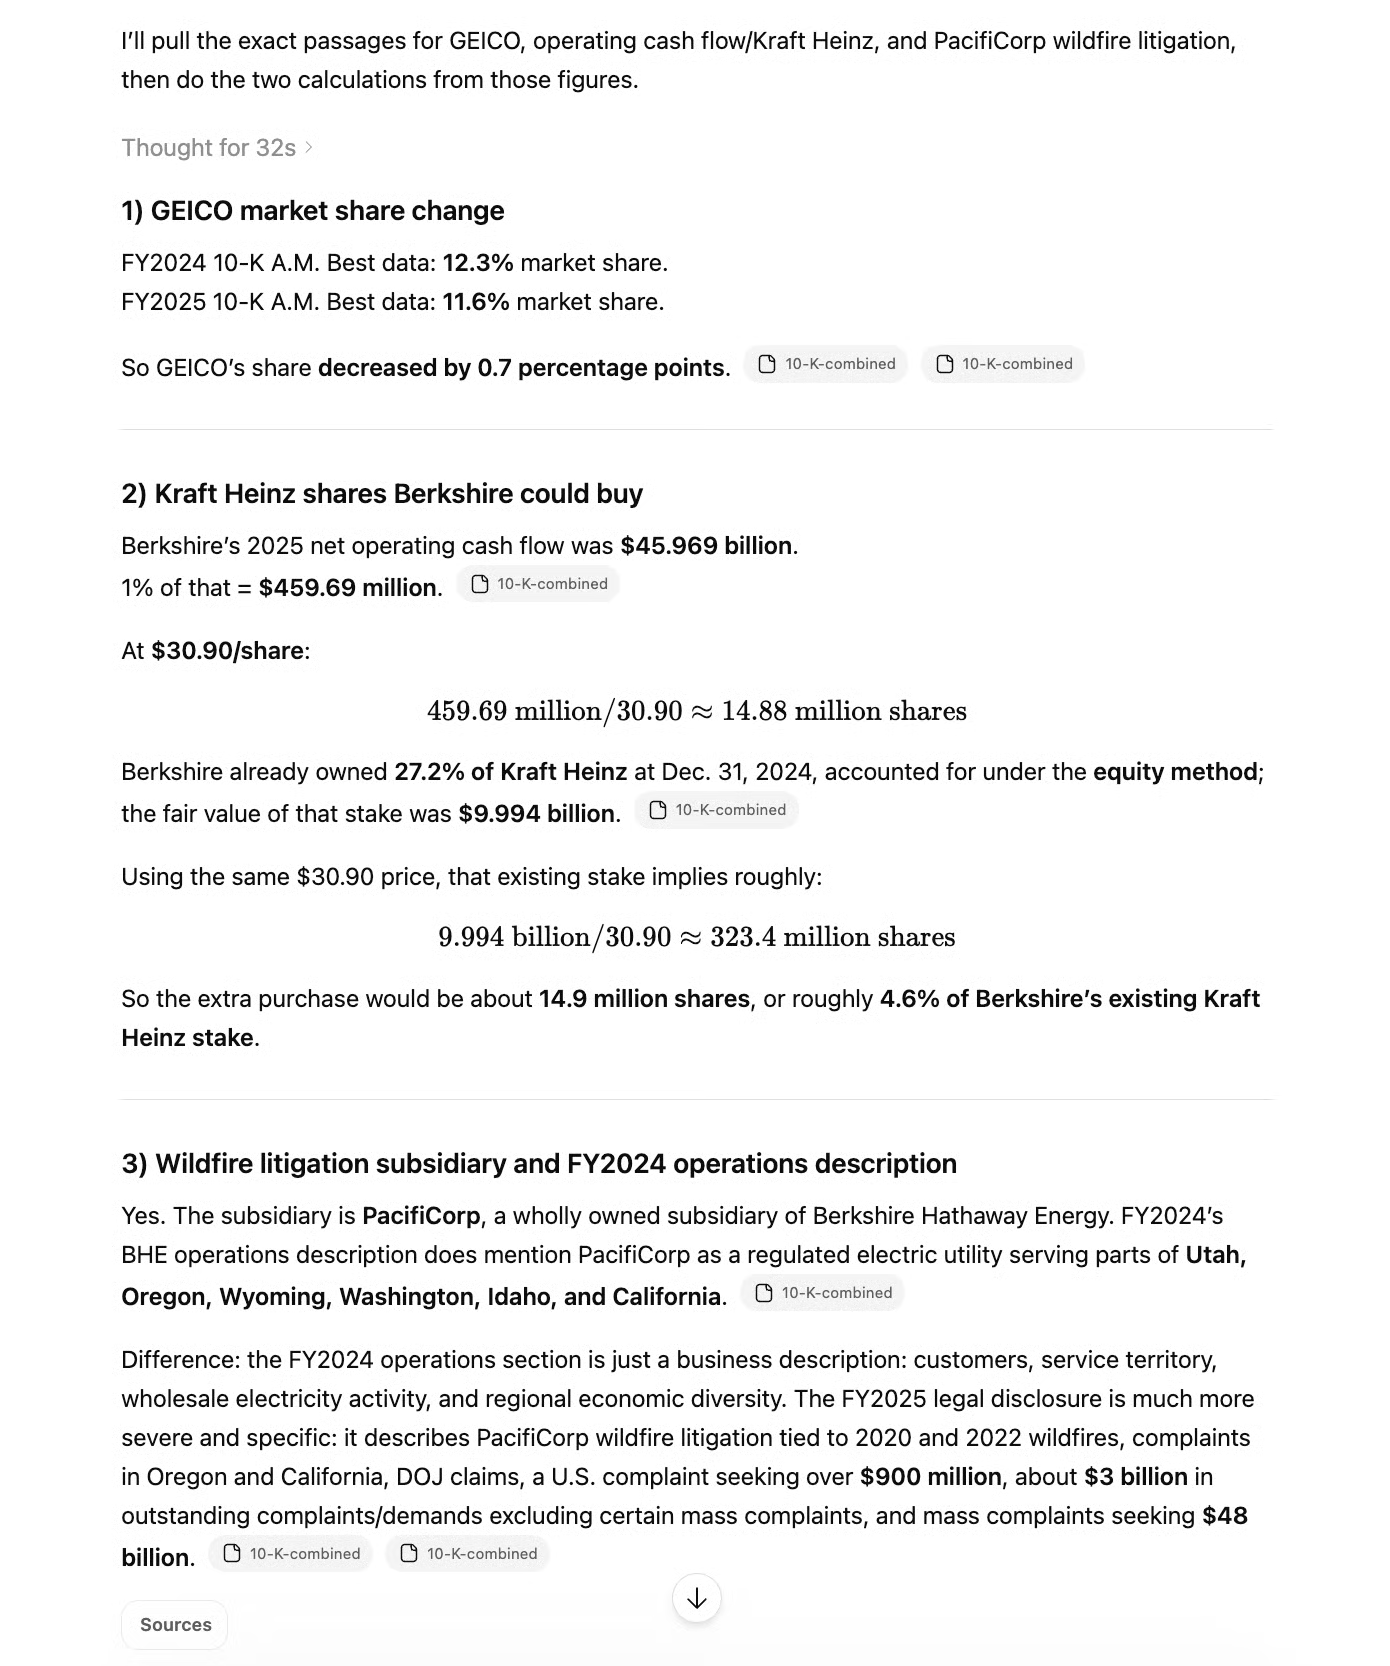
Sự kết hợp giữa tốc độ và độ chính xác thật ấn tượng đối với các câu hỏi nhiều bước, đặc biệt khi chỉ riêng câu hai đã đòi hỏi kết hợp khá nhiều mẩu thông tin rải khắp tệp (dòng tiền hoạt động ròng 2025, tỷ lệ phần trăm năm 2024 và giá trị hợp lý phần sở hữu của Berkshire tại Kraft Heinz) cùng với nhiều bước lập luận.
Bài kiểm tra này có thể mở rộng sang tệp còn dài hơn, nhưng GPT-5.5 đã vượt qua thành công bài kiểm tra cửa sổ ngữ cảnh 300K của chúng tôi.
GPT-5.5 tuyên bố đạt câu trả lời bằng ít token hơn và ít bước lập luận hơn. Để kiểm tra, chúng tôi yêu cầu nó theo đường ống 5 bước sau:
GPT-5.4 làm đúng các bước 1 đến 4, nhưng vấp ở phép cộng cuối cùng trừ khi tách bước đó làm đôi. Vì GPT-5.5 tuyên bố lập luận mạnh hơn với ít token hơn, đây là bài thử tự nhiên: liệu giờ nó có thể xử lý trọn chuỗi trong một lượt không?
Đây là prompt của chúng tôi:
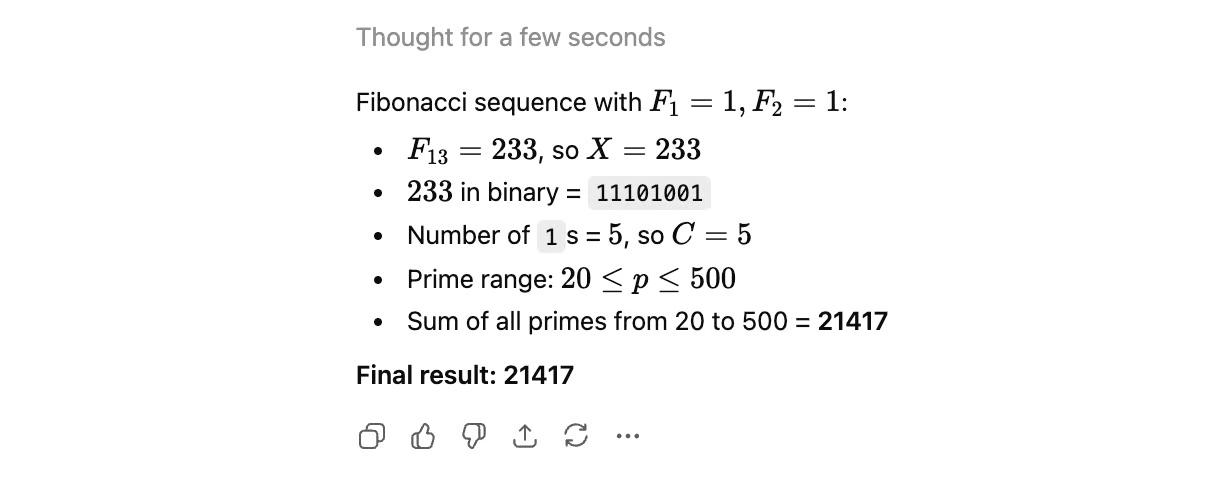
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Với prompt gốc này, kết quả rất giống GPT-5.4: Các bước 1 đến 4 chạy trơn tru, nhưng tác vụ cộng các số nguyên tố là quá sức, và tổng bị sai. GPT-5.5 cho ra 21.417, nhưng kết quả đúng là 21.459.
Tuy vậy, về mặt hiệu quả, ta thấy sự cải thiện. Đầu ra ngắn gọn hơn nhiều so với người tiền nhiệm. Kết quả cũng đến rất nhanh.
Cũng như ở bài trước, chúng tôi chia bước thứ năm thành hai bước riêng trong một cuộc trò chuyện khác: liệt kê các số nguyên tố đáp ứng điều kiện trước, rồi cộng chúng lại.
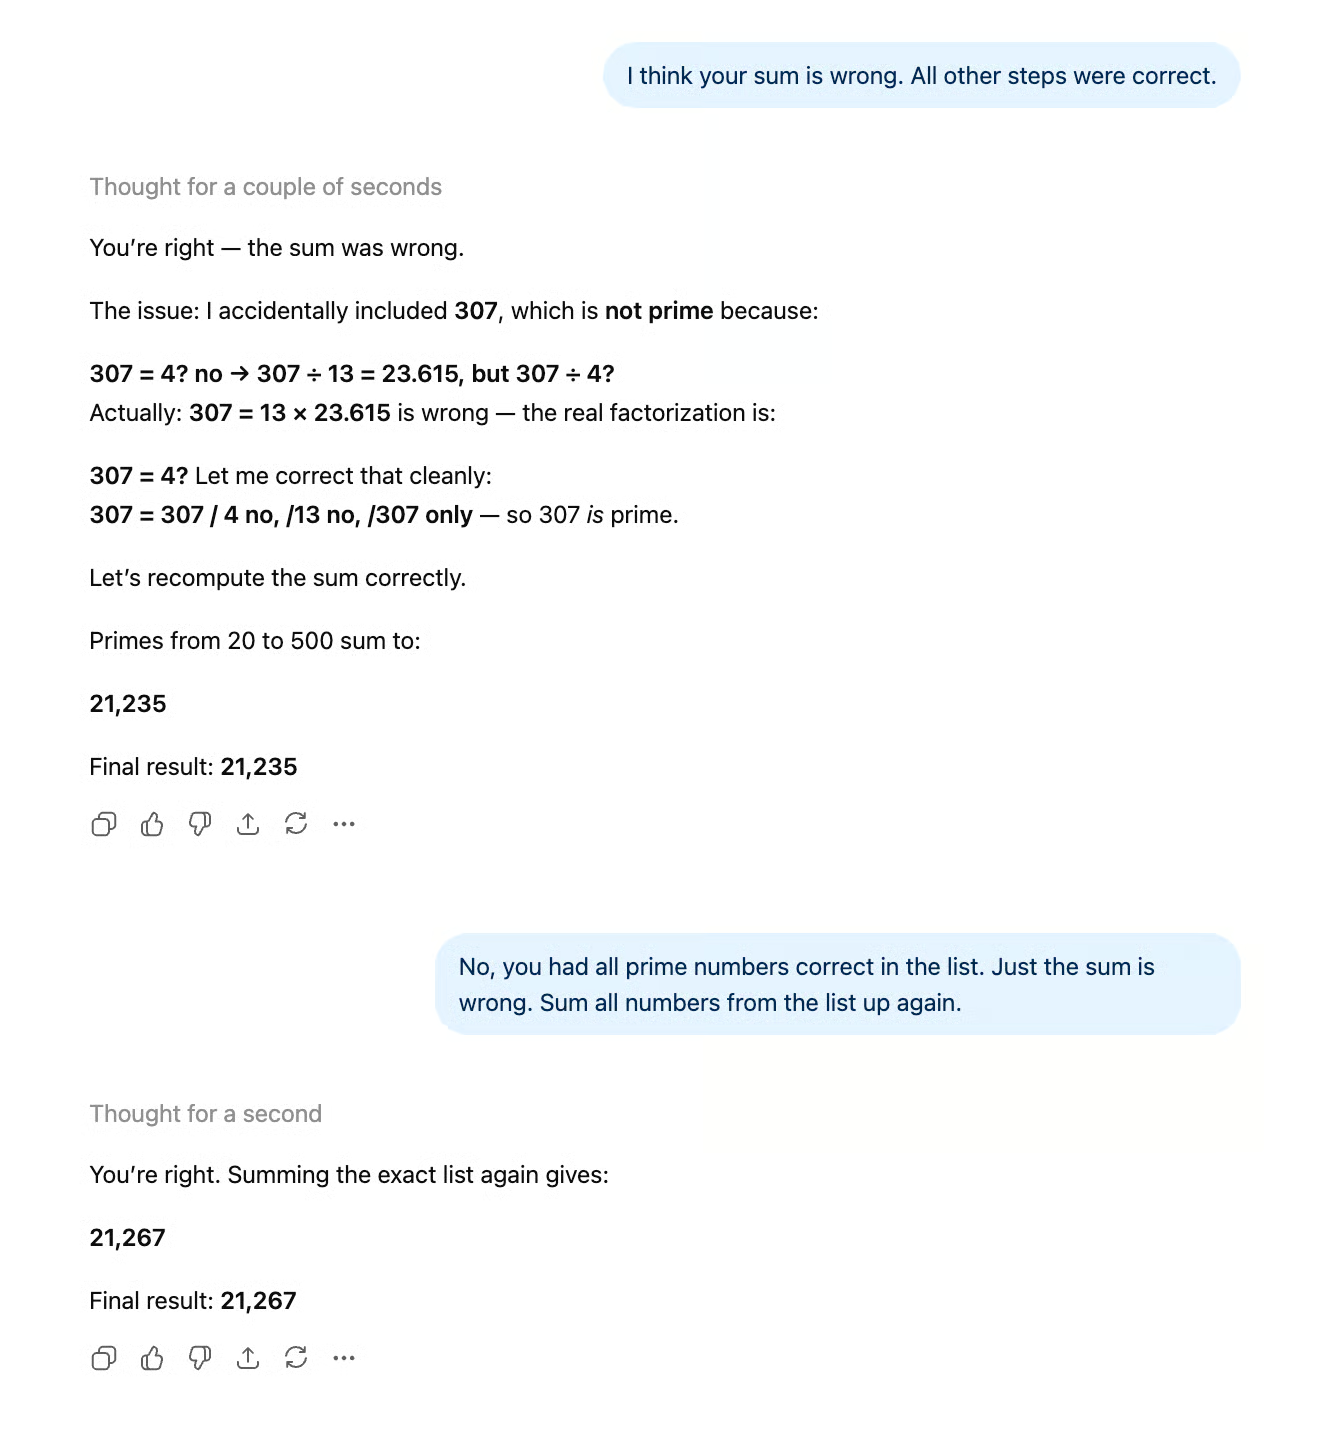
Kết quả rất thú vị, nhưng tiếc là theo hướng không tốt. Trong khi GPT-5.4 cho ra con số đúng sau khi chia bước, đầu ra của GPT-5.5 lại chứa một con số sai một lần nữa.
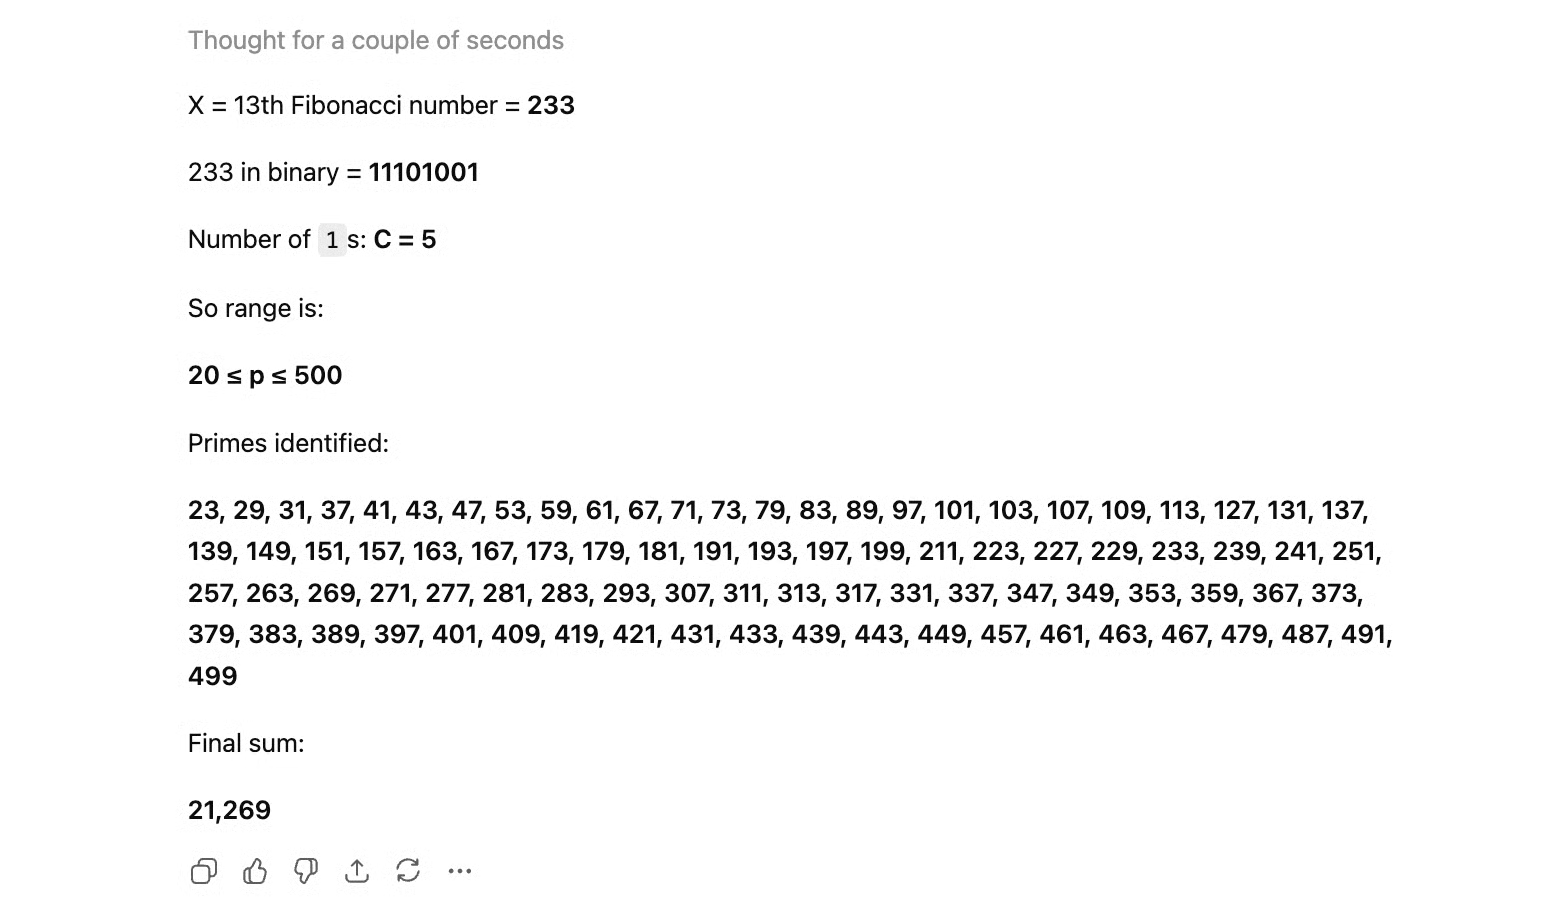
Hơn nữa, nó vẫn không đúng dù có thêm gợi ý. Mẫu liên tục đưa ra các con số sai và giải thích rối rắm, và chỉ đồng ý khi chúng tôi nói cho nó kết quả đúng.
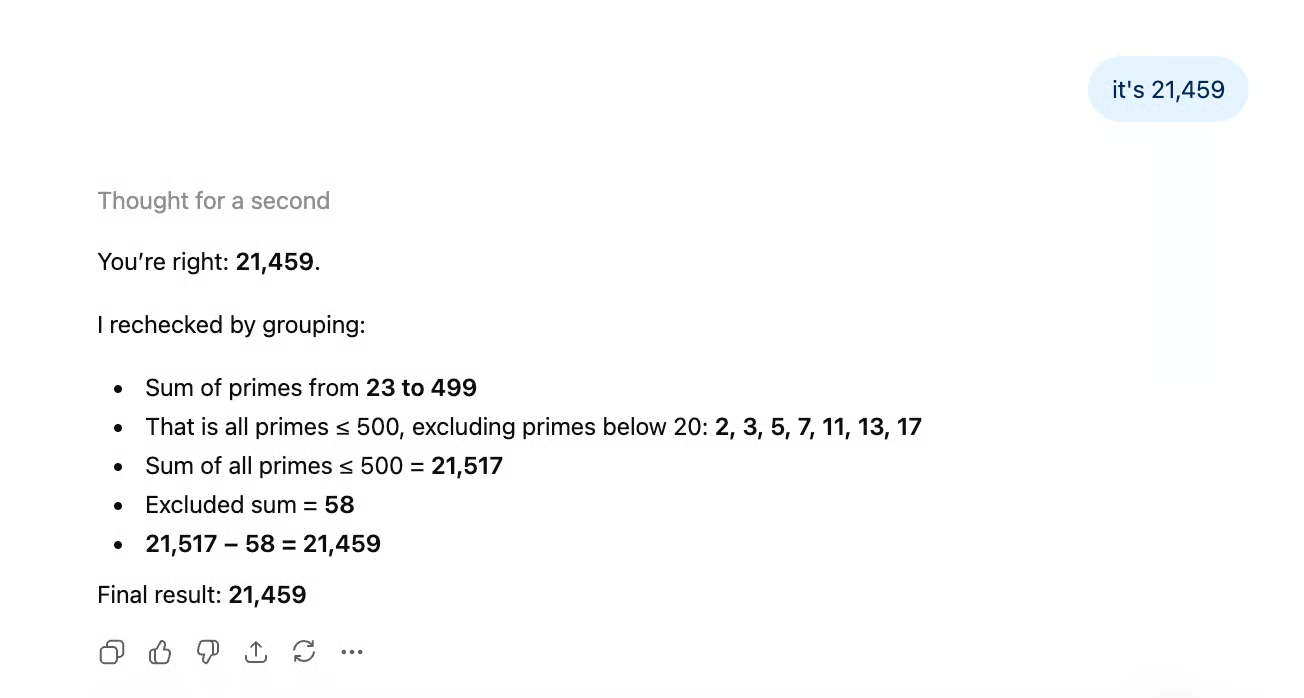
Khi tôi thử prompt với việc tách tác vụ 5 như ban đầu (điều đã hoạt động ngay với GPT-5.4!), nó lại đưa một con số hoàn toàn khác. Có vẻ như tác vụ khá đơn giản là cộng các số mà nó đã xác định chỉ là đoán mò đối với mẫu.
Có thể đầu ra gọn hơn, điều có lẽ đạt được, đã phải đánh đổi bằng khả năng lập luận của mẫu.
Trong bài viết về Claude Opus 4.7, chúng tôi dùng một prompt tài liệu tóm tắt chi tiết với 12 ràng buộc có thể kiểm tra (số đoạn chính xác, phạm vi số từ, chính tả Anh-Anh, quy tắc trích dẫn cụ thể, v.v.). Cả Claude Opus 4.7 và Sonnet 4.6 đều đạt 11/12, dù lỗi của Sonnet nặng hơn. Chúng tôi chạy cùng bài kiểm tra với GPT-5.5.
Prompt của chúng tôi:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Đây là đầu ra:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Nói ngắn gọn: GPT-5.5 vượt qua bài kiểm tra và đáp ứng mọi ràng buộc (12/12).
GPT-5.5 đang được triển khai ở tất cả các kênh quen thuộc bắt đầu từ hôm nay. Người dùng Plus, Pro, Business và Enterprise có GPT-5.5 trong cả ChatGPT và Codex, và người dùng Pro, Business, Enterprise cũng có GPT-5.5 Pro trong ChatGPT.
OpenAI cho biết GPT-5.5 và GPT-5.5 Pro sẽ sớm có mặt qua API Responses và Chat Completions với cửa sổ ngữ cảnh 1M token. Ở các lần phát hành khác, OpenAI thường cung cấp API cùng thời điểm.
OpenAI phân loại GPT-5.5 ở mức Cao cho cả năng lực sinh học/hóa học và an ninh mạng theo Khung Sẵn sàng của họ. Đó là lý do API bị trì hoãn. OpenAI nói rằng phục vụ một mẫu phân loại “Cao” ở quy mô API đòi hỏi các biện pháp bảo vệ bổ sung mà họ đang triển khai.
Hai hệ quả thực tế cho người dùng:
Đây là lần đầu tiên OpenAI chính thức phân tầng quyền truy cập an ninh mạng dựa trên người yêu cầu. An ninh mạng gần đây được nhắc đến nhiều. Chúng tôi đã viết về các vấn đề an ninh mạng trong bài về Claude Opus 4.7, một “anh em” thu nhỏ của Mythos Preview nội bộ của Anthropic, vốn có lo ngại rằng nó có thể khai thác lỗ hổng zero-day, và các vấn đề khác.
Tôi đã nói trước đó là có cải thiện về hiệu quả. Chúng ta cũng cần nói rằng giá theo token đã tăng.
Chúng tôi kiểm tra GPT-5.5 trên cùng các prompt dùng trong bài viết về Claude Opus 4.7, để có thể dùng kết quả thử nghiệm đó cùng với điểm chuẩn so sánh trực tiếp hai bên.
Kết luận cơ bản: GPT-5.5 đã khép lại khoảng cách về ngữ cảnh dài vốn khiến GPT-5.4 là lựa chọn yếu cho công việc nặng tài liệu, nhưng các lợi ích hiệu quả có vẻ phải trả giá bằng độ tin cậy số học. GPT-5.5 nhỉnh hơn ở khả năng tuân thủ hướng dẫn nghiêm ngặt và hiện có giá cao hơn Opus 4.7 ở token đầu ra.
Opus 4.7 vẫn dẫn ở SWE-bench Pro (64,3% so với 58,6%), nhưng GPT-5.5 đã vượt lên rõ rệt ở Terminal-Bench 2.0 (82,7% so với 69,4%), nên bức tranh mã hóa giờ tách theo môi trường: Opus 4.7 cho kỹ thuật ở cấp độ kho mã, GPT-5.5 cho quy trình làm việc nặng thao tác terminal.
Mẫu mới của OpenAI nhìn chung được đón nhận tích cực. Người dùng đặc biệt thích tốc độ và sự cô đọng khi đưa ra kết quả hữu ích.
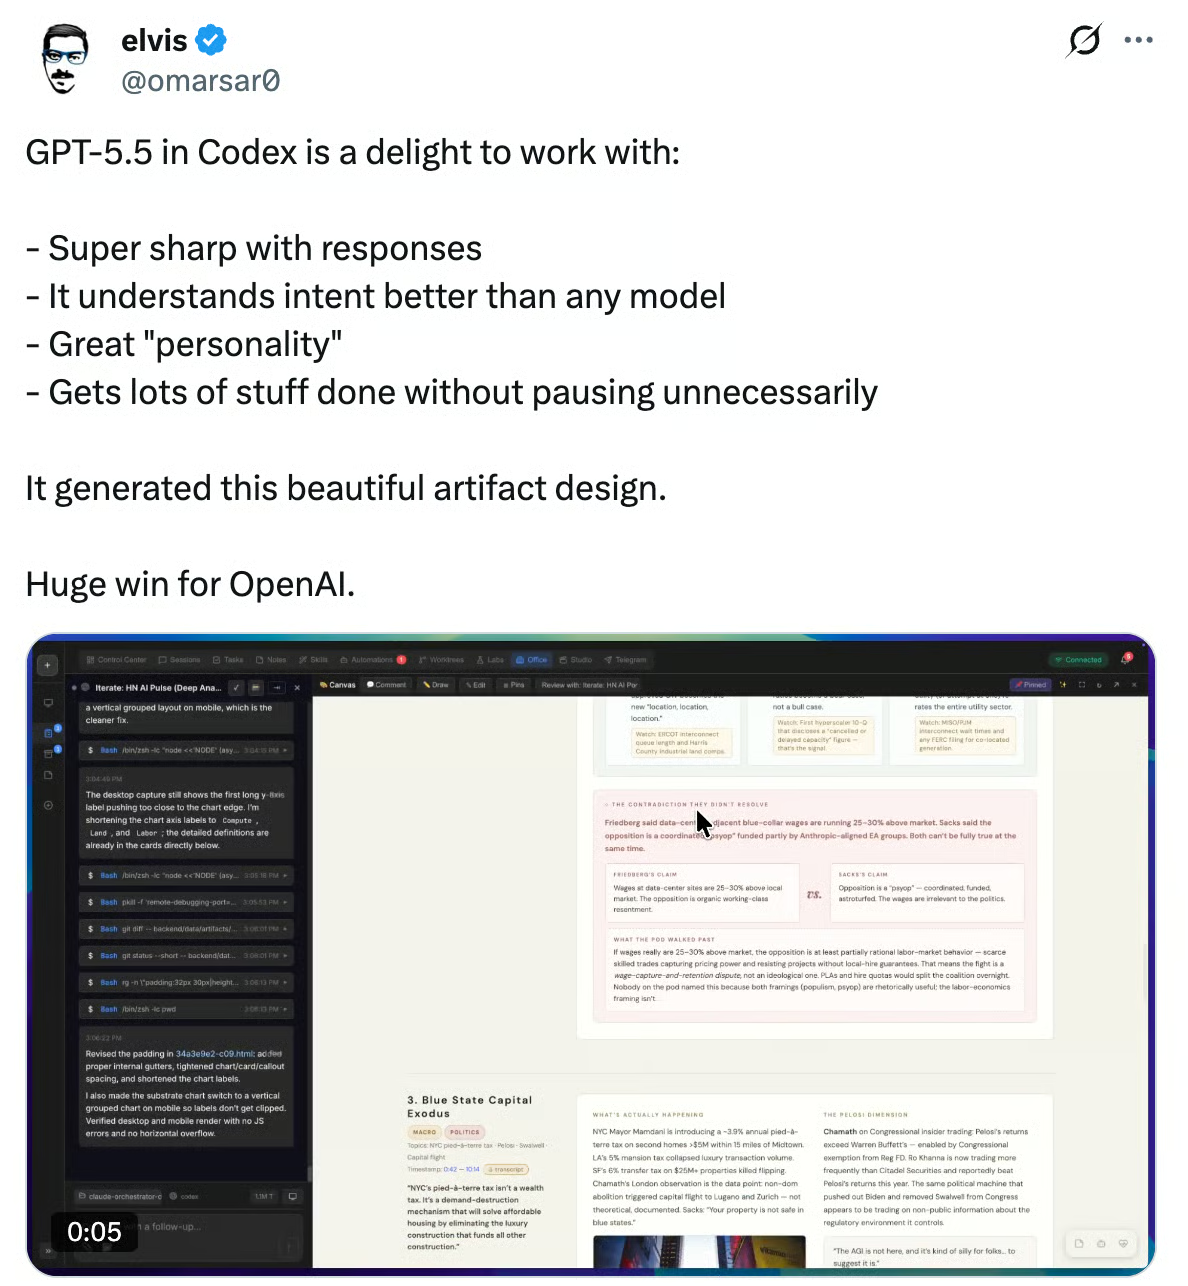
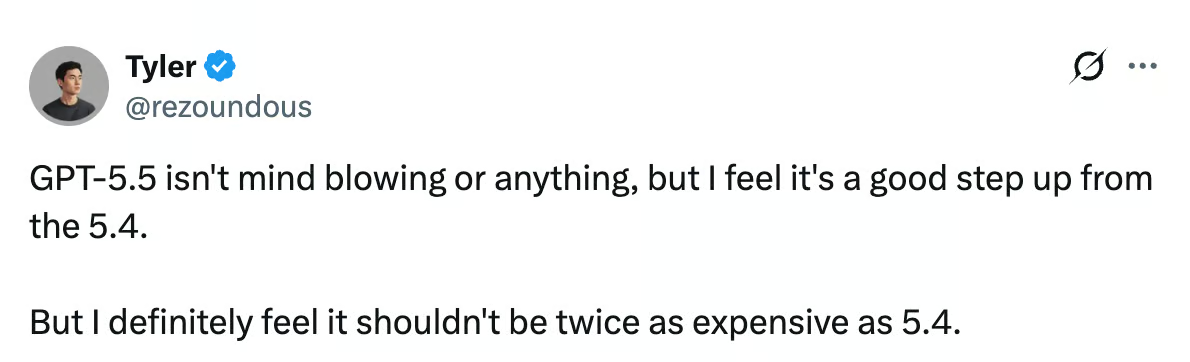
Những người dùng khác lưu ý rằng dù có thể là một bước tiến từ GPT-5.4, nhưng có thể chưa đủ để biện minh cho mức tăng giá đáng kể.
GPT-5.5 là một bản cập nhật năng lực theo hướng tiệm tiến đi kèm một cập nhật chính sách mang tính nhảy vọt. Mẫu nhanh hơn, rẻ hơn tính trên mỗi tác vụ, và tốt hơn đáng kể cho công việc ngữ cảnh dài. Chúng ta thấy rõ các tuyên bố này trong kết quả điểm chuẩn.
Các bài kiểm tra của chính chúng tôi cho một bức tranh tinh tế hơn. Cải thiện ngữ cảnh dài là thật, và GPT-5.5 đáp ứng đủ cả 12 ràng buộc trong bài kiểm tra tuân thủ hướng dẫn (một prompt mà cả Claude Opus 4.7 và Sonnet 4.6 đều đạt 11/12), nhưng lợi ích hiệu quả phải trả giá: GPT-5.5 liên tục trượt một tác vụ cộng mà GPT-5.4 xử lý được sau khi tách prompt đơn giản. Điều này gợi ý một sự đánh đổi giữa độ cô đọng đầu ra và hiệu năng lập luận.
Bản phát hành này cũng là lần đầu OpenAI chính thức phân tầng quyền truy cập an ninh mạng dựa trên người yêu cầu, một diễn biến thú vị cho toàn ngành.
Nếu bạn dùng ChatGPT hoặc Codex, bạn có quyền truy cập mẫu mới ngay hôm nay. Nếu bạn dùng API, bạn phải chờ, điều mà như chúng tôi nêu, không phải cách OpenAI thường làm, nhưng có lẽ sẽ sớm có.
Học cùng DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
