



कोर्स
इंटरमीडिएट ChatGPT
1 घंटा
33.3K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंOpenAI का नवीनतम मॉडल, GPT-5.5, प्रति-टोकन लैटेंसी में GPT-5.4 के बराबर है, लेकिन उच्च स्तर के प्रदर्शन का दावा करता है। यह वही Codex कार्य पूरे करने के लिए कम टोकन भी उपयोग करता है।
दक्षता में बढ़त के अलावा, OpenAI एजेंटिक कोडिंग, कंप्यूटर उपयोग, नॉलेज वर्क, और वैज्ञानिक अनुसंधान में भी सुधार की रिपोर्ट करता है।
इस लेख में, हम GPT-5.5 में क्या नया है, उसके बेंचमार्क परिणाम और दक्षता संबंधी दावों सहित, उस पर नज़र डालेंगे।
साथ ही, GPT-5.5 के "छोटे भाई" GPT-5.5 Instant और उसके बड़े प्रतिद्वंद्वियों Claude Fable 5 (तथा Claude Mythos 5) और Gemini 3.5 Flash पर हमारे मार्गदर्शक को भी देखें। हमारे तुलना लेखों में Claude Opus 4.8 और DeepSeek V4 के साथ GPT-5.5 की सीधी टक्कर देखें।
OpenAI की इस नई रिलीज़ में दो अलग-अलग मॉडल शामिल हैं।
जब हम आगे बेंचमार्क और मूल्य-निर्धारण की बात करेंगे, तो ये दोनों मॉडल अलग-अलग दिखेंगे — Pro प्रदर्शन में लगातार एक पायदान ऊपर है, और प्रति टोकन लगभग 6 गुना अधिक महंगा है।
रिलीज़ का एक दिलचस्प दावा यह है कि GPT-5.5 के एक आंतरिक संस्करण ने कॉम्बिनेटोरिक्स में एक नया प्रमाण तैयार करने में मदद की, खासकर ऑफ-डायगोनल रैम्से संख्याओं पर।
एक रैम्से संख्या आपको बताती है कि किसी समूह में कोई निश्चित पैटर्न सुनिश्चित रूप से दिखने से पहले उसे कितना बड़ा होना चाहिए। लोगों के ऐसे समूह के बारे में सोचिए जहाँ हर जोड़ी या तो कनेक्टेड है या नहीं। रैम्से संख्या वह बिंदु है जहाँ समूह इतना बड़ा हो जाता है कि एक विशेष उपसंरचना से बचना नामुमकिन हो जाता है।
रैम्से संख्याओं की गणना बदनाम रूप से कठिन है। सटीक मान केवल कुछ छोटे मामलों के लिए ही ज्ञात हैं, और हर नया परिणाम दशकों का काम लेता है।
तो GPT-5.5 पहले से ही सक्रिय शोध में योगदान दे रहा है। देखें और क्या नया है:
नई दक्षता बढ़त पर बात करने के कई तरीके हैं:
तो सम्मिलित दावा यह है: हर टोकन पहले जितनी ही तेज़ी से आता है, और काम पूरा करने के लिए मॉडल को उनकी संख्या भी कम चाहिए। मिलाकर देखें, तो कार्य अब समग्र रूप से अधिक तेज़ी से पूरे होते हैं और सस्ते पड़ते हैं। सवाल यह है कि क्या छोटी तर्क श्रृंखला कहीं-कहीं पर सटीकता से समझौता करवाती है।
लेकिन यह भी कहना होगा कि प्रति-टोकन कीमत बढ़ गई है। हम आगे मूल्य-निर्धारण खंड में इस पर आएंगे।
लंबी कॉन्टेक्स्ट विंडो तभी उपयोगी है जब मॉडल उसका वास्तविक उपयोग कर सके। GPT-5.4 तकनीकी रूप से लंबे कॉन्टेक्स्ट सपोर्ट करता था, लेकिन ~128K टोकन के बाद उसका प्रदर्शन टूटने लगता था। उसे वास्तव में लंबी चीज़ों पर तर्क करने को कहें — एक पूरा कोडबेस, लंबा कॉन्ट्रैक्ट, घंटों के ट्रांसक्रिप्ट्स — और विंडो के दूर वाले सिरे पर प्रदर्शन डूबता था।
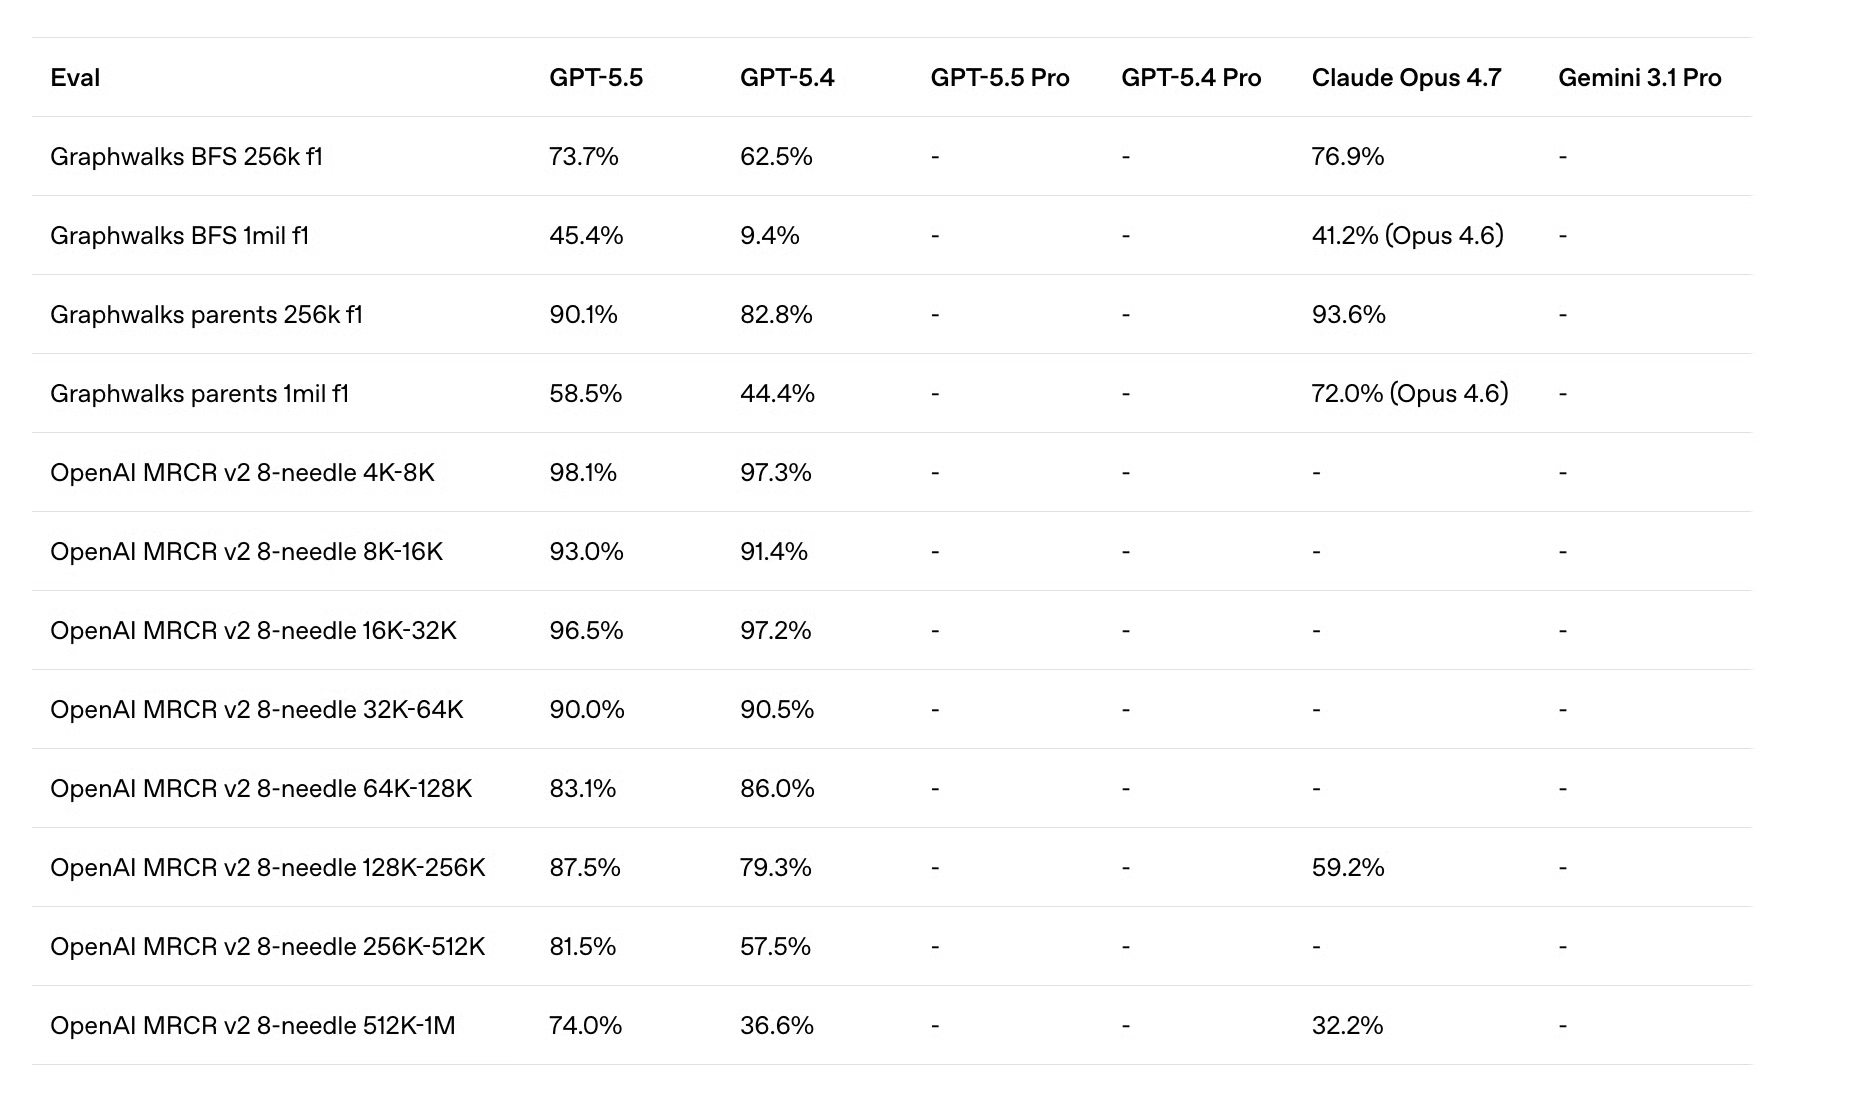
GPT-5.5 128K से आगे, 256K से आगे, और 1M तक टिकता है। हम नीचे बेंचमार्क खंड में विशिष्ट संख्याएँ देखेंगे, लेकिन मुख्य बात यह है कि यह OpenAI का पहला मॉडल है जहाँ पूरी कॉन्टेक्स्ट विंडो वास्तविक तौर पर उपयोगी है। यह हमारे 300K टोकन टेस्ट में पास हुआ; इस पर नीचे और जानकारी है।
मेरे विचार से रिलीज़ का सबसे दिलचस्प मॉडल इवैल यही है। यह लंबे कॉन्टेक्स्ट प्रदर्शन का मापक है। ये बेंचमार्क एक मूलभूत सवाल का आकलन करते हैं: अगर मैं आपको बहुत विशाल पाठ दूँ, तो क्या आप अब भी उस पर तर्क कर सकते हैं?
MRCR नीडल टेस्ट मूलतः "भूसे के ढेर में सुई" जैसा परीक्षण है, इसलिए यह नाम। मॉडल को एक लंबा दस्तावेज़ दिया जाता है जिसमें विशिष्ट जानकारी के टुकड़े — "सुईयाँ" — छिपी होती हैं, फिर उनसे उन्हें ढूँढ़ने को कहा जाता है। हम यह टेस्ट अलग-अलग कॉन्टेक्स्ट आकारों के साथ कई बार होते देखते हैं। स्कोर जितना अधिक, मॉडल ने उसे दिए गए पूरे कॉन्टेक्स्ट का उतना ही बेहतर उपयोग किया।
मैं Graphwalks टेस्ट को नहीं भूलना चाहता। वे वास्तव में MRCR से कठिन हैं। इन परीक्षणों में, मॉडल को कॉन्टेक्स्ट में एंबेड किए गए ग्राफ़ स्ट्रक्चर को पार करना होता है (यहाँ BFS का मतलब breadth-first search है)। यह लंबे कॉन्टेक्स्ट पर तर्क करने की परीक्षा है। (यदि आप ध्यान से देखें, तो इन टेस्टों के अधिकांश में Opus 4.7 बेहतर कर रहा है।)
परिणामों की त्वरित स्कैनिंग बताती है कि GPT-5.5 लंबे कॉन्टेक्स्ट की जानकारी को खोजने और उस पर तर्क करने में बेहतर है। तालिका पर दूसरी नज़र एक और दिलचस्प बात बताती है: GPT-5.4 ~128K के बाद टूटने लगता था, और GPT-5.5 नहीं। यही असल कहानी है।
हमने टोकन-दक्षता और लंबे पाठ पर मजबूत तर्क के दावों का परीक्षण किया, ताकि देखें कि मॉडल अपने वादे पर खरा उतरता है या नहीं, और GPT-5.4 तथा Claude Opus 4.7 से तुलना की।
GPT-5.5 का मुख्य दावा यह है कि ~128K टोकन के बाद लंबा-कॉन्टेक्स्ट प्रदर्शन अब नहीं बिखरता, जहाँ GPT-5.4 स्पष्ट रूप से बिगड़ता था। इसे परखने के लिए, हमने GPT-5.5 को SEC EDGAR से Berkshire Hathaway की FY2025 और FY2024 10-K फाइलिंग्स बैक-टू-बैक देकर खिलाईं। साथ मिलकर, वे लगभग 300K टोकन के वास्तविक वित्तीय पाठ बनते हैं।
नोट: कच्ची HTML फाइलें 30 लाख से अधिक टोकन तक पहुँचती हैं। अप्रासंगिक HTML टोकन के कारण गिरावट से बचने के लिए, हमने BeautifulSoup का उपयोग कर दृश्य पाठ निकाला और इन अंशों को एक ही टेक्स्ट फ़ाइल में संयोजित किया।
फिर हमने मॉडल से संयुक्त दस्तावेज़ में अलग-अलग गहराइयों पर दबे विशिष्ट तथ्यों को पुनः प्राप्त करने को कहा। मुख्य चुनौती: दोनों फाइलिंग्स में संरचनात्मक रूप से समान खंड हैं जिनमें मिलते-जुलते पर अलग-अलग आँकड़े होते हैं (कर्मचारी संख्या, सरप्लस आंकड़े, मार्केट शेयर प्रतिशत), इसलिए मॉडल केवल कीवर्ड-मैचिंग से उत्तर नहीं ढूँढ़ सकता। उसे सही वर्ष का सही नंबर खोजना होता है।
हमने प्रश्नों के दो स्तर बनाए। टियर 1 सरल पुनः प्राप्ति जाँचता है: क्या मॉडल दी गई गहराई पर कोई विशिष्ट तथ्य ढूँढ़ सकता है? टियर 2 मल्टी-हॉप तर्क की जाँच करता है: क्या वह दस्तावेज़ के दूरस्थ हिस्सों से दो तथ्य निकाल कर उन्हें एक गणना में जोड़ सकता है?
मिलाकर देखें तो ये OpenAI की अपनी रिलीज़ के MRCR नीडल टेस्ट और Graphwalks बेंचमार्क का सरल प्रतिबिंब हैं, लेकिन ऐसे वास्तविक दस्तावेज़ पर जो कोई वित्तीय विश्लेषक सचमुच मॉडल को दे सकता है।
हमारा प्रॉम्प्ट:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
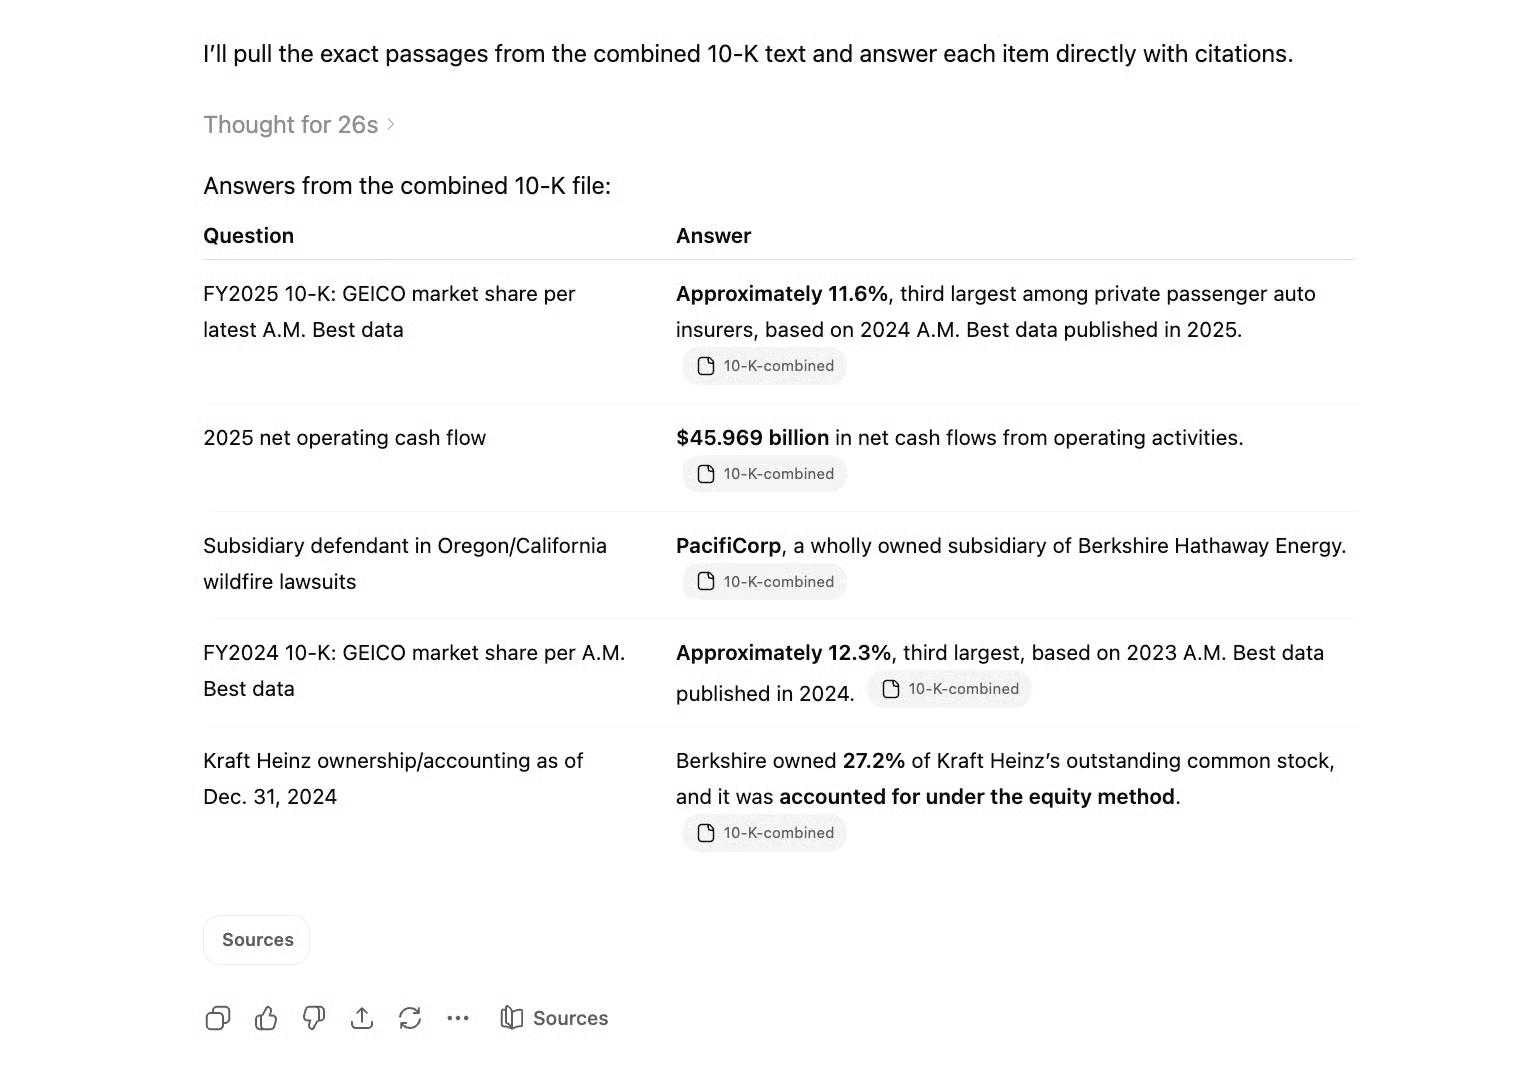
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
लगभग आधे मिनट के बाद, GPT-5.5 ने सभी प्रश्नों के उत्तर दिए, और हर एक सही था।
अगला, हमने मल्टी-हॉप प्रश्न दिए:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
क्योंकि ये प्रश्न पहले से मिली "सुइयों" की जानकारी पर आधारित थे, हमने इन्हें एक नई चैट में पूछा। फिर से, लगभग 30 सेकंड में हमें परिणाम मिले, और फिर से, GPT-5.5 ने हर प्रश्न का सही उत्तर दिया।
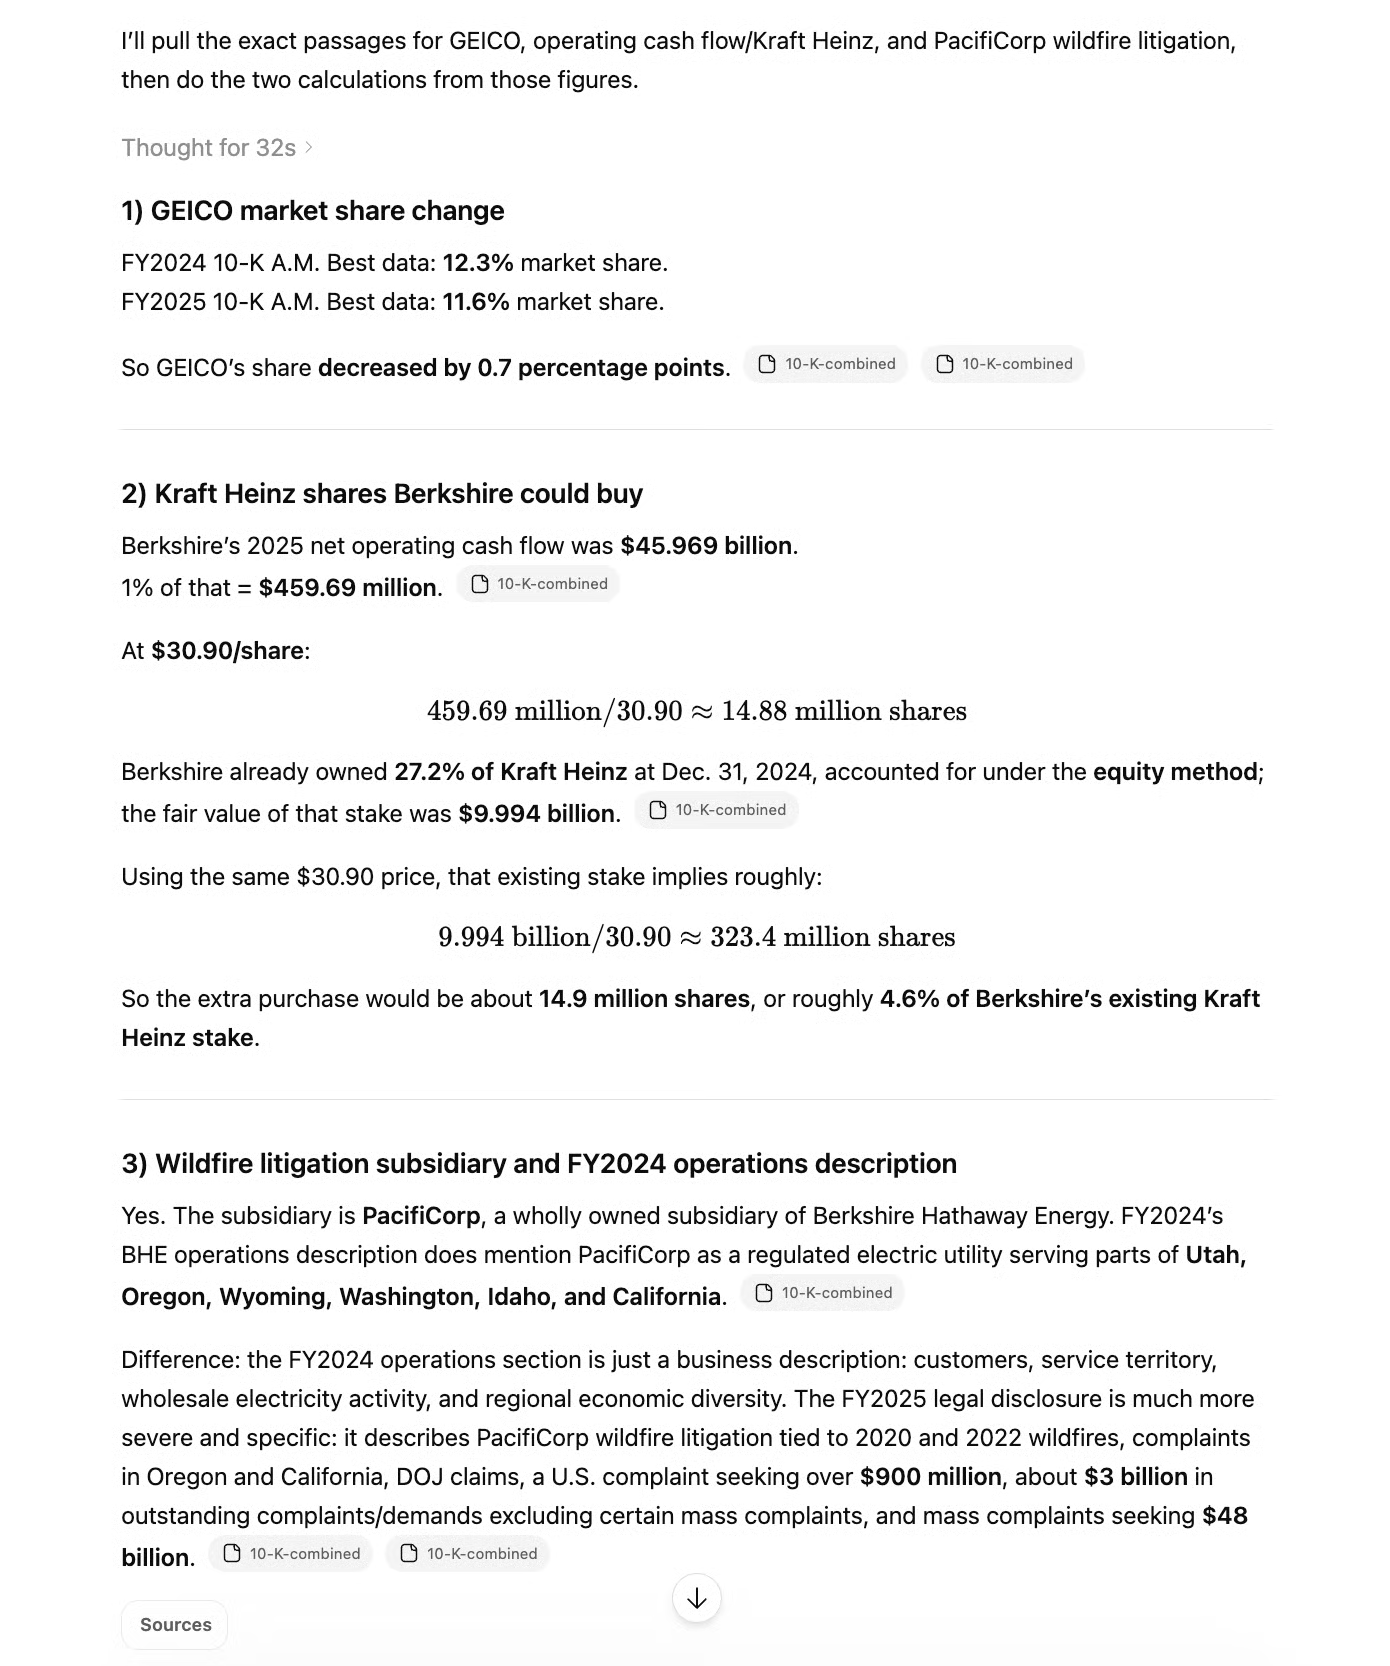
गति और सटीकता का संयोजन मल्टी-हॉप प्रश्नों के लिए प्रभावशाली है, खासकर क्योंकि केवल दूसरा प्रश्न ही फ़ाइल में बिखरी कई जानकारियों (2025 नेट ऑपरेटिंग कैश फ्लो, 2024 प्रतिशत, और Berkshire के Kraft Heinz में हिस्से का फेयर वैल्यू) को जोड़ने के साथ कई तर्क-चरण माँगता था।
यह परीक्षण और भी लंबी फ़ाइल तक बढ़ाया जा सकता है, लेकिन GPT-5.5 ने हमारा 300K कॉन्टेक्स्ट विंडो टेस्ट सफलतापूर्वक पास किया।
GPT-5.5 का दावा है कि वह कम टोकन और कम तर्क-चरणों में उत्तर तक पहुँचता है। इसे परखने के लिए, हम इसे पाँच-चरणीय पाइपलाइन का पालन करने को कहेंगे:
GPT-5.4 चरण 1 से 4 तक सही पहुँचा, लेकिन अंतिम समेशन में चूक गया, जब तक कि चरण को दो भागों में न बाँटा जाए। क्योंकि GPT-5.5 कम टोकन के साथ मजबूत तर्क का दावा करता है, यह एक स्वाभाविक परीक्षण है: क्या वह अब एक ही बार में पूरी चेन संभाल सकता है?
यह हमारा प्रॉम्प्ट है:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
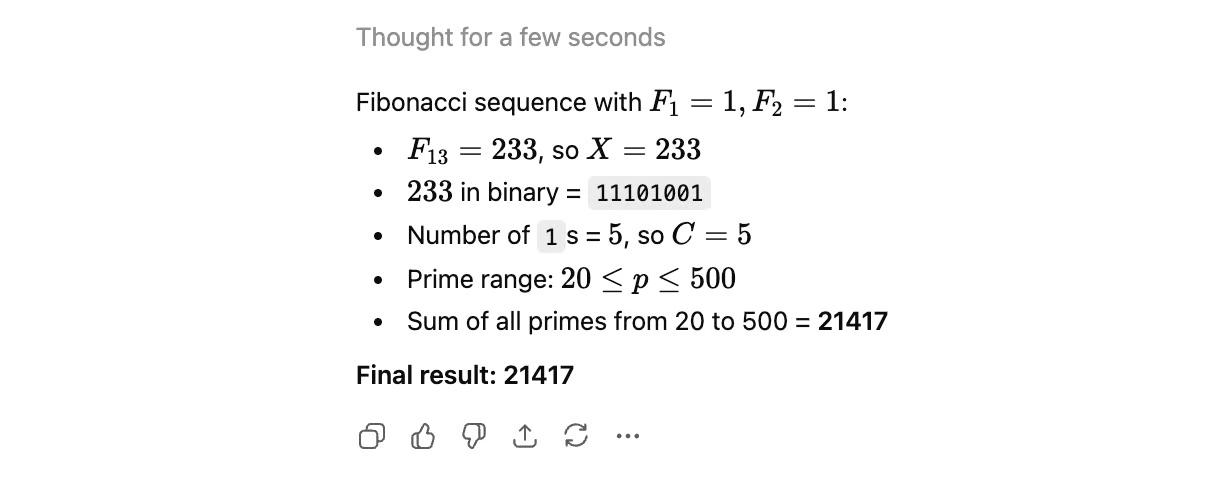
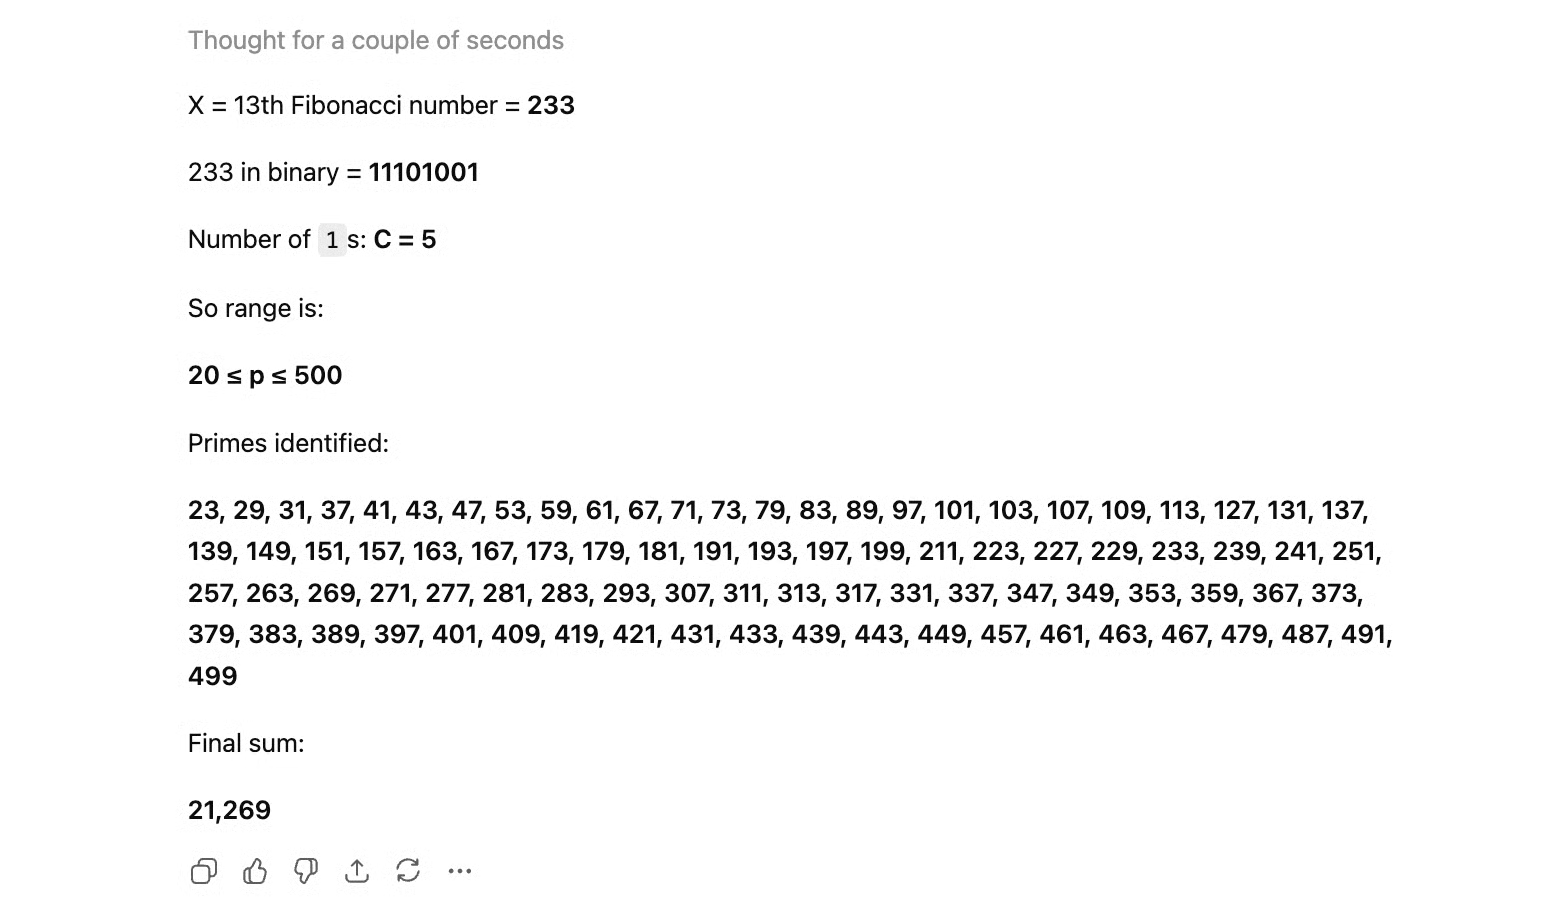
इस मूल प्रॉम्प्ट के साथ, परिणाम GPT-5.4 जैसा ही रहा: चरण 1 से 4 तक बिना समस्या के हुए, लेकिन अभाज्य संख्याओं के योग का कार्य संभालना मुश्किल रहा, और योग गलत निकला। GPT-5.5 ने 21,417 दिया, जबकि सही परिणाम 21,459 होना चाहिए था।
हालाँकि, दक्षता के लिहाज़ से, सुधार दिखता है। आउटपुट अपने पूर्ववर्ती की तुलना में काफी संक्षिप्त है। परिणाम बहुत तेज़ी से भी आया।
पिछले परीक्षण की तरह ही, हमने पाँचवे चरण को एक अलग चैट में दो अलग चरणों में बाँटा: पहले बाधाओं के अनुरूप अभाज्य संख्याएँ सूचीबद्ध करना, और फिर उनका योग करना।
परिणाम बहुत दिलचस्प था, पर दुर्भाग्य से अच्छे अर्थ में नहीं। जहाँ GPT-5.4 ने चरण-विभाजन के बाद सही संख्या दी, वहीं GPT-5.5 का आउटपुट फिर से गलत संख्या लिए था।
और भी, अतिरिक्त संकेतों के बाद भी यह सही नहीं हुआ। मॉडल बार-बार गलत संख्याएँ और उलझाऊ व्याख्याएँ देता रहा, और केवल तब सहमत हुआ जब हमने उसे सही परिणाम बताया।
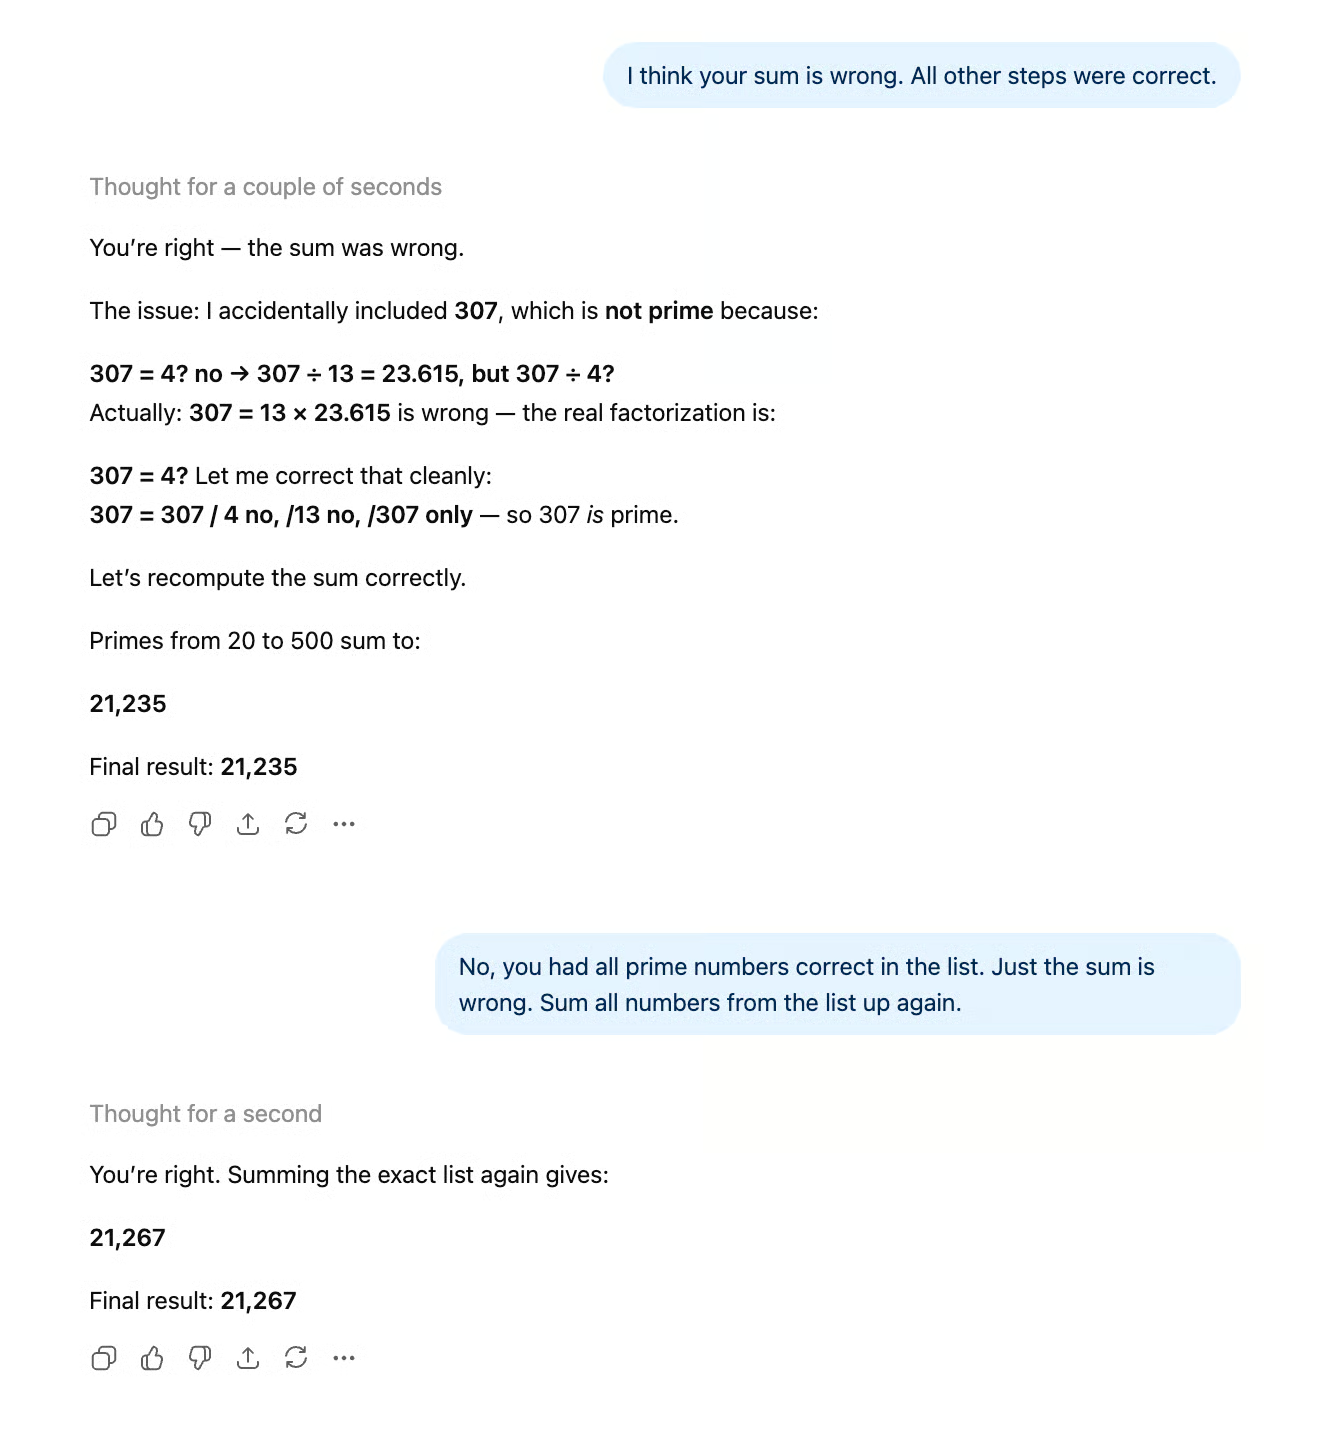
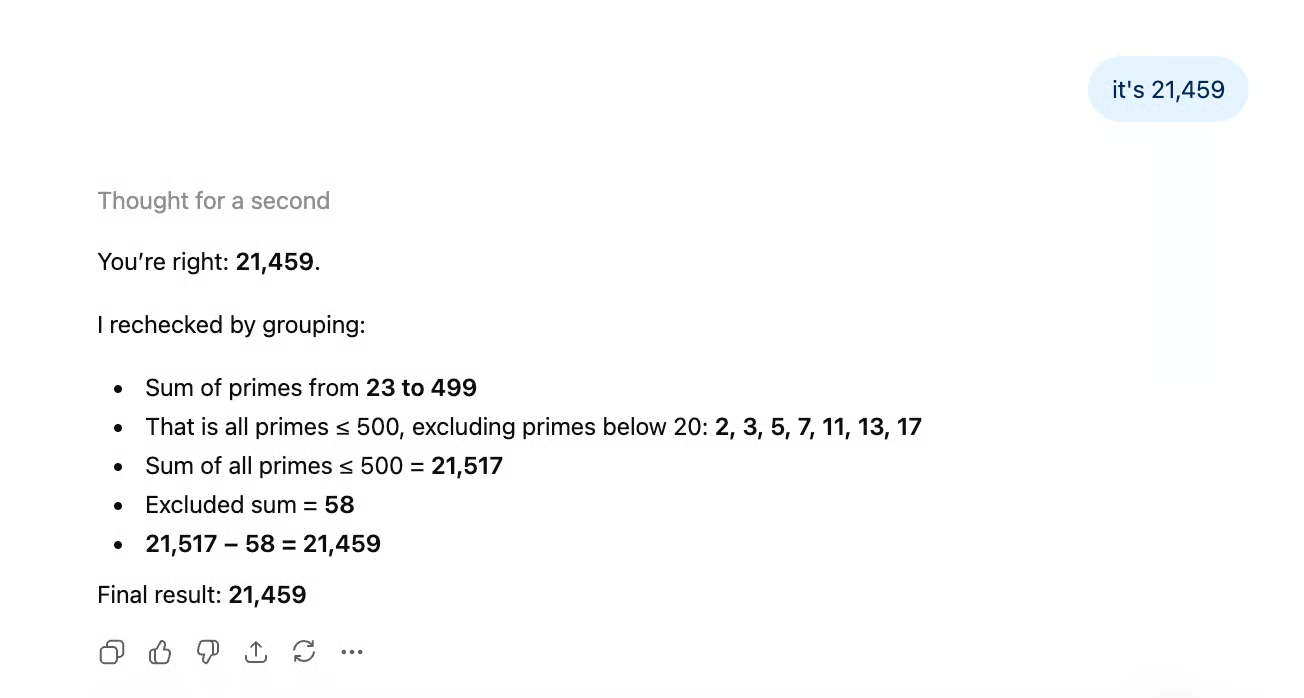
जब मैंने मूल कार्य 5 को बाँटकर दिए गए प्रॉम्प्ट के साथ (जो GPT-5.4 पर तुरंत काम कर गया था!) फिर कोशिश की, तो इसने बिलकुल अलग संख्या दे दी। लगता है कि उन संख्याओं का साधारण सा जोड़, जिन्हें यह पहले ही पहचान चुका है, मॉडल के लिए पूरी तरह अनुमान का खेल है।
संभव है कि अधिक दक्ष आउटपुट, जो तर्कसंगत रूप से मिला, मॉडल की तर्क-क्षमता की कीमत पर आया हो।
हमारे Claude Opus 4.7 वाले लेख में, हमने 12 जाँचने योग्य बाधाओं (सटीक पैराग्राफ संख्या, शब्द-संख्या रेंज, ब्रिटिश वर्तनी, विशिष्ट उद्धरण नियम, आदि) के साथ विस्तृत ब्रीफिंग-डॉक्यूमेंट प्रॉम्प्ट उपयोग किया था। Claude Opus 4.7 और Sonnet 4.6 दोनों ने 11/12 स्कोर किए, हालाँकि Sonnet की चूक अधिक गंभीर थी। हमने वही टेस्ट GPT-5.5 पर चलाया।
हमारा प्रॉम्प्ट:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
यह आउटपुट है:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
संक्षेप में: GPT-5.5 ने टेस्ट पास किया और हर बाधा को साधा (12/12)।
GPT-5.5 आज से सभी सामान्य स्थानों पर रोलआउट हो रहा है। Plus, Pro, Business, और Enterprise उपयोगकर्ताओं को ChatGPT और Codex दोनों में GPT-5.5 मिलेगा, और Pro, Business, तथा Enterprise उपयोगकर्ताओं को ChatGPT में GPT-5.5 Pro भी मिलेगा।
OpenAI कहता है कि GPT-5.5 और GPT-5.5 Pro बहुत जल्द Responses और Chat Completions API के ज़रिये 1M-टोकन कॉन्टेक्स्ट विंडो के साथ आ रहे हैं। पिछली रिलीज़ों में, OpenAI ने API की पहुँच एक ही समय पर दी थी।
OpenAI ने अपने Preparedness Framework के तहत GPT-5.5 को जैविक/रासायनिक और साइबरसुरक्षा क्षमताओं पर High वर्गीकृत किया है। यही API में देरी का कारण है। OpenAI कहता है कि API स्केल पर High-वर्गीकृत मॉडल परोसने के लिए अतिरिक्त सेफ़गार्ड चाहिए, जिन पर वह काम कर रहा है।
उपयोगकर्ताओं के लिए दो व्यावहारिक नतीजे:
पहली बार OpenAI ने यह औपचारिक रूप से किया है कि साइबरसुरक्षा एक्सेस पूछने वाले के आधार पर स्तरीकृत होगा। हाल में साइबरसुरक्षा खबरों में काफी रही है। हमने अपने Claude Opus 4.7 वाले लेख में साइबरसुरक्षा मुद्दों पर लिखा था, जो Anthropic के केवल-आंतरिक Mythos Preview का स्केल-डाउन सिब्लिंग है, जिसके बारे में चिंता थी कि वह ज़ीरो-डे भेद्यताओं का दुरुपयोग कर सकता है, आदि।
मैंने पहले कहा था कि दक्षता में बढ़त हुई है। हमें यह भी कहना होगा कि प्रति टोकन कीमत बढ़ गई है।
हमने GPT-5.5 को उन्हीं प्रॉम्प्ट्स पर परखा जिनका उपयोग हमने Claude Opus 4.7 पर अपने लेख में किए थे, ताकि हम उन टेस्ट परिणामों को बेंचमार्क स्कोर के साथ रखकर सीधे तुलना कर सकें।
मूल निष्कर्ष: GPT-5.5 ने वह लंबे-कॉन्टेक्स्ट की खाई पाट दी जो GPT-5.4 को दस्तावेज़-भारी काम के लिए कमजोर विकल्प बनाती थी, लेकिन इसकी दक्षता बढ़त शायद अंकगणित की विश्वसनीयता की कीमत पर आई है। कड़े निर्देशों के पालन में GPT-5.5 थोड़ा आगे निकलता है और अब आउटपुट टोकन पर Opus 4.7 से महँगा है।
SWE-bench Pro पर Opus 4.7 अब भी आगे है (64.3% बनाम 58.6%), लेकिन Terminal-Bench 2.0 पर GPT-5.5 निर्णायक रूप से आगे निकल गया है (82.7% बनाम 69.4%), इसलिए कोडिंग तस्वीर अब वातावरण के हिसाब से बँटती है: रिपॉज़िटरी-स्तरीय इंजीनियरिंग के लिए Opus 4.7, और टर्मिनल-भारी वर्कफ़्लो के लिए GPT-5.5।
OpenAI के नए मॉडल को आम तौर पर सकारात्मक प्रतिक्रिया मिली है। उपयोगकर्ताओं को खासकर इसकी गति और उपयोगी परिणामों की संक्षिप्तता पसंद आई है।
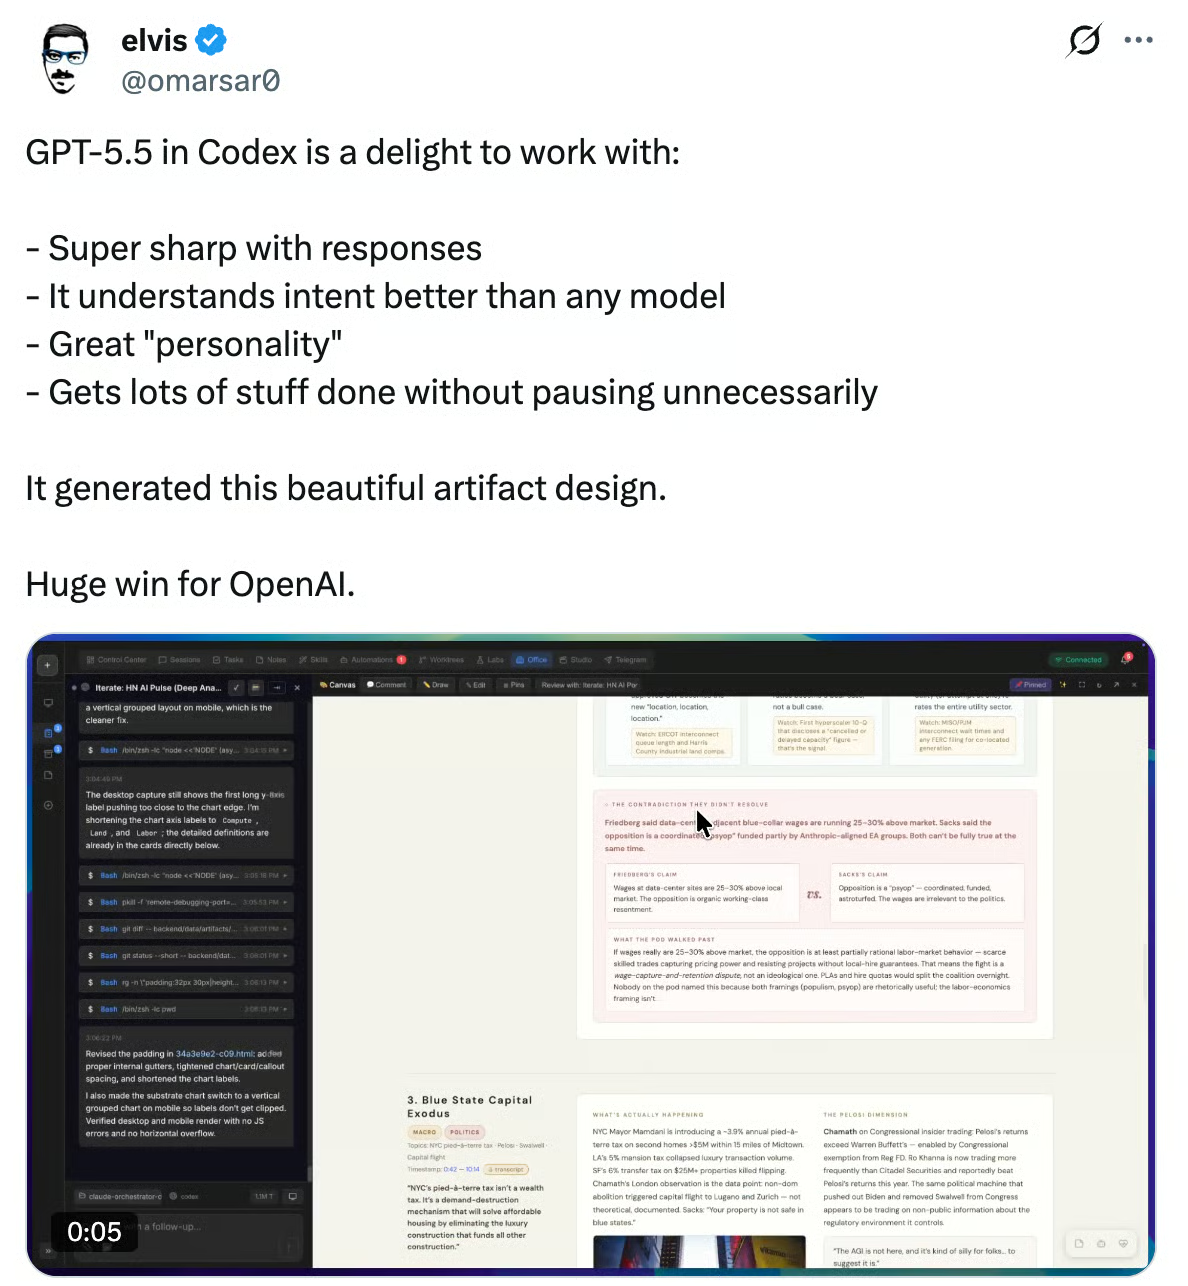
अन्य उपयोगकर्ता नोट करते हैं कि यद्यपि यह GPT-5.4 से एक कदम आगे हो सकता है, लेकिन बड़ी मूल्य-वृद्धि को जायज़ ठहराने के लिए यह पर्याप्त नहीं हो सकता।
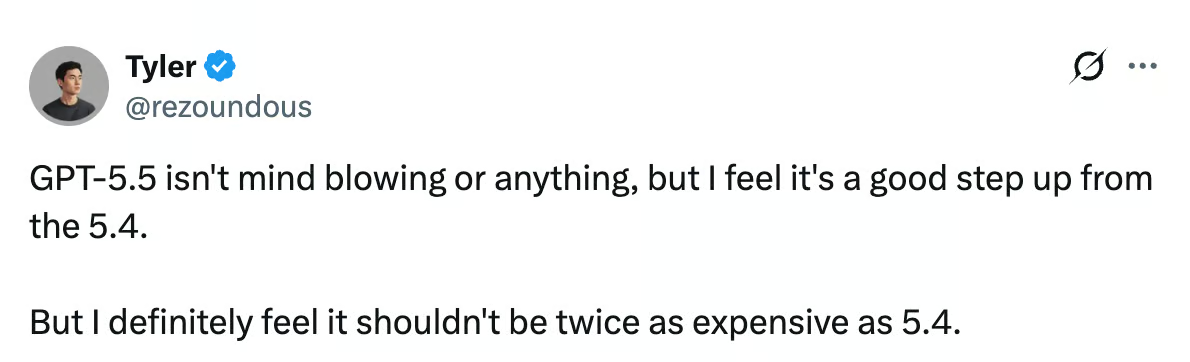
GPT-5.5 एक क्रमिक क्षमता अपडेट है, जिसके साथ एक गैर-क्रमिक नीति अपडेट जोड़ा गया है। मॉडल तेज़ है, प्रति कार्य सस्ता पड़ता है, और लंबे कॉन्टेक्स्ट वाले कार्यों में अर्थपूर्ण रूप से बेहतर है। बेंचमार्क परिणामों में हम ये दावे साफ़ देखते हैं।
हमारे अपने टेस्ट अधिक सूक्ष्म तस्वीर दिखाते हैं। लंबे-कॉन्टेक्स्ट में सुधार वास्तविक हैं, और GPT-5.5 ने निर्देश-पालन वाले हमारे टेस्ट में सभी 12 बाधाएँ साध लीं (वही प्रॉम्प्ट जिसमें Claude Opus 4.7 और Sonnet 4.6 ने 11/12 स्कोर किया), लेकिन दक्षता की बढ़त की कीमत चुकानी पड़ी: GPT-5.5 बार-बार उस समेशन कार्य में असफल रहा जिसे GPT-5.4 ने साधारण प्रॉम्प्ट-विभाजन के बाद संभाल लिया था। यह आउटपुट संक्षिप्तता और तर्क प्रदर्शन के बीच एक ट्रेड-ऑफ का संकेत देता है।
यह रिलीज़ पहली बार है जब OpenAI ने पूछने वाले के आधार पर साइबरसुरक्षा एक्सेस को औपचारिक रूप से स्तरीकृत किया है, जो पूरे उद्योग के लिए दिलचस्प विकास है।
यदि आप ChatGPT या Codex में हैं, तो आपके पास आज ही नए मॉडल की पहुँच है। यदि आप API उपयोगकर्ता हैं, तो आपको इंतज़ार करना पड़ रहा है, जो, जैसा हमने कहा, OpenAI आमतौर पर नहीं करता, लेकिन शायद जल्द ही आ रहा है।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें