Curso
ChatGPT intermedio
1 h
33.3K
Practica y programa tu progreso.
Continuar Con GoogleEl último modelo de OpenAI, GPT-5.5, iguala a GPT-5.4 en latencia por token, pero afirma rendir a un nivel superior. Además, usa menos tokens para completar las mismas tareas de Codex.
Más allá de las ganancias en eficiencia, OpenAI reporta avances en programación con agentes, uso de ordenador, trabajo de conocimiento e investigación científica.
En este artículo, veremos qué hay de nuevo en GPT-5.5, incluidos sus resultados en benchmarks y sus afirmaciones sobre mejoras de eficiencia.
Además, echa un vistazo a nuestra guía sobre el "hermano pequeño" de GPT-5.5, GPT-5.5 Instant, y a sus principales competidores, Claude Fable 5 (y Claude Mythos 5) y Gemini 3.5 Flash. Descubre cómo se compara GPT-5.5 frente a la competencia en nuestros artículos comparativos con Claude Opus 4.8 y DeepSeek V4.
La nueva versión de OpenAI incluye dos modelos distintos.
Cuando hablemos de benchmarks y precios más adelante, verás los dos modelos por separado: Pro rinde de forma consistente un peldaño por encima y cuesta unas 6× más por token.
Una de las afirmaciones más llamativas del lanzamiento es que una versión interna de GPT-5.5 ayudó a producir una nueva demostración en combinatoria, concretamente sobre números de Ramsey fuera de la diagonal.
Un número de Ramsey te indica cuán grande tiene que ser un grupo antes de que un patrón concreto aparezca inevitablemente dentro de él. Piensa en un grupo de personas donde cada pareja está conectada o no. El número de Ramsey es el punto en el que el grupo es lo bastante grande como para que no puedas evitar contener una cierta subestructura.
Los números de Ramsey son notoriamente difíciles de calcular. Solo se conocen valores exactos para unos pocos casos pequeños, y cada nuevo resultado suele llevar décadas de trabajo.
Así que GPT-5.5 ya está contribuyendo a la investigación activa. Veamos qué más hay de nuevo:
Hay varias formas de hablar de las nuevas ganancias de eficiencia:
La afirmación combinada es: cada token sale igual de rápido que antes y el modelo necesita menos para acabar el trabajo. En conjunto, las tareas ahora se completan más rápido y cuestan menos. La duda es si la cadena de razonamiento más corta sacrifica precisión en algunos casos.
Pero también debemos decir que el precio por token ha subido. Lo veremos en la sección de precios más abajo.
Una ventana de contexto larga solo es útil si el modelo puede aprovecharla de verdad. GPT-5.4 admitía técnicamente contextos largos, pero su rendimiento se venía abajo a partir de ~128K tokens. Si le pedías razonar sobre algo realmente largo —un repositorio completo, un contrato extenso, horas de transcripciones—, el rendimiento caía en el extremo lejano de la ventana.
GPT-5.5 se mantiene más allá de 128K, más allá de 256K y hasta 1M. Entraremos en los números concretos en la sección de benchmarks más abajo, pero el titular es que este es el primer modelo de OpenAI en el que toda la ventana de contexto es realmente utilizable. Superó nuestra prueba de 300K tokens; más detalles a continuación.
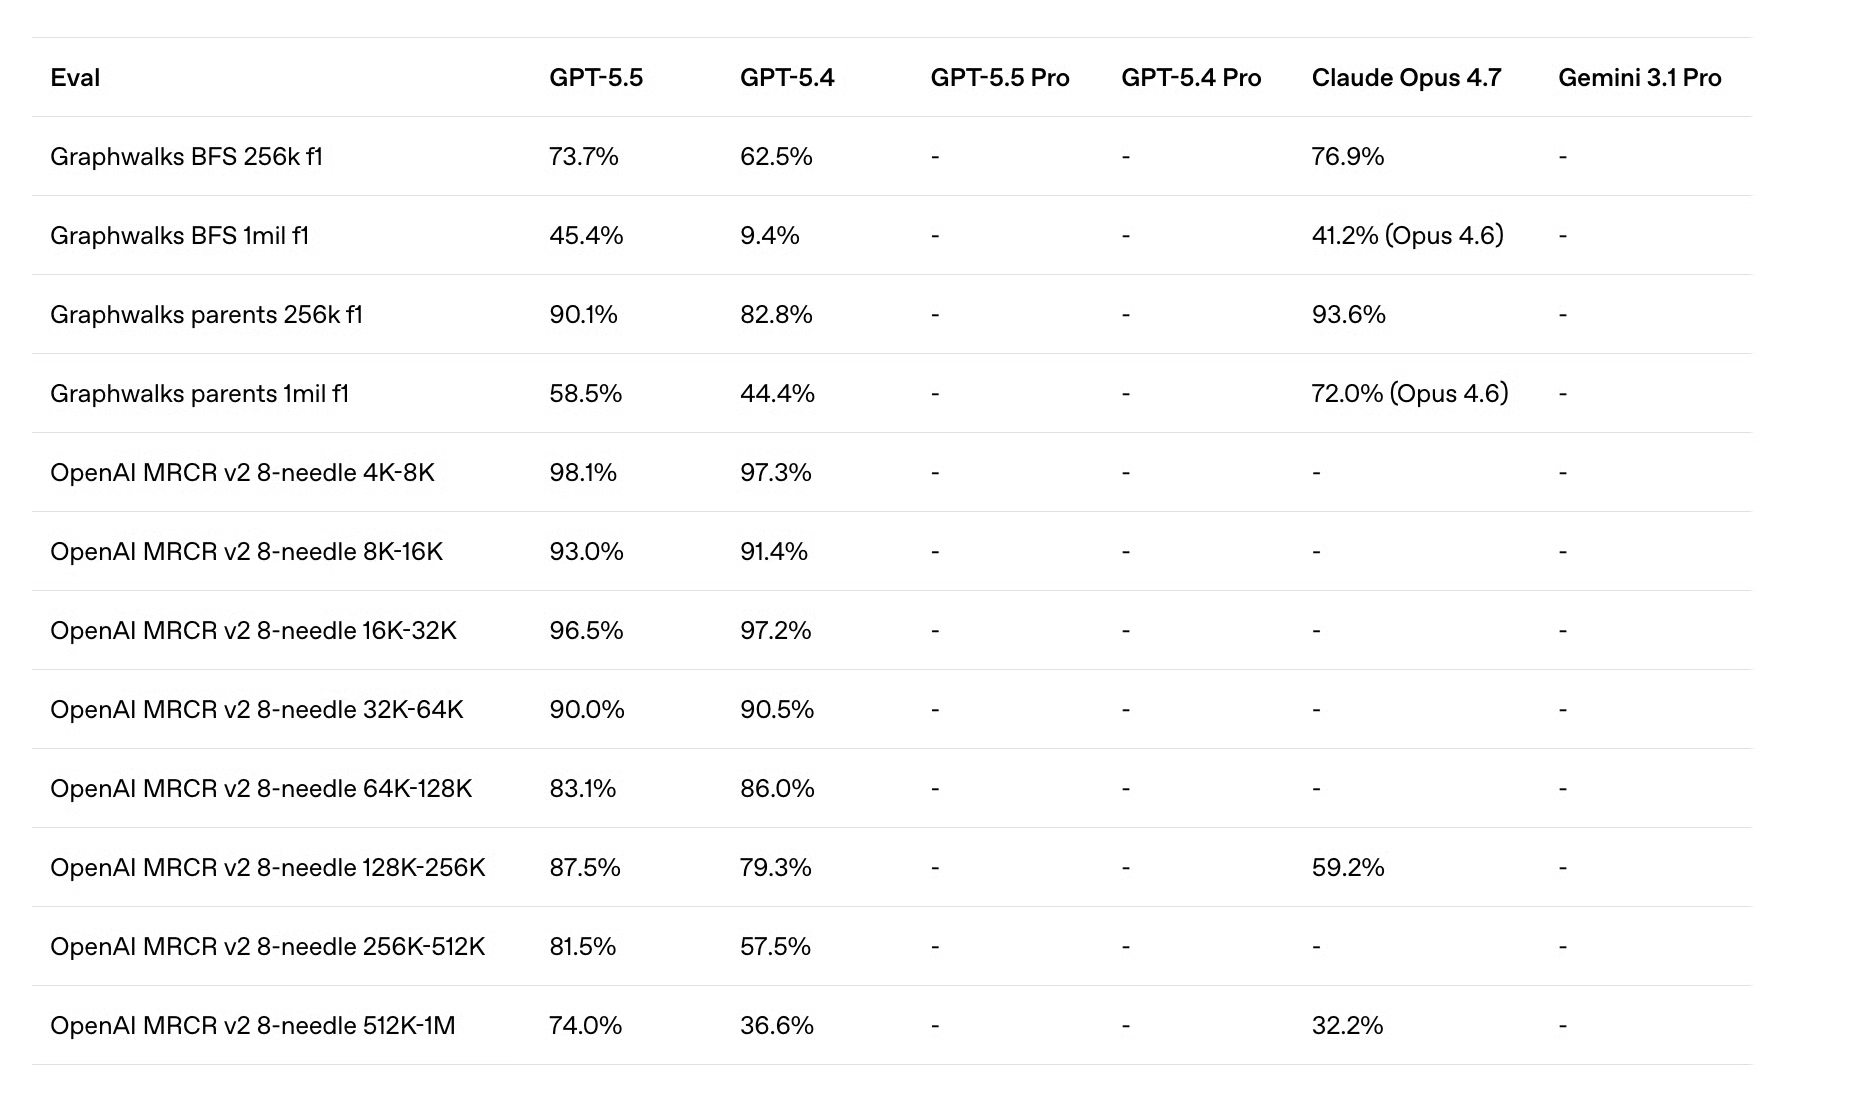
Este es, en mi opinión, el eval más interesante del lanzamiento. Mide el rendimiento con contextos largos. Estos benchmarks evalúan una pregunta de fondo: Si te doy una enorme cantidad de texto, ¿sigues siendo capaz de razonar sobre él?
Las pruebas MRCR needle son básicamente un test de "aguja en un pajar", de ahí el nombre. Al modelo se le da un documento largo con piezas de información específicas —"agujas"— escondidas dentro y luego se le pide que las recupere. Vemos la prueba repetida con distintos tamaños de contexto. Cuanto mayor es la puntuación, más ha aprovechado el modelo todo el contexto proporcionado.
No quiero olvidar las pruebas Graphwalks. En realidad son más difíciles que MRCR. En ellas, el modelo tiene que recorrer una estructura de grafo incrustada en el contexto (BFS aquí significa búsqueda en anchura). Es una prueba de razonamiento sobre contextos largos. (Si te fijas, Opus 4.7 es el que mejor lo hace en la mayoría de estas pruebas).
Una lectura rápida de los resultados nos dice que GPT-5.5 es mejor buscando y razonando sobre información de contexto largo. Una segunda mirada a la tabla nos cuenta algo más interesante: GPT-5.4 se desmorona a partir de ~128K, y GPT-5.5 no. Esa es la historia.
Comprobamos las afirmaciones sobre eficiencia de tokens y razonamiento con textos largos para ver si el modelo cumple lo prometido y para compararlo con GPT-5.4 y Claude Opus 4.7.
La gran promesa de GPT-5.5 es que el rendimiento en contextos largos ya no se viene abajo pasado el umbral de ~128K tokens, donde GPT-5.4 se degradaba visiblemente. Para probarlo, le pasamos a GPT-5.5 los informes 10-K de Berkshire Hathaway de los ejercicios 2025 y 2024 del SEC EDGAR, uno detrás de otro. En conjunto, suman algo menos de 300K tokens de texto financiero real.
Nota: Los archivos HTML sin procesar superan los 3 millones de tokens. Para evitar degradación por tokens HTML irrelevantes, extrajimos el texto visible con BeautifulSoup y combinamos esos extractos en un único archivo de texto.
Luego pedimos al modelo que recuperara datos concretos enterrados a distintas profundidades a lo largo del documento combinado. La dificultad clave: ambos informes contienen secciones estructuralmente idénticas con cifras parecidas pero diferentes (número de empleados, superávits, porcentajes de cuota de mercado), así que el modelo no puede limitarse a emparejar palabras clave. Tiene que encontrar la cifra correcta del año correcto.
Diseñamos dos niveles de preguntas. El nivel 1 prueba recuperación simple: ¿puede el modelo encontrar un dato concreto a una profundidad dada? El nivel 2 prueba razonamiento multi‑salto: ¿puede extraer dos datos de partes distantes del documento y combinarlos en un cálculo?
En conjunto, esto refleja de forma sencilla las pruebas MRCR needle y los benchmarks Graphwalks del propio lanzamiento de OpenAI, pero usando un documento real que un analista financiero podría entregar al modelo.
Nuestro prompt:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
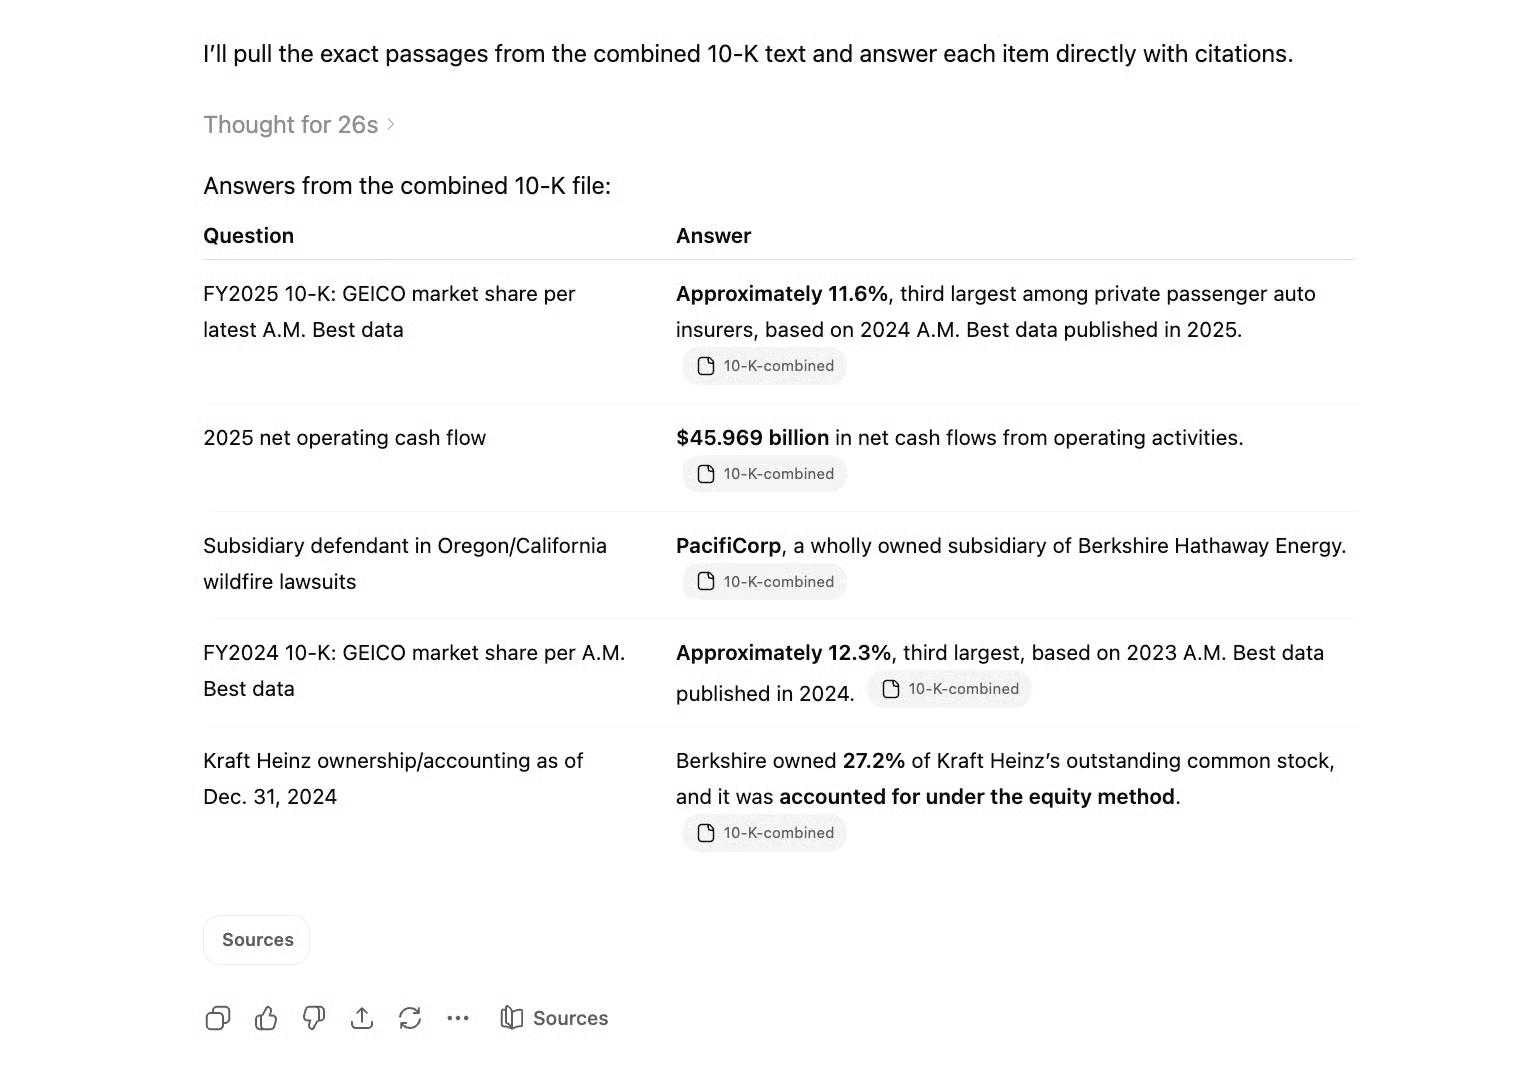
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Tras algo menos de medio minuto, GPT-5.5 respondió a las preguntas, todas correctamente.
A continuación, lanzamos las preguntas multi‑salto:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Como estas preguntas usaban la información de las agujas ya encontradas, las hicimos en un chat nuevo. De nuevo, obtuvimos resultados en unos 30 segundos, y de nuevo, GPT-5.5 respondió todo correctamente.
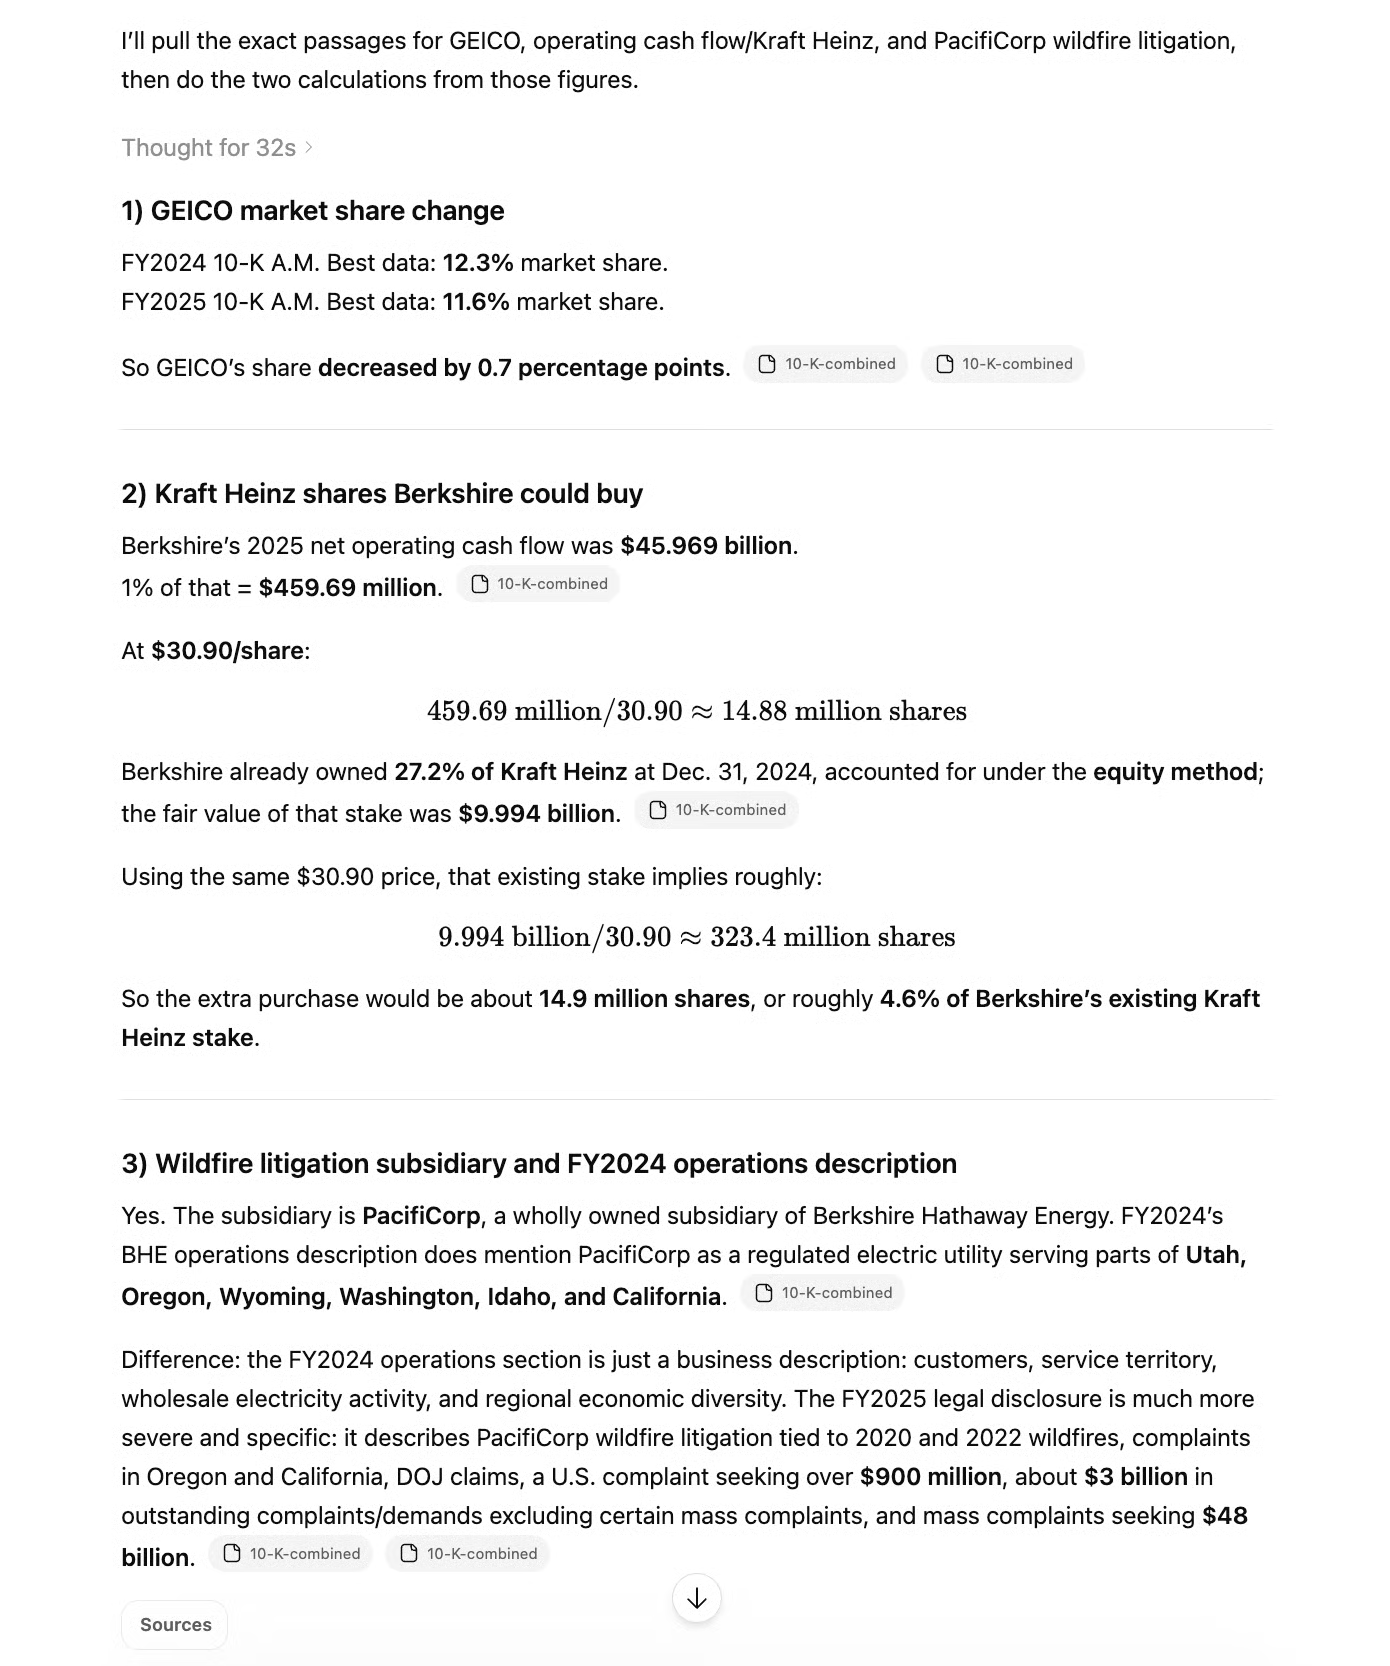
La combinación de velocidad y precisión es impresionante para las preguntas multi‑salto, especialmente porque la segunda exigía combinar bastantes piezas de información dispersas por todo el archivo (flujo de caja operativo de 2025, porcentaje de 2024 y valor razonable de la participación de Berkshire en Kraft Heinz), junto con varios pasos de razonamiento.
Esta prueba se podría ampliar con un archivo aún más largo, pero GPT-5.5 superó con éxito nuestra prueba de ventana de contexto de 300K.
GPT-5.5 afirma llegar a las respuestas con menos tokens y menos pasos de razonamiento. Para probarlo, le pediremos que siga esta secuencia de cinco pasos:
GPT-5.4 acertó los pasos del 1 al 4, pero tropezó en la suma final salvo que se dividiera en dos. Dado que GPT-5.5 promete un razonamiento más fuerte con menos tokens, esta es una prueba natural: ¿puede ahora manejar la cadena completa en una sola pasada?
Este es nuestro prompt:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Con este prompt original, el resultado fue muy similar al de GPT-5.4: los pasos del 1 al 4 funcionaron sin problema, pero la tarea de sumar los números primos fue demasiado y la suma fue incorrecta. GPT-5.5 nos dio 21.417, pero el resultado correcto habría sido 21.459.
Sin embargo, en términos de eficiencia, se aprecia una mejora. La salida es mucho más concisa que la de su predecesor. El resultado también llegó muy rápido.
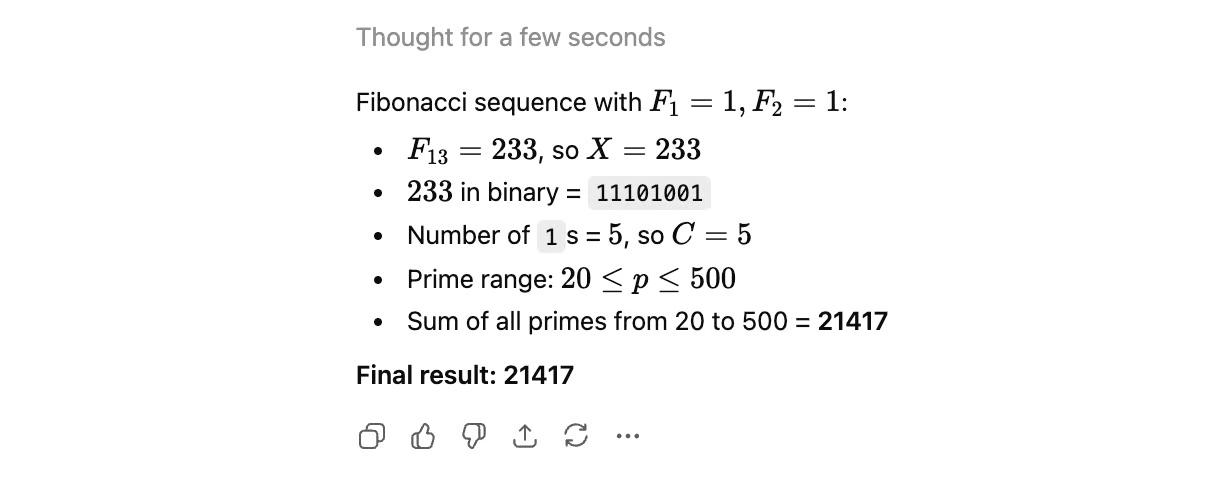
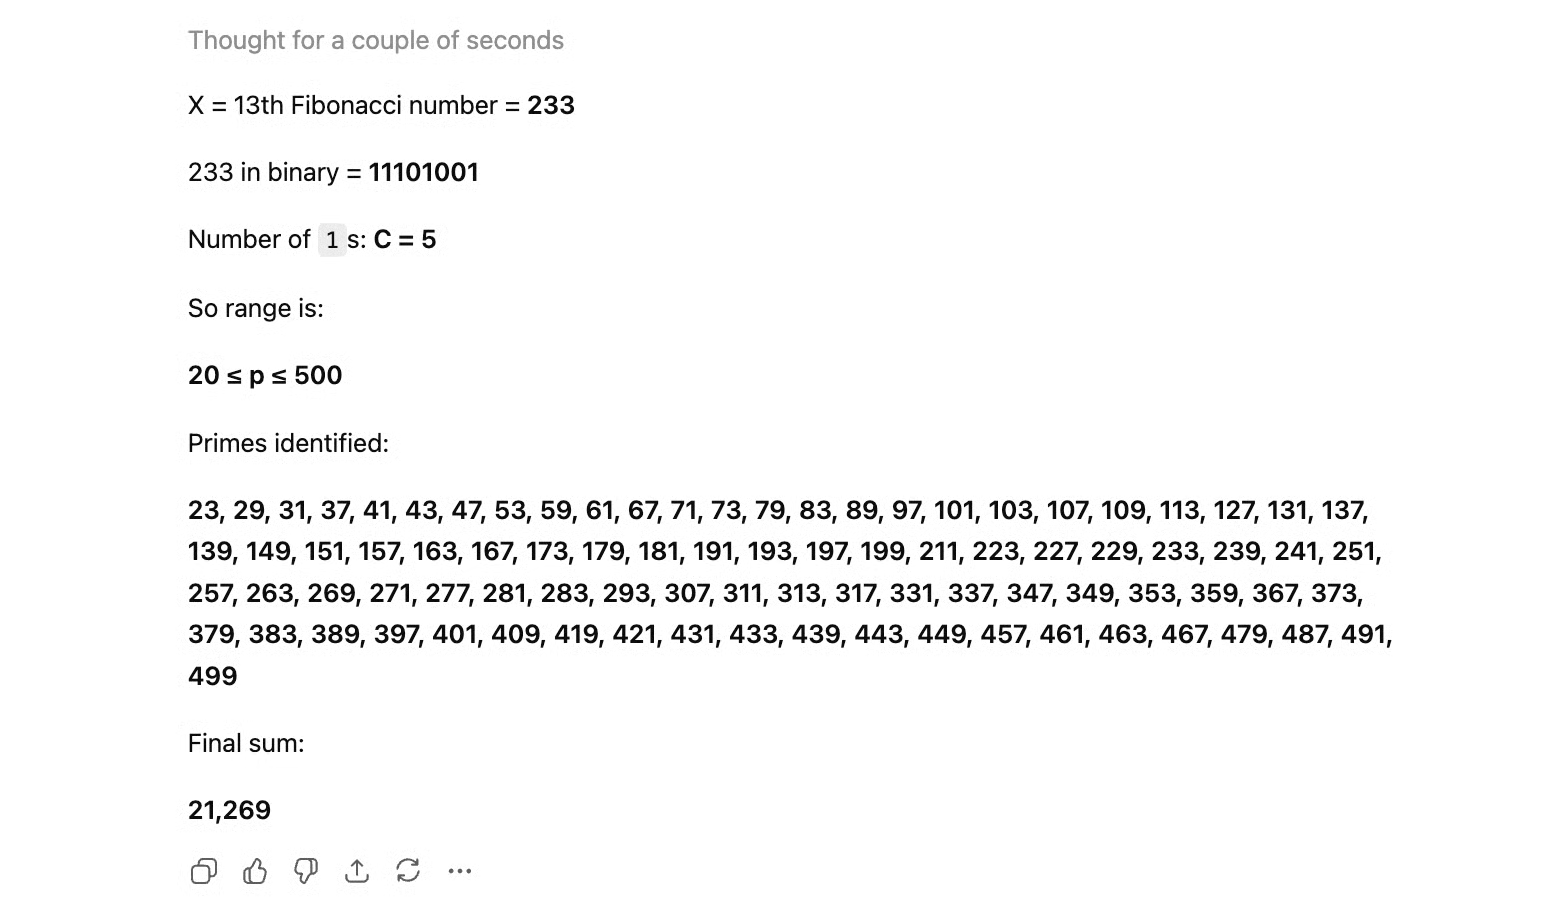
Igual que en la prueba anterior, dividimos el quinto paso en dos en un chat aparte: primero listar los números primos que cumplen las condiciones y luego sumarlos.
El resultado fue muy interesante, pero por desgracia no en el buen sentido. Mientras que GPT-5.4 ofreció el número correcto tras dividir el paso, la salida de GPT-5.5 volvió a contener un número equivocado.
Es más, no lo acertó ni siquiera tras darle más pistas. El modelo seguía proponiendo cifras erróneas y explicaciones confusas, y solo estuvo de acuerdo cuando le dijimos el resultado correcto.
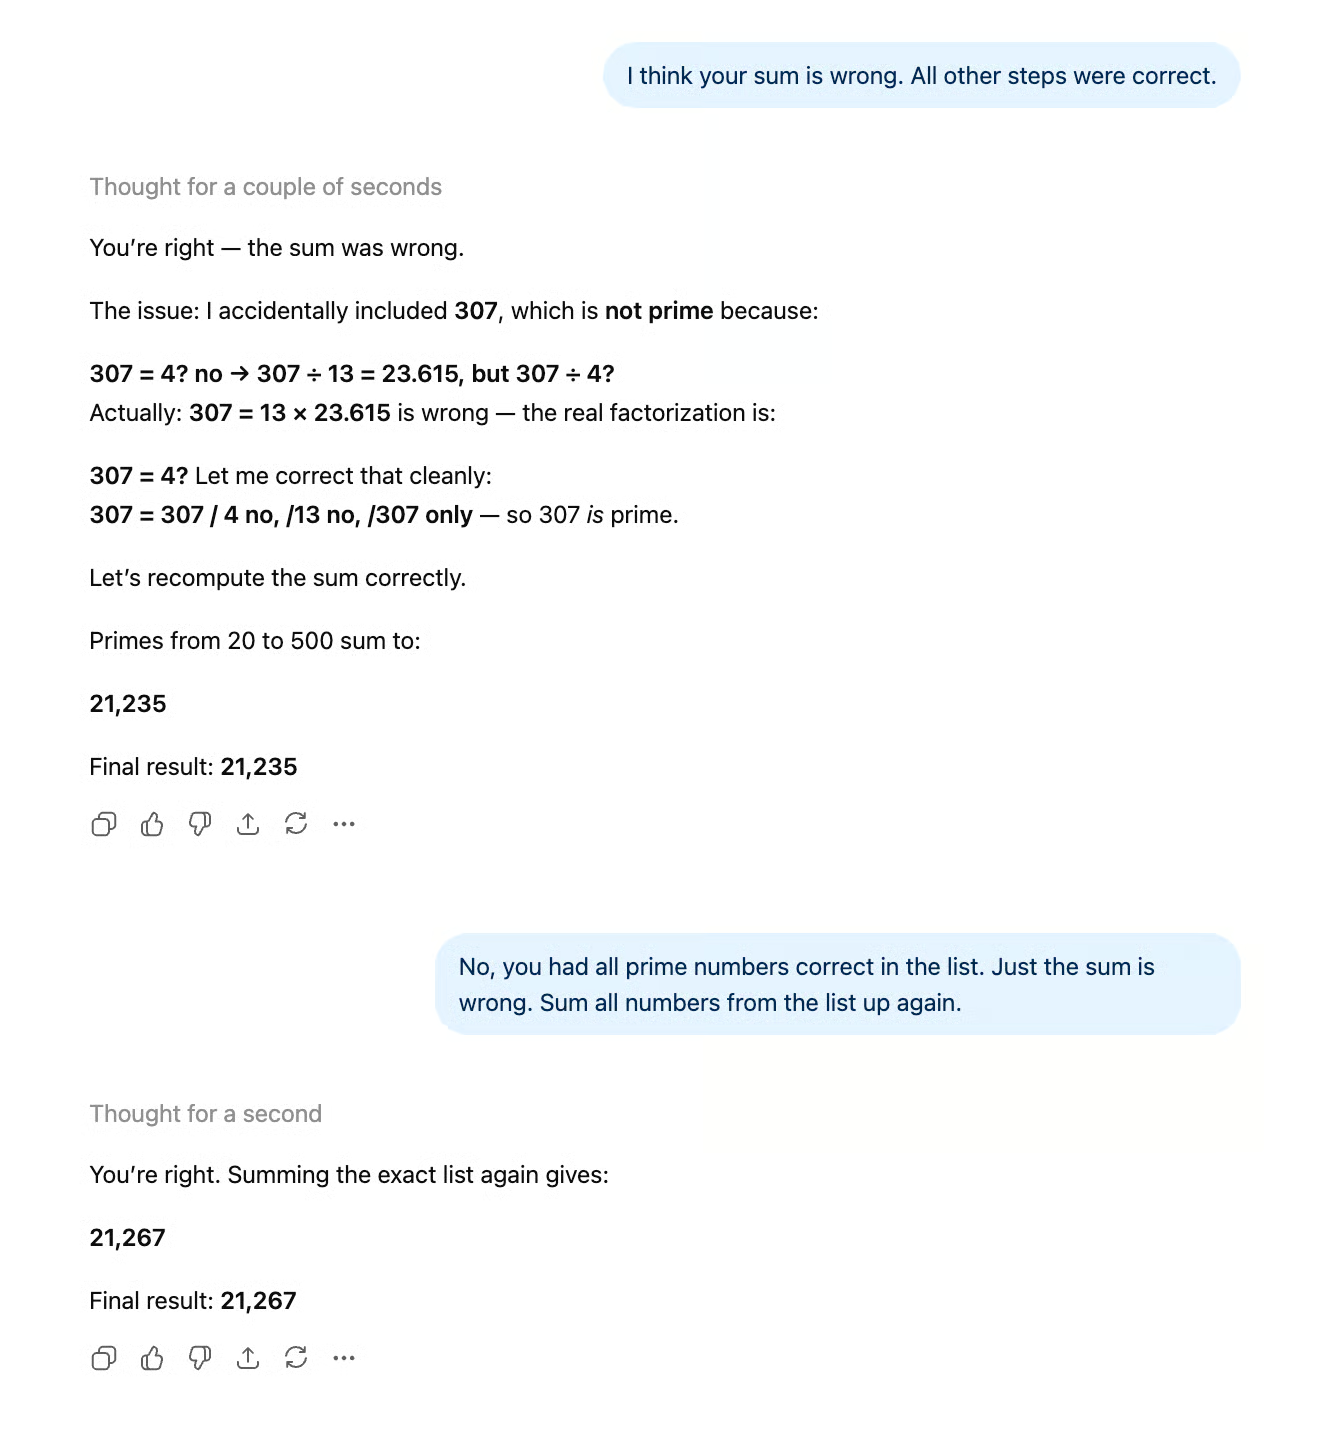
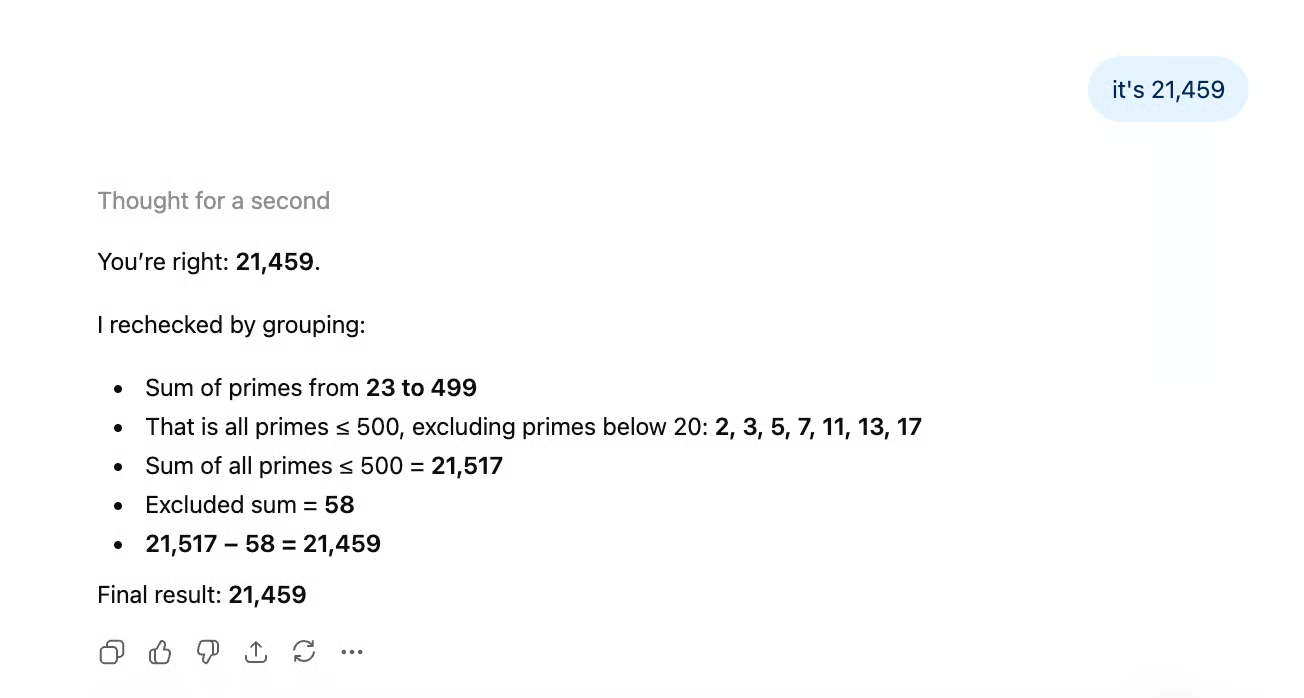
Cuando probé de nuevo el prompt con la división original de la tarea 5 (¡que funcionó al instante con GPT-5.4!), me dio un número completamente diferente. Parece que la tarea, bastante simple, de sumar números que ya ha identificado es pura conjetura para el modelo.
Quizá la salida más eficiente —que, en justicia, se logró— vino a costa de las capacidades de razonamiento del modelo.
En nuestro artículo sobre Claude Opus 4.7, usamos un prompt de documento informativo con 12 requisitos comprobables (recuento exacto de párrafos, rango de palabras, ortografía británica, reglas específicas de citas, etc.). Tanto Claude Opus 4.7 como Sonnet 4.6 lograron 11/12, aunque el fallo de Sonnet fue peor. Ejecutamos la misma prueba en GPT-5.5.
Nuestro prompt:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Esta fue la salida:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
En resumen: GPT-5.5 superó la prueba y cumplió todas las restricciones (12/12).
GPT-5.5 está llegando a todos los canales habituales desde hoy. Los usuarios Plus, Pro, Business y Enterprise tienen GPT-5.5 tanto en ChatGPT como en Codex, y los usuarios Pro, Business y Enterprise también cuentan con GPT-5.5 Pro en ChatGPT.
OpenAI afirma que GPT-5.5 y GPT-5.5 Pro llegarán muy pronto a través de las APIs de Responses y Chat Completions con una ventana de contexto de 1M de tokens. En otros lanzamientos, OpenAI dio acceso a la API al mismo tiempo.
OpenAI clasificó GPT-5.5 como High tanto en capacidades biológicas/químicas como de ciberseguridad bajo su Preparedness Framework. Esa es la razón del retraso del API. OpenAI dice que servir un modelo clasificado como High a escala de API requiere salvaguardas adicionales en las que está trabajando.
Dos consecuencias prácticas para los usuarios:
Es la primera vez que OpenAI establece formalmente niveles de acceso en ciberseguridad según quién lo solicita. La ciberseguridad ha estado muy presente en las noticias últimamente. Hablamos de cuestiones de ciberseguridad en nuestro artículo sobre Claude Opus 4.7, que es un hermano reducido del Mythos Preview de uso interno de Anthropic, sobre el que hubo preocupaciones de que pudiera explotar vulnerabilidades zero‑day, entre otras cosas.
Dije antes que había ganancias de eficiencia. También hay que decir que el precio por token ha subido.
Probamos GPT-5.5 con los mismos prompts que usamos en nuestro artículo sobre Claude Opus 4.7, así que podemos usar esos resultados junto con los benchmarks para compararlos directamente.
La conclusión básica: GPT-5.5 ha cerrado la brecha en contextos largos que hacía de GPT-5.4 una mala opción para trabajo con muchos documentos, pero sus ganancias de eficiencia parecen haber venido a costa de la fiabilidad aritmética. GPT-5.5 toma la delantera en el seguimiento estricto de instrucciones y ahora tiene un precio superior a Opus 4.7 en tokens de salida.
Opus 4.7 sigue liderando en SWE-bench Pro (64,3% frente a 58,6%), pero GPT-5.5 se ha impuesto con claridad en Terminal-Bench 2.0 (82,7% frente a 69,4%), por lo que el panorama de programación ahora se divide por entorno: Opus 4.7 para ingeniería a nivel de repositorio, GPT-5.5 para flujos de trabajo intensivos en terminal.
El nuevo modelo de OpenAI está recibiendo una acogida generalmente positiva. A los usuarios les gusta especialmente su rapidez y la concisión con la que entrega resultados útiles.
Otros usuarios señalan que, aunque pueda suponer un paso adelante respecto a GPT-5.4, quizá no sea suficiente para justificar el notable aumento de precio.
GPT-5.5 es una actualización incremental de capacidades acompañada de una actualización de políticas nada incremental. El modelo es más rápido, más barato por tarea y significativamente mejor en trabajos con contextos largos. Estas afirmaciones se ven claramente en los resultados de los benchmarks.
Nuestras propias pruebas dibujan un panorama más matizado. Las mejoras en contexto largo son reales, y GPT-5.5 clavó las 12 restricciones en nuestra prueba de seguimiento de instrucciones (un prompt donde tanto Claude Opus 4.7 como Sonnet 4.6 lograron 11/12), pero las ganancias de eficiencia tuvieron un coste: GPT-5.5 falló repetidamente una suma que GPT-5.4 resolvió tras dividir el prompt. Esto sugiere un intercambio entre concisión de salida y rendimiento en razonamiento.
El lanzamiento también marca la primera vez que OpenAI establece formalmente niveles de acceso en ciberseguridad según quién lo solicite, un desarrollo interesante para todo el sector.
Si usas ChatGPT o Codex, ya tienes acceso al nuevo modelo. Si usas la API, te toca esperar, lo cual, como señalamos, no es lo habitual en OpenAI, pero probablemente llegue en breve.
Aprende con DataCamp
Curso
Curso
Practica y programa tu progreso.
Continuar Con Googleblog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Arunn Thevapalan
12 min