



Kurs
ChatGPT für Fortgeschrittene
1 Std.
33.3K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleOpenAIs neuestes Modell, GPT-5.5, erreicht die gleiche Latenz pro Token wie GPT-5.4, soll aber insgesamt besser abschneiden. Zudem benötigt es für dieselben Codex-Aufgaben weniger Tokens.
Über die Effizienzgewinne hinaus meldet OpenAI Fortschritte beim agentischen Programmieren, in der Computerbedienung, bei Wissensarbeit und in der wissenschaftlichen Forschung.
In diesem Artikel schauen wir uns an, was in GPT-5.5 neu ist, einschließlich der Benchmark-Ergebnisse und der behaupteten Effizienzsteigerungen.
Sieh dir außerdem unseren Guide zum „kleinen Bruder“ von GPT-5.5 an, GPT-5.5 Instant, sowie zu seinen größten Konkurrenten, Claude Fable 5 (bzw. Claude Mythos 5) und Gemini 3.5 Flash. Wie GPT-5.5 im Direktvergleich abschneidet, erfährst du in unseren Artikeln zu Claude Opus 4.8 und DeepSeek V4.
OpenAIs neues Release umfasst zwei separate Modelle.
Wenn wir später über Benchmarks und Preise sprechen, tauchen die beiden Modelle getrennt auf — Pro liegt bei der Performance durchgehend eine Stufe höher und kostet pro Token rund 6× mehr.
Einer der interessantesten Punkte der Veröffentlichung: Eine interne Version von GPT-5.5 hat zu einem neuen Beweis in der Kombinatorik beigetragen, konkret zu off-diagonalen Ramsey-Zahlen.
Eine Ramsey-Zahl sagt dir, wie groß eine Gruppe werden muss, bevor darin ein bestimmtes Muster unvermeidlich auftritt. Denk an eine Gruppe von Personen, in der jedes Paar entweder verbunden ist oder nicht. Die Ramsey-Zahl markiert den Punkt, an dem die Gruppe groß genug ist, dass eine bestimmte Teilstruktur sicher enthalten ist.
Ramsey-Zahlen sind berüchtigt schwer zu berechnen. Exakte Werte sind nur für wenige kleine Fälle bekannt, und jedes neue Resultat erfordert oft Jahrzehnte Arbeit.
GPT-5.5 leistet also bereits Beiträge zur aktiven Forschung. Was ist noch neu?
Es gibt mehrere Arten, über die neuen Effizienzgewinne zu sprechen:
Die kombinierte Aussage lautet also: Jedes einzelne Token kommt genauso schnell wie zuvor, und das Modell braucht insgesamt weniger davon, um den Job zu erledigen. Zusammengenommen werden Aufgaben nun insgesamt schneller fertig und kosten weniger. Die Frage ist, ob die kürzere Reasoning-Kette an manchen Stellen Genauigkeit kostet.
Wir sollten aber auch sagen, dass der Preis pro Token gestiegen ist. Dazu später im Preisteil mehr.
Ein großes Kontextfenster ist nur dann nützlich, wenn das Modell es auch wirklich nutzen kann. GPT-5.4 unterstützte lange Kontexte zwar technisch, brach aber jenseits von ~128K Tokens ein. Musste es wirklich lange Inhalte verarbeiten — ein kompletter Codebase, ein ausgedehnter Vertrag, stundenlange Transkripte — sank die Leistung am hinteren Ende des Fensters deutlich.
GPT-5.5 hält über 128K und 256K hinaus bis auf 1M durch. Auf die genauen Zahlen gehen wir in den Benchmarks unten ein, aber die Überschrift lautet: Es ist das erste OpenAI-Modell, bei dem das gesamte Kontextfenster wirklich nutzbar ist. Unser 300K-Token-Test wurde bestanden; mehr dazu gleich.
Hier ist meines Erachtens die interessanteste Model-Eval aus dem Release. Sie misst die Performance bei langem Kontext. Diese Benchmarks prüfen die Kernfrage: Wenn ich dir eine riesige Menge Text gebe, kannst du darüber noch schlüssig nachdenken?
Die MRCR-Needle-Tests sind im Grunde ein „Nadel im Heuhaufen“-Test, daher der Name. Das Modell erhält ein langes Dokument mit spezifischen Informationsstücken — den „Nadeln“ — und soll sie dann wiederfinden. Wir sehen den Test mehrfach mit unterschiedlichen Kontextgrößen. Je höher der Score, desto stärker hat das Modell den vollen Kontext tatsächlich genutzt.
Die Graphwalks-Tests sollte man nicht übersehen. Sie sind tatsächlich schwieriger als MRCR. Hier muss das Modell eine im Kontext eingebettete Graphstruktur durchlaufen (BFS bedeutet hier Breadth-First Search). Es ist ein Reasoning-Test über langen Kontext. (Wenn du genau hinsiehst, schneidet Opus 4.7 bei den meisten dieser Tests am besten ab.)
Ein schneller Blick auf die Ergebnisse zeigt: GPT-5.5 ist besser darin, in langen Kontexten zu suchen und zu schlussfolgern. Ein zweiter Blick verrät etwas Spannenderes: GPT-5.4 bricht jenseits von ~128K ein, GPT-5.5 nicht. Das ist die eigentliche Geschichte.
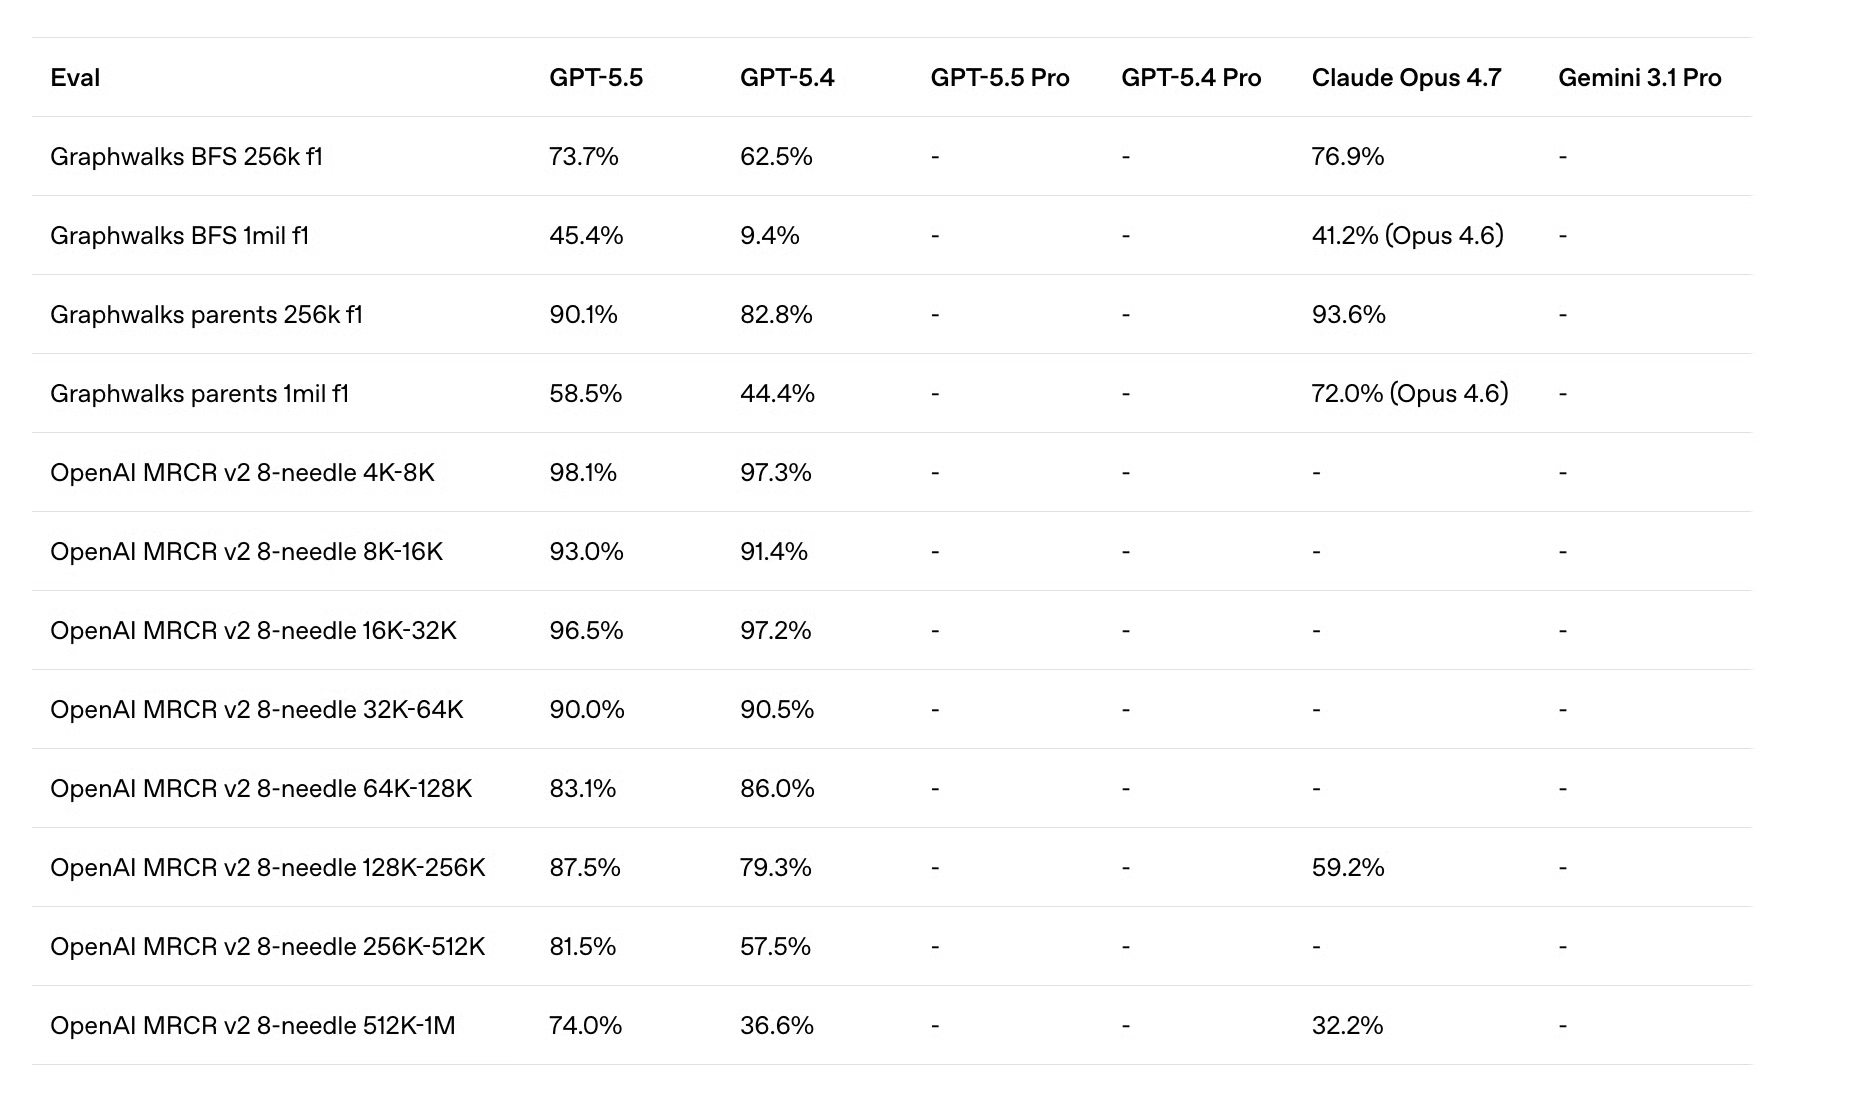
Wir haben die Behauptungen zur Token-Effizienz und zum stärkeren Long-Text-Reasoning überprüft, um zu sehen, ob das Modell liefert, was es verspricht, und Vergleiche mit GPT-5.4 und Claude Opus 4.7 gezogen.
Die zentrale Aussage von GPT-5.5 lautet, dass die Leistung bei langem Kontext jenseits von ~128K Tokens nicht mehr zusammenbricht — genau dort, wo GPT-5.4 sichtbar nachließ. Dafür haben wir GPT-5.5 die 10-K-Filings von Berkshire Hathaway für GJ2025 und GJ2024 aus der SEC EDGAR, Rücken an Rücken, vorgelegt. Zusammen ergeben sie knapp unter 300K Tokens echten Finanztext.
Hinweis: Die Roh-HTML-Dateien summieren sich auf über 3 Millionen Tokens. Um Einbrüche durch irrelevante HTML-Tokens zu vermeiden, haben wir den sichtbaren Text mit BeautifulSoup extrahiert und diese Auszüge in einer einzigen Textdatei zusammengeführt.
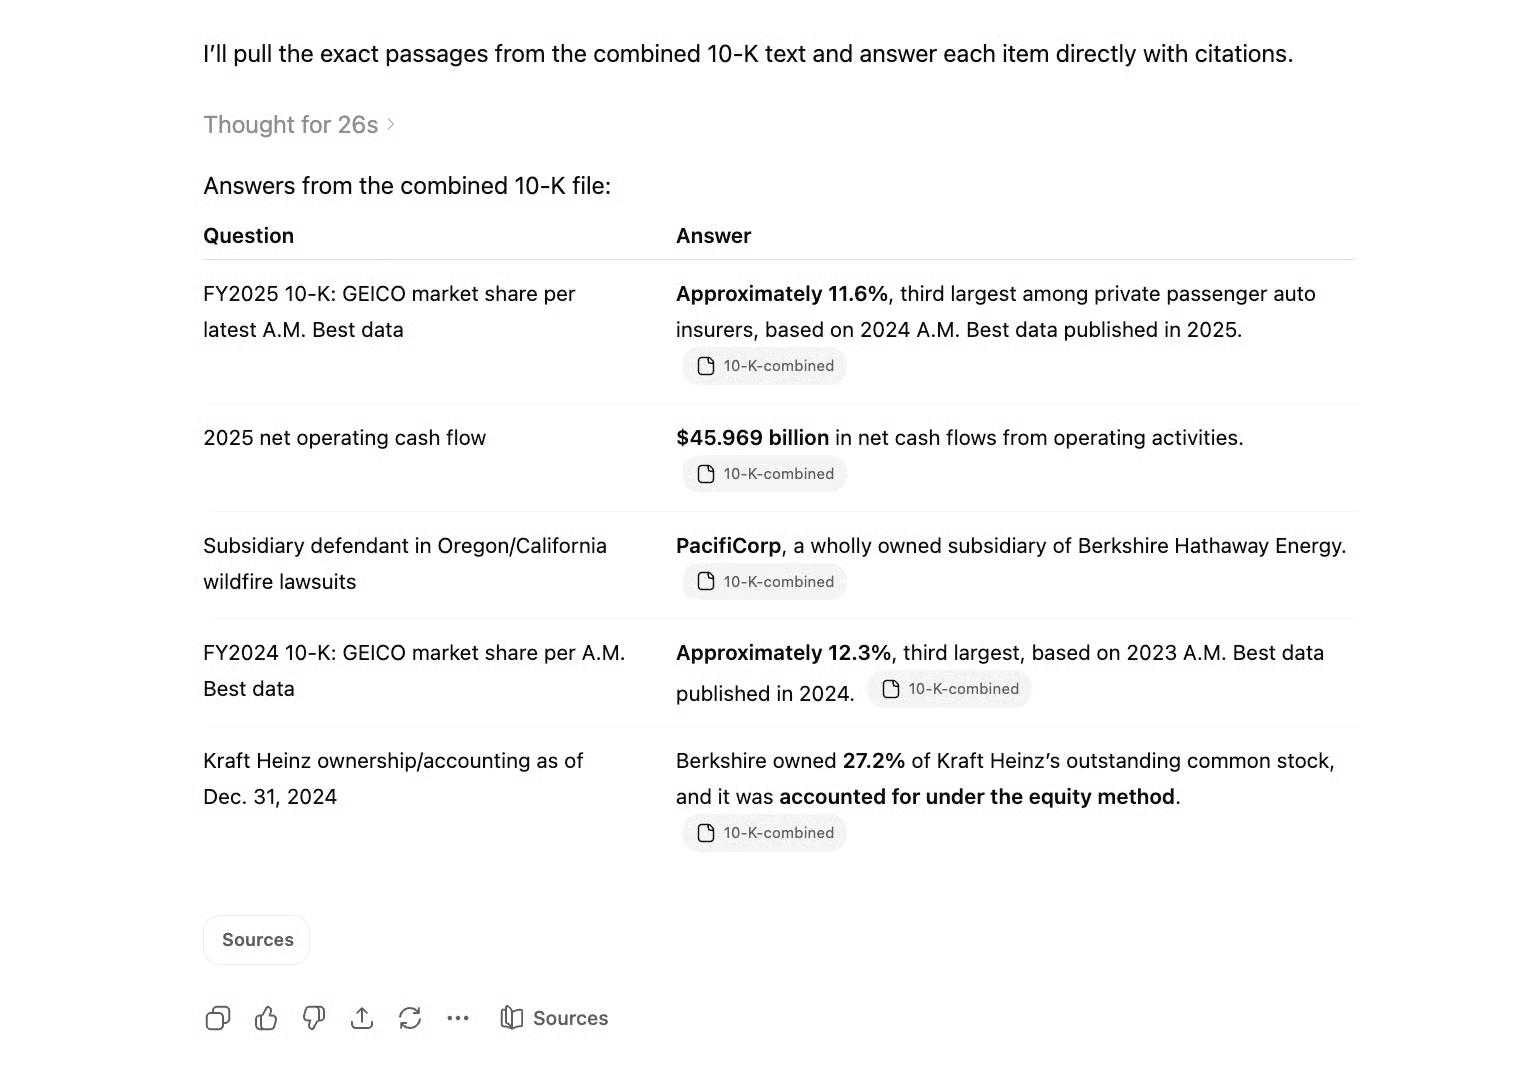
Anschließend baten wir das Modell, gezielte Fakten zu unterschiedlichen Tiefen im kombinierten Dokument zu finden. Die Herausforderung: Beide Filings enthalten strukturell identische Abschnitte mit ähnlichen, aber unterschiedlichen Zahlen (Mitarbeitendenzahlen, Überschussgrößen, Marktanteile), sodass sich die Antwort nicht per Keyword-Matching finden lässt. Es muss die richtige Zahl aus dem richtigen Jahr herausziehen.
Wir haben zwei Fragetypen entworfen. Tier 1 testet den einfachen Abruf: Findet das Modell einen spezifischen Fakt in einer bestimmten Tiefe? Tier 2 testet Multi-Hop-Reasoning: Kann es zwei Fakten aus weit entfernten Teilen des Dokuments ziehen und zu einer Rechnung kombinieren?
Zusammen spiegeln sie die MRCR-Needle-Tests und Graphwalks-Benchmarks aus OpenAIs Release in vereinfachter Form wider — allerdings an einem realen Dokument, wie es eine Finanzanalystin dem Modell tatsächlich geben könnte.
Unser Prompt:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
According to the most recent A.M. Best data cited in the FY2025 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?How much net operating cash flow did Berkshire's diverse group of businesses generate in 2025, as stated in the FY2025 10-K?Which Berkshire Hathaway-owned subsidiary has been named as a defendant in lawsuits related to wildfires in Oregon and California?According to the A.M. Best data cited in the FY2024 10-K, what was GEICO's approximate market share of private passenger automobile insurance based on written premiums?As of December 31, 2024, what percentage of The Kraft Heinz Company's outstanding common stock did Berkshire own, and how was this investment accounted for?
Nach etwa einer halben Minute beantwortete GPT-5.5 alle Fragen korrekt.
Als Nächstes stellten wir die Multi-Hop-Fragen:
Attached are Berkshire Hathaway's FY2025 and FY2024 10-K filings. Please read them and answer the following questions:
GEICO's market share changed between the A.M. Best data cited in the FY2024 10-K and the A.M. Best data cited in the FY2025 10-K. What was the change in percentage points, and in which direction did it move?
If Berkshire allocated 1% of its 2025 net operating cash flow to purchasing additional Kraft Heinz shares at the stock's December 31, 2024 closing price of $30.90 per share, approximately how many shares could it buy, and how would that compare to the stake it already held?
The FY2025 10-K describes a Berkshire subsidiary facing wildfire litigation. Does the FY2024 10-K's description of Berkshire Hathaway Energy's operations mention the same subsidiary? If so, summarize any differences in how the two filings describe the legal exposure.
Da diese Fragen Informationen aus den bereits gefundenen „Nadeln“ nutzten, stellten wir sie in einem neuen Chat. Wieder bekamen wir nach rund 30 Sekunden korrekte Antworten auf alle Fragen von GPT-5.5.
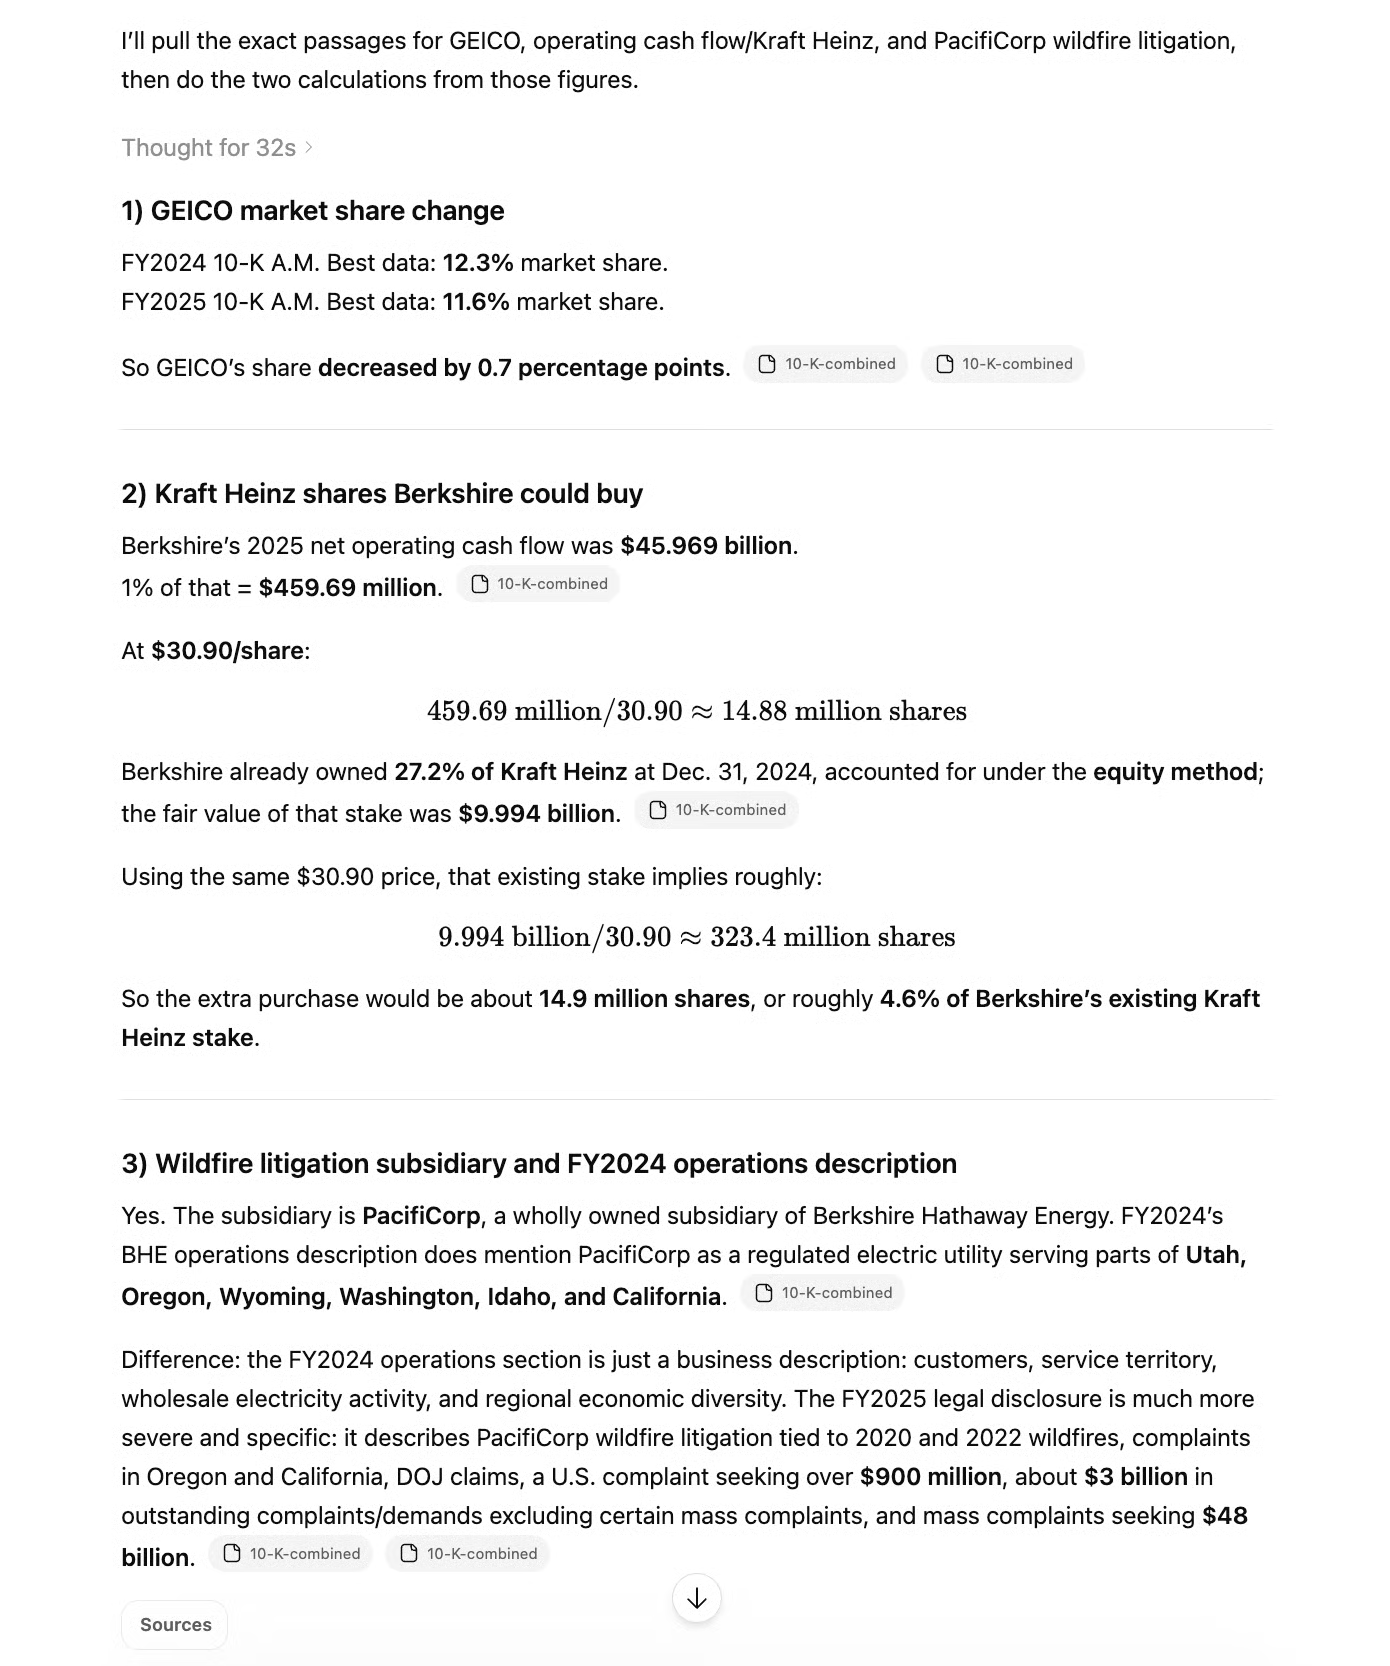
Die Kombination aus Tempo und Genauigkeit ist bei den Multi-Hop-Fragen beeindruckend, zumal Frage zwei allein bereits sehr viele, über die Datei verstreute Informationen zusammenführen musste (Netto-Mittelzufluss 2025 aus dem operativen Geschäft, 2024er-Prozentsatz und Fair Value von Berkshires Anteil an Kraft Heinz) sowie mehrere Reasoning-Schritte verlangte.
Der Test ließe sich auf eine noch längere Datei ausdehnen, aber GPT-5.5 hat unseren 300K-Kontextfenster-Test bestanden.
GPT-5.5 beansprucht, mit weniger Tokens und weniger Reasoning-Schritten ans Ziel zu kommen. Um das zu testen, lassen wir es diese fünfstufige Pipeline durchlaufen:
GPT-5.4 meisterte die Schritte 1 bis 4, stolperte aber bei der finalen Summation, sofern der Schritt nicht aufgeteilt wurde. Da GPT-5.5 stärkeres Reasoning mit weniger Tokens verspricht, ist das ein naheliegender Test: Schafft es die gesamte Kette nun in einem Durchgang?
Das ist unser Prompt:
Step 1: Find the 13th number in the Fibonacci sequence (starting with F1=1, F2=1). Let this be X.
Step 2: Convert X into a binary string (Base 2).
Step 3: Count the number of '1's in that binary string. Let this count be C.
Step 4: Identify all prime numbers (p) such that 20 ≤ p ≤ (C × 100).
Step 5: Calculate the sum of these primes. What is the final result?
Mit diesem Original-Prompt war das Ergebnis sehr ähnlich wie bei GPT-5.4: Schritte 1 bis 4 klappten problemlos, aber die Primzahl-Summation war zu viel, und die Summe lag daneben. GPT-5.5 lieferte 21.417, korrekt wären 21.459 gewesen.
In puncto Effizienz ist jedoch eine Verbesserung erkennbar. Die Ausgabe ist deutlich knapper als die des Vorgängers. Das Ergebnis kam zudem sehr schnell.
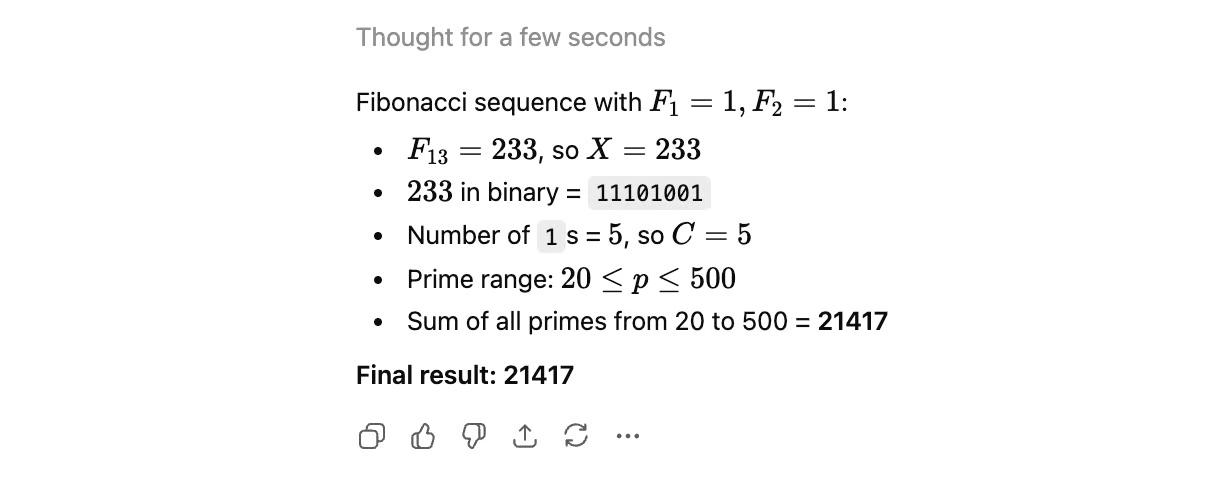
Wie im vorherigen Test haben wir den fünften Schritt in einem separaten Chat in zwei Schritte aufgeteilt: erst Auflisten der passenden Primzahlen, dann deren Addition.
Das Ergebnis war sehr interessant, aber leider nicht im positiven Sinne. Während GPT-5.4 nach der Aufteilung die richtige Zahl lieferte, enthielt GPT-5.5s Ausgabe erneut eine falsche Zahl.
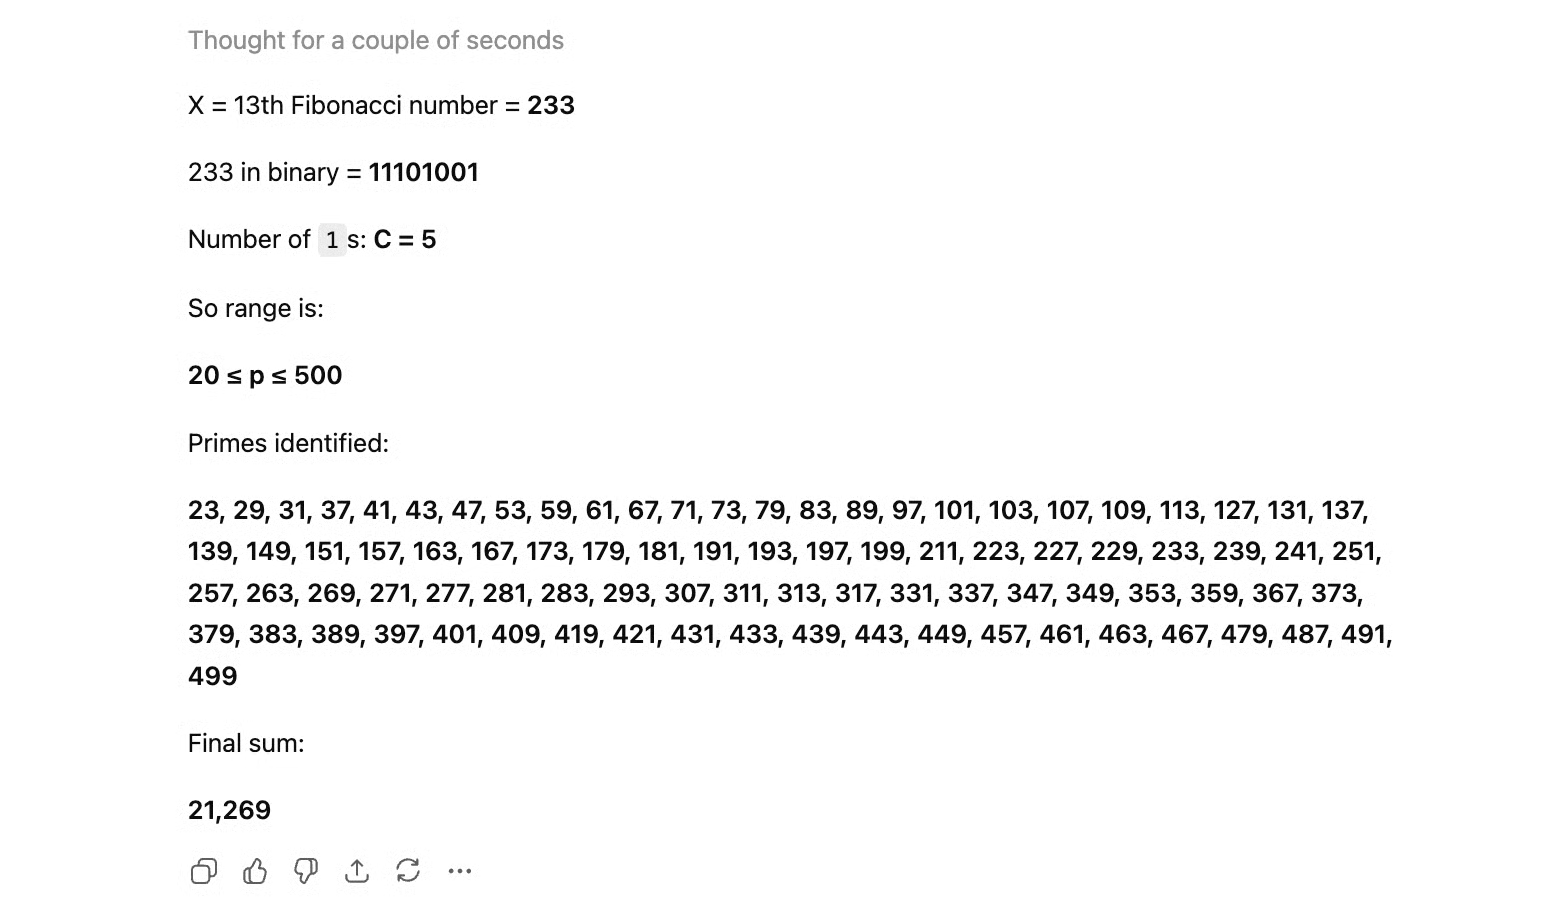
Mehr noch: Auch zusätzliche Hinweise halfen nicht. Das Modell produzierte weiterhin falsche Zahlen und verwirrende Erklärungen und stimmte uns erst zu, als wir ihm das korrekte Ergebnis nannten.
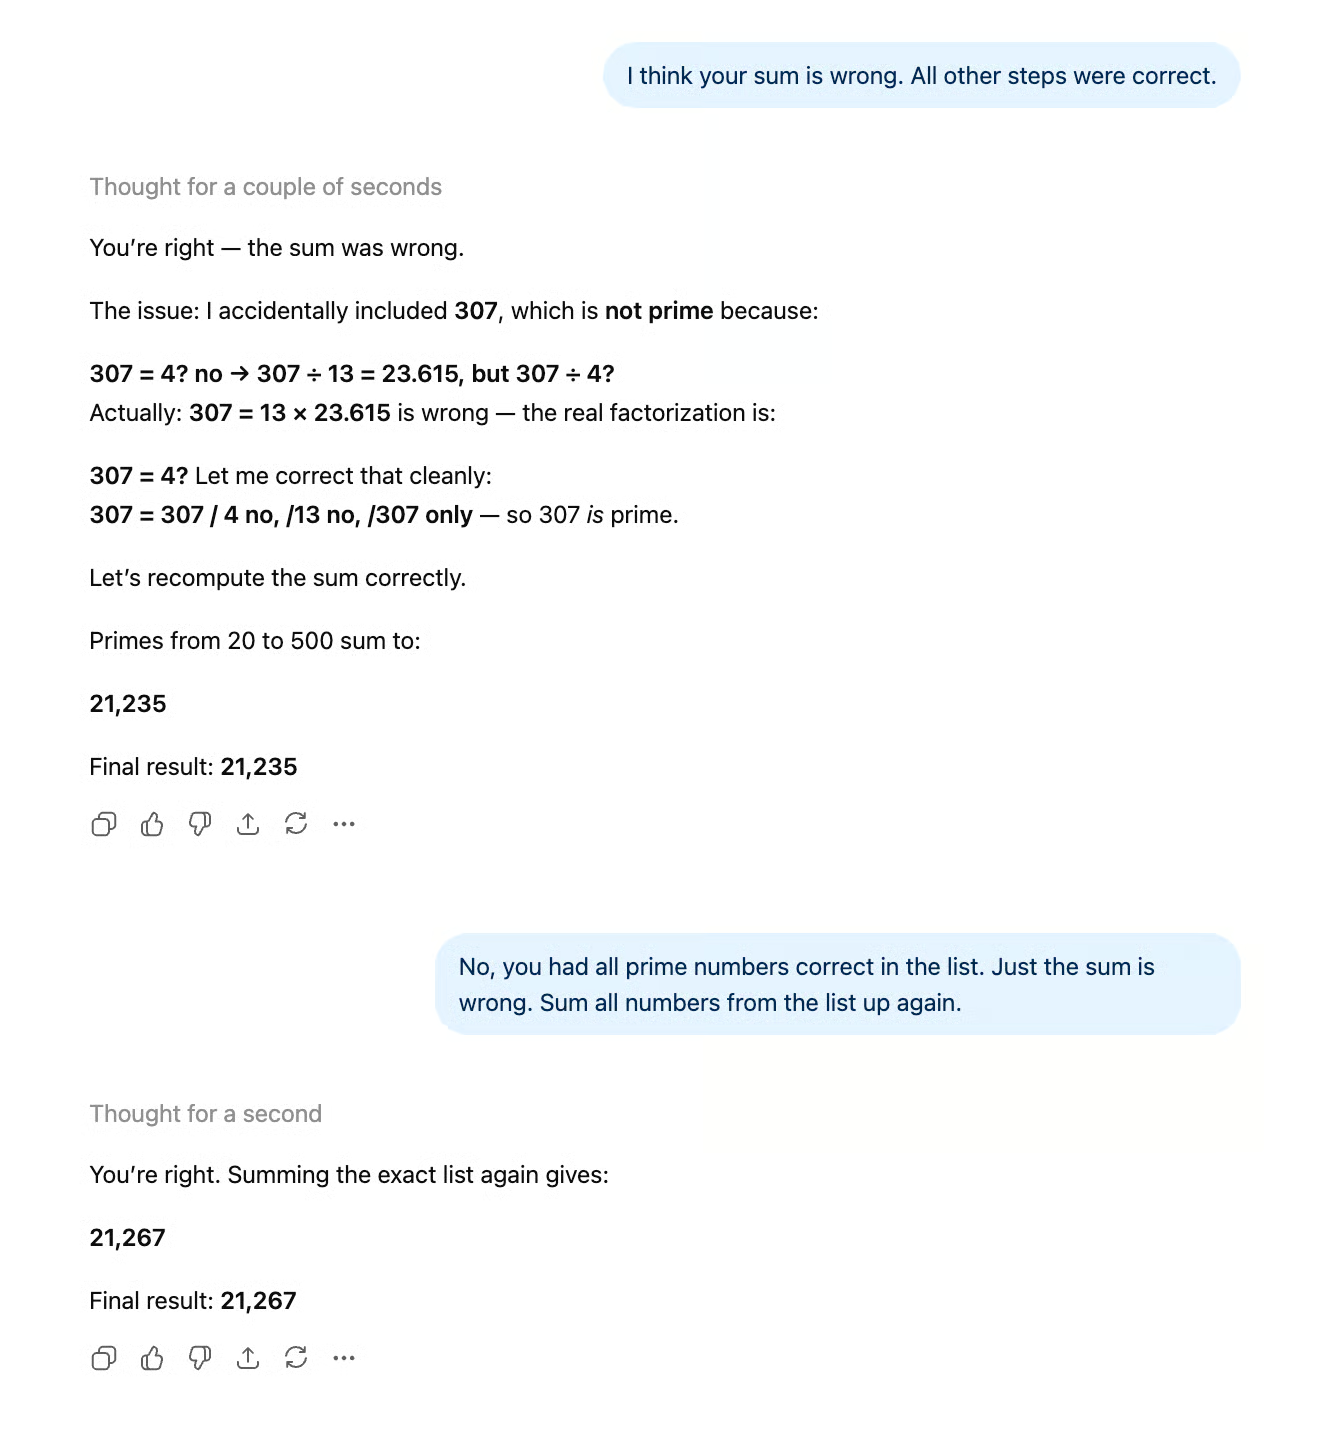
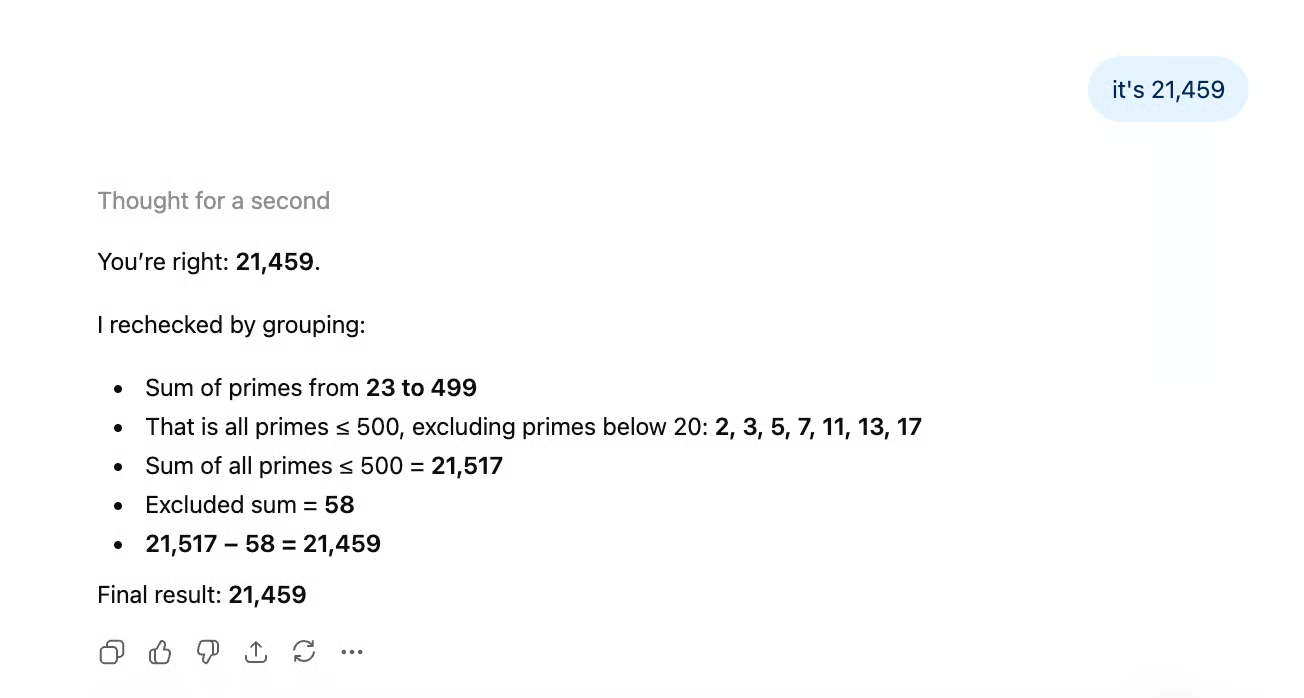
Als ich den Prompt mit der ursprünglichen, aufgeteilten Aufgabe 5 (die bei GPT-5.4 sofort funktionierte) erneut versuchte, kam eine völlig andere Zahl heraus. Die offenbar recht einfache Aufgabe, bereits identifizierte Zahlen zu addieren, scheint für das Modell pures Rätselraten zu sein.
Möglicherweise ging die effizientere Ausgabe, die man durchaus sehen konnte, auf Kosten der Reasoning-Fähigkeiten des Modells.
In unserem Artikel zu Claude Opus 4.7 nutzten wir einen detaillierten Briefing-Prompt mit 12 überprüfbaren Vorgaben (exakte Absatzanzahl, Wortzahlbereich, britische Rechtschreibung, spezifische Zitatregeln usw.). Sowohl Claude Opus 4.7 als auch Sonnet 4.6 erreichten 11/12, wobei Sonnet den schwerwiegenderen Ausreißer hatte. Den gleichen Test haben wir mit GPT-5.5 durchgeführt.
Unser Prompt:
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

-The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Das ist die Ausgabe:
Client onboarding at our firm is designed to establish confidence, clarity, and accountability from the first contact. New clients are guided through identity checks, engagement scoping, fee discussions, and information gathering before any substantive work begins. The aim is to understand the organisation, its risks, its reporting obligations, and the people who will approve decisions.
Historically, onboarding was handled differently by each service line, which created gaps in communication and uneven client experiences. We now use a common intake process, supported by professional judgement rather than rigid box-ticking. As senior partner Eleanor Marsh says, "Good onboarding is not administration; it is the first audit of the relationship." Her point is that early discipline prevents confusion later.
Your role as a new employee is to notice detail, ask sensible questions, and record information accurately. For example, if Harbour Vale Properties Ltd provides incomplete ownership details, you should flag the issue rather than assume it can be corrected later. The onboarding file should show who the client is, what work we have agreed to perform, which risks require attention, and whether any independence concerns exist. Clear notes matter because colleagues may rely on them months later.
Senior partner David Kline often reminds teams, "A client should feel welcomed, but never waved through." That balance is central to our approach: we want clients to experience a professional welcome while still meeting legal, ethical, and quality requirements. Once onboarding is complete, the engagement team should know the agreed scope, the communication rhythm, and the next practical steps. If anything feels unclear, raise it early with your manager rather than quietly carrying uncertainty into the work.
Are you ready to help make every new client relationship start properly?
Kurz gesagt: GPT-5.5 hat den Test bestanden und alle Vorgaben erfüllt (12/12).
GPT-5.5 wird ab heute an allen üblichen Stellen ausgerollt. Plus-, Pro-, Business- und Enterprise-Nutzer bekommen GPT-5.5 in ChatGPT und Codex, und Pro-, Business- und Enterprise-Nutzer erhalten zusätzlich GPT-5.5 Pro in ChatGPT.
OpenAI sagt, GPT-5.5 und GPT-5.5 Pro kommen sehr bald über die Responses- und Chat-Completions-APIs mit einem Kontextfenster von 1M Tokens. Bei anderen Releases hat OpenAI den API-Zugang zeitgleich freigeschaltet.
OpenAI stuft GPT-5.5 unter seinem Preparedness Framework sowohl bei biologisch/chemischen als auch bei Cybersicherheits-Fähigkeiten als „High“ ein. Das ist der Grund für die verzögerte API. OpenAI sagt, das Bereitstellen eines High-klassifizierten Modells im API-Maßstab erfordere zusätzliche Schutzmaßnahmen, an denen man arbeitet.
Zwei praktische Folgen für Nutzer:
Das ist das erste Mal, dass OpenAI den Zugang zu Cybersicherheitsfunktionen formell nach Anfragesteller staffelt. Cybersicherheit war zuletzt oft in den Schlagzeilen. Wir haben über Sicherheitsfragen in unserem Artikel zu Claude Opus 4.7 geschrieben, einem heruntergeregelten Geschwister von Anthropics internem Mythos Preview, zu dem es Bedenken gab, es könne Zero-Day-Schwachstellen ausnutzen, und anderes.
Ich sagte vorhin, es gibt Effizienzgewinne. Wir müssen auch sagen: Der Preis pro Token ist gestiegen.
Wir haben GPT-5.5 mit denselben Prompts getestet, die wir in unserem Artikel zu Claude Opus 4.7 verwendet haben, sodass wir diese Testergebnisse zusammen mit den Benchmarks direkt vergleichen können.
Das Fazit: GPT-5.5 hat die Long-Context-Lücke geschlossen, die GPT-5.4 für dokumentlastige Arbeit zur schwachen Wahl machte, doch die Effizienzgewinne scheinen auf Kosten der arithmetischen Zuverlässigkeit gegangen zu sein. GPT-5.5 liegt beim strikten Befolgen von Anweisungen knapp vorn und ist bei Output-Tokens nun teurer als Opus 4.7.
Opus 4.7 führt weiterhin bei SWE-bench Pro (64,3% vs. 58,6%), aber GPT-5.5 hat bei Terminal-Bench 2.0 deutlich die Nase vorn (82,7% vs. 69,4%). Das Coding-Bild teilt sich damit nach Umgebung: Opus 4.7 für Repository-Level-Engineering, GPT-5.5 für terminallastige Workflows.
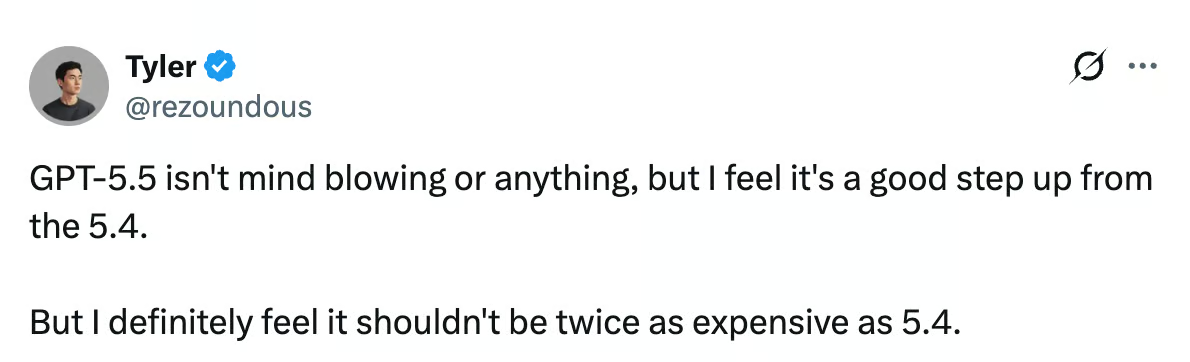
OpenAIs neues Modell wird generell positiv aufgenommen. Nutzer loben vor allem das Tempo und die Prägnanz bei hilfreichen Ergebnissen.
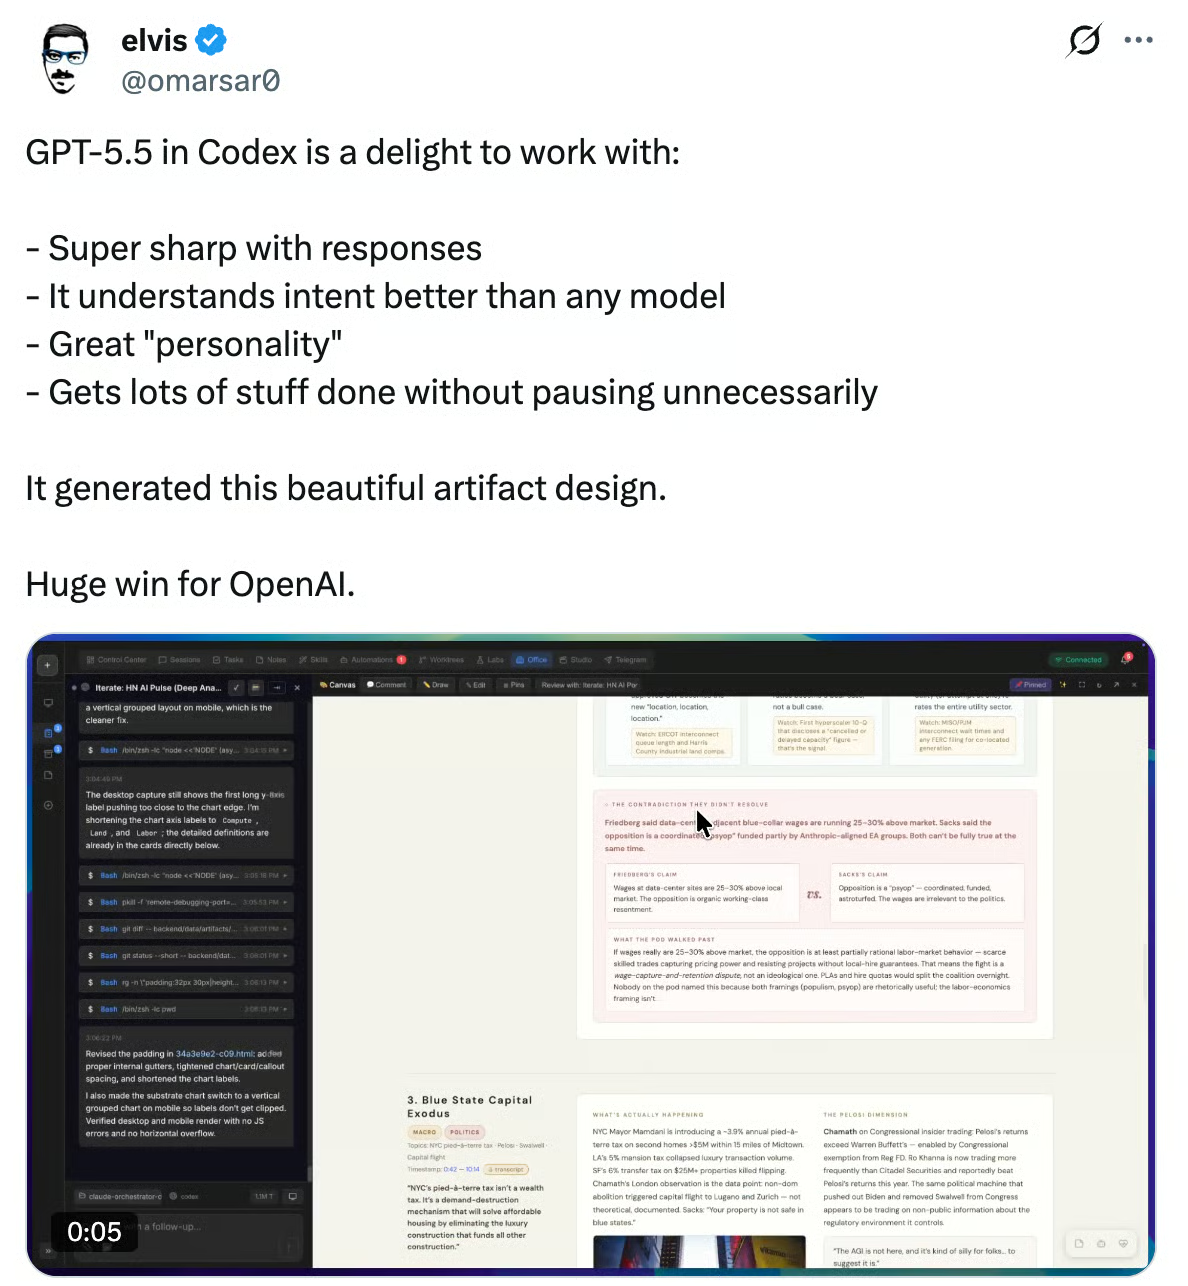
Andere merken an, dass es zwar ein Schritt nach vorn gegenüber GPT-5.4 sei, aber möglicherweise nicht genug, um den deutlichen Preisanstieg zu rechtfertigen.
GPT-5.5 ist ein inkrementelles Fähigkeitsupdate, gepaart mit einem nicht-incrementellen Policy-Update. Das Modell ist schneller, pro Aufgabe günstiger und deutlich besser bei Long-Context-Arbeit. Diese Aussagen spiegeln sich klar in den Benchmarks.
Unsere eigenen Tests zeichnen ein differenzierteres Bild. Die Long-Context-Verbesserungen sind real, und GPT-5.5 hat in unserem Anweisungstest alle 12 Vorgaben erfüllt (ein Prompt, bei dem sowohl Claude Opus 4.7 als auch Sonnet 4.6 11/12 erreichten). Doch die Effizienzgewinne hatten ihren Preis: GPT-5.5 scheiterte wiederholt an einer Summationsaufgabe, die GPT-5.4 nach einer einfachen Prompt-Aufteilung löste. Das deutet auf einen Trade-off zwischen Ausgabeknappheit und Reasoning-Leistung hin.
Das Release markiert zudem das erste Mal, dass OpenAI den Zugriff auf Cybersicherheitsfunktionen formell nach Anfragenden staffelt — eine interessante Entwicklung für die gesamte Branche.
Wenn du in ChatGPT oder Codex arbeitest, hast du ab heute Zugriff auf das neue Modell. Wenn du die API nutzt, musst du dich noch gedulden — was, wie erwähnt, untypisch für OpenAI ist, aber wohl bald folgt.
Lerne mit DataCamp
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
9 Min.


