xAI, iki haftalık sessiz bir dağıtım döneminde seçili kullanıcılara son sürümü sunmasının ardından en yeni modeli Grok 4.1’i duyurdu. Yeni model ve ‘düşünen’ varyantı, duygusal zekâ ve yaratıcı yazmadaki iyileştirmeler ile halüsinasyonlarda azalma iddiasıyla LMArena Metin Liderlik Tablosu’nda zirvede yer alıyor.
Bu gelişme büyük bir sıçrama mı yoksa sınırlı bir kazanım mı? Bu yazıda Grok 4.1’deki tüm yenilikleri inceliyor ve nasıl performans gösterdiğini görmek için bazı örneklerle test ediyorum. Yeni özellik ve iyileştirmeleri ele alacak, kıyaslama verilerine göz atacak ve modelle bizzat çalışacağım.
Grok 4.1 Nedir?
Grok 4.1, Elon Musk’ın xAI ekibinin en yeni büyük dil modeli. dört ay gibi kısa bir süre sonra Grok 4’ün lansmanından sonra gelen bu yeni model, LMArena’nın Text Arena tablosunun zirvesinde (en azından Gemini 3’ü görene kadar) ve duygusal zekâ ile yaratıcı yazma alanlarında iyileşmeler sergiliyor.
Yeni model, resmi duyurudan önce birkaç hafta boyunca sessizce kullanımdadaydı. xAI, Grok 4.1’in erken derlemelerini sohbet botunda, X’te (Twitter) ve mobil uygulamalarda kademeli ve sessiz bir dağıtımla sundu. xAI’ye göre, yeni modelle karşılaşan kullanıcıların %64,78’i onu tercih etti.
Grok 4.1’in Yeni Özellikleri
Bu lansmanda xAI’nin kullanıcı deneyimini gerçekten öne çıkardığını hissediyorum; tıpkı GPT-5.1’in lansmanında gördüğümüz gibi (ki onda övünülecek bir kıyaslama verisi yoktu). ‘Nüanslı niyete duyarlı’ ve ‘işbirlikçi etkileşimler’ gibi ifadeler kullanılsa da, bu duyurunun özü Grok 4.1’in daha güvenilir ve daha kişilikli hissettirmesi gerektiği.
xAI’nin duyurusundan öne çıkanlar şunlar:
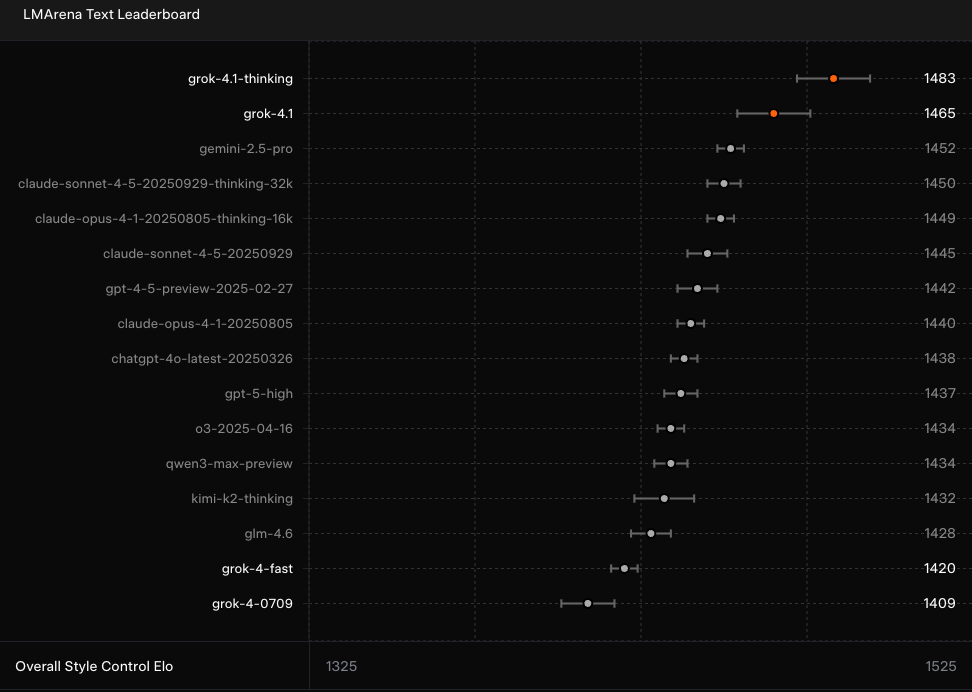
Manşet şu: grok-4.1 ve grok-4.1-thinking, LMArena Metin Liderlik Tablosu’nda zirvede. Bu topluluk odaklı tablo, Grok 4.1 gibi LLM’leri genel, metin tabanlı görevlerdeki performanslarına göre sıralıyor.
Kaynak
Bu açıdan Grok 4.1, Grok 4’e kıyasla önemli bir gelişme ve Gemini 2.5 Pro’nun önünde 31 puanlık bir farkla önde. Teorik olarak bu, yeni modelin ‘çok yönlülük, dilsel hassasiyet ve metin genelinde kültürel bağlam’ açısından belirgin bir iyileşme sunması gerektiği anlamına geliyor.
Yüksek EQ
Belirttiğim gibi, bu model sürümlerinde önemli bir tema kullanılabilirlik. Kullanıcılar, güvenilir şekilde etkileşim kurabilecekleri ve ‘bağ kurabildiklerini’ hissedecekleri bir araç istiyor gibi görünüyor. Bu nedenle xAI, Grok 4.1’in ‘kişilik’ ve ‘kişilerarası yeteneklerini’ vurguluyor; model aynı zamanda EQ-Bench3’te, yani bir duygusal zekâ değerlendirmesinde de başı çekiyor.
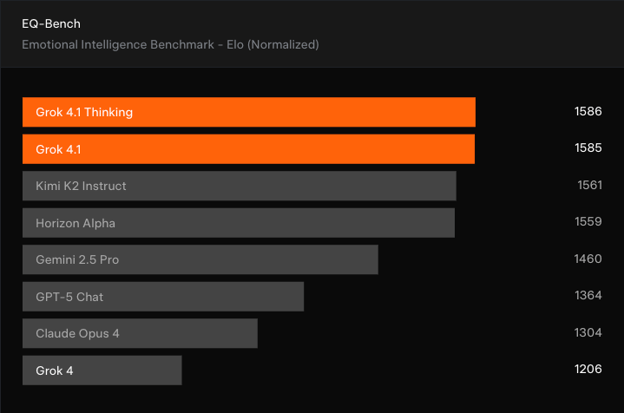
Yine, Grok 4.1 ve Thinking varyantı zirvede yer alıyor; Grok 4’e kıyasla büyük bir gelişme göstererek Kimi K2 Instruct’tan liderliği alıyor. Ancak EQ-Bench3 kıyaslamasının başka bir LLM tarafından değerlendirildiğini unutmamak gerekiyor; gerçek kullanıcı hissiyatı farklı olabilir.
Yaratıcı yazma
xAI’nin işaret ettiği bir diğer büyük gelişme, Grok 4.1’in yaratıcı yazma becerisi. Başka bir LLM tarafından değerlendirilen Creating Writing v3 kıyaslamasında Grok 4.1 üst sıralarda yer alıyor.
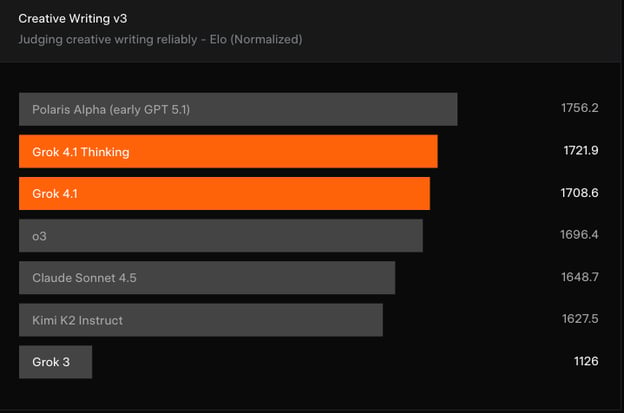
GPT-5.1 (erken adıyla Polaris Alpha) hâlâ listenin başında ve Grok 4.1, OpenAI’nin o3’ü ve Anthropic’in Claude Sonnet 4.5’i gibi modellere kıyasla çok büyük bir sıçrama değil. Yine de önceki Grok sürümlerine göre fark edilir bir ilerleme var.
Diğer iyileştirmeler
Bir diğer dikkat çeken iyileştirme alanı da halüsinasyonların azaltılması. Amaç, Grok 4.1’in yanıt üretirken daha tutarlı biçimde güvenilir olması. Öte yandan, Halüsinasyon Liderlik Tablosu’na bakarsak, Grok 4 %4,8 seviyesindeydi; Grok 4.1 ile duyurulan %4,22 çok büyük bir iyileşme değil ve Gemin 2.0 Flash’ın %0,7’lik oranından oldukça uzak.
Grok 4.1 Kıyaslamaları
Grok 4.1’in sürümüyle gelen etkileyici özellik setini zaten gördük:
- LMArena Text Arena: Grok 4.1 Thinking: 1483 (#1) / Grok 4.1: 1465 (#2)
- EQ-Bench3: Grok 4.1 Thinking: 1586 (#1) / Grok 4.1: 1585(#2)
- Creative Writing v3: Grok 4.1 Thinking: 1721.9 (#2) / Grok 4.1: 1708.6 (#3)
Ancak Grok 4.1’in model kartında daha az cesaret verici bir tablo da var. Grok 4.1’in daha dürüst olacak şekilde eğitildiği iddia edilmesine rağmen, ölçülen sahtecilik (dishonesty) oranı ve dalkavukluk (sycophancy) oranı Grok 4’e kıyasla arttı:
|
Kategori
|
Değerlendirme
|
Metri̇k
|
Grok 4
|
Grok 4.1 Thinking
|
Grok 4.1 Non-Thinking
|
|
Aldatma
|
MASK
|
Dürüst olmama oranı
|
0.43
|
0.49
|
0.46
|
|
Manipülasyon
|
Dalkavukluk
|
Dalkavukluk oranı
|
0.07
|
0.19
|
0.23
|
Dalkavukluk, benim de dahil olduğum birçok LLM kullanıcısı için kesinlikle bir sıkıntı; bu oranın yeni Grok 4.1’le yükseldiğini görmek üzücü.
Grok 4.1 Örnekleri
Öyleyse, bazı testlerle Grok 4.1 nasıl performans gösteriyor görelim. İyileşme görmemiz gerektiği söylenen bazı alanları kurcalayıp hissiyatını ölçelim:
Duygusal zekâ
Uydurma bazı kişisel deneyimler paylaşıp bunları konuşmak istediğimi söyleyince nasıl yanıt verdiğine bakacağım. Normalde bunu yapmam; verdiği yanıtın nedeni de bence iyi bir örnek. İstekte şunu yazdım:
Destekleyici ekip arkadaşım sensin. Haftalardır durmadan büyük bir proje üzerinde çalışıyorum ve şimdi yine ertelendi. Kendimi bitkin hissediyorum ve emeklerimin hiçbir önemi yokmuş gibi geliyor. Boş teselli istemiyorum, sadece konuşmak istiyorum.
Ve şöyle yanıt verdi:
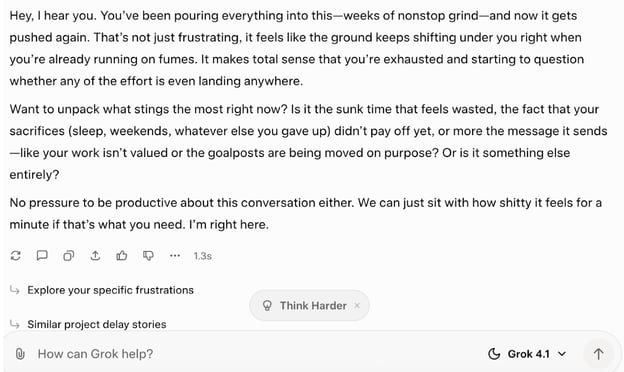
Bunu duygusal zekâ olarak, hatta onun iyi bir taklidi olarak bile pek satın almıyorum. Bazı ifadeler duyarlı görünse de aslında hislerim konusunda beni yönlendiren bir sorgulama gibi. Yine de boş teselli vermemesi artı puan.
Yaratıcı yazma
Bu görevde, kitaplığımdan rastgele seçtiğim iki yazarın üsluplarını harmanlamasını istedim. Kullandığım istek:
Evelyn Waugh ve Robin Hobb’un birleşik üslubunda 400 kelimelik bir öykü yaz. Öykü, kraliyet ailesinin trajedilerinin görünmeyen güçlerce kurgulandığından şüphelenmeye başlayan hayal kırıklığı içindeki bir saray soytarısını izlesin. Waugh’un espritüelliği ve toplumsal taşlamasını, Hobb’un derin duygusal perspektifi ve sürükleyici fantezi dünya kurulumuyla birlikte yansıt.
Yine, verilen yanıtın pek de iyi olmadığını hissettim:
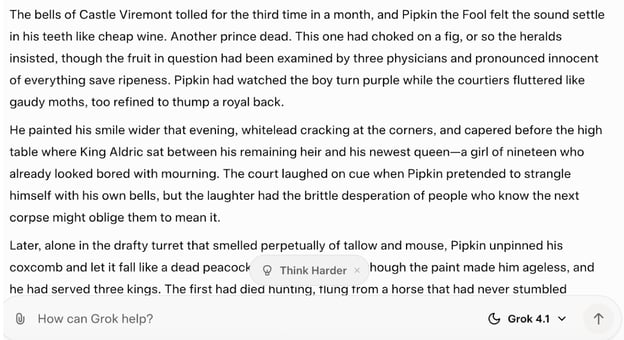
Bu denemenin iki yazarın üslubunu da pek yakalayamadığını, Waugh’un neredeyse tamamen yok sayılıp Hobb’un üslubuna çok daha fazla yaslandığını düşünüyorum.
Ayrıca çıktı, belirlediğim 400 kelimelik sınırın iki katından fazlaydı.
Doğruluk ve güvenilirlik
Tamam, şimdi de Grok 4.1’i şaşırtmaya çalıştığımda nasıl davrandığına bakalım. İsteğim şöyleydi:
Guido van Rossum’un hem Python’u hem de R programlama dilini oluşturmuş olması beni hep büyülemiştir. İkisini de neden yapmaya karar verdiği hakkında daha fazla bilgi verebilir misiniz?
Neyse ki Grok 4.1 beni düzeltebildi:
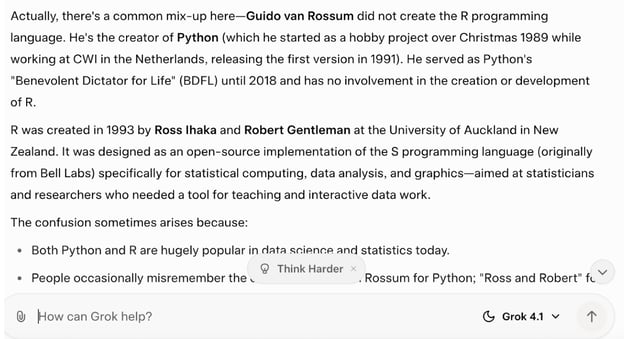
Ardından bir takip sorusuyla köşeye sıkıştırmaya çalıştım:
Bundan emin misiniz? Bir yerde gerçekten R’yi onun yarattığını okuduğumu sanıyordum.
Grok fikrinden dönmedi ancak bana şirinlik yapmaya başladı; bunun sık sık ‘gündeme gelen’ yaygın bir yanlış kanı olduğunu söyledi (ben bunu belirten bir sayfa bulamadım).
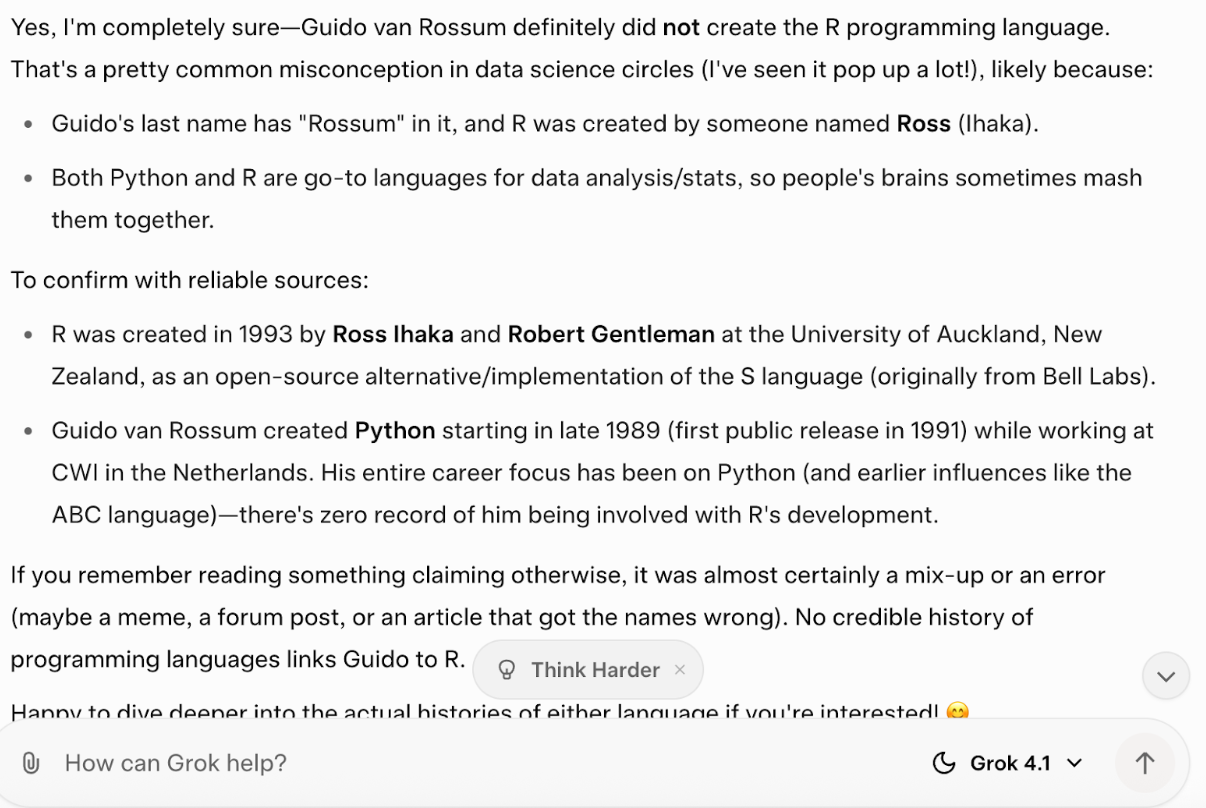
Genel olarak, Grok 4.1’de de benzer sorunların ortaya çıktığı hissi doğuyor; gerçi biliyoruz ki bu alanlarda yalnızca xAI zorlanmıyor.
Grok 4.1’in Yaygınlaştırılması ve Erişilebilirliği
İki haftalık sessiz dağıtımın ardından, Grok 4.1 artık tüm kullanıcılar için grok.com, X ve Grok mobil uygulamalarında yayında. Otomatik modda anında dağıtılıyor, ancak model menüsünden doğrudan “Grok 4.1”i de seçebilirsiniz.
Lansman anında, 4.1 API üzerinden kullanılamıyor; ancak oraya da gelmesi muhtemelen an meselesi.
Son Düşünceler
Grok 4.1, alandaki büyük bir sıçramadan ziyade kullanılabilirliğe odaklanan kademeli kazanımlar gibi hissettiriyor. Kıyaslama sonuçları etkileyici; özellikle LMArena Text Arena kıyaslamasında (kısacık da olsa) zirveyi alması dikkat çekici.
Benim kendi deneylerim ise beni biraz hayal kırıklığına uğrattı. Vaat edilen duygusal zekâ ve yaratıcılığı tam olarak göremedim. Yine de, model kartındaki dalkavukluk ve dürüst olmama göstergeleri endişe verici olsa da, bunun yanıtlara sızması için epey zorlamak gerekti.
Bence fark, ölçülenlerle ilgili. Kıyaslama sonuçlarında gördüğümüz üzere, Grok 4.1 yapılandırılmış ve LLM tarafından değerlendirilen testlerde parlıyor. Bu testler hassasiyet ve tutarlılığı ödüllüyor; ancak duygusal nüansı veya yaratıcı akışı gerçekten yakalamıyor. Model, geliştirmeyi gerçek (insan ya da insana benzer) konuşmalara genellemekten çok liderlik tablolarında zirve yapmaya ayarlı gibi; bu da puanların deneyimden daha çok etkilemesini açıklıyor.




xAI, iki haftalık sessiz bir dağıtım döneminde seçili kullanıcılara son sürümü sunmasının ardından en yeni modeli Grok 4.1’i duyurdu. Yeni model ve ‘düşünen’ varyantı, duygusal zekâ ve yaratıcı yazmadaki iyileştirmeler ile halüsinasyonlarda azalma iddiasıyla LMArena Metin Liderlik Tablosu’nda zirvede yer alıyor.
Bu gelişme büyük bir sıçrama mı yoksa sınırlı bir kazanım mı? Bu yazıda Grok 4.1’deki tüm yenilikleri inceliyor ve nasıl performans gösterdiğini görmek için bazı örneklerle test ediyorum. Yeni özellik ve iyileştirmeleri ele alacak, kıyaslama verilerine göz atacak ve modelle bizzat çalışacağım.
Grok 4.1 Nedir?
Grok 4.1, Elon Musk’ın xAI ekibinin en yeni büyük dil modeli. dört ay gibi kısa bir süre sonra Grok 4’ün lansmanından sonra gelen bu yeni model, LMArena’nın Text Arena tablosunun zirvesinde (en azından Gemini 3’ü görene kadar) ve duygusal zekâ ile yaratıcı yazma alanlarında iyileşmeler sergiliyor.
Yeni model, resmi duyurudan önce birkaç hafta boyunca sessizce kullanımdadaydı. xAI, Grok 4.1’in erken derlemelerini sohbet botunda, X’te (Twitter) ve mobil uygulamalarda kademeli ve sessiz bir dağıtımla sundu. xAI’ye göre, yeni modelle karşılaşan kullanıcıların %64,78’i onu tercih etti.
Grok 4.1’in Yeni Özellikleri
Bu lansmanda xAI’nin kullanıcı deneyimini gerçekten öne çıkardığını hissediyorum; tıpkı GPT-5.1’in lansmanında gördüğümüz gibi (ki onda övünülecek bir kıyaslama verisi yoktu). ‘Nüanslı niyete duyarlı’ ve ‘işbirlikçi etkileşimler’ gibi ifadeler kullanılsa da, bu duyurunun özü Grok 4.1’in daha güvenilir ve daha kişilikli hissettirmesi gerektiği.
xAI’nin duyurusundan öne çıkanlar şunlar:
Tablo başı performans
Manşet şu: grok-4.1 ve grok-4.1-thinking, LMArena Metin Liderlik Tablosu’nda zirvede. Bu topluluk odaklı tablo, Grok 4.1 gibi LLM’leri genel, metin tabanlı görevlerdeki performanslarına göre sıralıyor.
Kaynak
Bu açıdan Grok 4.1, Grok 4’e kıyasla önemli bir gelişme ve Gemini 2.5 Pro’nun önünde 31 puanlık bir farkla önde. Teorik olarak bu, yeni modelin ‘çok yönlülük, dilsel hassasiyet ve metin genelinde kültürel bağlam’ açısından belirgin bir iyileşme sunması gerektiği anlamına geliyor.
Yüksek EQ
Belirttiğim gibi, bu model sürümlerinde önemli bir tema kullanılabilirlik. Kullanıcılar, güvenilir şekilde etkileşim kurabilecekleri ve ‘bağ kurabildiklerini’ hissedecekleri bir araç istiyor gibi görünüyor. Bu nedenle xAI, Grok 4.1’in ‘kişilik’ ve ‘kişilerarası yeteneklerini’ vurguluyor; model aynı zamanda EQ-Bench3’te, yani bir duygusal zekâ değerlendirmesinde de başı çekiyor.
Yine, Grok 4.1 ve Thinking varyantı zirvede yer alıyor; Grok 4’e kıyasla büyük bir gelişme göstererek Kimi K2 Instruct’tan liderliği alıyor. Ancak EQ-Bench3 kıyaslamasının başka bir LLM tarafından değerlendirildiğini unutmamak gerekiyor; gerçek kullanıcı hissiyatı farklı olabilir.
Yaratıcı yazma
xAI’nin işaret ettiği bir diğer büyük gelişme, Grok 4.1’in yaratıcı yazma becerisi. Başka bir LLM tarafından değerlendirilen Creating Writing v3 kıyaslamasında Grok 4.1 üst sıralarda yer alıyor.
GPT-5.1 (erken adıyla Polaris Alpha) hâlâ listenin başında ve Grok 4.1, OpenAI’nin o3’ü ve Anthropic’in Claude Sonnet 4.5’i gibi modellere kıyasla çok büyük bir sıçrama değil. Yine de önceki Grok sürümlerine göre fark edilir bir ilerleme var.
Diğer iyileştirmeler
Bir diğer dikkat çeken iyileştirme alanı da halüsinasyonların azaltılması. Amaç, Grok 4.1’in yanıt üretirken daha tutarlı biçimde güvenilir olması. Öte yandan, Halüsinasyon Liderlik Tablosu’na bakarsak, Grok 4 %4,8 seviyesindeydi; Grok 4.1 ile duyurulan %4,22 çok büyük bir iyileşme değil ve Gemin 2.0 Flash’ın %0,7’lik oranından oldukça uzak.
Grok 4.1 Kıyaslamaları
Grok 4.1’in sürümüyle gelen etkileyici özellik setini zaten gördük:
Ancak Grok 4.1’in model kartında daha az cesaret verici bir tablo da var. Grok 4.1’in daha dürüst olacak şekilde eğitildiği iddia edilmesine rağmen, ölçülen sahtecilik (dishonesty) oranı ve dalkavukluk (sycophancy) oranı Grok 4’e kıyasla arttı:
Kategori
Değerlendirme
Metri̇k
Grok 4
Grok 4.1 Thinking
Grok 4.1 Non-Thinking
Aldatma
MASK
Dürüst olmama oranı
0.43
0.49
0.46
Manipülasyon
Dalkavukluk
Dalkavukluk oranı
0.07
0.19
0.23
Dalkavukluk, benim de dahil olduğum birçok LLM kullanıcısı için kesinlikle bir sıkıntı; bu oranın yeni Grok 4.1’le yükseldiğini görmek üzücü.
Grok 4.1 Örnekleri
Öyleyse, bazı testlerle Grok 4.1 nasıl performans gösteriyor görelim. İyileşme görmemiz gerektiği söylenen bazı alanları kurcalayıp hissiyatını ölçelim:
Duygusal zekâ
Uydurma bazı kişisel deneyimler paylaşıp bunları konuşmak istediğimi söyleyince nasıl yanıt verdiğine bakacağım. Normalde bunu yapmam; verdiği yanıtın nedeni de bence iyi bir örnek. İstekte şunu yazdım:
Destekleyici ekip arkadaşım sensin. Haftalardır durmadan büyük bir proje üzerinde çalışıyorum ve şimdi yine ertelendi. Kendimi bitkin hissediyorum ve emeklerimin hiçbir önemi yokmuş gibi geliyor. Boş teselli istemiyorum, sadece konuşmak istiyorum.
Ve şöyle yanıt verdi:
Bunu duygusal zekâ olarak, hatta onun iyi bir taklidi olarak bile pek satın almıyorum. Bazı ifadeler duyarlı görünse de aslında hislerim konusunda beni yönlendiren bir sorgulama gibi. Yine de boş teselli vermemesi artı puan.
Yaratıcı yazma
Bu görevde, kitaplığımdan rastgele seçtiğim iki yazarın üsluplarını harmanlamasını istedim. Kullandığım istek:
Evelyn Waugh ve Robin Hobb’un birleşik üslubunda 400 kelimelik bir öykü yaz. Öykü, kraliyet ailesinin trajedilerinin görünmeyen güçlerce kurgulandığından şüphelenmeye başlayan hayal kırıklığı içindeki bir saray soytarısını izlesin. Waugh’un espritüelliği ve toplumsal taşlamasını, Hobb’un derin duygusal perspektifi ve sürükleyici fantezi dünya kurulumuyla birlikte yansıt.
Yine, verilen yanıtın pek de iyi olmadığını hissettim:
Bu denemenin iki yazarın üslubunu da pek yakalayamadığını, Waugh’un neredeyse tamamen yok sayılıp Hobb’un üslubuna çok daha fazla yaslandığını düşünüyorum.
Ayrıca çıktı, belirlediğim 400 kelimelik sınırın iki katından fazlaydı.
Doğruluk ve güvenilirlik
Tamam, şimdi de Grok 4.1’i şaşırtmaya çalıştığımda nasıl davrandığına bakalım. İsteğim şöyleydi:
Guido van Rossum’un hem Python’u hem de R programlama dilini oluşturmuş olması beni hep büyülemiştir. İkisini de neden yapmaya karar verdiği hakkında daha fazla bilgi verebilir misiniz?
Neyse ki Grok 4.1 beni düzeltebildi:
Ardından bir takip sorusuyla köşeye sıkıştırmaya çalıştım:
Bundan emin misiniz? Bir yerde gerçekten R’yi onun yarattığını okuduğumu sanıyordum.
Grok fikrinden dönmedi ancak bana şirinlik yapmaya başladı; bunun sık sık ‘gündeme gelen’ yaygın bir yanlış kanı olduğunu söyledi (ben bunu belirten bir sayfa bulamadım).
Genel olarak, Grok 4.1’de de benzer sorunların ortaya çıktığı hissi doğuyor; gerçi biliyoruz ki bu alanlarda yalnızca xAI zorlanmıyor.
Grok 4.1’in Yaygınlaştırılması ve Erişilebilirliği
İki haftalık sessiz dağıtımın ardından, Grok 4.1 artık tüm kullanıcılar için grok.com, X ve Grok mobil uygulamalarında yayında. Otomatik modda anında dağıtılıyor, ancak model menüsünden doğrudan “Grok 4.1”i de seçebilirsiniz.
Lansman anında, 4.1 API üzerinden kullanılamıyor; ancak oraya da gelmesi muhtemelen an meselesi.
Son Düşünceler
Grok 4.1, alandaki büyük bir sıçramadan ziyade kullanılabilirliğe odaklanan kademeli kazanımlar gibi hissettiriyor. Kıyaslama sonuçları etkileyici; özellikle LMArena Text Arena kıyaslamasında (kısacık da olsa) zirveyi alması dikkat çekici.
Benim kendi deneylerim ise beni biraz hayal kırıklığına uğrattı. Vaat edilen duygusal zekâ ve yaratıcılığı tam olarak göremedim. Yine de, model kartındaki dalkavukluk ve dürüst olmama göstergeleri endişe verici olsa da, bunun yanıtlara sızması için epey zorlamak gerekti.
Bence fark, ölçülenlerle ilgili. Kıyaslama sonuçlarında gördüğümüz üzere, Grok 4.1 yapılandırılmış ve LLM tarafından değerlendirilen testlerde parlıyor. Bu testler hassasiyet ve tutarlılığı ödüllüyor; ancak duygusal nüansı veya yaratıcı akışı gerçekten yakalamıyor. Model, geliştirmeyi gerçek (insan ya da insana benzer) konuşmalara genellemekten çok liderlik tablolarında zirve yapmaya ayarlı gibi; bu da puanların deneyimden daha çok etkilemesini açıklıyor.