



Lộ trình
Cơ bản về ChatGPT
3 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleo3 là mô hình tiên phong mới nhất của OpenAI, được thiết kế để nâng cao khả năng suy luận trên nhiều tác vụ phức tạp như lập trình, toán học, khoa học và nhận thức thị giác.
Mô hình suy luận o3 là mô hình suy luận đầu tiên có quyền tự động sử dụng công cụ. Điều này có nghĩa o3 có thể dùng tìm kiếm, Python, tạo và phân tích hình ảnh để hoàn thành nhiệm vụ.
Điều đó đã chuyển hóa thành hiệu suất mạnh mẽ trên các điểm chuẩn nâng cao kiểm tra khả năng giải quyết vấn đề trong thế giới thực—nơi các mô hình trước đây thường chật vật. OpenAI nhấn mạnh sự cải thiện của o3 so với o1, định vị đây là mô hình mạnh mẽ và linh hoạt nhất của họ cho đến nay.
o3 xây dựng trực tiếp trên nền tảng do o1 đặt ra, nhưng các cải tiến là đáng kể trên những mảng then chốt. OpenAI định vị o3 là mô hình được thiết kế để xử lý các tác vụ suy luận phức tạp hơn, với mức tăng hiệu suất phản ánh qua các điểm chuẩn.
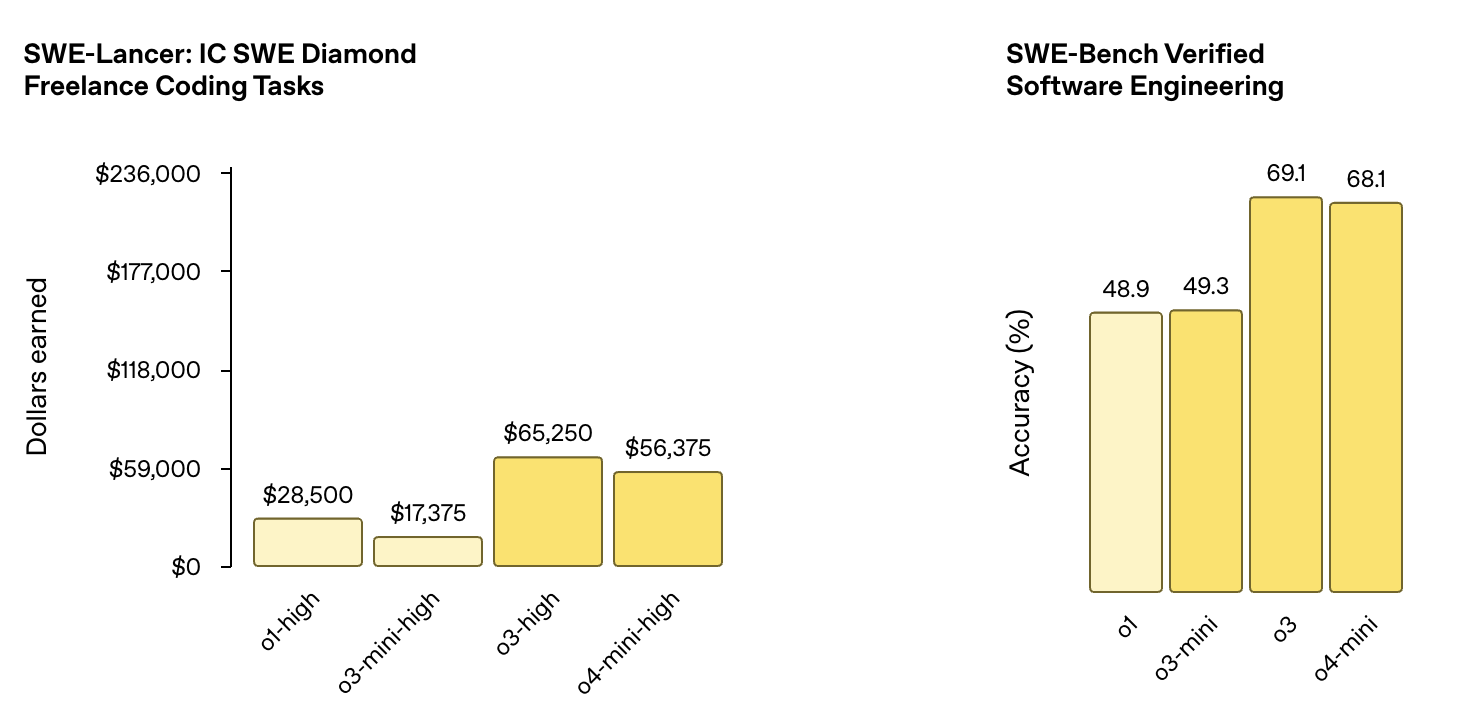
Khi kiểm tra trên các tác vụ kỹ thuật phần mềm, o3 đạt độ chính xác 69,1% trên điểm chuẩn SWE-Bench Verified Software Engineering, cải thiện đáng kể so với 48,9% của o1.
Nguồn: OpenAI
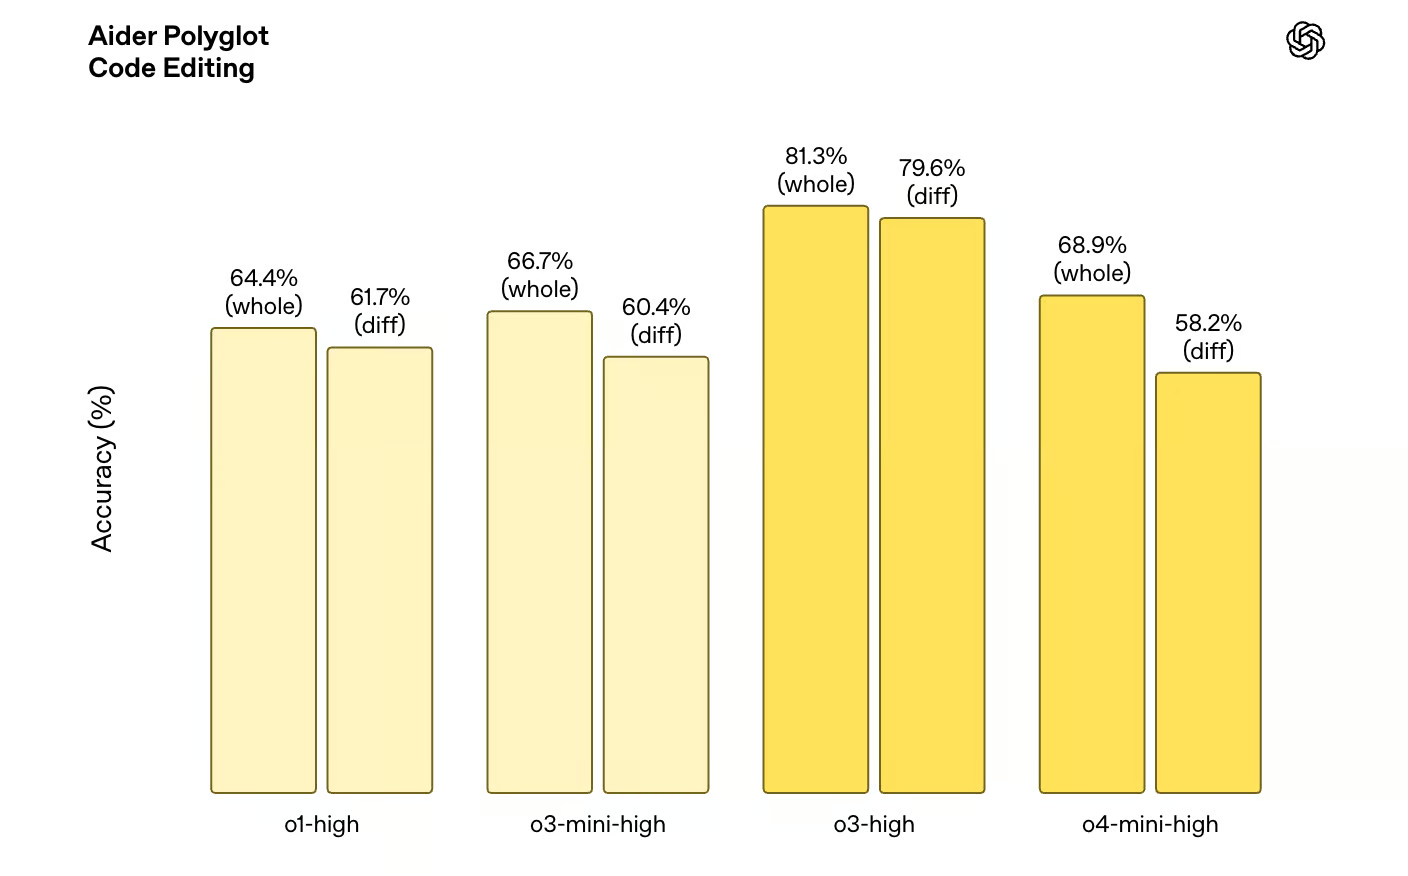
Tương tự, trong lập trình thi đấu, o3 đạt điểm ELO 2706, vượt xa kỷ lục trước đó của o1 là 1891. Hơn nữa, o3 thể hiện tốt hơn đáng kể ở các điểm chuẩn chỉnh sửa mã, với các biến thể o3 vượt o1 trên toàn bộ điểm chuẩn Aider Polyglot Code Editing.
Nguồn: OpenAI
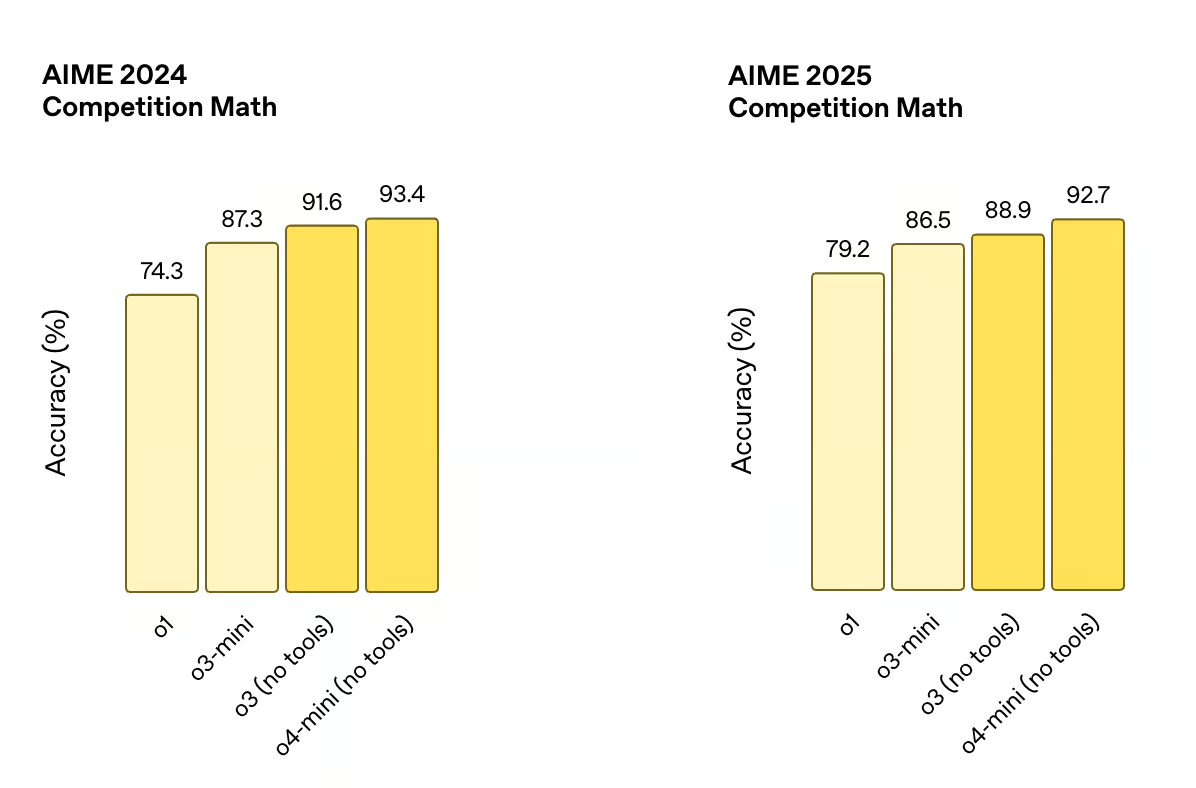
Những cải thiện không chỉ giới hạn ở lập trình. o3 cũng xuất sắc trong suy luận toán học, đạt độ chính xác 91,6% trên AIME 2024, so với 74,3% của o1. Nó cũng đạt 88,9% trên AIME 2025. Các mức tăng này cho thấy mô hình có thể xử lý những bài toán tinh tế và khó hơn, tiến gần tới các điểm chuẩn vốn do chuyên gia con người thống trị.
Nguồn: OpenAI
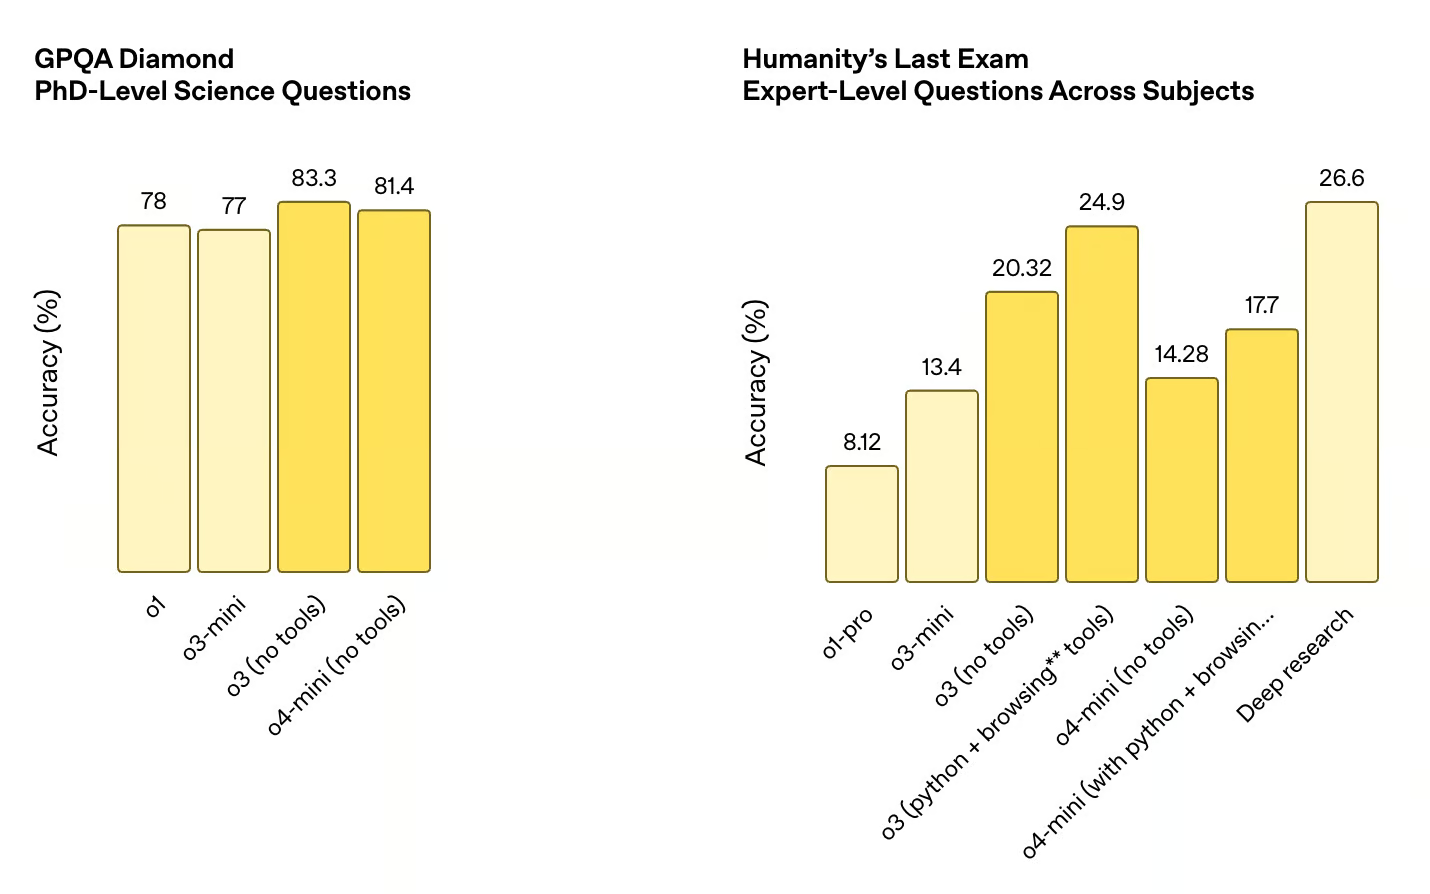
Bước nhảy cũng thể hiện rõ ở các điểm chuẩn liên quan đến khoa học. Trên GPQA Diamond—đánh giá hiệu suất với các câu hỏi khoa học cấp độ tiến sĩ—o3 đạt độ chính xác 83,3%, tăng từ 78% của o1. Những mức tăng này cho thấy sự cải thiện toàn diện trong năng lực giải quyết các vấn đề kỹ thuật đòi hỏi cao trên nhiều lĩnh vực.
Nguồn: OpenAI
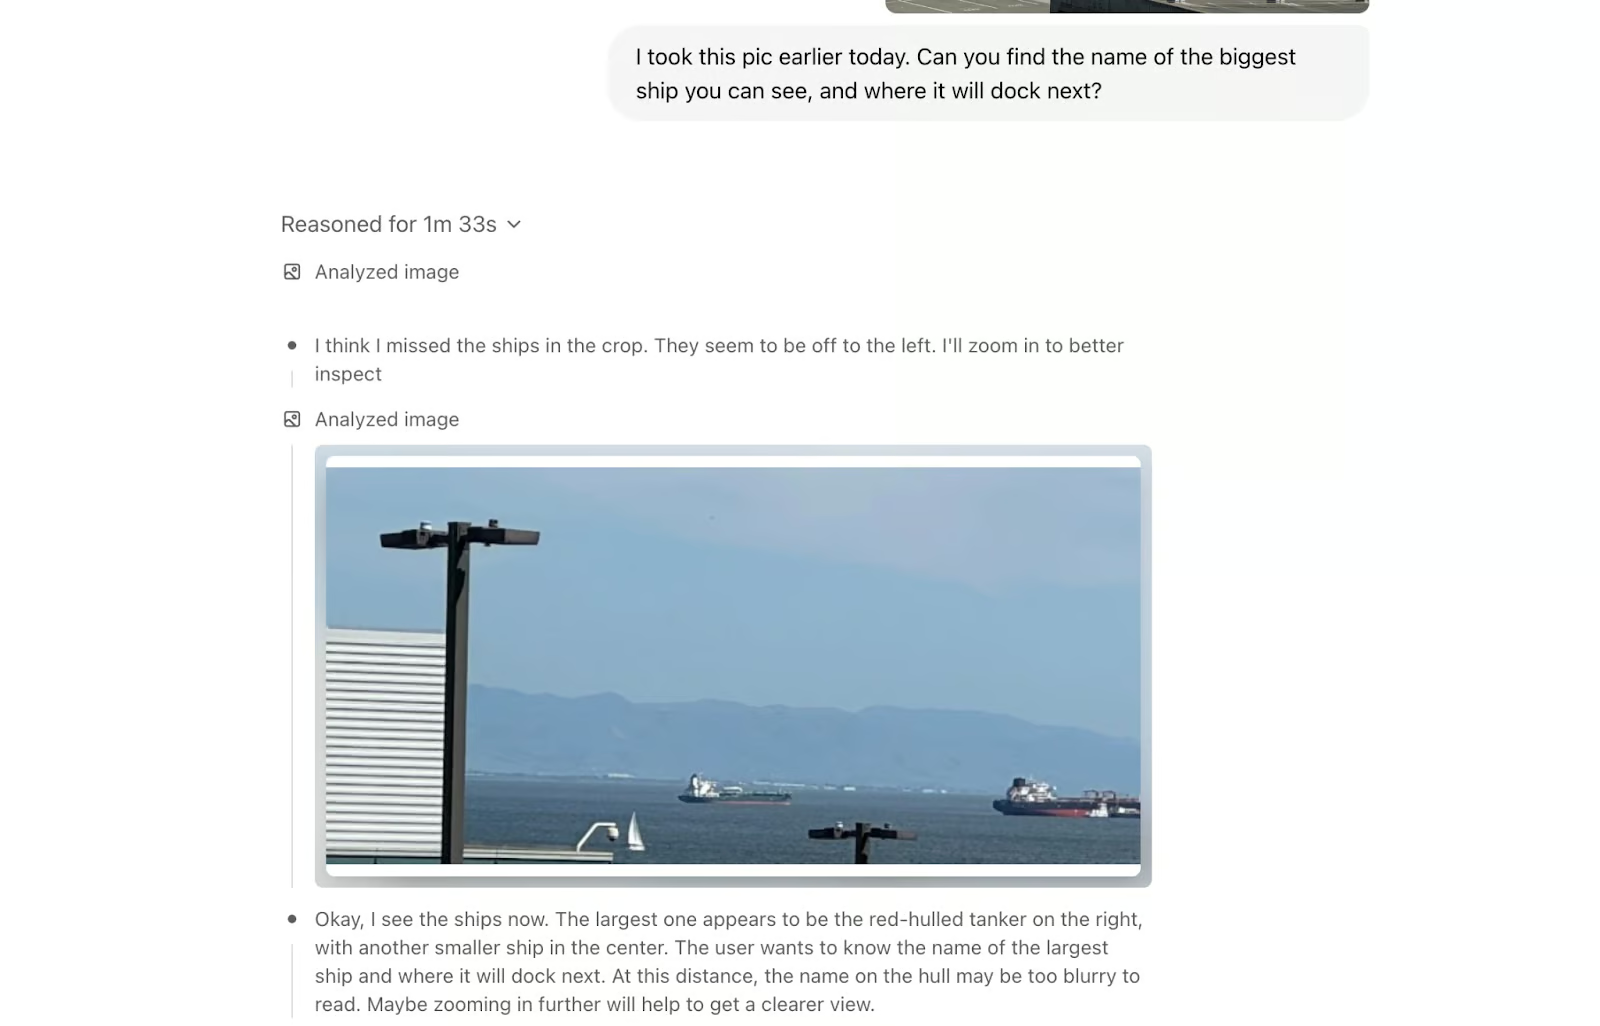
Một trong những khía cạnh đáng chú ý hơn của o3 mới là khả năng suy luận trực tiếp với hình ảnh trong chuỗi tư duy. Điều này có nghĩa o3 có thể hòa trộn suy luận hình ảnh và văn bản khi giải quyết vấn đề, và điều đó phản ánh qua hiệu suất của o3 trên nhiều điểm chuẩn suy luận thị giác.
Nguồn: OpenAI
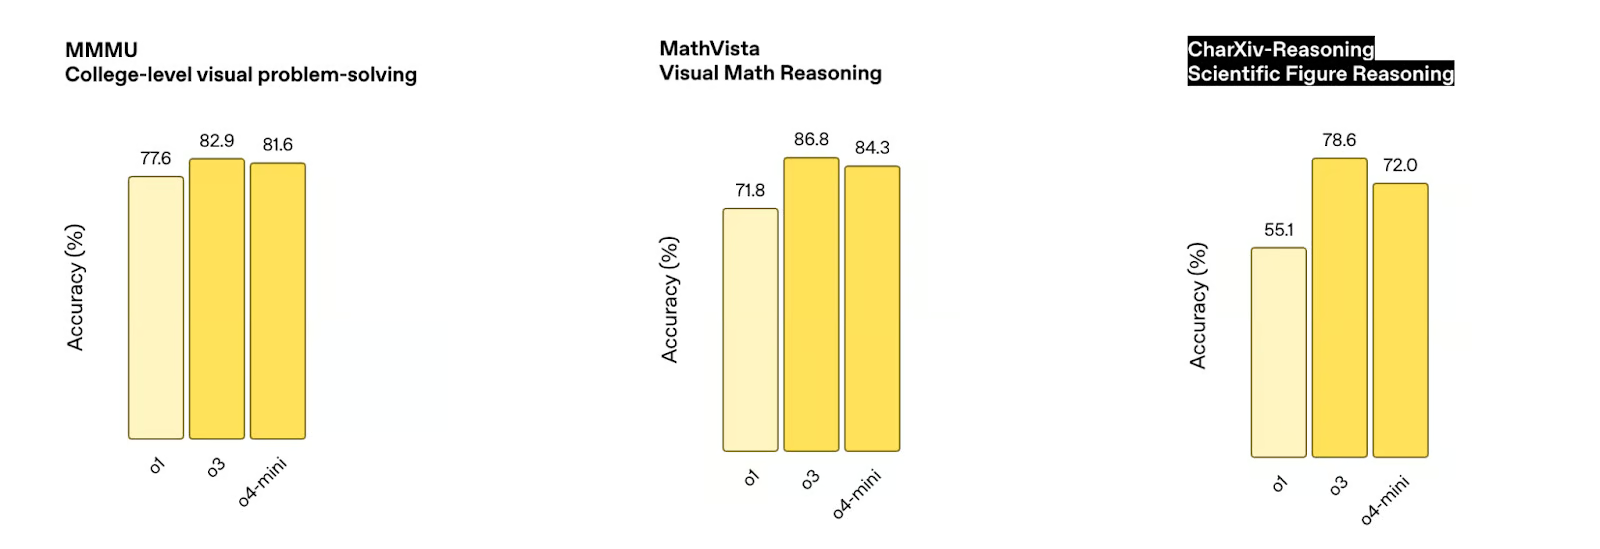
Chẳng hạn, o3 vượt o1 trên nhiều điểm chuẩn suy luận thị giác, bao gồm MMMU (giải quyết vấn đề bằng hình ảnh ở cấp đại học) với 82,9% (so với 77,6% của o1), MathVista (suy luận toán học bằng hình ảnh) với 86,8% (so với 71,8% của o1), và CharXiv-Reasoning (suy luận với hình minh họa khoa học) với 78,6% (so với 55,1% của o1).
Nguồn: OpenAI
Một lĩnh vực nơi tiến bộ của o3 đặc biệt đáng chú ý là trên điểm chuẩn EpochAI Frontier Math.
Đây được xem là một trong những điểm chuẩn thách thức nhất trong AI vì bao gồm các bài toán mới, chưa công bố, được cố ý thiết kế khó hơn nhiều so với các bộ dữ liệu tiêu chuẩn. Nhiều bài toán ở cấp độ nghiên cứu toán học, thường cần các nhà toán học chuyên nghiệp mất hàng giờ hoặc thậm chí vài ngày để giải một bài. Các hệ thống AI hiện nay thường đạt dưới 2% trên điểm chuẩn này, cho thấy mức độ khó của nó.
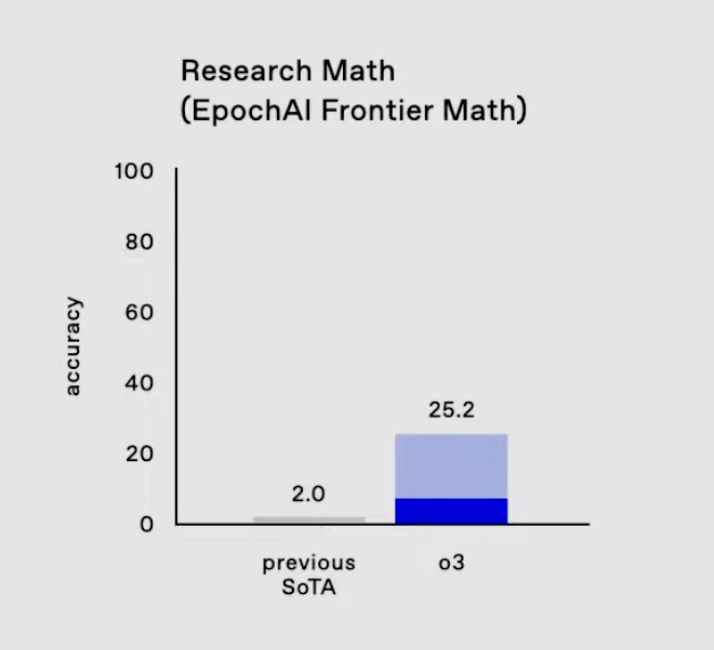
O3 trên EpochAI Frontier Math. Nguồn: OpenAI
Frontier Math của EpochAI quan trọng vì nó đẩy các mô hình vượt khỏi việc ghi nhớ máy móc hay tối ưu hóa các mẫu quen thuộc. Thay vào đó, nó kiểm tra khả năng khái quát hóa, suy luận trừu tượng và giải quyết các vấn đề chưa từng gặp—những phẩm chất thiết yếu để nâng cao năng lực suy luận của AI. Điểm 25,2% của o3 trên điểm chuẩn này là một bước nhảy vọt so với mức đỉnh trước đây.
Một trong những thành tựu nổi bật nhất của o3 là hiệu suất trên điểm chuẩn ARC AGI, một bài kiểm tra được xem là tiêu chuẩn vàng để đánh giá trí tuệ tổng quát của AI.
Được phát triển năm 2019 bởi François Chollet, ARC (Abstraction and Reasoning Corpus) tập trung vào đánh giá khả năng của AI học và khái quát hóa kỹ năng mới từ số ít ví dụ. Không giống các điểm chuẩn truyền thống thường kiểm tra kiến thức được huấn luyện trước hay nhận dạng mẫu, các tác vụ ARC được thiết kế để thách thức mô hình suy ra quy tắc và phép biến đổi ngay lập tức—những việc con người làm một cách trực giác nhưng AI trước đây thường gặp khó.
Điều khiến ARC AGI đặc biệt khó là mỗi tác vụ đòi hỏi kỹ năng suy luận khác nhau. Mô hình không thể dựa vào lời giải hay khuôn mẫu đã ghi nhớ; thay vào đó phải thích ứng với những thách thức hoàn toàn mới trong mỗi bài. Ví dụ, một tác vụ có thể yêu cầu nhận diện mẫu trong các phép biến đổi hình học, trong khi tác vụ khác đòi hỏi suy luận về dãy số. Sự đa dạng này khiến ARC AGI trở thành thước đo mạnh mẽ về việc AI có thể thực sự “nghĩ” và học như con người đến đâu.
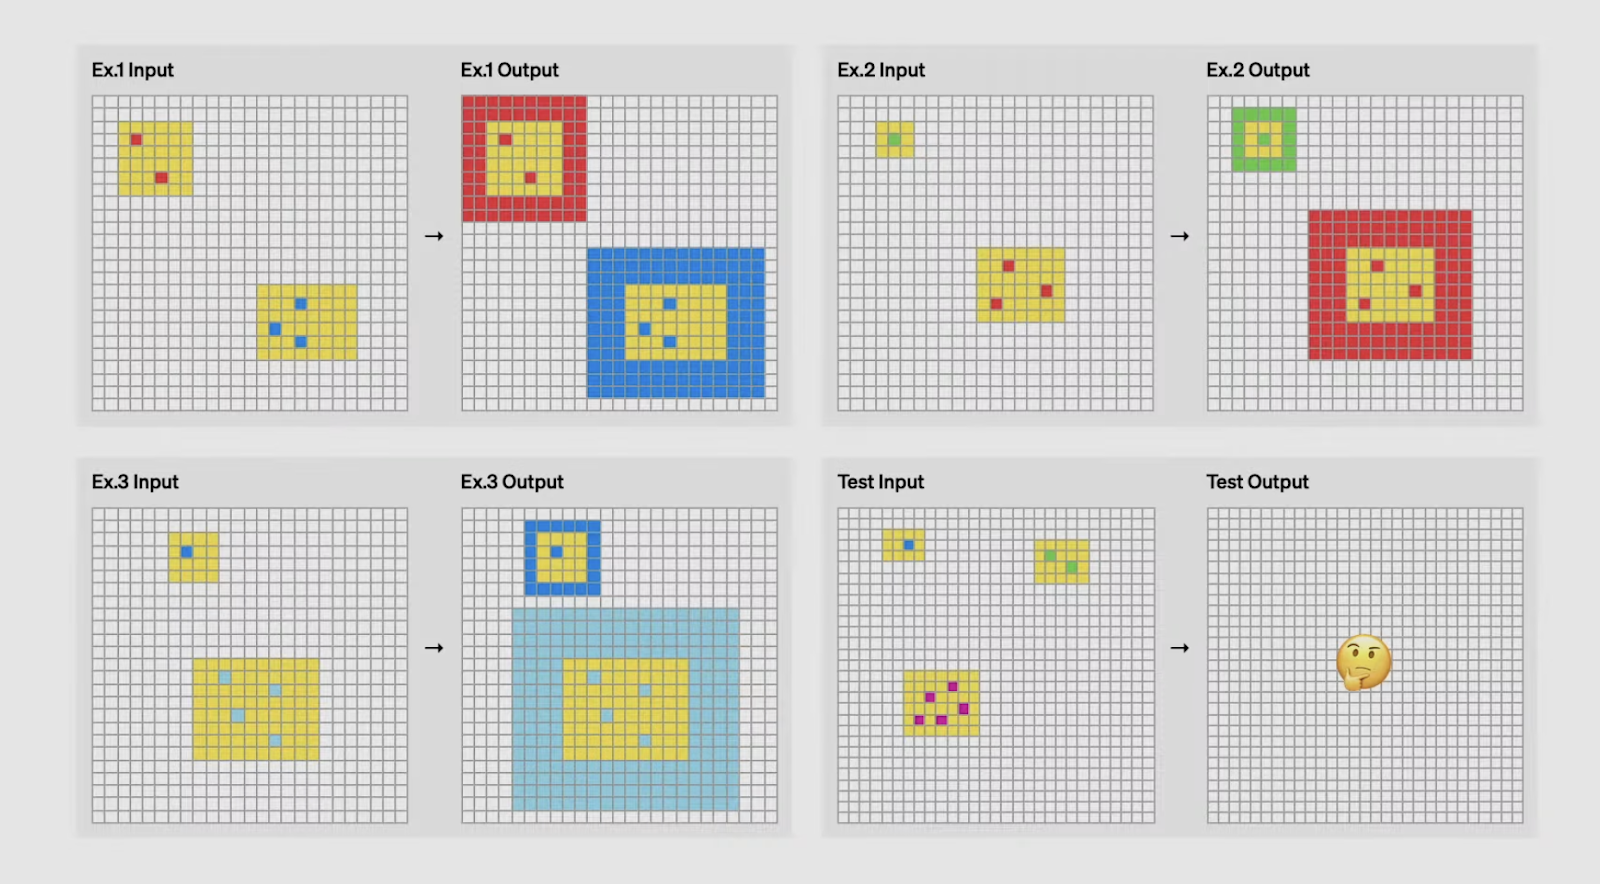
Bạn có đoán được logic biến đổi đầu vào thành đầu ra không? Nguồn: OpenAI
Hiệu suất của o3 trên ARC AGI đánh dấu một cột mốc quan trọng. Ở thiết lập tính toán thấp, o3 đạt 76% trên tập semi-private holdout—một con số vượt xa mọi mô hình trước đó.
Khi chạy ở thiết lập tính toán cao, nó còn đạt 88%, vượt ngưỡng 85% thường được xem là mức hiệu suất của con người. Đây là lần đầu một AI vượt qua con người trên điểm chuẩn này, thiết lập tiêu chuẩn mới cho các tác vụ dựa trên suy luận.
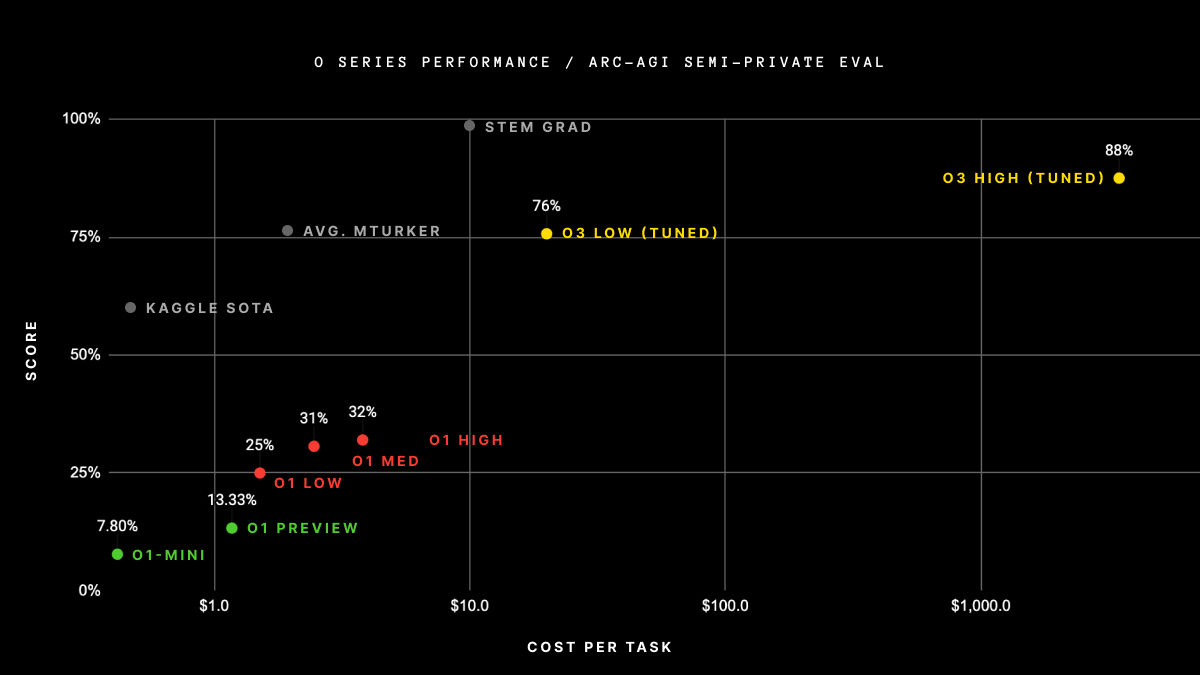
Nguồn: ArcPrize
Chúng tôi cho rằng các kết quả này đặc biệt đáng chú ý vì chúng cho thấy khả năng của o3 trong việc xử lý các tác vụ đòi hỏi tính thích ứng và khái quát hóa, thay vì kiến thức máy móc hay tính toán bạo lực. Đây là dấu hiệu rõ ràng cho thấy o3 đang tiến gần hơn tới trí tuệ tổng quát thực sự, vượt khỏi những năng lực đặc thù theo lĩnh vực và bước vào những miền trước đây được cho là độc quyền của con người.
Tuy nhiên, các kết quả trên dựa trên phiên bản o3 được chia sẻ trong sự kiện 12 Days of Christmas của OpenAI vào tháng 12, và OpenAI đã xác nhận phiên bản o3 vừa phát hành khác với phiên bản dùng trong các thử nghiệm trên. ARC AGI sẽ sớm công bố kết quả cập nhật cho o3.
Những cải thiện hiệu suất lớn như vậy không tự nhiên mà có. Đội ngũ OpenAI đã tìm ra một số đột phá để đạt được các con số này:
OpenAI nhận thấy việc tăng ngân sách tính toán trong quá trình huấn luyện học tăng cường giúp cải thiện hiệu suất mô hình—phản chiếu hành vi mở rộng quy mô mà chúng ta từng thấy với tiền huấn luyện giám sát ở các mô hình GPT. Nhưng lần này, thay vì tối ưu hóa dự đoán từ tiếp theo, o3 học bằng cách tối đa hóa phần thưởng học tăng cường, thường trong các môi trường có bổ trợ công cụ.
Nói cách khác, OpenAI đang coi học tăng cường giống như tiền huấn luyện—mở rộng cả về thời lượng lẫn tính toán—và có vẻ hiệu quả. Điều này mở khóa các năng lực hưởng lợi từ lập kế hoạch dài hạn và suy luận tuần tự, như lập trình thi đấu và chứng minh toán nhiều bước. Khi kết hợp với việc dùng công cụ, mức tăng hiệu suất càng rõ nét.
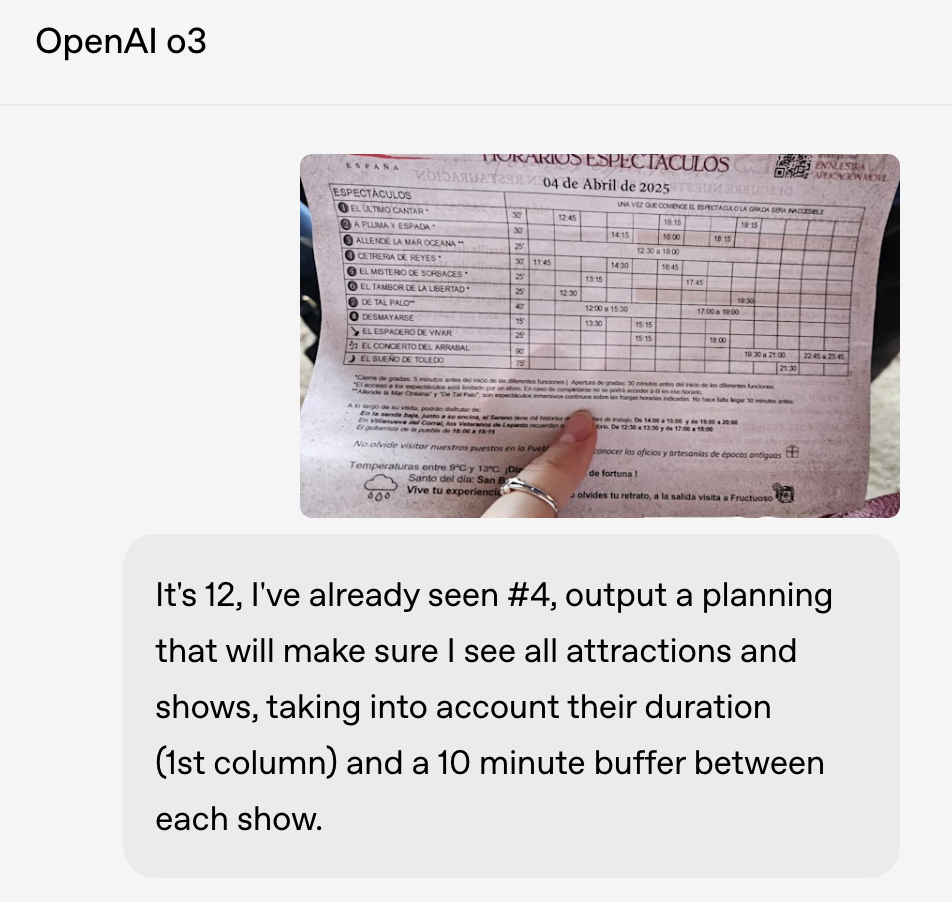
o3 cũng cho thấy cải tiến đáng kể trong suy luận thị giác. Nó không chỉ hiểu hình ảnh—mà còn tích hợp chúng trực tiếp vào vòng lặp suy luận. Bao gồm diễn giải, thao tác và xem lại hình ảnh trong khi giải bài toán. Đây là một lý do giúp o3 làm tốt các tác vụ liên quan đến hình khoa học, sơ đồ toán, thậm chí là lập lịch từ ảnh chụp.
Một đổi mới then chốt là cách o3 giữ hình ảnh thô trong bộ nhớ suốt quá trình suy luận. Thay vì xử lý một mô tả tĩnh rồi loại bỏ ảnh, nó có thể phóng to, xoay hoặc xem lại các phần khác nhau của ảnh theo yêu cầu bằng công cụ. Điều này khiến suy luận linh hoạt hơn và cho phép xử lý đầu vào thị giác “lộn xộn” hơn, như bảng trắng mờ, sơ đồ vẽ tay, hay ảnh lịch sự kiện.
Trong một ví dụ, OpenAI dùng o3 để đọc một ảnh lịch trình chất lượng thấp và lập kế hoạch hành trình sao cho tham gia đủ mọi sự kiện với khoảng nghỉ mười phút giữa các mục—điều đòi hỏi cả phân tích bố cục thị giác và áp dụng ràng buộc thời gian thực.
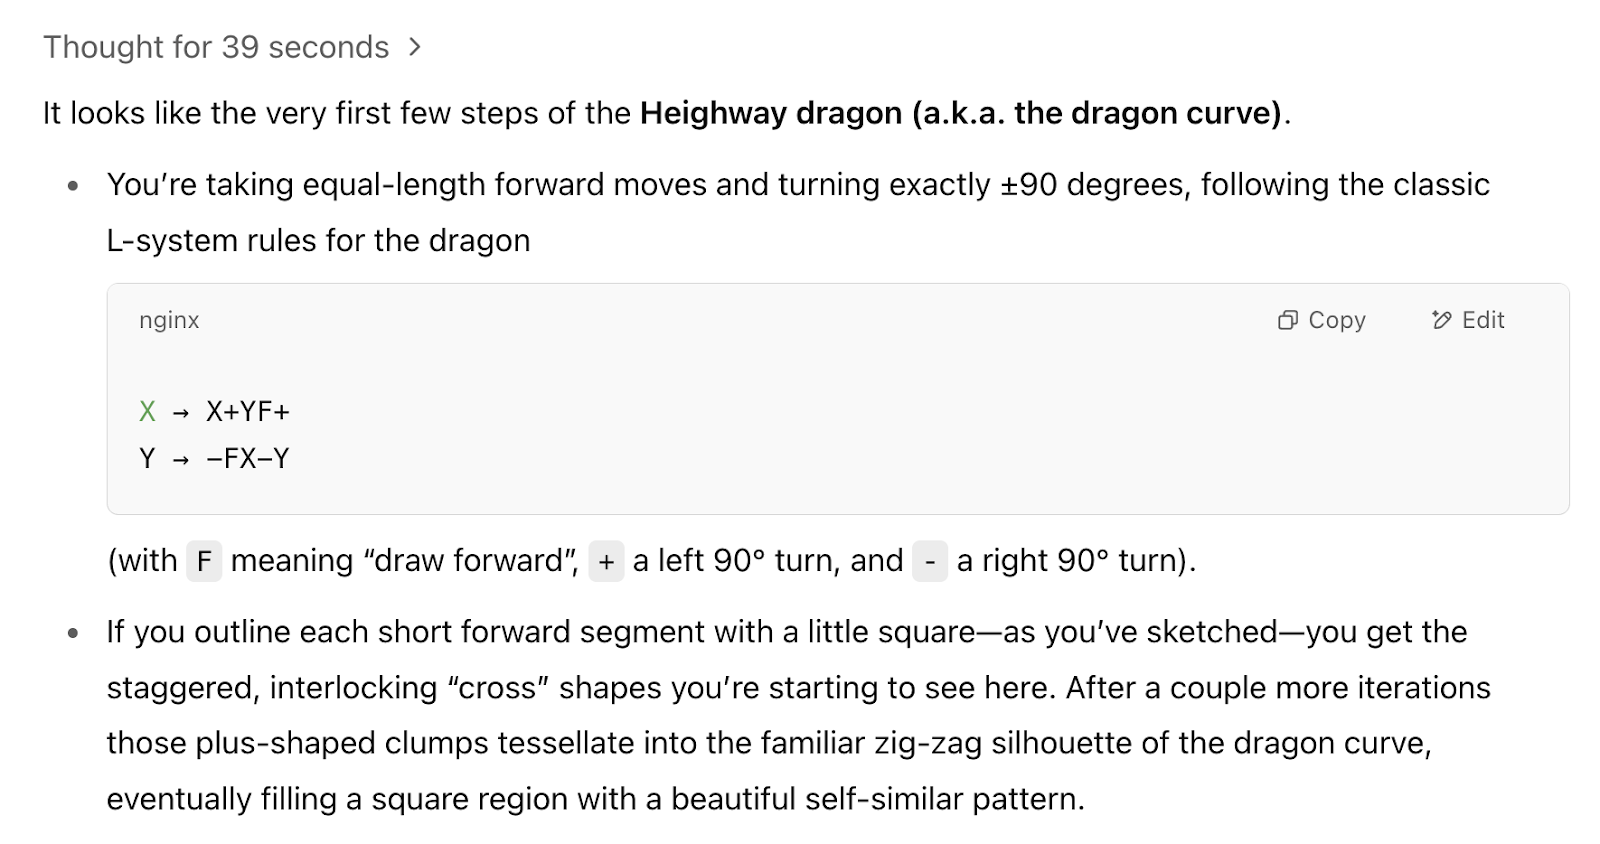
Chúng tôi muốn thử nhanh kỹ năng thị giác bằng một bài kiểm tra tự làm. Trước tiên, chúng tôi đưa cho o1 một bản vẽ sơ sài và hỏi: “Chúng ta đang bắt đầu vẽ fractal nào?”
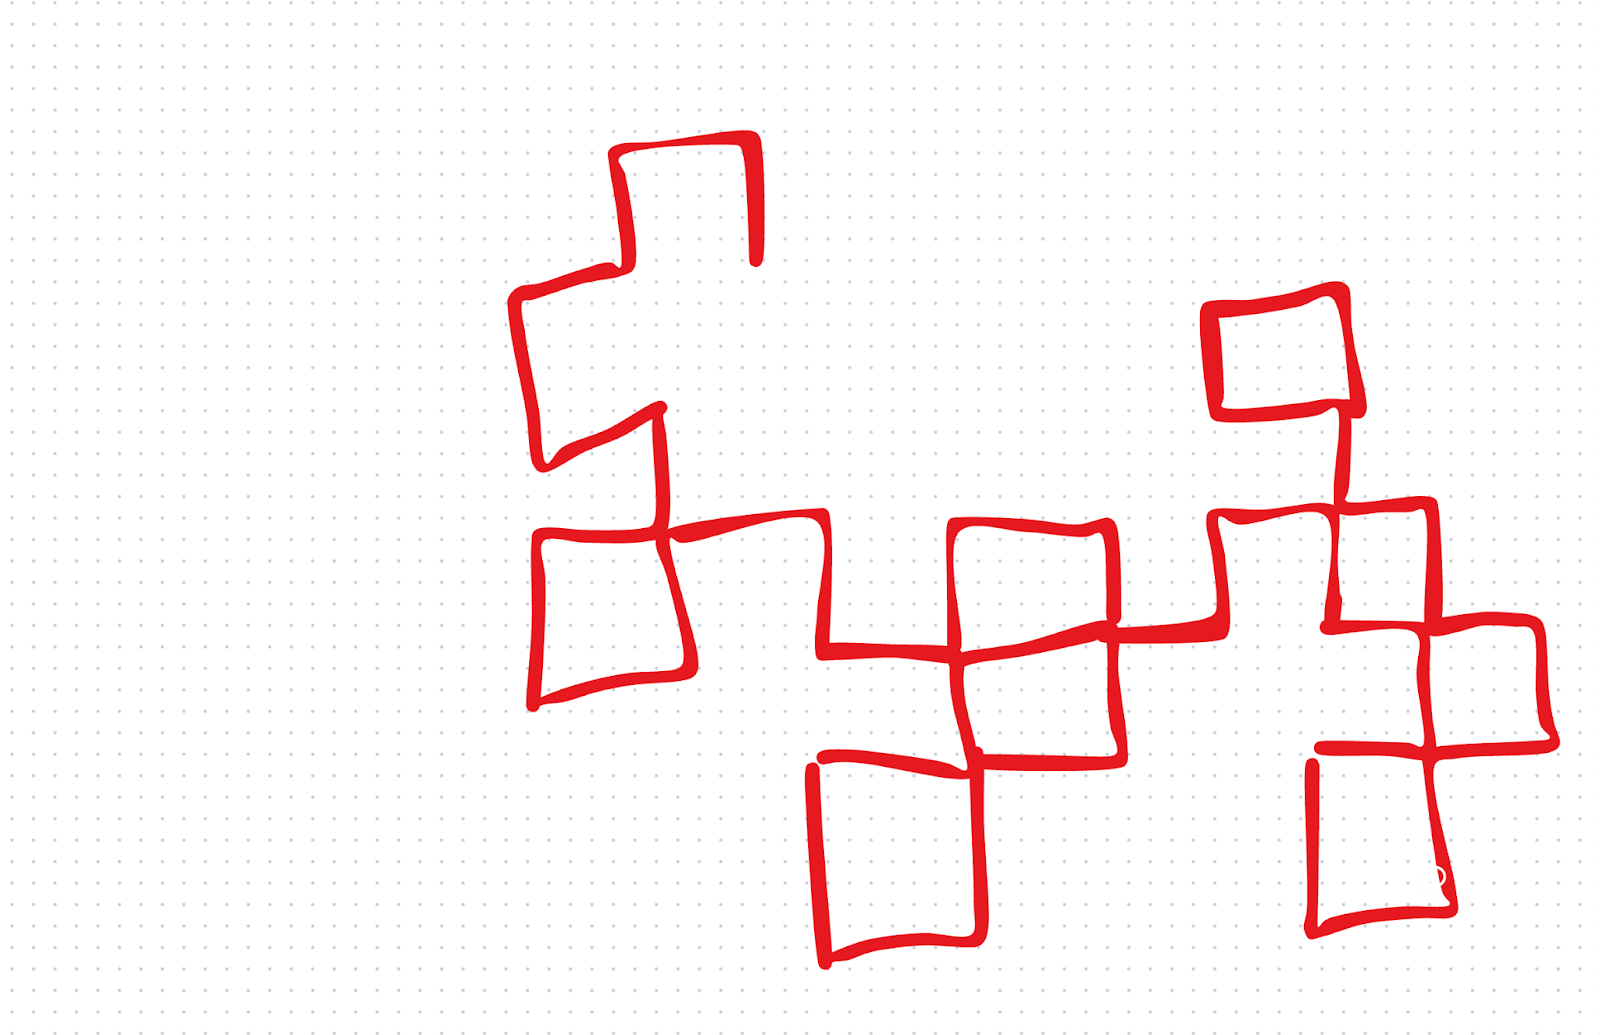
o1 trả lời sai. Còn o3 thì đúng: Nó cho biết chúng tôi đang bắt đầu vẽ đường cong rồng (dragon curve). Đây chỉ là một thử nghiệm nhỏ, nhưng chúng tôi thấy ấn tượng vì chúng tôi không cung cấp cho o3 nhiều dữ kiện.
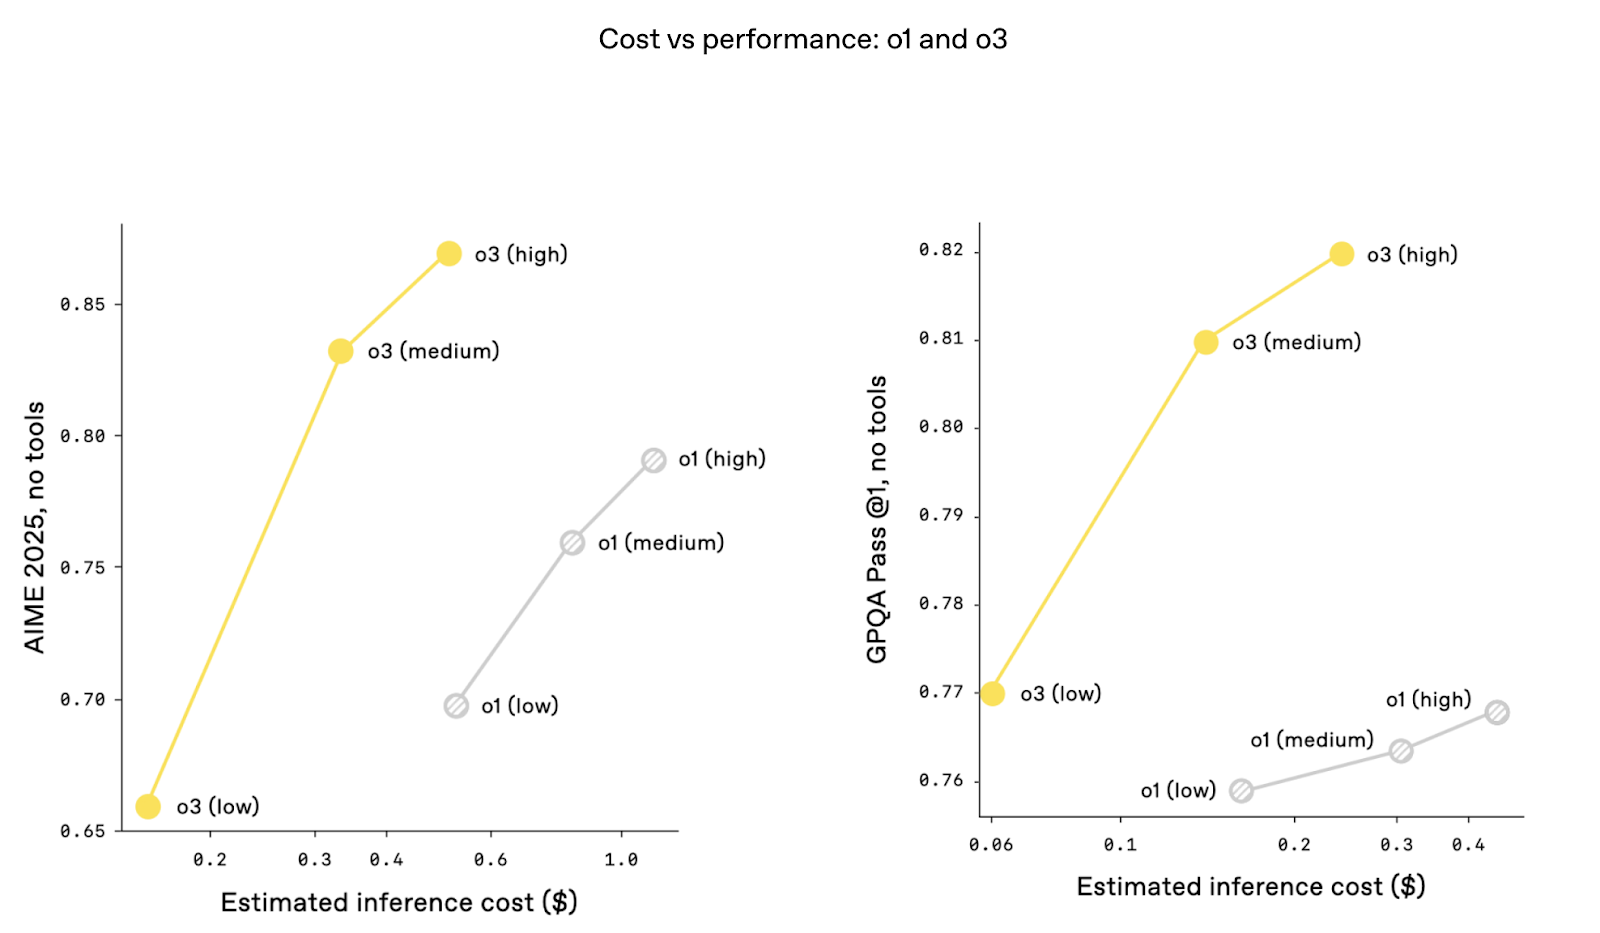
Điều thú vị là tỷ lệ chi phí so với hiệu suất tốt hơn với o3. Tức là hiệu suất cao hơn ở cùng mức chi phí suy luận. Điều này có thể nhờ các tối ưu kiến trúc cải thiện thông lượng token và giảm độ trễ. Chi phí đã là chủ đề nóng kể từ khi Deepseek-R1 công bố hiệu suất rất cao với chi phí chỉ bằng một phần nhỏ so với ChatGPT.
Tính đến tháng 4/2025, o3-mini đã được thay thế hoàn toàn bằng o4-mini trong ChatGPT và API. o4-mini cho hiệu suất tốt hơn trên hầu hết các điểm chuẩn, bổ sung đầu vào đa phương thức gốc và giữ khả năng dùng công cụ—đồng thời vẫn nhanh hơn và tiết kiệm hơn o3. Thực tế, o4-mini giờ đảm nhận vai trò mà o3-mini được thiết kế để đảm nhiệm. Tuy nhiên, nội dung dưới đây về o3-mini vẫn còn giá trị.
o3-mini được giới thiệu cùng o3 như một lựa chọn tiết kiệm chi phí nhằm đưa khả năng suy luận nâng cao đến với nhiều người dùng hơn mà vẫn duy trì hiệu suất. OpenAI mô tả o3-mini là tái định nghĩa “biên hiệu suất–chi phí” của các mô hình suy luận, giúp tiếp cận các tác vụ đòi hỏi độ chính xác cao nhưng cần cân bằng ràng buộc tài nguyên.
Một trong những điểm nổi bật của o3-mini là thời gian suy nghĩ thích ứng, cho phép người dùng điều chỉnh nỗ lực suy luận của mô hình dựa trên độ phức tạp của tác vụ. Với các bài toán đơn giản, người dùng có thể chọn suy luận mức thấp để tối đa hóa tốc độ và hiệu quả.
Với các tác vụ thách thức hơn, tùy chọn nỗ lực suy luận cao cho phép mô hình đạt hiệu suất tương đương o3, nhưng với chi phí chỉ bằng một phần. Sự linh hoạt này đặc biệt hấp dẫn với nhà phát triển và nhà nghiên cứu làm việc trên nhiều trường hợp sử dụng đa dạng.
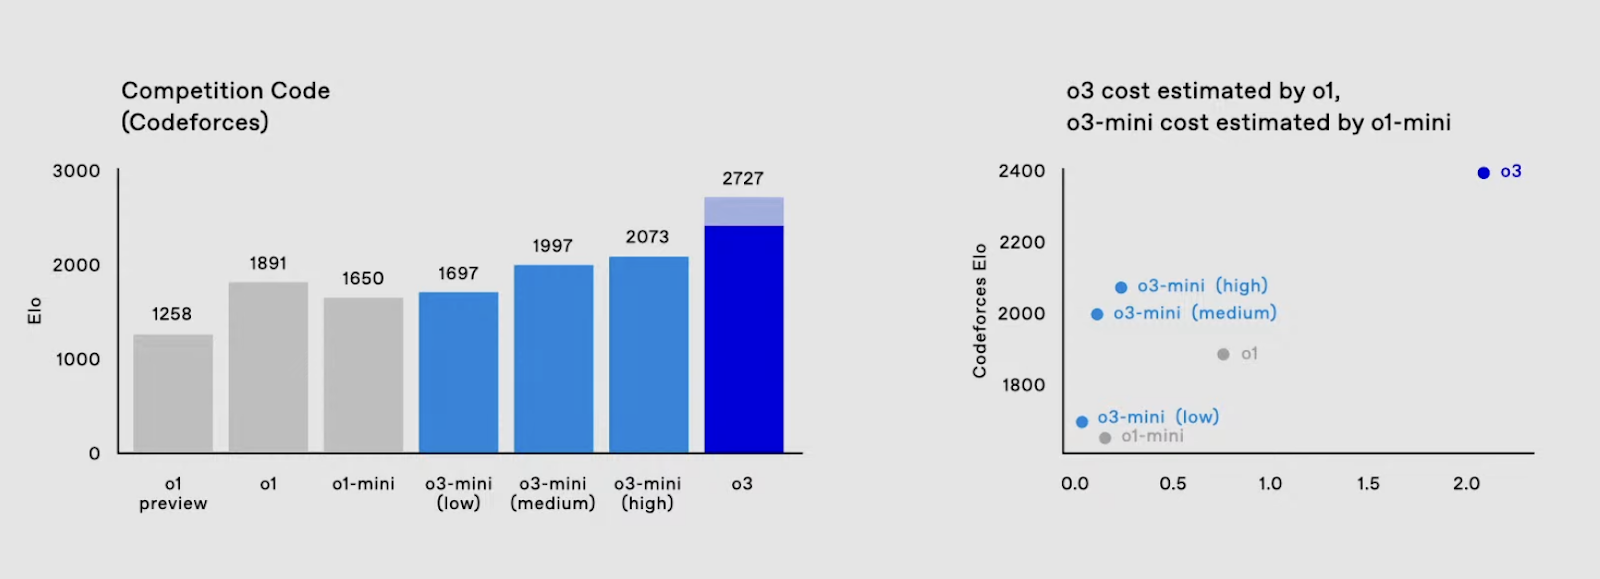
Nguồn: OpenAI
Bản demo trực tiếp cho thấy o3-mini giữ đúng lời hứa. Ví dụ, trong một tác vụ lập trình, o3-mini được yêu cầu tạo một script Python để dựng máy chủ cục bộ với giao diện tương tác phục vụ kiểm thử. Dù nhiệm vụ phức tạp, mô hình vẫn thực hiện tốt, thể hiện khả năng xử lý các thách thức lập trình.
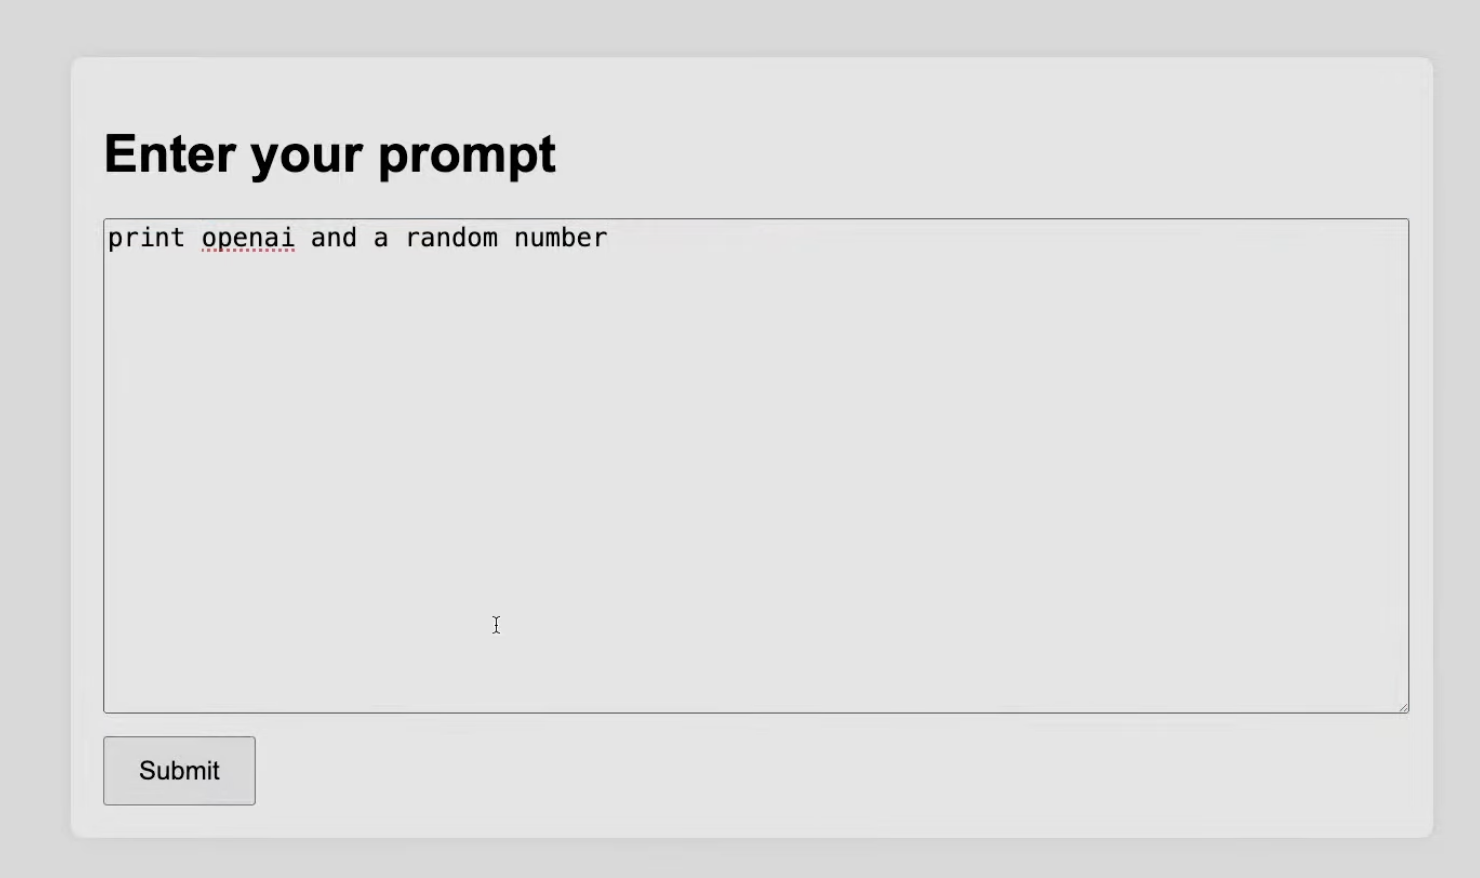
Nguồn: OpenAI
Chúng tôi xem o3-mini là giải pháp thực tiễn cho các tình huống cần hài hòa giữa hiệu quả chi phí và hiệu suất.
O3 mất thêm thời gian mới khả dụng, và một phần lý do có thể liên quan đến các đổi mới về an toàn.
OpenAI cho biết họ đã xây dựng lại các bộ dữ liệu huấn luyện an toàn và đưa vào hàng nghìn lời nhắc từ chối có mục tiêu. Họ nêu rõ các danh mục: mối đe dọa sinh học, tạo phần mềm độc hại và kỹ thuật jailbreak. Dữ liệu huấn luyện mới này đã giúp o3 thể hiện độ chính xác từ chối cao trên các điểm chuẩn nội bộ, như xử lý thứ bậc hướng dẫn và khả năng chống jailbreak. Để làm được điều này, theo báo cáo, các thành viên OpenAI đã dành hàng nghìn giờ gắn cờ nội dung không an toàn.
OpenAI cũng triển khai một bộ giám sát dựa trên LLM suy luận (họ gọi là “bộ giám sát suy luận tập trung vào an toàn”). Vì vậy, ngoài việc huấn luyện mô hình nói “không” với lời nhắc không an toàn, OpenAI còn bổ sung một lớp an toàn nữa—một LLM dựa trên suy luận. Hãy coi đây là một mô hình “chó canh gác” chạy song song, được huấn luyện chuyên để lý giải về mục đích và rủi ro tiềm ẩn của đầu vào người dùng, dựa trên các quy tắc an toàn do con người viết.
OpenAI đã áp dụng cách tiếp cận chủ động để kiểm thử an toàn cho o3 và o3 mini bằng cách mở quyền truy cập cho các nhà nghiên cứu thực hiện đánh giá an toàn công khai trước khi mô hình được phát hành đầy đủ.
Một tính năng trung tâm trong chiến lược an toàn của OpenAI cho o3 là điều chỉnh mang tính suy xét (deliberative alignment)—một phương pháp vượt ra ngoài các cách tiếp cận an toàn truyền thống. Biểu đồ dưới đây cho thấy điều chỉnh mang tính suy xét khác với các phương pháp như RLHF (Học tăng cường với phản hồi của con người), RLAIF (Học tăng cường với phản hồi của AI), và các kỹ thuật tinh chỉnh ở thời điểm suy luận như Self-REFINE.
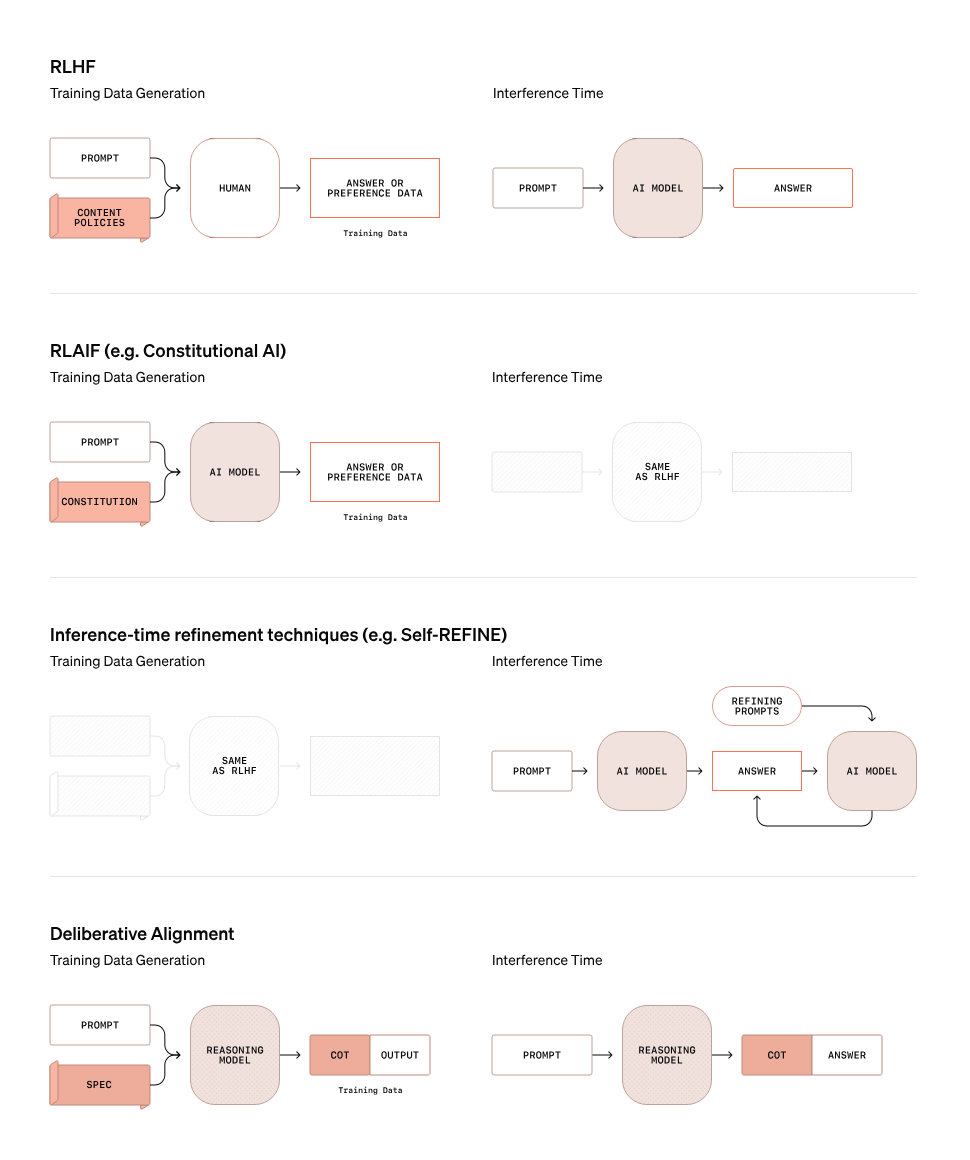
Nguồn: OpenAI
Trong điều chỉnh mang tính suy xét, mô hình không chỉ dựa vào các quy tắc tĩnh hay bộ dữ liệu sở thích để xác định một lời nhắc an toàn hay không an toàn. Thay vào đó, nó sử dụng khả năng suy luận để đánh giá lời nhắc theo thời gian thực. Biểu đồ trên minh họa quy trình này:
OpenAI dự đoán chúng ta sẽ muốn tiếp tục tìm hiểu về an toàn. Đón trước điều này, họ đã phát hành Khung Sẵn sàng (Preparedness Framework) của họ với các ý tưởng về đo lường và bảo vệ trước những tổn hại nghiêm trọng.
Trong bộ chọn mô hình ChatGPT, giờ bạn sẽ thấy o3 và o4-mini khả dụng. Theo thông báo của OpenAI, o3-pro dự kiến ra mắt trong vài tuần tới. Nó sẽ bao gồm các khả năng dùng công cụ tương tự—như Python, duyệt web và phân tích hình ảnh—như những mô hình khác trong dòng o.
Nếu bạn quan tâm cập nhật thời điểm o3-pro khả dụng, hãy đăng ký nhận bản tin The Median của DataCamp, chúng tôi sẽ thông báo ngay khi có.
O3 và o3 mini làm nổi bật sự phức tạp ngày càng tăng của các hệ thống AI và thách thức trong việc phát hành chúng một cách có trách nhiệm. Dù các điểm chuẩn rất ấn tượng, chúng tôi quan tâm nhiều hơn đến những câu hỏi mà các mô hình này đặt ra: Chúng sẽ tiếp tục hoạt động ra sao trong các kịch bản thực tế? Các biện pháp an toàn liệu đủ vững để xử lý các trường hợp ngoại lệ ở quy mô lớn?
Theo chúng tôi, o3 và o3 mini là những tín hiệu sớm về việc hệ thống AI đang tiến dần tới tính tự chủ cao hơn. Khả năng suy luận và thích ứng ấn tượng của chúng gợi ý một sự chuyển dịch từ công cụ do chúng ta vận hành sang tác nhân hành động thay cho chúng ta. Điều gì sẽ xảy ra khi các hệ thống này điều hướng các tác vụ mở mà không cần nhắc nhở từ con người? Chúng ta đánh giá các mô hình tự đặt mục tiêu cho mình—chứ không chỉ tạo đầu ra—như thế nào?
Nếu bạn muốn khám phá thêm các chủ đề AI, chúng tôi khuyến nghị:
Học AI với các khóa học này!
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
