

Kurs
Llama 3 ile Çalışmak
2 sa
15.7K
Alıştırma and program your progress.
Google Ile Devam EdinMeta, iki yayınlanmış model—Llama 4 Scout ve Llama 4 Maverick—ve hâlen eğitimde olan üçüncü bir model: Llama 4 Behemoth içeren Llama 4 model paketini yeni duyurdu.
Scout ve Maverick sürümleri şu anda Meta’nın tipik açık-ağırlık lisansı altında kullanılabilir durumda—ancak önemli bir çekinceyle: Hizmetleriniz aylık 700 milyon aktif kullanıcıyı aşıyorsa, Meta’dan ayrı bir lisans almanız gerekiyor; Meta bu lisansı kendi takdirine göre verebilir veya vermeyebilir.
Llama Scout, kamuya açık olarak yayımlanan tüm modeller arasında en büyük olan 10 milyon belirteçlik bir bağlam penceresini destekler. Llama Maverick, genel amaçlı bir model olup GPT-4o, Gemini 2.0 Flash ve DeepSeek-V3’ü hedef alır. Hâlen eğitilmekte olan Llama Behemoth ise yüksek kapasiteli bir öğretmen model olarak hizmet verir.
Bu giriş yazısında, Llama 4 paketine genel bir bakış sunacağım. Ekibimiz modeli çoktan test etti ve öğrenmenizi ilerletmek isterseniz şu eğitimleri öneririm:
Güncelleme: Yaklaşık bir yıllık sessizliğin ardından Meta en yeni LLM’ini yayımladı. Genel bir bakış için Muse Spark rehberimize göz atın.
Okurlarımızı en yeni yapay zekâ gelişmelerinden haberdar etmek için hafta içinin önemli haberlerini özetleyen, ücretsiz Cuma bültenimiz The Median’i gönderiyoruz. Abone olun; haftada sadece birkaç dakikayla güncel kalın:
Llama 4, Meta’nın yeni büyük dil modeli ailesidir. Yayın, hâlihazırda kullanıma açık iki modeli—Llama 4 Scout ve Llama 4 Maverick—ve eğitim aşamasındaki üçüncü bir modeli, Llama 4 Behemoth’u içerir.
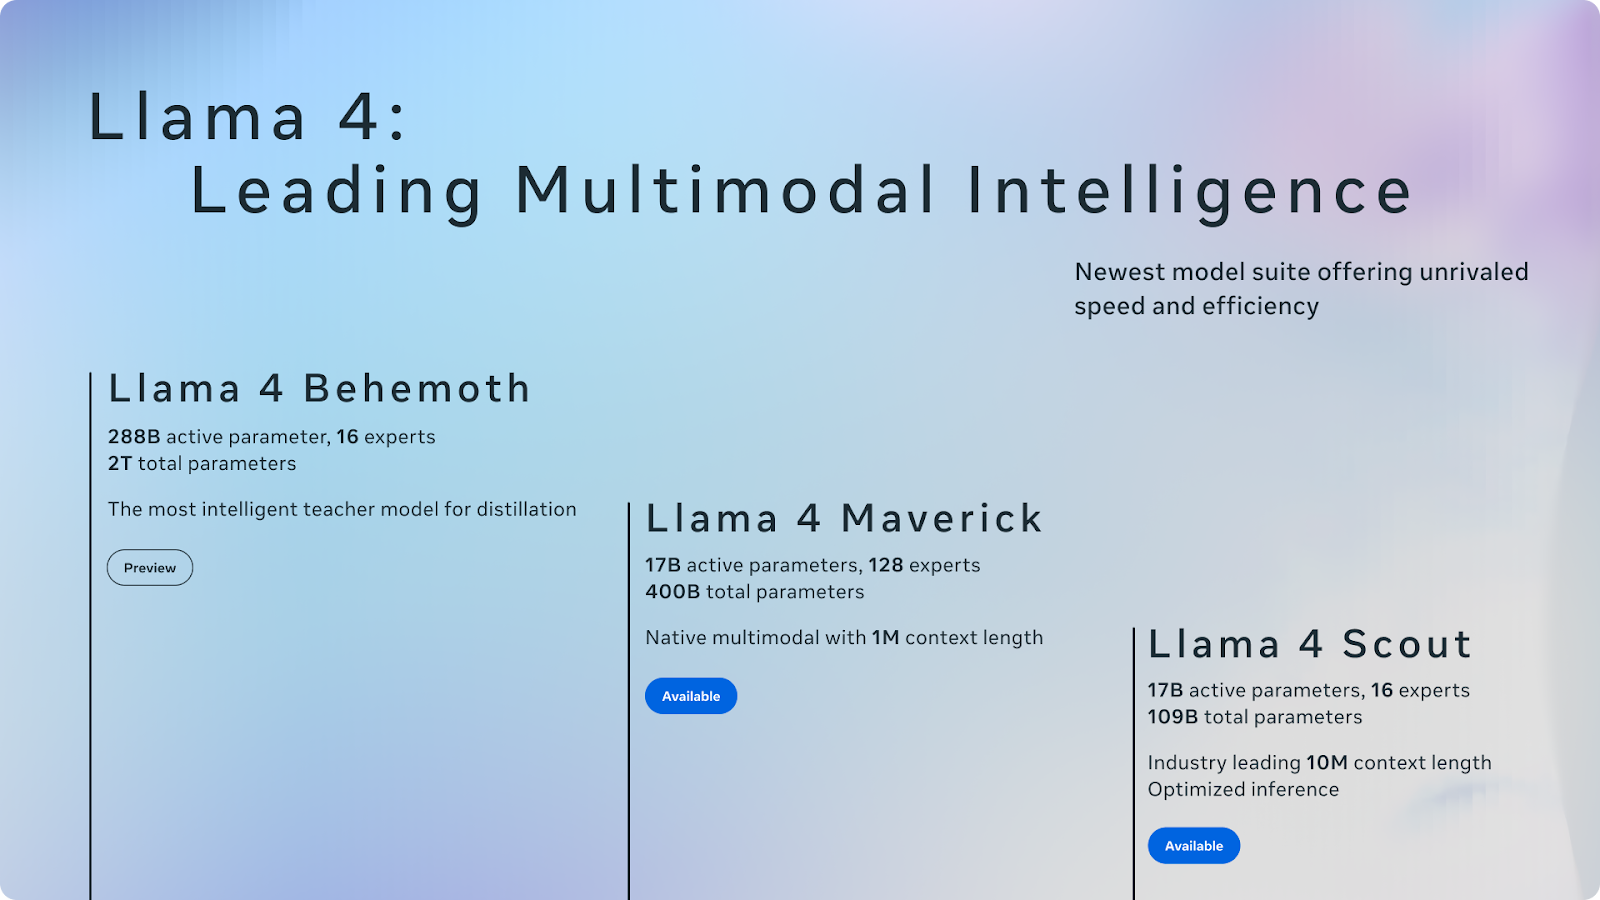
Kaynak: Meta AI
Llama 4, kayda değer iyileştirmeler getiriyor. Özellikle, yalnızca belirli görevler için gerekli bileşenleri etkinleştirerek verimliliği ve performansı artırmayı amaçlayan bir uzman karışımı (MoE) mimarisini içeriyor (buna birazdan değineceğiz). Bu tasarım, daha ölçeklenebilir ve uzmanlaşmış yapay zekâ modellerine bir geçişi temsil ediyor.
Llama 4, Meta’nın açık-ağırlık modeller yayınlama stratejisini sürdürüyor—ancak bir çekinceyle. Şirketiniz aylık 700 milyondan fazla aktif kullanıcıya sahip hizmetler işletiyorsa, Meta’dan ayrı bir lisans almanız gerekecek ve bu lisans verilebilir de verilmeyebilir de. Bu sınırlama bir yana, yayın yine de açık-ağırlık ekosisteminde büyük bir olay gibi hissettiriyor; gerçi ekosistemin kendisi son aylarda hızla değişti.
Llama 2 ve 3 bir zamanlar kategoriyi tanımlamış olsa da, Llama 4 artık çok daha rekabetçi bir alana giriyor. DeepSeek güçlü akıl yürütme yetenekleriyle geldi. Alibaba’nın Qwen serisi çok dilli ve kodlama kıyaslamalarında iyi performans gösterdi. Google’ın Gemma modelleri de daha küçük, verimli mimarilerle aynı alana giriyor. Ve sadece birkaç gün önce, OpenAI bir açık-ağırlık model yayımlamayı planladığını duyurdu; bu, bir yıl önce pek olası görünmeyen bir değişimdi.
Şimdi her bir model hakkında daha fazla ayrıntıya bakalım.
Llama 4 Scout, yeni paketin daha hafif modeli; ancak muhtemelen en ilgi çekici olanı. Tek bir H100 GPU üzerinde çalışır ve 10 milyon belirteçlik bir bağlam penceresini destekler. Bu, Scout’u bugüne kadar yayımlanan en çok bağlam işleyebilen açık-ağırlık model yapar ve çoklu belge özetleme, uzun biçimli kod akıl yürütme ve etkinlik ayrıştırma gibi görevler için potansiyel olarak en kullanışlı hâle getirir.
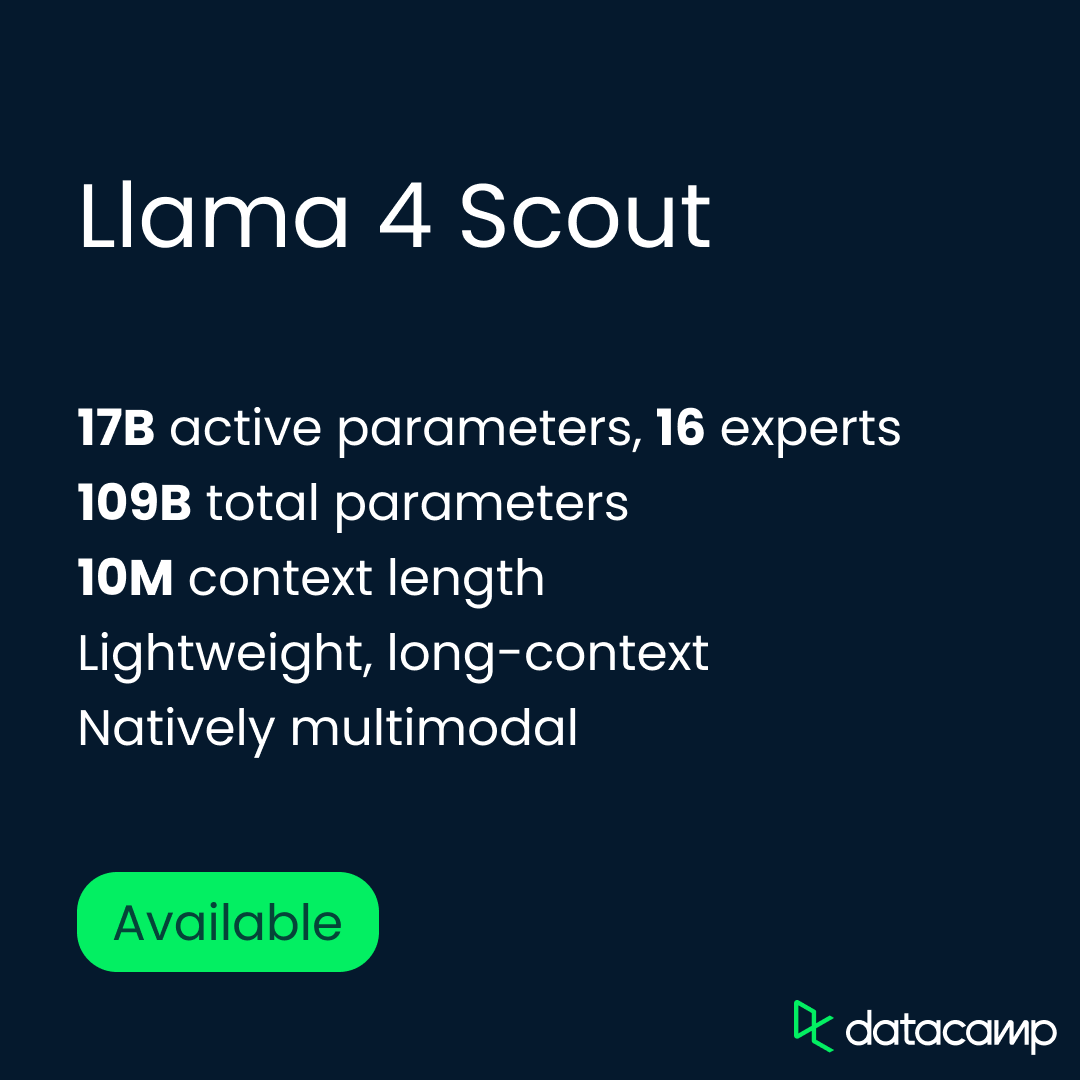
Scout, 16 uzmana dağıtılmış 17 milyar etkin parametreye sahiptir; toplam parametre sayısı 109 milyardır. 256K bağlam penceresiyle ön-eğitim ve son-eğitim yapılmıştır; ancak Meta, çok ötesine genelleme yapabildiğini söylüyor (bu iddianın test edilmesi gerekiyor). Pratikte bu, tüm kod tabanları, oturum geçmişleri veya hukuki belgeleri tek bir ileri geçişte işleyen iş akışlarının kapısını aralar.
Mimari açıdan Scout, Meta’nın uzman karışımı (MoE) çerçevesiyle inşa edilmiştir; burada, yoğun modellerde (ör. GPT-4o) tüm parametrelerin etkinleşmesine karşın, belirteç başına yalnızca bir alt küme etkinleşir. Bu da onu hem hesaplama açısından verimli hem de son derece ölçeklenebilir kılar.
Çekirdek mimarinin ötesinde Meta, Scout’un çok modlu yeteneklerini vurguladı. Metin, görüntü ve video verileriyle erken füzyon kullanılarak ön-eğitilmiştir; bu da metin ve görsel istem kombinasyonlarını yerel olarak işlemesini sağlar. Görsel dayanaklandırma ve VQA (görsel soru-cevap) gibi görüntü ağırlıklı görevlerde Scout, önceki tüm Llama modellerinden daha iyi performans gösterir ve çok daha büyük sistemlerle başa baş ilerler.
Kısacası, Scout genişlik ve ölçek için tasarlandı. Verimli çalışmak, önceki hiçbir açık modelin kaldıramadığı kadar girdi işlemek ve hem metin hem görüntü görevlerinde iyi performans göstermek üzere tasarlandı. 10M bağlam sınırını yakında test edeceğiz—ve sonuçları paylaşacağız.
Llama 4 Maverick, serinin genel amaçlı modeli—sohbet, akıl yürütme, görüntü anlama ve kodlama genelinde performans için oluşturulmuş tam ölçekli, çok modlu bir model. Scout bağlam uzunluğunun sınırlarını zorlarken Maverick, görevler arasında dengeli, yüksek kaliteli çıktıya odaklanır. Bu, Meta’nın GPT-4o, DeepSeek-V3 ve Gemini 2.0 Flash karşılığıdır.
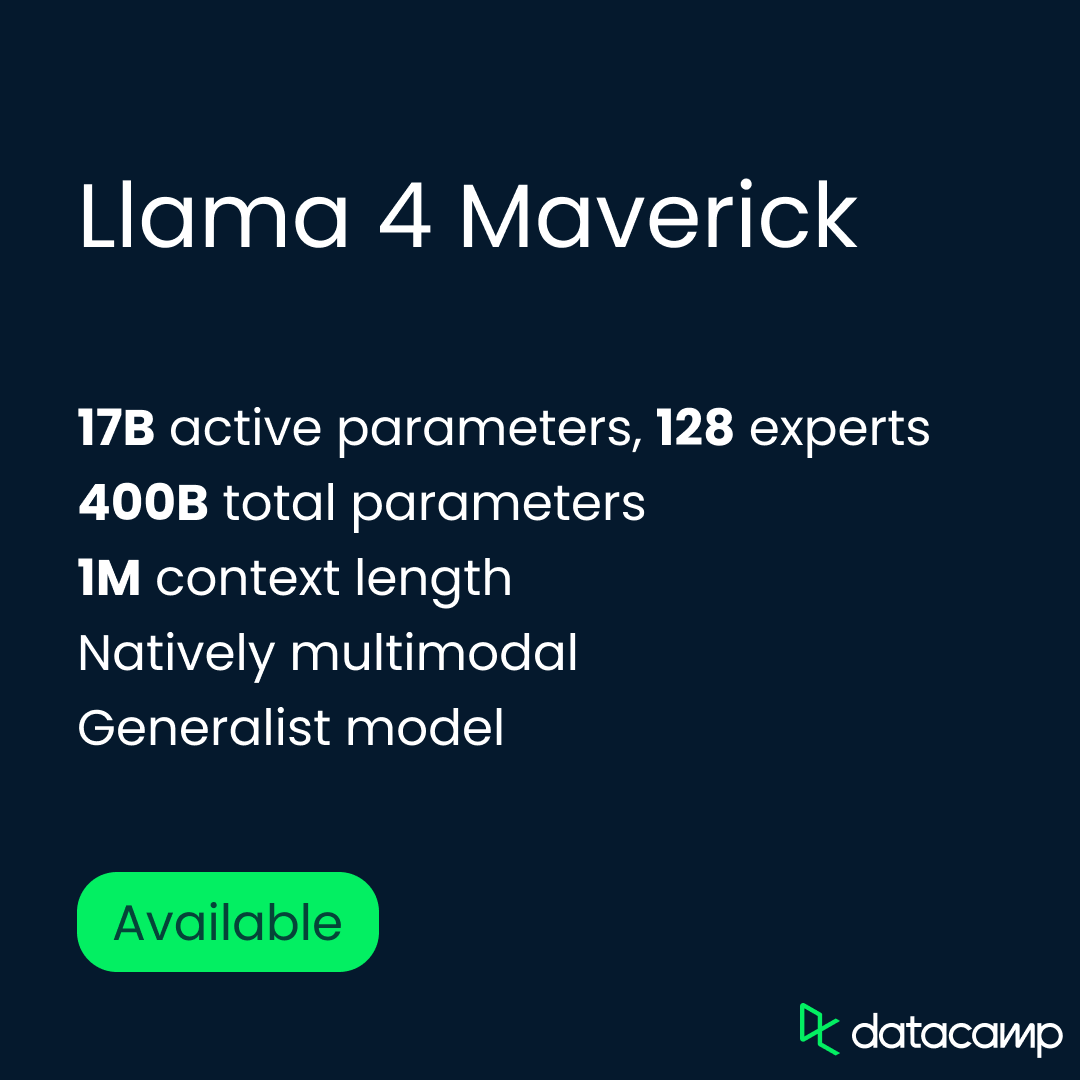
Maverick, Scout ile aynı 17 milyar etkin parametreye sahiptir; ancak daha büyük bir MoE yapılandırmasıyla: 128 uzman ve toplamda 400 milyar parametre. Scout gibi, belirteç başına yalnızca modelin bir kısmını etkinleştirerek çıkarım maliyetini düşürüp kapasiteyi ölçekleyen bir uzman karışımı mimarisi kullanır. Model tek bir H100 DGX ana makinesinde çalışır; ancak daha büyük ölçekli uygulamalar için dağıtık çıkarımla da dağıtılabilir.
Meta, son-eğitimde farklı bir yaklaşım benimsedi; hafif denetimli ince ayarlama, çevrimiçi pekiştirmeli öğrenme ve doğrudan tercih optimizasyonunun bir karışımını kullandı. Amaç, modeli aşırı kısıtlamadan zor istemlerde performansı keskinleştirmekti. Bu doğrultuda Meta, önceki Llama modelleri tarafından “kolay” olarak işaretlenen eğitim örneklerinin %50’den fazlasını eledi ve daha zor akıl yürütme, kodlama ve çok modlu görevlere ağırlık veren bir öğretim planı oluşturdu.
Maverick, Meta’nın çok daha büyük dahili modeli Llama 4 Behemoth’tan ortak damıtma ile de yararlandı; bu, ek eğitim maliyeti olmaksızın performansı artırmaya yardımcı oldu. Meta’ya göre bu damıtma hattı, akıl yürütme ve sohbet kalitesinde belirgin bir sıçrama sağladı.
Llama 4 Behemoth, Meta’nın bugüne kadarki en güçlü ve en büyük modeli—ancak henüz kullanıma sunulmuş değil. Hâlen eğitimde olan Behemoth, DeepSeek-R1 veya OpenAI’nin o3’ü gibi, çok adımlı düşünme zinciri görevleri için inşa edilip optimize edilmiş anlamda bir akıl yürütme modeli değildir.
Şu ana kadar bildiklerimize göre, doğrudan kullanım için bir ürün olarak da tasarlanmamış görünüyor. Bunun yerine, hem Scout hem Maverick’i damıtmak ve şekillendirmek için kullanılan bir öğretmen model olarak hareket ediyor. Yayınlandığında, başkalarının da kendi modellerini damıtmalarına imkân tanıyabilir.
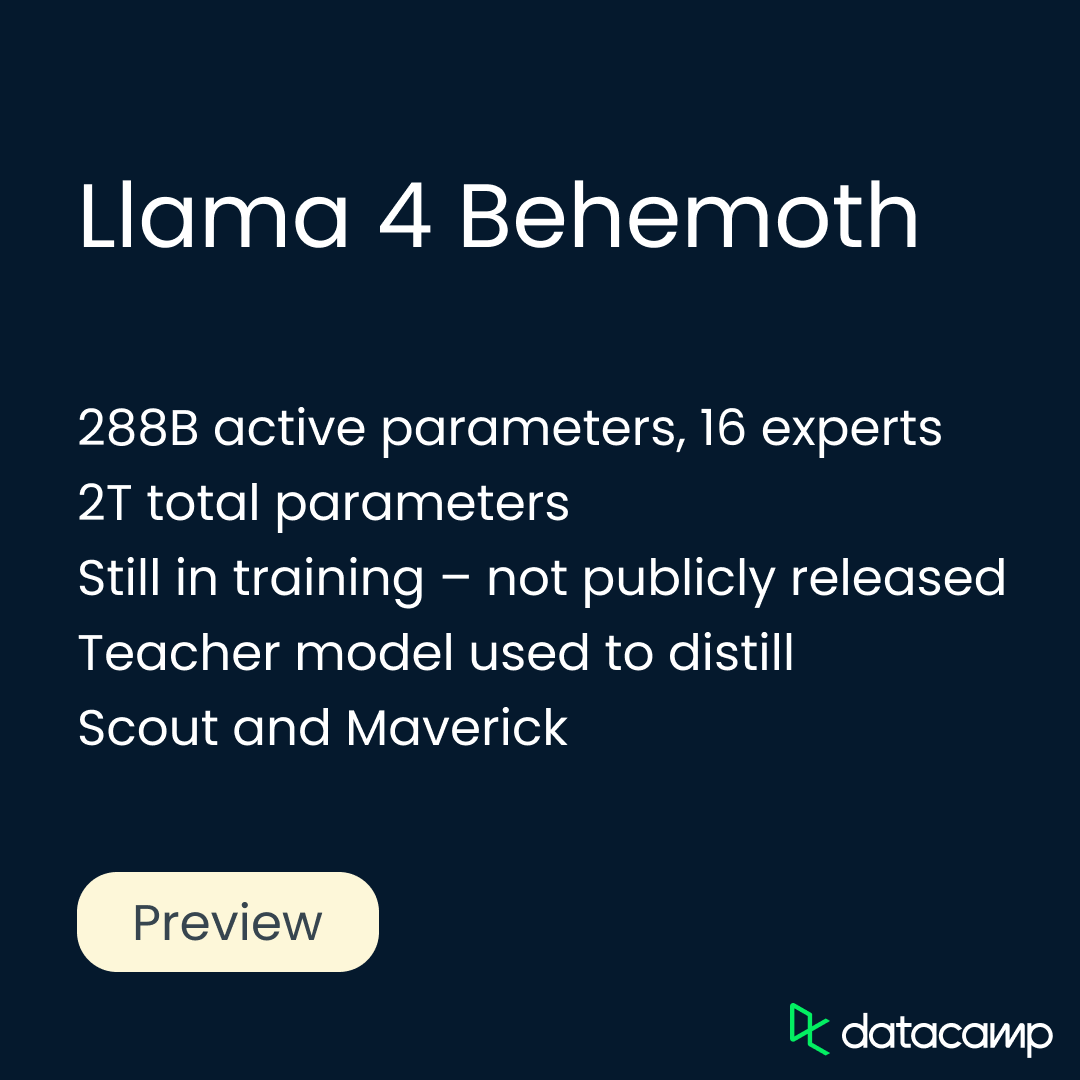
Behemoth, 16 uzmana dağıtılmış 288 milyar etkin parametreye sahiptir; toplam parametre sayısı 2 trilyona yaklaşır. Meta, Behemoth’u bu ölçekte desteklemek için tamamen yeni bir eğitim altyapısı kurdu. Eşzamansız pekiştirmeli öğrenme, istem zorluğuna dayalı öğretim örneklemesi ve yumuşak ve sert hedefleri dinamik olarak dengeleyen yeni bir damıtma kayıp fonksiyonu tanıttı.
Behemoth için son-eğitim de farklı bir tarif gerektirdi. Meta, zor istemlere odaklanmak için SFT örneklerinin %95’inden fazlasını eledi ve pekiştirmeli öğrenmeyi karmaşık akıl yürütme, kodlama ve çok dilli senaryolara yöneltti. Çeşitli sistem talimatlarından örnekleme, modelin genellemesini sağlarken, dinamik filtreleme RL eğitimi sırasında düşük değerli istemleri kaldırdı.
Meta, Llama 4 modellerinin her biri için, önceki Llama sürümleriyle ve çeşitli rakip açık-ağırlık ve sınır modelleriyle karşılaştırmalı dahili kıyaslama sonuçları yayımladı.
Bu bölümde, Meta’nın kendi rakamlarını kullanarak Scout, Maverick ve Behemoth için öne çıkan kıyaslamaları aktaracağım. Her zamanki gibi, öz bildirime dayalı kıyaslamalara temkinli yaklaşmanızı öneririm—ancak bu skorlar, her modelin farklı görevlerde nasıl performans gösterdiğine ve mevcut manzarada nerede durduğuna dair yararlı bir ilk bakış sunuyor. Scout ile başlayalım.
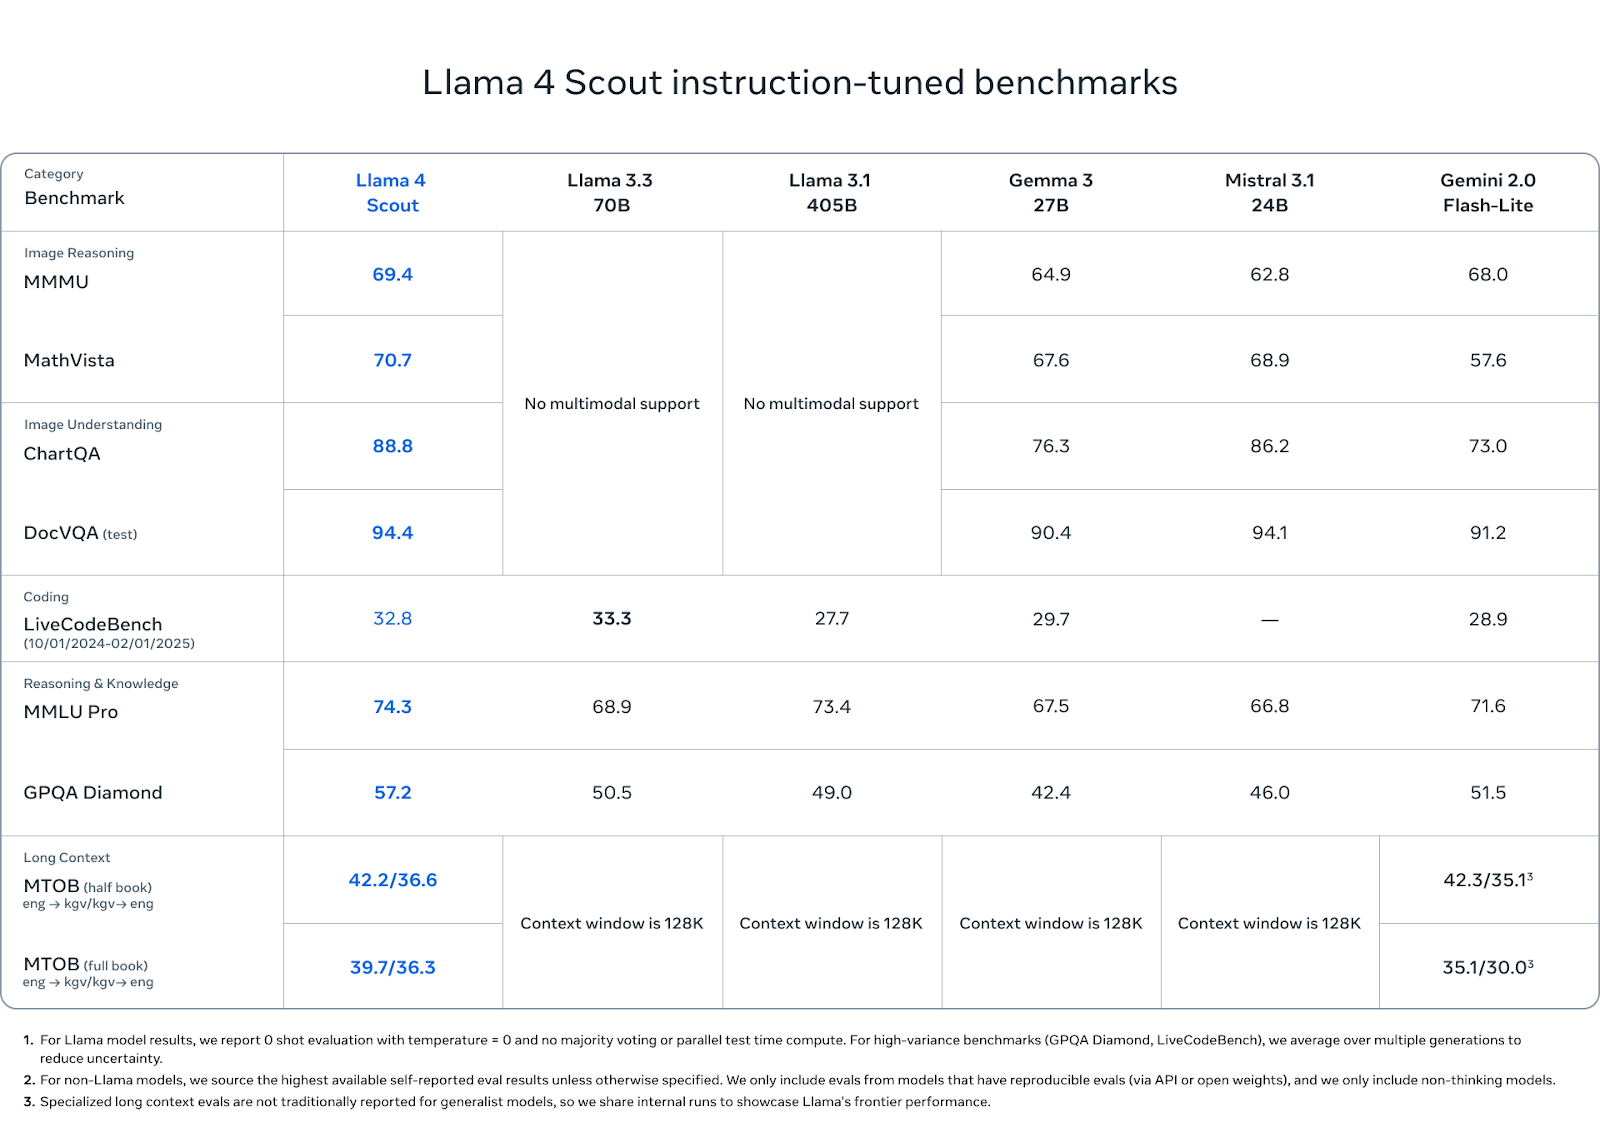
Llama 4 Scout, özellikle daha küçük etkin parametre sayısı ve tek GPU ayak izi düşünüldüğünde, akıl yürütme, kodlama ve çok modlu kıyaslamaların bir karışımında iyi performans gösteriyor.
Kaynak: MetaAI
Görüntü anlama tarafında Scout, rakiplerini az farkla geçiyor: ChartQA’da 88,8 ve DocVQA (test)’de 94,4 puan alarak Gemini 2.0 Flash-Lite’ı (sırasıyla 73,0 ve 91,2) geride bırakıyor ve Mistral 3.1 ile Gemma 3 27B’yi yakalıyor veya hafifçe aşıyor.
MMMU (69,4) ve MathVista (70,7) gibi görüntü temelli akıl yürütme kıyaslarında da açık-ağırlık grubuna liderlik ediyor; Gemma 3’ü (64,9; 67,6), Mistral 3.1’i (62,8; 68,9) ve Gemini Flash-Lite’ı (68,0; 57,6) geride bırakıyor.
Kodlamada, Scout LiveCodeBench’te 32,8 puan alıyor; bu da onu Gemini Flash-Lite’ın (28,9) ve Gemma 3 27B’nin (29,7) önüne koyuyor; ancak Llama 3.3’ün 33,3 puanının biraz gerisinde. Kodlama odaklı bir model değil; ama ayakta kalıyor.
Bilgi ve akıl yürütmede, Scout MMLU Pro’da 74,3 ve GPQA Diamond’da 57,2 puan alarak her iki kıyaslamada da diğer tüm açık-ağırlık modelleri geride bırakıyor. Bu kıyaslamalar uzun biçimli çok adımlı akıl yürütmeyi ödüllendirdiği için, özellikle bu ölçekte Scout’un güçlü performansı dikkat çekici.
Son olarak, Scout’un uzun bağlam yetenekleri gerçek dünya potansiyeli gösteriyor. Modelin İngilizce ile düşük kaynaklı bir dil olan KGV arasında çeviri yapma becerisini test eden MTOB (Massive Textual Overlap Benchmark) üzerinde, yarım kitap testinde 42,2/36,6 ve tam kitap testinde 39,7/36,3 puan alıyor. Yarım kitap testinde Gemini 2.0 Flash-Lite 42,3 ile az farkla öne geçse de, Scout tam kitapta açığı kapatıp Gemini’nin 35,1/30,0 puanını geride bırakıyor.
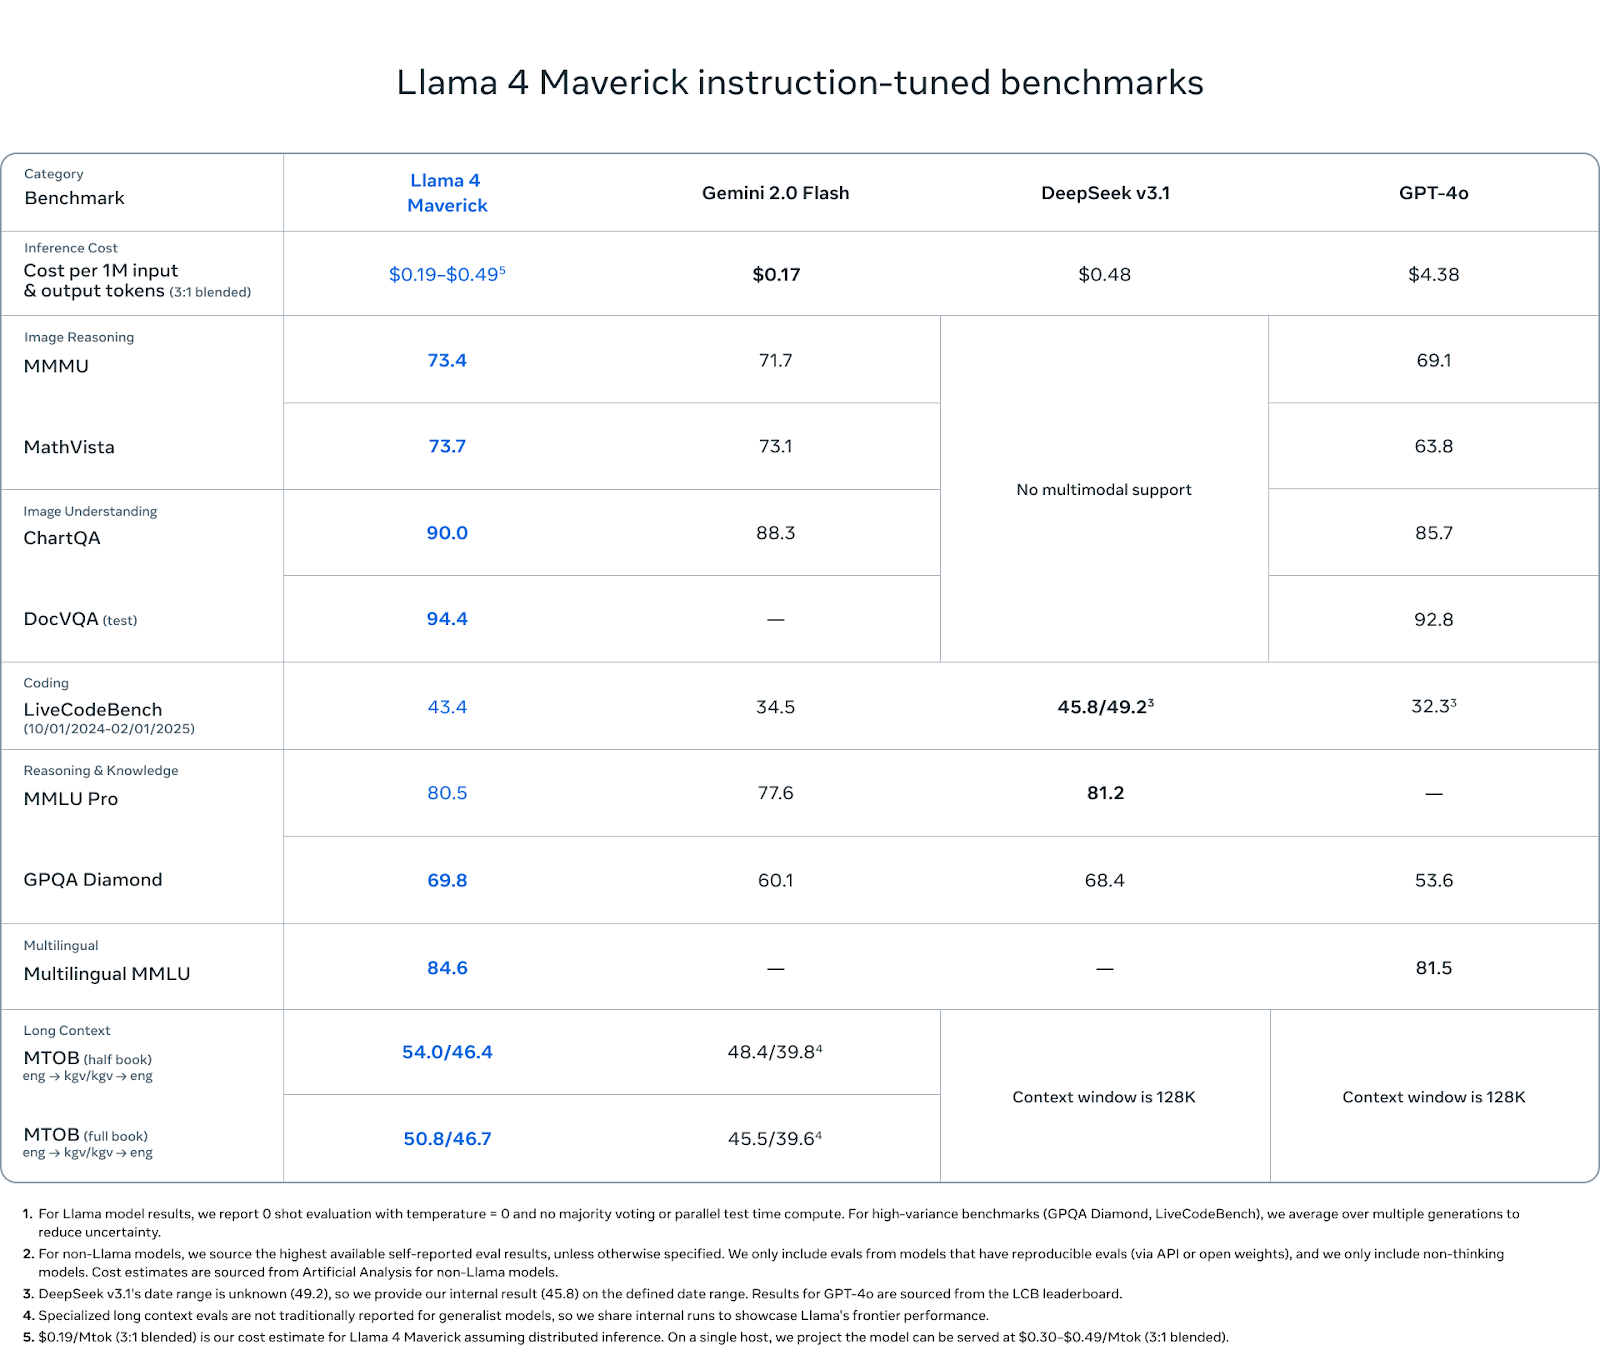
Maverick, Llama 4 serisindeki en dengeli model—ve kıyaslama sonuçları bunu yansıtıyor. Scout’un bağlam uzunluğu uçlarını ya da Behemoth’un ham ölçeğini hedeflemezken, çok modlu akıl yürütme, kodlama, dil anlama ve uzun bağlamı koruma gibi önemli her kategoride tutarlı performans gösterir.
Kaynak: MetaAI
Görüntü akıl yürütmede, Maverick MMMU’da 73,4 ve MathVista’da 73,7 puan alarak Gemini 2.0 Flash’ı (71,7 ve 73,1) ve GPT-4o’yu (69,1 ve 63,8) geride bırakıyor. ChartQA’da (görüntü anlama) 90,0 puanla, Gemini’nin 88,3’ünün biraz üzerinde ve GPT-4o’nun 85,7’sinin oldukça üzerinde. DocVQA’da Maverick 94,4’e ulaşıyor; Scout ile aynı ve GPT-4o’nun 92,8’ini aşıyor.
Kodlamada Maverick, LiveCodeBench’te 43,4 puan alarak GPT-4o’nun (32,3), Gemini Flash’ın (34,5) üzerine çıkıyor ve DeepSeek v3.1’in 45,8’ine oldukça yaklaşıyor.
Akıl yürütme ve bilgi tarafında Maverick, MMLU Pro’da 80,5 ve GPQA Diamond’da 69,8 puan alıyor; yine Gemini Flash’ı (77,6 ve 60,1) ve GPT-4o’yu (raporlanan MMLU Pro yok, GPQA’da 53,6) geride bırakıyor. DeepSeek v3.1, MMLU Pro’da 0,7 farkla önde.
Maverick, çok dilli anlamada da iyi performans gösteriyor ve Çok Dilli MMLU’da 84,6 puan alarak Gemini’nin 81,5’inin biraz üzerine çıkıyor. Bu da birden fazla dil veya coğrafyada çalışan geliştiriciler için ona avantaj sağlıyor.
Uzun bağlam değerlendirmelerinde (MTOB) Maverick, yarım kitap testinde 54,0/46,4 ve tam kitapta 50,8/46,7 puan alıyor—Gemini’nin sırasıyla 48,4/39,8 ve 45,5/39,6 puanlarının oldukça ilerisinde. Bu skorlar, Maverick bağlam uzunluğunu Scout kadar yüksek sesle pazarlamasa da, genişletilmiş penceresinden anlamlı şekilde faydalandığını gösteriyor.
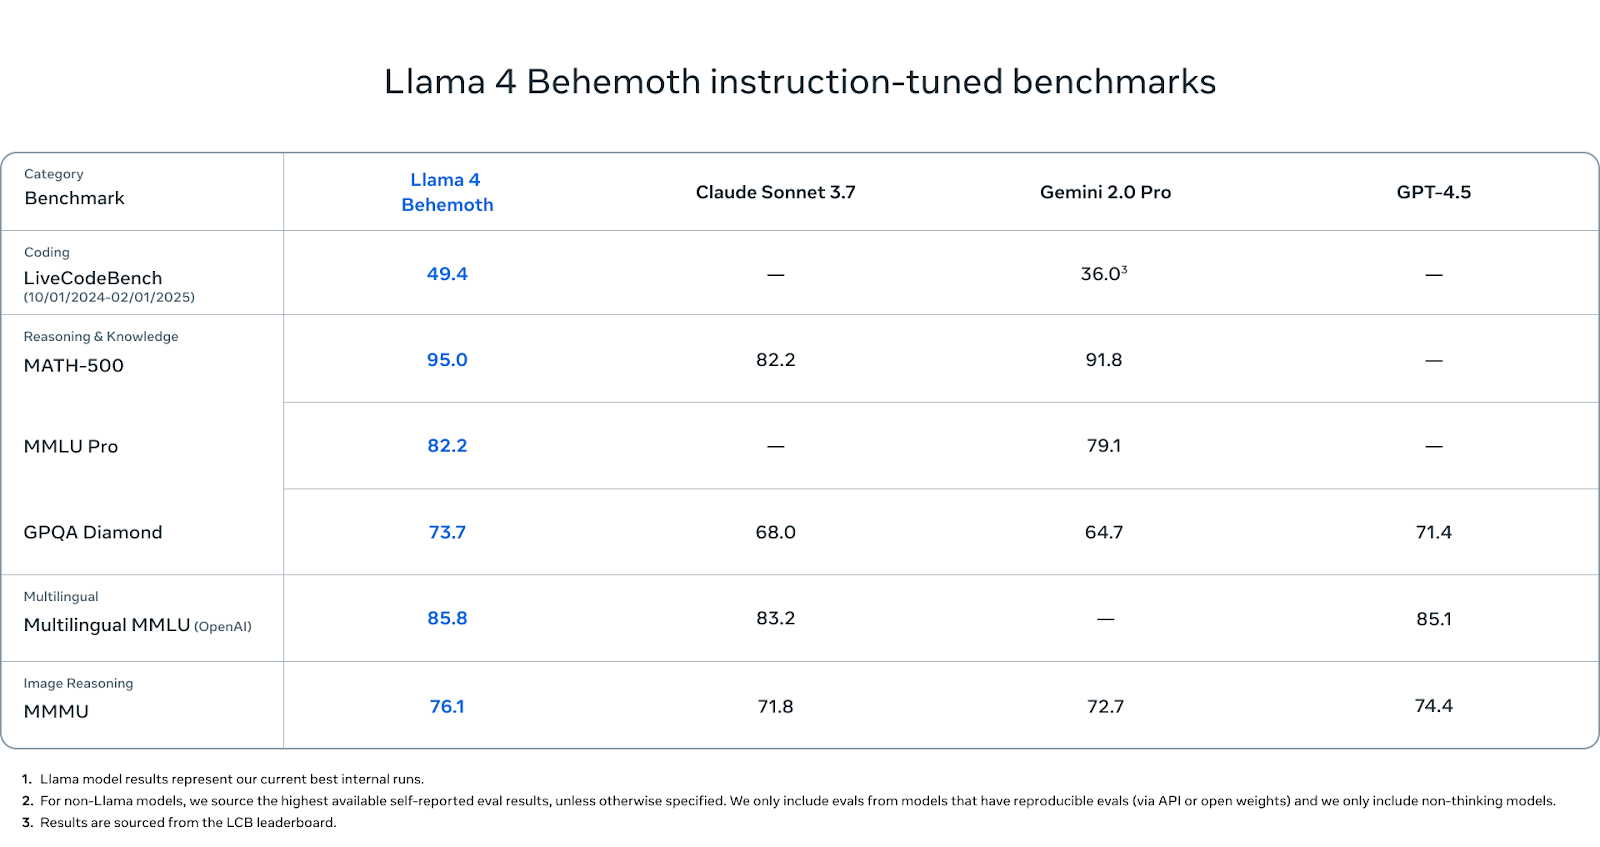
Behemoth henüz yayımlanmadı; ancak kıyaslama rakamları dikkat etmeye değer.
Kaynak: MetaAI
STEM ağırlıklı kıyaslamalarda Behemoth son derece iyi performans gösteriyor. MATH-500’de 95,0 puan alıyor—bu, Gemini 2.0 Pro’nun (91,8) üzerinde ve Claude Sonnet 3.7’nin (82,2) oldukça üzerinde. MMLU Pro’da Behemoth 82,2 puan alırken Gemini Pro 79,1’de kalıyor (Claude için raporlanan skor yok). Ve gerçeklere dayalı derinlik ve hassasiyeti ödüllendiren bir başka kıyas olan GPQA Diamond’da Behemoth 73,7’ye ulaşıyor; Claude (68,0), Gemini (64,7) ve GPT-4.5’i (71,4) geride bırakıyor.
Çok dilli anlamada Behemoth, Çok Dilli MMLU’da 85,8 puan alarak Claude Sonnet’i (83,2) ve GPT-4.5’i (85,1) az farkla geride bırakıyor. Bu skorlar, İngilizce dışındaki dillerde çalışan küresel geliştiriciler için önem taşıyor ve Behemoth bu kategoride şu anda lider.
Görüntü akıl yürütmede Behemoth, MMMU’da 76,1’e ulaşıyor; Gemini (71,8), Claude (72,7) ve GPT-4.5’i (74,4) aşıyor. Bu onun ana odağı olmasa da, önde gelen çok modlu modellerle rekabetçi performans sergiliyor.
Kod üretiminde Behemoth, LiveCodeBench’te 49,4 puan alıyor. Bu, Gemini 2.0 Pro’nun (36,0) oldukça üzerinde.
Hem Llama 4 Scout hem Llama 4 Maverick, Meta’nın açık-ağırlık lisansı altında şu anda mevcut. Resmî Llama web sitesinden veya Hugging Face üzerinden doğrudan indirebilirsiniz.
Modellere Meta’nın kendi hizmetleri üzerinden erişmek için, WhatsApp, Messenger, Instagram ve Facebook’ta Meta AI ile etkileşime geçebilirsiniz. Erişim şu anda bir Meta hesabıyla oturum açmayı gerektiriyor ve Meta AI için bağımsız bir API uç noktası yok—en azından şimdilik.
Modelleri kendi uygulamalarınıza veya altyapınıza entegre etmeyi planlıyorsanız, lisans maddesini aklınızda bulundurun: Ürün veya hizmetiniz aylık 700 milyondan fazla aktif kullanıcıya sahipse, Meta’dan ayrı izin almanız gerekir. Bunun dışında modeller, araştırma, deney yapma ve çoğu ticari kullanım için uygundur.
Scout, tek bir GPU üzerinde eşi görülmemiş bir bağlam uzunluğu sunuyor. Maverick, akıl yürütme, kod ve çok modlu görevlerde daha büyük modellere karşı ayakta kalıyor. Ve hâlen eğitimde olan Behemoth, öğretmen modellerin daha verimli ve dağıtılabilir varyantları nasıl şekillendirebileceğine dair bir fikir veriyor.
Açık-ağırlık alanı her zamankinden daha rekabetçi. DeepSeek, Qwen, Gemma ve yakında OpenAI güçlü sürümlerle ilerliyor. Llama 4, Meta’nın ölçeklenebilir, açıkça erişilebilir modelleri çeşitli kullanım senaryoları için sunma çabasının bir devamı olarak geliyor.
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




