2026 ortasında yapay zekâ dünyası, ham kıyaslama skorlarında yarışan yekpare öncü modellerle dolu. Sakana AI farklı bir iddia ortaya koyuyor: Daha büyük bir temel model eğitmek yerine, mevcut öncü modellerden oluşan bir havuzu tek bir OpenAI uyumlu API arkasında orkestre eden Fugu’yu piyasaya sürdü.
Manşet iddia şu: Sakana Fugu Ultra, ihracat kısıtlamalı bu modellere erişim gerektirmeden, mühendislik, bilimsel ve akıl yürütme kıyaslamalarında Anthropic’in Fable 5 ve Mythos Preview modelleriyle başa baş performans sergiliyor.
Sakana Fugu, 22 Haziran 2026’da iki varyantla piyasaya çıktı: Günlük, gecikmeye duyarlı işler için Fugu ve karmaşık, çok adımlı görevler için Fugu Ultra. SWE-Bench Pro’da Fugu Ultra %73,7 puan alarak Claude Opus 4.8’in (%69,2), GPT-5.5’in (%58,6) ve Gemini 3.1 Pro’nun (%54,2) önüne geçti.
Tüm kıyaslama rakamları Sakana tarafından bildirildi ve henüz üçüncü taraf laboratuvarlarca bağımsız olarak çoğaltılmadı; okurken bunu akılda tutmakta fayda var.
Bu yazıda Fugu’nun gerçekte ne olduğunu, temel özelliklerini, tam kıyaslama tablosunu ve bazı kullanım örneklerini inceleyeceğim. Ayrıca Fugu’nun rekabet ettiği modellere dair bağlam için GPT-5.5 ve Gemini 3.1 Pro karşılaştırmamıza da bakabilirsiniz.
Sakana Fugu nedir?
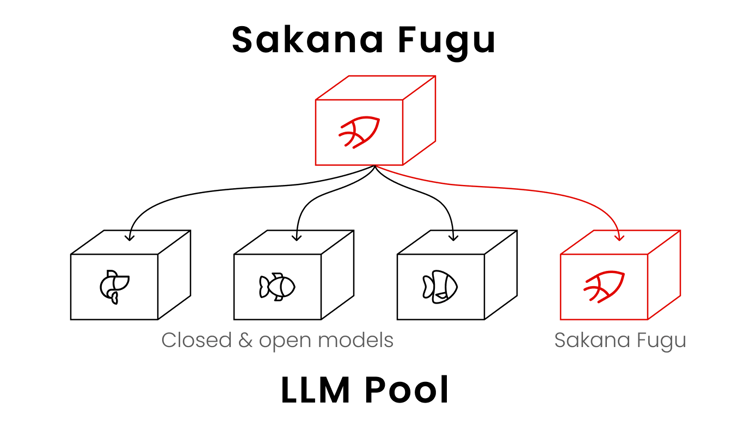
Sakana Fugu, bir orkestratör gibi hareket etmek üzere eğitilmiş bir dil modelidir: Bir isteği alır, onu doğrudan mı işleyeceğine yoksa ajan havuzundaki uzman modellere mi devredeceğine karar verir, doğrulama ve sentezi yönetir ve tek bir yanıt döndürür. Dışarıdan bakıldığında tek bir uç noktayı çağırırsınız. İçeride ise koordineli bir model kümesi işi yapar.
Sakana AI kuruluşundan bu yana bu mimariye doğru ilerliyor. Laboratuvar, ilk “Attention Is All You Need” makalesinin yazarlarından Llion Jones ve David Ha tarafından kuruldu ve uzun süredir koordineli model ekosistemlerinin, zorlu ve uzun soluklu görevlerde izole monolitlerden daha iyi performans gösterdiğini savunuyor.
Fugu, bu tezin ürünleştirilmiş hâli; temeli, iki ICLR 2026 makalesine dayanıyor: TRINITY (evrimleşmiş bir LLM koordinatörü) ve Conductor (ajanları doğal dilde orkestre etmeyi öğrenme).
Bu yazının yazıldığı tarihte Anthropic’in Fable 5 ve Mythos Preview modelleri ihracat kısıtlamaları nedeniyle kamuya açık değil; bu da Fugu’nun ajan havuzuna dahil edilemeyecekleri anlamına geliyor.
Sakana’nın iddiası, değiştirilebilir bir model havuzu üzerinden yönlendirme yapmanın tam da bu tür erişim kesintilerine karşı pratik bir sigorta sunduğu yönünde. Bunun gerçek bir “yapay zekâ egemenliği” oluşturup oluşturmadığı tartışmalı olsa da operasyonel mantık açık: Bir sağlayıcı erişimi kısıtlarsa, Fugu etrafından dolaşır.
Kaynak
Sakana Fugu’da Yeni Olan Ne?
Fugu, hem geleneksel öncü modellerden hem de klasik çoklu ajan çerçevelerinden ayrışan birkaç fikir sunuyor. Önemlilerini aşağıda özetledim.
Sabirlenmiş boru hatları değil, öğrenilmiş orkestrasyon
Çoklu ajan sistemlerinin çoğunda geliştiriciler, hangi görevi hangi modelin üstleneceğini tanımlamak zorundadır. Fugu bunu öğrenir. Orkestratör model; ne zaman delege edileceğine, ajanların nasıl iletişim kuracağına ve çıktılarının tek bir yanıtta nasıl birleştirileceğine karar verecek şekilde eğitilir. Bu, yukarıda bağlantısını verdiğim TRINITY ve Conductor araştırmalarının temel katkısıdır.
Pratikte bu, çoklu ajan sisteminin karmaşıklığının kodunuza hiç yansımadığı anlamına gelir. Tek bir uç noktaya istek gönderirsiniz; Fugu model seçimi, delege etme, doğrulama ve sentezi içeride halleder. Kendi orkestrasyon katmanını kurmayı denemiş ekipler için cazibe açık: harness’ı bakımını üstlenmeden koordinasyon kazanımları elde edersiniz.
Belirtmeye değer bir uyarı: Yönlendirme kararları tescillidir ve kullanıcılara açılmaz. Belirli bir isteği hangi temel modelin işlediğini göremezsiniz. Gerekçelendirme zincirini denetlemeniz gereken uyumluluk hassas işlerde bu kapalılık gerçek bir sınırlamadır.
Değiştirilebilir ajan havuzu
Fugu’nun havuzundaki modeller sabit değildir. Yeni bir öncü model kamuya açıldığında, Sakana’nın güncellenmiş Fugu modellerini yayınlamadan önce eğitme ve değerlendirme için yaklaşık iki haftaya ihtiyaç duyacağı öngörülüyor. Bu, kullanıcıların entegrasyonlarını değiştirmesine gerek kalmadan, Fugu’nun performansının temel ekosistem geliştikçe iyileşeceği anlamına gelir.
Standart Fugu modelinde kullanıcılar, konsol ayarlarından belirli ajanları havuzdan hariç tutmayı da seçebilir; bu, veri gizliliği veya uyumluluk gereksinimleri olan ekipler için önemlidir. Fugu Ultra’nın havuzu ise sabittir; çünkü kıyaslama performansını sunmak için tam ajan setine dayanır.
İki katmanlı model tasarımı
Fugu ve Fugu Ultra farklı iş yüklerine hizmet eder. Fugu, düşük gecikmeyle kaliteyi dengeler; kodlama, kod incelemesi ve etkileşimli hizmetler için makul bir varsayılandır. Fugu Ultra ise daha derin bir uzman ajan havuzunu koordine eder ve zor, çok adımlı problemler için en yüksek yanıt kalitesine göre ayarlanmıştır.
Erken kullanıcılar, makale yeniden üretimi, siber güvenlik analizi, Kaggle tarzı veri bilimi ve patent araştırmaları gibi görevlerde Fugu Ultra’yı tercih etti.
Betadaki bir yazılım mühendisi, Fugu Ultra’nın yirmiden fazla kod inceleme sorununu ortaya çıkardığını; diğer araçların ise yaklaşık üç tane işaretlediğini bildirdi.
Bir siber güvenlik mühendisi, tek bir kapsamlı talimatın kanıt ve yeniden test adımları içeren temiz bir raporla birlikte uçtan uca tam bir güvenlik değerlendirmesini tetiklediğini aktardı.
Burada gecikme ödünleşiminin gerçek olduğunu not etmekte fayda var. Çoklu ajan yönlendirme ve sentez ek yük getirir. Basit sorgular veya sıkı gecikme gereksinimleri için, tek bir öncü modele doğrudan çağrı muhtemelen daha hızlı ve daha ucuz olacaktır.
OpenAI uyumlu API
Hem Fugu hem de Fugu Ultra tek bir OpenAI uyumlu API üzerinden erişilebilir. SDK geçişi gerekmez.
Mevcut istemcinizi API anahtarınızla Fugu uç noktasına yönlendirir ve istek göndermeye başlarsınız. Bu, OpenAI istemci kitaplığı aracılığıyla GPT-5.5 veya Claude Opus 4.8 kullanan ekiplerin geçiş maliyetini düşürmek için kasıtlı bir tercihtir.
Sakana Fugu Kıyaslamaları
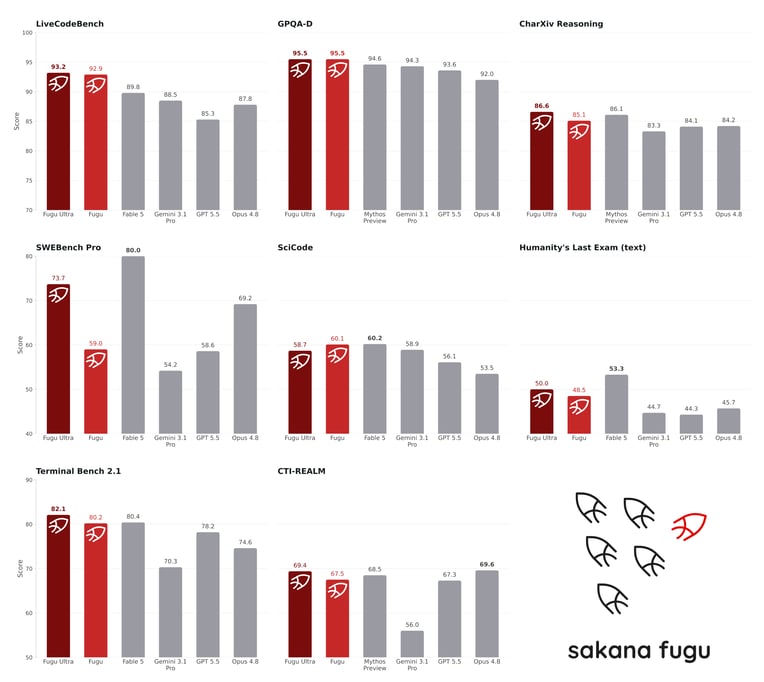
Sakana’nın karşılaştırma tablosuna göre Fugu Ultra, 11 kıyaslamanın 10’unda zirvede; GPT-5.5 yalnızca MRCRv2’de birinci. Fugu dışındaki tüm skorlar sağlayıcıların bildirimlerine dayanıyor. Fable 5 ve Mythos Preview, kamuya açık olmadıkları ve bu nedenle Fugu’nun ajan havuzunda yer alamadıkları için karşılaştırmadan hariç tutuldu.
Bu rakamların bağımsız tekrarları, yazı zamanında gördüğüm kadarıyla henüz üçüncü taraf liderlik tablolarında yer almadı.
| Kıyaslama | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
SWE-Bench Pro
Fugu Ultra, SWE-Bench Pro’da %73,7 puan alıyor; Claude Opus 4.8 %69,2, GPT-5.5 %58,6 ve Gemini 3.1 Pro %54,2’de kalıyor. GPT-5.5 kapsamımızda, bu kıyaslamada %58,6 puan aldığını not etmiştik; Fugu Ultra bu eşiği 15 puanla geçiyor.
SWE-Bench Pro, bir modelin yazılım depolarındaki gerçek GitHub sorunlarını çözüp çözemedğini sınar; bu da onu pratik temele en çok oturan kodlama kıyaslamalarından biri yapar. Fugu Ultra ile bir sonraki en iyi kamuya açık model arasındaki fark, ciddi kod inceleme veya hata düzeltme yapan ekipler için önem arz edecek kadar büyük.
LiveCodeBench ve LiveCodeBench Pro
Fugu Ultra, LiveCodeBench’te %93,2 ve LiveCodeBench Pro’da %90,8 puan alıyor. Sıradaki en iyi skorlar, standart sürümde Gemini 3.1 Pro’da %88,5 ve Claude Opus 4.8’de %87,8.
LiveCodeBench, yakın tarihli yarışmalardan alınan rekabetçi programlama problemlerini sınar; bu da eğitim verisi bulaşma riskinin daha eski kodlama kıyaslamalarına göre daha düşük olduğu anlamına gelir. Pro varyantı daha zor problemler kullanır. Fugu’nun buradaki üstünlüğü, güçlü kod inceleme performansına dair beta raporlarıyla tutarlıdır.
Humanity's Last Exam
Fugu Ultra, Humanity’s Last Exam’de %50,0 puan alırken; Claude Opus 4.8 %49,8, Gemini 3.1 Pro %44,4 ve GPT-5.5 %41,4’te kalıyor.
Bu kıyaslama, bilimsel ve akademik alanlarda uzman düzeyinde bilgiyi sınar; sorular, alan uzmanları için bile zor olacak şekilde tasarlanır. GPT-5.5’in %41,4’te olduğu düşünüldüğünde %50’lik bir skor kayda değerdir. Fugu Ultra ile GPT-5.5 arasındaki fark, tabloda en büyük olanıdır.
GPQA Diamond
Hem Fugu hem de Fugu Ultra, GPQA Diamond’da %95,5 puan alıyor; Gemini 3.1 Pro %94,3, GPT-5.5 %93,6 ve Claude Opus 4.8 %92,0’da.
GPQA Diamond, biyoloji, kimya ve fizikte doktora seviyesinde bilim sorularını sınar; alan uzmanları tarafından yazılır ve uzman olmayanlar için zor olduğu doğrulanır. Standart Fugu’nun burada Fugu Ultra ile aynı performansı göstermesi, bu kıyaslamada orkestrasyon ek yükünün fazla bir katkısı olmadığını düşündürür; çok adımlı planlama gerektirmeyen soru-cevap görevlerinde bu mantıklıdır.
TerminalBench 2.1
Fugu Ultra, TerminalBench 2.1’de %82,1 puan ile GPT-5.5’i (%78,2), Claude Opus 4.8’i (%74,6) ve Gemini 3.1 Pro’yu (%70,3) geride bırakıyor. TerminalBench, dosya işlemleri, kabuk komutları ve çok adımlı yürütme dahil, terminal ortamıyla etkileşim gerektiren ajan temelli kodlama görevlerini sınar.
Bu, gerçek geliştirici iş akışlarıyla en çok örtüşen kıyaslamalardan biridir ve Fugu Ultra’nın burada GPT-5.5’e karşı üstünlüğü, betada bildirilen siber güvenlik değerlendirmesi kullanım örneğiyle tutarlıdır.
MRCRv2
GPT-5.5, %94,8 ile MRCRv2’yi kazanıyor; Fugu Ultra %93,6 ve Claude Opus 4.8 %87,9’da. MRCRv2, uzun bağlamlı anımsamayı sınar; özellikle, bir modelin çok uzun belgelerden belirli bilgiyi geri çağırıp çağıramadığını ölçer.
Bu, Fugu Ultra’nın lider olmadığı tek kıyaslama; çok adımlı akıl yürütme veya kod üretimi yerine büyük belgelerden belirli olguları çekmeyi birincil kullanım durumu yapan ekipler için not edilmeye değerdir.
Kaynak
Sakana Fugu Fiyatlandırma ve Erişilebilirlik
Fugu, Sakana’nın konsolundan console.sakana.ai adresi üzerinden, OpenAI uyumlu bir API ile şu anda kullanılabilir. Tüm planlarda hem Fugu hem de Fugu Ultra dahildir. Abonelik kademeleri şunlardır:
- Standard: Aylık 20 ABD doları, temel kullanım; ara sıra API çağrıları ve kişisel denemeler için uygundur
- Pro: Aylık 100 ABD doları, Standard kullanımın 10 katı; düzenli kodlama ve araştırma seansları için uygundur
- Max: Aylık 200 ABD doları, Standard kullanımın 30 katı; ağır ve uzun süreli iş yükleri için uygundur
Kullandıkça öde planı, aylık kota yerine belirteç kullanımına göre faturalandırır. Fugu Ultra (model kimliği: fugu-ultra-20260615) için, standart bağlam uzunluklarında fiyatlandırma milyon başına 5 ABD doları giriş belirteci ve milyon başına 30 ABD doları çıkış belirtecidir.
272B belirtecin üzerindeki bağlamlarda, oranlar giriş için 10 ABD dolarına ve çıkış için 45 ABD dolarına yükselir. Önbelleğe alınmış giriş milyon belirteç başına 0,50 ABD dolarıdır; 272B üzerinde 1,00 ABD dolarıdır. Fugu’nun standart fiyatlandırması, etkin olan temel modelin oranıyla eşleşir ve Sakana, birden fazla ajan çalıştığında ücretleri üst üste bindirmez.
Dikkate değer bölgesel bir sınırlama: Sakana, GDPR uyumluluğu üzerinde çalışırken Fugu, şu anda AB veya AEA üye devletlerinde kullanılamamaktadır. Avrupa ekipleri için bu şimdilik bir engeldir. Sakana, AB’de kullanılabilirlik için bir zaman çizelgesi yayımlamadı.
Son Düşünceler
Fugu, OpenAI, Anthropic ve Google’ın yaptıklarından gerçekten farklı bir iddia. Temel model ölçeğinde rekabet etmek yerine Sakana, değiştirilebilir bir öncü model havuzu üzerinde öğrenilmiş orkestrasyonun, gerçekten zaman alan görevlerde herhangi bir bireysel sistemi yakalayabileceğini veya geçebileceğini savunuyor: uzun kod incelemeleri, çok adımlı araştırma, güvenlik değerlendirmeleri ve makale yeniden üretimi.
Kıyaslama rakamları, bağımsız doğrulamaya dayanabilirse, geliştiriciler için önemli metriklerin çoğunda bu savı destekliyor. Elbette, Fable 5 ve Mythos’a yeniden erişim sağlayana kadar onlarla doğrudan kıyaslama yapamayız.
Öte yandan, bazı çekinceler kesinlikle var.
Tüm kıyaslama puanları Sakana tarafından bildirildi. Yönlendirme katmanı opaktır; bu da uyumluluk hassas işler için sürtünme yaratır. AB/AEA hariç tutulması, küresel geliştirici topluluğunun önemli bir kısmı için benimsemeyi sınırlar. Ve basit görevlerde gecikme ödünleşimi gerçektir: Hızlı, tek turlu API çağrıları yapıyorsanız, Fugu Ultra’nın orkestrasyon ek yükü fayda sağlamadan saf maliyettir.
Fugu’nun gerçek bir katkı yaptığı yerin, uzun ufuklu ajan temelli iş akışları yürüten ve hâlihazırda çoklu model kurulumlarının karmaşıklığını kendileri yöneten ekipler olduğunu düşünüyorum. Claude ve GPT’nin üzerine kendi orkestrasyon harness’ınızı bakımını yapıyorsanız, Fugu Ultra ciddi bir değerlendirmeyi hak ediyor.
Egemenlik çerçevesi muhtemelen abartılıyor, ancak sağlayıcı kesintilerini etrafından dolaşan tek bir uç noktanın pratik değeri yadsınamaz.
Fugu’nun faaliyet gösterdiği ajan temelli yapay zekâ manzarasına hızlıca hâkim olmak istiyorsanız, DataCamp’teki AI Agent Fundamentals beceri yoluyla başlamanızı öneririm; bu yol büyük dil modellerinin, ajanların ve çoklu model sistemlerinin temellerini kapsar.







2026 ortasında yapay zekâ dünyası, ham kıyaslama skorlarında yarışan yekpare öncü modellerle dolu. Sakana AI farklı bir iddia ortaya koyuyor: Daha büyük bir temel model eğitmek yerine, mevcut öncü modellerden oluşan bir havuzu tek bir OpenAI uyumlu API arkasında orkestre eden Fugu’yu piyasaya sürdü.
Manşet iddia şu: Sakana Fugu Ultra, ihracat kısıtlamalı bu modellere erişim gerektirmeden, mühendislik, bilimsel ve akıl yürütme kıyaslamalarında Anthropic’in Fable 5 ve Mythos Preview modelleriyle başa baş performans sergiliyor.
Sakana Fugu, 22 Haziran 2026’da iki varyantla piyasaya çıktı: Günlük, gecikmeye duyarlı işler için Fugu ve karmaşık, çok adımlı görevler için Fugu Ultra. SWE-Bench Pro’da Fugu Ultra %73,7 puan alarak Claude Opus 4.8’in (%69,2), GPT-5.5’in (%58,6) ve Gemini 3.1 Pro’nun (%54,2) önüne geçti.
Tüm kıyaslama rakamları Sakana tarafından bildirildi ve henüz üçüncü taraf laboratuvarlarca bağımsız olarak çoğaltılmadı; okurken bunu akılda tutmakta fayda var.
Bu yazıda Fugu’nun gerçekte ne olduğunu, temel özelliklerini, tam kıyaslama tablosunu ve bazı kullanım örneklerini inceleyeceğim. Ayrıca Fugu’nun rekabet ettiği modellere dair bağlam için GPT-5.5 ve Gemini 3.1 Pro karşılaştırmamıza da bakabilirsiniz.
Sakana Fugu nedir?
Sakana Fugu, bir orkestratör gibi hareket etmek üzere eğitilmiş bir dil modelidir: Bir isteği alır, onu doğrudan mı işleyeceğine yoksa ajan havuzundaki uzman modellere mi devredeceğine karar verir, doğrulama ve sentezi yönetir ve tek bir yanıt döndürür. Dışarıdan bakıldığında tek bir uç noktayı çağırırsınız. İçeride ise koordineli bir model kümesi işi yapar.
Sakana AI kuruluşundan bu yana bu mimariye doğru ilerliyor. Laboratuvar, ilk “Attention Is All You Need” makalesinin yazarlarından Llion Jones ve David Ha tarafından kuruldu ve uzun süredir koordineli model ekosistemlerinin, zorlu ve uzun soluklu görevlerde izole monolitlerden daha iyi performans gösterdiğini savunuyor.
Fugu, bu tezin ürünleştirilmiş hâli; temeli, iki ICLR 2026 makalesine dayanıyor: TRINITY (evrimleşmiş bir LLM koordinatörü) ve Conductor (ajanları doğal dilde orkestre etmeyi öğrenme).
Bu yazının yazıldığı tarihte Anthropic’in Fable 5 ve Mythos Preview modelleri ihracat kısıtlamaları nedeniyle kamuya açık değil; bu da Fugu’nun ajan havuzuna dahil edilemeyecekleri anlamına geliyor.
Sakana’nın iddiası, değiştirilebilir bir model havuzu üzerinden yönlendirme yapmanın tam da bu tür erişim kesintilerine karşı pratik bir sigorta sunduğu yönünde. Bunun gerçek bir “yapay zekâ egemenliği” oluşturup oluşturmadığı tartışmalı olsa da operasyonel mantık açık: Bir sağlayıcı erişimi kısıtlarsa, Fugu etrafından dolaşır.
Kaynak
Sakana Fugu’da Yeni Olan Ne?
Fugu, hem geleneksel öncü modellerden hem de klasik çoklu ajan çerçevelerinden ayrışan birkaç fikir sunuyor. Önemlilerini aşağıda özetledim.
Sabirlenmiş boru hatları değil, öğrenilmiş orkestrasyon
Çoklu ajan sistemlerinin çoğunda geliştiriciler, hangi görevi hangi modelin üstleneceğini tanımlamak zorundadır. Fugu bunu öğrenir. Orkestratör model; ne zaman delege edileceğine, ajanların nasıl iletişim kuracağına ve çıktılarının tek bir yanıtta nasıl birleştirileceğine karar verecek şekilde eğitilir. Bu, yukarıda bağlantısını verdiğim TRINITY ve Conductor araştırmalarının temel katkısıdır.
Pratikte bu, çoklu ajan sisteminin karmaşıklığının kodunuza hiç yansımadığı anlamına gelir. Tek bir uç noktaya istek gönderirsiniz; Fugu model seçimi, delege etme, doğrulama ve sentezi içeride halleder. Kendi orkestrasyon katmanını kurmayı denemiş ekipler için cazibe açık: harness’ı bakımını üstlenmeden koordinasyon kazanımları elde edersiniz.
Belirtmeye değer bir uyarı: Yönlendirme kararları tescillidir ve kullanıcılara açılmaz. Belirli bir isteği hangi temel modelin işlediğini göremezsiniz. Gerekçelendirme zincirini denetlemeniz gereken uyumluluk hassas işlerde bu kapalılık gerçek bir sınırlamadır.
Değiştirilebilir ajan havuzu
Fugu’nun havuzundaki modeller sabit değildir. Yeni bir öncü model kamuya açıldığında, Sakana’nın güncellenmiş Fugu modellerini yayınlamadan önce eğitme ve değerlendirme için yaklaşık iki haftaya ihtiyaç duyacağı öngörülüyor. Bu, kullanıcıların entegrasyonlarını değiştirmesine gerek kalmadan, Fugu’nun performansının temel ekosistem geliştikçe iyileşeceği anlamına gelir.
Standart Fugu modelinde kullanıcılar, konsol ayarlarından belirli ajanları havuzdan hariç tutmayı da seçebilir; bu, veri gizliliği veya uyumluluk gereksinimleri olan ekipler için önemlidir. Fugu Ultra’nın havuzu ise sabittir; çünkü kıyaslama performansını sunmak için tam ajan setine dayanır.
İki katmanlı model tasarımı
Fugu ve Fugu Ultra farklı iş yüklerine hizmet eder. Fugu, düşük gecikmeyle kaliteyi dengeler; kodlama, kod incelemesi ve etkileşimli hizmetler için makul bir varsayılandır. Fugu Ultra ise daha derin bir uzman ajan havuzunu koordine eder ve zor, çok adımlı problemler için en yüksek yanıt kalitesine göre ayarlanmıştır.
Erken kullanıcılar, makale yeniden üretimi, siber güvenlik analizi, Kaggle tarzı veri bilimi ve patent araştırmaları gibi görevlerde Fugu Ultra’yı tercih etti.
Betadaki bir yazılım mühendisi, Fugu Ultra’nın yirmiden fazla kod inceleme sorununu ortaya çıkardığını; diğer araçların ise yaklaşık üç tane işaretlediğini bildirdi.
Bir siber güvenlik mühendisi, tek bir kapsamlı talimatın kanıt ve yeniden test adımları içeren temiz bir raporla birlikte uçtan uca tam bir güvenlik değerlendirmesini tetiklediğini aktardı.
Burada gecikme ödünleşiminin gerçek olduğunu not etmekte fayda var. Çoklu ajan yönlendirme ve sentez ek yük getirir. Basit sorgular veya sıkı gecikme gereksinimleri için, tek bir öncü modele doğrudan çağrı muhtemelen daha hızlı ve daha ucuz olacaktır.
OpenAI uyumlu API
Hem Fugu hem de Fugu Ultra tek bir OpenAI uyumlu API üzerinden erişilebilir. SDK geçişi gerekmez.
Mevcut istemcinizi API anahtarınızla Fugu uç noktasına yönlendirir ve istek göndermeye başlarsınız. Bu, OpenAI istemci kitaplığı aracılığıyla GPT-5.5 veya Claude Opus 4.8 kullanan ekiplerin geçiş maliyetini düşürmek için kasıtlı bir tercihtir.
Sakana Fugu Kıyaslamaları
Sakana’nın karşılaştırma tablosuna göre Fugu Ultra, 11 kıyaslamanın 10’unda zirvede; GPT-5.5 yalnızca MRCRv2’de birinci. Fugu dışındaki tüm skorlar sağlayıcıların bildirimlerine dayanıyor. Fable 5 ve Mythos Preview, kamuya açık olmadıkları ve bu nedenle Fugu’nun ajan havuzunda yer alamadıkları için karşılaştırmadan hariç tutuldu.
Bu rakamların bağımsız tekrarları, yazı zamanında gördüğüm kadarıyla henüz üçüncü taraf liderlik tablolarında yer almadı.
SWE-Bench Pro
Fugu Ultra, SWE-Bench Pro’da %73,7 puan alıyor; Claude Opus 4.8 %69,2, GPT-5.5 %58,6 ve Gemini 3.1 Pro %54,2’de kalıyor. GPT-5.5 kapsamımızda, bu kıyaslamada %58,6 puan aldığını not etmiştik; Fugu Ultra bu eşiği 15 puanla geçiyor.
SWE-Bench Pro, bir modelin yazılım depolarındaki gerçek GitHub sorunlarını çözüp çözemedğini sınar; bu da onu pratik temele en çok oturan kodlama kıyaslamalarından biri yapar. Fugu Ultra ile bir sonraki en iyi kamuya açık model arasındaki fark, ciddi kod inceleme veya hata düzeltme yapan ekipler için önem arz edecek kadar büyük.
LiveCodeBench ve LiveCodeBench Pro
Fugu Ultra, LiveCodeBench’te %93,2 ve LiveCodeBench Pro’da %90,8 puan alıyor. Sıradaki en iyi skorlar, standart sürümde Gemini 3.1 Pro’da %88,5 ve Claude Opus 4.8’de %87,8.
LiveCodeBench, yakın tarihli yarışmalardan alınan rekabetçi programlama problemlerini sınar; bu da eğitim verisi bulaşma riskinin daha eski kodlama kıyaslamalarına göre daha düşük olduğu anlamına gelir. Pro varyantı daha zor problemler kullanır. Fugu’nun buradaki üstünlüğü, güçlü kod inceleme performansına dair beta raporlarıyla tutarlıdır.
Humanity's Last Exam
Fugu Ultra, Humanity’s Last Exam’de %50,0 puan alırken; Claude Opus 4.8 %49,8, Gemini 3.1 Pro %44,4 ve GPT-5.5 %41,4’te kalıyor.
Bu kıyaslama, bilimsel ve akademik alanlarda uzman düzeyinde bilgiyi sınar; sorular, alan uzmanları için bile zor olacak şekilde tasarlanır. GPT-5.5’in %41,4’te olduğu düşünüldüğünde %50’lik bir skor kayda değerdir. Fugu Ultra ile GPT-5.5 arasındaki fark, tabloda en büyük olanıdır.
GPQA Diamond
Hem Fugu hem de Fugu Ultra, GPQA Diamond’da %95,5 puan alıyor; Gemini 3.1 Pro %94,3, GPT-5.5 %93,6 ve Claude Opus 4.8 %92,0’da.
GPQA Diamond, biyoloji, kimya ve fizikte doktora seviyesinde bilim sorularını sınar; alan uzmanları tarafından yazılır ve uzman olmayanlar için zor olduğu doğrulanır. Standart Fugu’nun burada Fugu Ultra ile aynı performansı göstermesi, bu kıyaslamada orkestrasyon ek yükünün fazla bir katkısı olmadığını düşündürür; çok adımlı planlama gerektirmeyen soru-cevap görevlerinde bu mantıklıdır.
TerminalBench 2.1
Fugu Ultra, TerminalBench 2.1’de %82,1 puan ile GPT-5.5’i (%78,2), Claude Opus 4.8’i (%74,6) ve Gemini 3.1 Pro’yu (%70,3) geride bırakıyor. TerminalBench, dosya işlemleri, kabuk komutları ve çok adımlı yürütme dahil, terminal ortamıyla etkileşim gerektiren ajan temelli kodlama görevlerini sınar.
Bu, gerçek geliştirici iş akışlarıyla en çok örtüşen kıyaslamalardan biridir ve Fugu Ultra’nın burada GPT-5.5’e karşı üstünlüğü, betada bildirilen siber güvenlik değerlendirmesi kullanım örneğiyle tutarlıdır.
MRCRv2
GPT-5.5, %94,8 ile MRCRv2’yi kazanıyor; Fugu Ultra %93,6 ve Claude Opus 4.8 %87,9’da. MRCRv2, uzun bağlamlı anımsamayı sınar; özellikle, bir modelin çok uzun belgelerden belirli bilgiyi geri çağırıp çağıramadığını ölçer.
Bu, Fugu Ultra’nın lider olmadığı tek kıyaslama; çok adımlı akıl yürütme veya kod üretimi yerine büyük belgelerden belirli olguları çekmeyi birincil kullanım durumu yapan ekipler için not edilmeye değerdir.
Kaynak
Sakana Fugu Fiyatlandırma ve Erişilebilirlik
Fugu, Sakana’nın konsolundan console.sakana.ai adresi üzerinden, OpenAI uyumlu bir API ile şu anda kullanılabilir. Tüm planlarda hem Fugu hem de Fugu Ultra dahildir. Abonelik kademeleri şunlardır:
Kullandıkça öde planı, aylık kota yerine belirteç kullanımına göre faturalandırır. Fugu Ultra (model kimliği: fugu-ultra-20260615) için, standart bağlam uzunluklarında fiyatlandırma milyon başına 5 ABD doları giriş belirteci ve milyon başına 30 ABD doları çıkış belirtecidir.
272B belirtecin üzerindeki bağlamlarda, oranlar giriş için 10 ABD dolarına ve çıkış için 45 ABD dolarına yükselir. Önbelleğe alınmış giriş milyon belirteç başına 0,50 ABD dolarıdır; 272B üzerinde 1,00 ABD dolarıdır. Fugu’nun standart fiyatlandırması, etkin olan temel modelin oranıyla eşleşir ve Sakana, birden fazla ajan çalıştığında ücretleri üst üste bindirmez.
Dikkate değer bölgesel bir sınırlama: Sakana, GDPR uyumluluğu üzerinde çalışırken Fugu, şu anda AB veya AEA üye devletlerinde kullanılamamaktadır. Avrupa ekipleri için bu şimdilik bir engeldir. Sakana, AB’de kullanılabilirlik için bir zaman çizelgesi yayımlamadı.
Son Düşünceler
Fugu, OpenAI, Anthropic ve Google’ın yaptıklarından gerçekten farklı bir iddia. Temel model ölçeğinde rekabet etmek yerine Sakana, değiştirilebilir bir öncü model havuzu üzerinde öğrenilmiş orkestrasyonun, gerçekten zaman alan görevlerde herhangi bir bireysel sistemi yakalayabileceğini veya geçebileceğini savunuyor: uzun kod incelemeleri, çok adımlı araştırma, güvenlik değerlendirmeleri ve makale yeniden üretimi.
Kıyaslama rakamları, bağımsız doğrulamaya dayanabilirse, geliştiriciler için önemli metriklerin çoğunda bu savı destekliyor. Elbette, Fable 5 ve Mythos’a yeniden erişim sağlayana kadar onlarla doğrudan kıyaslama yapamayız.
Öte yandan, bazı çekinceler kesinlikle var.
Tüm kıyaslama puanları Sakana tarafından bildirildi. Yönlendirme katmanı opaktır; bu da uyumluluk hassas işler için sürtünme yaratır. AB/AEA hariç tutulması, küresel geliştirici topluluğunun önemli bir kısmı için benimsemeyi sınırlar. Ve basit görevlerde gecikme ödünleşimi gerçektir: Hızlı, tek turlu API çağrıları yapıyorsanız, Fugu Ultra’nın orkestrasyon ek yükü fayda sağlamadan saf maliyettir.
Fugu’nun gerçek bir katkı yaptığı yerin, uzun ufuklu ajan temelli iş akışları yürüten ve hâlihazırda çoklu model kurulumlarının karmaşıklığını kendileri yöneten ekipler olduğunu düşünüyorum. Claude ve GPT’nin üzerine kendi orkestrasyon harness’ınızı bakımını yapıyorsanız, Fugu Ultra ciddi bir değerlendirmeyi hak ediyor.
Egemenlik çerçevesi muhtemelen abartılıyor, ancak sağlayıcı kesintilerini etrafından dolaşan tek bir uç noktanın pratik değeri yadsınamaz.
Fugu’nun faaliyet gösterdiği ajan temelli yapay zekâ manzarasına hızlıca hâkim olmak istiyorsanız, DataCamp’teki AI Agent Fundamentals beceri yoluyla başlamanızı öneririm; bu yol büyük dil modellerinin, ajanların ve çoklu model sistemlerinin temellerini kapsar.