Kurs
Google: Agent Fundamentals
1 Std.
750
Das KI-Feld ist Mitte 2026 voll von monolithischen Spitzenmodellen, die um rohe Benchmark-Scores konkurrieren. Sakana AI setzt auf etwas anderes: Statt ein noch größeres Basismodell zu trainieren, hat das Unternehmen Fugu vorgestellt – ein System, das einen Pool bestehender Spitzenmodelle über eine einzige, OpenAI-kompatible API orchestriert.
Die Kernbotschaft: Sakana Fugu Ultra erreicht auf Engineering-, Wissenschafts- und Reasoning-Benchmarks das Niveau von Anthropics Fable 5 und Mythos Preview – ohne Zugang zu diesen exportkontrollierten Modellen zu benötigen.
Sakana Fugu startete am 22. Juni 2026 in zwei Varianten: Fugu für alltägliche, latenzkritische Aufgaben und Fugu Ultra für komplexe, mehrstufige Aufgaben. Auf SWE-Bench Pro erzielt Fugu Ultra 73,7% und liegt damit vor Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%) und Gemini 3.1 Pro (54,2%).
Alle Benchmark-Zahlen stammen von Sakana und wurden bislang nicht unabhängig von Drittanbieter-Labs reproduziert – das solltest du beim Lesen im Hinterkopf behalten.
In diesem Artikel erkläre ich, was Fugu eigentlich ist, führe durch die wichtigsten Features, zeige die komplette Benchmark-Tabelle und nenne einige Anwendungsfälle. Außerdem findest du unseren Vergleich GPT-5.5 vs Gemini 3.1 Pro zur Einordnung der Modelle, gegen die Fugu antritt.
Sakana Fugu ist ein Sprachmodell, das als Orchestrator trainiert wurde: Es nimmt Anfragen entgegen, entscheidet, ob es sie selbst beantwortet oder an Spezialisten im Agentenpool delegiert, steuert Verifikation und Synthese und liefert eine konsolidierte Antwort zurück. Von außen rufst du einen Endpoint auf. Innen erledigt ein koordiniertes Set von Modellen die Arbeit.
Sakana AI baut seit der Gründung auf diese Architektur hin. Das Lab, gestartet von Llion Jones (Mitautor von "Attention Is All You Need") und David Ha, argumentiert seit Langem, dass koordinierte Modell-Ökosysteme isolierte Monolithen bei schwierigen, lang laufenden Aufgaben übertreffen.
Fugu ist die Produktumsetzung dieser These, untermauert durch zwei ICLR-2026-Paper: TRINITY (ein weiterentwickelter LLM-Koordinator) und Conductor (Orchestrierung von Agenten in natürlicher Sprache lernen).
Zum Zeitpunkt des Schreibens sind Anthropics Fable 5 und Mythos Preview aufgrund von Exportkontrollen nicht öffentlich zugänglich, weshalb sie nicht in Fugus Agentenpool enthalten sein können.
Sakanas Argument: Das Routing über einen austauschbaren Pool von Modellen ist eine pragmatische Absicherung genau gegen diese Art von Zugriffsstörungen. Ob das echte "KI-Souveränität" ist, kann man diskutieren, aber operativ ist die Logik stimmig: Wenn ein Anbieter den Zugang einschränkt, routet Fugu darum herum.
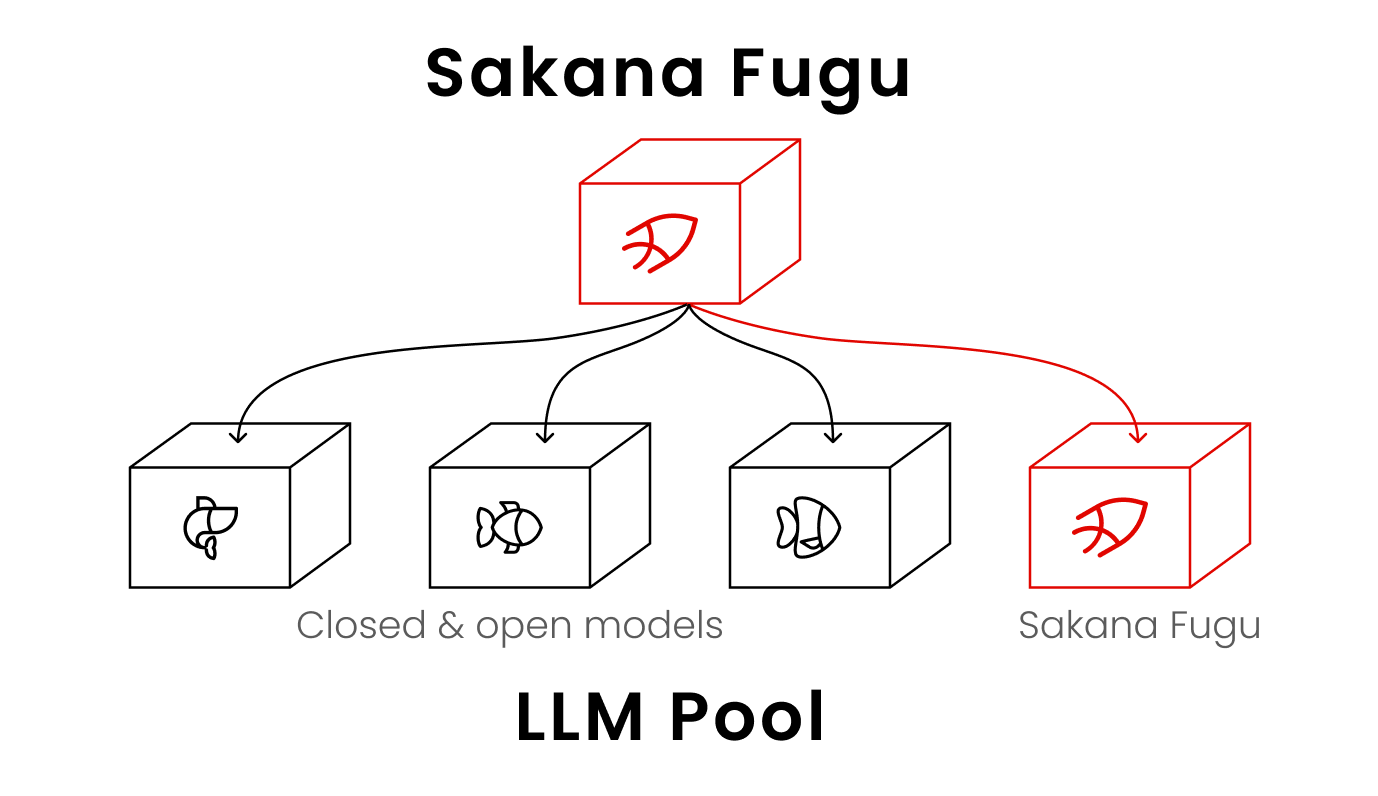
Fugu bringt mehrere Ideen mit, die es sowohl von klassischen Spitzenmodellen als auch von traditionellen Multi-Agent-Frameworks abheben. Die wichtigsten Punkte habe ich unten zusammengefasst.
Die meisten Multi-Agent-Systeme verlangen von Entwicklerinnen und Entwicklern, festzulegen, welches Modell welche Aufgabe übernimmt. Fugu lernt das. Das Orchestrator-Modell entscheidet, wann delegiert wird, wie Agenten kommunizieren und wie ihre Outputs zu einer Antwort zusammengeführt werden. Das ist der Kernbeitrag aus den oben verlinkten TRINITY- und Conductor-Studien.
In der Praxis bedeutet das: Die Komplexität eines Multi-Agent-Systems landet nie in deinem Code. Du sendest eine Anfrage an einen Endpoint, und Fugu übernimmt Modellwahl, Delegation, Verifikation und Synthese intern. Für Teams, die versucht haben, ihre eigene Orchestrierung zu bauen, ist der Reiz klar: Du bekommst die Koordinationsvorteile ohne den Aufwand für das Harness.
Ein Hinweis mit Blick auf Compliance: Die Routing-Entscheidungen sind proprietär und werden nicht offengelegt. Du kannst nicht sehen, welches zugrunde liegende Modell eine Anfrage bearbeitet hat. Für prüfpflichtige Workflows, in denen die Reasoning-Kette auditierbar sein muss, ist diese Intransparenz eine echte Einschränkung.
Die Modelle in Fugus Pool sind nicht fix. Sobald ein neues Spitzenmodell öffentlich verfügbar ist, plant Sakana etwa zwei Wochen für Training und Evaluierung aktualisierter Fugu-Modelle ein, bevor diese ausgerollt werden. Das heißt: Fugus Leistung sollte sich mit dem Ökosystem verbessern, ohne dass Nutzende ihre Integration anpassen müssen.
Beim Standardmodell Fugu können Nutzerinnen und Nutzer zudem bestimmte Agenten im Konsolen-Setting aus dem Pool abwählen – wichtig für Teams mit Datenschutz- oder Compliance-Vorgaben. Der Pool von Fugu Ultra ist fix, weil das Modell für seine Benchmark-Leistung auf den vollen Agentensatz angewiesen ist.
Fugu und Fugu Ultra bedienen unterschiedliche Workloads. Fugu balanciert Qualität und niedrige Latenz und ist damit eine gute Wahl für Coding, Code-Review und interaktive Services. Fugu Ultra koordiniert einen größeren Pool von Expertinnen und Experten-Agenten und ist auf maximale Antwortqualität bei harten, mehrschrittigen Problemen getrimmt.
Frühe Nutzerinnen und Nutzer setzten Fugu Ultra bei Aufgaben wie Paper-Reproduktion, Cybersecurity-Analysen, Data-Science im Kaggle-Stil und Patentrecherchen ein.
Ein Software Engineer aus der Beta berichtete, dass Fugu Ultra über zwanzig Code-Review-Befunde identifizierte, während andere Tools etwa drei meldeten.
Eine Cybersecurity-Engineer meldete, dass eine einzige präzise Instruktion eine vollständige Security-Assessment-Kette auslöste – inklusive sauberem Report mit Evidenz und Retest-Schritten.
Wichtig ist der reale Latenz-Trade-off. Multi-Agent-Routing und Synthese erzeugen Overhead. Für einfache Anfragen oder enge Latenzbudgets ist der Direktaufruf eines einzelnen Spitzenmodells wahrscheinlich schneller und günstiger.
Sowohl Fugu als auch Fugu Ultra sind über eine einzige, OpenAI-kompatible API zugänglich. Kein SDK-Wechsel nötig.
Du richtest deinen bestehenden Client auf den Fugu-Endpoint mit deinem API-Schlüssel und legst los. Das senkt bewusst die Wechselkosten für Teams, die GPT-5.5 oder Claude Opus 4.8 bereits über die OpenAI-Clientbibliothek nutzen.
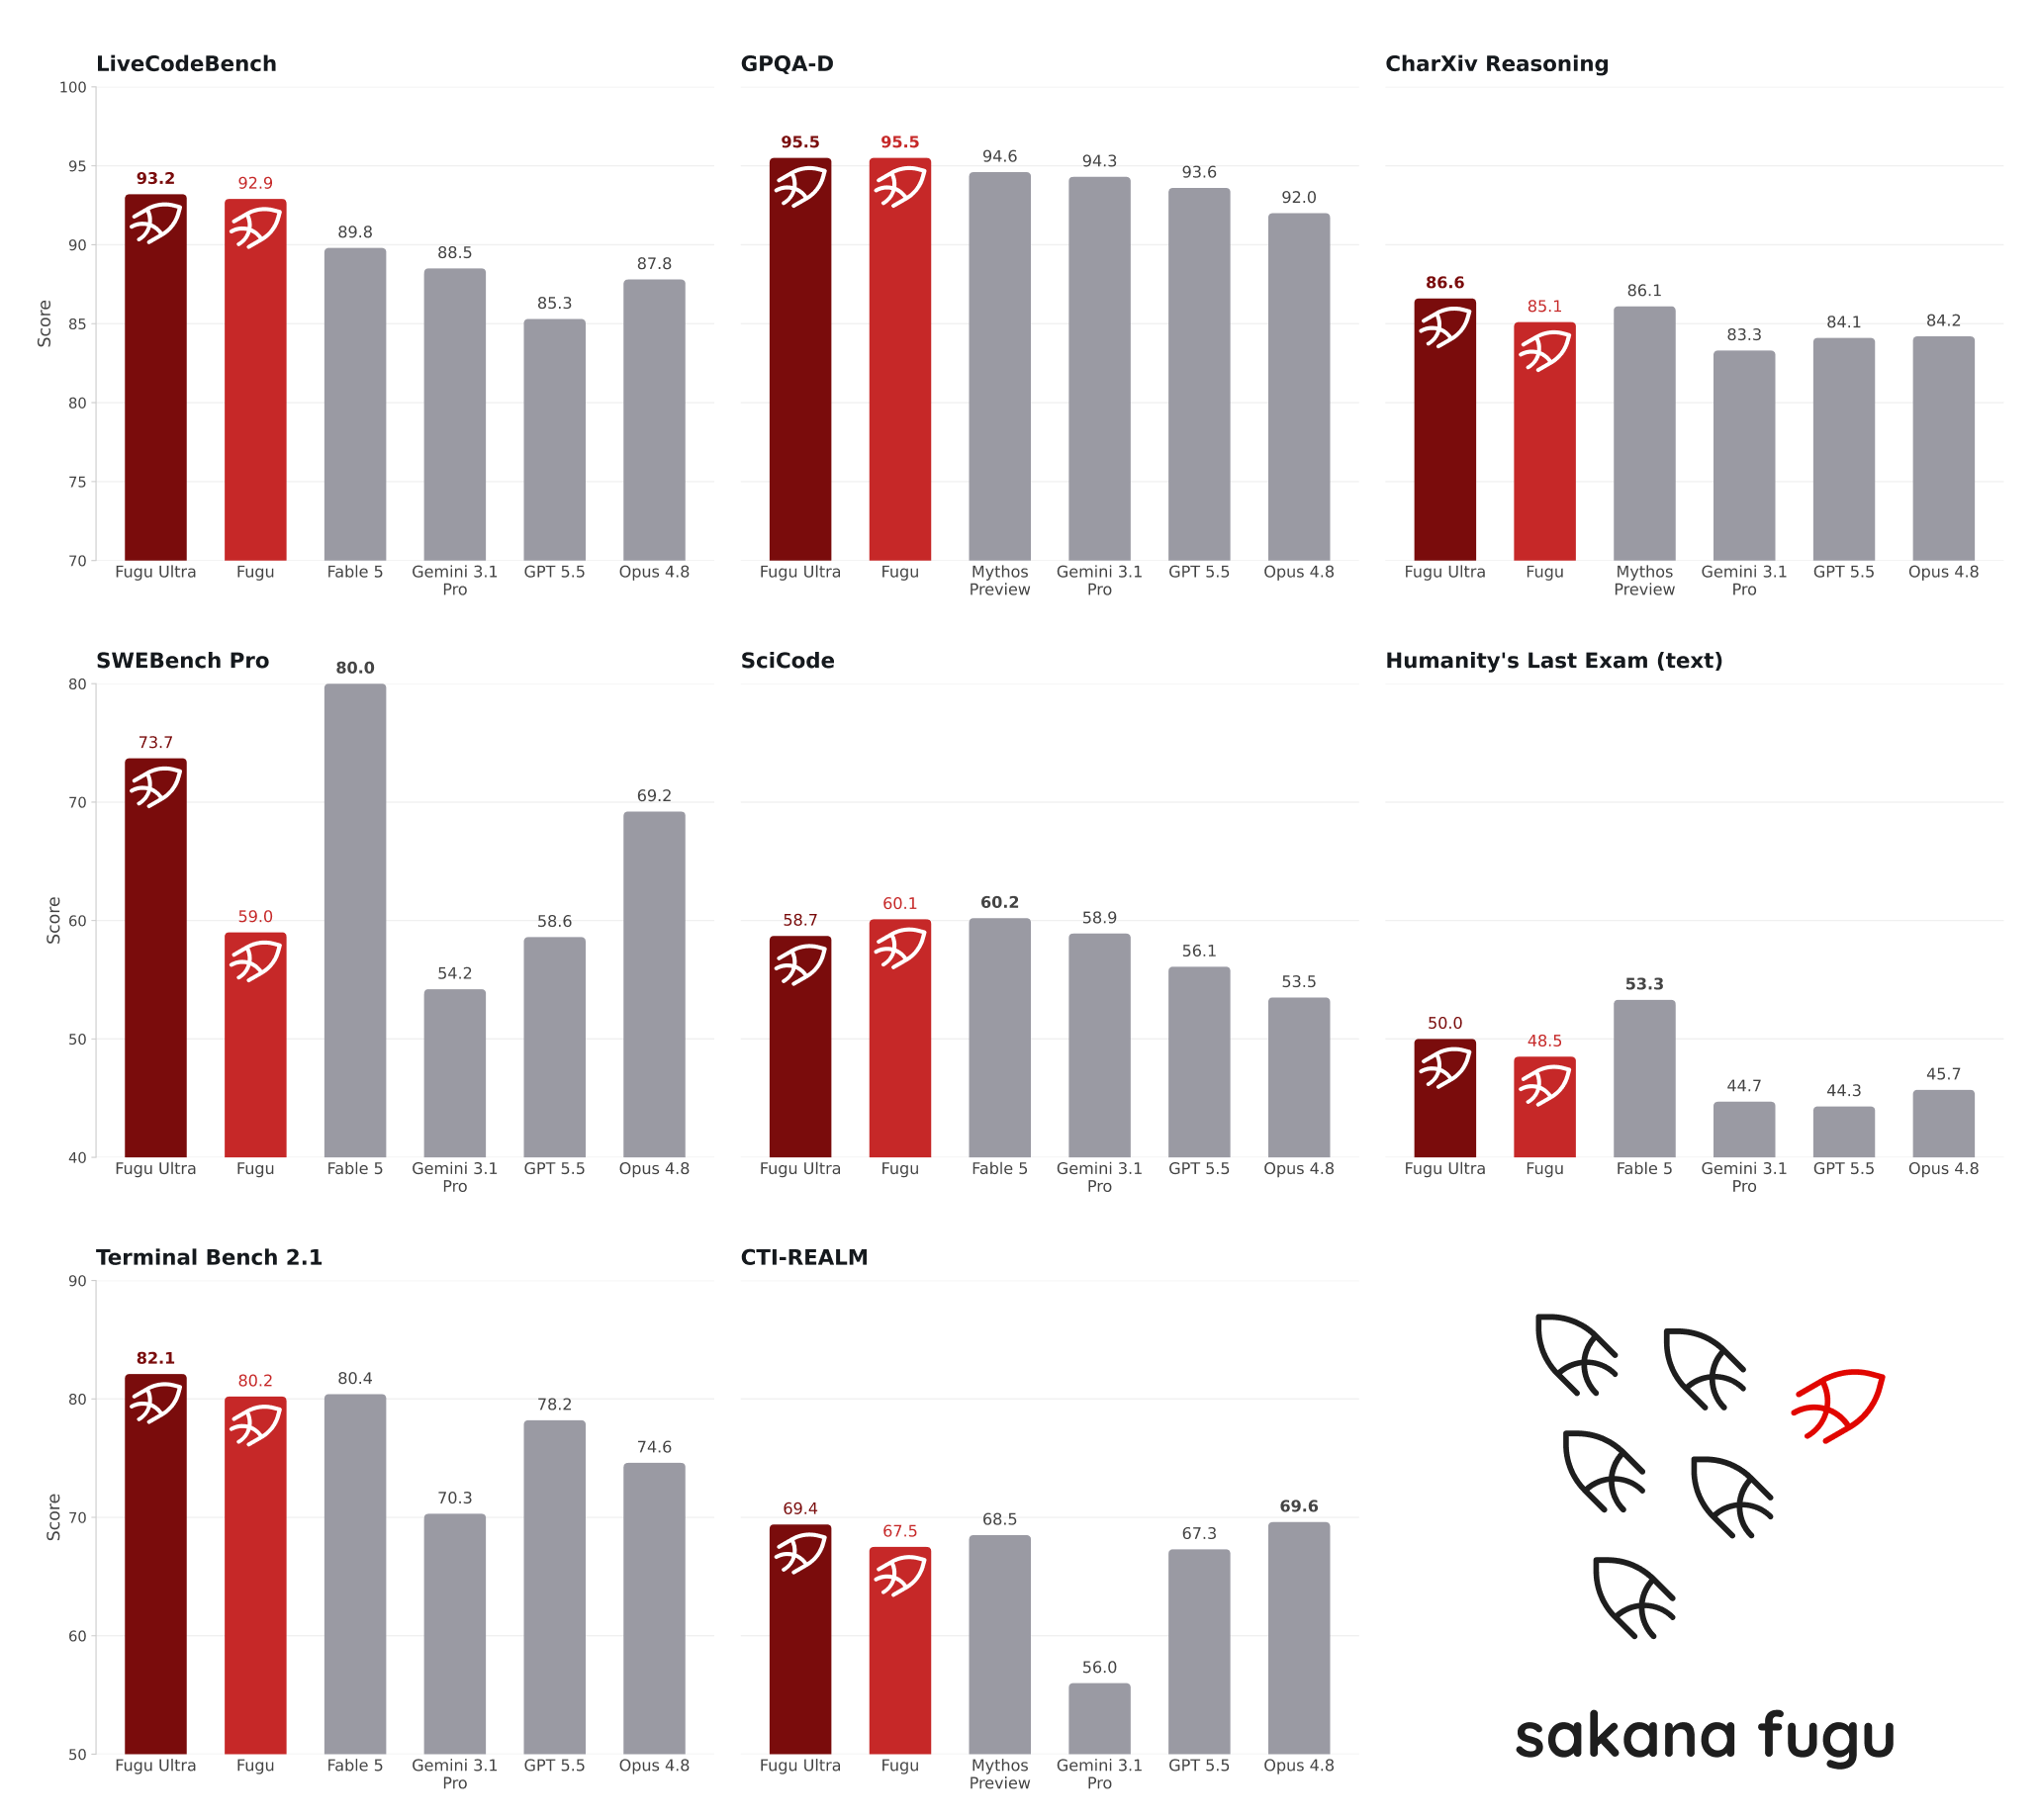
Laut Sakanas Vergleichstabelle führt Fugu Ultra 10 von 11 Benchmarks an, nur bei MRCRv2 liegt GPT-5.5 vorn. Alle Scores – außer denen von Fugu – sind Anbieterangaben. Fable 5 und Mythos Preview fehlen im Vergleich, weil sie nicht öffentlich zugänglich sind und daher nicht in Fugus Agentenpool vorkommen können.
Unabhängige Reproduktionen dieser Zahlen sind nach meinem Kenntnisstand zum Zeitpunkt des Schreibens noch nicht auf Drittanbieter-Leaderboards aufgetaucht.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
Fugu Ultra erreicht 73,7% auf SWE-Bench Pro und liegt damit vor Claude Opus 4.8 mit 69,2%, GPT-5.5 mit 58,6% und Gemini 3.1 Pro mit 54,2%. In unserer GPT-5.5-Berichterstattung hielten wir fest, dass es hier 58,6% erzielt – Fugu Ultra liegt also 15 Punkte darüber.
SWE-Bench Pro prüft, ob ein Modell reale GitHub-Issues in Repositories lösen kann, und zählt zu den praxisnäheren Coding-Benchmarks. Die Lücke zwischen Fugu Ultra und dem nächstbesten öffentlich zugänglichen Modell ist groß genug, um bei ernsthaften Code-Reviews oder Bugfixing spürbar zu sein.
Fugu Ultra erzielt 93,2% auf LiveCodeBench und 90,8% auf LiveCodeBench Pro. Dahinter folgen Gemini 3.1 Pro mit 88,5% und Claude Opus 4.8 mit 87,8% auf der Standardvariante.
LiveCodeBench testet Programmieraufgaben aus aktuellen Wettbewerben, wodurch das Risiko von Trainingsdaten-Kontamination geringer ist als bei älteren Coding-Benchmarks. Die Pro-Variante nutzt schwerere Aufgaben. Fugus Vorsprung passt zu den Beta-Berichten über starke Code-Review-Leistung.
Fugu Ultra erzielt 50,0% bei Humanity's Last Exam, gegenüber 49,8% für Claude Opus 4.8, 44,4% für Gemini 3.1 Pro und 41,4% für GPT-5.5.
Dieser Benchmark testet Expertenwissen über wissenschaftliche und akademische Disziplinen hinweg – mit Fragen, die selbst für Spezialistinnen und Spezialisten schwierig sind. 50% sind bemerkenswert, zumal GPT-5.5 bei 41,4% liegt. Hier ist der Abstand zwischen Fugu Ultra und GPT-5.5 am größten.
Sowohl Fugu als auch Fugu Ultra erreichen 95,5% bei GPQA Diamond, Gemini 3.1 Pro liegt bei 94,3%, GPT-5.5 bei 93,6% und Claude Opus 4.8 bei 92,0%.
GPQA Diamond testet Promotionsniveau-Fragen in Biologie, Chemie und Physik, erstellt von Fachexperten und nachweislich schwierig für Nicht-Spezialisten. Dass der Standard-Fugu hier Fugu Ultra gleichzieht, deutet darauf hin, dass der Orchestrierungs-Overhead bei diesem Q&A-Benchmark wenig bringt – plausibel für Aufgaben, die keine mehrschrittige Planung erfordern.
Fugu Ultra erzielt 82,1% auf TerminalBench 2.1 und liegt damit vor GPT-5.5 mit 78,2%, Claude Opus 4.8 mit 74,6% und Gemini 3.1 Pro mit 70,3%. TerminalBench testet agentische Coding-Aufgaben, die Interaktionen mit einer Terminal-Umgebung erfordern, inklusive Dateimanipulation, Shell-Befehlen und mehrschrittiger Ausführung.
Das ist einer der Benchmarks mit der höchsten Relevanz für reale Developer-Workflows, und Fugus Vorsprung gegenüber GPT-5.5 passt zu den gemeldeten Cybersecurity-Einsatzszenarien in der Beta.
GPT-5.5 gewinnt MRCRv2 mit 94,8%, vor Fugu Ultra mit 93,6% und Claude Opus 4.8 mit 87,9%. MRCRv2 prüft Long-Context-Recall – also ob ein Modell spezifische Informationen aus sehr langen Dokumenten zuverlässig wiederfinden kann.
Das ist der eine Benchmark, bei dem Fugu Ultra nicht führt – wichtig für Teams, deren Hauptanwendungsfall das gezielte Auffinden von Fakten in großen Dokumenten ist und weniger mehrstufiges Reasoning oder Codegenerierung.
Fugu ist jetzt über Sakanas Konsole unter console.sakana.ai verfügbar – mit OpenAI-kompatibler API. Sowohl Fugu als auch Fugu Ultra sind in allen Plänen enthalten. Die Abostufen sind:
Im Pay-as-you-go-Plan wird nach Tokenverbrauch abgerechnet statt per Monatskontingent. Für Fugu Ultra (Model-ID: fugu-ultra-20260615) liegen die Preise bei $5 pro Million Input-Tokens und $30 pro Million Output-Tokens für Standard-Kontextlängen.
Für Kontexte über 272K Tokens steigen die Sätze auf $10 Input und $45 Output. Zwischengespeicherter Input kostet $0,50 pro Million Tokens, bzw. $1,00 über 272K. Die Standardpreise von Fugu entsprechen der Rate des jeweils aktiven zugrunde liegenden Modells, und Sakana stapelt keine Gebühren, wenn mehrere Agenten parallel laufen.
Ein regionaler Hinweis: Fugu ist derzeit nicht in EU- oder EWR-Mitgliedstaaten verfügbar, während Sakana an der DSGVO-Compliance arbeitet. Für europäische Teams ist das aktuell ein Showstopper. Sakana hat keinen Zeitplan für die EU-Verfügbarkeit veröffentlicht.
Fugu ist tatsächlich ein anderer Ansatz als der von OpenAI, Anthropic und Google. Statt über Basismodellgröße zu konkurrieren, argumentiert Sakana, dass gelerntes Orchestrieren über einen austauschbaren Pool von Spitzenmodellen jedes einzelne System bei den wirklich zeitintensiven Aufgaben schlagen oder einholen kann: lange Code-Reviews, mehrstufige Recherche, Security-Assessments und Paper-Reproduktionen.
Die Benchmark-Zahlen stützen dieses Argument – sofern sie unabhängiger Überprüfung standhalten – bei den meisten für Developer relevanten Metriken. Klar ist aber auch: Solange wir nicht wieder Zugriff auf Fable 5 und Mythos haben, fehlt der direkte Vergleich.
Gleichzeitig gibt es Einschränkungen.
Alle Scores sind von Sakana gemeldet. Die Routing-Schicht ist intransparent und erschwert compliance-kritische Arbeit. Die EU/EWR-Exklusion bremst die Adoption in einem bedeutenden Teil der globalen Developer-Community. Und der Latenz-Trade-off bei einfachen Aufgaben ist real: Wenn du schnelle, einstufige API-Calls machst, ist der Orchestrierungs-Overhead von Fugu Ultra reiner Kostenfaktor ohne Mehrwert.
Wo Fugu aus meiner Sicht überzeugt: Teams mit langlaufenden, agentischen Workflows, die heute schon die Komplexität mehrerer Modelle selbst managen. Wenn du dein eigenes Orchestrierungs-Harness über Claude und GPT pflegst, ist Fugu Ultra eine ernsthafte Evaluation wert.
Die Souveränitäts-Rhetorik ist vermutlich überzeichnet, aber der praktische Nutzen eines einzelnen Endpoints, der Anbieterstörungen umschifft, ist es nicht.
Wenn du dich schnell im agentischen KI-Feld orientieren willst, in dem Fugu operiert, empfehle ich den AI Agent Fundamentals Skill Track auf DataCamp. Er behandelt die Grundlagen großer Sprachmodelle, Agenten und Multi-Modell-Systeme.
Top-DataCamp-Kurse
Kurs
Lernpfad
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Tutorial
Mark Pedigo
10 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.





