Curso
Google: Agent Fundamentals
1 h
750
O cenário de IA em meados de 2026 está lotado de modelos de fronteira monolíticos disputando em benchmarks brutos. A Sakana AI está apostando em outra direção: em vez de treinar um modelo base ainda maior, lançou o Fugu, um sistema que orquestra um pool de modelos de ponta existentes por trás de uma única API compatível com a OpenAI.
A promessa principal é que o Sakana Fugu Ultra iguala o Fable 5 e o Mythos Preview, da Anthropic, em benchmarks de engenharia, ciência e raciocínio — sem exigir acesso a esses modelos sujeitos a controle de exportação.
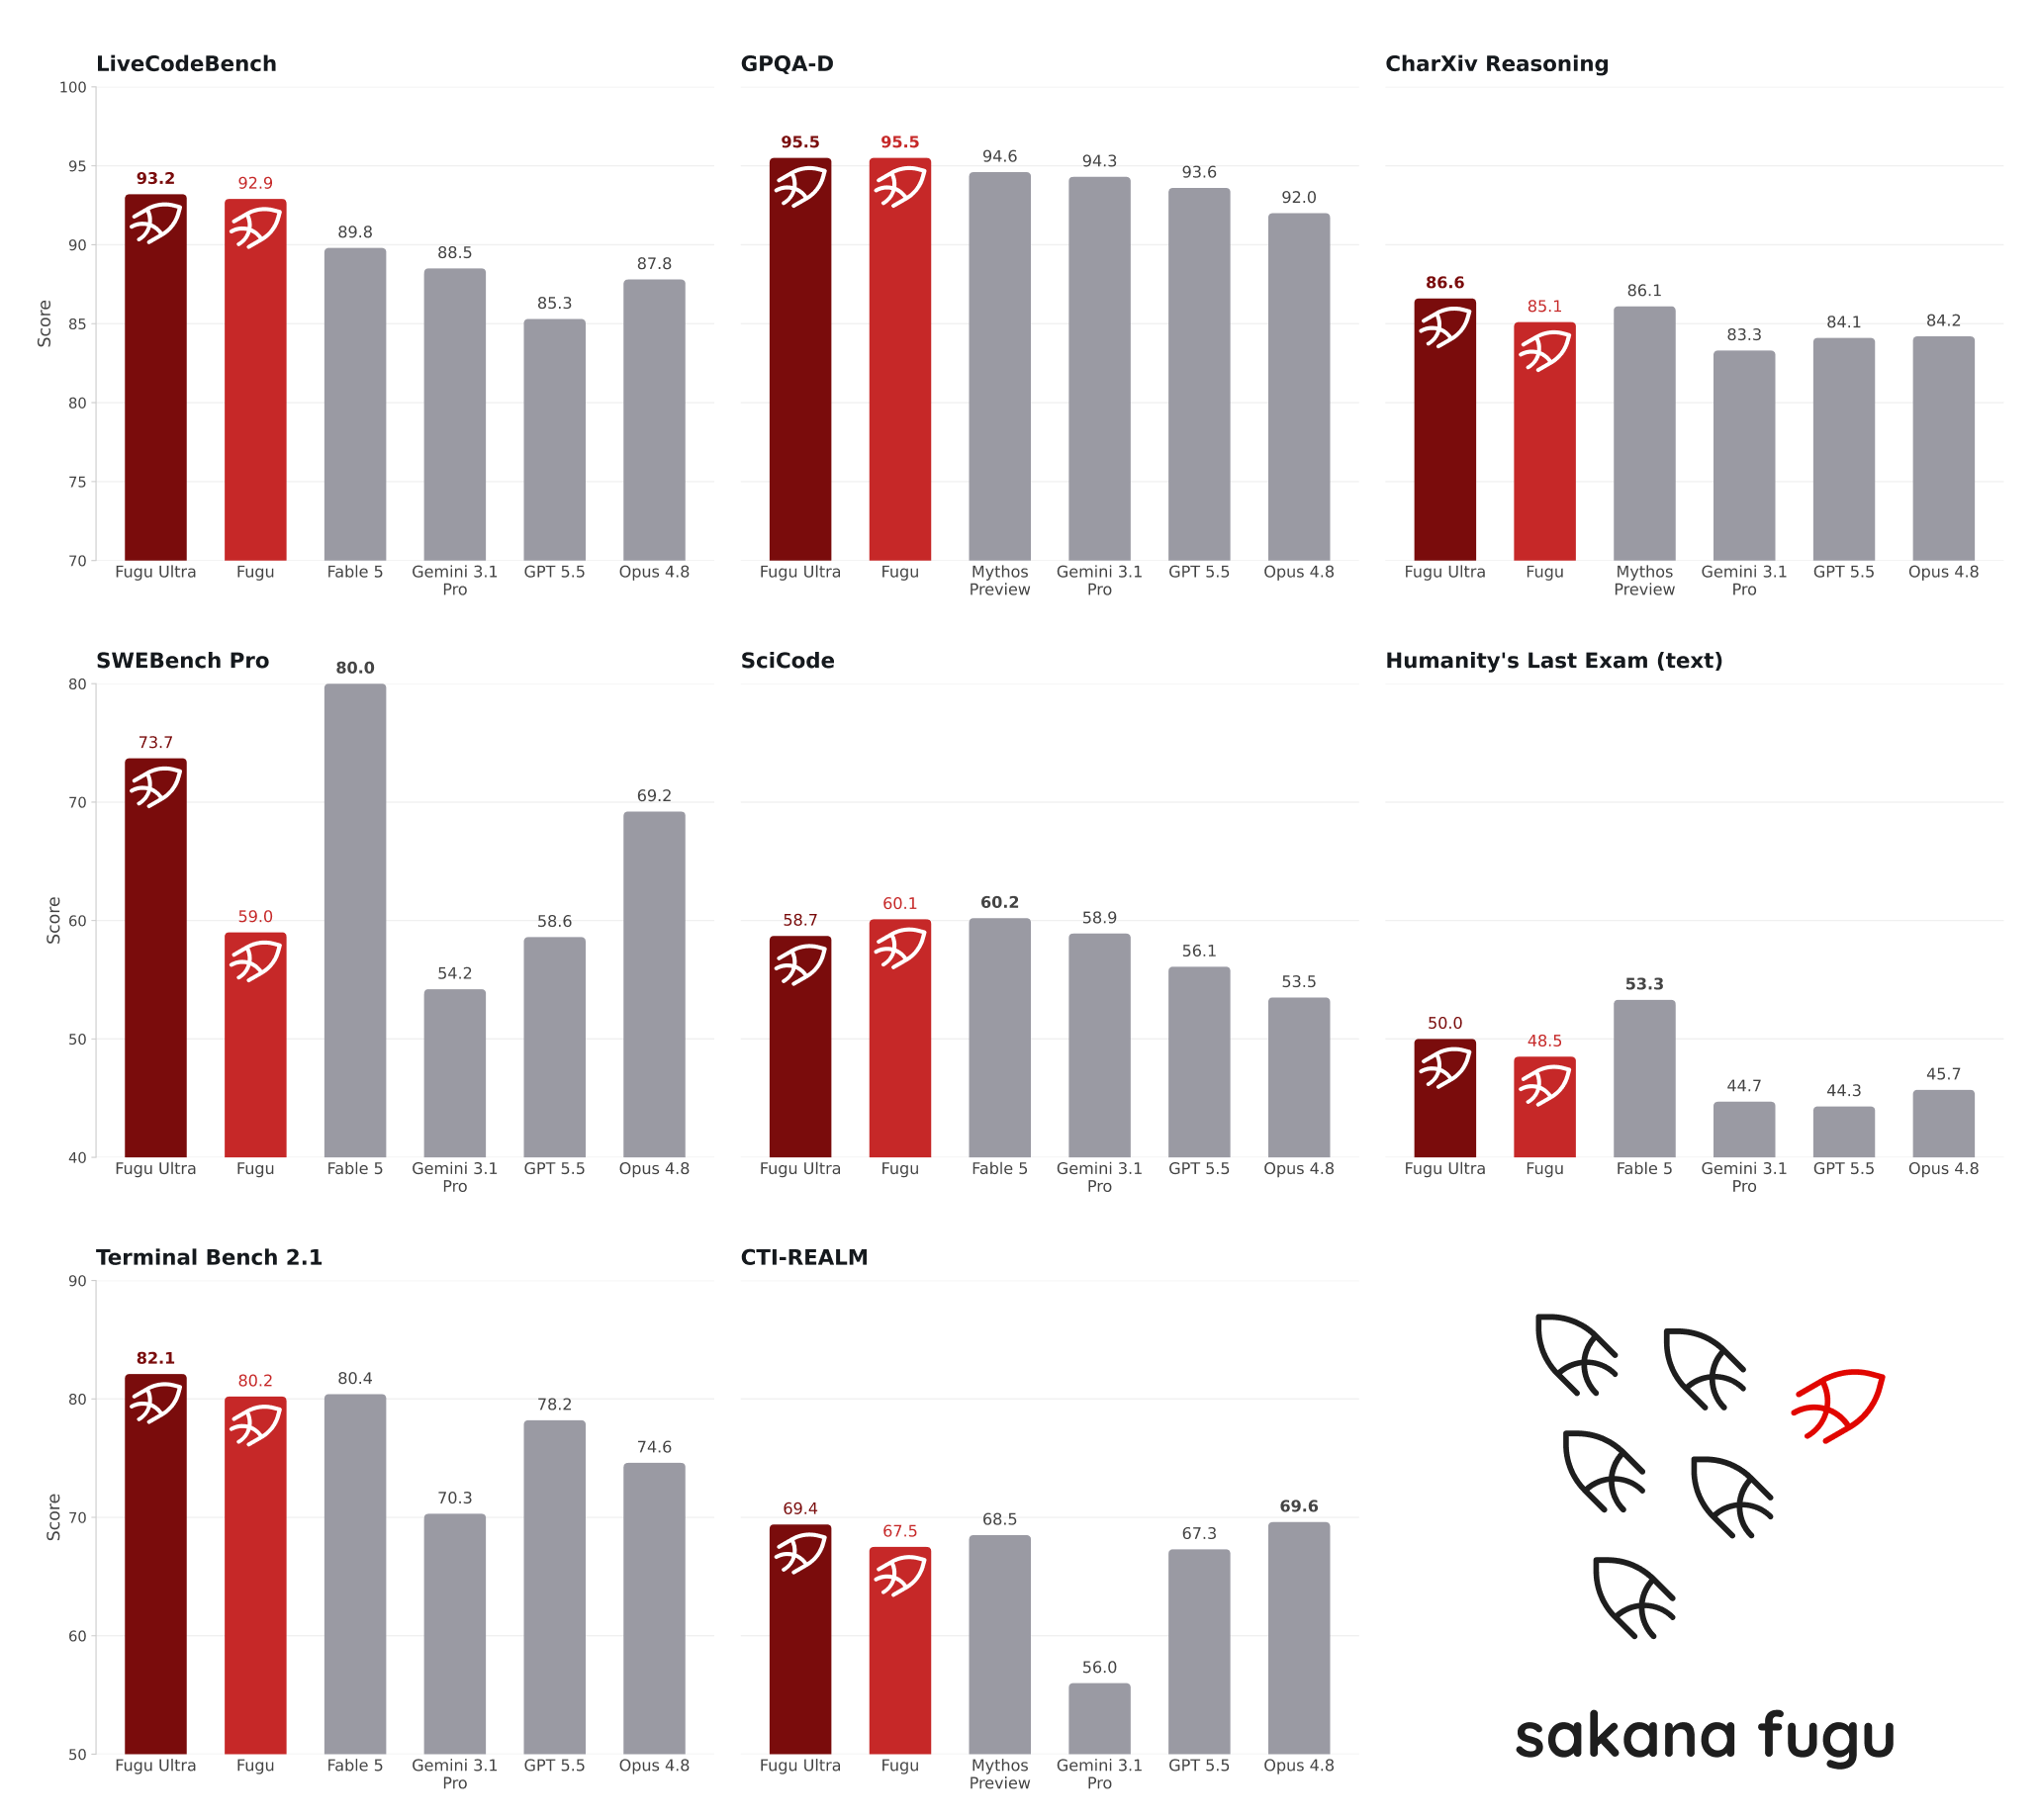
O Sakana Fugu foi lançado em 22 de junho de 2026, em duas variantes: Fugu, para trabalho do dia a dia sensível a latência, e Fugu Ultra, para tarefas complexas e de múltiplas etapas. No SWE-Bench Pro, o Fugu Ultra marca 73,7%, à frente do Claude Opus 4.8 (69,2%), do GPT-5.5 (58,6%) e do Gemini 3.1 Pro (54,2%).
Todos os números de benchmark foram reportados pela própria Sakana e ainda não foram reproduzidos de forma independente por laboratórios terceiros — vale ter isso em mente enquanto você lê.
Neste artigo, explico o que o Fugu realmente é, passo pelos principais recursos, trago a tabela completa de benchmarks e comento alguns casos de uso. Você também pode conferir nossa comparação entre GPT-5.5 e Gemini 3.1 Pro para contextualizar os modelos com os quais o Fugu está competindo.
O Sakana Fugu é um modelo de linguagem treinado para atuar como orquestrador: ele recebe uma solicitação, decide se resolve diretamente ou delega a modelos especialistas do seu pool de agentes, gerencia verificação e síntese e retorna uma resposta única. Por fora, você chama um endpoint. Por dentro, um conjunto coordenado de modelos faz o trabalho.
A Sakana AI vem construindo nessa direção desde a sua fundação. O laboratório, criado por Llion Jones (coautor do artigo original "Attention Is All You Need") e David Ha, defende há tempos que ecossistemas de modelos coordenados superam monólitos isolados em tarefas difíceis e de longa duração.
O Fugu é a materialização dessa tese, baseada em dois artigos da ICLR 2026: TRINITY (um coordenador de LLMs evoluído) e Conductor (aprendizado de orquestração de agentes em linguagem natural).
No momento da escrita, o Fable 5 e o Mythos Preview, da Anthropic, não estão acessíveis publicamente por conta de controles de exportação, o que significa que eles não podem integrar o pool de agentes do Fugu.
O argumento da Sakana é que fazer o roteamento em um pool de modelos intercambiável oferece uma proteção prática exatamente contra esse tipo de interrupção de acesso. Se isso de fato configura "soberania em IA" é discutível, mas a lógica operacional é sólida: se um provedor restringe o acesso, o Fugu contorna.
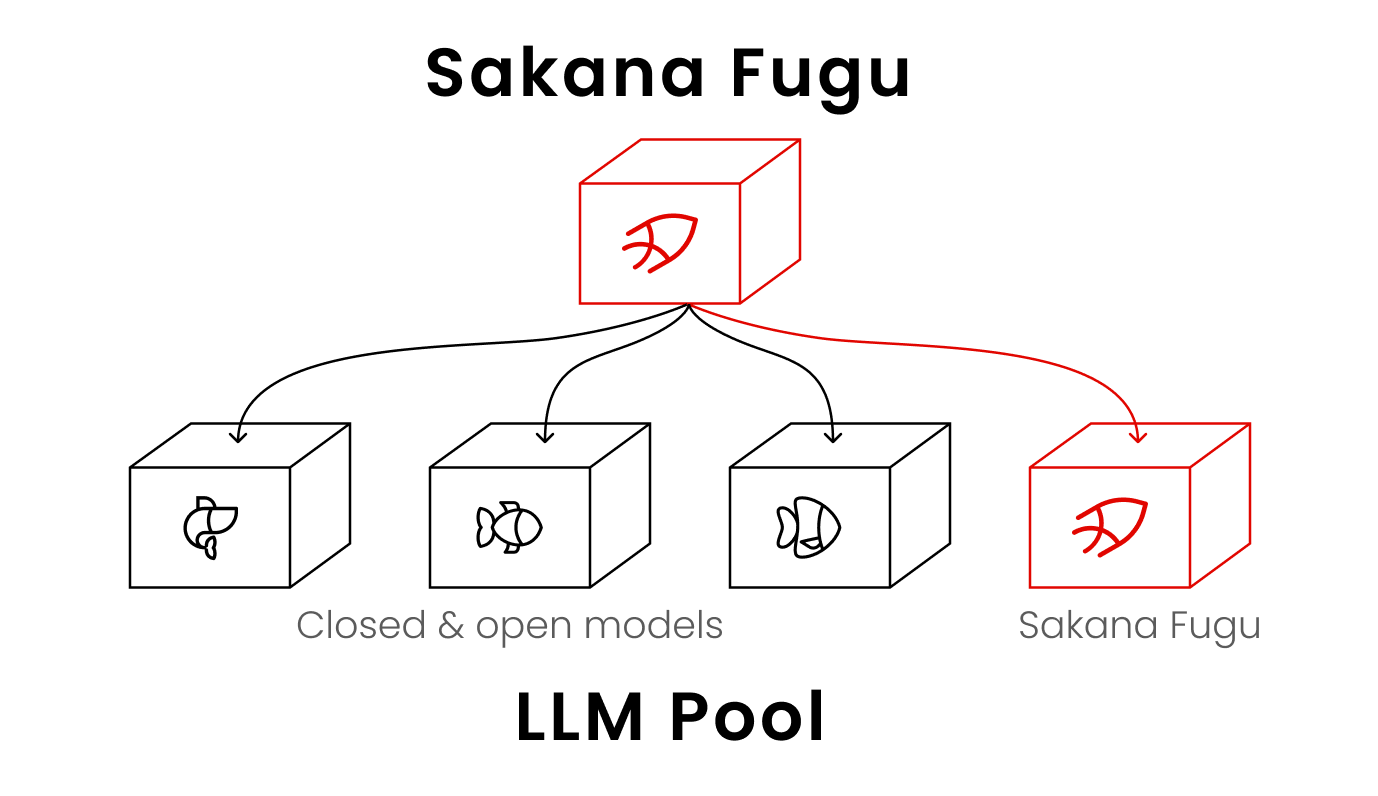
O Fugu traz várias ideias que o diferenciam tanto de modelos de fronteira convencionais quanto de frameworks multiagentes tradicionais. Destaco as principais abaixo.
A maioria dos sistemas multiagentes exige que os desenvolvedores definam qual modelo cuida de qual tarefa. O Fugu aprende isso. O modelo orquestrador é treinado para decidir quando delegar, como os agentes devem se comunicar e como combinar suas saídas em uma resposta única. Essa é a contribuição central das pesquisas TRINITY e Conductor que linkei acima.
Na prática, isso significa que a complexidade de um sistema multiagente não chega ao seu código. Você envia uma solicitação para um endpoint e o Fugu cuida internamente da seleção de modelos, delegação, verificação e síntese. Para times que já tentaram construir suas próprias camadas de orquestração, a atração é óbvia: você colhe os ganhos de coordenação sem manter o harness.
Um ponto de atenção: as decisões de roteamento são proprietárias e não são expostas aos usuários. Você não consegue ver qual modelo subjacente atendeu uma solicitação específica. Para trabalhos sensíveis a compliance, em que é preciso auditar a cadeia de raciocínio, essa opacidade é uma limitação real.
Os modelos no pool do Fugu não são fixos. Quando surge um novo modelo de ponta disponível publicamente, a expectativa da Sakana é gastar cerca de duas semanas treinando e avaliando versões atualizadas do Fugu antes de disponibilizá-las. Isso significa que o desempenho do Fugu deve melhorar à medida que o ecossistema evolui — sem exigir mudanças na integração por parte do usuário.
No Fugu padrão, usuários também podem desativar agentes específicos do pool pelas configurações do console, o que é importante para times com requisitos de privacidade de dados ou compliance. O pool do Fugu Ultra é fixo porque ele depende do conjunto completo de agentes para entregar seus resultados de benchmark.
Fugu e Fugu Ultra atendem cargas de trabalho diferentes. O Fugu equilibra qualidade com baixa latência, sendo um padrão razoável para coding, revisão de código e serviços interativos. O Fugu Ultra coordena um pool mais profundo de agentes especialistas e é ajustado para máxima qualidade de resposta em problemas difíceis e de múltiplas etapas.
Usuários iniciais recorreram ao Fugu Ultra para tarefas como reprodução de artigos científicos, análises de cibersegurança, data science ao estilo Kaggle e investigações de patentes.
Um engenheiro de software no beta relatou que o Fugu Ultra apontou mais de vinte problemas em uma revisão de código, enquanto outras ferramentas sinalizaram cerca de três.
Uma engenheira de cibersegurança relatou que uma única instrução bem delimitada conduziu uma avaliação completa de segurança de ponta a ponta, incluindo um relatório organizado com evidências e etapas de reteste.
Vale reforçar que a troca em latência é real. O roteamento e a síntese multiagentes adicionam sobrecarga. Para consultas simples ou com requisitos de latência apertados, uma chamada direta a um único modelo de fronteira provavelmente será mais rápida e barata.
Tanto o Fugu quanto o Fugu Ultra são acessíveis por meio de uma única API compatível com a OpenAI. Não é necessário migrar SDK.
Você aponta seu cliente existente para o endpoint do Fugu com sua chave de API e começa a enviar requisições. Essa é uma escolha deliberada para reduzir o custo de troca para times que já usam GPT-5.5 ou Claude Opus 4.8 via a biblioteca cliente da OpenAI.
Segundo a tabela de comparação da Sakana, o Fugu Ultra lidera 10 de 11 benchmarks, com o GPT-5.5 vencendo apenas o MRCRv2. Todas as pontuações, exceto as do Fugu, são reportadas pelos próprios provedores. Fable 5 e Mythos Preview foram excluídos da comparação por não estarem acessíveis publicamente e, portanto, não poderem integrar o pool de agentes do Fugu.
Reproduções independentes desses números ainda não apareceram em rankings de terceiros, pelo que vi até o momento da escrita.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
O Fugu Ultra marca 73,7% no SWE-Bench Pro, à frente do Claude Opus 4.8 com 69,2%, do GPT-5.5 com 58,6% e do Gemini 3.1 Pro com 54,2%. Na nossa cobertura do GPT-5.5, destacamos a pontuação de 58,6% nesse benchmark, que o Fugu Ultra supera em 15 pontos.
O SWE-Bench Pro testa se um modelo consegue resolver issues reais do GitHub em repositórios de software, tornando-o um dos benchmarks de código mais conectados à prática. A diferença entre o Fugu Ultra e o próximo modelo acessível publicamente é grande o suficiente para impactar times que fazem revisão de código séria ou correção de bugs.
O Fugu Ultra marca 93,2% no LiveCodeBench e 90,8% no LiveCodeBench Pro. As próximas melhores pontuações são do Gemini 3.1 Pro com 88,5% e do Claude Opus 4.8 com 87,8% na versão padrão.
O LiveCodeBench testa problemas de programação competitiva extraídos de competições recentes, o que reduz o risco de contaminação por dados de treino em relação a benchmarks mais antigos. A variante Pro traz problemas mais difíceis. A liderança do Fugu aqui é consistente com os relatos do beta sobre desempenho forte em revisão de código.
O Fugu Ultra marca 50,0% no Humanity's Last Exam, contra 49,8% do Claude Opus 4.8, 44,4% do Gemini 3.1 Pro e 41,4% do GPT-5.5.
Esse benchmark avalia conhecimento em nível de especialista em domínios científicos e acadêmicos, com questões difíceis até para especialistas da área. Uma pontuação de 50% é notável considerando que o GPT-5.5 está em 41,4%. A diferença entre o Fugu Ultra e o GPT-5.5 aqui é a maior da tabela.
Fugu e Fugu Ultra marcam 95,5% no GPQA Diamond, com o Gemini 3.1 Pro em 94,3%, o GPT-5.5 em 93,6% e o Claude Opus 4.8 em 92,0%.
O GPQA Diamond testa questões de ciência em nível de PhD em biologia, química e física, escritas por especialistas e verificadas para serem difíceis a não especialistas. O fato de o Fugu padrão igualar o Fugu Ultra sugere que a sobrecarga de orquestração aqui não agrega muito — o que faz sentido para um task de perguntas e respostas que não demanda planejamento em múltiplas etapas.
O Fugu Ultra marca 82,1% no TerminalBench 2.1, à frente do GPT-5.5 com 78,2%, do Claude Opus 4.8 com 74,6% e do Gemini 3.1 Pro com 70,3%. O TerminalBench avalia tarefas de coding agentic que exigem interação com um ambiente de terminal, incluindo manipulação de arquivos, comandos de shell e execução em múltiplas etapas.
Esse é um dos benchmarks mais relevantes para o fluxo de trabalho real de desenvolvedores, e a liderança do Fugu Ultra sobre o GPT-5.5 aqui é consistente com o caso de uso de avaliação de segurança relatado no beta.
O GPT-5.5 vence o MRCRv2 com 94,8%, contra 93,6% do Fugu Ultra e 87,9% do Claude Opus 4.8. O MRCRv2 testa recall em longos contextos, especificamente se um modelo consegue recuperar informações específicas de documentos muito extensos.
Esse é o único benchmark em que o Fugu Ultra não lidera, o que vale ser observado por times cujo uso principal envolve recuperar fatos específicos de grandes documentos, em vez de raciocínio multi-etapas ou geração de código.
O Fugu já está disponível pelo console da Sakana em console.sakana.ai, com API compatível com a OpenAI. Fugu e Fugu Ultra estão inclusos em todos os planos. As faixas de assinatura são:
O plano pré-pago cobra por uso de tokens em vez de franquia mensal. Para o Fugu Ultra (ID do modelo: fugu-ultra-20260615), o preço é de US$ 5 por milhão de tokens de entrada e US$ 30 por milhão de tokens de saída para janelas de contexto padrão.
Para contextos acima de 272 mil tokens, as tarifas sobem para US$ 10 na entrada e US$ 45 na saída. Entrada em cache custa US$ 0,50 por milhão de tokens, ou US$ 1,00 acima de 272 mil. O preço do Fugu padrão acompanha a tarifa do modelo subjacente ativo, e a Sakana não empilha taxas quando vários agentes rodam ao mesmo tempo.
Uma limitação regional importante: o Fugu não está disponível atualmente em países da UE ou do EEE, enquanto a Sakana trabalha a conformidade com o GDPR. Para times europeus, isso é um impeditivo por ora. A Sakana não publicou um prazo para disponibilidade na UE.
O Fugu é uma aposta realmente diferente do que OpenAI, Anthropic e Google estão fazendo. Em vez de competir em escala de modelo base, a Sakana defende que a orquestração aprendida em um pool intercambiável de modelos de ponta pode igualar ou superar qualquer sistema individual nas tarefas que realmente consomem tempo: revisões longas de código, pesquisas multi-etapas, avaliações de segurança e reprodução de artigos.
Os números de benchmark, se forem confirmados por verificação independente, sustentam esse argumento na maioria das métricas que importam para desenvolvedores. Claro, enquanto não tivermos novamente acesso ao Fable 5 e ao Mythos, não dá para comparar diretamente com eles.
Dito isso, há alguns poréns.
Todas as pontuações foram reportadas pela Sakana. A camada de roteamento é opaca, o que gera atrito para trabalhos sensíveis a compliance. A exclusão de UE/EEE limita a adoção por uma parcela relevante da comunidade global de desenvolvedores. E a troca de latência em tarefas simples é real: se você faz chamadas rápidas e de turno único à API, a sobrecarga de orquestração do Fugu Ultra é custo puro, sem benefício.
Onde acredito que o Fugu tem um caso sólido é para times que rodam fluxos agentic de longo horizonte e já gerenciam por conta própria a complexidade de setups multi-modelo. Se você mantém seu próprio harness de orquestração sobre Claude e GPT, o Fugu Ultra merece uma avaliação séria.
A moldura de "soberania" talvez esteja exagerada, mas o valor prático de um endpoint único que contorna interrupções de provedores não está.
Se você quer se atualizar sobre o panorama de IA agentic em que o Fugu opera, recomendo começar pela trilha de habilidades AI Agent Fundamentals na DataCamp, que cobre os fundamentos de grandes modelos de linguagem, agentes e sistemas multi-modelo.
Principais cursos da DataCamp
Curso
Programa
Curso
blog
Richie Cotton
8 min
blog
Khalid Abdelaty
15 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
14 min
Tutorial
Kurtis Pykes
12 min